Accelerated Computing Hub, часть 2: GPU, CUDA и Python — основы
Перевод вводных глав NVIDIA Accelerated Python User Guide и урока «What Are GPUs»: чем GPU отличается от CPU, как устроены SM, потоки, варпы, блоки и иерархия памяти CUDA, и почему Python-разработчику хватает высокоуровневых библиотек вроде CuPy.
Это перевод вводных материалов NVIDIA из репозитория Accelerated Computing Hub: первых трёх глав Accelerated Python User Guide («Руководство по ускоренному Python») и короткого урока What Are GPUs из учебного курса Accelerated Python. Тексты репозитория распространяются по лицензии CC BY-NC-SA 4.0, поэтому и у этой страницы та же лицензия: можно делиться и переделывать с указанием авторства, некоммерчески и на тех же условиях.
Путеводитель по всему репозиторию — в части 1, практика с CuPy и своими ядрами на Numba — в части 3.
Глава 1. Основы вычислений на GPU
Заголовок раздела «Глава 1. Основы вычислений на GPU»Введение
Заголовок раздела «Введение»Графический процессор (GPU, graphics processing unit) — специализированная электронная схема, которую изначально создали, чтобы ускорять компьютерную графику и обработку изображений. У графических процессоров есть специальные вычислительные ядра, с помощью которых можно ускорять вычисления.
GPU изначально проектировали для обработки изображений и визуальных данных, но теперь их применяют, чтобы ускорять и другие вычисления — например, научные расчёты и машинное обучение. Дело в том, что GPU эффективно работают параллельно на огромных распределённых вычислительных задачах.
Мир программирования GPU огромен, и разобраться одновременно в понятиях программирования GPU и в подходах к нему из Python бывает непросто. В этом руководстве мы надеемся развеять туман вокруг этой экосистемы и привести разработчиков к решению, которое подходит именно под их задачи ускоренных вычислений.
(В оригинале здесь картинка-заставка — куб NVIDIA.)
Режимы параллелизма
Заголовок раздела «Режимы параллелизма»Главное преимущество GPU — параллелизм, то есть одновременная обработка частей целого. Для параллельной обработки используют четыре архитектуры:
- одна инструкция, один поток данных (SISD, Single instruction, single data);
- одна инструкция, много данных (SIMD, Single instruction, multiple data);
- много инструкций, один поток данных (MISD, Multiple instructions, single data);
- много инструкций, много данных (MIMD, Multiple instructions, multiple data).
Большинство CPU — многоядерные процессоры с архитектурой MIMD. GPU, напротив, используют архитектуру SIMD. Из-за этого различия GPU хорошо подходят для сильно параллельных задач, где одну и ту же операцию нужно выполнить над множеством элементов данных.
(Примечание переводчика: сама NVIDIA в руководстве по CUDA называет модель исполнения своих GPU SIMT — Single Instruction, Multiple Threads, «одна инструкция, много потоков». Отличие от классического SIMD в том, что программист пишет код для одного потока, а железо группирует потоки по 32 — это варп, см. главу 2 — и исполняет одну инструкцию сразу для всей группы.)
Программирование GPU общего назначения
Заголовок раздела «Программирование GPU общего назначения»Из-за изначального назначения GPU раньше требовали знания специализированных языков вроде OpenGL. Эти языки использовались только для GPU, учить их было непрактично, и это создавало барьер для использования.
В 2007 году, с выходом платформы NVIDIA CUDA, этот барьер был сломан и доступ к ресурсам GPU стал гораздо шире. CUDA основана на C и предоставляет API, с помощью которого разработчики могут применять GPU для других задач.
(Примечание переводчика: в главе 2 указан ноябрь 2006 года — тогда CUDA анонсировали вместе с GPU G80; первые версии инструментов для разработчиков вышли в 2007-м.)
Плюсы и минусы CPU и GPU
Заголовок раздела «Плюсы и минусы CPU и GPU»Решая, что запускать на CPU, а что на GPU, помните: у этих двух процессоров разная архитектура. Инструкции нельзя разделить между ними, и сами они работу друг другу не передают. Программист должен сознательно переносить данные и вычисления с одного на другой — явно или неявно, через программный пакет с поддержкой GPU.
Центральные процессоры (CPU, Central Processing Units) — самый распространённый тип процессоров в современных компьютерах; долгое время они были «рабочей лошадкой» аналитики данных. CPU состоят из нескольких ядер, которые выполняют инструкции и последовательно, и параллельно, — поэтому CPU универсальны и подходят для широкого круга задач.
Сильные стороны CPU
Заголовок раздела «Сильные стороны CPU»- Универсальность. CPU справляются с широким кругом задач общего назначения: логическими сравнениями, пересылкой данных между регистрами, работой с файлами. CPU быстрее GPU в обработке данных в оперативной памяти, операциях ввода-вывода и администрировании операционной системы.
- Многозадачность. CPU могут выполнять несколько задач одновременно.
- Высокая тактовая частота. Обычно частота у CPU выше, чем у GPU, поэтому однопоточные задачи CPU выполняет быстрее.
- Гибкость. CPU умеют переключаться между несколькими задачами и быстро менять контекст.
- Кэш-память. У CPU большая локальная кэш-память.
- Совместимость. CPU совместимы со всеми типами систем, а GPU может потребоваться специальное оборудование.
Слабые стороны CPU
Заголовок раздела «Слабые стороны CPU»- Ограниченный параллелизм. CPU не рассчитаны на сильно параллельные нагрузки.
- Высокое энергопотребление. CPU могут потреблять много энергии, что увеличивает эксплуатационные расходы.
- Ограниченная пропускная способность памяти. По сравнению с GPU у CPU пропускная способность памяти ниже, поэтому на больших наборах данных они работают медленнее.
- Параллельная обработка. CPU хуже справляются с задачами, где нужны миллионы одинаковых операций.
- Ограниченное развитие. CPU — очень зрелая технология, у неё меньше потенциала для улучшения, чем у GPU.
В целом CPU — универсальный и надёжный выбор для многих задач, но не лучший вариант для вычислительно тяжёлых, сильно параллельных нагрузок или крупных операций при жёстких ограничениях по времени и бюджету.
Графические процессоры (GPU) изначально создавали для отрисовки графики и изображений, но в последние годы они стали мощными ускорителями и для других вычислительных задач общего назначения. GPU состоят из тысяч вычислительных ядер, которые выполняют инструкции параллельно, — поэтому GPU идеальны для вычислительно тяжёлых задач.
Сильные стороны GPU
Заголовок раздела «Сильные стороны GPU»- Параллельная обработка. GPU выполняют тысячи вычислений одновременно над множеством элементов данных. Сотни ядер GPU позволяют вести массово-параллельные вычисления — например, умножение матриц.
- Высокая пропускная способность памяти. GPU быстрее обращаются к данным и обрабатывают их.
- Энергоэффективность. GPU могут потреблять меньше энергии, чем CPU, что снижает эксплуатационные расходы.
- Настраиваемые архитектуры. GPU можно настраивать под конкретные приложения и нагрузки, они гибкие и адаптируемые.
- Научные вычисления. GPU дают огромное ускорение в специализированных задачах вроде генеративного ИИ, глубокого обучения и обработки больших данных.
Слабые стороны GPU
Заголовок раздела «Слабые стороны GPU»- Ограниченная многозадачность. GPU умеют повторять одну задачу в огромном масштабе, но не умеют выполнять задачи общего назначения так, как CPU.
- Сложность. GPU плохо справляются с ветвлениями, последовательными операциями и другими сложными шаблонами программирования.
- Совместимость ПО. Чтобы GPU работали эффективно, может понадобиться дополнительное программирование или оптимизация.
В целом GPU — мощный и эффективный вариант для задач, которым нужны высокая производительность и параллельная обработка. Поэтому они идеальны для ускорения научного кода на Python, который обычно повторяет одни и те же операции над большими объёмами данных.
(Примечание переводчика: «энергоэффективность» здесь — в пересчёте на операцию: одна видеокарта потребляет сотни ватт, но на матричных вычислениях делает на порядки больше операций за ватт, чем CPU.)
Архитектура GPU
Заголовок раздела «Архитектура GPU»Чтобы выжать из GPU максимум, нужно понимать основы его архитектуры. Для простоты можно считать, что один GPU состоит из нескольких кластеров потоковых мультипроцессоров.
flowchart TB
subgraph GPU["GPU"]
  subgraph PC1["Кластер (PC)"]
    SM1["SM: ядра + L1"]
    SM2["SM: ядра + L1"]
  end
  subgraph PC2["Кластер (PC)"]
    SM3["SM: ядра + L1"]
    SM4["SM: ядра + L1"]
  end
  L2["Общий кэш L2"]
end
MEM[("Глобальная память GPU<br/>GDDR / HBM")]
SM1 & SM2 & SM3 & SM4 --> L2 --> MEMОдин GPU состоит из нескольких кластеров процессоров (PC, Processor Clusters), в каждом из которых несколько потоковых мультипроцессоров (SM, Streaming Multiprocessors). В каждом SM есть кэш инструкций первого уровня и связанные с ним ядра. Обычно SM использует свой кэш первого уровня (L1) и общий кэш второго уровня (L2), прежде чем обращаться к глобальной памяти GDDR-5 (или GDDR-6 в более новых моделях GPU). Архитектура GPU терпима к задержкам памяти.
В отличие от CPU, у GPU меньше уровней кэша и они относительно маленькие: больше транзисторов отдано под вычисления. GPU не так важно, сколько времени занимает выборка данных из памяти, если эта задержка (latency) скрыта за массово параллельными вычислениями.
GPU оптимизирован для вычислений с высокой пропускной способностью над параллельными данными. Одного взгляда на число ядер достаточно, чтобы понять, какой параллелизм ему доступен.
В этом и сила программирования GPU. Если использовать большое число ядер и при этом оптимизировать пересылку данных, приложение ускорится в разы.
(Примечание переводчика: у серверных GPU (A100, H100 и новее) вместо GDDR стоит память HBM с гораздо большей
пропускной способностью. Число SM у своей видеокарты можно узнать в PyTorch:
torch.cuda.get_device_properties(0).multi_processor_count — у RTX 4080 их 76.)
Развитие GPU NVIDIA
Заголовок раздела «Развитие GPU NVIDIA»Вариантов много: можно выбрать потребительские GPU, GPU для дата-центров или готовые рабочие станции.
(В оригинале — рисунок с тремя классами оборудования.)
Потребительские GPU
Заголовок раздела «Потребительские GPU»Потребительские GPU не подходят для крупных проектов глубокого обучения, но могут стать отправной точкой. Они позволяют недорого дополнить существующие системы и полезны для построения моделей или низкоуровневого тестирования.
Актуальная информация о видеокартах NVIDIA GeForce: https://www.nvidia.com/en-us/geforce/graphics-cards/
GPU для дата-центров
Заголовок раздела «GPU для дата-центров»GPU для дата-центров — стандарт для промышленного глубокого обучения. Они рассчитаны на крупные проекты и дают производительность корпоративного уровня.
Актуальная информация о решениях NVIDIA для дата-центров: https://www.nvidia.com/en-us/data-center/data-center-gpus/
Серверы DGX
Заголовок раздела «Серверы DGX»Серверы NVIDIA DGX — готовые решения корпоративного уровня «под ключ», от железа до программ. Эти системы спроектированы специально для машинного и глубокого обучения. Их достаточно подключить; развёртывать можно на «голом железе» или в контейнерах.
Актуальная информация о серверах NVIDIA DGX: https://www.nvidia.com/en-us/data-center/dgx-platform/
Типичные приложения, ускоряемые GPU
Заголовок раздела «Типичные приложения, ускоряемые GPU»GPU обычно применяют для:
- научного моделирования и симуляций;
- машинного обучения и нейросетей;
- глубокого обучения.
Научные вычисления
Заголовок раздела «Научные вычисления»GPU вместе с CPU быстро выполняют численно тяжёлые операции вроде научных симуляций и моделирования. Конструкция GPU традиционно нацелена на максимум блоков операций с плавающей точкой и на операции с многомерными массивами. GPU особенно хороши там, где полезны линейная алгебра и матричные операции. Это возможно благодаря тензорным ядрам (Tensor Cores) GPU — блокам, оптимизированным для умножения матриц.
Реализации на GPU есть для многих задач научных вычислений, включая молекулярное моделирование, гидродинамику, астрофизику и климатические симуляции.
Глубокое обучение
Заголовок раздела «Глубокое обучение»Нейросети учатся на огромных объёмах данных, пытаясь имитировать работу человеческого мозга. На этапе обучения нейросеть просматривает входные данные и сравнивает их с эталонными, чтобы научиться делать предсказания и прогнозы.
Поскольку нейросети в основном работают с огромными наборами данных, время обучения растёт вместе с размером набора. Небольшие нейросети можно обучать и на CPU, но с большими объёмами данных CPU справляются хуже, и с ростом числа слоёв и параметров время обучения увеличивается.
Нейросети — основа глубокого обучения (нейросеть с тремя слоями и более) — устроены так, чтобы работать параллельно: каждая задача выполняется независимо от других. Поэтому GPU лучше подходят для обработки огромных наборов данных и сложных математических вычислений, нужных для обучения нейросетей.
Глубокое обучение с массово-параллельными входами
Заголовок раздела «Глубокое обучение с массово-параллельными входами»После появления CUDA было разработано несколько фреймворков глубокого обучения, например PyTorch и TensorFlow. Они скрывают сложность прямого программирования на CUDA и сделали вычисления на GPU доступными для современного глубокого обучения.
Модель глубокого обучения — нейросеть с тремя слоями и более. У моделей глубокого обучения очень гибкие архитектуры, которые позволяют им учиться прямо на сырых данных. Обучение на больших наборах данных может повышать точность предсказаний.
Для глубокого обучения CPU менее эффективны, чем GPU, потому что обрабатывают задачи по порядку, по одной. Чем больше точек данных используется для входа и прогноза, тем труднее CPU управиться со всеми связанными задачами.
Глубокому обучению нужны большая скорость и высокая производительность, и модели учатся быстрее, когда все операции обрабатываются одновременно. Благодаря тысячам ядер GPU оптимизированы для обучения моделей глубокого обучения и могут обрабатывать множество параллельных задач до трёх раз быстрее CPU.
(Примечание переводчика: «до трёх раз» — очень осторожная оценка. На умножении больших матриц современный GPU с тензорными ядрами быстрее серверного CPU в десятки и сотни раз; поэтому LLM и обучают на GPU. Ваш собственный замер — в части 3 и в уроке «Как устроена видеокарта».)
Ресурсы
Заголовок раздела «Ресурсы»- Архитектуры GPU NVIDIA: https://www.nvidia.com/en-us/technologies/
- Процессоры NVIDIA с поддержкой CUDA: https://developer.nvidia.com/cuda-gpus
- Каталог ускоренных приложений NVIDIA: https://www.nvidia.com/en-us/accelerated-applications/
- Каталог приложений NVIDIA GPU Cloud: https://catalog.ngc.nvidia.com/
Глава 2. Краткое введение в CUDA
Заголовок раздела «Глава 2. Краткое введение в CUDA»В ноябре 2006 года NVIDIA® представила CUDA® (Compute Unified Device Architecture) — платформу параллельных вычислений общего назначения и модель программирования. Она использует параллельный вычислительный движок GPU NVIDIA, чтобы решать многие сложные вычислительные задачи эффективнее, чем на CPU.
Многие Python-разработчики могут пропустить эту главу, если пользуются высокоуровневым интерфейсом библиотек. Понятия из этой главы пригодятся, если вам когда-нибудь придётся писать свои функции-ядра или эффективно отображать свой алгоритм на архитектуру GPU.
Архитектура CUDA
Заголовок раздела «Архитектура CUDA»Чтобы выполнить функцию (её называют ядром, kernel) на GPU, в научном коде обычно нужны три главных шага:
- Скопировать входные данные из памяти CPU в память GPU.
- Загрузить и выполнить ядро на GPU.
- Скопировать результаты из памяти GPU в память CPU.
Как объяснялось в прошлой главе, архитектуры CPU и GPU различаются, и для них нужна разная парадигма программирования.
sequenceDiagram
participant CPU as CPU и его память (host)
participant GPU as GPU и его память (device)
CPU->>GPU: 1. Копируем входные данные
CPU->>GPU: 2. Запускаем ядро
Note over GPU: тысячи потоков<br/>выполняют ядро
GPU->>CPU: 3. Копируем результат
Модель программирования CUDA
Заголовок раздела «Модель программирования CUDA»CUDA работает по модели гетерогенных вычислений, в которой участвуют и CPU, и GPU.
Ядро CUDA — глобальная функция, которая выполняется на GPU. Параллельная часть вашего приложения выполняется K раз параллельно K разными потоками CUDA — в отличие от обычных последовательных функций на CPU, которые выполняются один раз.
Потоки и варпы
Заголовок раздела «Потоки и варпы»В CUDA ядро выполняется потоками (threads). Поток — абстрактная сущность, которая представляет выполнение ядра. Это наименьшая единица исполнения в CUDA, у каждого потока есть уникальный идентификатор (Thread ID).
Каждая группа из 32 последовательных потоков называется варпом (warp). Варп — основная единица исполнения в SM. Когда блок потоков назначается на SM, он дальше делится на набор варпов для исполнения. На блок потоков всегда приходится целое число варпов, и операции на GPU выполняются сразу для всего варпа.
Группа потоков называется блоком CUDA (block). Потоки блока могут взаимодействовать через разделяемую память и синхронизировать доступ к памяти по ходу исполнения. Блоки CUDA объединяются в сетку (grid). Ядро исполняется как сетка из блоков потоков. Все блоки массива выполняют одно и то же ядро, и параллельное исполнение масштабируется на все потоки.
Каждый блок CUDA исполняется одним потоковым мультипроцессором (SM) и не может переехать на другие SM этого GPU (кроме случаев вытеснения, отладки или динамического параллелизма CUDA). Один SM может выполнять несколько блоков CUDA одновременно — в зависимости от того, сколько ресурсов нужно блокам. Каждое ядро выполняется на одном устройстве, и CUDA позволяет запускать на устройстве несколько ядер одновременно.
flowchart LR
K["Ядро (kernel)"] --> G["Сетка (grid)"]
G --> B1["Блок 0"] & B2["Блок 1"] & B3["Блок …"]
B1 --> W1["Варп 0:<br/>потоки 0–31"] & W2["Варп 1:<br/>потоки 32–63"]
B1 -.->|"исполняется<br/>на одном"| SM["SM"]
Иерархическая структура этих компонентов не только помогает управлять исполнением потоков, но и отражает физическую архитектуру GPU с поддержкой CUDA. Потоки исполняются одновременно на нескольких потоковых мультипроцессорах (SM).
Управление памятью
Заголовок раздела «Управление памятью»Понимать иерархию памяти CUDA жизненно важно для оптимизации производительности программ на CUDA. На GPU есть несколько видов памяти, у каждого своя область видимости и свой кэш. Если использовать виды памяти так, чтобы эффективно задействовать разделяемую память, можно снизить задержку и повысить пропускную способность.
Основные виды:
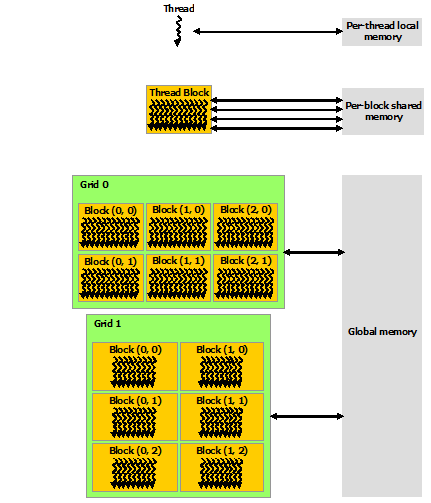
- Глобальная память (global memory) — доступна всем потокам.
- Разделяемая память / кэш L1 (shared memory) — общая для потоков одного блока.
- Локальная память (local) — личная для каждого потока, но физически часть глобальной памяти.
- Регистры (registers) — личные для каждого потока.
(В оригинале — рисунок с видами памяти.)
Есть и другие виды памяти, о которых стоит знать, но они, скорее всего, выходят за рамки создания ускоренных Python-приложений на высокоуровневых библиотеках.
- Константная память (constant memory) — кэшируемая память только для чтения, доступная всем потокам. У GPU NVIDIA разделяемая память, кэш L1 и кэш константной памяти находятся внутри потокового мультипроцессора. Поэтому они быстрее кэша L2 и оперативной памяти GPU.
- Текстуры (textures) — память только для чтения, оптимизированная для фильтрации, методов интерполяции и произвольного доступа всеми потоками.
Вид памяти влияет на производительность. Например, глобальная память большая, но может увеличивать задержку. Локальная память личная для каждого потока, но это часть глобальной памяти, поэтому доступ к ней тоже может быть долгим. Разделяемая память быстрее, но ограничена по размеру.
Для лучшей производительности данные должны лежать в том виде памяти, который ближе всего к месту их обработки и лучше всего подходит под шаблон доступа к ним. Данные, к которым часто обращаются или которые делят между собой потоки, по возможности нужно переносить в разделяемую память или хранить в регистрах. Это снижает накладные расходы на выборку данных из глобальной памяти.
flowchart TB
R["Регистры<br/>(свои у каждого потока)"] --> S["Разделяемая память / L1<br/>(общая в блоке, внутри SM)"]
S --> L2["Кэш L2<br/>(общий для всех SM)"]
L2 --> GM["Глобальная память GPU<br/>(видна всем потокам)"]
GM <-->|"PCIe"| HM["Память CPU (host)"]
Архитектура создаёт пул управляемой памяти (managed memory): каждый блок, выделенный из этого пула, доступен и на хосте, и на устройстве по одному и тому же адресу или указателю. Система сама переносит данные между хостом и устройством.
Умение эффективно передавать данные между CPU и GPU — ключ к высокой производительности приложений, ускоренных на GPU. Передача данных между CPU и GPU идёт по шине PCIe, и это может ограничивать скорость доступа к локальной памяти и на CPU, и на GPU.
Двигаемся дальше по-питоновски
Заголовок раздела «Двигаемся дальше по-питоновски»Эти виды выделения памяти приведены в главе для справки, но подробности исполнения ядер, потоков и управления памятью обычно скрыты во многих высокоуровневых пакетах CUDA Python. Сгенерированный шаблонный код и разумные значения по умолчанию дают производительный код без обращения к низкоуровневым функциям CUDA. Python-разработчики, которые не знакомы с C++, оценят и «питоничность» этих API.
Общее мнение таково: разработчику стоит брать библиотеку самого высокого уровня, доступную для его задачи, и лишь при необходимости спускаться к вариантам пониже. Большинство высокоуровневых пакетов дают доступ и к низкоуровневым функциям, так что этот путь у вас есть, если вызовы высокоуровневой библиотеки не дают нужной производительности.
Ресурсы
Заголовок раздела «Ресурсы»- Руководство по программированию CUDA C++: https://docs.nvidia.com/cuda/cuda-c-programming-guide/
- CUDA Toolkit: https://developer.nvidia.com/cuda-toolkit
- Форумы разработчиков NVIDIA CUDA: https://forums.developer.nvidia.com/c/accelerated-computing/cuda/206
Глава 3. Python на GPU
Заголовок раздела «Глава 3. Python на GPU»Компиляция и интерпретация
Заголовок раздела «Компиляция и интерпретация»Python — один из самых популярных языков программирования для науки, инженерии, анализа данных и глубокого обучения. Но как интерпретируемый язык он считался слишком медленным для высокопроизводительных вычислений.
У программ, скомпилированных в машинный код, есть преимущество в скорости перед интерпретируемыми языками: перед выполнением инструкций на процессоре не нужен промежуточный шаг.
Кроме того, потоки Python ведут себя не так, как потоки операционной системы, потому что в интерпретаторе одновременно может выполняться только один поток. Глобальная блокировка интерпретатора (GIL, Global Interpreter Lock), по сути, не даёт потокам работать параллельно, и потоки в Python ведут себя как на одноядерном CPU. Поэтому Python-программистам часто приходится добиваться параллелизма через конкурентные программы (например, несколько процессов), а не через многопоточность.
Многие внешние библиотеки Python написаны на других языках, например C или C++, чтобы пользоваться многопоточностью. Одна из них — NumPy, библиотека, на которой строятся численные вычисления в Python.
(Примечание переводчика: начиная с Python 3.13 есть экспериментальная сборка без GIL (free-threaded), но на момент перевода основная сборка Python по-прежнему с GIL.)
Экосистема научных библиотек Python
Заголовок раздела «Экосистема научных библиотек Python»NumPy в экосистеме научных вычислений на Python
Заголовок раздела «NumPy в экосистеме научных вычислений на Python»NumPy (сокращение от Numerical Python) появился в 2005 году в результате слияния библиотеки Numarray с Numeric.
С тех пор открытая библиотека NumPy стала незаменимой для научных вычислений на Python. Она — фундамент многих других
научных библиотек: SciPy, Scikit-learn, Pandas и других. Научное сообщество так ценит NumPy за удобный интерфейс Python
для эффективной работы с многомерными массивами; структуру данных «массив NumPy» называют также ndarray — сокращение
от n-dimensional array, «n-мерный массив».
NumPy в основном написан на C, а Python служит «языком-клеем». Но главная причина его эффективности в численных
вычислениях в том, что массивы NumPy занимают непрерывные блоки памяти, которые CPU умеет эффективно кэшировать.
Списки Python, напротив, — это массивы указателей на объекты, разбросанные по памяти в случайных местах; их трудно
кэшировать, и поиск в памяти обходится дороже. Но за вычислительную эффективность и малый расход памяти приходится
платить: массивы NumPy имеют фиксированный размер и однородны, то есть все элементы должны быть одного типа.
Однородность ndarray позволяет NumPy выполнять операции эффективным кодом на C и избегать дорогих проверок типов
и других накладных расходов API Python. Добавлять и удалять элементы в конце списка Python очень дёшево, а вот
менять размер массива NumPy очень дорого: для этого нужно создать новый массив и перенести в него содержимое старого,
который мы хотим увеличить или уменьшить.
Кроме того, что NumPy эффективнее обычного кода на Python для численных вычислений, он ещё и позволяет писать изящнее и понятнее благодаря векторизованным операциям и broadcasting (их мы разберём дальше).
(Примечание переводчика: векторизация и broadcasting подробно разобраны в уроке «Broadcasting и векторизация».)
(В оригинале — два рисунка: области, где используют NumPy, и экосистема научного Python, в центре которой NumPy.)
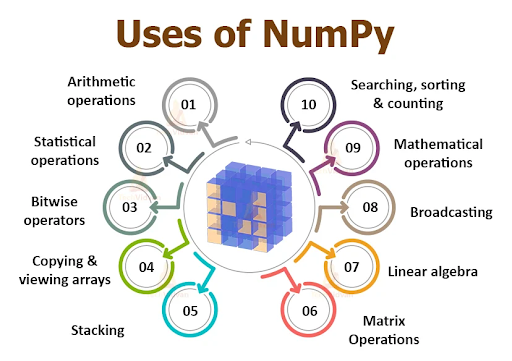
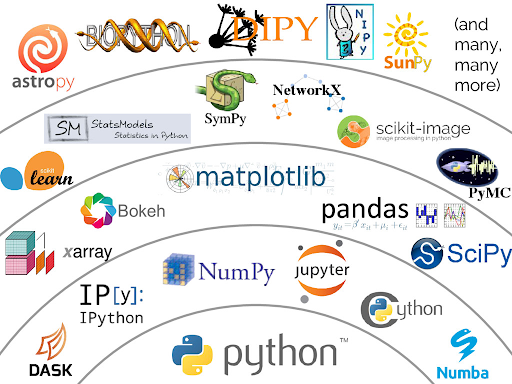
Сегодня NumPy — основа экосистемы научных вычислений на Python (см. numpy.org). Уже разрабатываются версии этих фундаментальных библиотек с ускорением на GPU, но возможность воспользоваться такими оптимизациями есть у всех научных библиотек.
CuPy в научных библиотеках Python
Заголовок раздела «CuPy в научных библиотеках Python»Класс cupy.ndarray — ядро библиотеки CuPy и замена классу numpy.ndarray из NumPy. Поэтому CuPy — отличная точка
входа в экосистему CUDA для Python, особенно для разработчиков научных библиотек, чьи программы зависят от NumPy.
Цель проекта CuPy — дать пользователям Python ускорение на GPU без глубокого знания нижележащих технологий GPU. Команда CuPy стремится обеспечить:
- полное покрытие API NumPy и SciPy, чтобы CuPy был полноценной заменой «один в один» (drop-in replacement), а также продвинутые возможности CUDA для максимальной производительности;
- зрелую и качественную библиотеку как фундаментальный пакет для всех проектов, которым нужно ускорение, — от лабораторного окружения до крупного кластера.
CuPy построен поверх CUDA и даёт более высокий уровень абстракции, поэтому код проще переносить между разными архитектурами GPU и версиями CUDA. Это значит, что код на CuPy может работать на разных системах с поддержкой CUDA без серьёзных изменений.
Под капотом CuPy использует библиотеки CUDA Toolkit — cuBLAS, cuRAND, cuSOLVER, cuSPARSE, cuFFT, cuDNN и NCCL, — чтобы в полной мере задействовать архитектуру GPU.
Ресурсы
Заголовок раздела «Ресурсы»- NumPy: https://numpy.org/
- CuPy: https://cupy.dev/
- Различия между NumPy и CuPy: https://docs.cupy.dev/en/stable/user_guide/difference.html
Дополнение: что такое GPU (урок 00 курса Accelerated Python)
Заголовок раздела «Дополнение: что такое GPU (урок 00 курса Accelerated Python)»Оригинал: tutorials/accelerated-python/notebooks/fundamentals/00__what_are_gpus.ipynb.
CPU — самый распространённый тип процессора, который выполняет ваш код. У CPU один или несколько последовательных процессоров, каждый из которых берёт по одной инструкции из стека и выполняет их последовательно.
GPU — разновидность сопроцессора. Их обычно используют для отрисовки видео и изображений, но они чрезвычайно популярны и в машинном обучении и науке о данных. У GPU один или несколько потоковых мультипроцессоров, которые принимают массивы инструкций и выполняют их параллельно.
(В оригинале — рисунок сравнения CPU и GPU.)
Что такое ядро?
Заголовок раздела «Что такое ядро?»Ядро (kernel) похоже на функцию: это блок кода, который принимает входные данные и выполняется процессором.
Отличия ядра от функции:
- ядро ничего не может вернуть — вместо этого оно должно изменить память;
- для ядра нужно указать иерархию потоков (потоки и блоки).
Что такое сетки, потоки и блоки (и варпы)?
Заголовок раздела «Что такое сетки, потоки и блоки (и варпы)?»Потоки и блоки — способ сказать GPU, чтобы он выполнял код параллельно. GPU — параллельный процессор, поэтому нужно указать, сколько раз мы хотим выполнить ядро.
У потоков есть преимущество — общая кэш-память между ними, но число ядер на GPU ограничено, поэтому работу нужно разбить на блоки, которые будут распланированы и выполнены на GPU параллельно.
(В оригинале — рисунок из руководства по программированию CUDA C++: сетка из блоков, блоки из потоков.)
Как же управлять GPU?
Заголовок раздела «Как же управлять GPU?»Выполнять код на GPU — это очень похоже на выполнение кода на втором компьютере по сети.
Если бы я хотел отправить программу на Python на другую машину и выполнить её там, мне понадобились бы:
- способ скопировать данные и код на удалённую машину (SCP, SFTP, SMB, NFS и т. д.);
- способ войти и запустить программы на удалённой машине (SSH, VNC, удалённый рабочий стол и т. д.).
Чтобы сделать то же самое с GPU, нужно использовать CUDA через шину PCI. Но идея та же: перенести данные и код на устройство и выполнить этот код.
(В оригинале — две схемы: «два компьютера в сети» и «компьютер и GPU, связанные через CUDA».)
Что такое CUDA?
Заголовок раздела «Что такое CUDA?»CUDA (Compute Unified Device Architecture) — платформа параллельных вычислений и модель программирования, созданная NVIDIA. Она позволяет разработчикам использовать GPU NVIDIA для вычислений общего назначения, а не только для графики, и задействовать массовый параллелизм GPU, чтобы значительно ускорять вычислительно тяжёлые приложения в искусственном интеллекте, научных симуляциях и анализе данных.
Что такое CUDA Python?
Заголовок раздела «Что такое CUDA Python?»CUDA Python — точка доступа к платформе CUDA из Python. Она состоит из нескольких компонентов:
- cuda.core — «питоничный» доступ к среде выполнения CUDA и другим базовым возможностям;
- cuda.bindings — низкоуровневые привязки Python к C API CUDA;
- cuda.pathfinder — утилиты, которые находят компоненты CUDA, установленные в окружении Python;
- cuda.coop — модуль Python с переиспользуемыми примитивами CCCL уровня блока и варпа для ядер Numba CUDA;
- cuda.compute — модуль Python для удобного доступа к высокоэффективным настраиваемым параллельным алгоритмам CCCL (сортировка, префиксная сумма, свёртка, преобразование и т. д.), которые вызываются с хоста;
- numba.cuda — цель компиляции Numba для программирования GPU на CUDA: ограниченное подмножество Python напрямую компилируется в ядра CUDA и функции устройства по модели исполнения CUDA;
- nvmath-python — «питоничный» доступ к математическим библиотекам NVIDIA для CPU и GPU, с API и для хоста,
и для устройства (через
nvmath.device). Также даёт низкоуровневые привязки Python к C API хоста (черезnvmath.bindings).
Словарик
Заголовок раздела «Словарик»| EN | RU |
|---|---|
| GPU, CPU | графический процессор, центральный процессор |
| host, device | хост (CPU и его память), устройство (GPU) |
| Streaming Multiprocessor (SM) | потоковый мультипроцессор |
| kernel | ядро (функция, исполняемая на GPU) |
| thread, warp, block, grid | поток, варп (32 потока), блок, сетка |
| SIMD / SIMT | одна инструкция — много данных / много потоков |
| global / shared / local memory | глобальная / разделяемая / локальная память |
| registers | регистры |
| latency, bandwidth, throughput | задержка, пропускная способность (памяти), производительность (пропускная способность вычислений) |
| Tensor Cores | тензорные ядра |
| managed memory | управляемая (унифицированная) память |
| Global Interpreter Lock (GIL) | глобальная блокировка интерпретатора |
| drop-in replacement | замена «один в один» |