How To Scale Your Model, глава 12: как думать о GPU
Перевод ядра двенадцатой главы книги Google DeepMind: устройство GPU (SM, тензорные ядра, CUDA-ядра, иерархия памяти), сравнение с TPU, сеть NVLink и InfiniBand, коллективные операции и roofline для параллелизма данных, тензорного, экспертного и конвейерного на GPU.
Мы в Google любим TPU, но и GPU — это здорово. Эта глава подробно разбирает GPU NVIDIA: как устроен каждый чип, как они связываются в сеть и что это значит для LLM, особенно в сравнении с TPU. — подзаголовок главы.
Что такое GPU?
Заголовок раздела «Что такое GPU?»Современный GPU для ML (например, H100, B200) — это, по сути, набор вычислительных ядер, специализированных на умножении матриц (их называют потоковыми мультипроцессорами, Streaming Multiprocessors, SM), подключённых к «планке» быстрой памяти (её называют HBM).
Рисунок в оригинале (gpu-diagram.png): абстрактная схема GPU H100 или B200. У H100 132 SM, у B200 — 148. Термином «планировщик варпов» (Warp Scheduler) авторы довольно широко называют набор из 32 SIMD-ядер CUDA и планировщик, который раздаёт им работу. Обратите внимание, насколько это похоже на TPU!
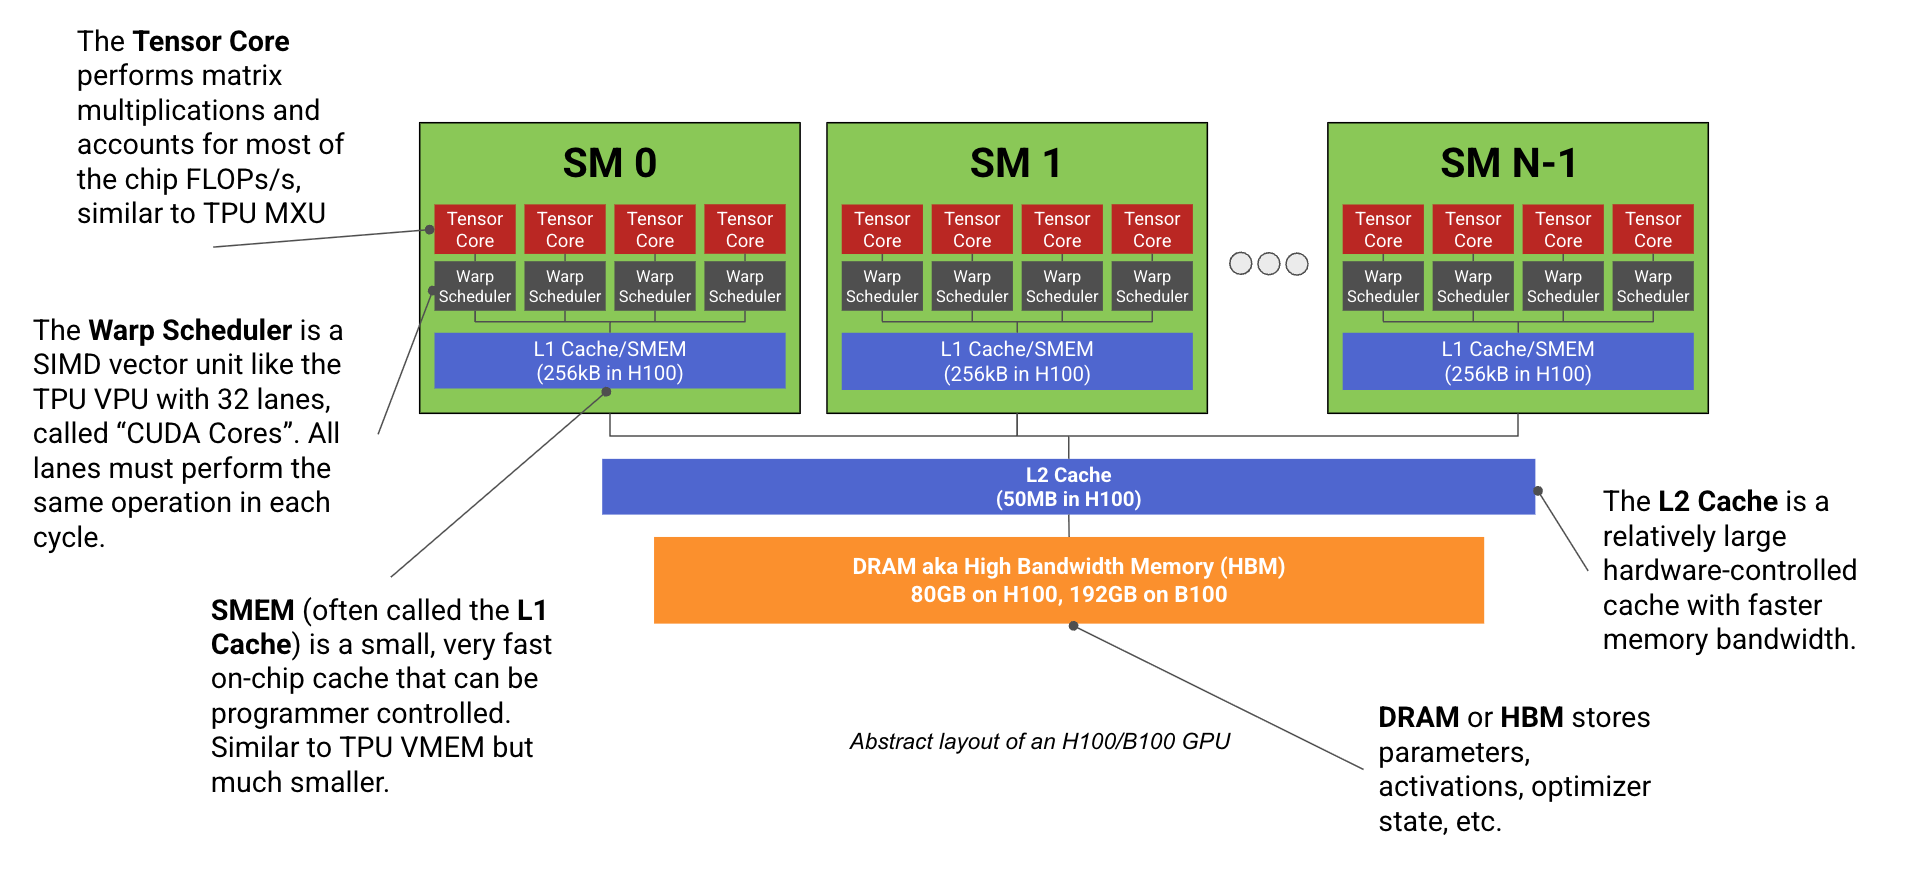
Каждый SM, как и TensorCore у TPU, имеет специальное ядро умножения матриц (к сожалению, тоже называемое тензорным ядром, Tensor Core1), векторный арифметический блок (его называют планировщиком варпов, Warp Scheduler2) и быстрый кэш на кристалле (его называют SMEM). В отличие от TPU, где не больше 2 независимых «TensorCore», у современного GPU больше 100 SM (132 у H100). Каждый из этих SM гораздо слабее TensorCore у TPU, но система в целом гибче. Каждый SM более-менее полностью независим, так что GPU может одновременно выполнять сотни отдельных задач3.
Рассмотрим SM у H100 подробнее.
Рисунок в оригинале (blackwell-sm.png): схема SM у H100 с 4 подразделами (subpartitions); в каждом — тензорное ядро, планировщик варпов, регистровый файл и наборы CUDA-ядер разной точности. «L1 Data Cache» внизу — это SMEM на 256 КБ. У B200 похоже, но добавлен заметный объём тензорной памяти (TMEM) для питания громоздких тензорных ядер.
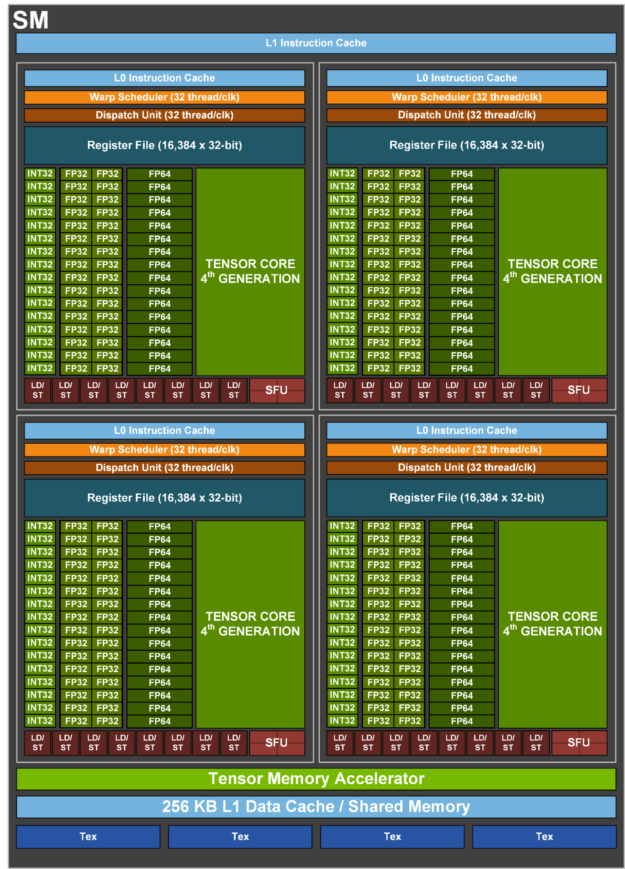
Каждый SM разбит на 4 одинаковые четверти, которые NVIDIA называет подразделами SM (SM subpartitions); в каждой — тензорное ядро, 16 тысяч 32-битных регистров и векторный арифметический блок SIMD/SIMT, называемый планировщиком варпов, дорожки (ALU) которого NVIDIA называет CUDA-ядрами. Главный компонент каждого подраздела — пожалуй, тензорное ядро: оно умножает матрицы и даёт подавляющую часть FLOPs/s, — но не единственный, о котором стоит знать.
- CUDA-ядра. В каждом подразделе есть набор ALU, называемых CUDA-ядрами, которые выполняют векторную арифметику SIMD/SIMT. Каждый ALU обычно выполняет 1 арифметическую операцию за такт, например f32.add4. В каждом подразделе 32 ядра fp32 (и меньшее число ядер int32 и fp64), и все они на каждом такте выполняют одну и ту же инструкцию. Как VPU у TPU, CUDA-ядра отвечают за ReLU, поточечные векторные операции и редукции (суммы)5.
- Тензорное ядро (TC). В каждом подразделе своё тензорное ядро — специальный блок умножения матриц, как MXU у TPU.
Тензорные ядра дают подавляющую часть FLOPs/s GPU (например, у H100 990 TFLOPs/s в bf16 на тензорных ядрах против всего
66 TFLOPs/s на CUDA-ядрах).
- 990 TFLOPs/s в bf16 при 132 SM на частоте 1,76 ГГц значит, что каждое
тензорное ядро H100 выполняет
7.5e12 / 1.76e9 / 4 ~ 1024FLOPs в bf16 за такт — примерно умножение 8×8×86. - Как и TPU, GPU умножают матрицы в пониженной точности быстрее (например, у H100 FLOPs/s в fp8 вдвое больше, чем в fp16). Обучение или обслуживание в пониженной точности может быть заметно быстрее.
- С поколения Volta каждое следующее поколение GPU увеличивало размер тензорного ядра (хорошая статья об этом). У B200 тензорное ядро стало настолько большим, что его входы больше не помещаются в SMEM, поэтому в B200 появилось новое пространство памяти — TMEM7.
- 990 TFLOPs/s в bf16 при 132 SM на частоте 1,76 ГГц значит, что каждое
тензорное ядро H100 выполняет
CUDA-ядра гибче, чем VPU у TPU. CUDA-ядра GPU (начиная с V100) используют модель программирования SIMT (Single Instruction Multiple Threads, «одна инструкция — много потоков»), а VPU у TPU — модель SIMD (Single Instruction Multiple Data, «одна инструкция — много данных»). Как и ALU в VPU у TPU, CUDA-ядра одного подраздела на каждом такте должны выполнять одну и ту же операцию (например, если одно ядро складывает два числа, то и все остальные CUDA-ядра подраздела должны это делать). Но, в отличие от VPU, у каждого CUDA-ядра (или «потока» в модели программирования CUDA) свой указатель инструкций, и его можно программировать независимо. Когда двум потокам одного варпа велено выполнять разные операции, фактически выполняются обе операции, а ядра, которым расходящаяся операция не нужна, маскируются.
Рисунок в оригинале (warp-divergence.png): пример расхождения варпа (warp divergence) в наборе потоков; белые промежутки — простои хотя бы части физических CUDA-ядер.
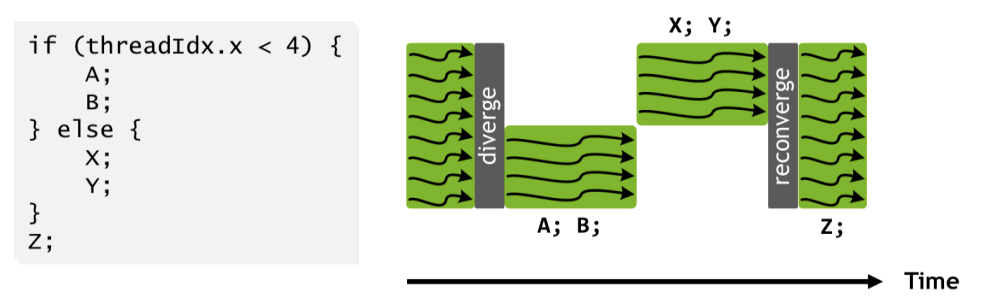
Это даёт гибкость программирования на уровне потоков, но ценой тихого падения производительности, если варпы расходятся слишком часто. Потоки также гибче в том, к какой памяти обращаться: VPU работает только с непрерывными блоками памяти, а CUDA-ядра могут обращаться к отдельным числам в общих регистрах и хранить собственное состояние каждого потока.
Планирование CUDA-ядер тоже гибче. SM работают отчасти как многопоточные процессоры в том смысле, что могут «планировать» много программ (варпов) одновременно (до 64 на SM), но каждый планировщик варпов на каждом такте выполняет только одну программу8. Планировщик варпов автоматически переключается между активными варпами, чтобы скрыть операции ввода-вывода, например загрузки из памяти. TPU по сравнению с этим, как правило, однопоточные.
Помимо вычислительных блоков, у GPU есть иерархия памяти: самая большая — HBM (основная память GPU), а дальше ряд меньших кэшей (L2, L1/SMEM, TMEM, регистры).
- Регистры. У каждого подраздела свой регистровый файл: 16 384 32-битных слова у H100/B200 (
4 * 16384 * 4 = 256kiBна SM), доступные CUDA-ядрам.- Каждое CUDA-ядро может одновременно обращаться не более чем к 256 регистрам, поэтому, хотя на SM можно запланировать
до 64 «резидентных варпов», при 256 регистрах на поток одновременно поместятся только 8
(
256 * 1024 / (4 * 32 * 256)).
- Каждое CUDA-ядро может одновременно обращаться не более чем к 256 регистрам, поэтому, хотя на SM можно запланировать
до 64 «резидентных варпов», при 256 регистрах на поток одновременно поместятся только 8
(
- SMEM (кэш L1). У каждого SM свой кэш на кристалле объёмом 256 КБ — SMEM; программист может управлять им как «общей памятью» (shared memory), или железо использует его как кэш. В SMEM хранятся активации и входы для умножений на тензорных ядрах.
- Кэш L2. Все SM делят9 сравнительно большой кэш L2 на ~50 МБ, который сокращает обращения к основной памяти.
- По размеру он похож на VMEM у TPU, но гораздо медленнее и не управляется программистом. Получается своего рода «жуткое дальнодействие»: программисту приходится менять порядок обращений к памяти, чтобы кэш L2 использовался хорошо10.
- NVIDIA не публикует пропускную способность L2 своих чипов, но замеры дают около 5,5 ТБ/с. Это примерно в 1,6 раза больше пропускной способности HBM, но канал полнодуплексный, так что эффективная двусторонняя пропускная способность ближе к трёхкратной. Для сравнения: VMEM у TPU вдвое больше и гораздо быстрее (около 40 ТБ/с).
- HBM — основная память GPU, где хранятся веса модели, градиенты, активации и т. д.
- Объём HBM сильно вырос: с 32 ГБ у Volta до 192 ГБ у Blackwell (B200).
- Пропускную способность от HBM к тензорным ядрам называют пропускной способностью HBM или памяти; у H100 это около 3,35 ТБ/с, у B200 — 9 ТБ/с.
Сводка характеристик GPU
Заголовок раздела «Сводка характеристик GPU»Вот сводка характеристик последних моделей GPU. Число SM, тактовая частота и FLOPs немного различаются между вариантами одного GPU. Сначала объёмы памяти:
| GPU | Поколение | Тактовая частота | SM на чип | SMEM на SM | L2 на чип | HBM на чип |
|---|---|---|---|---|---|---|
| V100 | Volta | 1,25/1,38 ГГц | 80 | 96 КБ | 6 МБ | 32 ГБ |
| A100 | Ampere | 1,10/1,41 ГГц | 108 | 192 КБ | 40 МБ | 80 ГБ |
| H100 | Hopper | 1,59/1,98 ГГц | 132 | 256 КБ | 50 МБ | 80 ГБ |
| H200 | Hopper | 1,59/1,98 ГГц | 132 | 256 КБ | 50 МБ | 141 ГБ |
| B200 | Blackwell | ? | 148 | 256 КБ | 126 МБ | 192 ГБ |
У всех поколений по 256 КБ регистров на SM. Blackwell добавляет ещё 256 КБ TMEM на SM. Теперь FLOPs и пропускные способности:
| GPU | Поколение | HBM, байт/с на чип | FLOPs/s на чип (bf16/fp16) | FLOPs/s на чип (fp8/int8) | FLOPs/s на чип (fp4) |
|---|---|---|---|---|---|
| V100 | Volta | 9.0e11 | — | — | — |
| A100 | Ampere | 2.0e12 | 3.1e14 | 6.2e14 | — |
| H100 | Hopper | 3.4e12 | 9.9e14 | 2.0e15 | — |
| H200 | Hopper | 4.8e12 | 9.9e14 | 2.0e15 | — |
| B200 | Blackwell | 8.0e12 | 2.3e15 | 4.5e15 | 9.0e15 |
B100 мы не включаем: в массовое производство он не пошёл11. Некоторые характеристики немного зависят от точной версии GPU: GPU NVIDIA не так стандартизованы, как TPU.
Удобная шпаргалка соответствия компонентов GPU и TPU:
| GPU | TPU | Что это? |
|---|---|---|
| потоковый мультипроцессор (SM) | TensorCore | основная «ячейка», содержащая остальные блоки |
| планировщик варпов | VPU | векторный арифметический блок SIMD |
| CUDA-ядро | ALU в VPU | SIMD ALU |
| SMEM (кэш L1) | VMEM | быстрая кэш-память на кристалле |
| тензорное ядро | MXU | блок умножения матриц |
| HBM (она же GMEM) | HBM | память с большой пропускной способностью и объёмом |
GPU и TPU на уровне чипа
Заголовок раздела «GPU и TPU на уровне чипа»GPU начинались как устройства для отрисовки видеоигр, но с тех пор как в 2010-х взлетело глубокое обучение, они всё больше ведут себя как специализированные машины для умножения матриц — то есть всё больше похожи на TPU12. Отчасти эта история объясняет, почему современные GPU выглядят именно так. Их проектировали не только под LLM или ML-модели, а как универсальные ускорители, и железо стремится к «универсальности», которая может быть и благом, и проклятием. GPU гораздо чаще «просто работают» на новых задачах и гораздо меньше зависят от хорошего компилятора, чем TPU. Но из-за этого о них гораздо труднее рассуждать и труднее добиться от них производительности на уровне roofline: очень многие особенности компилятора могут создать узкие места.
GPU модульнее. У TPU 1–2 больших TensorCore, а у GPU — сотни маленьких SM. Точно так же у каждого TensorCore один большой VPU из 4 независимо программируемых блоков 8×128 (всего 4096 ALU), а у H100 132 × 4 = 528 независимых SIMD-блоков шириной 32 (всего 16 тысяч ALU). Вот сравнение GPU и TPU один к одному, которое это подчёркивает:
| GPU | TPU | Число у H100 | Число у TPU v5p |
|---|---|---|---|
| SM (потоковый мультипроцессор) | TensorCore | 132 | 2 |
| планировщик варпов | слоты VPU | 528 | 8 |
| SMEM (кэш L1) | VMEM | 32 МБ | 128 МБ |
| регистры | векторные регистры (VREG) | 32 МБ | 256 КБ |
| тензорное ядро | MXU | 528 | 8 |
Такая разница в модульности, с одной стороны, делает TPU гораздо дешевле в производстве и проще для понимания, но, с другой, перекладывает больше ответственности на компилятор. У TPU один поток управления и только векторные инструкции шириной во весь VPU, поэтому компилятор должен вручную конвейеризовать все загрузки из памяти и работу MXU/VPU, чтобы не было простоев. Программист GPU может просто запустить десятки разных ядер (kernels), каждое на совершенно независимом SM. Зато эти ядра могут работать ужасно медленно, потому что «перемалывают» кэш L2 или не объединяют загрузки из памяти; поскольку железо само управляет столь многим во время выполнения, трудно понять, что происходит за кулисами. В итоге TPU часто приближаются к пиковой производительности roofline с меньшими усилиями.
Исторически отдельный GPU мощнее (и дороже) сравнимого TPU. Один H200 даёт почти вдвое больше FLOPs/s, чем TPU v5p, и в 1,5 раза больше HBM. При этом в Google Cloud H200 стоит около 10 долл. в час, а TPU v5p — около 4 долл. в час. TPU в целом сильнее полагаются на объединение многих чипов в сеть, чем GPU.
У TPU гораздо больше быстрой кэш-памяти. VMEM у TPU гораздо больше, чем SMEM (+TMEM) у GPU, и эту память можно использовать для хранения весов и активаций так, чтобы загружать и использовать их очень быстро. Это может сделать TPU быстрее в инференсе LLM, если удаётся постоянно хранить веса модели в VMEM или заранее предзагружать их туда.
Задачи: железо GPU (выборочно)
Заголовок раздела «Задачи: железо GPU (выборочно)»Вопрос 3 [интенсивность матмула на GPU]. Какова пиковая интенсивность умножения матриц в fp16 у H100? У B200? А в fp8? Под интенсивностью понимаем отношение FLOPs/s умножения матриц к пропускной способности памяти.
Ответ
У H100 пик — 990e12 FLOPs в fp16 и 3,35e12 байт/с пропускной способности. Значит, критическая интенсивность —
990e12 / 3.35e12 = 295, довольно близко к 240 у TPU. У B200 — 2250e12 / 8e12 = 281, очень похоже. Значит, как и на
TPU, чтобы умножение матриц упиралось в вычисления, нужен батч около 280 токенов.
И у H100, и у B200 FLOPs в fp8 ровно вдвое больше, поэтому пиковая интенсивность тоже удваивается — до 590 и 562 соответственно, хотя в каком-то смысле она остаётся прежней, если учесть, что веса, скорее всего, тоже будут загружаться в fp8.
Вопрос 4 [время умножения матриц]. По ответу на вопрос 3 оцените, сколько займёт умножение
fp16[64, 4096] * fp16[4096, 8192] на одном B200. А fp16[512, 4096] * fp16[4096, 8192]?
Ответ
Из сказанного выше мы знаем, что при батче меньше 281 токена упираемся в связь. Значит, первое умножение целиком
ограничено пропускной способностью. Мы читаем или пишем байт
(2*64*4096 + 2*4096*8192 + 2*64*8192=69e6) при 8e12 байт/с, так что это займёт около 69e6 / 8e12 = 8.6us. На практике
мы, скорее всего, получим лишь часть пропускной способности, так что может выйти ближе к 10–12 мкс. С ростом батча мы
полностью упираемся в вычисления и ожидаем T=2*512*4096*8192/2.3e15=15us. И снова мы ожидаем лишь часть FLOPs, так что
может выйти ближе к 20 мкс.
Вопрос 7 [время сложения на H100]. По числам выше посчитайте, сколько должно занимать сложение двух векторов
fp32[N] на одном H100. Посчитайте и , и . Какова арифметическая интенсивность этой
операции? Если есть доступ, попробуйте выполнить её в PyTorch или JAX для N = 1024 и N=1024 * 1024 * 1024. Как это
соотносится с расчётом?
Ответ
Сложение двух векторов fp32[N] — это N FLOPs, при этом нужно загрузить 4 * N * 2 байт и записать обратно 4 * N байт,
всего 3 * 4 * N = 12N. Отношение: всего FLOPs / всего байт = N / 12N = 1 / 12 — совсем плохо.
Как мы посчитали выше, без учёта FMA можно выполнять примерно 33,5 TFLOPs/s с ускорением частоты. Это — если задействованы
все CUDA-ядра. При N = 1024 можно задействовать не больше 1024 CUDA-ядер, или 8 SM, что займёт больше времени
(примерно в 16 раз, если упираемся в вычисления). Пропускная способность памяти — 3,35e12 байт/с. Значит, пиковая
интенсивность железа — 33.5e12 / 3.35e12 = 1013. Так что мы безнадёжно упрёмся в связь, и время — просто
Для N = 65,536 это около 0,23 мкс. На практике в JAX выходит около 1,5 мкс, и это нормально: здесь мы, ожидаемо, сильно
упираемся в задержку. Для N = 1024 * 1024 * 1024 roofline даёт около 3,84 мс, а на деле — 4,1 мс. Отлично!
Сеть — одна из областей, где GPU и TPU различаются сильнее всего. Как мы видели, TPU соединены в двумерные или трёхмерные торы, где каждый TPU связан только с соседями. Значит, сообщение между двумя TPU должно пройти через все промежуточные TPU, и мы вынуждены использовать по сетке только однородные схемы обмена. В чём-то это неудобно, но зато число каналов на TPU постоянно, и можно масштабироваться до сколь угодно больших «подов» TPU без потери пропускной способности.
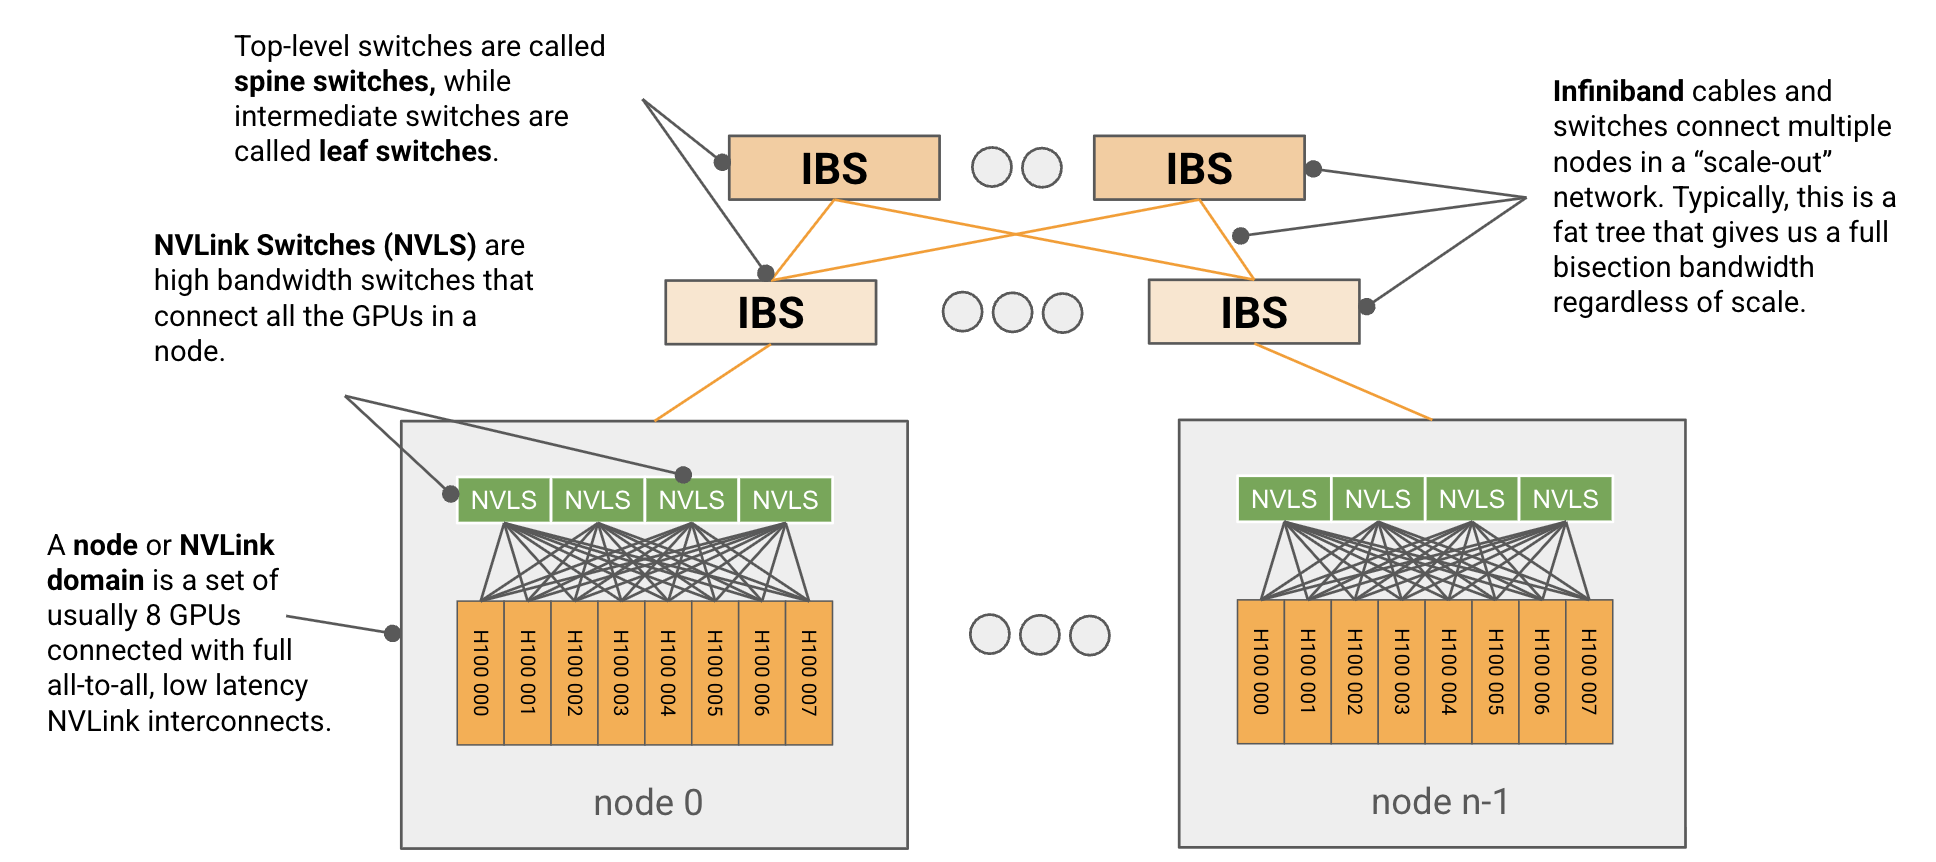
GPU же используют более традиционную иерархическую древовидную коммутируемую сеть. Наборы из 8 GPU, называемые узлами (nodes; до 72 у GB20014), соединены друг с другом за 1 переход с помощью быстрых межсоединений NVLink, а эти узлы соединяются в более крупные блоки (SU, Scalable Units, «масштабируемые блоки») более медленной сетью InfiniBand (IB) или Ethernet через сетевые карты (NIC), подключённые к каждому GPU. Их, в свою очередь, можно объединять в сколь угодно большие блоки коммутаторами более высокого уровня.
Рисунок в оригинале (superpod-diagram.png): типичная сеть H100. Набор из 8 GPU соединён в узел, или домен NVLink, коммутаторами NVSwitch (их также называют коммутаторами NVLink), а узлы соединены коммутируемой сетью InfiniBand. У H100 около 450 ГБ/с исходящей пропускной способности на GPU внутри домена NVLink, а у каждого узла — 400 ГБ/с исходящей пропускной способности в сеть IB.
На уровне узла
Заголовок раздела «На уровне узла»Узел GPU — небольшой блок, обычно из 8 GPU (до 72 у GB200), соединённых «каждый с каждым» межсоединениями NVLink с полной
пропускной способностью и низкой задержкой15. В каждом узле несколько быстрых коммутаторов NVSwitch, которые
передают пакеты между всеми локальными GPU. Реальная топология узла со временем сильно менялась, включая число
коммутаторов на узел, но у H100 на узел 4 NVSwitch, а GPU подключены к ним по схеме 5 + 4 + 4 + 5 каналов.
Рисунок в оригинале (nvlink-nodes.png): схемы узлов (доменов NVLink) начиная с Pascal (P100). С Volta (V100) внутри узла есть связность «каждый с каждым» через набор коммутаторов. В узле H100 4 NVSwitch подключены ко всем 8 GPU каналами по 25 ГБ/с.
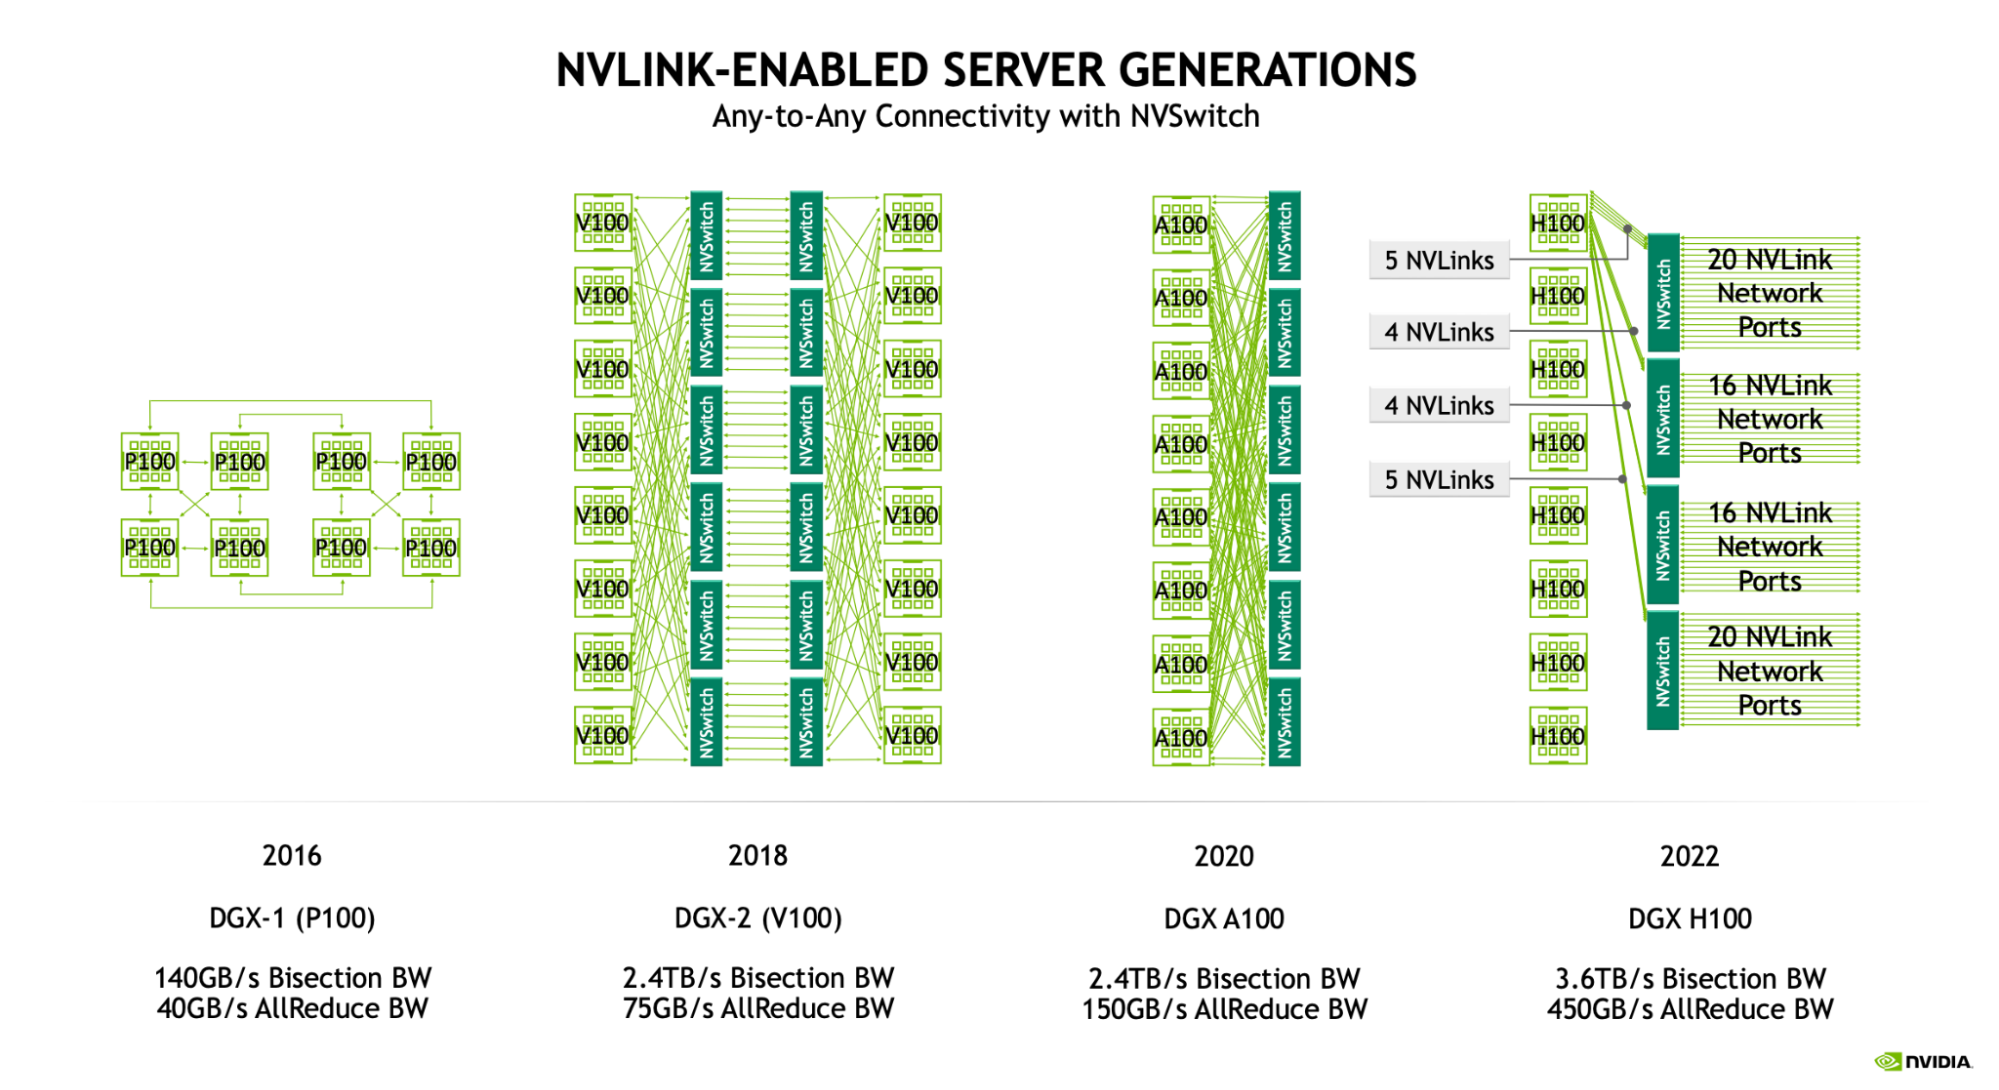
В поколении Hopper (NVLink 4.0) каждый канал NVLink даёт 25 ГБ/с в полнодуплексном режиме16 (50 ГБ/с у B200), что
даёт 18 * 25=450GB/s полнодуплексной пропускной способности от каждого GPU в сеть. У огромных NVSwitch до 64 портов
NVLink, так что узел 8×H100 с 4 коммутаторами может пропустить до 64 * 25e9 * 4=6.4TB/s. Вот как эти числа менялись
от поколения к поколению:
| Поколение NVLink | Поколение NVSwitch | Поколение GPU | Пропускная способность NVLink (ГБ/с, полный дуплекс) | Портов NVLink на GPU | GPU ↔ GPU в узле (ГБ/с, полный дуплекс) | Размер узла (домен NVLink) | NVSwitch на узел |
|---|---|---|---|---|---|---|---|
| 3.0 | 2.0 | Ampere | 25 | 12 | 300 | 8 | 6 |
| 4.0 | 3.0 | Hopper | 25 | 18 | 450 | 8 | 4 |
| 5.0 | 4.0 | Blackwell | 50 | 18 | 900 | 8/72 | 2/18 |
У Blackwell (B200) узлы по 8 GPU. GB200 NVL72 поддерживает большие домены NVLink — на 72 GPU. В таблице приведены данные для обеих систем — на 8 и на 72 GPU.
Вопрос [стоимость AllGather]. Сколько займёт AllGather (ограниченный пропускной способностью) массива из B байт
на узле 8×H100? Посчитайте для bf16[DX, F], где D=4096, F=65,536. Перед ответом стоит прочитать раздел
о коллективных операциях TPU в главе 3.
Ответ
Каждый GPU отправляет 450 ГБ/с, и у каждого GPU байт (где N=8 — размер узла). Можно представить, что каждый узел
по очереди отправляет свои байты каждому из остальных узлов; всего получается раундов, каждый —
, то есть .
Это примерно , или .
Для данного массива B = 4096 * 65536 * 2 = 536e6 байт, так что общее время — 536e6 * (8 - 1) / (8 * 450e9) = 1.04ms
(или 536e6 / 450e9 = 1.19ms в приближении). Операция может упираться в задержку, так что на практике она может занять
больше (на деле — около 1,5 мс).
За пределами узла (в сокращении)
Заголовок раздела «За пределами узла (в сокращении)»Пересказ раздела «Beyond the node level» с переводом выводов.
За пределами узла топология сети GPU менее стандартизована. NVIDIA публикует эталонную архитектуру DGX SuperPod: 1024 GPU H100 — это 128 узлов по 8 GPU, у каждого GPU своя сетевая карта InfiniBand на 400 Гбит/с. Узлы группами по 32 (256 GPU) подключены к 8 «листовым» (leaf) коммутаторам IB — такая группа называется Scalable Unit (SU); четыре SU соединены 16 «хребтовыми» (spine) коммутаторами. Такая сеть — толстое дерево (fat tree): кабели и коммутаторы подобраны так, чтобы над уровнем узла была полная бисекционная пропускная способность — 400 ГБ/с на узел. Значит, если разделить узлы пополам, каждый узел может одновременно отправлять 400 ГБ/с узлу из другой половины, и пропускная способность AllReduce в масштабирующей сети (scale-out network) примерно постоянна, сколько бы узлов ни участвовало. Заказчики вправе менять эту схему: например, Meta обучала LLaMA-3 на сети Ethernet с трёхуровневой коммутацией и переподпиской на верхнем уровне.
| Уровень | GPU | Коммутаторов на блок | Тип | Пропускная способность блока (ТБ/с) | GPU ↔ GPU (ГБ/с) | Толстое дерево (ГБ/с) |
|---|---|---|---|---|---|---|
| Узел | 8 | 4 | NVLink | 3,6 | 450 | 450 |
| Лист | 256 | 8 | IB | 12,8 | 50 | 400 |
| Хребет | 1024 | 16 | IB | 51,2 | 50 | 400 |
Для сравнения: у TPU v5p около 90 ГБ/с исходящей пропускной способности на канал, или 540 ГБ/с по всем осям трёхмерного тора. Это не соединение «точка-точка», так что его можно использовать только для ограниченных однородных схем обмена, но оно даёт гораздо большую пропускную способность TPU ↔ TPU и масштабируется до сколь угодно больших топологий (по крайней мере до 8960 TPU).
GB200 NVL72. Новые кластеры NVIDIA GB200 NVL72 объединяют 72 GPU в одном домене NVLink с полными 900 ГБ/с между GPU, а исходящая пропускная способность узла в листовой уровень — 3,6 ТБ/с, в 9 раз больше, чем у H100 (ровно во столько же раз в узле больше GPU). Из-за этого критическая исходящая пропускная способность узла намного выше, и пропускная способность коллективных операций между узлами может оказаться даже ниже, чем внутри узла.
| Тип узла | GPU на узел | Исходящая пропускная способность GPU | Исходящая пропускная способность узла |
|---|---|---|---|
| H100 | 8 | 450e9 | 400e9 |
| B200 | 8 | 900e9 | 400e9 |
| GB200 NVL72 | 72 | 900e9 | 3600e9 |
Как работают коллективные операции на GPU
Заголовок раздела «Как работают коллективные операции на GPU»GPU умеют выполнять те же коллективные операции, что и TPU: ReduceScatter, AllGather, AllReduce и AllToAll. В отличие от TPU, то, как они работают, зависит от того, выполняются ли они на уровне узла (по NVLink) или выше (по InfiniBand). Эти операции NVIDIA реализует в библиотеках NVSHMEM и NCCL (произносится «никель»); NCCL открыта здесь. NCCL использует разные реализации в зависимости от требований к задержке и топологии (подробности), но дальше мы будем обсуждать теоретически оптимальную модель для коммутируемой древовидной сети.
Коллективные операции внутри узла
Заголовок раздела «Коллективные операции внутри узла»AllGather или ReduceScatter. AllGather или ReduceScatter на уровне узла можно выполнить по кольцу, как на TPU, используя на каждом переходе полную пропускную способность GPU ↔ GPU. Упорядочите GPU произвольно и передавайте часть массива по кольцу с полной пропускной способностью17. Стоимость каждого перехода — , так что общая стоимость
Заметьте: это ровно то же, что на TPU. AllReduce, как обычно, можно сложить из RS + AG — вдвое дороже.
Анимация в оригинале (all-gather.gif): оптимальный по пропускной способности кольцевой AllGather. Для B байт он отправляет B / X байт через коммутаторы верхнего уровня X − 1 раз.
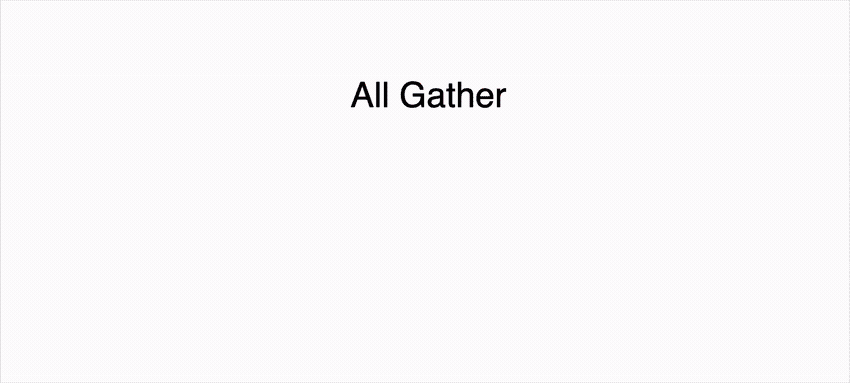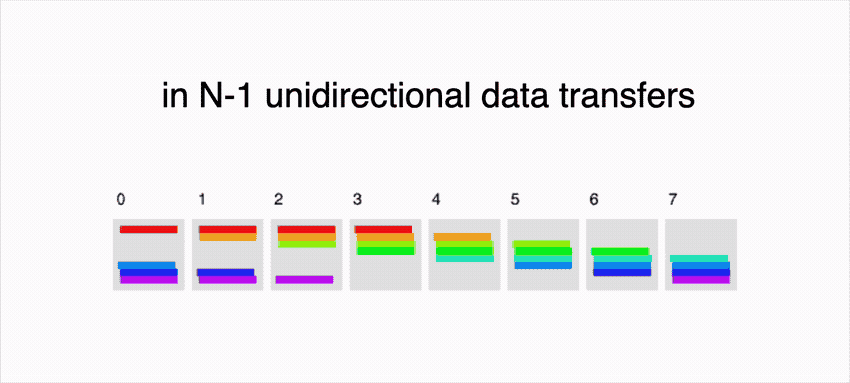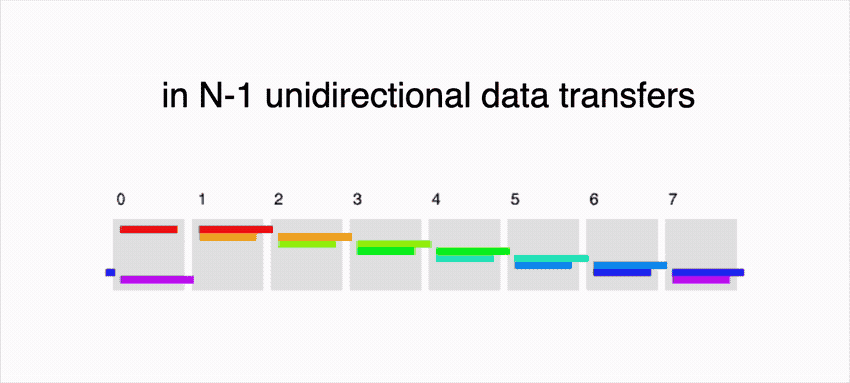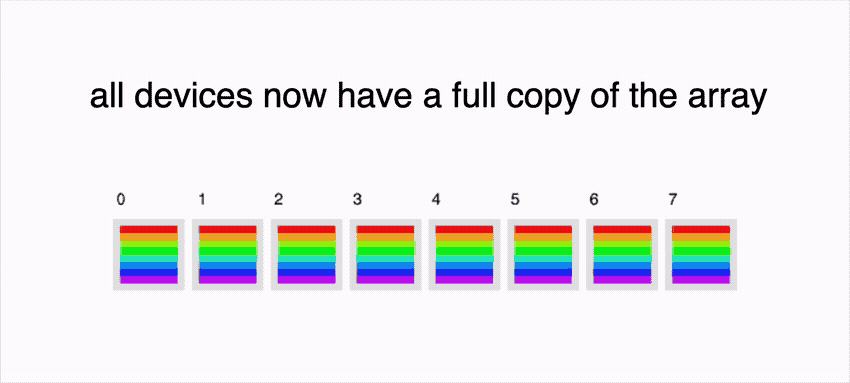
Если вас беспокоит задержка (например, массив очень маленький), можно выполнить редукцию деревом: AllReduce в парах, затем в четвёрках, затем в восьмёрках — всего переходов вместо , хотя общая стоимость остаётся той же.
Быстрый вопрос 1 [время AllGather]. Сколько займёт AllGather(bf16[BX, F]) на узле 8×H100 с полнодуплексной пропускной способностью 450 ГБ/с? Пусть , .
Ответ
Всего байт при односторонней пропускной способности 450e9. Это займёт примерно , а точнее . По данным значениям выходит примерно мкс, а точнее — 65 мкс.
AllToAll. У GPU внутри узла связность «каждый с каждым», поэтому AllToAll выполняется, ну, довольно просто. Каждый GPU просто отправляет данные прямо в пункт назначения. Внутри узла для B байт у каждого GPU байт, и он отправляет по байт получателям, всего
Сравните с TPU, где стоимость . То есть внутри одного узла получаем теоретическое ускорение в 2 раза ( против ).
Для моделей со смесью экспертов (MoE) часто нужен разреженный (ragged) AllToAll, где гарантированно не больше из шардов по выходному измерению ненулевые. Его стоимость уменьшается в раз — всего около . В MoE ненулевые значения часто выбираются независимо и случайно, так что есть шанс, что ненулевых окажется меньше , и получается примерно .
Замеры на практике. Замер пропускной способности AllReduce на узле 8×H100 (рисунок в оригинале) показывает: «шинная» пропускная способность (Bus BW, — теоретически мера реальной пропускной способности каналов) достигает почти 370 ГБ/с — меньше 450 ГБ/с, но довольно близко, — однако только при сообщениях около 10 ГБ на устройство. То есть оценки теоретически верны, но, чтобы их достичь, нужны большие сообщения.
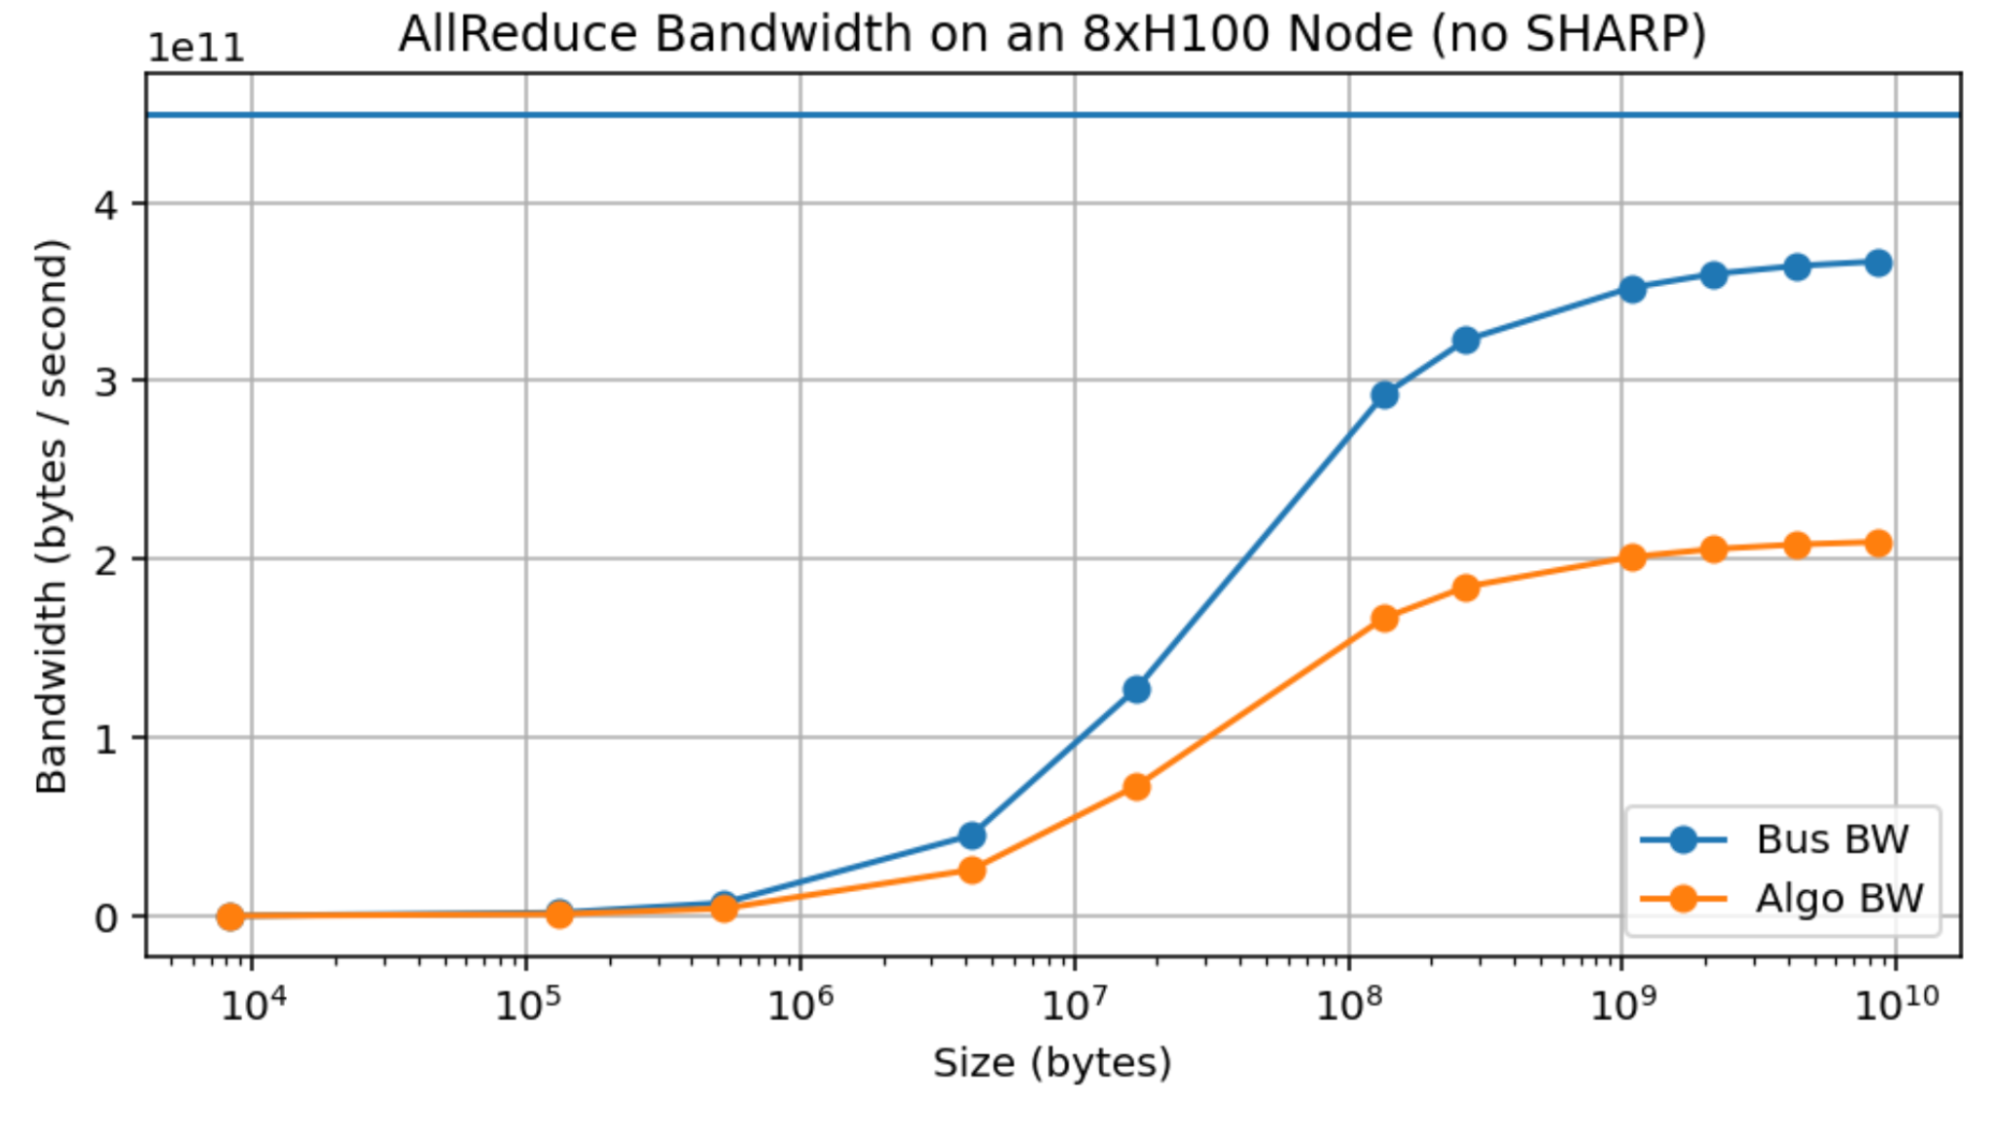
Это серьёзная проблема: она заметно усложняет любые теоретические утверждения. Например, даже AllReduce массива разумного
размера — скажем, MLP у LLaMA-3 70B (размера bf16[8192, 28672], или при 8-путевом шардировании модели
bf16[8192, 3584] = 58MB) — достигает лишь около 150 ГБ/с против пиковых 450 ГБ/с. TPU, для сравнения, выходят на пиковую
пропускную способность при гораздо меньших сообщениях.
Редукции в сети. С поколения Hopper коммутаторы NVIDIA поддерживают SHARP (Scalable Hierarchical Aggregation and Reduction Protocol) — «редукции в сети»: сами коммутаторы выполняют редукцию и рассылают результат нескольким GPU. Теоретически это почти вдвое удешевляет AllReduce ( вместо удвоенного), но на практике прирост пропускной способности около 30%, а не ожидаемые 75%, — примерно до 480 ГБ/с эффективной пропускной способности коллективной операции.
Коллективные операции между узлами (в сокращении)
Заголовок раздела «Коллективные операции между узлами (в сокращении)»Пересказ раздела «Cross-node collectives» с переводом выводов.
За пределами узла редукцию по дереву можно представлять снизу вверх: сначала внутри узла, затем на листовом уровне, затем на хребтовом, каждый раз обычным алгоритмом. Для AllReduce это значит, что после AllReduce внутри узла наверх нужно отправить лишь байт, а не . В первом приближении, благодаря полной бисекционной пропускной способности, AllGather или ReduceScatter стоит примерно размер буфера, делённый на исходящую пропускную способность узла, независимо от деталей древовидной редукции:
Проще всего представить кольцевую редукцию по всем узлам кластера: благодаря толстому дереву между любыми двумя узлами можно построить кольцо с пропускной способностью . Редукция на уровне узла почти никогда не узкое место, но в общем случае
(Точный расчёт по уровням дерева для эталонного SuperPod даёт 514 ГБ/с на уровне узла, 413 ГБ/с на листовом и 17,1 ТБ/с на хребтовом, итого ~413 ГБ/с.) AllReduce по-прежнему вдвое дороже, если нет SHARP. А вот AllToAll между узлами дорожает сильно: он не «иерархический», и бисекционную пропускную способность узла использовать не получается. Для N-путевого AllToAll на узлах
то есть фактически 50 ГБ/с вместо 400: от внутри одного узла H100 к на двух узлах — ухудшение больше чем вчетверо.
| Уровень | Число GPU | Степень (число потомков) | Пропускная способность коммутаторов (ТБ/с) | Пропускная способность кабелей (ТБ/с) | Пропускная способность коллективных операций (ГБ/с) |
|---|---|---|---|---|---|
| Узел | 8 | 8 | 6,4 | 3,6 | 450 |
| Лист (SU) | 256 | 32 | 25,6 | 12,8 | 400 |
| Хребет | 1024 | 4 | 51,2 | 51,2 | 400 |
«Пропускная способность коллективных операций» — эффективная пропускная способность, с которой можно отправлять данные из GPU или из узла; она же равна .
Редукции массива, шардированного по другой оси. Если массив, по которому делается AllReduce по оси , сам шардирован по другой оси , то на TPU стоимость падает в раз. На GPU — только если внутренняя ось охватывает несколько узлов:
Roofline для масштабирования LLM на GPU
Заголовок раздела «Roofline для масштабирования LLM на GPU»Теперь посмотрим, к чему всё это вело: поймём roofline для масштабирования LLM на GPU. Это дополнение к главе об обучении на TPU (глава 5). Как и там, цель — посмотреть на общие и для разных стратегий параллелизма и понять, в какой момент . Как и раньше, рассматриваем только блок MLP с операциями
где — глобальный размер батча в токенах (то есть ).
Повторим таблицу эффективных пропускных способностей на уровне GPU и узла:
| Тип узла | GPU на узел | Исходящая пропускная способность GPU | Исходящая пропускная способность узла |
|---|---|---|---|
| H100 | 8 | 450e9 | 400e9 |
| B200 | 8 | 900e9 | 400e9 |
| GB200 NVL72 | 72 | 900e9 | 3600e9 |
Замечание: roofline наших LLM определяют обе пропускные способности — и GPU, и узла. Через будем обозначать пропускную способность GPU или узла — в зависимости от того, работаем мы внутри узла или выше.
Рассмотрим roofline «вычисления — связь», как делали для TPU, для параллелизма данных, тензорного, конвейерного и экспертного параллелизма и их сочетаний. До конца раздела в конкретных расчётах ориентируемся на H100 (обозначим его пиковые FLOPs/s через ). У GB200-NVL72 roofline в целом те же, но из-за большей исходящей пропускной способности узла узким местом иногда может стать уровень узла.
Параллелизм данных
Заголовок раздела «Параллелизм данных»Как отмечалось, параллелизм данных (DP) и шардирование ZeRO требуют в обратном проходе либо AllReduce весов, либо ReduceScatter + AllGather. Стоимость у них одинакова, поэтому, чтобы чистый параллелизм данных или FSDP без редукций в сети упирались в вычисления, нужно (на слой, в обратном проходе, для оси размера X):
Поэтому для нужно , или
где — исходящая пропускная способность GPU или узла, в зависимости от того, шардируем мы внутри узла или между узлами. Значит:
- внутри узла достаточно, чтобы батч на GPU в токенах был больше ;
- внутри SU или на хребтовом уровне — больше .
Это заметно больше, чем на TPU, где это число — 850 при всех трёх осях. Например, LLaMA-3, обучавшейся на 16 000 H100, понадобился бы батч не меньше 40 млн токенов (для сравнения: использовали 16 млн). DeepSeek v3, обучавшейся на 2048 GPU H800 с более низкой пропускной способностью 300 ГБ/с (вместо 450 ГБ/с у H100), понадобилось бы токенов на GPU, или около 6,7 млн (на практике использовали 4 млн).
С редукциями в сети и чистым параллелизмом данных теоретически пропускная способность AllReduce удваивается, и оба числа уменьшились бы вдвое. Но на практике выигрыш ближе к 30%, что лишь компенсирует то, что обычно мы не дотягиваем до заявленных чисел. К тому же чистый параллелизм данных редко бывает полезен, так что на практике это почти не важно.
MoE-модели. Для модели со смесью экспертов (MoE), где E экспертов и k экспертов на токен, это растёт до
что увеличивает батч на GPU в токенах в раз:
Например, у новой открытой модели OpenAI с и это вырастает до 32 * 2475 = 79,200 между узлами — какое-то
смехотворно большое число.
Что, если X мал? Когда параллелизм данных, например, всего на 2 узла, помогает множитель :
где X — число узлов, а . Тогда для плотной модели , например — вдвое меньше значения выше. Поэтому двухпутевой параллелизм данных встречается довольно часто.
Тензорный параллелизм
Заголовок раздела «Тензорный параллелизм»Тензорный параллелизм (TP) требует AllGather и ReduceScatter активаций, которые нужно совмещать с FLOPs блока MLP. То есть в прямом проходе
откуда для упора в вычисления получаем правило
Внутри узла это примерно , а за его пределами — . Для , как у LLaMA-3, это около 11-путевого TP (или, с округлением вниз, около 8-путевого — ровно размер узла). Как и выше, если охватить ровно 2 узла, получаем дополнительный двукратный выигрыш в пропускной способности, так что обычно можно делать 16-путевой тензорный параллелизм (), что теоретически даёт до 19-путевого параллелизма модели.
Экспертный параллелизм
Заголовок раздела «Экспертный параллелизм»Как уже отмечалось, модели со смесью экспертов (MoE) дают в E раз больше весов модели при лишь в k раз большем числе FLOPs, и параллелизм данных становится заметно труднее. Это можно отчасти смягчить, шардируя веса по измерению экспертов, то есть Win[EZ, D, F]. Для блока MLP нужно ввести два AllToAll, чтобы отправить активации нужным экспертам.
Как отмечено выше, стоимость такого AllToAllZ→k([B, D, k]), если он охватывает несколько узлов, — примерно , так что для чистого экспертного параллелизма нужно
Нужно либо при , либо и , где . Получаются две области, где экспертный параллелизм возможен: одна — с небольшой степенью экспертного параллелизма (примерно на 2 узла) и малым , другая — с большим и сколь угодно большим (вплоть до E-путевого экспертного параллелизма).
На практике встречаются оба случая: либо немного экспертного параллелизма (как у DeepSeek v3 с очень маленьким F и сравнительно небольшим, ограниченным межузловым экспертным параллелизмом), либо модели с большим F, где можно делать значительный межузловой EP вместе с TP.
Конвейерный параллелизм
Заголовок раздела «Конвейерный параллелизм»Конвейерный параллелизм (PP) делит слои между узлами с крайне низкой стоимостью связи: раз в несколько слоёв отправляются лишь небольшие микробатчи активаций. Исторически конвейеры страдали от «пузырей», но с новыми подходами без пузырей (zero-bubble) обычно можно обойтись без них.
Общая стоимость связи в конвейере крошечная: при микробатчах и стадиях , а переходов , так что примерно
Поскольку мы делим на , это гораздо меньше любых других затрат. Иначе говоря, с точки зрения связи конвейер практически бесплатен. Почему же тогда не использовать только конвейер? Причин несколько.
(1) Сложность кода. Конвейер не так хорошо вписывается во фреймворки автоматического параллелизма (вроде GSPMD в XLA), как другие подходы. Он вводит микробатчи, чтобы скрыть пузыри, и тем меняет структуру программы, а собственные расписания конвейера без пузырей ещё усугубляют проблему, требуя сложного чередования прямого и обратного проходов.
(2) Конвейер затрудняет параллелизм данных и FSDP. Пожалуй, главная причина не использовать конвейер — он плохо сочетается с FSDP и параллелизмом данных. Особенно плохо работает шардирование ZeRO-3: оно требует AllGather весов на каждом микробатче, а это не окупается, когда на микробатч приходится лишь токенов. Кроме того, в обратном проходе нельзя выполнить AllReduce или ReduceScatter градиентов, пока последний микробатч не прошёл данную стадию, — значит, появляется заметное время связи, которое не перекрывается вычислениями.
Рисунок в оригинале (pipeline-bubble.png): пример конвейера из 2 стадий и 2 микробатчей. F — прямой проход стадии, B — обратный (вдвое дороже), G — AllReduce параллелизма данных, который может быть заметно длиннее одного микробатча.
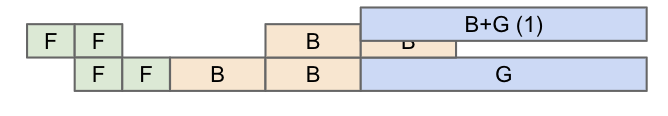
(3) Пузыри конвейера и дисбаланс шагов. Как видно из (плохого) расписания выше, при наивном расписании легко получить заметные пузыри (то есть потерянные вычисления). Выше вторая стадия простаивает на шаге 0, первая — с шага 2 по 3, а вторая снова простаивает на последнем шаге. Аккуратным планированием это отчасти можно обойти, но какие-то пузыри часто остаются. Кроме того, активации нужно передавать от стадии к стадии на критическом пути, что добавляет накладные расходы (pipeline-transfer.png: стоимость передачи сдвигает стадии друг относительно друга и увеличивает пузыри).
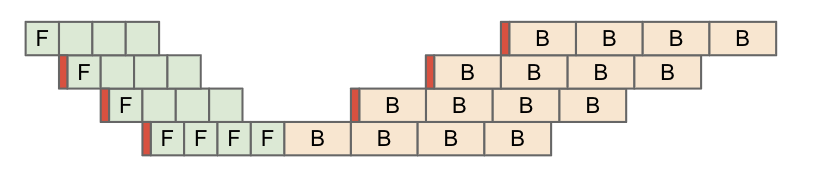
Для каждой из этих проблем есть обходные пути, но их обычно сложно реализовать и трудно поддерживать; конвейер остаётся приёмом с низкой стоимостью связи по сравнению с другими методами.
Оговорка о задержке. Как отмечалось, GPU с трудом достигают полной пропускной способности AllReduce даже на довольно больших сообщениях. Значит, даже если теоретически можно масштабировать, скажем, AllToAll экспертного параллелизма на несколько узлов, на деле может не получиться выжать и 50% общей пропускной способности. Поэтому TP или EP стараются держать в пределах небольшого числа узлов, чтобы уменьшить накладные расходы на задержку.
Примеры
Заголовок раздела «Примеры»Что делает DeepSeek? Для справки: DeepSeek V3 обучалась на 2048 GPU H800 с:
- 64-путевым экспертным параллелизмом (EP), охватывающим 8 узлов;
- 16-путевым конвейерным параллелизмом (PP);
- 2-путевым параллелизмом данных ZeRO-1 (DP).
Установившийся размер батча — 4096 * 15360 = 62,914,560 токенов, или 30 тысяч токенов на GPU. Это уже довольно много, но
и модель очень разреженная (k=8, E=256), так что нужен довольно большой батч. Видно, что при 64-путевом EP и 16-путевом PP
получается в сумме 1024-путевой параллелизм модели, а значит, AllReduce выполняется на хребтовом уровне, и, поскольку он
лишь 2-путевой, на практике получаем в раза больше пропускной способности. Это также помогает удешевить
финальный AllReduce параллелизма данных, перекрывающийся с последними стадиями конвейера.
Что делает LLaMA-3? LLaMA-3 обучается с батчем 16 млн токенов на 16 тысячах GPU, то есть около 1 тысячи токенов на GPU. Используются:
- 8-путевой тензорный параллелизм внутри узла (TP);
- 16-путевой конвейерный параллелизм (PP);
- 128-путевой параллелизм данных ZeRO-1.
Это плотная модель, так что всё в целом довольно просто. 16-путевой PP в 16 раз удешевляет AllReduce параллелизма данных, что помогает снизить критический размер батча.
Итоги масштабирования LLM на GPU
Заголовок раздела «Итоги масштабирования LLM на GPU»Отступим на шаг и подведём общий итог того, что мы узнали:
- Параллелизм данных или FSDP (ZeRO-1/3) требует локального батча около 2500 токенов на GPU, хотя теоретически редукции в сети плюс чистый DP могут это немного снизить.
- Тензорный параллелизм упирается в вычисления примерно до 8-путевого, но пропускной способности не хватает, чтобы масштабироваться заметно дальше, не упёршись в связь. В основном это ограничивает нас одним доменом NVLink (то есть одним узлом, или нужен GB200NVL72 с числом GPU до 72).
- Любой вид параллелизма модели, охватывающий несколько узлов, может ещё удешевить FSDP, поэтому часто хочется смешать PP + EP + TP, чтобы охватить много узлов и снизить стоимость FSDP.
- Конвейерный параллелизм хорошо работает, если вы справляетесь со сложностью кода конвейера без пузырей и держите размеры батча достаточно большими, чтобы избежать узких мест параллелизма данных. Конвейер обычно делает ZeRO-3 невозможным (пришлось бы делать AllGather на каждой стадии конвейера), но вместо него можно использовать ZeRO-1.
В целом это даёт рецепт шардирования больших моделей на GPU:
- Для сравнительно небольших плотных моделей отлично работает агрессивный FSDP, если хватает размера батча, — возможно, с небольшой долей конвейерного или тензорного параллелизма, если нужно.
- Для более крупных плотных моделей хорошо работает сочетание TP на 1–2 узла + PP на много узлов + чистый DP.
- Для MoE действует то же правило, но можно использовать и экспертный параллелизм, который обычно предпочтительнее TP. Если , можно делать много межузлового экспертного параллелизма, иначе мы ограничены примерно 2-узловым EP.
flowchart TD
A["Модель помещается в одну GPU с оптимизатором?"] -->|"да"| DP["DDP: батч ≥ ~2500 токенов на GPU (на PCIe — больше)"]
A -->|"нет"| B["Плотная модель среднего размера?"]
B -->|"да"| FSDP["FSDP (ZeRO-3), при нужде + немного PP или TP"]
B -->|"нет, очень большая"| C["TP внутри узла + PP между узлами + DP (ZeRO-1)"]
C --> D{"MoE?"}
D -->|"да"| EP["Экспертный параллелизм вместо части TP"]Дальше в оригинале — квиз 5 о roofline для LLM, благодарности и приложения о GB200 и деталях сети (не переведены).
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| Streaming Multiprocessor (SM), SM subpartition | потоковый мультипроцессор, подраздел SM |
| Tensor Core, CUDA core | тензорное ядро, CUDA-ядро |
| warp, warp scheduler, warp divergence | варп, планировщик варпов, расхождение варпа |
| SIMT / SIMD | одна инструкция — много потоков / данных |
| register file, SMEM (shared memory), L2, TMEM, HBM | регистровый файл, общая память, кэш L2, тензорная память, HBM |
| FMA (fused multiply-add) | совмещённое умножение-сложение |
| node, NVLink domain, NVSwitch | узел, домен NVLink, коммутатор NVSwitch |
| InfiniBand, NIC, leaf / spine switch | InfiniBand, сетевая карта, листовой / хребтовый коммутатор |
| fat tree, bisection bandwidth | толстое дерево, бисекционная пропускная способность |
| scale-out network | масштабирующая сеть (между узлами) |
| full-duplex, egress / ingress | полный дуплекс, исходящий / входящий трафик |
| AllGather, ReduceScatter, AllReduce, AllToAll | сбор, редукция с раздачей, общая редукция, «все всем» |
| ragged AllToAll | разреженный AllToAll |
| in-network reduction (SHARP) | редукция в сети |
| data / tensor / expert / pipeline parallelism | параллелизм данных / тензорный / экспертный / конвейерный |
| ZeRO-1, ZeRO-3, FSDP | шардирование состояния оптимизатора / всего, полностью шардированный DP |
| microbatch, pipeline bubble, zero-bubble | микробатч, пузырь конвейера, конвейер без пузырей |
Footnotes
Заголовок раздела «Footnotes»-
Тензорное ядро GPU — подблок SM для умножения матриц, а TensorCore у TPU — объемлющий блок, содержащий MXU, VPU и другие компоненты. ↩
-
У NVIDIA нет хорошего названия для этого блока, поэтому мы используем это — как лучшее из нескольких плохих. Планировщик варпов — прежде всего блок, раздающий работу набору CUDA-ядер, но здесь мы называем так и управляющий блок, и набор ядер, которым он управляет. ↩
-
Новые GPU поддерживают инструкции FMA (fused multiply-add, совмещённое умножение-сложение), которые формально выполняют две FLOPs за такт, — этим NVIDIA беззастенчиво пользуется, удваивая заявленные характеристики. ↩
-
Исторически, до появления тензорных ядер, CUDA-ядра были главным компонентом GPU и использовались для отрисовки, включая пересечения лучей с треугольниками и затенение. В современных игровых GPU они по-прежнему выполняют основную работу по отрисовке, а тензорные ядра используются для повышения разрешения (DLSS): GPU рисует в меньшем разрешении (меньше пикселей — меньше работы) и повышает его с помощью ML. ↩
-
NVIDIA раскрывает мало аппаратных деталей тензорных ядер, так что это скорее догадка, чем точный факт, — и уж точно ничего не говорит о том, как тензорное ядро реализовано. Известно, что V100 выполняет 256 FLOPs на тензорное ядро за такт, A100 — 512, H100 — 1024, а для B200 детали не опубликованы, но, вероятно, около 2048, поскольку
2250e12 / (148 * 4 * 1.86e9)— примерно 2048. Некоторые подробности подтверждены здесь. ↩ -
В Ampere тензорное ядро можно было питать из одного варпа, в Hopper нужен целый SM (warpgroup), а в Blackwell его питают 2 SM. Умножения в Blackwell стали такими большими, что аргументы (точнее, аккумулятор) больше не помещаются в регистры/SMEM, поэтому в Blackwell добавили TMEM. ↩
-
Варпы, запланированные на данном SM, называют «резидентными». ↩
-
Строго говоря, кэш L2 разделён на две половины, так что у H100 половина SM имеет доступ к 25 МБ каждая. Половины связаны каналом, но с меньшей пропускной способностью. ↩
-
То, что кэш L2 общий для всех SM, фактически вынуждает программиста всё равно запускать SM довольно согласованно, хотя в принципе это независимые блоки. ↩
-
NVIDIA выпустила поколение B100, но его продавали и производили недолго — якобы из-за конструктивных недостатков, которые не давали работать близко к заявленным характеристикам. Ему было трудно выходить на пиковые FLOPs без снижения частоты из-за нагрева и энергопотребления. ↩
-
До бума глубокого обучения GPU («графические процессоры») занимались, собственно, графикой — в основном для видеоигр. Видеоигры представляют объекты миллионами маленьких треугольников, а игра отрисовывает (растеризует) эти треугольники в двумерное изображение, которое показывается на экране 30–60 раз в секунду (эта частота называется частотой кадров). Растеризация включает проецирование треугольников в систему координат камеры и вычисление, какие треугольники перекрывают какие пиксели, — миллиарды раз в секунду. Это очень дорого, и это только начало: затем каждый пиксель нужно раскрасить, смешав цвета, возможно, нескольких полупрозрачных треугольников, которые пересекает луч. GPU проектировали так, чтобы выполнять эти операции очень быстро и при этом универсально: одновременно нужно запускать много разных задач GPU (их называют шейдерами), и ни одна операция не доминирует. Поэтому потребительские графические GPU умеют умножать матрицы, но это не их главная функция. ↩
-
Примечательно, что эта интенсивность остаётся постоянной в последних поколениях GPU: у H100 — 33,5 / 3,35, у B200 — 80 / 8. Почему так, неясно, но наблюдение интересное. ↩
-
Термин «узел» перегружен и может значить две вещи: домен NVLink, то есть набор GPU, полностью связанных межсоединениями NVLink, или набор GPU, подключённых к одному хосту с процессором. До B200 это обычно совпадало, но в GB200 NVL72 домен NVLink — 72 GPU, а к каждому хосту по-прежнему подключено 8 GPU. Здесь мы называем узлом домен NVLink, хотя это спорно. ↩
-
NVLink мне описывали как что-то вроде «прокачанного» PCIe — с низкой задержкой и накладными расходами протокола, но не рассчитанного на масштабируемость и отказоустойчивость, тогда как InfiniBand больше похож на Ethernet и рассчитан на большие сети с потерями. ↩
-
Полный дуплекс здесь означает 25 ГБ/с в каждую сторону, причём направления независимы. Всего по каналу можно отправить 50 ГБ/с, но не больше 25 ГБ/с в каждом направлении. ↩
-
Можно представить и так: каждый GPU отправляет свой кусок размером каждому из остальных GPU, всего переданных байт, — ответ тот же. ↩