MDP, отдача и функции ценности
Язык обучения с подкреплением с нуля: агент и среда, MDP, дисконтированная отдача, политика, функции ценности V и Q, преимущество, уравнение Беллмана, value iteration и policy iteration на мире-сетке.
Зачем это нужно
Заголовок раздела «Зачем это нужно»До сих пор модель училась на правильных ответах: у каждого примера был эталон, и loss измерял расстояние до него. Так устроены регрессия, классификация (ступень 2) и претрейн (ступени 4–5). Но для многих задач эталона нет, зато есть оценка: решила ли модель задачу, прошли ли тесты, понравился ли ответ человеку. Учиться по такой оценке — задача обучения с подкреплениемобучение с подкреплениемEN reinforcement learning (RL) (reinforcement learning, RL).
На RL стоит вся вторая половина ступени 6. RLHF в ChatGPT (урок 6.3.2) — это алгоритм PPO, GRPO в DeepSeek-R1 (урок 6.4.1) — его упрощение. В их формулах встречаются , , , , , и без подготовки читаются как шифр. Модуль 6.0 даёт эту подготовку на простых примерах, без языковых моделей:
- 6.0.1 (этот урок) — язык RL и планирование, когда правила среды известны: MDP, отдача, функции ценности, Беллман;
- 6.0.2 — обучение на собственном опыте, без знания правил: Монте-Карло, TD, Q-learning;
- 6.0.3 — градиент политики, actor-critic, GAE и PPO целиком, и как всё это переносится на LLM.
Агент и среда
Заголовок раздела «Агент и среда»В RL два участника. АгентагентEN agentВ китайском встречается и «дайли» («посредник»), но в AI-контексте стандарт — «чжинэнти» (буквально «интеллектуальное тело»). принимает решения. Средасреда (в RL и для агентов)EN environmentТо, с чем взаимодействует агент — инструменты, песочница, симулятор пользователя — вместе с правилами выдачи награды. — всё остальное: она показывает агенту ситуацию и реагирует на его действия. Взаимодействие идёт по шагам:
flowchart LR
A["Агент: политика π"] -->|"действие a_t"| E["Среда"]
E -->|"новое состояние s_t+1"| A
E -->|"награда r_t"| A
На шаге агент видит состояниесостояние (в RL)EN stateВсё, что агенту нужно знать о ситуации, чтобы выбрать действие. У LLM — промпт плюс уже написанные токены. , выбирает действиедействие (в RL)EN actionВыбор агента на шаге. У LLM действие — следующий токен. , получает наградунаграда, вознаграждениеEN rewardЧисло, которым среда оценивает действие или весь ответ. У LLM обычно одна награда в конце ответа. (число, может быть нулём или отрицательным) и оказывается в состоянии . Цепочка от старта до конца — эпизодэпизодEN episodeОдна партия взаимодействия от старта до конечного состояния. У LLM — один ответ до токена конца.. Лучше всего понятия видны на примерах:
| Пример | Состояние | Действие | Награда | Конец эпизода |
|---|---|---|---|---|
| Дрессировка собаки | что сказал хозяин, где собака | сесть, лечь, подать лапу | лакомство или ничего | конец занятия |
| Робот-пылесос | карта комнаты, заряд батареи | ехать, повернуть, на базу | +1 за чистую клетку, −10 за разряд | батарея села или всё убрано |
| Шахматы | позиция на доске | ход | +1 победа, −1 поражение, только в конце | мат или ничья |
| Ответ LLM | промпт и уже написанные токены | следующий токен | оценка готового ответа | токен конца ответа |
Чем RL отличается от обучения с учителем из урока 2.1.1:
- Нет правильных ответов. Собаке не показывают «эталонную лапу», ей дают лакомство за результат.
- Награда запаздывает. В шахматах ход на 10-й минуте мог решить партию, а награда пришла на 40-й. Понять, какое действие «заслужило» награду, — главная трудность RL (её называют распределением заслуг, credit assignment).
- Агент сам выбирает свои данные. Что он увидит дальше, зависит от его действий. Плохая стратегия — плохие данные.
MDP: формальная модель среды
Заголовок раздела «MDP: формальная модель среды»Чтобы считать, среду описывают марковским процессом принятия решениймарковский процесс принятия решений (MDP)EN Markov decision process (MDP)Пятёрка (S, A, P, R, γ): состояния, действия, вероятности переходов, награда и коэффициент дисконтирования. (Markov decision process, MDP). Это пять объектов:
- — множество состояний, — множество действий;
- — вероятность попасть в , если в выбрать . Это условная вероятностьусловная вероятностьEN conditional probabilityP(A | B) = P(A ∩ B) / P(B) — вероятность A, если известно, что B произошло. В общем случае P(A | B) ≠ P(B | A). из урока 1.3.1;
- — средняя награда за шаг: какое число в среднем получим, выбрав в ;
- — коэффициент дисконтированиякоэффициент дисконтированияEN discount factorγ от 0 до 1: во сколько раз награда через шаг «дешевле» награды сейчас. Горизонт планирования ≈ 1/(1−γ)., о нём ниже.
Слово «марковский» означает марковское свойствомарковское свойствоEN Markov propertyБудущее зависит только от текущего состояния и действия, а не от всей предыстории.: будущее зависит только от текущего состояния и действия, а не от того, как мы сюда пришли. Вы встречали ту же идею в n-граммных моделях (урок 4.1.1): там следующий токен зависел только от нескольких предыдущих. Если в состояние положить всё нужное (у LLM — весь текущий контекст), свойство выполняется.
Переходы бывают детерминированными (из действием всегда в одно и то же ) и случайными: робот на скользком полу иногда съезжает вбок. Задачи бывают эпизодическими (партия, ответ, уровень игры) и бесконечными (термостат, биржевой робот).
Сквозной пример — коридор. Три клетки: , и выход. Действия — «влево» и «вправо». Из влево — стена, остаёмся в . Из вправо — выход и награда , эпизод кончается. Все остальные награды нулевые.
flowchart LR
A["A"] -->|"вправо, r = 0"| B["B"]
A -->|"влево (стена), r = 0"| A
B -->|"влево, r = 0"| A
B -->|"вправо, r = +1"| X["Выход (конец)"]
Отдача и коэффициент дисконтирования
Заголовок раздела «Отдача и коэффициент дисконтирования»Агент максимизирует не награду за один шаг, а сумму будущих наград — отдачуотдача (return)EN returnG_t = r_t + γ r_{t+1} + γ² r_{t+2} + … — дисконтированная сумма наград от шага t до конца эпизода. (return):
Как читать: отдача с шага — это награда сейчас плюс награда через шаг, умноженная на , плюс награда через два шага, умноженная на , и так далее. Если эпизод кончился, дальше стоят нули.
Главное свойство отдачи — рекурсия, на ней построен весь урок:
Пример. Эпизод из трёх шагов с наградами (до выхода три хода, награда в конце), . Считаем с конца: , , .
def returns(rewards, gamma):    """Отдачи G_t для всех шагов эпизода: идём с конца, G_t = r_t + γ·G_{t+1}."""    G, out = 0.0, []    for r in reversed(rewards):        G = r + gamma * G        out.append(G)    return out[::-1]

for gamma in [0.9, 0.5, 1.0]:    print(gamma, [round(g, 3) for g in returns([0, 0, 1], gamma)])
0.9 [0.81, 0.9, 1.0]0.5 [0.25, 0.5, 1.0]1.0 [1.0, 1.0, 1.0]Зачем дисконт. Три причины:
- Конечность. В бесконечной задаче сумма наград может быть бесконечной. При и наградах не больше отдача не больше — геометрическая прогрессия.
- Синица в руках. Награда сейчас надёжнее награды потом: среда может измениться, эпизод — оборваться. Как с деньгами: рубль сегодня ценнее рубля через год.
- Горизонт. Множитель быстро тает, и агент фактически планирует примерно на шагов вперёд.
| 0 | 0.5 | 0.9 | 0.99 | 1 | |
|---|---|---|---|---|---|
| Горизонт | 1 шаг | 2 шага | 10 шагов | 100 шагов | весь эпизод |
| Поведение | думает только о текущем шаге | близорук | разумный баланс | дальновиден | только для конечных эпизодов |
У языковых моделей эпизод конечен (ответ рано или поздно кончается), и в RLHF обычно берут : награда за ответ одинаково важна для первого и для последнего токена.
Политика
Заголовок раздела «Политика»Политикаполитика (стратегия агента)EN policy — правило выбора действий. Детерминированная политика — таблица «состояние → действие». Стохастическая — распределение : в коридоре можно идти вправо с вероятностью 0.5 и влево с вероятностью 0.5. Языковая модель — стохастическая политика: softmax над словарём даёт , а сэмплирование выбирает действие.
Цель RL — найти политику с максимальной средней отдачей: . Матожидание — потому что и политика, и среда случайны: одна и та же политика в разных эпизодах получает разную отдачу.
Функции ценности V и Q
Заголовок раздела «Функции ценности V и Q»Насколько хорошо находиться в состоянии ? Ответ зависит от того, как мы будем действовать дальше. Поэтому ценность всегда считают для конкретной политики.
Функция ценности состоянияфункция ценности состояния (V)EN state-value functionV^π(s) — средняя отдача, если стартовать из s и дальше действовать по политике π.:
Как читать: средняя отдача, если стартовать из и дальше действовать по . Это матожиданиематематическое ожидание (матожидание)EN expected value (expectation)E[X] = Σ x·p(x) — среднее значение «в долгую», центр тяжести распределения. из урока 1.3.1: сыграть из много эпизодов и усреднить отдачи.
Функция ценности действияфункция ценности действия (Q)EN action-value function (Q-function)Q^π(s, a) — средняя отдача, если в s выбрать действие a, а дальше действовать по π. уточняет первый шаг:
Как читать: средняя отдача, если в выбрать именно , а дальше действовать по . Связь между ними — обычное среднее: .
Разность называют преимуществомпреимущество (advantage)EN advantageA = r − b или A(s, a) = Q(s, a) − V(s): насколько действие лучше среднего в этой ситуации. (advantage):
Пример из жизни. Дорога на работу, награда — минус минуты в пути. Ваша привычка — 50/50 между метро и такси. Метро занимает в среднем 30 минут: . Такси — 20 минут: . Ценность утра «как обычно» . Преимущество такси , метро . Знак преимущества говорит, поднимать или опускать вероятность действия, — ровно это делают PPO и GRPO. Запомните формулу : в уроке 6.0.3 она станет сердцем алгоритма.
Уравнение Беллмана
Заголовок раздела «Уравнение Беллмана»Как посчитать , не играя миллион эпизодов? Подставим рекурсию в определение . Матожидание суммы — сумма матожиданий, а среднее из следующего состояния — это . Получаем уравнение Беллманауравнение БеллманаEN Bellman equationЦенность состояния = средняя немедленная награда + γ · средняя ценность следующего состояния.:
Как читать: ценность состояния = среднее по действиям политики от «немедленная награда + × средняя ценность места, куда попадём». Выражение в квадратных скобках — это . Так что уравнение говорит то же, что , только расписано через следующего шага.
Это рекурсия, как функция, вызывающая саму себя (урок 0.2.2): ценность выражена через ценность. Метод, где большую задачу решают через подзадачи и переиспользуют их ответы, называют динамическим программированиемдинамическое программированиеEN dynamic programmingРешение задачи через ответы на подзадачи, которые хранятся и переиспользуются. В RL — методы для случая, когда модель среды известна.. Отсюда и название методов этого урока.
Решаем коридор руками
Заголовок раздела «Решаем коридор руками»Политика случайная: 50/50, , ценность выхода 0 (дальше наград нет). Пишем уравнение для каждой клетки:
Из первого: , то есть . Подставляем во второе: , откуда и .
Теперь преимущества в : , . Средняя , значит , . В разница больше: , преимущество . Логично: в правильный выбор сразу приносит награду.
Решаем коридор итерациями
Заголовок раздела «Решаем коридор итерациями»Систему из двух уравнений легко решить руками, из 10 тысяч — нет. Есть два компьютерных способа. Первый — записать
уравнения как линейную систему и вызвать np.linalg.solve
(урок 1.1.2). Второй — итерации: начать с и много раз
подставлять текущую оценку в правую часть уравнения. Это называют оценкой политики (policy evaluation).
import numpy as np
gamma = 0.9# Политика 50/50 в коридоре. Состояния: 0 = A, 1 = B (выход — ценность 0, его не храним).P_pi = np.array([[0.5, 0.5],      # из A: 0.5 остаёмся (стена), 0.5 в B                 [0.5, 0.0]])     # из B: 0.5 в A, 0.5 на выходR_pi = np.array([0.0, 0.5])       # средняя награда за шаг: в B с вероятностью 0.5 получаем +1
V = np.zeros(2)for k in range(1, 31):    V = R_pi + gamma * P_pi @ V   # одна «подстановка» уравнения Беллмана    if k in (1, 2, 3, 10, 30):        print(k, V.round(4))print("точно:", np.linalg.solve(np.eye(2) - gamma * P_pi, R_pi).round(4))
1 [0. 0.5]2 [0.225 0.5 ]3 [0.3262 0.6013]10 [0.613 0.7701]30 [0.6474 0.7913]точно: [0.6475 0.7914]Ценность «просачивается» от награды назад: после первой итерации её чувствует только , после второй — и . Каждая итерация уменьшает ошибку как минимум в раз, поэтому процесс сходится к точному решению.
Оптимальность: уравнение Беллмана с максимумом
Заголовок раздела «Оптимальность: уравнение Беллмана с максимумом»Нас интересует не любая политика, а лучшая. Её ценности обозначают и . Лучший агент в каждом состоянии выбирает лучшее действие, поэтому среднее по политике заменяется максимумом — получается уравнение оптимальности Беллманауравнение оптимальности БеллманаEN Bellman optimality equationТо же уравнение, но вместо усреднения по политике — максимум по действиям. Его решение — V* и Q*.:
Как читать: ценность состояния при лучшей игре = ценность лучшего действия; лучшая политика — жадная по . В коридоре (сразу вправо), (вправо, вправо). Сравните со случайной политикой: 0.791 и 0.647.
Value iteration и policy iteration
Заголовок раздела «Value iteration и policy iteration»Когда модель среды ( и ) известна, оптимальную политику находят двумя классическими алгоритмами.
Итерация по ценностиитерация по ценности (value iteration)EN value iterationПовторять V(s) ← max_a Σ P(s′|s,a)[R + γV(s′)] до сходимости, затем взять жадную политику. (value iteration):
- Начать с .
- Для всех состояний сразу: , затем .
- Повторять, пока меняется больше допуска. В конце взять жадную политику .
В коридоре: после первой итерации , после второй , третья ничего не меняет — стоп.
Итерация по политикеитерация по политике (policy iteration)EN policy iterationЧередовать оценку политики (решить уравнение Беллмана для V^π) и её жадное улучшение, пока политика не перестанет меняться. (policy iteration):
- Начать с любой политики.
- Оценка: найти (решить линейную систему или итерациями, как выше).
- Улучшение: в каждом состоянии взять действие с максимальным . Новая политика не хуже старой — это теорема об улучшении политики.
- Если политика не изменилась — она оптимальна. Иначе вернуться к шагу 2.
| Value iteration | Policy iteration | |
|---|---|---|
| Что повторяем | один шаг Беллмана с максимумом | точную оценку + жадное улучшение |
| Цена итерации | дешёвая | дорогая (решить систему) |
| Число итераций | много: растёт при | обычно единицы раундов |
| Что нужно знать | и | и |
Оба алгоритма требуют модели среды. В жизни её обычно нет: никто не выдаст вам таблицу вероятностей для шахматного противника или для пользователя чат-бота. Как учиться без модели — следующий урок.
Мир-сетка: как дисконт меняет поведение
Заголовок раздела «Мир-сетка: как дисконт меняет поведение»Мир-сеткамир-сетка (gridworld)EN grid worldУчебная среда — агент ходит по клеткам поля, есть цели, ловушки и стены. (gridworld) — классическая учебная среда. Наше поле 5×5: старт S, большая
цель G (+1), маленькая цель g (+0.4), ловушки X (−1), стена #. Цели и ловушки заканчивают эпизод.
Value iteration при трёх значениях даёт такие политики (стрелки) и ценности (цвет: зелёный — выше):
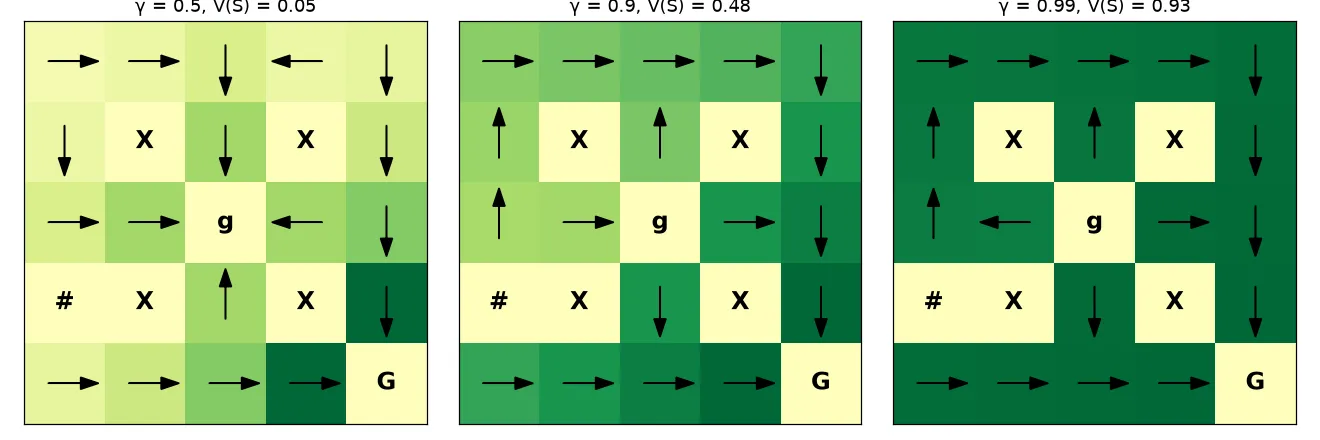
- — агент близорук. До
g4 шага, доG— 8. Сравним: против . Синица в руках побеждает. - — уже против : агент идёт к большой цели в обход ловушек.
- — путь тот же, но ценности почти не убывают с расстоянием (): далёкое будущее весит почти как настоящее.
Если пол сделать скользким (агент с вероятностью 0.2 съезжает вбок), появится осторожность: рядом с ловушками стрелки
начинают «упираться в стену», чтобы не соскользнуть в X. Это поведение никто не программировал — оно следует из
уравнения Беллмана. Попробуйте сами в задании ниже (make_gridworld(slip=0.2)).
Почему ответ LLM — контекстный бандит, а агент — нет
Заголовок раздела «Почему ответ LLM — контекстный бандит, а агент — нет»Запишем генерацию ответа как MDP. Состояние — промпт плюс уже написанные токены, действие — следующий токен, переход детерминирован (токен просто дописывается в контекст), награда приходит один раз в конце, . Раз переходы предсказуемы, а награда одна, весь ответ можно считать одним действием: увидели промпт — выдали ответ — получили оценку. Задачу из одного шага, но в разных ситуациях называют контекстным бандитомконтекстный бандитEN contextual banditЗадача RL из одного шага, но в разных ситуациях (контекстах). Ответ LLM целиком на промпт — пример такой задачи.: контекст — промпт, «ручка бандита» — ответ.
На языке этого урока: — средняя награда ответов модели на этот промпт, а преимущество ответа — . Именно эту величину GRPO (урок 6.4.1) оценивает просто по выборке: генерирует на промпт группу ответов и сравнивает награду каждого со средней по группе.
У агента с инструментами (модуль 8.3) так не выйдет:
| Один ответ LLM | Агент с инструментами | |
|---|---|---|
| Кто меняет состояние | только модель | модель и среда: вывод инструментов, веб-страницы, результаты тестов |
| Переходы | детерминированы | случайны, модель их не контролирует |
| Шагов с решениями | один (если считать ответ целиком) | десятки вызовов инструментов |
| Распределение заслуг | одна оценка на весь ответ | какой из 30 шагов привёл к успеху? |
Для агента нужна полноценная MDP: функции ценности по шагам, критик и GAE из урока 6.0.3.
Практика
Заголовок раздела «Практика»Задание: value iteration и policy iteration на мире-сетке
Заголовок раздела «Задание: value iteration и policy iteration на мире-сетке»Модель среды (make_gridworld) и печать карты уже готовы. Реализуйте шаг Беллмана для всех состояний сразу, оценку
политики, value iteration и policy iteration. Тесты проверят, что ценности решают уравнение оптимальности, что политика
ведёт к цели в обход ловушек и что policy iteration приходит к той же .
import numpy as np

# ── Среда уже готова: модель gridworld 5×5 ──────────────────────────────────
# S — старт, G — большая цель (+1), g — маленькая цель (+0.4), X — ловушка (−1),
# # — стена, . — пустая клетка. G, g и X — конечные клетки: эпизод там заканчивается.
LAYOUT = [
    "S....",
    ".X.X.",
    "..g..",
    "#X.X.",
    "....G",
]
MOVES = [(-1, 0), (0, 1), (1, 0), (0, -1)]   # действия: 0 ↑, 1 →, 2 ↓, 3 ←
ARROWS = "↑→↓←"
CELL_REWARD = {"G": 1.0, "g": 0.4, "X": -1.0}


def make_gridworld(layout=LAYOUT, slip=0.0):
    """Модель среды: P[s, a, s'] — вероятность перехода, R[s, a] — средняя награда за шаг.

    slip — вероятность «поскользнуться»: агент уходит вбок от выбранного направления
    (по slip/2 в каждую сторону). Упёрся в край поля или в стену — остаётся на месте.
    Конечные клетки (и стены) поглощающие: из них P = 1 в себя же, награда 0.
    """
    H, W = len(layout), len(layout[0])
    n = H * W
    P = np.zeros((n, 4, n))
    R = np.zeros((n, 4))
    for s in range(n):
        r, c = divmod(s, W)
        if layout[r][c] in "GgX#":
            P[s, :, s] = 1.0
            continue
        for a in range(4):
            for move, p in [(a, 1 - slip), ((a + 1) % 4, slip / 2), ((a + 3) % 4, slip / 2)]:
                if p == 0:
                    continue
                nr, nc = r + MOVES[move][0], c + MOVES[move][1]
                if not (0 <= nr < H and 0 <= nc < W) or layout[nr][nc] == "#":
                    nr, nc = r, c
                P[s, a, nr * W + nc] += p
                R[s, a] += p * CELL_REWARD.get(layout[nr][nc], 0.0)
    return P, R


def show(V, policy, layout=LAYOUT):
    """Печатает стрелки политики и «тепловую карту» V (числами) рядом."""
    W = len(layout[0])
    for r, row in enumerate(layout):
        arrows = " ".join(ch if ch in "GgX#" else ARROWS[policy[r * W + c]] for c, ch in enumerate(row))
        values = " ".join(f"{V[r * W + c]:+.2f}" for c in range(W))
        print(arrows, "   ", values)


# ── Ваша часть ──────────────────────────────────────────────────────────────

def bellman_q(P, R, V, gamma):
    """Q[s, a] = R[s, a] + gamma * sum_s' P[s, a, s'] * V[s'] для всех s и a сразу.

    Вход: P — [S, A, S], R — [S, A], V — [S]. Ответ — массив [S, A].
    Подсказка: P @ V перемножает последнюю ось P с V и даёт [S, A].
    """
    # TODO: ваш код
    ...


def policy_evaluation(P, R, policy, gamma, tol=1e-10):
    """Оценка политики: V^π итерациями уравнения Беллмана.

    policy — массив [S] с номером действия в каждом состоянии.
    Старт V = нули; повторять V_new[s] = Q[s, policy[s]] (Q считать через bellman_q),
    пока max |V_new - V| >= tol. Вернуть V_new.
    """
    # TODO: ваш код
    ...


def value_iteration(P, R, gamma, tol=1e-10):
    """Итерация по ценности. Вернуть (V, policy, n_iter).

    Старт V = нули; на каждой итерации Q = bellman_q(P, R, V, gamma), V_new = max по действиям.
    Остановка, когда max |V_new - V| < tol. policy — argmax по действиям у последнего Q,
    n_iter — сколько раз пересчитали V.
    """
    # TODO: ваш код
    ...


def policy_iteration(P, R, gamma, max_rounds=100):
    """Итерация по политике. Вернуть (V, policy).

    Старт: policy = нули (все «↑»). Раунд: V = policy_evaluation(...),
    Q = bellman_q(...), new_policy = argmax Q. Чтобы не «дрожать» на равных значениях,
    оставляйте старое действие, если оно всё ещё оптимально (np.isclose с максимумом).
    Политика не изменилась — стоп.
    """
    # TODO: ваш код
    ...


# Проверьте себя кнопкой «Запустить»: эксперимент с γ
P, R = make_gridworld()
for gamma in [0.5, 0.9, 0.99]:
    out = value_iteration(P, R, gamma)
    if out is not None:
        V, pi, n_iter = out
        print(f"γ = {gamma}: итераций {n_iter}, V(S) = {V[0]:.3f}")
        show(V, pi)
После решения нажмите «Запустить»: вы увидите стрелки и ценности для , и . Затем поменяйте
make_gridworld() на make_gridworld(slip=0.2) и посмотрите, как растёт число итераций (26, 100 и 333) и где агент
начинает осторожничать.
Локально: тепловая карта и стрелки
Заголовок раздела «Локально: тепловая карта и стрелки»Картинку выше рисует такой код (matplotlib из урока 0.3.3). Сохраните
своё решение задания в файл solution.py рядом со скриптом:
import matplotlib.pyplot as pltimport numpy as npfrom solution import LAYOUT, make_gridworld, value_iteration   # ваше решение задания
P, R = make_gridworld()fig, axes = plt.subplots(1, 3, figsize=(12, 4))for ax, gamma in zip(axes, [0.5, 0.9, 0.99]):    V, policy, _ = value_iteration(P, R, gamma)    ax.imshow(V.reshape(5, 5), cmap="RdYlGn", vmin=-1, vmax=1)        # тепловая карта V    for s in range(25):        r, c = divmod(s, 5)        ch = LAYOUT[r][c]        if ch in "GgX#":            ax.text(c, r, ch, ha="center", va="center", fontsize=16, weight="bold")        else:                                                         # стрелка политики            dr, dc = [(-1, 0), (0, 1), (1, 0), (0, -1)][policy[s]]            ax.arrow(c - 0.2 * dc, r - 0.2 * dr, 0.4 * dc, 0.4 * dr, head_width=0.15, color="black")    ax.set_title(f"γ = {gamma}, V(S) = {V[0]:.2f}")    ax.set_xticks([]); ax.set_yticks([])plt.tight_layout()plt.savefig("gridworld_gamma.png", dpi=110, facecolor="white")
Получится файл gridworld_gamma.png — те же три панели, что выше. Видеокарта здесь не нужна: поле из 25 клеток
считается за миллисекунды.
Проверь себя
Заголовок раздела «Проверь себя»- Задача RL — MDP : агент выбирает действия, среда отвечает состоянием и наградой. Цель — максимум средней отдачи , где задаёт горизонт .
- — средняя отдача из состояния, — после конкретного действия, преимущество — насколько действие лучше обычного. На преимуществе построены PPO и GRPO.
- Уравнение Беллмана выражает ценность через ценность следующего шага; с максимумом вместо среднего оно задаёт оптимальную политику.
- Когда модель среды известна, value iteration и policy iteration находят оптимальную политику; на мире-сетке видно, как превращает близорукого агента в дальновидного.
- Один ответ LLM — контекстный бандит ( промпта = средняя награда его ответов), агент с инструментами — полноценная MDP.
Дальше: что делать, если модели среды нет и вероятности неизвестны, — учиться на собственном опыте методами Монте-Карло и TD, исследовать мир ε-жадно и находить оптимальную политику алгоритмом Q-learning.