Mistral Cookbook: путеводитель и рецепт «RAG с нуля»
Карта сборника рецептов Mistral AI — промпты, эмбеддинги, RAG, function calling, оценка, OCR, модерация, агенты и разборы токенизации, сэмплирования и квантования — с полным переводом ноутбука «RAG Basics with Mistral AI».
Mistral Cookbook — сборник примеров от сотрудников Mistral AI, сообщества и партнёров. Mistral AI — французская
лаборатория, авторы открытых моделей Mistral 7B, Mixtral, Pixtral и коммерческого API. Почти все рецепты работают
через облачный API Mistral (pip install mistralai), но идеи и структура кода прямо переносятся на любую модель с
OpenAI-совместимым интерфейсом.
Эта страница — путеводитель по репозиторию (ветка main, коммит 9deed45) и полный перевод одного ключевого рецепта:
«RAG Basics with Mistral AI» — сборка RAG с нуля на 30 строках кода. Лицензия репозитория — MIT.
Что это и для кого
Заголовок раздела «Что это и для кого»- Ступень. 8 — приложения на LLM: API, промпты, RAG, агенты. Разделы
concept-deep-diveполезны ещё на ступенях 4 и 7 (токенизация, сэмплирование, квантование). - Что нужно. Ключ API Mistral (тарифы и бесплатные лимиты меняются — проверьте на сайте Mistral). Без ключа рецепты удобно читать как образцы и повторять на локальной модели.
- Короткий видеокурс. У Mistral есть часовой курс «Getting Started with Mistral» на DeepLearning.AI — по сути, видеоверсия первых рецептов отсюда.
Карта содержимого
Заголовок раздела «Карта содержимого»Основные ноутбуки (папка mistral/)
Заголовок раздела «Основные ноутбуки (папка mistral/)»| Рецепт | О чём | Урок курса | Важность |
|---|---|---|---|
quickstart.ipynb | Первый запрос в чат и первые эмбеддинги через API | 8.1 | ★★ |
prompting/prompting_capabilities.ipynb | Промпты для классификации, суммаризации, персонализации и оценки | 8.1 | ★★★ |
prompting/prefix_use_cases.ipynb | Префикс ответа: заставить модель начать ответ с заданного текста (язык, формат, роль) | 8.1 | ★★ |
rag/basic_RAG.ipynb | RAG с нуля: фрагменты, эмбеддинги, Faiss, промпт (перевод ниже) | 8.2 | ★★★ |
rag/RAG_via_function_calling.ipynb, rag/mistral-search-engine.ipynb, rag/mistral-reference-rag.ipynb | Function calling как маршрутизатор между несколькими источниками; поисковик; RAG со ссылками на источники | 8.2 | ★★ |
embeddings/embeddings.ipynb | Эмбеддинги для классификации и кластеризации | 4.3, 2.3 | ★★ |
function_calling/function_calling.ipynb | Вызов функций: описание инструментов, ответ модели, выполнение, возврат результата | 8.3 | ★★★ |
evaluation/evaluation.ipynb, evaluation/RAG_evaluation.ipynb | Оценка моделей; оценка RAG судьёй-LLM со структурированным выводом | 7.3 | ★★★ |
observability/* | Кампании LLM-судей для разметки поведения агентов, наборы данных для оценки | 8.4 | ★ |
data_generation/* | Генерация синтетических данных (переписывание новостей) | 6.1 | ★ |
image_understanding/* | Pixtral: структурированные описания картинок в JSON, таблица с картинки → вызов функции | 9.1 | ★★ |
ocr/* | OCR документов, пакетная обработка, структурированный вывод, нарезка документа на фрагменты | 8.2 | ★★ |
moderation/* | API модерации, защитные фильтры уровня системы, классификатор Shieldstral с открытыми весами | 8.3 | ★★ |
agents/*, connectors/*, lechat_custom_mcp_server/ | Agents API, многоагентные цепочки без фреймворков, коннекторы, свой MCP-сервер | 8.3 | ★★ |
deprecated_cookbooks/* | Устаревшие рецепты, в том числе дообучение через API и классификаторы | — | — |
Разборы понятий (папка concept-deep-dive/)
Заголовок раздела «Разборы понятий (папка concept-deep-dive/)»| Раздел | О чём | Урок курса | Важность |
|---|---|---|---|
tokenization/ | Как устроены токенизаторы Mistral V1, V2, V3 и Tekken (на основе tiktoken): управляющие токены, шаблоны чата, вызов инструментов на уровне токенов | 4.2 | ★★★ |
sampling/ | Температура, top-k, top-p — с наглядными объяснениями | 4.1 | ★★ |
quantization/ | Зачем квантовать, формат BF16 и методы GGUF, GPTQ, AWQ, EXL2, bitsandbytes | 7.2 | ★★ |
prompting/prompt_optimization.md | Оптимизация промптов | 8.4 | ★ |
Сторонние инструменты (папка third_party/)
Заголовок раздела «Сторонние инструменты (папка third_party/)»Около сорока рецептов от партнёров: LangChain и LangGraph, LlamaIndex, Haystack, векторные БД (Chroma, Pinecone, Neo4j),
наблюдаемость (Langfuse, Arize Phoenix, OpenLIT), интерфейсы (Gradio, Streamlit, Chainlit), локальный запуск через
Ollama (Ollama/function_calling_local.ipynb — вызов функций на локальной модели). Берите их, когда уже выбрали
конкретный фреймворк.
Перевод: «RAG Basics with Mistral AI»
Заголовок раздела «Перевод: «RAG Basics with Mistral AI»»Оригинал: mistral/rag/basic_RAG.ipynb, MIT. Выводы ячеек — из сохранённого в репозитории запуска.
(В оригинале в начале — схема RAG rag.png. Ниже — её упрощённая версия.)
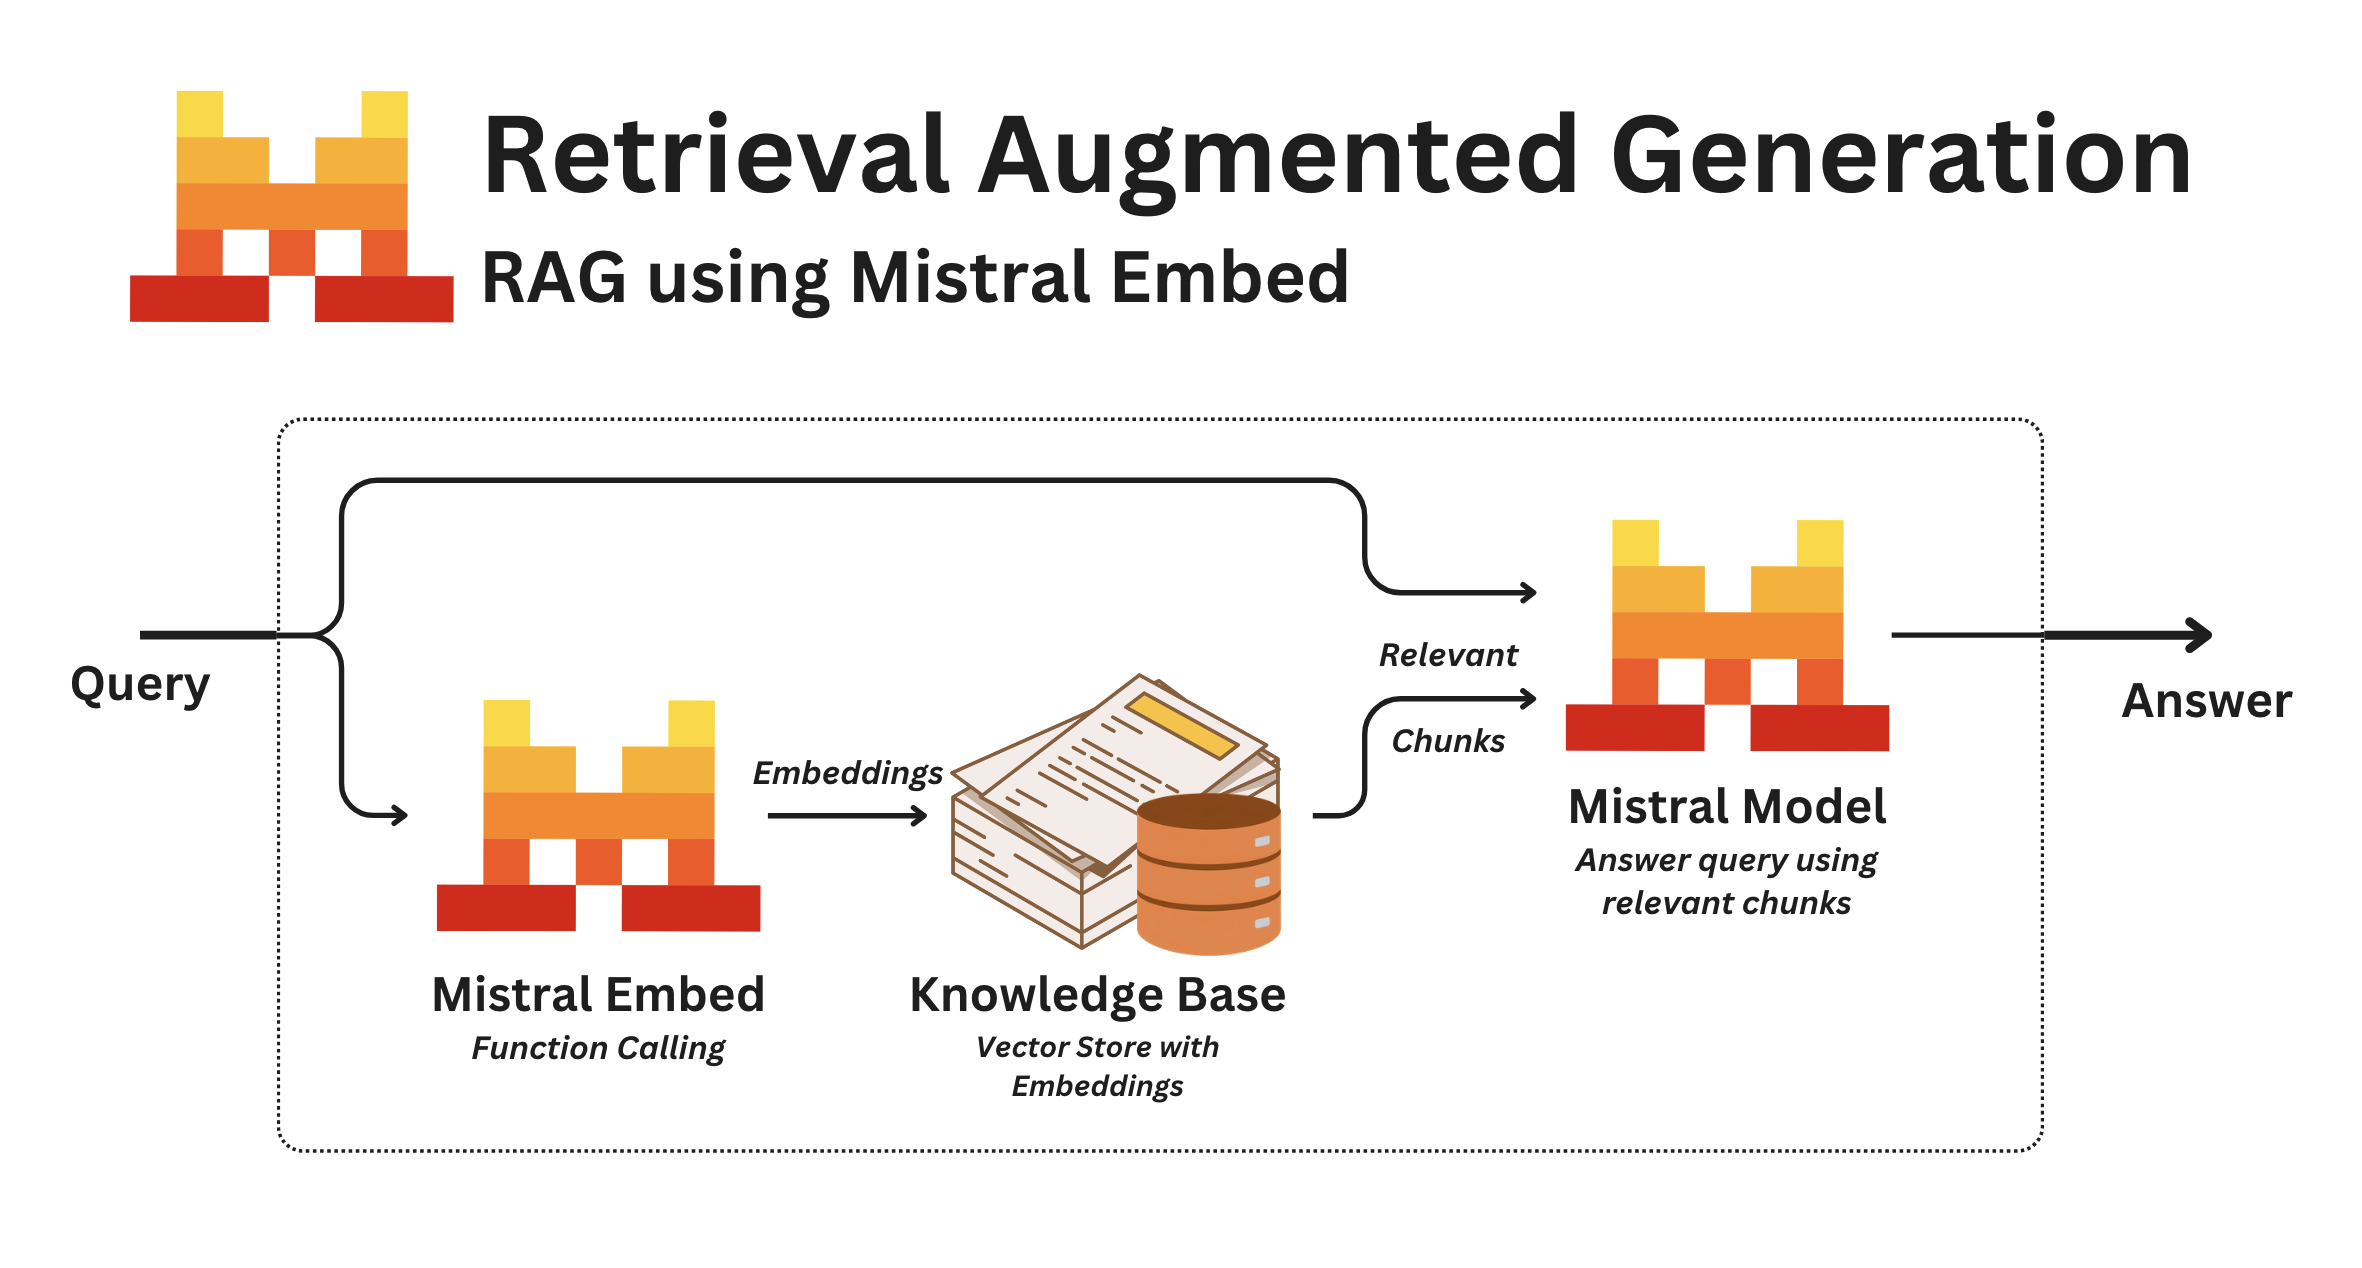
flowchart LR
D["Документ"] --> C["Фрагменты"] --> E1["Эмбеддинги<br/>фрагментов"] --> V[("Векторный индекс")]
Q["Вопрос"] --> E2["Эмбеддинг<br/>вопроса"] --> V
V --> R["Похожие<br/>фрагменты"] --> P["Промпт:<br/>контекст + вопрос"] --> L["LLM"] --> A["Ответ"]Генерация, дополненная поиском (генерация с дополнением извлечёнными даннымигенерация с дополнением извлечёнными данными (RAG)EN retrieval-augmented generation (RAG), Retrieval Augmented Generation) — подход, который объединяет возможности LLM и систем информационного поиска. Он полезен, чтобы отвечать на вопросы или создавать текст с опорой на внешние знания. В стандартном RAG два главных шага:
- Поиск (retrieval): найти нужную информацию в базе знаний — часто с помощью текстовых эмбеддингов, которые хранятся в векторном хранилище;
- Генерация (generation): вставить найденную информацию в промпт, чтобы LLM на её основе сгенерировала ответ.
В этом руководстве мы разберём совсем простой пример RAG на наших моделях.
RAG с нуля
Заголовок раздела «RAG с нуля»Этот раздел проведёт вас через сборку простого RAG с нуля. У нас две цели: во-первых, дать полное понимание того, как RAG работает изнутри, и развеять ореол тайны вокруг его механизмов; во-вторых, дать вам основу, достаточную, чтобы построить RAG с минимумом зависимостей.
Импорт нужных пакетов
Заголовок раздела «Импорт нужных пакетов»Первый шаг — установить пакеты mistralai и faiss-cpu и импортировать нужное:
! pip install faiss-cpu mistralaifrom mistralai.client import Mistralimport requestsimport numpy as npimport faissimport getpassimport os
if not os.environ.get("MISTRAL_API_KEY"): os.environ["MISTRAL_API_KEY"] = getpass.getpass("Mistral API key: ")
client = Mistral(os.environ["MISTRAL_API_KEY"])Получаем данные
Заголовок раздела «Получаем данные»В этом очень простом примере возьмём эссе Пола Грэма:
response = requests.get('https://raw.githubusercontent.com/run-llama/llama_index/main/data/paul_graham_essay.txt')text = response.textПри желании эссе можно сохранить в локальный файл:
with open('essay.txt', 'w') as f: f.write(text)Делим документ на фрагменты
Заголовок раздела «Делим документ на фрагменты»В RAG-системе очень важно разбить документ на фрагменты (chunks) поменьше: так на этапе поиска эффективнее находить и извлекать самую нужную информацию.
В этом примере мы просто режем текст по символам — по 2048 символов во фрагменте — и получаем 37 фрагментов.
chunk_size = 2048chunks = [text[i:i + chunk_size] for i in range(0, len(text), chunk_size)]len(chunks)Вывод:
37На что обратить внимание
Заголовок раздела «На что обратить внимание»- Размер фрагмента. В зависимости от задачи может понадобиться подобрать размер фрагментов и их перекрытие (overlap) экспериментально, чтобы RAG работал лучше всего. Например, маленькие фрагменты бывают полезнее при поиске: в больших фрагментах часто много «воды», которая размывает смысловое представление. Поэтому фрагменты поменьше помогают RAG-системе точнее находить и извлекать нужную информацию. Но стоит учитывать и минусы маленьких фрагментов: растут время обработки и затраты вычислений.
- Как резать. Проще всего резать текст по символам, но есть и другие варианты — в зависимости от задачи и структуры документа. Например, чтобы не превысить лимит токенов в запросах к API, текст может понадобиться резать по токенам. Чтобы фрагменты были цельными, полезно резать по предложениям, абзацам или HTML-заголовкам. Если вы работаете с кодом, обычно советуют резать по осмысленным кускам кода — например, с помощью парсера абстрактного синтаксического дерева (AST).
Создаём эмбеддинги для каждого фрагмента
Заголовок раздела «Создаём эмбеддинги для каждого фрагмента»Для каждого фрагмента текста нужно получить текстовый эмбеддингэмбеддинг, векторное представлениеEN embedding — числовое представление текста в векторном пространстве. Ожидается, что близкие по смыслу слова находятся в векторном пространстве рядом, то есть на меньшем расстоянии.
Чтобы получить эмбеддинг, воспользуемся эндпоинтом эмбеддингов в API Mistral и моделью mistral-embed. Создадим
функцию get_text_embedding, которая получает эмбеддинг одного фрагмента, а затем генератором списка получим эмбеддинги
всех фрагментов.
def get_text_embedding(input): embeddings_batch_response = client.embeddings.create( model="mistral-embed", inputs=input ) return embeddings_batch_response.data[0].embeddingtext_embeddings = np.array([get_text_embedding(chunk) for chunk in chunks])text_embeddings.shapeВывод:
(37, 1024)text_embeddingsВывод (начало):
array([[-0.03979492, 0.07733154, 0.00013709, ..., -0.01274109, -0.02101135, -0.00264168], [-0.03152466, 0.07226562, 0.02961731, ..., -0.01079559, -0.01189423, -0.00821686], ...Если хотите узнать об эмбеддингах больше, загляните в наши рецепты, посвящённые этой теме.
Загружаем в векторную базу данных
Заголовок раздела «Загружаем в векторную базу данных»Когда эмбеддинги готовы, их обычно сохраняют в векторную базу данных (векторная база данныхвекторная база данныхEN vector database), чтобы эффективно обрабатывать и искать. Векторных баз много. В нашем простом примере мы используем открытую векторную базу Faiss — она умеет быстро искать похожие векторы.
В Faiss мы создаём экземпляр класса Index — он задаёт структуру индекса векторной базы. Затем добавляем в эту структуру эмбеддинги текстов.
d = text_embeddings.shape[1]index = faiss.IndexFlatL2(d)index.add(text_embeddings)На что обратить внимание
Заголовок раздела «На что обратить внимание»- Векторная база данных. Выбирая векторную базу, учитывайте несколько факторов: скорость, масштабируемость, управление в облаке, продвинутую фильтрацию, открытый или закрытый исходный код.
Создаём эмбеддинг вопроса
Заголовок раздела «Создаём эмбеддинг вопроса»Когда пользователь задаёт вопрос, для него тоже нужно получить эмбеддинг — той же моделью, что и раньше.
question = "What were the two main things the author worked on before college?"question_embeddings = np.array([get_text_embedding(question)])question_embeddings.shapeВывод:
(1, 1024)(Вопрос: «Какими двумя главными делами занимался автор до колледжа?»)
На что обратить внимание
Заголовок раздела «На что обратить внимание»- Гипотетические эмбеддинги документов (HyDE). Иногда сам вопрос пользователя — не лучший запрос для поиска нужного контекста. Бывает эффективнее сгенерировать по вопросу гипотетический ответ или гипотетический документ и искать похожие фрагменты по эмбеддингу этого сгенерированного текста.
Ищем похожие фрагменты в векторной базе
Заголовок раздела «Ищем похожие фрагменты в векторной базе»Поиск по векторной базе выполняет index.search. Она принимает два аргумента: вектор-эмбеддинг вопроса и число похожих
векторов, которые нужно найти. Функция возвращает расстояния и индексы векторов, самых похожих на вектор вопроса.
По этим индексам мы достаём сами фрагменты текста.
D, I = index.search(question_embeddings, k=2) # возвращает id двух фрагментов с наибольшим сходствомprint(I)Вывод:
[[0 3]]retrieved_chunk = [chunks[i] for i in I.tolist()[0]]print(retrieved_chunk)Вывод (начало первого фрагмента):
['\n\nWhat I Worked On\n\nFebruary 2021\n\nBefore college the two main things I worked on, outside of school, were writing and programming. ...(«До колледжа, помимо школы, я в основном занимался двумя вещами: писал тексты и программировал».)
На что обратить внимание
Заголовок раздела «На что обратить внимание»- Методы поиска. Стратегий поиска много. В нашем примере показан простой поиск по сходству эмбеддингов. Если у данных есть метаданные, иногда лучше сначала отфильтровать данные по метаданным, а уже потом искать по сходству. Есть и статистические методы поиска — например, TF-IDF и BM25: они находят нужные фрагменты по частоте и распределению терминов в документе.
- Найденный документ. Всегда ли мы возвращаем найденный фрагмент как есть? Не всегда.
- Иногда хочется добавить больше контекста вокруг найденного фрагмента. Найденный фрагмент называют «дочерним» (child chunk), и цель — вернуть больший «родительский» фрагмент (parent chunk), которому он принадлежит.
- Иногда найденным документам полезно дать веса. Например, взвешивание по времени помогает находить самые свежие документы.
- Частая проблема поиска — «потеря в середине» (lost in the middle): информация из середины длинного контекста теряется. Наши модели старались смягчить эту проблему. Например, в задаче с ключом-паролем (passkey) наши модели показали, что умеют найти «иголку в стоге сена» — случайно вставленный ключ в длинном промпте длиной до 32 тыс. токенов. Но стоит поэкспериментировать и с перестановкой документов: не станет ли лучше, если самые нужные фрагменты поставить в начало и в конец.
Объединяем контекст и вопрос в промпт и генерируем ответ
Заголовок раздела «Объединяем контекст и вопрос в промпт и генерируем ответ»Наконец, найденные фрагменты можно передать модели как контекст внутри промпта. Вот шаблон промпта, в который входят и найденный текст, и вопрос пользователя.
prompt = f"""Context information is below.---------------------{retrieved_chunk}---------------------Given the context information, answer the provided user query.User Query: {question}Answer:"""(Перевод шаблона: «Ниже — контекстная информация. … С учётом контекстной информации ответь на запрос пользователя. Запрос пользователя: … Ответ:».)
def run_mistral(user_message, model = "mistral-medium-latest"): messages = [ { "role": "user", "content": user_message } ] chat_response = client.chat.complete( model=model, messages=messages ) return chat_response.choices[0].message.contentrun_mistral(prompt)Вывод:
'The two main things the author worked on before college were **writing** and **programming**.'(«До колледжа автор в основном занимался двумя вещами: писательством и программированием».)
На что обратить внимание
Заголовок раздела «На что обратить внимание»- Техники промптинга. При разработке RAG-системы можно использовать большинство техник промптинга. Например, с помощью few-shot — нескольких примеров в промпте — можно направлять ответы модели. Можно также явно указать модели, в каком формате отвечать.
В следующих разделах мы покажем, как сделать похожий простой RAG в популярных RAG-фреймворках. Начнём с LlamaIndex, а другие фреймворки добавим позже.
(Примечание переводчика: в текущей версии ноутбука раздела с LlamaIndex уже нет — вместо него ссылка на коммерческие
Search Kit и Agentic Search Kit от Mistral. Рецепты с LlamaIndex лежат в папке third_party/LlamaIndex/.)
Как повторить без ключа Mistral
Заголовок раздела «Как повторить без ключа Mistral»Что сделать руками
Заголовок раздела «Что сделать руками»- Повторите рецепт на своём документе — например, на русской статье из Википедии. Сравните размер фрагмента 2048 символов и 500 символов: какие фрагменты находятся по одному и тому же вопросу?
- Добавьте перекрытие фрагментов (например, 200 символов) и проверьте, не теряется ли ответ на границе двух фрагментов.
- Попробуйте HyDE: попросите модель сначала написать гипотетический ответ, найдите фрагменты по его эмбеддингу и сравните с поиском по самому вопросу.
- Откройте
function_calling/function_calling.ipynbи сравните его с уроком «Инструменты и MCP»: какие шаги цикла вызова инструмента совпадают?
Что читать дальше
Заголовок раздела «Что читать дальше»- Документация Mistral: docs.mistral.ai, раздел Cookbooks.
- Библиотека mistral-common — эталонная реализация токенизаторов,
о которых рассказывает
concept-deep-dive/tokenization/. - В курсе: путеводитель по Llama Cookbook — те же задачи у Meta.
Словарик
Заголовок раздела «Словарик»| EN | RU |
|---|---|
| Retrieval-Augmented Generation (RAG) | генерация, дополненная поиском |
| retrieval, generation | поиск (извлечение), генерация |
| chunk, chunk size, overlap | фрагмент, размер фрагмента, перекрытие |
| embedding | эмбеддинг, векторное представление |
| vector store / vector database | векторное хранилище / векторная база данных |
| similarity search | поиск по сходству |
| Hypothetical Document Embeddings (HyDE) | эмбеддинги гипотетических документов |
| parent / child chunk | родительский / дочерний фрагмент |
| lost in the middle | «потеря в середине» |
| function calling | вызов функций |
| guardrails, moderation | защитные фильтры, модерация |