How To Scale Your Model, глава 3: шардированные матрицы и как их умножать
Перевод третьей главы книги Google DeepMind: нотация шардирования A[I_X, J_Y], четыре случая умножения шардированных матриц, коллективные операции AllGather, ReduceScatter, AllReduce и AllToAll, их стоимость и совмещение связи с вычислениями.
Здесь мы объясним, как устроены четыре главные коммуникационные операции (примитива), используемые для обучения больших моделей, и как они работают на TPU и GPU. — подзаголовок главы.
Нотация разбиения и коллективные операции
Заголовок раздела «Нотация разбиения и коллективные операции»Когда мы обучаем LLM на десяти тысячах TPU или GPU, мы абстрактно выполняем то же вычисление, что и при обучении на одном. Разница в том, что наши массивы не помещаются в HBM одного TPU/GPU, поэтому их приходится делить1. Это называют «шардированием» (sharding) или «разбиением» (partitioning) массивов. Искусство масштабирования — понять, как шардировать модель, чтобы вычисления оставались эффективными.
Рисунок в оригинале (sharding-example.png): массив формы A[I, J] шардирован между 4 устройствами. Оба измерения поровну разделены между 2 устройствами с шардированием A[IX, JY]. Каждый TPU хранит 1/4 всей памяти.
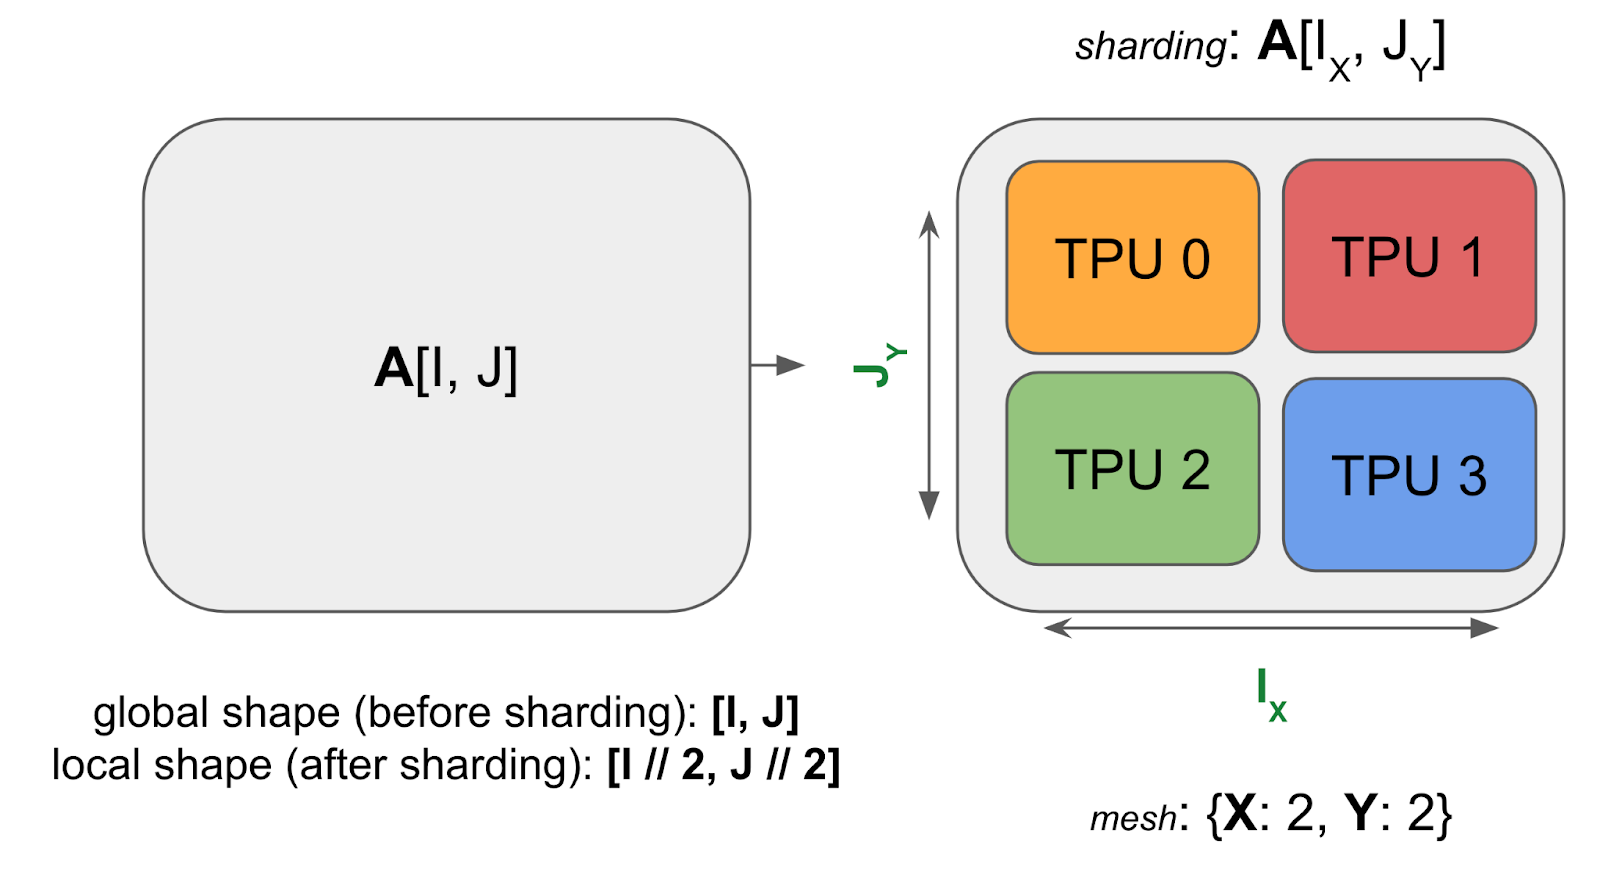
Заметьте: у шардированного массива по-прежнему та же глобальная, или логическая форма, что и у нешардированного,
например (4, 128), но есть и локальная форма на устройстве, например (2, 64), — она показывает реальный размер
в байтах, который хранит каждый TPU (на рисунке выше каждый TPU хранит ¼ всего массива). Обобщим это на произвольные
массивы.
Единая нотация шардирования
Заголовок раздела «Единая нотация шардирования»Чтобы описать, как тензор разделён на блоки между устройствами, мы используем вариант нотации с именованными осями: предполагаем, что есть двумерная или трёхмерная сетка устройств, называемая сеткой устройств (device mesh), где каждой оси дано имя оси сетки, например X, Y и Z. Тогда расположение данных матрицы по сетке устройств можно задать, описав, как каждое именованное измерение массива разделено по физическим осям сетки. Такое назначение мы называем шардированием (sharding).
Пример (рисунок выше). Для рисунка выше:
- Сетка:
Mesh(devices=((0, 1), (2, 3)), axis_names=('X', 'Y'))— 4 TPU в сетке 2×2 с именами осей и . - Шардирование: — первую ось, , шардировать по оси сетки , а вторую, , — по оси сетки . Значит, каждый шард хранит массива.
Вместе это говорит нам, что локальная форма массива (размер шарда, который хранит отдельное устройство) — , где — размер первого измерения A, а — второго.
Быстрый вопрос [двумерное шардирование по одной оси массива]. Рассмотрим массив fp32[1024, 4096] с шардированием
и сеткой {'X': 8, 'Y': 2}. Сколько данных хранит каждое устройство? Сколько времени займёт загрузка
этого массива из HBM на H100 (пропускная способность памяти 3.4e12 на чип)?
Ответ
шардирует первое измерение (I) сразу по аппаратным осям X и Y. Здесь локальная форма —
. Глобальная форма — fp32[1024, 4096], значит,
локальная — fp32[64, 4096].
У каждого GPU 4 * 64 * 4096 = 1MiB байт, так что загрузка займёт около 1e6 / 3.4e12 = 294ns, хотя, вероятно, заметно
дольше из-за разных накладных расходов — массив очень мал.
Как это выглядит. Представим себе эти шардирования на примере двумерного массива, разделённого между 4 устройствами (рисунки sharding-colored1–6 в оригинале, где каждое устройство закрашено своим цветом):
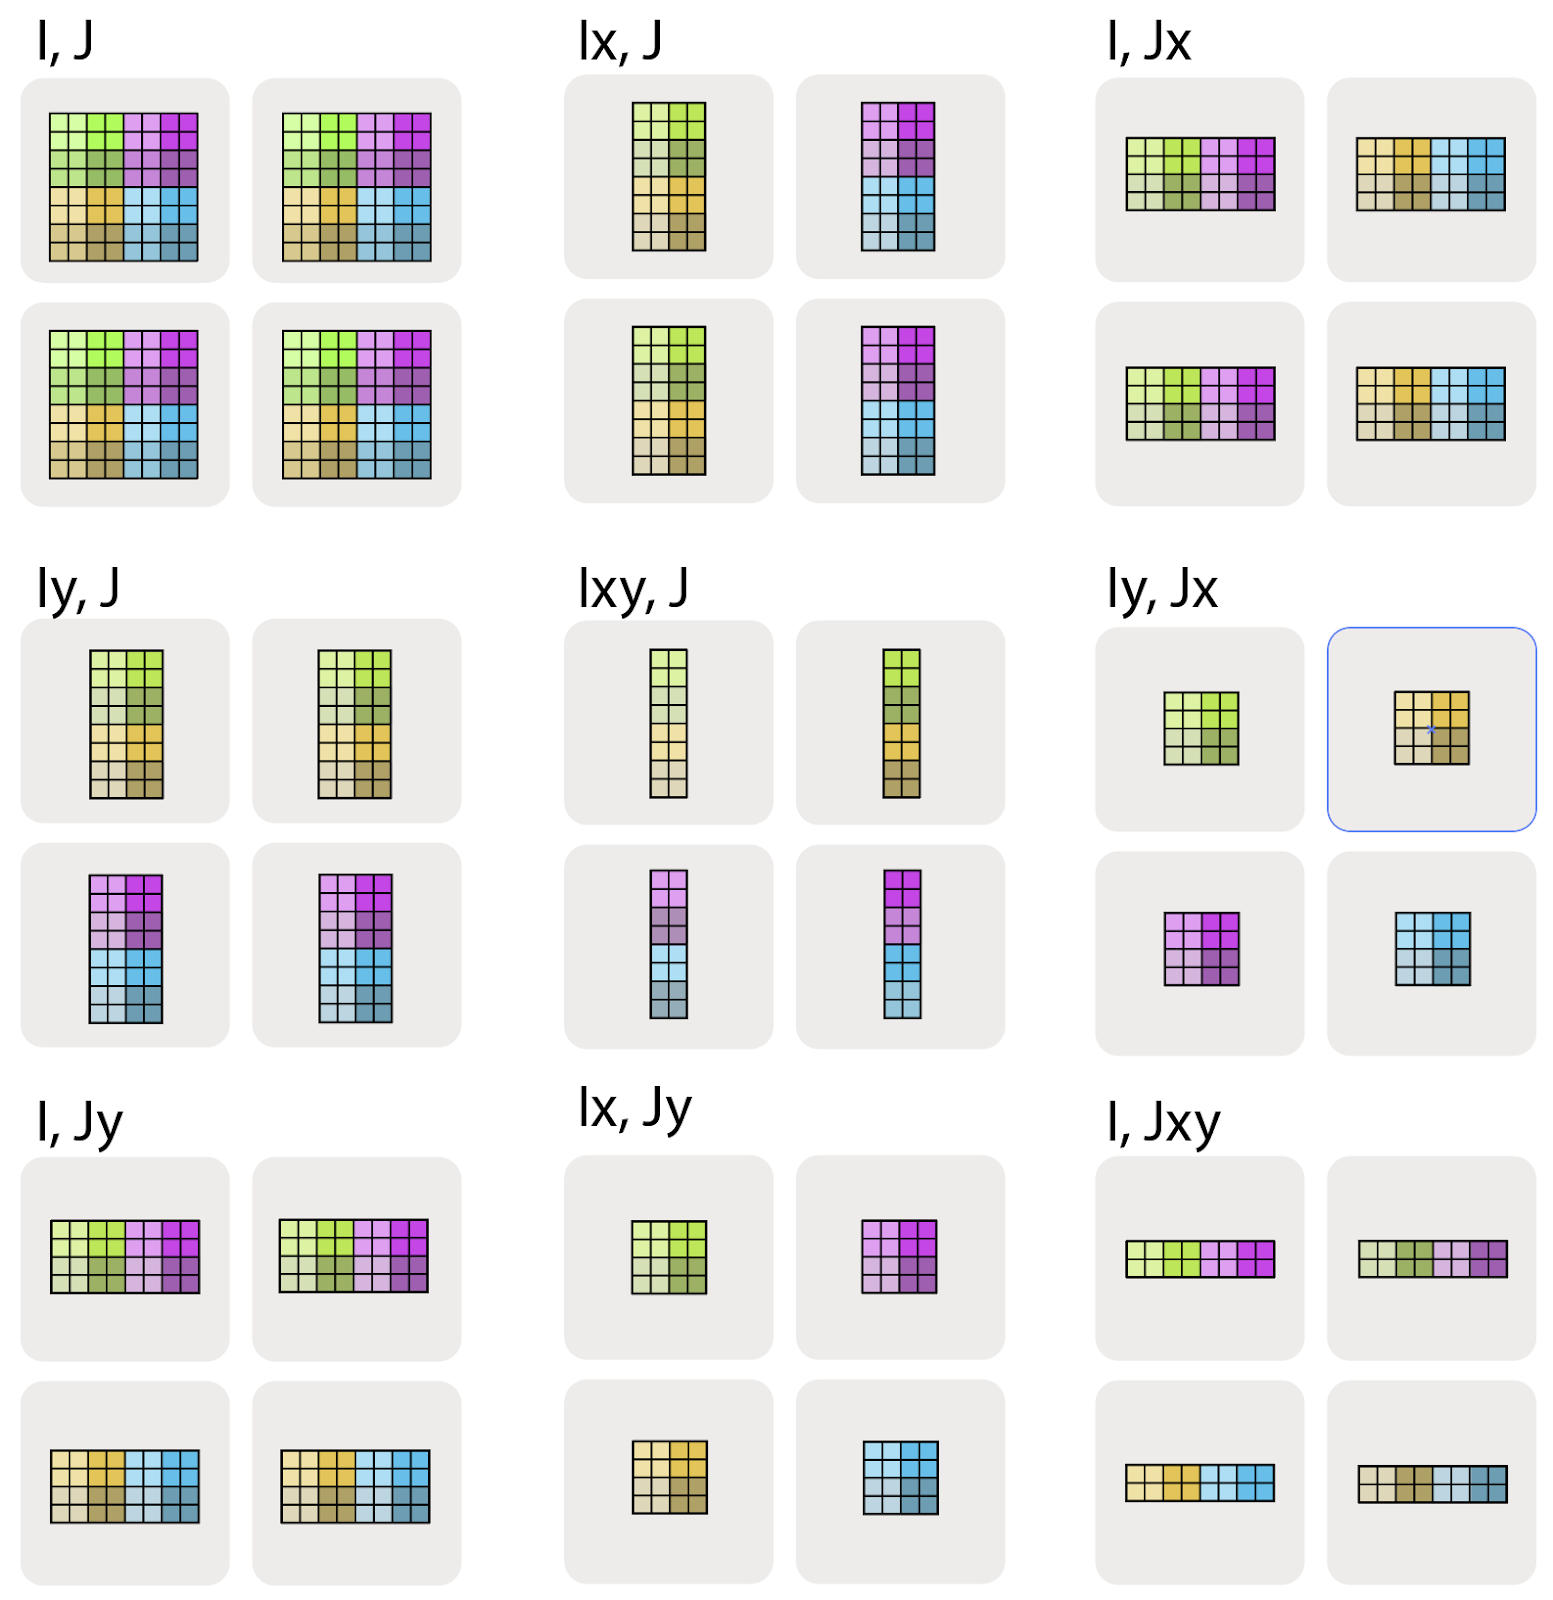
- Полностью реплицированную (размноженную) форму матрицы пишем просто , без назначения шардирования. Это значит, что каждое устройство хранит полную копию всей матрицы.
- То, что одно из измерений разделено по оси сетки, обозначаем нижним индексом — осью сетки. Например, значит, что логическая ось I разделена по измерению сетки X, а измерение J не разделено, и блоки остаются частично реплицированными по оси сетки Y.
- значит, что логическая ось I разделена по оси сетки X, а измерение J — по оси сетки Y.
- значит, что оси сетки X и Y мы рассматриваем как одно большое «сплющенное» измерение и делим именованную ось I между всеми устройствами. Порядок нескольких осей сетки в индексе важен: он задаёт порядок обхода сетки при разбиении.
Наконец, нельзя шардировать несколько именованных осей по одному и тому же измерению сетки. Например, — бессмысленное, запрещённое шардирование. Как только измерение сетки использовано для шардирования одного измерения массива, оно в каком-то смысле «израсходовано».
Быстрый вопрос. Пусть A — массив формы int8[128, 2048] с шардированием на сетке
Mesh({'X': 2, 'Y': 8, 'Z': 2}) (всего 32 устройства). Сколько памяти A занимает на устройстве? Сколько всего на всех
устройствах?
Ответ
Массив A шардирован по X и Y и реплицирован по Z, так что на устройстве он имеет форму
int8[128 / (2 * 8), 2048] = int8[8, 2048] и размер 8 * 2048 = 16,384 байт. Поскольку он реплицирован по Z, а внутри
каждой Z-плоскости полностью шардирован по X и Y, получается 2 полные копии исходного массива (по одной на Z-плоскость).
Значит, всего на всех устройствах: размер исходного массива × число реплик по Z = 128 × 2048 × 2 = 512 КиБ. Проверка:
32 устройства × 16 384 байт = 512 КиБ.
Как это описать в коде?
Заголовок раздела «Как это описать в коде?»До сих пор мы обходили стороной код, но сейчас хороший момент заглянуть вперёд. JAX использует синтаксис именованного шардирования, очень близкий к абстрактному синтаксису выше. Подробнее мы поговорим об этом в главе 10, а пока — краткий анонс. Поиграть с этим можно в Google Colab и, профилируя результат, посмотреть, как JAX обрабатывает разные шардирования. Этот фрагмент делает 3 вещи:
- Создаёт jax.Mesh, который раскладывает наши 8 TPU в сетку 4×2 с именами осей ‘X’ и ‘Y’.
- Создаёт матрицы A и B, где A шардирована по обоим измерениям, а B — по выходному.
- Компилирует и выполняет простое умножение матриц, которое возвращает шардированный массив.
import jaximport jax.numpy as jnp
# Создаём сетку! Работаем на срезе TPU v2-8 4x2 с именами осей 'X' и 'Y'.# Тип оси Auto говорит JAX позволить компилятору XLA самому выводить промежуточные шардирования.assert len(jax.devices()) == 8Auto = jax.sharding.AxisType.Automesh = jax.make_mesh(axis_sizes=(4, 2), axis_names=('X', 'Y'), axis_types=(Auto, Auto))
# Небольшая вспомогательная функция для задания шардирования. PartitionSpec — это наше# шардирование (отображение осей массива в имена осей сетки).def P(*args):  return jax.NamedSharding(mesh, jax.sharding.PartitionSpec(*args))
# Шардируем и A, и B по несворачиваемому измерению, а A — ещё и по сворачиваемому.A = jnp.zeros((8, 2048), dtype=jnp.bfloat16, device=P('X', 'Y'))B = jnp.zeros((2048, 8192), dtype=jnp.bfloat16, device=P(None, 'Y'))
# На этих шардированных массивах можно выполнить умножение! out_shardings говорит, как# шардировать результат. Остальное шардирование JAX/XLA сделают за нас.y = jax.jit(lambda A, B: jnp.einsum('BD,DF->BF', A, B), out_shardings=P('X', 'Y'))(A, B)
Самое приятное в JAX — эти массивы ведут себя так, будто они не шардированы! B.shape покажет глобальную, или логическую,
форму (2048, 8192). Чтобы увидеть локальное шардирование, нужно посмотреть на B.addressable_shards. С этими массивами
можно выполнять операции, и JAX попытается понять, как их транслировать (broadcast) или менять форму, чтобы выполнить
операции. Например, в примере выше локальная форма A — [2, 1024], а B — [2048, 4096]. JAX/XLA автоматически
добавят между этими массивами связь, необходимую для итогового умножения.
Вычисления с шардированными массивами
Заголовок раздела «Вычисления с шардированными массивами»Если у вас массив данных, распределённый между многими устройствами, и вы хотите выполнять над ним математические операции, каковы накладные расходы на шардирование и данных, и вычислений?
Очевидно, это зависит от вычисления.
- Для поэлементных операций распределённость массива не даёт накладных расходов.
- Когда нужно выполнять операции над элементами, лежащими на многих устройствах, всё усложняется. К счастью, в машинном обучении почти все вычисления — это умножения матриц, а их анализировать сравнительно просто.
Остаток раздела — о том, как умножать шардированные матрицы. В первом приближении это значит перемещать куски матриц так, чтобы каждый кусок можно было полностью перемножить или просуммировать. Каждое шардирование потребует своей связи. Например, можно перемножить вообще без связи, потому что сворачиваемое измерение (contracting dimension; J — то, по которому мы на самом деле суммируем) не шардировано. Но если бы мы хотели получить нешардированный результат (), пришлось бы скопировать на каждое устройство либо и , либо (с помощью AllGather). У этих двух вариантов разная стоимость связи, так что её нужно посчитать и выбрать наименьшую.
Это удобно понимать через «блочное умножение матриц»
Здесь полезно вспомнить понятие «блочной матрицы» — матрицы, составленной из матриц:
где каждый — блок 2×2. У умножения матриц есть приятное свойство: если сомножители записаны через блоки, произведение можно записать через блочные умножения по обычному правилу:
Значит, распределённое умножение матриц сводится к тому, чтобы перемещать эти шардированные блоки по сети, выполнять локальные умножения блоков и суммировать результаты. Вопрос лишь в том, какую связь добавить и сколько она стоит.
Удобно, что все возможные шардирования сводятся примерно к 4 случаям, и для каждого есть правило, какую связь добавить:
- Случай 1: ни один вход не шардирован по сворачиваемому измерению. Можно перемножить локальные шарды без всякой связи.
- Случай 2: у одного входа сворачиваемое измерение шардировано. Обычно делают «AllGather» шардированного входа по сворачиваемому измерению.
- Случай 3: оба входа шардированы по сворачиваемому измерению. Можно перемножить локальные шарды, а затем сделать «AllReduce» результата.
- Случай 4: у обоих входов несворачиваемое измерение шардировано по одной и той же оси. Двигаться дальше нельзя, пока не сделан AllGather одного из входов.
Это можно считать просто правилами, которым нужно следовать, но полезно понимать, почему они верны и сколько стоят. Разберём каждое подробно.
flowchart TD
S["Умножаем A · B, сворачивая по J"] --> Q1{"J шардировано?"}
Q1 -->|"ни у кого"| Q4{"Несворачиваемые оси шардированы по одной оси сетки?"}
Q4 -->|"нет"| C1["Случай 1: связь не нужна"]
Q4 -->|"да"| C4["Случай 4: сначала AllGather одного входа"]
Q1 -->|"у одного"| C2["Случай 2: AllGather этого входа, затем локальный матмул"]
Q1 -->|"у обоих по одной оси"| C3["Случай 3: локальный матмул, затем AllReduce или ReduceScatter"]Случай 1: ни у одного сомножителя сворачиваемое измерение не шардировано
Заголовок раздела «Случай 1: ни у одного сомножителя сворачиваемое измерение не шардировано»Лемма: при умножении шардированных матриц вычисление корректно и результат следует шардированию входов, если только не шардировано сворачиваемое измерение и обе матрицы не шардированы по одной и той же оси. Например, вот это работает отлично
безо всякой связи, и даёт тензор, шардированный по обоим аппаратным измерениям X и Y. Подумайте, почему так. По сути, вычисление не зависит от шардирования, поскольку у каждой строки батча есть свой локальный кусок сворачиваемой оси, который можно перемножить и просуммировать. Все эти случаи работают и следуют правилу:
Ни у A, ни у B сворачиваемое измерение J не шардировано, поэтому можно просто выполнить локальные блочные умножения входов, и результаты уже будут шардированы так, как нужно. Когда у обоих сомножителей несворачиваемые измерения шардированы по одной оси, это уже не так (подробнее — в разделе о недопустимых шардированиях).
Случай 2: у одного сомножителя сворачиваемое измерение шардировано
Заголовок раздела «Случай 2: у одного сомножителя сворачиваемое измерение шардировано»Посмотрим, что делать, когда один вход A шардирован по сворачиваемому измерению J, а B полностью реплицирован:
Просто перемножить локальные куски A и B нельзя: нужно просуммировать по всему сворачиваемому измерению A, а оно разделено по оси X. Обычно сначала делают «AllGather» шардов A, чтобы у каждого устройства была полная копия, и только потом умножают на B:
Так само умножение целиком выполняется на каждом устройстве.
Заметьте: если B не шардирована по X, можно также выполнить локальное частичное умножение, а затем просуммировать (сделать AllReduce) шардированные частичные суммы — так вычисления тоже шардируются, но связь обычно дороже. Иногда это быстрее, хотя на практике B обычно тоже шардирована. Когда это лучше, разбирает вопрос 4 ниже.
Что такое AllGather? AllGather — первый базовый коммуникационный примитив MPI, который мы обсудим. AllGather снимает шардирование по оси и собирает шарды, разбросанные по устройствам, на каждом устройстве вдоль этой оси. В нашей нотации AllGather убирает нижний индекс у набора осей, например
Убирать все индексы данного измерения не обязательно: например, — тоже AllGather, только по одной оси. Также AllGather может понадобиться, чтобы снять шардирование несворачиваемого измерения, например в умножении
Можно сначала сделать AllGather A, сняв шардирование входа, а можно выполнить шардированное умножение и затем сделать AllGather результата C.
Как на самом деле выполняется AllGather? Чтобы выполнить одномерный AllGather вдоль одной оси TPU (кольца), каждый TPU, по сути, передаёт свой шард по кольцу, пока копия не окажется у каждого устройства2.
Анимация в оригинале (all-gather.gif): AllGather на 8 устройствах TPU или GPU. Каждое устройство начинает с 1/8 массива и заканчивает полной копией.
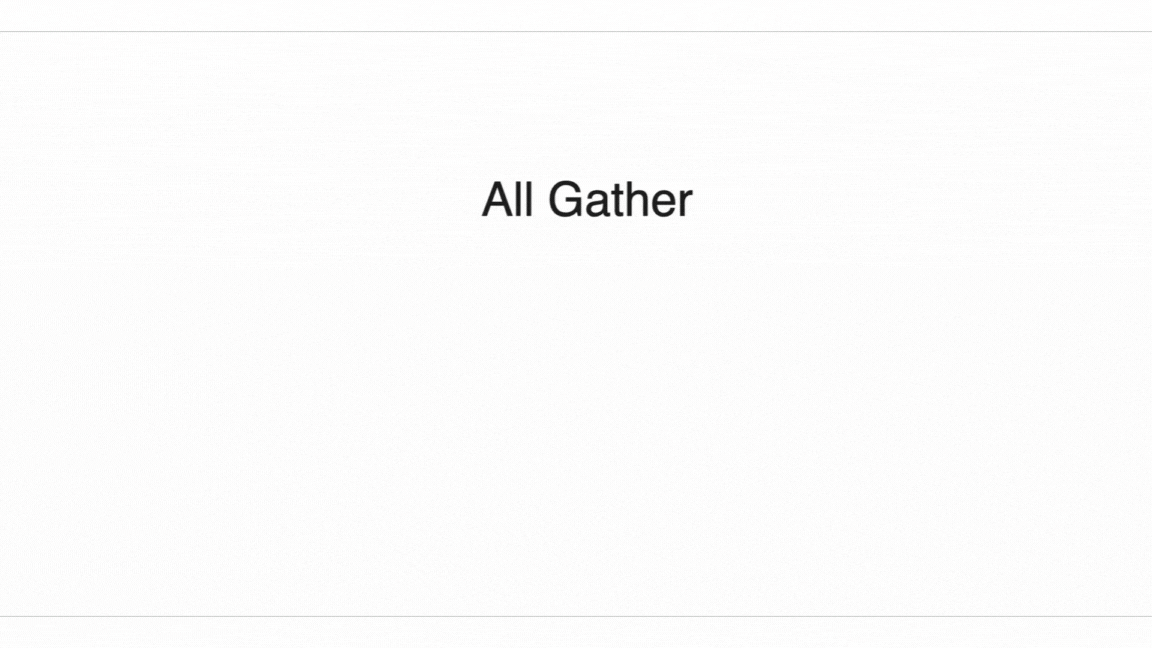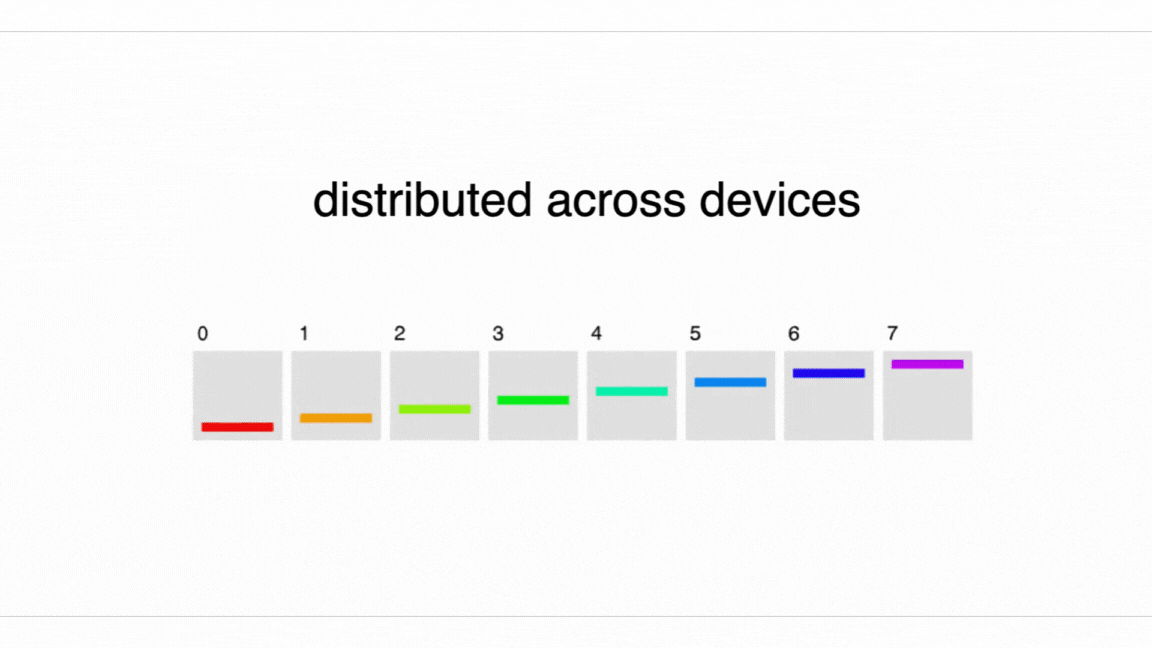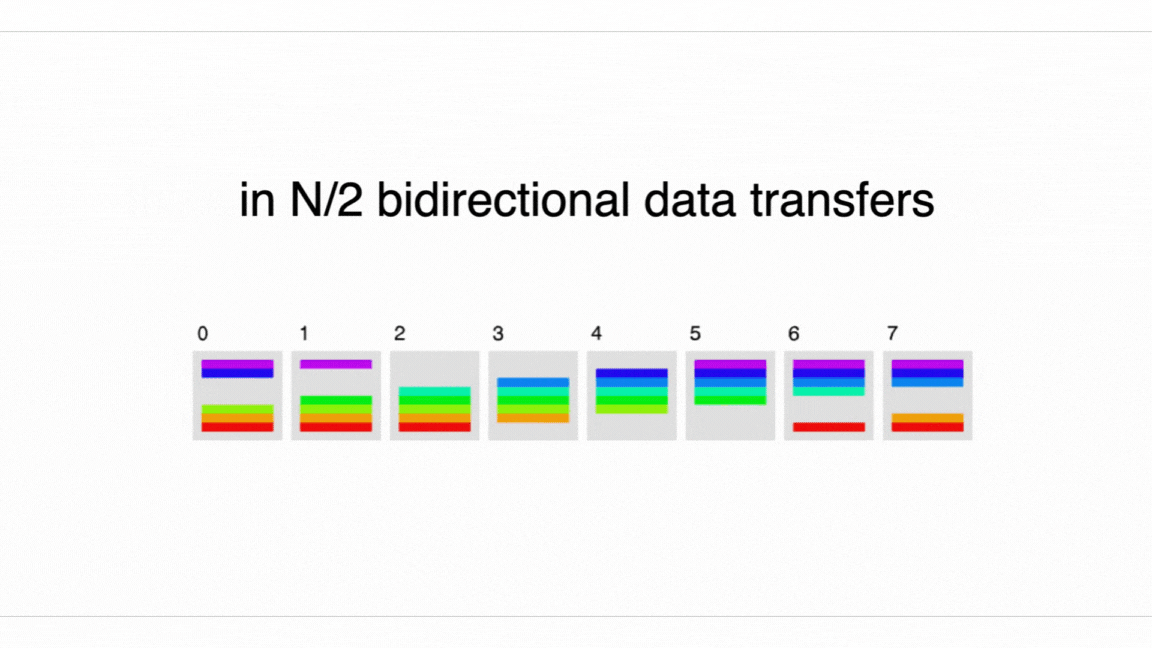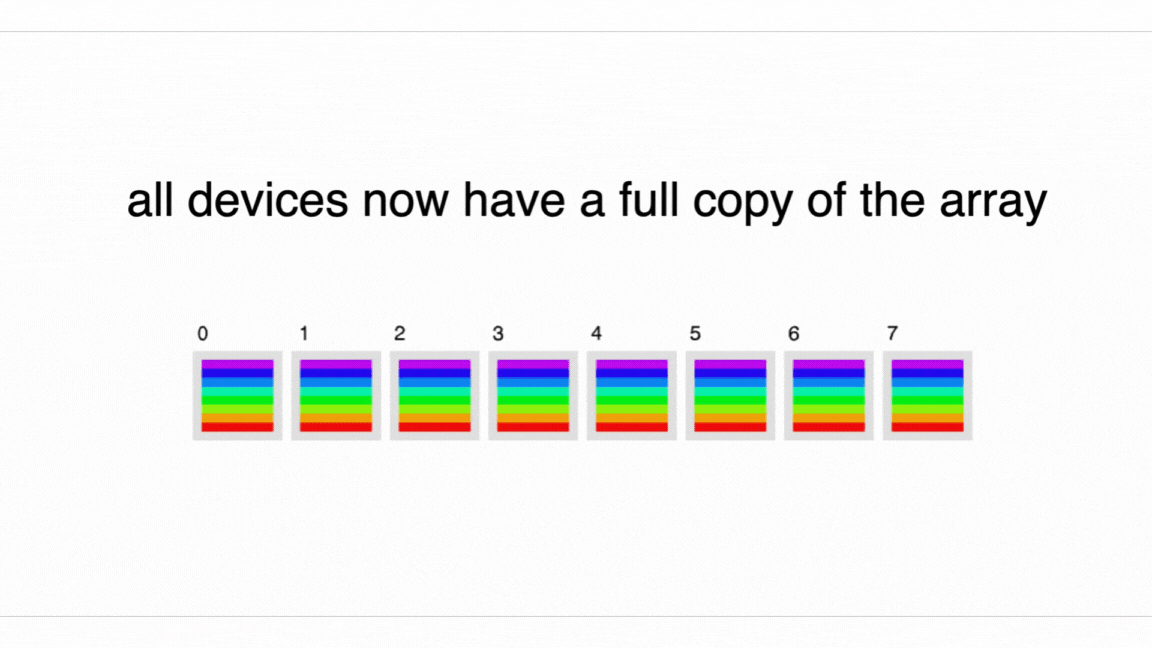
AllGather можно делать в одном направлении или в обоих (в анимации — оба). При одном направлении каждый TPU отправляет куски размером за переходов по кольцу. При двух — переходов с кусками размером .
Сколько это длится? Возьмём двунаправленный AllGather и посчитаем его время. Пусть — число байт в массиве, а — число шардов по сворачиваемому измерению. Тогда, как видно из анимации, на каждом переходе в каждую сторону отправляется байт, так что каждый переход занимает
где — двусторонняя пропускная способность ICI3. Чтобы дойти до каждого TPU, нужно переходов4, так что вся операция занимает
Заметьте: это не зависит от ! Это поразительно: хотя наши TPU связаны только локально, локальность связей роли не играет. Узкое место — лишь скорость каждого канала.
О задержке ICI. У каждого перехода по каналу ICI есть собственные накладные расходы, не зависящие от объёма данных. Обычно это около 1 мкс. Значит, когда массив очень мал и каждый переход занимает меньше 1 мкс, можно попасть в режим, ограниченный задержкой (latency-bound), где время зависит от .
Подробности
Пусть — минимальное время одного перехода. Тогда
поскольку переходов . Для больших редукций или сборов мы надёжно ограничены пропускной способностью: данных так
много, что накладные расходы на переход практически не важны. Но для маленьких массивов (например, при сэмплировании
из модели) они уже не пренебрежимы, а пропускная способность ICI не важна: мы ограничены только задержкой. Иначе говоря,
для конкретного TPU, например TPU v5e с односторонней пропускной способностью ICI 4.5e10, отправка любого буфера меньше
4.5e10 * 1e-6 = 45kB будет ограничена задержкой.
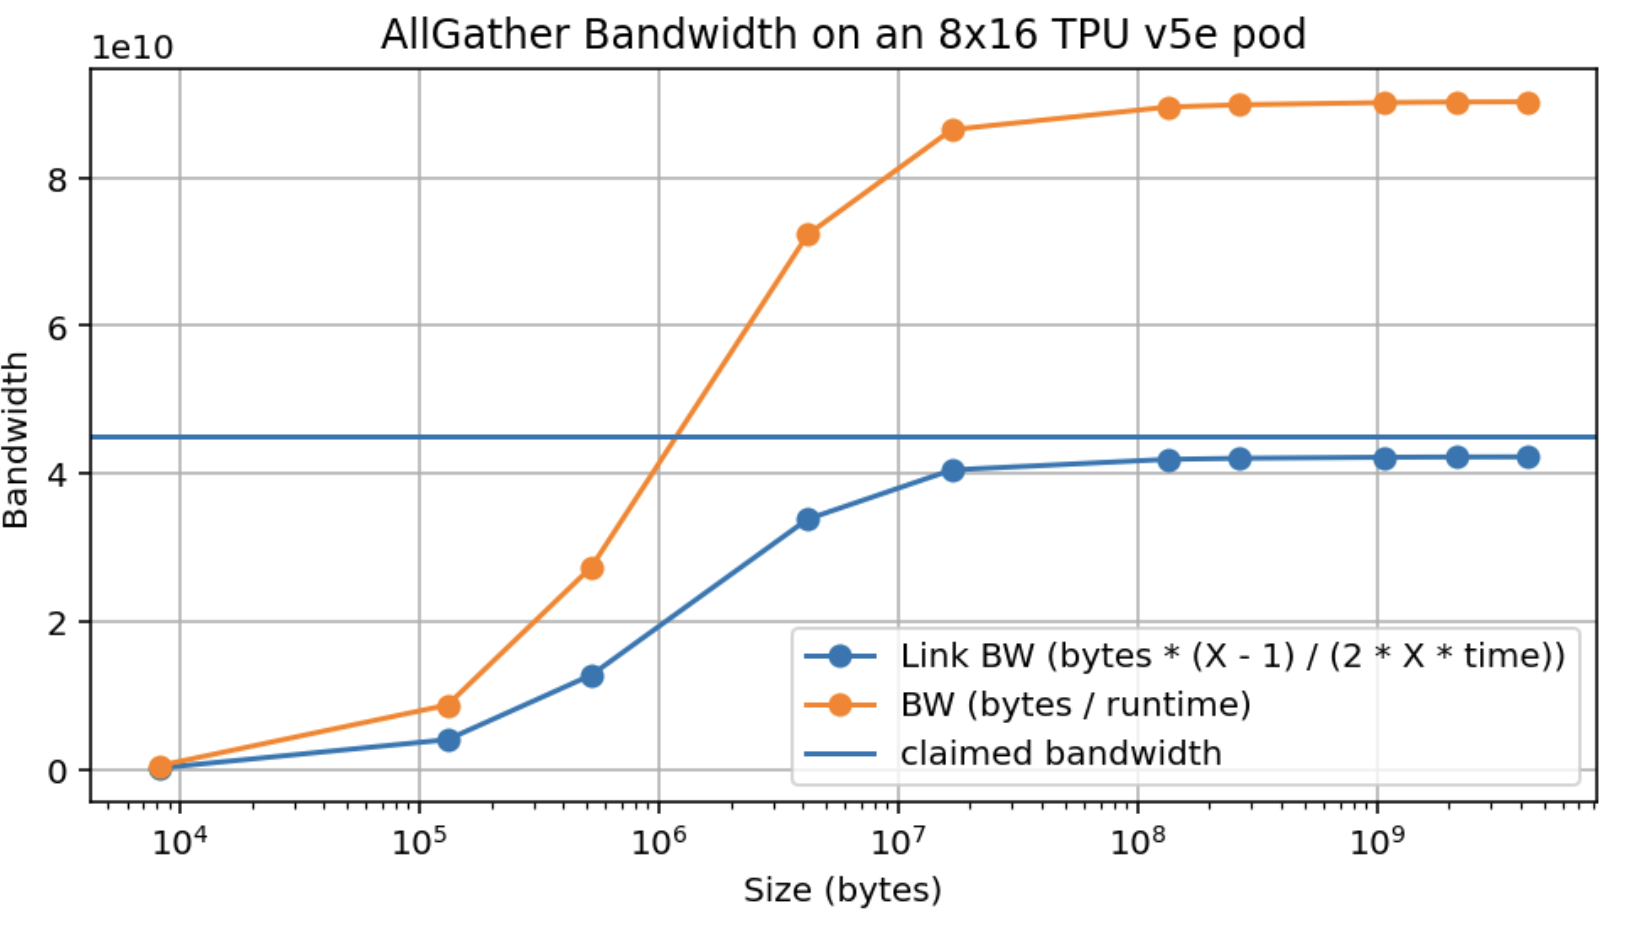
Замер пропускной способности AllGather на срезе TPU v5e 8x16 (all-gather-bandwidth.png
в оригинале; массив шардирован по оси 16, так что есть полное двунаправленное кольцо) показывает: достигается около 95%
заявленной пиковой пропускной способности (4.5e10), причём уже при массиве около 10 МБ, что при 16-путевом шардировании
даёт примерно 625 КБ на устройство (к слову, это гораздо лучше, чем у GPU).
Что, если делать AllGather по нескольким осям? Тогда у нас несколько измерений ICI, по которым можно вести сбор. Например, AllGatherXY([B, DXY]) работает по двум аппаратным осям сетки. Это увеличивает доступную пропускную способность в раз.
С учётом задержки получаем общее правило:
где — длина самого длинного пути в сетке TPU.
Быстрый вопрос 2 [время AllGather]. По числам из главы 2 — сколько займёт
AllGatherY([EY, F]) → [E, F] на TPU v5e с двумерной сеткой {'X': 8, 'Y': 4}, ,
в bfloat16? А при ?
Ответ
Начнём с базовых величин:
- У TPU v5e 4,5e10 байт/с односторонней пропускной способности ICI по каждой из 2 осей.
- В bfloat16 для случая (1) имеем , так что каждое устройство хранит массив формы bf16[512, 8192] размером 512 × 8192 × 2 = 8,4 МБ. Весь массив — 2048 × 8192 × 2 = 34 МБ.
Для случая (1) можно применить формулу выше. Сбор идёт по одной оси, так что
мкс. Проверим, что мы не упираемся в задержку: по оси размера 4
будет не больше 3 переходов, так что граница по задержке — около 3 мкс, нам до неё далеко. Однако у TPU v5e замыкающий
канал есть, только когда ось имеет размер 16, так что здесь полностью двунаправленный AllGather на самом деле невозможен.
Данным с краёв нужно 3 перехода, чтобы дойти до другого края, так что теоретически получается скорее
. Вот
реальный профиль из этого Colab:
— разумно, ведь мы, скорее всего, не получаем 100% теоретической пропускной способности! Для случая (2)
каждый шард имеет размер 64 * 256 * 2 = 32kB. 32e3 / 4.5e10 = 0.7us, так что мы упираемся в задержку. Переходов 3, так
что это займёт примерно 3 × 1 мкс = 3 мкс. На практике — ближе к 8 мкс.
Случай 3: у обоих сомножителей сворачиваемые измерения шардированы
Заголовок раздела «Случай 3: у обоих сомножителей сворачиваемые измерения шардированы»Третий базовый случай — когда оба сомножителя шардированы по сворачиваемым измерениям вдоль одной и той же оси сетки:
Здесь локальные шардированные блочные умножения по крайней мере возможны: у них одни и те же наборы сворачиваемых индексов. Но каждое произведение — лишь частичная сумма нужного полного произведения, и у каждого устройства вдоль измерения X останутся разные частичные суммы итогового произведения. Это встречается так часто, что мы расширим нотацию, чтобы явно отмечать такое состояние:
Запись { UX } читается как «не редуцировано (unreduced) по оси сетки X» и означает, что операция в каком-то смысле «не завершена»: она закончится только после итогового суммирования. Запись означает, что мы выполняем локальную сумму, но оставляем результат нередуцированным.
Это можно понимать через связь умножения матриц с внешними произведениями:
где ⊗ — внешнее произведение. Значит, если у TPU номер i на оси X есть i-й столбец A и i-я строка B, можно локальным умножением получить . В каждой клетке этой матрицы — i-е слагаемое суммы, которая стоит в этой клетке у A • B. Остаётся выполнить суммирование по P, которое мы шардировали по оси сетки X, чтобы получить полное A • B. Так же это работает, если записать A и B блоками (то есть шардами) и затем просуммировать по каждому получившемуся шарду результата.
Выполнить это суммирование можно полным AllReduce по оси X:
AllReduce убирает частичные суммы: у каждого устройства вдоль оси оказывается одно и то же полностью просуммированное значение. AllReduce — вторая из нескольких ключевых операций связи, которые мы обсуждаем в этом разделе (первая — AllGather, остальные — ReduceScatter и AllToAll). AllReduce берёт массив с нередуцированной (частично просуммированной) осью и выполняет суммирование, передавая шарды вдоль этой оси и накапливая результат. Сигнатура:
То есть он просто убирает суффикс , в остальном оставляя результат прежним.
Сколько стоит AllReduce? Одна мысленная модель AllReduce: каждое устройство отправляет свой шард соседям и суммирует все полученные шарды. Ясно, что это дороже AllGather: каждый «шард» имеет ту же форму, что и весь массив. Как правило, AllReduce вдвое дороже AllGather. Один способ это увидеть — заметить, что AllReduce можно выразить как композицию двух других примитивов: ReduceScatter и AllGather. Как и AllReduce, ReduceScatter сводит частичные суммы массива, но результат оказывается «разбросан» (scattered), то есть разделён по заданному измерению. AllGather собирает все эти куски и «снимает разбиение / шардирование / размножает» логическую ось вдоль этой физической оси.
А что такое ReduceScatter? Как AllGather собирает шардированный массив (убирая нижний индекс), так ReduceScatter суммирует нередуцированный (частично просуммированный) массив, а затем разбрасывает (шардирует) другую логическую ось по той же оси сетки: . Анимация в оригинале (reduce-scatter.gif) показывает, как это делается: очень похоже на AllGather, только вместо того чтобы сохранять каждый шард, мы их суммируем. Поэтому задержка примерно та же, не считая времени на само суммирование.
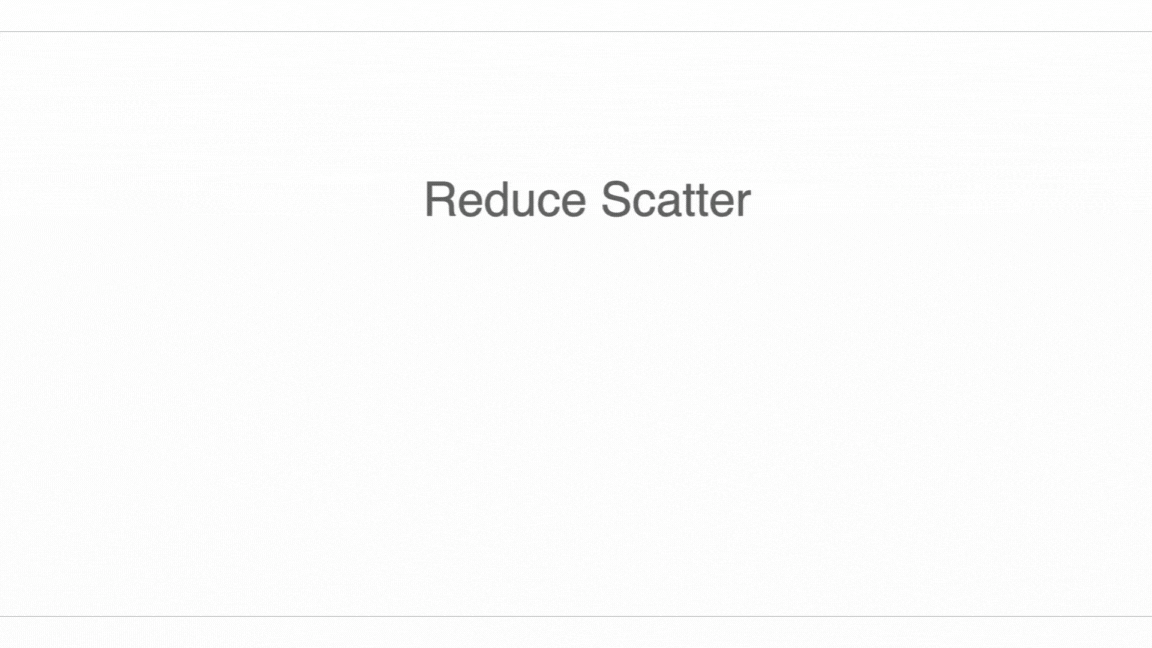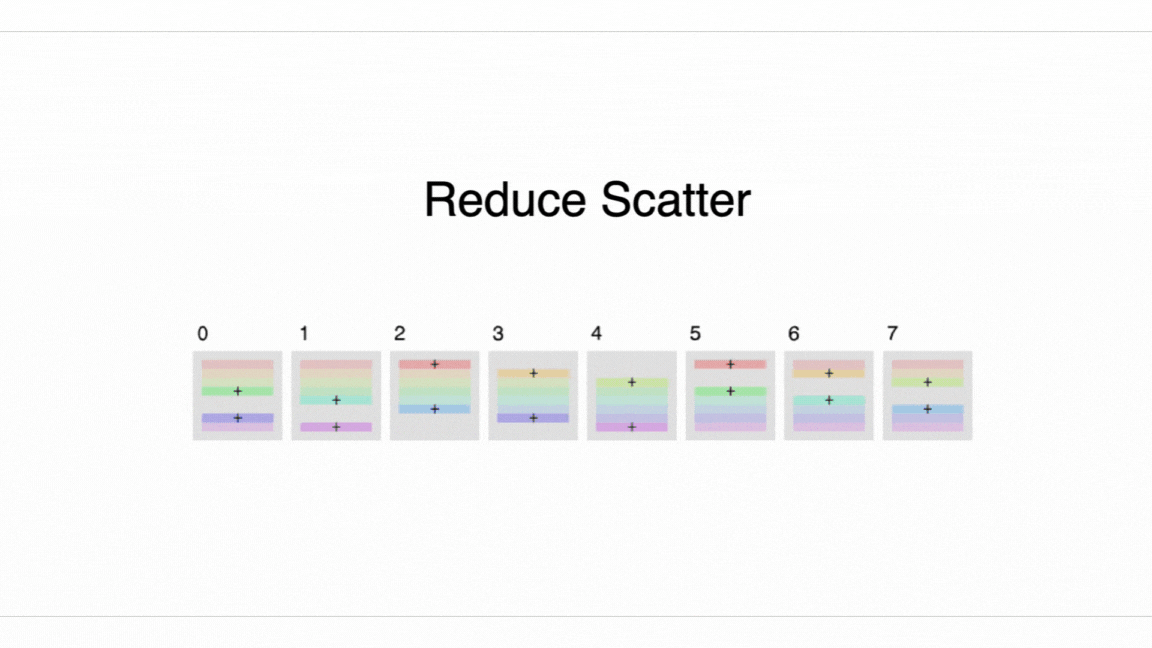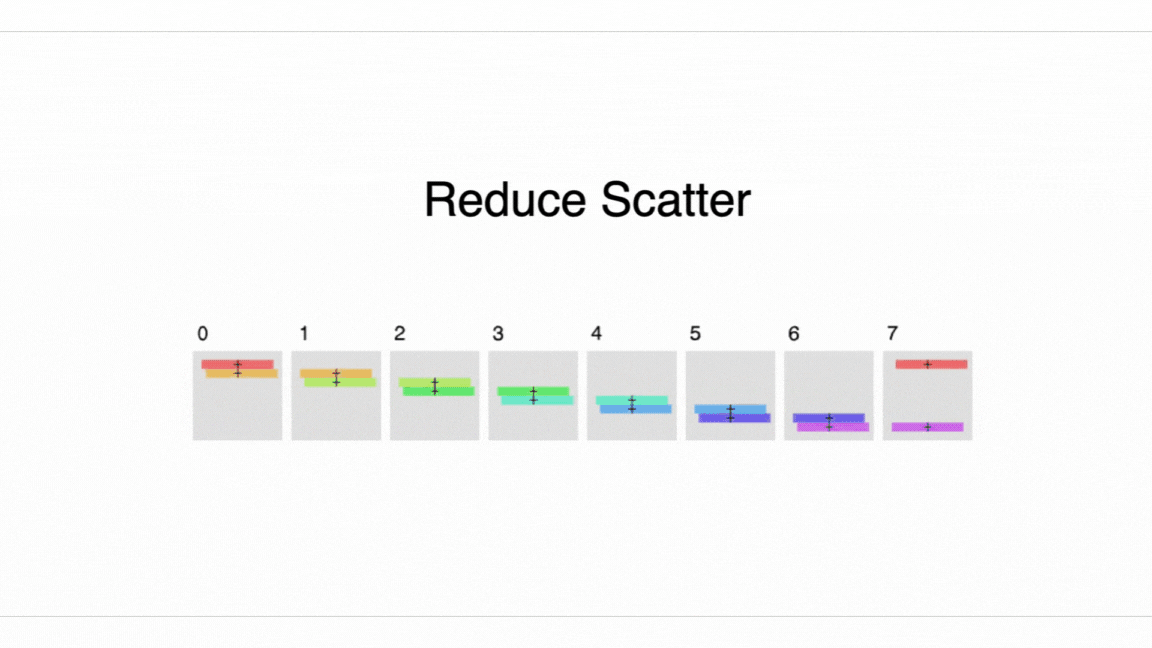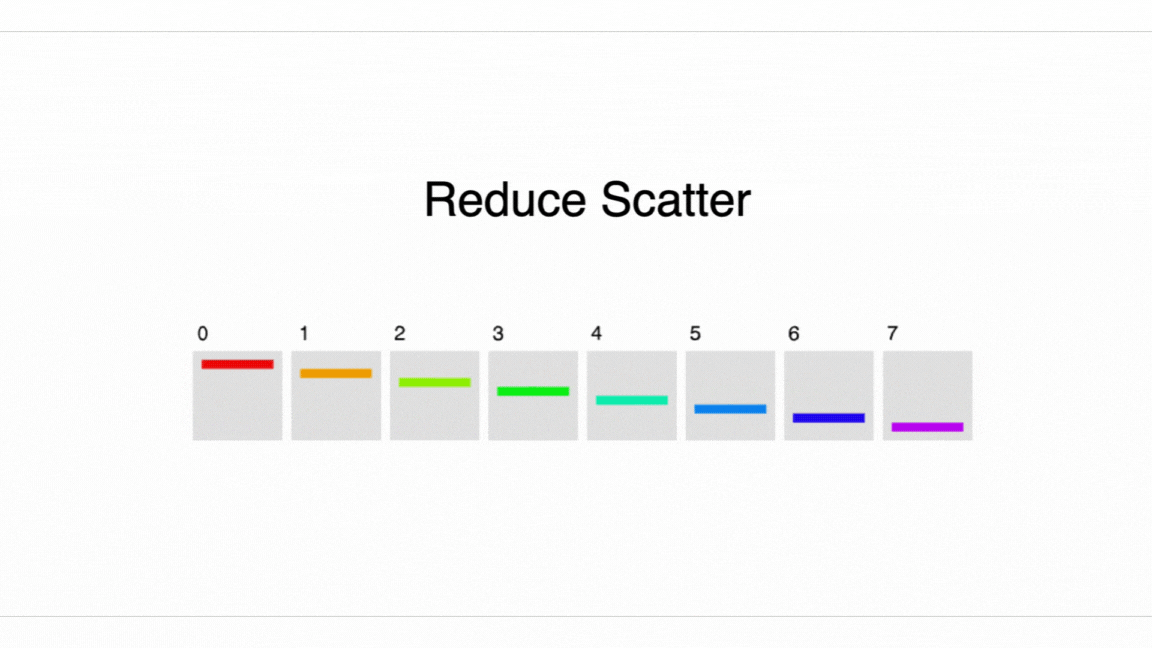
Время связи на каждом переходе — просто байты шарда , делённые на пропускную способность , как и для AllGather, так что
где — двусторонняя пропускная способность, при условии что есть полное кольцо для редукции.
Случай 4: у обоих сомножителей несворачиваемое измерение шардировано по одной оси
Заголовок раздела «Случай 4: у обоих сомножителей несворачиваемое измерение шардировано по одной оси»Каждое измерение сетки может встречаться в шардировании тензора не больше одного раза. Применение правил выше иногда приводит к нарушению этого правила, например:
Это недопустимо, потому что данный шард, скажем i, вдоль измерения X получил бы (i, i)-й шард C, то есть диагональный элемент. Информации во всех шардах вместе не хватает, чтобы восстановить что-то кроме диагональных элементов результата, поэтому такое шардирование запрещено.
Выход — сделать AllGather некоторых измерений. Есть два варианта:
или
В любом случае в форме результата X встретится лишь один раз. Какой вариант выбрать, зависит от того, какое шардирование нужно следующим операциям.
Подробнее о коммуникационных примитивах TPU
Заголовок раздела «Подробнее о коммуникационных примитивах TPU»Четыре случая выше ввели несколько «базовых коммуникационных примитивов», которые используются для умножения шардированных матриц:
- AllGather: убирает нижний индекс из шардирования, собирая шарды.
- ReduceScatter: убирает суффикс «нередуцировано», суммируя шарды вдоль этой оси, и оставляет массив шардированным по второй оси.
- AllReduce: убирает суффикс «нередуцировано», оставляя массив нешардированным вдоль этой оси.
Есть ещё один базовый коммуникационный примитив, который возникает в моделях со смесью экспертов (MoE) и других вычислениях: AllToAll.
Последний коммуникационный примитив: AllToAll
Заголовок раздела «Последний коммуникационный примитив: AllToAll»Последняя фундаментальная коллективная операция, которая не возникает естественно при рассмотрении умножений шардированных матриц, но постоянно встречается на практике, — AllToAll, а точнее её частный случай шардированного транспонирования, или операции перешардирования. Например:
AllToAll обычно нужны, чтобы перестроить шардированные раскладки между разными частями шардированного вычисления с несовместимыми схемами раскладки. Они естественно возникают в шардированных моделях со смесью экспертов. AllToAll можно представлять как перенос нижнего индекса с одной оси на другую. Поскольку AllToAll не нужно размножать все данные каждого шарда по кольцу, он на самом деле дешевле AllGather (в 4 раза)5.
Анимация в оригинале (all-to-all.gif): AllToAll по кольцу.
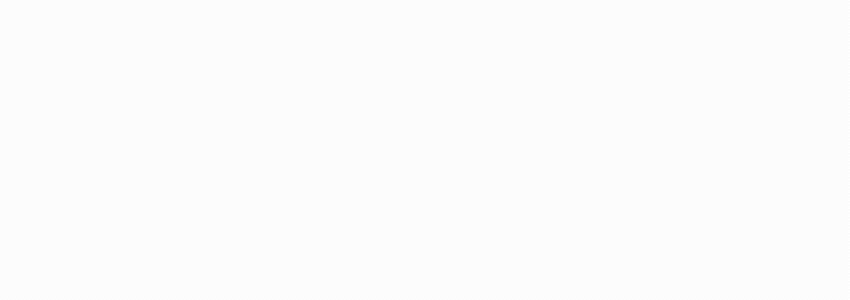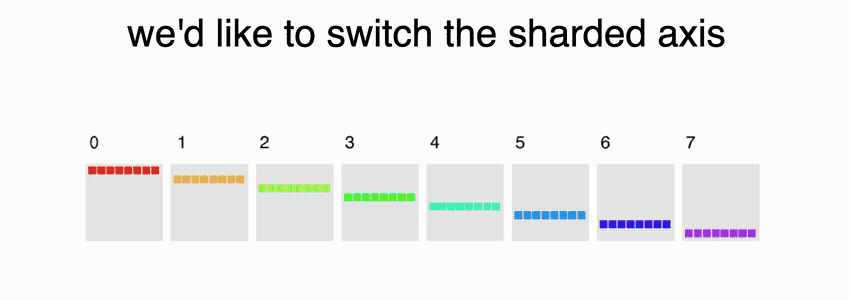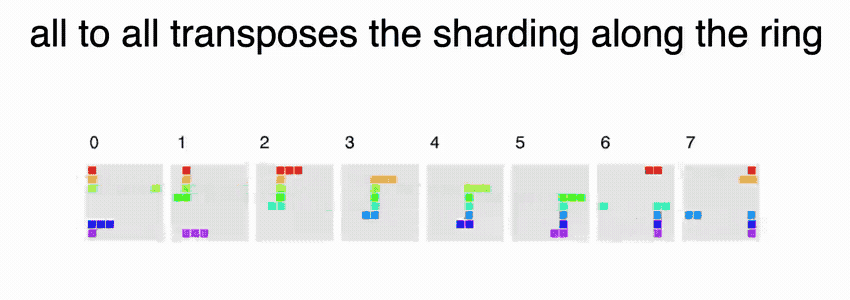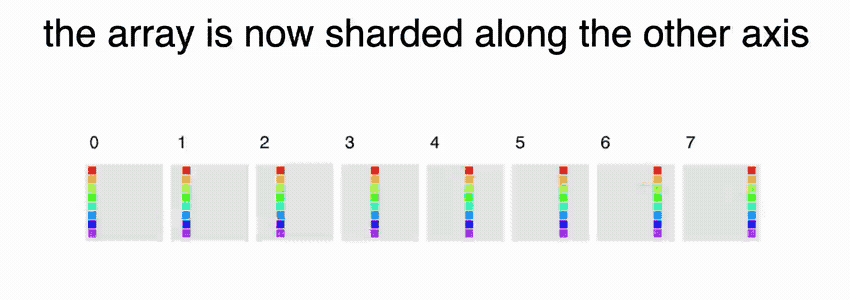
Если обобщить на N-мерный AllToAll, общая стоимость для массива из байт (суммарно по всем устройствам) на сетке A×B×C:
где, как обычно, — двусторонняя пропускная способность ICI, а — общее число устройств. В терминах байт на устройство стоимость равна . Для одномерной сетки это сводится к — ¼ стоимости AllGather. В двумерном случае стоимость даже уменьшается с размером наименьшей оси.
Попутно — нестрогий вывод. Начнём с одномерного тора . Если выбрать источник и приёмник случайно, в среднем между ними N / 4 переходов, что даёт стоимость . В N-мерном торе каждая ось, по сути, независима. У каждого узла байт, и в среднем его данные должны пройти переходов. Можно вывести это и через бисекционную пропускную способность: при AllToAll каждая половина сетки отправляет половину своих данных ( байт) другой половине. Самое узкое сечение перпендикулярно самой длинной оси и пересекает каналов (две плоскости разреза с учётом замыкания), что даёт одностороннюю пропускную способность . Делим — и получаем формулу выше.
Подробнее о ReduceScatter
Заголовок раздела «Подробнее о ReduceScatter»ReduceScatter — более фундаментальная операция, чем кажется: на самом деле это производная AllGather, и наоборот. То есть если в прямом проходе у нас
то производные обратного режима A’ (в общем случае разные на каждом шарде) мы сводим ReduceScatter, получая шардированное A’:
Аналогично в прямом проходе означает в обратном.
Почему AllGather и ReduceScatter — производные друг друга
Дело в том, что трансляция (broadcast) и редукция (reduce) — транспонированные друг к другу линейные операторы, а AllGather и ReduceScatter — внешние произведения (их также называют произведениями Кронекера) трансляции и редукции соответственно. Конкретно: если у нас вектор , любое число устройств и , то трансляцию и редукцию можно определить так (это должно совпадать с интуитивным пониманием):
Пример при , . Если , то — как и ожидалось, вектор из размножен в . При : — вектор из сведён к вектору из . Поскольку для любых матриц и , получаем . AllGather и ReduceScatter выражаются как внешние произведения:
Здесь понимается как — по одному вектору на каждое из устройств. Советуем поиграть с маленькими примерами, скажем , , чтобы увидеть, как эти операторы выглядят в виде матриц. По тому же свойству транспонирования и . Транспонирование и возникает при обратном распространении: если для линейного оператора (например, AllGather или ReduceScatter), то при обратном распространении у нас есть производная потерь по , , и мы получаем . Отсюда производная AllGather — ReduceScatter, и наоборот.
Разложение AllReduce на AllGather и ReduceScatter удобно ещё и тем, что итоговый AllGather можно отложить. Очень часто мы не хотим платить за сборку полного произведения матриц, размноженного по устройствам, а предпочли бы сохранить шардированное состояние и при умножении двух сомножителей с шардированными сворачиваемыми измерениями:
Тогда вместо AllReduce можно выполнить ReduceScatter, а AllGather — при желании позже:
Заметьте: ReduceScatter вводит шардированное измерение, и здесь у него есть естественная свобода шардировать либо по I, либо по K. Используя ReduceScatter, обычно нужно выбрать, какому именованному измерению добавить шардирование (хотя выбор обычно диктуется контекстом модели). Поэтому мы пишем ReduceScatterX,K, указывая ось, по которой шардировать.
Как совместить связь при умножении матриц с вычислениями
Заголовок раздела «Как совместить связь при умножении матриц с вычислениями»Как мы обсуждали в главе 1, обычно мы считаем, что связь всегда можно совместить с какими-то полезными вычислениями, если она достаточно быстра. Коллективные операции этого раздела, как правило, можно совместить с вычислениями самого умножения матриц, но это нетривиально. Алгоритм для этого называется коллективным умножением матриц (collective matmul); впервые он описан в Wang et al..
Анимация в оригинале (ag_matmul.gif): как одно шардированное умножение матрицы на вектор совмещается с последующим AllReduce (случай 3 выше). Полное умножение матриц состоит из многих умножений матрицы на вектор.
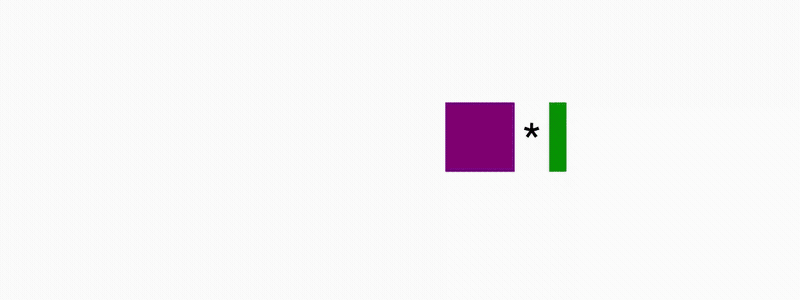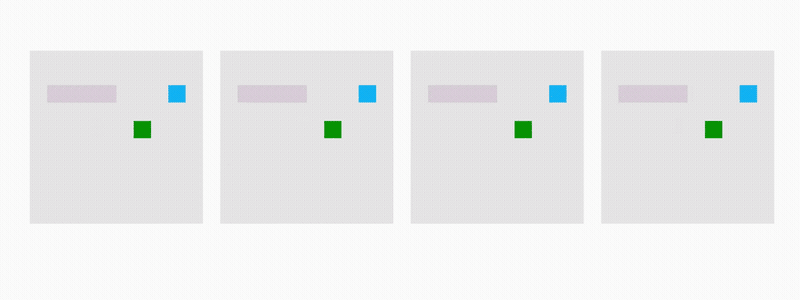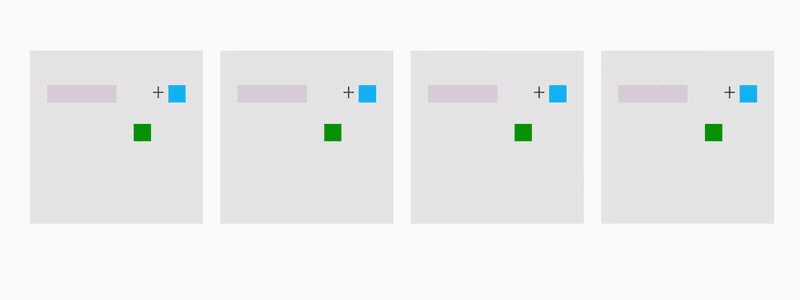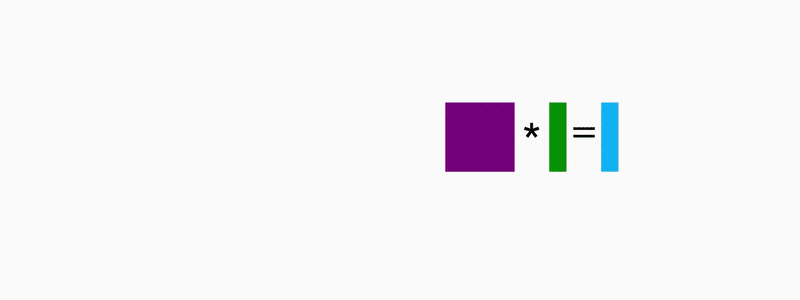
Проще говоря, можно выполнять умножение для одного куска матрицы, одновременно запуская кольцевую редукцию для предыдущих кусков. Иногда можно также разбивать на тайлы по измерению батча или по входному измерению матрицы. Простая реализация на JAX разобрана в главе 10, хороший пример для GPU есть и в документации Mosaic. Советуем как-нибудь реализовать свою версию.
Что мы узнали?
Заголовок раздела «Что мы узнали?»- Шардирование массива задаётся сеткой (Mesh), которая называет физические аппаратные оси сетки TPU, и
шардированием (Sharding), которое назначает имена осей сетки логическим осям массива.
- Например, A[IXY, J] описывает абстрактный массив A, первое измерение которого шардировано по двум
осям сетки X и Y. Вместе с
Mesh(mesh_shape=(4, 8), axis_names=('X', 'Y'))или сокращённоMesh({'X': 4, 'Y': 8})это говорит, что массив разделён на 32 части по первому измерению.
- Например, A[IXY, J] описывает абстрактный массив A, первое измерение которого шардировано по двум
осям сетки X и Y. Вместе с
- Арифметика с шардированными массивами работает в точности как с нешардированными, если не выполнять свёртку
по шардированной оси. В этом случае нужно добавить связь. Рассматриваем четыре случая:
- Ни один массив не шардирован по сворачиваемому измерению: связь не нужна.
- Один массив шардирован по сворачиваемому измерению (или сворачиваемые измерения шардированы по разным осям): перед операцией делаем AllGather одного из входов.
- Оба массива одинаково шардированы по сворачиваемому измерению: перемножаем шарды локально, затем делаем AllReduce или ReduceScatter.
- Оба массива шардированы по одной оси сетки по несворачиваемому измерению: сначала делаем AllGather одного из входов.
- TPU используют примерно 4 базовых коммуникационных примитива:
- AllGather:
- ReduceScatter:
- AllToAll:
- AllReduce: (формально не примитив, так как сочетает ReduceScatter + AllGather)
- Стоимость и задержка каждой из этих операций не зависят от размера оси (пока они ограничены пропускной способностью), а только от размера входных массивов и пропускной способности канала. Для одностороннего AllGather/ReduceScatter:
- AllReduce состоит из ReduceScatter и следующего за ним AllGather и поэтому вдвое дороже. AllToAll передаёт шарды лишь на часть кольца и поэтому стоит ¼ от AllGather. Сводка:
| Операция | Описание | Запись | Время |
|---|---|---|---|
| AllGather | Собирает все шарды шардированного массива вдоль оси, убирая нижний индекс | байты / (двусторонняя пропускная способность ICI × число осей) | |
| ReduceScatter | Суммирует частично просуммированный массив вдоль оси и шардирует его по другой оси (добавляя нижний индекс) | как AllGather | |
| AllReduce | Суммирует частично просуммированный массив вдоль оси, убирает { UX }; сочетает AllGather и ReduceScatter | 2 × AllGather | |
| AllToAll | Собирает (размножает) ось и шардирует другое измерение по той же оси | AllGather / 4 для двунаправленного кольца |
Вот несколько поучительных задач по материалу главы. Ответы есть пока не ко всем — авторы обещают дописывать.
Вопрос 1 [реплицированное шардирование]. Массив шардирован как (то есть только по ) на сетке
Mesh({'X': 4, 'Y': 8, 'Z': 2}). Каково отношение общего числа байт, которые занимает на всех чипах, к размеру одной
копии массива?
Ответ
Массив шардирован только по X размера 4, так что фактически каждый шард имеет размер . Поскольку массив реплицирован по Y и Z, общий размер — , так что отношение общего размера к размеру одной копии — .
Вопрос 2 [задержка AllGather]. Сколько должен занимать на срезе TPU v4p 4x4x4 с сеткой
Mesh({'X': 4, 'Y': 4, 'Z': 4}) при и в bfloat16? А ? А
?
Ответ
У нас полный куб 4x4x4, так что замыкающие каналы есть по всем осям, и доступна двусторонняя пропускная способность 9e10.
- Мы собираем только по одной оси, а другая шардирована, так что фактически собираем байт по 1 оси. Если представить один шард вдоль оси Y, AllGather по X выглядит как AllGather нешардированного массива с 1 / Y байт. Двусторонняя пропускная способность ICI у TPU v4p — 9e10 байт/с, так что это займёт .
- Пропускная способность вдвое больше, но мы собираем весь массив, так что
T = 2BD / (2 * W) = 2*1024*4096 / (2 * 9e10) = 46us. Это далеко от границы по задержке в 4 мкс (1 мкс на переход), так что всё в порядке. - AllReduce вдвое дороже AllGather. Каждый шард имеет размер , так что стоимость около
, то есть примерно
4 * 1024 * 4096 / (16 * 9e10) = 11.6us.
Забавный факт: части (1) и (2) на самом деле не оптимальны: массив реплицирован ещё и по неиспользуемой оси Z, и её простаивающие каналы можно задействовать. Сначала бесплатно перешардируем (каждое устройство просто отбрасывает часть своего шарда), а затем выполним (или ), придя к тому же итоговому состоянию, но собирая по большему числу осей. Это сокращает часть (1) до 11,5 мкс, а часть (2) — до 31 мкс. На практике этого добиваются, просто сразу шардируя по большему числу осей, — это одна из причин шардировать массивы как можно мельче.
Вопрос 3 [AllGather, ограниченный задержкой]. Допустим, мы выполняем , но очень мало
(скажем, 128). Сколько это займёт на срезе TPU v4p 4x4x4 с сеткой Mesh({'X': 4, 'Y': 4, 'Z': 4}) в bfloat16?
Подсказка: вероятно, вы упираетесь в задержку.
Ответ
Массив в bfloat16 занимает всего 256 байт, по 64 на устройство. Ось размера 4 у TPU v4p имеет замыкающий канал, так что
массив можно отправлять в обе стороны. При односторонней пропускной способности 4.5e10 каждый переход займёт примерно
64 / 4.5e10 ~ 0, так что мы определённо упираемся в задержку. Считаем переходы: полный сбор можно сделать всего
за 2 перехода, так что около 2 мкс — хорошая оценка.
Вопрос 4 [стратегии умножения матриц]. Чтобы выполнить , в этой главе мы советуем выполнить и перемножить полностью реплицированные матрицы (случай 2, стратегия 1). Вместо этого можно перемножить локальные шарды: (случай 3, стратегия 2), — а затем выполнить . Сколько FLOPs и связи требует каждая? Какая лучше и почему?
Ответ
Начнём с базовой (стратегия 1). Как мы показали, стоимость AllGather — . Когда массивы полностью реплицированы, общее время вычислений — (где — FLOPs/s ускорителя, поскольку каждый TPU выполняет одни и те же FLOPs). Итак,
Для сравнения, новая стратегия (стратегия 2) делает AllReduce над байт со стоимостью , но выполняет в раз меньше FLOPs (вычисления шардированы). То есть мы делаем FLOPs, а итоговый AllReduce передаёт байт в bfloat16. Значит, общее время стратегии 2 (без AllGather, только AllReduce в конце) примерно
Вопрос: что из этого больше? Стратегия (2) упирается в вычисления, когда , то есть когда . Разумно ожидать тысяч, то есть примерно , что маловероятно, — значит, со стратегией 2 мы почти всегда упираемся в связь. С базовой (стратегия 1) мы упираемся в связь, когда , что часто, но не всегда верно.
Так что при мы упираемся в связь в обоих случаях, и
что верно при , где . Это часто так, поэтому стратегия 2 иногда лучше при маленьком батче. При большом батче ()
что верно при , то есть при , что для больших моделей обычно выполняется. Так что эта альтернативная стратегия обычно лучше для больших моделей, если только не мал.
Остальные задачи главы (условия; ответы — в оригинале):
- [Минимальная задержка] Как шардировать входы умножения на TPU v4p 4x4x4, чтобы получить наименьшую задержку при полностью реплицированном результате? Каковы FLOPs и время связи?
- Какая связь нужна для на TPU v5e 4x4 и сколько времени уходит на связь и на вычисления?
- Блок трансформера при , , в bfloat16 на срезе TPU v5e 2x2, где у каждого TPU всего 300 МБ свободной памяти: как шардировать вход, , и выход, чтобы уложиться в память и минимизировать время?
- [Задание] По фрагменту кода выше создайте шардированный массив и замерьте четыре примитива
(
jax.lax.all_gather,jax.lax.psum,jax.lax.psum_scatter,jax.lax.all_to_all). - Почему при одном шардированном по сворачиваемому измерению входе лучше AllGather, чем «шардированный матмул + AllReduce»?
- [AllToAll] Откуда в стоимости AllToAll множитель 1/4 и как он изменился бы при односторонних каналах ICI?
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| sharding, partitioning | шардирование, разбиение |
| global (logical) shape / device local shape | глобальная (логическая) форма / локальная форма на устройстве |
| device mesh, mesh axis | сетка устройств, ось сетки |
| fully / partially replicated | полностью / частично реплицированный (размноженный) |
| contracting dimension | сворачиваемое измерение (по которому суммируем) |
| block matrix | блочная матрица |
| collective operation, primitive | коллективная операция, примитив |
| AllGather, ReduceScatter, AllReduce, AllToAll | сбор, редукция с раздачей, общая редукция, «все всем» |
| unreduced { UX } | нередуцированный (частичные суммы) по оси X |
| throughput-bound / latency-bound | ограниченный пропускной способностью / задержкой |
| outer (Kronecker) product | внешнее произведение (Кронекера) |
| collective matmul | коллективное умножение матриц |
| resharding, sharded transposition | перешардирование, шардированное транспонирование |
Footnotes
Заголовок раздела «Footnotes»-
Стоит отметить, что параллелить можно и ради скорости. Даже если модель поместилась бы на меньшем числе чипов, масштабирование на большее просто даёт больше FLOPs/s. Например, при инференсе модель иногда помещается на меньших топологиях, но мы масштабируемся на большие, чтобы снизить задержку. Так же и при обучении часто масштабируются на больше чипов, чтобы сократить время шага. ↩
-
AllGather на GPU может работать так же: из GPU в узле строится кольцо, и куски передаются по нему в этом (произвольном) порядке. ↩
-
Двойка в числителе — потому что мы используем двустороннюю пропускную способность: отправляем в каждую сторону, всего . ↩
-
Строго говоря, . ↩
-
Для двунаправленных колец чётного размера каждое устройство отправляет кусков вправо и кусков влево, итого . Размер каждого куска («шарда шарда») — , так что стоимость на устройство — . Этот результат масштабируется на все устройства, поскольку общая пропускная способность растёт с числом устройств. ↩