LLM Course, глава 12 (часть 3): GRPO в TRL и практика
Перевод разделов 12.4–12.7 курса Hugging Face: как устроен GRPOTrainer в TRL, как писать функции награды, практикум с SmolLM-135M и практикум с Unsloth на GSM8K — с примечаниями о том, что изменилось в TRL.
Это перевод заключительных разделов главы 12 курса LLM Course — «Строим рассуждающие модели». Начало главы: часть 1 — RL для LLM и статья DeepSeek-R1, часть 2 — математика GRPO. Карта всего курса — в путеводителе.
12.4. Реализуем GRPO в TRL
Заголовок раздела «12.4. Реализуем GRPO в TRL»На этой странице мы научимся реализовывать групповую относительную оптимизацию политики (Group Relative Policy Optimization, GRPO) с помощью библиотеки TRL (Transformer Reinforcement Learning). Сосредоточимся на практической реализации с минимумом кода.
Мы разберём ключевые идеи GRPO в том виде, в каком они воплощены в GRPOTrainer из TRL, опираясь на фрагменты
из официальной документации TRL.
Сначала напомним себе важные идеи алгоритма GRPO:
- Формирование группы: модель генерирует несколько ответов на каждый промпт.
- Обучение на предпочтениях: модель учится по функции награды, которая сравнивает группы ответов.
- Настройка обучения: процесс обучения управляется конфигурацией.
(Примечание переводчика: «обучение на предпочтениях» здесь сказано вольно. Функция награды оценивает каждый ответ отдельно, а сравнение внутри группы происходит потом, когда награды нормируются в преимущества. Подробно — в части 2.)
Что нужно сделать, чтобы запустить GRPO?
- Задать датасет промптов.
- Задать функцию награды, которая принимает список ответов и возвращает список наград.
- Настроить процесс обучения через
GRPOConfig. - Обучить модель с помощью
GRPOTrainer.
Вот минимальный пример, с которого можно начать обучение GRPO:
from trl import GRPOTrainer, GRPOConfigfrom datasets import load_dataset
# 1. Загружаем датасетdataset = load_dataset("your_dataset", split="train")

# 2. Задаём простую функцию наградыdef reward_func(completions, **kwargs):    """Пример: награждаем более длинные ответы"""    return [float(len(completion)) for completion in completions]

# 3. Настраиваем обучениеtraining_args = GRPOConfig(    output_dir="output",    num_train_epochs=3,    per_device_train_batch_size=4,    gradient_accumulation_steps=2,    logging_steps=10,)
# 4. Создаём тренер и обучаемtrainer = GRPOTrainer( model="your_model", # например, "Qwen/Qwen2-0.5B-Instruct" args=training_args, train_dataset=dataset, reward_funcs=reward_func,)trainer.train()Ключевые компоненты
Заголовок раздела «Ключевые компоненты»1. Формат датасета
Заголовок раздела «1. Формат датасета»Датасет должен содержать промпты, на которые модель будет отвечать. Тренер GRPO сгенерирует несколько ответов на каждый промпт и сравнит их с помощью функции награды.
2. Функция награды
Заголовок раздела «2. Функция награды»Функция награды критически важна: именно она определяет, чему учится модель. Вот два практических примера:
# Пример 1: награда по длине ответаdef reward_length(completions, **kwargs):    return [float(len(completion)) for completion in completions]

# Пример 2: награда за совпадение с шаблономimport re

def reward_format(completions, **kwargs):    pattern = r"^<think>.*?</think><answer>.*?</answer>$"    return [1.0 if re.match(pattern, c) else 0.0 for c in completions]
(Примечание переводчика: без флага re.DOTALL точка в регулярном выражении не совпадает с переводом строки,
поэтому рассуждение в несколько строк этот шаблон не пропустит. Для многострочных ответов пишите
re.match(pattern, c, re.DOTALL) — как в функции format_reward ниже.)
3. Настройка обучения
Заголовок раздела «3. Настройка обучения»Главные параметры GRPOConfig:
training_args = GRPOConfig( # Обязательные параметры output_dir="output", num_train_epochs=3, num_generations=4, # сколько ответов генерировать на каждый промпт per_device_train_batch_size=4, # хотим, чтобы все ответы группы попали в один батч на устройстве # Необязательные, но полезные gradient_accumulation_steps=2, learning_rate=1e-5, logging_steps=10, # Специфичные для GRPO (необязательные) use_vllm=True, # ускоряет генерацию)(Примечание переводчика: в оригинале параметр написан с опечаткой — num_generation; правильное имя —
num_generations, мы его исправили. С опечаткой GRPOConfig падает с ошибкой о неизвестном аргументе.
Для use_vllm=True нужен установленный vLLM: pip install "trl[vllm]".)
Параметр num_generations особенно важен для GRPO: он задаёт размер группы — сколько разных ответов модель
сгенерирует на каждый промпт. Это ключевое отличие от других методов RL:
- Слишком мало (например, 2–3): может не хватить разнообразия для осмысленного сравнения.
- Рекомендуется (4–16): хороший баланс между разнообразием и вычислительной стоимостью.
- Больше: может улучшить обучение, но заметно увеличивает стоимость вычислений.
Размер группы выбирайте исходя из своих вычислительных ресурсов и сложности задачи. Для простых задач может хватить небольших групп (4–8), а сложным задачам на рассуждение полезны группы побольше (8–16).
- Память: подбирайте
per_device_train_batch_sizeиgradient_accumulation_stepsпод объём памяти GPU. - Скорость: включите
use_vllm=Trueдля более быстрой генерации, если ваша модель поддерживается. - Мониторинг: следите за метриками в логах во время обучения:
reward— средняя награда по ответам;reward_std— стандартное отклонение награды внутри групп;kl— KL-дивергенция относительно эталонной модели.
(Примечание переводчика: в свежих версиях TRL KL-штраф по умолчанию выключен (beta=0.0), и метрики kl в логах
не будет, пока вы не зададите beta больше нуля. Полный список метрик и что считать нормой — в таблице
урока 6.4.5.)
Как проектировать функцию награды
Заголовок раздела «Как проектировать функцию награды»Статья DeepSeek R1 показывает несколько действенных подходов к проектированию наград, которые можно перенести в свою реализацию GRPO.
1. Награда за длину
Заголовок раздела «1. Награда за длину»Одна из самых простых наград — награда за длину. Можно поощрять более длинные ответы:
def reward_len(completions, **kwargs): ideal_length = 20 return [-abs(ideal_length - len(completion)) for completion in completions]Эта функция награды штрафует слишком короткие и слишком длинные ответы и подталкивает модель к ответам длиной около идеальных 20 токенов.
(Примечание переводчика: и здесь len считает символы, а не токены — модель будет стремиться к ответам около
20 символов. Чтобы считать токены, передайте токенизатор и используйте len(tokenizer(completion).input_ids).
Сама функция поощряет не «длинные», а «близкие к идеальной длине» ответы: максимум награды, ноль, достигается
ровно на длине 20.)
В оригинале здесь встроен интерактивный ноутбук marimo — grpo_length.py из репозитория
huggingface/notebooks (папка course/en/chapter13).
2. Правила для проверяемых задач
Заголовок раздела «2. Правила для проверяемых задач»Для задач с объективно правильным ответом (математика, программирование) можно написать функцию награды на правилах:
def problem_reward(completions, answers, **kwargs):    """Функция награды для математических задач с проверяемым ответом    completions: список ответов, которые надо оценить    answers: список правильных ответов к задачам из датасета    """
    rewards = []    for completion, correct_answer in zip(completions, answers):        # Достаём ответ из текста модели        try:            # Это упрощённый пример — на практике нужен аккуратный разбор            answer = extract_final_answer(completion)            # Бинарная награда: 1 за верный ответ, 0 за неверный            reward = 1.0 if answer == correct_answer else 0.0            rewards.append(reward)        except:            # Если ответ не удалось разобрать, даём низкую награду            rewards.append(0.0)
    return rewards
(Примечание переводчика: extract_final_answer в оригинале не определена — это место, куда вы вставляете свой
разбор ответа, например извлечение числа после #### или содержимого \boxed{}. Аргумент answers тренер передаст,
только если в датасете есть колонка с ровно таким именем.)
В оригинале — интерактивный ноутбук grpo_math.py из того же репозитория.
3. Награда за формат
Заголовок раздела «3. Награда за формат»Можно поощрять и правильное оформление ответа — это было важно при обучении DeepSeek R1:
def format_reward(completions, **kwargs):    """Награждает ответы в нужном формате"""    # Пример: проверяем формат «сначала рассуждение, потом ответ»    pattern = r"<think>(.*?)</think>\s*<answer>(.*?)</answer>"
    rewards = []    for completion in completions:        match = re.search(pattern, completion, re.DOTALL)        if match:            # Проверяем, что в обоих разделах есть содержательный текст            think_content = match.group(1).strip()            answer_content = match.group(2).strip()
            if len(think_content) > 20 and len(answer_content) > 0:                rewards.append(1.0)            else:                rewards.append(                    0.5                )  # частичная награда: формат верный, но содержания мало        else:            rewards.append(0.0)  # формат неверный — награды нет
    return rewards
В оригинале — интерактивный ноутбук grpo_format.py.
Эти примеры показывают, как реализовать функции награды по мотивам обучения DeepSeek R1: за правильность, за формат и за их сочетание.
flowchart LR
D["Датасет<br/>колонка prompt"] --> T["GRPOTrainer"]
T --> G["G ответов<br/>на каждый промпт"]
G --> R1["reward_len"]
G --> R2["format_reward"]
G --> R3["problem_reward"]
R1 --> S["Сумма наград"]
R2 --> S
R3 --> S
S --> A["Преимущества<br/>внутри группы"]
A --> U["Шаг оптимизатора"]
U --> T
Вот и всё!
Заголовок раздела «Вот и всё!»В следующем разделе вы выполните упражнение: реализуете GRPO в TRL.
12.5. Практикум: дообучаем модель с GRPO
Заголовок раздела «12.5. Практикум: дообучаем модель с GRPO»Ноутбук к разделу: grpo_finetune.ipynb в Google Colab.
Теория позади — переходим к практике! В этом упражнении вы дообучите модель с помощью GRPO.
Установка зависимостей
Заголовок раздела «Установка зависимостей»Сначала установим зависимости для упражнения.
!pip install -qqq datasets==3.2.0 transformers==4.47.1 trl==0.14.0 peft==0.14.0 accelerate==1.2.1 bitsandbytes==0.45.2 wandb==0.19.7 --progress-bar off!pip install -qqq flash-attn --no-build-isolation --progress-bar off(Примечание переводчика: восклицательный знак в начале — синтаксис ноутбука (Colab, Jupyter); в обычном терминале
пишите команды без него. Версии закреплены специально: код ниже написан под TRL 0.14. Сборка flash-attn из исходников
может идти долго; если она не ставится, уберите строку attn_implementation="flash_attention_2" при загрузке модели.)
Теперь импортируем нужные библиотеки.
import torchfrom datasets import load_datasetfrom peft import LoraConfig, get_peft_modelfrom transformers import AutoModelForCausalLM, AutoTokenizerfrom trl import GRPOConfig, GRPOTrainerИмпортируем Weights & Biases и входим в аккаунт
Заголовок раздела «Импортируем Weights & Biases и входим в аккаунт»Weights & Biases — сервис для записи и отслеживания экспериментов. Мы будем логировать в него процесс дообучения.
import wandb
wandb.login()
Упражнение можно выполнить и без входа в Weights & Biases, но рекомендуем войти: так удобнее следить за экспериментами и разбираться в результатах.
(Примечание переводчика: если аккаунта нет, уберите wandb.login() и wandb.init(...), а в GRPOConfig поставьте
report_to="none" — метрики будут печататься в консоль.)
Загружаем датасет
Заголовок раздела «Загружаем датасет»Теперь загрузим датасет. Мы возьмём mlabonne/smoltldr — в нём
собраны короткие истории.
dataset = load_dataset("mlabonne/smoltldr")print(dataset)(Примечание переводчика: smoltldr — это тексты постов Reddit с задачей «сделай краткое содержание», TL;DR. Промпт — сам текст, ответ модели — пересказ. Поэтому награда за длину ниже по смыслу учит модель писать краткие пересказы.)
Загружаем модель
Заголовок раздела «Загружаем модель»Теперь загрузим модель.
В этом упражнении мы используем модель SmolLM2-135M.
Это маленькая модель на 135 млн параметров, которая работает на скромном железе. Поэтому она идеальна для учёбы,
хотя и не самая сильная. Если у вас есть железо помощнее, попробуйте дообучить модель покрупнее, например
SmolLM2-1.7B.
model_id = "HuggingFaceTB/SmolLM-135M-Instruct"model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto", device_map="auto", attn_implementation="flash_attention_2",)tokenizer = AutoTokenizer.from_pretrained(model_id)(Примечание переводчика: в тексте упомянута SmolLM2-135M, а в коде загружается SmolLM-135M-Instruct — модель
первого поколения в варианте с инструкциями. Работают обе; для этого упражнения удобнее instruct-вариант.)
Подключаем LoRA
Заголовок раздела «Подключаем LoRA»Теперь зададим конфигурацию LoRA. LoRA сокращает число обучаемых параметров, а значит, и объём памяти, нужный для дообучения.
Если вы не знакомы с LoRA, прочитайте о ней в главе 11.
# Подключаем LoRAlora_config = LoraConfig( task_type="CAUSAL_LM", r=16, lora_alpha=32, target_modules="all-linear",)model = get_peft_model(model, lora_config)print(model.print_trainable_parameters())Total trainable parameters: 135MЗадаём функцию награды
Заголовок раздела «Задаём функцию награды»Как говорилось в прошлом разделе, GRPO может улучшать модель по любой функции награды. Здесь возьмём простую функцию, которая поощряет модель генерировать текст длиной 50 токенов.
# Функция наградыideal_length = 50

def reward_len(completions, **kwargs):    return [-abs(ideal_length - len(completion)) for completion in completions]
(Примечание переводчика: как и в разделе 12.4, len считает символы — на деле модель учится писать пересказы
около 50 символов, то есть в одно короткое предложение.)
Задаём параметры обучения
Заголовок раздела «Задаём параметры обучения»Теперь зададим параметры обучения. Используем класс GRPOConfig — в привычном для transformers стиле.
Если вы задаёте параметры обучения впервые, посмотрите описание класса TrainingArguments или подробное введение во второй главе (она есть на русском).
# Параметры обученияtraining_args = GRPOConfig( output_dir="GRPO", learning_rate=2e-5, per_device_train_batch_size=8, gradient_accumulation_steps=2, max_prompt_length=512, max_completion_length=96, num_generations=8, optim="adamw_8bit", num_train_epochs=1, bf16=True, report_to=["wandb"], remove_unused_columns=False, logging_steps=1,)Теперь можно создать тренер с моделью, датасетом и параметрами обучения и запустить обучение.
# Тренерtrainer = GRPOTrainer(    model=model,    reward_funcs=[reward_len],    args=training_args,    train_dataset=dataset["train"],)
# Обучаем модельwandb.init(project="GRPO")trainer.train()
Обучение занимает около часа на одной GPU A10G, которая доступна в Google Colab или в Hugging Face Spaces.
(Примечание переводчика: на одной RTX 4080 время того же порядка. bf16=True требует GPU с поддержкой bfloat16 —
RTX 30xx/40xx и новее; на старых картах, например T4, поставьте fp16=True.)
Публикуем модель на Hub во время обучения
Заголовок раздела «Публикуем модель на Hub во время обучения»Если задать аргумент push_to_hub=True и в hub_model_id — корректное имя модели, модель будет выгружаться на
Hugging Face Hub прямо во время обучения. Это удобно, если хочется сразу начать «пробовать модель на ощупь»
(vibe testing)!
(Примечание переводчика: в оригинале аргумент назван model_id; в GRPOConfig, как и в TrainingArguments, он
называется hub_model_id. Для выгрузки нужен токен Hugging Face: huggingface-cli login.)
Разбираемся в результатах обучения
Заголовок раздела «Разбираемся в результатах обучения»GRPOTrainer логирует награду от вашей функции награды, loss и ряд других метрик.
Мы сосредоточимся на награде и на loss.
Как видно, награда от функции награды по мере обучения приближается к 0. Это хороший знак: модель учится генерировать текст нужной длины.
(В оригинале — график «Reward from reward function»: награда начинается с больших отрицательных значений и растёт к нулю. Ссылка на рисунок.)

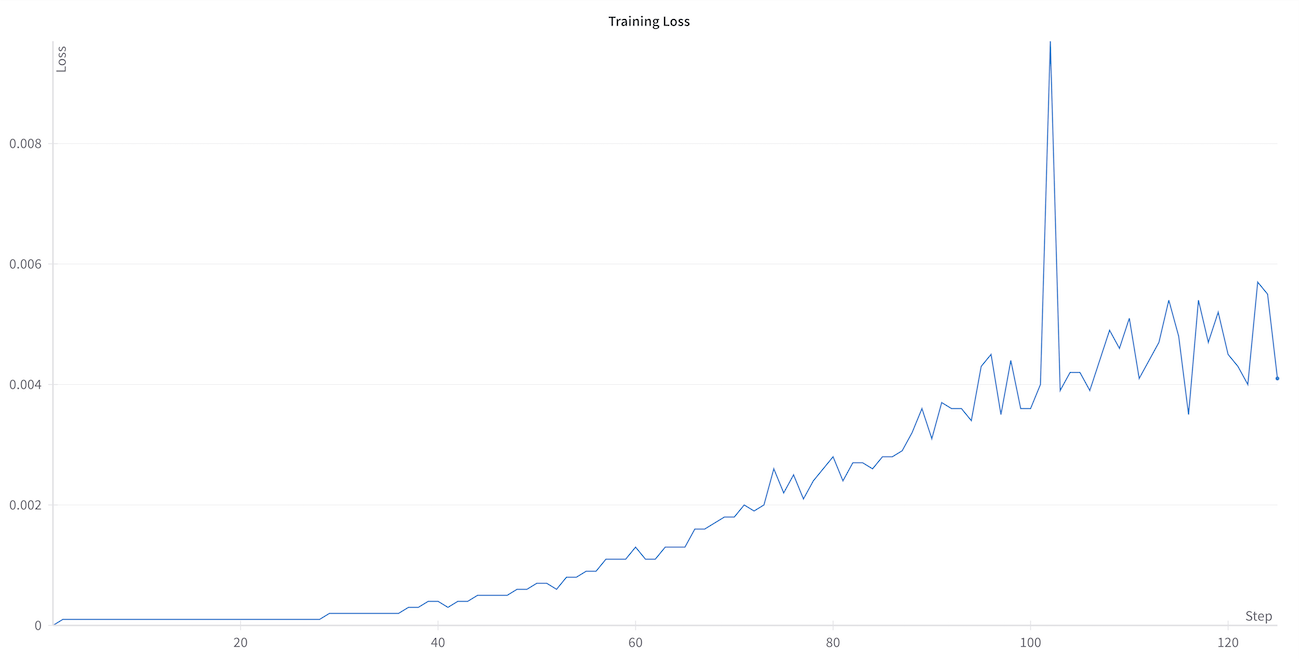
Возможно, вы заметите, что loss начинается с нуля, а затем в ходе обучения растёт, — это может показаться странным. Такое поведение ожидаемо в GRPO и прямо следует из математической формулировки алгоритма. Loss в GRPO пропорционален KL-дивергенции (ограничению относительно исходной политики). По мере обучения модель всё лучше генерирует текст, который нравится функции награды, и поэтому всё сильнее отклоняется от исходной политики. Растущее расхождение и отражается в растущем loss — то есть рост loss на самом деле показывает, что модель успешно подстраивается под функцию награды.
(В оригинале — график «Loss»: loss начинается около нуля и постепенно растёт. Ссылка на рисунок.)
Сохраняем и публикуем модель
Заголовок раздела «Сохраняем и публикуем модель»Поделимся моделью с сообществом!
merged_model = trainer.model.merge_and_unload()merged_model.push_to_hub( "SmolGRPO-135M", private=False, tags=["GRPO", "Reasoning-Course"])(Примечание переводчика: merge_and_unload() вливает веса адаптера LoRA в базовую модель, и на Hub уходит обычная
модель без зависимости от PEFT. Токенизатор этот код не выгружает — добавьте tokenizer.push_to_hub("SmolGRPO-135M"),
иначе загрузка по имени в следующем шаге не найдёт токенизатор.)
Генерируем текст
Заголовок раздела «Генерируем текст»🎉 Вы успешно дообучили модель с GRPO! Теперь сгенерируем ею текст.
Сначала зададим по-настоящему длинный документ!
prompt = """# A long document about the Cat
The cat (Felis catus), also referred to as the domestic cat or house cat, is a smalldomesticated carnivorous mammal. It is the only domesticated species of the family Felidae.Advances in archaeology and genetics have shown that the domestication of the cat occurredin the Near East around 7500 BC. It is commonly kept as a pet and farm cat, but also rangesfreely as a feral cat avoiding human contact. It is valued by humans for companionship andits ability to kill vermin. Its retractable claws are adapted to killing small prey speciessuch as mice and rats. It has a strong, flexible body, quick reflexes, and sharp teeth,and its night vision and sense of smell are well developed. It is a social species,but a solitary hunter and a crepuscular predator. Cat communication includesvocalizations—including meowing, purring, trilling, hissing, growling, and grunting—aswell as body language. It can hear sounds too faint or too high in frequency for human ears,such as those made by small mammals. It secretes and perceives pheromones."""
messages = [    {"role": "user", "content": prompt},]
(Текст документа оставлен на английском, как в оригинале: модель обучалась на английских текстах. Это начало статьи о домашней кошке: происхождение, повадки, органы чувств.)
Теперь сгенерируем текст моделью.
# Генерируем текстfrom transformers import pipeline
generator = pipeline("text-generation", model="SmolGRPO-135M")
## Или используем модель и токенизатор, заданные ранее# generator = pipeline("text-generation", model=model, tokenizer=tokenizer)
generate_kwargs = {    "max_new_tokens": 256,    "do_sample": True,    "temperature": 0.5,    "min_p": 0.1,}
generated_text = generator(messages, generate_kwargs=generate_kwargs)
print(generated_text)
(Примечание переводчика: pipeline принимает параметры генерации напрямую:
generator(messages, **generate_kwargs). Вариант generate_kwargs=... из оригинала в разных версиях transformers
работает по-разному, поэтому надёжнее распаковать словарь. Если модель выгружена под вашим логином, указывайте полное
имя: "ваш-логин/SmolGRPO-135M".)
Заключение
Заголовок раздела «Заключение»В этой главе мы увидели, как дообучить модель с GRPO, как читать результаты обучения и как генерировать текст обученной моделью.
12.6. Практикум: GRPO с Unsloth
Заголовок раздела «12.6. Практикум: GRPO с Unsloth»Ноутбук к разделу: Gemma 3 (1B) GRPO в Google Colab.
В этом упражнении вы дообучите модель с GRPO (Group Relative Policy Optimization) с помощью Unsloth, чтобы улучшить её способности к рассуждению. GRPO мы разбирали в разделе 12.3.
Unsloth — библиотека, которая ускоряет дообучение LLM: модели учатся быстрее и на меньших ресурсах. Unsloth подключается к TRL, поэтому мы опираемся на то, что узнали в прошлых разделах, и учитываем особенности Unsloth.
Установка зависимостей
Заголовок раздела «Установка зависимостей»Сначала установим нужные библиотеки. Нам понадобятся Unsloth для ускоренного дообучения и vLLM для быстрого инференса.
pip install unsloth vllmpip install --upgrade pillowНастраиваем Unsloth
Заголовок раздела «Настраиваем Unsloth»Unsloth предоставляет класс FastLanguageModel, который соединяет transformers с оптимизациями Unsloth.
Импортируем его:
from unsloth import FastLanguageModelТеперь загрузим модель Gemma 3 1B Instruct от Google и настроим её для дообучения:
from unsloth import FastLanguageModelimport torch
max_seq_length = 1024  # можно увеличить для более длинных рассужденийlora_rank = 32  # больше ранг — умнее модель, но медленнее обучение
model, tokenizer = FastLanguageModel.from_pretrained(    model_name="google/gemma-3-1b-it",    max_seq_length=max_seq_length,    load_in_4bit=True,  # False — для LoRA в 16 битах    fast_inference=True,  # включает быстрый инференс через vLLM    max_lora_rank=lora_rank,    gpu_memory_utilization=0.6,  # уменьшите, если не хватает памяти)
model = FastLanguageModel.get_peft_model(    model,    r=lora_rank,  # любое число больше 0; рекомендуем 8, 16, 32, 64, 128    target_modules=[        "q_proj",        "k_proj",        "v_proj",        "o_proj",        "gate_proj",        "up_proj",        "down_proj",    ],  # уберите QKVO, если не хватает памяти    lora_alpha=lora_rank,    use_gradient_checkpointing="unsloth",  # позволяет дообучать на длинном контексте    random_state=3407,)
Этот код загружает модель с 4-битным квантованием, чтобы сэкономить память, и подключает LoRA (низкоранговую адаптацию)
для экономного дообучения. Параметр target_modules задаёт, какие слои модели дообучать, а
use_gradient_checkpointing позволяет обучать на более длинном контексте.
(Примечание переводчика: модели Gemma на Hub «закрытые» — перед загрузкой нужно принять лицензию на странице модели
и войти через huggingface-cli login. Четырёхбитная загрузка базовой модели вместе с LoRA — это подход QLoRA,
см. урок 6.2.1.)
Подготовка данных
Заголовок раздела «Подготовка данных»В этом упражнении используем датасет GSM8K со школьными задачами по математике. Отформатируем данные так, чтобы модель сначала показывала рассуждение, а потом давала ответ.
Сначала зададим формат промптов и ответов:
# Системный промпт, который требует от модели определённый форматSYSTEM_PROMPT = """Respond in the following format:<reasoning>...</reasoning><answer>...</answer>"""
XML_COT_FORMAT = """\<reasoning>{reasoning}</reasoning><answer>{answer}</answer>"""
(Системный промпт оставлен на английском, как в оригинале. Перевод: «Отвечай в следующем формате:» — дальше блок
рассуждения в тегах <reasoning> и ответ в тегах <answer>.)
Теперь подготовим датасет:
import refrom datasets import load_dataset, Dataset

# Вспомогательные функции: достают ответ из текста в разных форматахdef extract_xml_answer(text: str) -> str:    answer = text.split("<answer>")[-1]    answer = answer.split("</answer>")[0]    return answer.strip()

def extract_hash_answer(text: str) -> str | None:    if "####" not in text:        return None    return text.split("####")[1].strip()

# Функция подготовки датасета GSM8Kdef get_gsm8k_questions(split="train") -> Dataset:    data = load_dataset("openai/gsm8k", "main")[split]    data = data.map(        lambda x: {            "prompt": [                {"role": "system", "content": SYSTEM_PROMPT},                {"role": "user", "content": x["question"]},            ],            "answer": extract_hash_answer(x["answer"]),        }    )    return data

dataset = get_gsm8k_questions()
Датасет готовится так: из исходного решения извлекается ответ, и он записывается строкой.
(Примечание переводчика: в GSM8K решение каждой задачи заканчивается строкой #### 72 — после четырёх решёток
стоит итоговое число. extract_hash_answer берёт именно его. Промпт здесь записан в «разговорном» формате — списком
сообщений с ролями, поэтому тренер сам применит к нему chat-шаблон модели, а ответы в функции награды придут тоже
списками сообщений: отсюда completion[0]["content"] ниже.)
Задаём функции награды
Заголовок раздела «Задаём функции награды»Как мы обсуждали в разделе 12.4, GRPO может направлять обучение модели функциями награды по проверяемым критериям — например, по длине и формату.
В этом упражнении зададим несколько функций награды, которые поощряют разные стороны хорошего рассуждения. Например, будем награждать модель за целочисленный ответ и за строгое соблюдение формата.
# Функция награды: проверяет, верен ли ответdef correctness_reward_func(prompts, completions, answer, **kwargs) -> list[float]:    responses = [completion[0]["content"] for completion in completions]    q = prompts[0][-1]["content"]    extracted_responses = [extract_xml_answer(r) for r in responses]    print(        "-" * 20,        f"Question:\n{q}",        f"\nAnswer:\n{answer[0]}",        f"\nResponse:\n{responses[0]}",        f"\nExtracted:\n{extracted_responses[0]}",    )    return [2.0 if r == a else 0.0 for r, a in zip(extracted_responses, answer)]

# Функция награды: проверяет, что ответ — целое числоdef int_reward_func(completions, **kwargs) -> list[float]:    responses = [completion[0]["content"] for completion in completions]    extracted_responses = [extract_xml_answer(r) for r in responses]    return [0.5 if r.isdigit() else 0.0 for r in extracted_responses]

# Функция награды: проверяет строгое соблюдение форматаdef strict_format_reward_func(completions, **kwargs) -> list[float]:    pattern = r"^<reasoning>\n.*?\n</reasoning>\n<answer>\n.*?\n</answer>\n$"    responses = [completion[0]["content"] for completion in completions]    matches = [re.match(pattern, r) for r in responses]    return [0.5 if match else 0.0 for match in matches]

# Функция награды: проверяет более мягкий вариант форматаdef soft_format_reward_func(completions, **kwargs) -> list[float]:    pattern = r"<reasoning>.*?</reasoning>\s*<answer>.*?</answer>"    responses = [completion[0]["content"] for completion in completions]    matches = [re.match(pattern, r) for r in responses]    return [0.5 if match else 0.0 for match in matches]

# Функция награды: считает XML-теги и штрафует за лишний текстdef count_xml(text) -> float:    count = 0.0    if text.count("<reasoning>\n") == 1:        count += 0.125    if text.count("\n</reasoning>\n") == 1:        count += 0.125    if text.count("\n<answer>\n") == 1:        count += 0.125        count -= len(text.split("\n</answer>\n")[-1]) * 0.001    if text.count("\n</answer>") == 1:        count += 0.125        count -= (len(text.split("\n</answer>")[-1]) - 1) * 0.001    return count

def xmlcount_reward_func(completions, **kwargs) -> list[float]:    contents = [completion[0]["content"] for completion in completions]    return [count_xml(c) for c in contents]
У этих функций разные задачи:
| Функция награды | Назначение |
|---|---|
correctness_reward_func | Награждает модель, когда её ответ совпадает с правильным |
int_reward_func | Награждает за числовой ответ |
strict_format_reward_func и soft_format_reward_func | Награждают за соблюдение заданного формата |
xmlcount_reward_func | Награждает за правильные XML-теги и штрафует за лишний текст после закрывающих тегов |
Обучение с GRPO
Заголовок раздела «Обучение с GRPO»Теперь настроим тренер GRPO с моделью, токенизатором и функциями награды. Эта часть повторяет подход из прошлого упражнения.
from trl import GRPOConfig, GRPOTrainer
max_prompt_length = 256
training_args = GRPOConfig(    learning_rate=5e-6,    adam_beta1=0.9,    adam_beta2=0.99,    weight_decay=0.1,    warmup_ratio=0.1,    lr_scheduler_type="cosine",    optim="paged_adamw_8bit",    logging_steps=1,    per_device_train_batch_size=1,    gradient_accumulation_steps=1,  # увеличьте до 4 для более плавного обучения    num_generations=6,  # уменьшите, если не хватает памяти    max_prompt_length=max_prompt_length,    max_completion_length=max_seq_length - max_prompt_length,    # num_train_epochs = 1, # поставьте 1 для полного прогона обучения    max_steps=250,    save_steps=250,    max_grad_norm=0.1,    report_to="none",  # можно использовать Weights & Biases    output_dir="outputs",)
trainer = GRPOTrainer(    model=model,    processing_class=tokenizer,    reward_funcs=[        xmlcount_reward_func,        soft_format_reward_func,        strict_format_reward_func,        int_reward_func,        correctness_reward_func,    ],    args=training_args,    train_dataset=dataset,)
GRPOConfig задаёт разные гиперпараметры обучения:
use_vllm— включает быстрый инференс через vLLM;learning_rate— управляет тем, как быстро учится модель;num_generations— число ответов на каждый промпт;max_steps— общее число шагов обучения.
(Примечание переводчика: use_vllm в этом конфиге нет — vLLM включён раньше, через fast_inference=True при загрузке
модели в Unsloth. При per_device_train_batch_size=1 Unsloth сам подстраивает батч так, чтобы в него поместилась целая
группа из num_generations ответов; в «чистом» TRL такой конфиг пришлось бы поправить.)
Запускаем обучение:
trainer.train()Проверяем модель
Заголовок раздела «Проверяем модель»После обучения проверим, как работает модель. Сначала сохраним веса LoRA:
model.save_lora("grpo_saved_lora")Теперь проверим модель на новом вопросе:
from vllm import SamplingParams
text = tokenizer.apply_chat_template(    [        {"role": "system", "content": SYSTEM_PROMPT},        {"role": "user", "content": "Calculate pi."},    ],    tokenize=False,    add_generation_prompt=True,)
sampling_params = SamplingParams(    temperature=0.8,    top_p=0.95,    max_tokens=1024,)output = (    model.fast_generate(        text,        sampling_params=sampling_params,        lora_request=model.load_lora("grpo_saved_lora"),    )[0]    .outputs[0]    .text)
print(output)
Вы должны увидеть, что модель теперь соблюдает заданный формат: сначала показывает рассуждение, потом даёт ответ.
(«Calculate pi.» — «Вычисли число пи». Полезный опыт: сравните ответ с адаптером и без него — уберите аргумент
lora_request.)
Сохраняем модель
Заголовок раздела «Сохраняем модель»Unsloth умеет сохранять дообученную модель несколькими способами; разберём самый распространённый.
# Сохраняем в 16-битной точностиmodel.save_pretrained_merged("model", tokenizer, save_method="merged_16bit")Публикуем на Hugging Face Hub
Заголовок раздела «Публикуем на Hugging Face Hub»Выгрузим модель на Hugging Face Hub методом push_to_hub_merged. Он позволяет выгружать модель в нескольких
вариантах квантования.
# Выгрузка на Hugging Face Hub (нужен токен)model.push_to_hub_merged( "your-username/model-name", tokenizer, save_method="merged_16bit", token="your-token")Unsloth также умеет сохранять модель в формате GGUF для llama.cpp:
model.push_to_hub_gguf( "your-username/model-name", tokenizer, quantization_method=["q4_k_m", "q8_0", "q5_k_m"], token="your-token",)Файлы GGUF можно запускать в llama.cpp или в программах с графическим интерфейсом вроде Jan и Open WebUI.
(Примечание переводчика: your-username/model-name и your-token — заглушки: ваш логин, имя модели и токен с
правом записи. Не вставляйте токен прямо в ноутбук, который потом публикуете. Форматы квантования GGUF (q4_k_m и
др.) разобраны в уроке 7.2.1.)
Заключение
Заголовок раздела «Заключение»В этом упражнении вы научились:
- Настраивать Unsloth для ускоренного дообучения.
- Готовить данные для обучения GRPO.
- Задавать свои функции награды, которые направляют обучение модели.
- Обучать модель с GRPO.
- Проверять дообученную модель.
- Сохранять модель в разных форматах.
GRPO — мощный способ научить языковую модель нужному поведению, а Unsloth делает его доступным даже на скромном железе. Сочетая несколько функций награды, можно добиться, чтобы модель соблюдала формат и одновременно лучше рассуждала.
Дополнительные материалы:
12.7. Скоро…
Заголовок раздела «12.7. Скоро…»Эта глава сейчас проходит в формате живого потока! Если вы уже прошли весь материал, вот что вас ждёт.
Расписание курса
Заголовок раздела «Расписание курса»| Дата | Юнит |
|---|---|
| 21 марта 2025 | Интерактивное ревью кода |
| Апрель 2025 | Больше текстов о создании рассуждающих моделей |
| Апрель 2025 | Живые сессии о создании Open R1 |
| Апрель 2025 | Экзамен с кодом и сертификация |
Как следить за новостями
Заголовок раздела «Как следить за новостями»Чтобы следить за курсом, подпишитесь на The Reasoning Course и присоединяйтесь к сообществу в Discord!
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| reward function | функция награды |
| completion | ответ (продолжение), сгенерированное моделью |
group size, num_generations | размер группы, число ответов на промпт |
| verifiable / rule-based reward | проверяемая награда / награда на правилах |
| format reward | награда за формат |
| reward hacking | «взлом» награды |
KL divergence, beta | KL-дивергенция, коэффициент KL-штрафа |
| vibe testing | проверка «на ощупь» (поговорить с моделью вручную) |
| merge and unload | влить адаптер в модель и убрать обёртку PEFT |
| 4-bit quantization | 4-битное квантование |
| gradient checkpointing | перерасчёт активаций (экономия памяти) |
| GGUF | формат файлов модели для llama.cpp |