AI Research Foundations, курс 3, часть 1: от нейрона к MLP
Перевод лабораторных 3.1–3.4 курса Google DeepMind «Design and Train Neural Networks»: недо- и переобучение на маленькой языковой модели, один нейрон и граница решений, зачем нужны скрытый слой и нелинейность, свой MLP на Keras.
Курс 3 программы AI Research Foundations называется «Design and Train Neural Networks» («Спроектируйте и обучите нейросеть»). В курсах 1–2 трансформер был готовым «чёрным ящиком» из пакета курса. Теперь вы открываете ящик на уровень ниже: что такое нейрон, как слои складываются в многослойный перцептрон (MLP), что значит «модель переобучилась» и как это увидеть на кривых потерь. Здесь — первые четыре лабораторные. Продолжение — часть 2: гиперпараметры, регуляризация, градиенты и Keras.
Как проходить вместе с курсом ChinaAI
Заголовок раздела «Как проходить вместе с курсом ChinaAI»| Лабораторная | Время | Когда делать | Что нужно |
|---|---|---|---|
| 3.1. Отличите сигнал от шума | 15 мин | После курса 1 и урока «Обобщение, переобучение, регуляризация» | Keras на JAX, CPU хватит |
| 3.2. Предсказание однослойной нейросетью | 15 мин | Вместе с уроком «Логистическая и softmax-регрессия» или «Нейрон, слой, MLP» | JAX (jax.numpy), CPU |
| 3.3. Разделяем данные посложнее | 20 мин | Вместе с уроком «Нейрон, слой, MLP» | Keras, CPU |
| 3.4. Спроектируйте свой MLP | 20 мин | Вместе с уроком «nn.Module, оптимизаторы, цикл обучения» | Keras, scikit-learn, CPU |
Лабораторная 3.1 использует маленькую языковую модель и BPE-токенизатор из курсов 1–2, остальные три — игрушечные двумерные данные, которые можно нарисовать на плоскости. В курсе ChinaAI вы строите MLP руками (micrograd) и на PyTorch; здесь тот же MLP собирается из кубиков Keras — сравните, сколько работы фреймворк берёт на себя.
Лабораторная 3.1. Отличите сигнал от шума
Заголовок раздела «Лабораторная 3.1. Отличите сигнал от шума»Ноутбук: gdm_lab_3_1_distinguish_between_signal_and_noise.ipynb · открыть в Colab
Посмотрите, как неправильно обученные модели не выучивают устойчивых закономерностей. 15 минут.
В предыдущем материале вы видели, как модель может выучить шум (noise) в обучающих данных. Эта лабораторная развивает идею на трансформере, которого вы уже обучали на наборе Africa Galore. Вы исследуете, как длительность обучения влияет на баланс между полезными закономерностями (сигналом, signal) и нежелательными (шумом).
Напомним из первого курса «01 Build Your Own Small Language Model»: трансформерные языковые модели обучаются, раз за разом сравнивая свои предсказания для контекста с настоящим следующим токеном из обучающих данных. Это повторяется для каждого токена обучающих данных, и часто модель проходит по данным несколько раз. Каждый проход по обучающим данным называется эпохой (epoch).
В каждую эпоху модель обновляет свои параметры, чтобы уменьшить функцию потерь — она показывает, насколько предсказания модели отклоняются от целевых значений. В целом, если модель учится хорошо, потери от эпохи к эпохе падают — вы это видели, когда обучали языковую модель.
В этой лабораторной вы будете давать промпты разным маленьким языковым моделям, которые обучались на зашумлённых данных разное число эпох. Вы увидите, что одна модель не выучила никаких закономерностей, другая выучила и полезные, и нежелательные, а третья выучила в основном полезные.
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»К концу лабораторной вы:
- поймёте, к чему приводит обучение модели слишком малое или слишком большое число эпох;
- получите интуицию того, что значит недообучение (underfitting) и переобучение (overfitting) модели на закономерностях набора данных.
Вы будете работать с тремя маленькими языковыми моделями, которые обучались на зашумлённой версии набора Africa Galore. В этом наборе в одном из абзацев есть опечатка: фраза «a vibrant symbol of» («яркий символ чего-то») написана как «a vibrant symbol fo». Кроме того, это единственное место, где встречается фраза «a vibrant symbol». Во всех остальных абзацах со словом «symbol» прилагательного «vibrant» нет.
В этой лабораторной вы сравните продолжения разных промптов у моделей, которые обучались 10, 400 и 1000 эпох.
Импорты
Заголовок раздела «Импорты»В этой лабораторной вы используете только пакет курса ai_foundations. «Под капотом» он загрузит BPE-токенизатор
из предыдущего курса и трансформер, реализованный на Keras.
%%capture# Ставим специальный пакет курса.!pip install "git+https://github.com/google-deepmind/ai-foundations.git@main"
# Используемые пакеты.from urllib import request  # Чтобы скачать параметры моделей.from IPython import display  # Чтобы аккуратнее выводить результаты некоторых ячеек.
# Настраиваем Keras на вычисления через JAX.import osos.environ["KERAS_BACKEND"] = "jax"
from ai_foundations import training  # Чтобы загрузить заранее обученные модели.from ai_foundations import generation  # Чтобы давать модели промпты.from ai_foundations import tokenization  # Чтобы загрузить токенизатор.
BPEWordTokenizer = tokenization.BPEWordTokenizer
Загружаем токенизатор и параметры моделей
Заголовок раздела «Загружаем токенизатор и параметры моделей»Следующая ячейка загружает токенизатор, заранее обученный на наборе Africa Galore, и параметры трёх маленьких языковых моделей. Ещё она задаёт сам трансформер. Запустите её, чтобы подготовиться к промптам.
# Загружаем токенизатор (BPE на 3000 слияний, как в лабораторной 2.6).tokenizer_url = "https://storage.googleapis.com/dm-educational/assets/ai_foundations/bpe_tokenizer_3000_v2.pkl"tokenizer = BPEWordTokenizer.from_url(tokenizer_url)
# Скачиваем параметры трёх моделей.MODEL_PARAMETER_URLS = {    "africa_galore_10ep_underfit.weights.h5": "https://storage.googleapis.com/dm-educational/assets/ai_foundations/africa_galore_10ep_underfit.weights.h5",    "africa_galore_400ep_good_fit.weights.h5": "https://storage.googleapis.com/dm-educational/assets/ai_foundations/africa_galore_400ep_good_fit.weights.h5",    "africa_galore_1000ep_overfit.weights.h5": "https://storage.googleapis.com/dm-educational/assets/ai_foundations/africa_galore_1000ep_overfit.weights.h5"}
# Скачиваем параметры моделей.for (parameter_file, parameter_url) in MODEL_PARAMETER_URLS.items():    request.urlretrieve(parameter_url, parameter_file)print("Loaded model parameters.")
# Задаём модель. В каждой следующей ячейке с промптом в модель будут загружаться# параметры одной из трёх моделей. Конфигурация модели должна совпадать# с конфигурацией при обучении.model = training.create_model(    max_length=399,    vocabulary_size=tokenizer.vocabulary_size,    learning_rate=1e-4,    embedding_dim=64,    mlp_dim=64,    num_blocks=3)
Промпт модели, обученной 1000 эпох
Заголовок раздела «Промпт модели, обученной 1000 эпох»Начните с модели, которая обучалась больше всех — 1000 эпох. Это значит, что при обучении модель 1000 раз прошла по обучающим данным и 1000 раз обновила параметры, сравнивая свои предсказания с каждым целевым токеном. Получились очень низкие потери — 0,37.
В следующей ячейке дайте модели два промпта:
- «They are serving as a symbol» («Они служат символом»);
- «They are serving as a vibrant symbol» («Они служат ярким символом»).
Прежде чем запускать ячейку, подумайте, чем, скорее всего, будут отличаться две генерации. Вспомните, что говорилось об обучающих данных в разделе «Задачи».
# @title Промпт модели, обученной 1000 эпохmodel.load_weights("africa_galore_1000ep_overfit.weights.h5")display.clear_output()
prompt = 'They are serving as a symbol' #@param {type: 'string'}generated_text, probs = generation.generate_text(prompt, n_tokens=5, model=model, tokenizer=tokenizer, pad_token_id=tokenizer.pad_token_id, sampling_mode="greedy") # жадно: всегда самый вероятный токенprint('Generated Text:', generated_text)Что вы заметили?
Заголовок раздела «Что вы заметили?»Вероятно, вы увидели, что первая модель сгенерировала разумное продолжение для первого промпта, в котором не было слова «vibrant». А для второго промпта она должна была сгенерировать опечатку «fo» вместо «of».
Так происходит потому, что модель выучила из обучающих данных не только верные закономерности, но и нежелательные, свойственные только этим данным. Эта проблема называется переобучением (overfitting): модель подогнала свои параметры слишком точно под закономерности обучающих данных.
Промпт модели, обученной 10 эпох
Заголовок раздела «Промпт модели, обученной 10 эпох»Теперь дайте промпты модели, которая обучалась всего 10 эпох. Потери у неё гораздо выше — 7,55, потому что её параметры обновлялись намного реже, чем у модели на 1000 эпох.
В следующей ячейке снова дайте модели два промпта:
- «They are serving as a symbol»;
- «They are serving as a vibrant symbol».
Как вы думаете, как будут выглядеть генерации этой модели при таких высоких потерях?
# @title Промпт модели, обученной 10 эпохmodel.load_weights("africa_galore_10ep_underfit.weights.h5")display.clear_output()
prompt = 'They are serving as a symbol' #@param {type: 'string'}generated_text, probs = generation.generate_text(prompt,                                      n_tokens=4,                                      model=model,                                      tokenizer=tokenizer,                                      pad_token_id=tokenizer.pad_token_id,                                      sampling_mode="greedy")print('Generated Text:', generated_text)
Что вы заметили?
Заголовок раздела «Что вы заметили?»Вероятно, вы увидели, что эта модель не смогла сгенерировать ничего осмысленного ни для одного из двух промптов. Вместо этого она несколько раз сгенерировала слово «the».
Так происходит потому, что модель обучалась недостаточно долго и не выучила из обучающих данных никаких закономерностей. Эта проблема называется недообучением (underfitting): модель подогнала свои параметры под закономерности обучающих данных недостаточно точно.
Промпт модели, обученной 400 эпох
Заголовок раздела «Промпт модели, обученной 400 эпох»Наконец, дайте промпты модели, которая обучалась 400 эпох. Её потери — 2,77. Как видите, это гораздо меньше, чем у модели, обученной всего 10 эпох, но заметно больше, чем у модели, обученной 1000 эпох.
В следующей ячейке снова дайте модели два промпта:
- «They are serving as a symbol»;
- «They are serving as a vibrant symbol».
Как, по-вашему, будут выглядеть генерации этой модели?
# @title Промпт модели, обученной 400 эпохmodel.load_weights("africa_galore_400ep_good_fit.weights.h5")display.clear_output()
prompt = 'They are serving as a symbol' #@param {type: 'string'}generated_text, probs = generation.generate_text(prompt,                                      n_tokens=4,                                      model=model,                                      tokenizer=tokenizer,                                      pad_token_id=tokenizer.pad_token_id,                                      sampling_mode="greedy")print('Generated Text:', generated_text)
Что вы заметили?
Заголовок раздела «Что вы заметили?»Вероятно, вы увидели, что эта модель дала осмысленные генерации для обоих промптов. В обоих случаях она сгенерировала продолжение «of East African cultures» («…культур Восточной Африки»). Даже на промпт со словами «a vibrant symbol» она выдала правильный предлог «of» без опечатки.
Так происходит потому, что модель правильно подогнана под закономерности обучающих данных. Она выучила полезные закономерности — например, что «of» часто идёт после фраз вроде «a symbol» или «a vibrant symbol». И она не выучила нежелательных закономерностей, которые были лишь случайными особенностями обучающих данных.
Как вы увидели в этой лабораторной, низкие потери на обучающих данных сами по себе плохо говорят о том, хороша модель или плоха. У первой модели потери были самые низкие (0,37), но она выучила не только полезные закономерности (сигнал), но и нежелательные, свойственные лишь обучающим данным (шум). Это классический случай переобучения.
У второй модели потери на обучении были гораздо выше (7,55), и она не смогла сгенерировать ни одного осмысленного продолжения. Модель не выучила полезных закономерностей (сигнала) обучающих данных — классический случай недообучения.
Последняя модель с потерями 2,77 нашла хороший баланс и дала разумные ответы на оба промпта. Она выучила полезную закономерность, что после фраз вроде «a symbol» или «a vibrant symbol» обычно идёт «of» (сигнал), и не выучила закономерностей, свойственных только обучающим данным (шум). Значит, она выучила более абстрактные закономерности и может обобщать (generalize) на новые ситуации.
В следующих заданиях вы подробнее узнаете о переобучении и недообучении и о том, как их избежать. Вы также узнаете, как добиться, чтобы модель хорошо обобщала, отвечая на промпты, мало похожие на промпты из обучающих данных.
flowchart LR
A["10 эпох<br/>потери 7,55"] -->|"недообучение:<br/>the the the"| X["ни сигнала, ни шума"]
B["400 эпох<br/>потери 2,77"] -->|"хорошая подгонка:<br/>of East African cultures"| Y["сигнал без шума"]
C["1000 эпох<br/>потери 0,37"] -->|"переобучение:<br/>vibrant symbol fo"| Z["сигнал и шум"]
Лабораторная 3.2. Предсказание однослойной нейросетью
Заголовок раздела «Лабораторная 3.2. Предсказание однослойной нейросетью»Ноутбук: gdm_lab_3_2_make_predictions_with_a_single_layer_neural_network.ipynb · открыть в Colab
Разделите эмбеддинги на два класса однослойной нейросетью. 15 минут.
В этой лабораторной вы интуитивно поймёте, как работают нейросети и многослойные перцептроны, разобрав, как принимает решения один искусственный нейрон. Вы увидите, как разделяющая прямая классифицирует двумерные точки двух классов. Каждая точка набора данных — эмбеддинг промпта. Задача классификатора — предсказать следующий токен из двух: «water» («вода») и «food» («еда»).
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»К концу лабораторной вы поймёте, как можно разделить данные для бинарной классификации (на два класса).
Ваша задача — подобрать веса и смещение одного искусственного нейрона так, чтобы найти границу решений, которая разделяет два класса. Нейрон использует сигмоидную функцию активации, чтобы вычислить вероятность класса 1. Такой классификатор ещё называют логистической регрессией — возможно, вы встречали её в курсе статистики.
В этой лабораторной вы:
- загрузите набор двумерных эмбеддингов;
- нарисуете набор данных;
- вручную подберёте веса и смещение, пока получившаяся граница решений идеально не разделит два класса.
Импорты
Заголовок раздела «Импорты»В этой лабораторной вы используете модуль numpy пакета JAX, чтобы задавать векторы. В нём почти те же функции, что
в numpy, с которым вы познакомились в прошлом курсе, но он оптимизирован для данных и параметров нейросетей. Как вы
увидите в следующих модулях курса, у него есть и дополнительные возможности, которые упрощают обучение нейросетей.
Пока что думайте о нём ровно как о numpy, только вместо префикса np пишите jnp (от jax.numpy). Ещё лабораторная
использует pandas, чтобы загрузить и показать набор данных, и пакет курса ai_foundations для графиков.
%%capture# Ставим специальный пакет курса.!pip install "git+https://github.com/google-deepmind/ai-foundations.git@main"
# Используемые пакеты.import jax.numpy as jnp  # Чтобы задавать векторы и матрицы.import pandas as pd  # Чтобы загрузить и показать набор данных.from ai_foundations import visualizations  # Чтобы рисовать графики.
Загружаем набор данных
Заголовок раздела «Загружаем набор данных»Вы будете работать с маленьким набором данных: эмбеддингами для предсказания следующего токена по 20 разным промптам. Эти эмбеддинги промптов (prompt embeddings) устроены похоже на эмбеддинги токенов, которые вы видели в прошлом курсе. Но идея эмбеддинга промпта в том, что он кодирует информацию не одного токена, а всего промпта. В следующем курсе («04 Discover the Transformer Architecture») вы узнаете, как вычислять такие эмбеддинги промптов трансформером. Пока просто считайте, что такие методы существуют и их результат — двумерные точки из загружаемого набора.
У половины эмбеддингов промптов в этом наборе вероятный следующий токен — «food», у другой половины — «water». Цель классификатора, который вы строите в этой лабораторной, — правильно предсказать следующий токен.
Запустите следующую ячейку, чтобы скачать данные.
# Загружаем данные с помощью pandas.df = pd.read_csv("https://storage.googleapis.com/dm-educational/assets/ai_foundations/food-water-dataset.csv")
# Достаём эмбеддинги (Embedding_dim_1, Embedding_dim_2) и метки.# Эмбеддинги представляем массивом JAX с помощью функции jnp.array.input_features = jnp.array(df[["Embedding_dim_1", "Embedding_dim_2"]].values)labels = df["Label"].values  # Метки: "food" или "water".
# Переводим метки в числа для графиков (food = 1, water = 0).numeric_labels = jnp.where(labels == "food", 1, 0)
# Печатаем загруженные данные для проверки.df.head(n=20)
Что вы увидите (несколько строк из 20):
| Prompt (промпт) | dim 1 | dim 2 | Label |
|---|---|---|---|
| Jide was hungry so she went looking for («Джиде проголодалась и пошла искать…») | 0.27 | 0.39 | food |
| The lion went hunting for («Лев отправился охотиться за…») | 0.61 | 1.64 | food |
| My doctor advised me to avoid very fatty («Врач посоветовал мне избегать очень жирной…») | 0.71 | 0.41 | food |
| Jide was thirsty so she went looking for («Джиде захотела пить и пошла искать…») | −1.34 | −0.74 | water |
| The first step in making tea is to boil the («Чтобы заварить чай, сначала вскипятите…») | −1.26 | −0.90 | water |
| The boat cut through the river’s calm («Лодка рассекала спокойную речную…») | −1.78 | −1.00 | water |
Рисуем точки данных
Заголовок раздела «Рисуем точки данных»Сначала запустите следующую ячейку, чтобы нарисовать двумерные эмбеддинги.
visualizations.plot_data_and_decision_boundary( input_features, labels, title="2D Prompt Embeddings")Синие точки — эмбеддинги промптов, после которых следующим токеном должно быть «water», жёлтые — промптов, после которых должно быть «food». Все синие точки лежат довольно близко друг к другу, и все жёлтые — тоже. Поэтому можно построить классификатор, который разделит классы с высокой точностью, — а значит, и языковую модель, которая вполне сносно предсказывает следующий токен из этого списка двух возможных.
Заметьте также, что все эти точки считаются обучающими примерами, отдельной тестовой выборки (test set) пока нет. В следующих лабораторных вы будете обучать модели автоматически и для этого сначала будете делить набор данных на обучающую и тестовую выборки.
Задание 1. Подбираем веса и смещение вручную
Заголовок раздела «Задание 1. Подбираем веса и смещение вручную»Напомним из предыдущей статьи: один слой многослойного перцептрона (MLP) вычисляет взвешенную сумму входного вектора как скалярное произведение на вектор весов . Итоговый выход получается, если прибавить смещение (bias) и применить нелинейную функцию активации, например сигмоиду :
Словами: умножаем каждый признак на его вес, складываем, прибавляем смещение и пропускаем через сигмоиду, которая превращает любое число в вероятность от 0 до 1. Например, при , и точке («Jide was hungry…») взвешенная сумма равна , а — модель на 66% уверена, что дальше будет «food».
В этом задании вы вручную подберёте вектор весов и смещение так, чтобы получившийся классификатор идеально разделил два класса набора данных.
Вспомните: для положительных чисел сигмоида возвращает значение больше 0,5, для отрицательных — меньше 0,5. Поэтому классификатор работает правильно, если для всех точек положительного класса (здесь им произвольно выбран «food») и для всех точек отрицательного класса (здесь «water»).
Классификатор с двумерным входом удобно изображать через границу решений (decision boundary). Это прямая (или несколько прямых), которая делит плоскость так, что по одну сторону от неё классификатор для всех точек предсказывает один класс, а по другую — другой.
# Начальная догадка для весов и смещения.weight_vector = jnp.array([-0.5, 0.45])  # Вектор весов: [w1, w2].bias_term = 0.2  # Смещение.
visualizations.plot_data_and_decision_boundary( input_features, labels, weight_vector, bias_term, provide_feedback=True)Что вы заметили?
Заголовок раздела «Что вы заметили?»Заметьте, что все точки положительного класса («food») собраны вокруг . Поэтому, если выбрать вектор весов, похожий на , он будет указывать в сторону положительного класса. Тогда для всех точек положительного класса и для всех точек отрицательного («water»).
Если к тому же взять смещение близким к , удаётся избежать ортогональных точек — тех, для которых скалярное произведение равно или близко к нему. Такая граница решений идеальна: она отстоит от всех точек как можно дальше и при этом идеально разделяет данные.
В этой лабораторной вы разобрали, как разделить два класса эмбеддингов на плоскости одним искусственным нейроном. Вы исследовали, как, меняя вектор весов и смещение, передвигать границу решений, чтобы она правильно разделяла классы. Подбирая параметры вручную, вы поняли, как скалярное произведение связано с классификацией.
Вы увидели: чтобы хорошо разделить классы, вектор весов должен указывать в сторону «положительного» класса (здесь — «food»). Кроме того, вы увидели, что для точки, лежащей точно на границе, скалярное произведение с вектором весов равно нулю. Такая точка ортогональна вектору весов: классификатор не относит её ни к одному классу.
Решения
Заголовок раздела «Решения»Задание 1
# Один из вариантов, который идеально разделяет данные.weight_vector = jnp.array([1.0, 1.0])bias_term = 0 # Смещение.Лабораторная 3.3. Разделяем данные посложнее
Заголовок раздела «Лабораторная 3.3. Разделяем данные посложнее»Ноутбук: gdm_lab_3_3_separate_more_complex_data.ipynb · открыть в Colab
Посмотрите, как несколько слоёв позволяют многослойному перцептрону выучить сложные границы решений. 20 минут.
В этой лабораторной — ещё одна задача предсказания следующего токена. На этот раз вы обучите модель выбирать правильный токен из трёх возможных:
- «mat» («коврик»);
- «apple» («яблоко»);
- «bank» («берег» или «банк»).
В прошлой лабораторной хватило классификатора на одном нейроне (и, значит, на одном слое), чтобы разделить эмбеддинги на два класса. Для эмбеддингов этой задачи так не получится. Вы увидите, что для правильного разделения данных на три класса на самом деле нужна многослойная нейросеть.
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»К концу лабораторной вы:
- поймёте, к чему приводит добавление скрытого слоя (hidden layer) в нейросеть;
- поймёте роль нелинейной функции активации.
Представьте, что модель должна выбрать правильный следующий токен из «mat», «apple», «bank».
Помните, что у слова «bank» два значения:
- берег реки (river bank);
- финансовое учреждение, банк.
Поэтому эмбеддинг промпта вроде «They walked along the river» («Они шли вдоль реки…») будет сильно отличаться от эмбеддинга промпта вроде «They deposited the check at the nearest» («Они положили чек в ближайший…»).
В этой лабораторной вы изобразите и сравните границы решений:
- однослойной нейросети с несколькими нейронами;
- многослойной нейросети без функции активации;
- многослойной нейросети с функцией активации ReLU.
В этом задании нужно только запускать код ноутбука, чтобы обучить модели и построить картинки. Дописывать код не нужно. Сосредоточьтесь на картинках на каждом шаге.
Импорты
Заголовок раздела «Импорты»В этой лабораторной вы в основном работаете с готовыми функциями пакета курса ai_foundations: с их помощью задаёте
и обучаете MLP и строите картинки. «Под капотом» пакет задаёт и обучает MLP на Keras.
%%capture# Ставим специальный пакет курса.!pip install "git+https://github.com/google-deepmind/ai-foundations.git@main"
import os  # Чтобы менять настройки Keras.os.environ["KERAS_BACKEND"] = "jax"  # Задаём параметр Keras: вычисления — на JAX.
# Используемые пакеты.import jax.numpy as jnp  # Чтобы превратить эмбеддинги и метки в матрицы.import pandas as pd  # Чтобы загрузить набор данных.from ai_foundations import machine_learning  # Чтобы задавать и обучать MLP.from ai_foundations import visualizations  # Чтобы рисовать данные и границы.
Загружаем и рисуем данные
Заголовок раздела «Загружаем и рисуем данные»Для начала запустите следующую ячейку, чтобы загрузить набор с эмбеддингами и метками. Заметьте: по соглашению матрицу
с входными данными, в нашем случае эмбеддингами, обычно называют X, а вектор с целевыми метками — y. Дальше мы будем
придерживаться этого соглашения.
# Загружаем данные с помощью pandas.df = pd.read_csv("https://storage.googleapis.com/dm-educational/assets/ai_foundations/mat-apple-bank-dataset.csv")
# Достаём эмбеддинги (Embedding_dim_1, Embedding_dim_2) и метки.X = jnp.array(df[["Embedding_dim_1", "Embedding_dim_2"]].values)# Метки: 0 ("mat"), 1 ("apple") или 2 ("bank").y = jnp.array(df["Label"].values)
# Метки, понятные человеку.labels = ["mat", "apple", "bank"]
Затем запустите следующую ячейку, чтобы нарисовать точки.
visualizations.plot_data_and_mlp(X, y, labels, title="2D Embeddings of Sentences")Что вы заметили?
Заголовок раздела «Что вы заметили?»Скорее всего, вы заметили, что зелёные точки класса «bank» разбиты на два облака. Значит, прямыми линиями хорошо разделить все три класса не получится.
Обучаем однослойную модель
Заголовок раздела «Обучаем однослойную модель»Теперь обучите на этих данных однослойную модель и изобразите её границы решений. В отличие от прошлой лабораторной, у этой модели в слое несколько нейронов, а функция активации — SoftMax. Поэтому границ решений будет несколько, а не одна.
Запустите следующую ячейку несколько раз. Каждый раз она обучает однослойную модель и рисует её границу решений.
# Параметр hidden_dims задаёт размеры скрытых слоёв.# Если передать пустой список, как здесь, MLP создаётся без скрытых слоёв,# то есть получается однослойная нейросеть.## Как реализовать MLP на Python, вы узнаете в следующих лабораторных.# Пока для задания MLP используйте `build_mlp`, а для обучения — `train_mlp`.model_1layer = machine_learning.build_mlp(hidden_dims=[], n_classes=3)
history = machine_learning.train_mlp(model_1layer, X, y, 200)  # 200 эпох
print(f"Accuracy (single layer model): {history.history['accuracy'][-1]*100:.2f}%")
visualizations.plot_data_and_mlp(    X,    y,    labels,    mlp_model=model_1layer,    title="Decision Boundaries - Single Layer Model",)
Что вы заметили?
Заголовок раздела «Что вы заметили?»Модель поделила плоскость на три области, разделённые двумя прямыми (иногда одна из трёх областей слишком мала, чтобы её разглядеть, но областей всегда три). Сколько ни перезапускай обучение, модель никогда не разделит три класса идеально. Так происходит потому, что однослойная модель может выучить только такие линейные границы решений.
Над картинкой код печатает ещё и долю правильных ответов (accuracy) модели на обучающих данных. Это метрика: процент примеров, классифицированных правильно. Доля правильных ответов 100% значит, что модель отнесла к правильному классу каждый пример набора.
Обучаем многослойную нейросеть
Заголовок раздела «Обучаем многослойную нейросеть»Чтобы это исправить, поэкспериментируйте с моделью, у которой есть дополнительный скрытый слой. Запустите следующую ячейку, чтобы обучить многослойную нейросеть и изобразить её новую границу решений.
Сначала изобразите такую модель: в ней несколько слоёв, но в скрытом слое нет функции активации.
# Значение [10] означает, что у модели будет один скрытый слой# из 10 нейронов.hidden_dims = [10]model_2layer = machine_learning.build_mlp(    hidden_dims=hidden_dims, n_classes=3, activation="linear"  # без нелинейности)
history = machine_learning.train_mlp(model_2layer, X, y, 200)
print(f"Accuracy (multi-layer model): {history.history['accuracy'][-1]*100:.2f}%")visualizations.plot_data_and_mlp(    X,    y,    labels,    mlp_model=model_2layer,    title="Decision Boundaries - Multi-Layer Model",)
Что вы заметили?
Заголовок раздела «Что вы заметили?»Как вы, скорее всего, увидели, модель выучивает несколько границ решений, но и они не могут правильно разделить данные. Дело в том, что без нелинейной функции активации многослойная нейросеть не может выучить функции сложнее, чем однослойная.
Добавляем функцию активации
Заголовок раздела «Добавляем функцию активации»Следующая сеть в точности такая же, как выше, но выход скрытого слоя вычисляется с функцией активации ReLU. Запустите ячейку и посмотрите, как изменятся границы решений.
# Значение [10] означает, что у модели будет один скрытый слой# из 10 нейронов.hidden_dims = [10]model_2layer = machine_learning.build_mlp(    hidden_dims=hidden_dims, n_classes=3, activation="relu"  # ReLU(z) = max(0, z))
history = machine_learning.train_mlp(model_2layer, X, y, 200)
print(f"Accuracy (multi-layer model): {history.history['accuracy'][-1]*100:.2f}%")visualizations.plot_data_and_mlp(    X,    y,    labels,    mlp_model=model_2layer,    title="Decision Boundaries - Multi-Layer Model",)
Что вы заметили?
Заголовок раздела «Что вы заметили?»Теперь модель должна правильно классифицировать оба облака «bank». Так происходит потому, что многослойная модель может выучить нелинейные границы решений, которые справляются с такой ситуацией.
Если этого не произошло и скрытый слой не дал хороших предсказаний, измените размер скрытого слоя и попробуйте снова.
Зачем нужна нелинейная функция активации
Заголовок раздела «Зачем нужна нелинейная функция активации»В предыдущих заданиях вы увидели, что правильно разделить точки этого набора может только нейросеть, у которой есть хотя бы один скрытый слой и нелинейная функция активации. В последнем разделе лабораторной — неформальное математическое доказательство, почему это так.
Пусть есть двухслойная нейросеть без функции активации в скрытом слое, у которой:
- входной слой с двумя признаками;
- скрытый слой с одним нейроном;
- выходной слой с одним нейроном.
Для простоты пусть все смещения равны 0, чтобы их можно было не учитывать.
Тогда взвешенная сумма в скрытом слое с весами равна:
Выход скрытого слоя совпадает с , потому что нелинейной функции активации нет:
Теперь рассмотрим выходной слой. Его вход — это выход скрытого слоя . Поэтому взвешенная сумма в выходном слое равна:
Подставим вместо величину (ведь ), а затем подставим и упростим дальше по формулам выше:
Если теперь ввести новые веса и , такие что и , выходной слой можно записать так:
Это уравнение однослойной нейросети с двумя входами. И это не совпадение: любую многослойную нейросеть без нелинейной функции активации можно записать как однослойную. Поэтому сеть без функции активации не может выучить функции сложнее, чем однослойный MLP.
Пример с числами: пусть , , . Тогда двухслойная сеть считает — ровно то же, что один нейрон с весами .
А вот если к взвешенной сумме в скрытом слое применить нелинейную функцию активации, свести многослойный MLP к однослойному уже не получится, и модель может выучить более сложные границы решений.
В этой лабораторной вы попробовали разные нейросети на данных, которые нельзя разделить прямыми. Вы увидели, что однослойная модель не может выучить границы решений, разделяющие три класса набора. А многослойная модель с нелинейной функцией активации смогла выучить нелинейную границу решений и правильно разделить оба облака «bank».
Способность многослойных нейросетей выучивать сложные границы решений — причина, по которой они так сильны и служат основой очень сложных моделей, например языковых.
В следующем задании вы реализуете свой MLP.
Лабораторная 3.4. Спроектируйте свой MLP
Заголовок раздела «Лабораторная 3.4. Спроектируйте свой MLP»Ноутбук: gdm_lab_3_4_design_your_own_mlp.ipynb · открыть в Colab
Реализуйте свою первую нейросеть с нуля. 20 минут.
В этой лабораторной вы реализуете свою первую нейросеть с нуля в пакете глубокого обучения Keras. Вы будете работать с тем же игрушечным набором, что в прошлой лабораторной: двумерными эмбеддингами промптов, для которых модель должна предсказать один из трёх токенов: «mat», «apple», «bank».
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»К концу лабораторной вы:
- сможете реализовывать нейросети на Keras;
- поймёте, как читать кривые потерь (loss curves) процесса обучения.
Вы зададите функцию, которая собирает в нейросеть разные операции. Затем обучите эту нейросеть на наборе с тремя классами («mat», «apple», «bank») и посмотрите, насколько хорошие границы решений модель сможет выучить.
В этой лабораторной вы:
- реализуете функцию, которая задаёт MLP на Keras;
- обучите свой MLP на наборе эмбеддингов;
- нарисуете кривые потерь на обучающей и тестовой выборках;
- изобразите границу решений своей модели.
Импорты
Заголовок раздела «Импорты»В этой лабораторной вы в основном работаете с пакетом keras, чтобы задать нейросеть: он позволяет быстро собирать
сложные нейросети из отдельных кубиков. Функции пакета курса ai_foundations строят картинки и помогают обучать модель.
Ещё понадобится функция из пакета sklearn, чтобы случайно поделить набор на обучающую и тестовую выборки.
%%capture# Ставим специальный пакет курса.!pip install "git+https://github.com/google-deepmind/ai-foundations.git@main"
import os  # Чтобы менять настройки Keras.os.environ['KERAS_BACKEND'] = 'jax'  # Задаём параметр Keras: вычисления — на JAX.
# Используемые пакеты.import jax.numpy as jnp  # Чтобы задавать матрицы.import keras  # Чтобы задать ваш MLP.import pandas as pd  # Чтобы загрузить набор данных.# Чтобы поделить данные на обучающую и тестовую выборки.from sklearn import model_selection
from ai_foundations import machine_learning  # Чтобы обучить ваш MLP.from ai_foundations import visualizations  # Чтобы рисовать данные и границы.from ai_foundations import training  # Чтобы печатать потери по ходу обучения.from ai_foundations.feedback import course_3  # Для обратной связи.
Готовим данные
Заголовок раздела «Готовим данные»Для начала запустите следующую ячейку, чтобы загрузить эмбеддинги и метки. Обратите внимание: в ячейке есть строка, которая автоматически делит данные на обучающую и тестовую выборки:
X_train, X_test, y_train, y_test = model_selection.train_test_split( X, y, test_size=0.2, random_state=42)Функция берёт исходные эмбеддинги (матрицу X) и метки (вектор y) и случайно делит набор так, что 80% примеров попадают
в обучающую выборку, а 20% — в тестовую. По тестовой выборке потом можно проверить, что модель правильно обобщает,
а не переобучилась на шуме обучающих данных.
# Загружаем данные с помощью pandas.df = pd.read_csv("https://storage.googleapis.com/dm-educational/assets/ai_foundations/mat-apple-bank-dataset.csv")
# Достаём эмбеддинги (Embedding_dim_1, Embedding_dim_2) и метки.X = jnp.array(df[["Embedding_dim_1", "Embedding_dim_2"]].values)# Метки: 0 ("mat"), 1 ("apple") или 2 ("bank").y = jnp.array(df["Label"].values)
# Метки, понятные человеку.labels = ["mat", "apple", "bank"]
# Случайно делим набор на обучающую и тестовую выборки.X_train, X_test, y_train, y_test = model_selection.train_test_split(    X, y, test_size=0.2, random_state=42)
# Превращаем данные в массивы JAX, чтобы на них можно было обучать MLP.X_train, y_train = jnp.array(X_train), jnp.array(y_train)X_test, y_test = jnp.array(X_test), jnp.array(y_test)
В наборе 73 точки, так что в тестовую выборку попадёт 15 из них, в обучающую — 58.
Задание 1. Реализуем MLP
Заголовок раздела «Задание 1. Реализуем MLP»Теперь вы реализуете свою первую нейросеть на Keras. В Keras нейросеть задаётся просто: описанием её структуры.
Вы соберёте нейросеть, задав в ячейке ниже список операций. Операция — это, например, вычисление взвешенной суммы или применение нелинейной функции активации.
Например, чтобы собрать простую однослойную нейросеть, можно задать операцию взвешенной суммы и SoftMax-классификацию на 5 классов:
operations = []# keras.layers.Dense добавляет в сеть взвешенную сумму с выходной размерностью 5.operations.append(keras.layers.Dense(5))# Добавляем функцию SoftMax, которая применяется к выходу предыдущей операции.operations.append(keras.layers.Softmax())def construct_operations( hidden_dims: list[int], n_classes: int) -> list[keras.Layer]: """ Строит все операции — вычисления взвешенных сумм и функции активации — для MLP с выходным слоем SoftMax.
Аргументы: hidden_dims: список размеров всех скрытых слоёв. n_classes: число классов выходного слоя.
Возвращает: Список операций — экземпляров слоёв Keras (Layer). """ operations = []
# # # Добавьте свой код здесь. # #
return operations
# Собирает MLP из списка операций.# Эту функцию менять не нужно.def build_mlp(hidden_dims: list[int], n_classes: int) -> keras.Model: """ Строит MLP с помощью функции construct_operations выше.
Аргументы: hidden_dims: список размеров всех скрытых слоёв. n_classes: число классов выходного слоя.
Возвращает: Модель Keras, которая последовательно пропускает данные через все операции из operations. """ operations = construct_operations(hidden_dims, n_classes) return keras.Sequential(operations)Реализовав функцию, запустите следующую ячейку, чтобы проверить реализацию. Если тесты не пройдены, вывод подскажет, что может быть не так.
# Запустите эту ячейку, чтобы проверить реализацию.course_3.test_construct_operations(construct_operations)Обучаем свой MLP
Заголовок раздела «Обучаем свой MLP»Сначала создайте новый экземпляр модели — для этого есть следующая ячейка. Параметры можно менять: добавлять или убирать
скрытые слои и менять число нейронов в каждом. Набор данных задаёт классификацию на три класса, поэтому параметр
n_classes оставьте равным 3.
# Задаём модель с одним скрытым слоем из 10 нейронов.model = build_mlp([10], 3)Затем запустите следующую ячейку, чтобы обучить модель. Каждые 20 эпох функция печатает потери на обучающей и тестовой выборках и долю правильных ответов на них.
training_logger = training.CustomAccuracyPrinter(print_every=20)training_history = machine_learning.train_mlp( model, X_train, y_train, validation_data=(X_test, y_test), # тестовая выборка — только для оценки epochs=200, callbacks=[training_logger],)Рисуем кривые потерь
Заголовок раздела «Рисуем кривые потерь»Когда обучение закончится, нарисуйте кривые потерь на обучающей и тестовой выборках следующей ячейкой.
visualizations.plot_loss_curve(training_history.history)Что вы видите? Падают ли потери? Падают ли они на обучающих данных так же быстро, как на тестовых?
Вспомните рисунок с типичными формами кривых потерь. В оригинале здесь картинка из предыдущей статьи курса (underfitting-overfitting.png). Мы её не копируем; три типичных случая (наше описание):
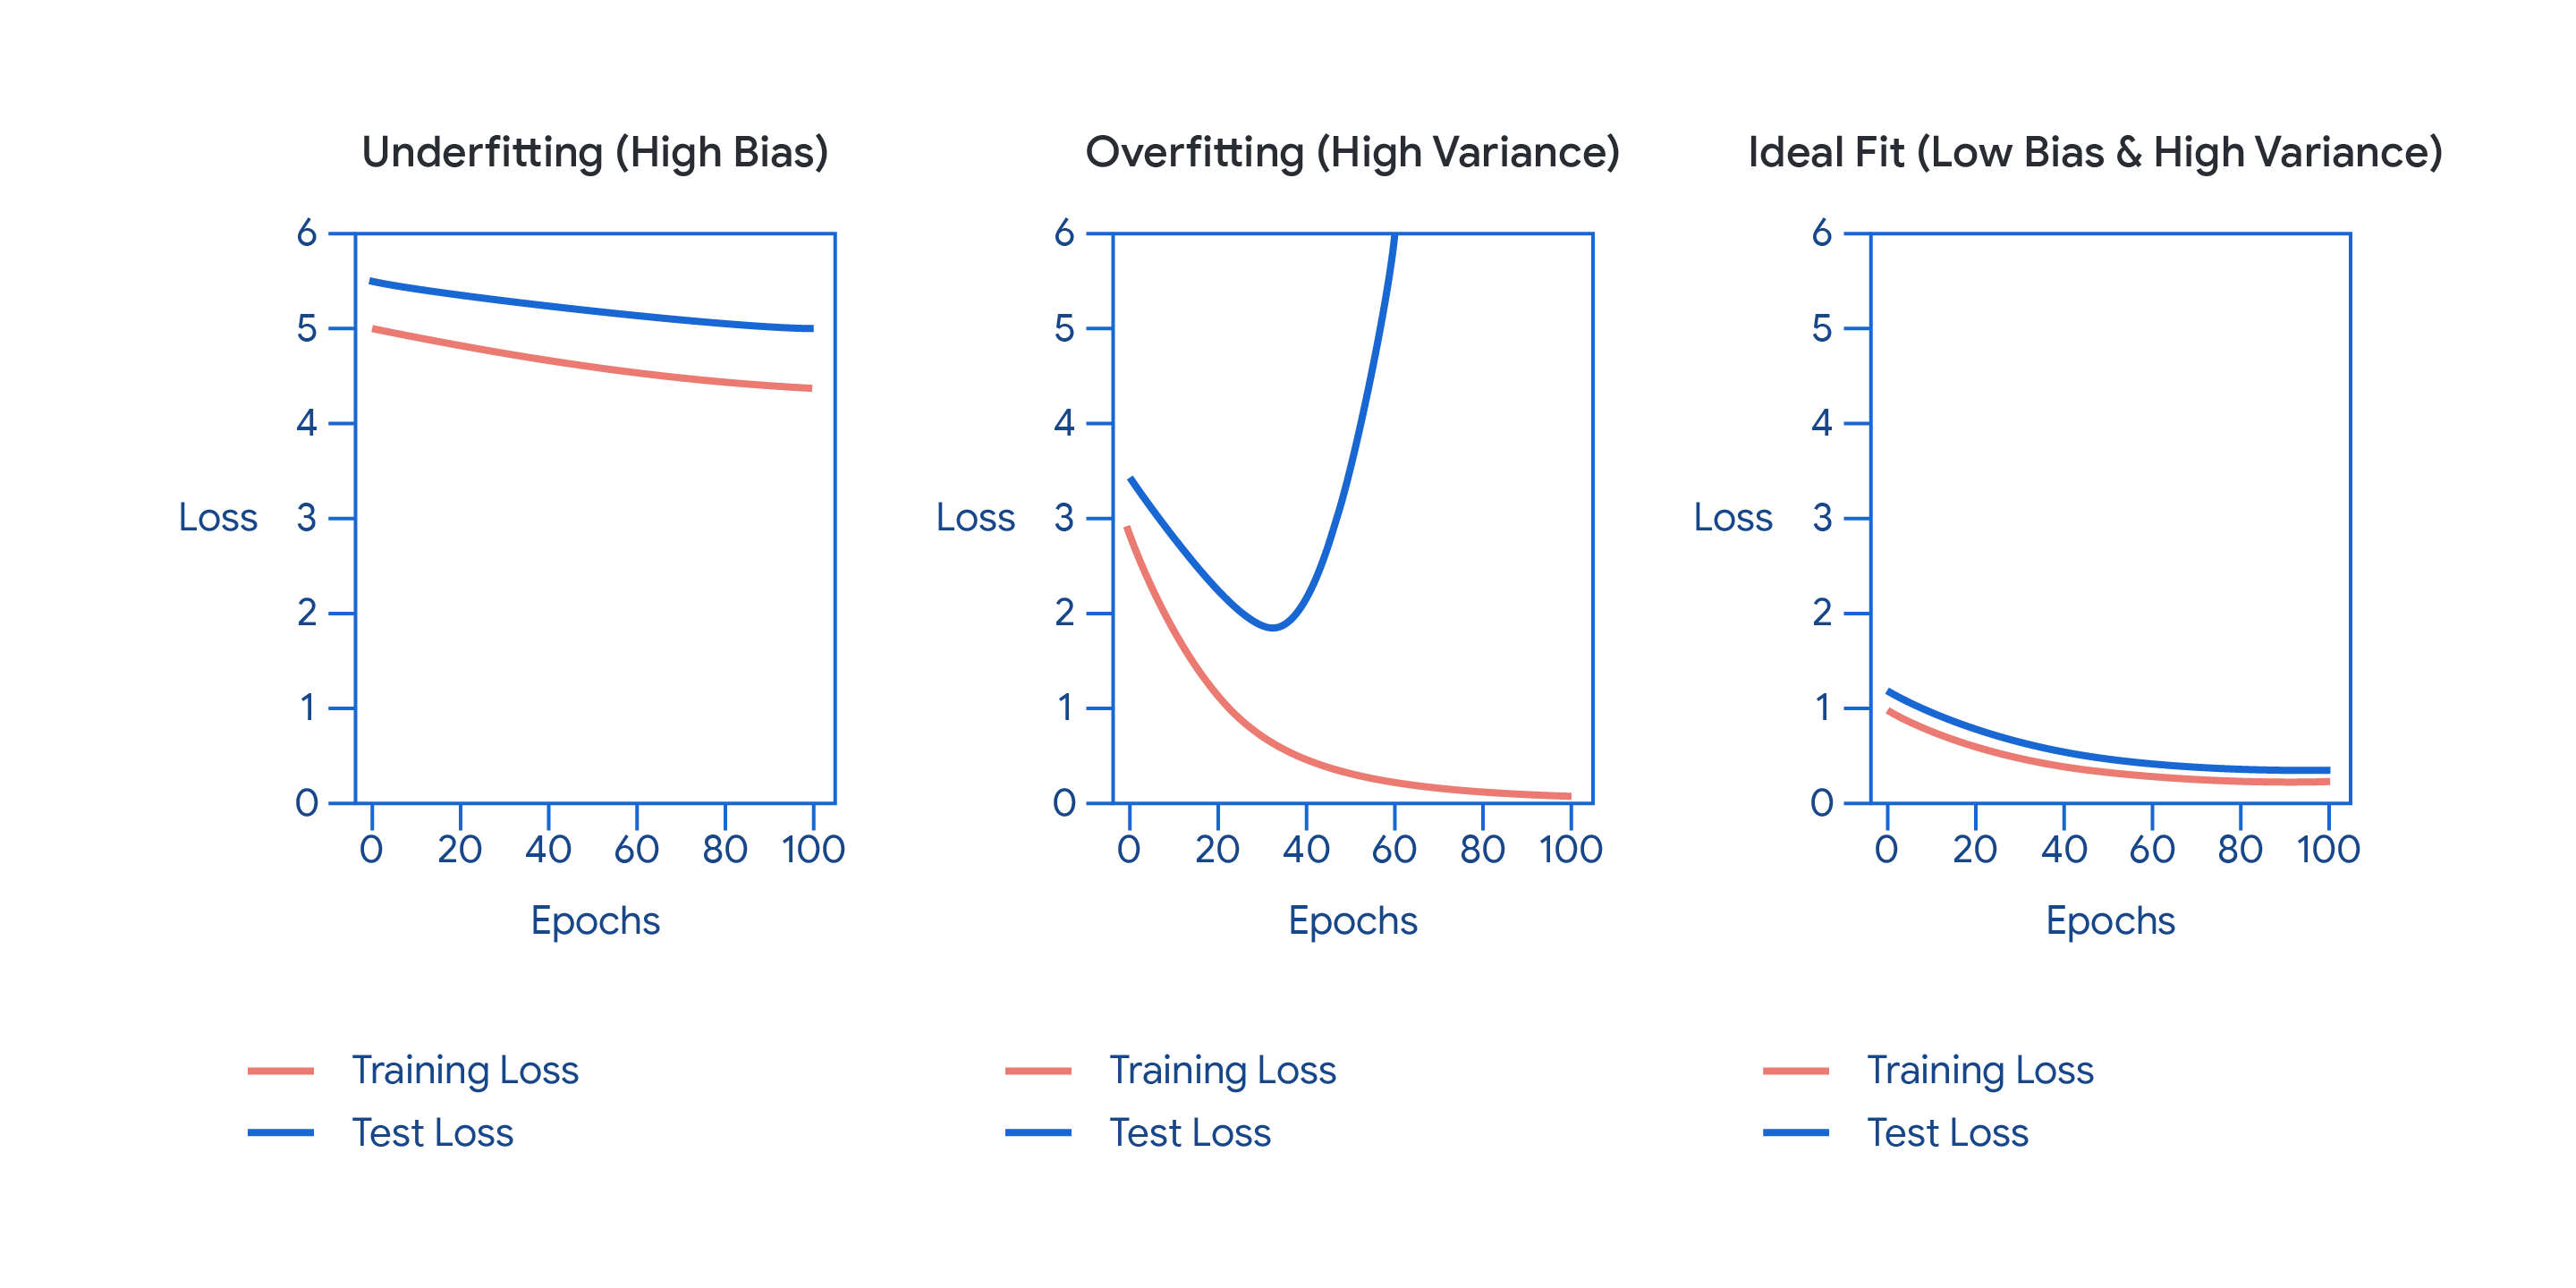
| Что видно на графике | Диагноз |
|---|---|
| Обе кривые высоко и почти не падают | Недообучение: модель слишком простая или учится слишком мало |
| Обе кривые падают и выходят на низкое плато рядом друг с другом | Хорошая подгонка |
| Кривая обучения продолжает падать, а тестовая после минимума начинает расти | Переобучение: модель запоминает шум обучающих данных |
На какой из этих случаев больше всего похожа ваша кривая? Что это говорит о модели и процессе обучения?
Изображаем границы решений
Заголовок раздела «Изображаем границы решений»Теперь можно изобразить и выученные границы решений. Разделяют ли они три класса как следует?
visualizations.plot_data_and_mlp( X_train, y_train, labels, features_test=X_test, label_ids_test=y_test, mlp_model=model, title="Decision Boundaries - Your MLP",)Ваша модель должна хорошо разделять набор. Если это не так, вернитесь к своей реализации MLP и проверьте, что она верна.
В этом задании вы построили свой MLP, который предсказывает следующий токен по эмбеддингам разных промптов. Вы создавали разные структуры моделей, меняя число слоёв и нейронов, и видели, как эти изменения влияют на качество модели и на то, как она разделяет классы («mat», «apple», «bank»). Вы также построили свои первые кривые потерь на обучающей и тестовой выборках. Это задание дало практический опыт реализации нейросетей и наглядно показало, как их структура влияет на обучение.
В следующих заданиях вы узнаете о других способах проверить, что модель обучается правильно и не недообучается и не переобучается на обучающих данных.
Решения
Заголовок раздела «Решения»Задание 1
# Полная реализация функции construct_operations.def construct_operations(hidden_dims: list[int], n_classes: int) -> list[keras.Layer]:    operations = []    for dim in hidden_dims:        operations.append(keras.layers.Dense(dim))  # взвешенные суммы dim нейронов        operations.append(keras.layers.ReLU())      # нелинейность после каждого скрытого слоя
    operations.append(keras.layers.Dense(n_classes))  # Выходной слой: n_classes нейронов.    operations.append(keras.layers.Softmax())         # Превращаем выходы в вероятности.
    return operations
Тот же MLP на PyTorch
Заголовок раздела «Тот же MLP на PyTorch»Это не часть оригинала, а мостик к курсу ChinaAI. Так та же сеть выглядит в PyTorch (урок «nn.Module, оптимизаторы, цикл обучения»):
import torch.nn as nn
def build_mlp_torch(in_dim: int, hidden_dims: list[int], n_classes: int) -> nn.Sequential:    layers = []    prev = in_dim                        # в PyTorch размер входа нужно указать явно    for dim in hidden_dims:        layers += [nn.Linear(prev, dim), nn.ReLU()]        prev = dim    layers.append(nn.Linear(prev, n_classes))    # Softmax в конце обычно НЕ ставят: nn.CrossEntropyLoss сама применяет log-softmax к логитам.    return nn.Sequential(*layers)
print(build_mlp_torch(2, [10], 3))
Два отличия от Keras: размер входа in_dim задаётся явно (Keras узнаёт его при первом вызове), и выходной SoftMax
переносится внутрь функции потерь — так численно устойчивее.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| signal, noise | сигнал, шум |
| epoch | эпоха |
| underfitting, overfitting | недообучение, переобучение |
| generalize | обобщать |
| greedy decoding (sampling mode) | жадное декодирование |
| neuron, weight, bias | нейрон, вес, смещение |
| sigmoid, logistic regression | сигмоида, логистическая регрессия |
| binary classification | бинарная классификация |
| decision boundary | граница решений |
| prompt embedding | эмбеддинг промпта |
| training set, test set | обучающая выборка, тестовая выборка |
| hidden layer, activation function | скрытый слой, функция активации |
| ReLU, SoftMax | ReLU, SoftMax |
| linear / non-linear decision boundary | линейная / нелинейная граница решений |
| accuracy | доля правильных ответов (accuracy) |
| multi-layer perceptron (MLP) | многослойный перцептрон (MLP) |
| loss curve | кривая потерь |
| dense layer | полносвязный слой |