LLM Evaluation Guidebook, часть 2: LLM-as-a-judge, модели награды и оценка людьми
Перевод глав LLM Evaluation Guidebook о моделях-судьях (как выбрать судью, написать промпт, проверить самого судью, бороться с его перекосами), о моделях награды как оценщиках и об оценке людьми — от разметчиков до арен.
Вторая часть перевода LLM Evaluation Guidebook (лицензия CC BY-NC-SA 4.0; перевод распространяется на тех же условиях). Начало — часть 1: инференс, токенизация и автоматические бенчмарки, продолжение — часть 3: отладка.
LLM-as-a-judge: основы
Заголовок раздела «LLM-as-a-judge: основы»Что такое оценка моделью-судьёй?
Заголовок раздела «Что такое оценка моделью-судьёй?»Модели-судьи — это просто нейросети, которые оценивают вывод других нейросетей. Чаще всего они оценивают сгенерированный текст.
Модели-судьи бывают разными: от маленьких специализированных классификаторов (представьте «спам-фильтр», только,
например, для токсичности) до LLM — больших универсальных или маленьких специализированных. Во втором случае, используя
LLM как судью, вы даёте ей промпт с объяснением, как ставить оценки (например: Оцени связность текста от 0 до 5, где 0 — совершенно непонятный…).
Модели-судьи позволяют оценивать текст по сложным и тонким свойствам. Например, точное совпадение предсказания с эталоном позволяет проверить, назвала ли модель правильный факт или число, но для оценки более открытых способностей (связности, качества стихов, верности исходному тексту) нужны более сложные оценщики.
Тут и вступают в игру модели-судьи.
Их используют в трёх основных задачах:
- оценка генерации модели по заданной шкале, чтобы измерить свойство текста (связность, токсичность, согласованность, убедительность и т. д.);
- попарное сравнение: сравнить пару выводов моделей и выбрать лучший по заданному свойству;
- вычисление сходства вывода модели с эталоном.
Примечание: здесь я пока сосредоточусь на подходе «LLM + промпт», но обязательно посмотрите, как работают судьи-классификаторы: по-моему, они довольно надёжны и хорошо подходят для многих задач. Посмотрите и на недавно появившийся многообещающий подход «модель награды как судья» (впервые описан в этом техотчёте); о нём — небольшой раздел ниже.
Плюсы и минусы LLM-судей
Заголовок раздела «Плюсы и минусы LLM-судей»LLM-судей используют ради следующего:
- Объективность по сравнению с людьми: они автоматизируют эмпирические суждения объективно и воспроизводимо.
- Масштаб и воспроизводимость: они масштабируются лучше разметчиков-людей и позволяют воспроизводить оценку на больших объёмах данных.
- Стоимость: их дёшево запустить — не нужно обучать новую модель, достаточно хорошего промпта и существующей качественной LLM. И это дешевле, чем платить настоящим разметчикам.
- Согласие с людьми: их оценки в какой-то мере коррелируют с оценками людей.
У каждого пункта есть и обратная сторона:
- LLM-судьи кажутся объективными, но у них много скрытых перекосов (biases), которые труднее заметить, чем человеческие, потому что мы их так активно не ищем (см. «Советы и приёмы» ниже). Кроме того, человеческие перекосы можно уменьшать, составляя вопросы анкет особым статистически надёжным образом (социология изучает это около века), а промптинг LLM пока не так надёжен. Оценку LLM с помощью LLM сравнивают с эффектом «эхо-камеры», незаметно усиливающей перекосы.
- Они действительно масштабируются, но порождают огромные объёмы данных, которые сами нужно проверять на качество (например, качество LLM-судей можно повысить, попросив их писать рассуждение перед оценкой, — а это ещё больше новых искусственных данных для анализа).
- Их действительно дёшево запустить, но оплата настоящих разметчиков-экспертов, скорее всего, даст качественно лучшие результаты для ваших конкретных задач.
С чего начать?
Заголовок раздела «С чего начать?»Если хотите попробовать, сначала прочитайте очень хорошее руководство (⭐) Аймерика Руше о том, как настроить первого LLM-судью! Можно попробовать и библиотеку distilabel, которая позволяет генерировать синтетические данные и улучшать их с помощью LLM. В ней есть хороший туториал, применяющий методику статьи UltraFeedback, и туториал о бенчмаркинге, реализующий бенчмарк Arena Hard.
LLM-as-a-judge: как получить модель-судью
Заголовок раздела «LLM-as-a-judge: как получить модель-судью»Можно взять существующую LLM — универсальную сильную модель или маленькую специализированную, обученную различать ответы на данных предпочтений, — либо обучить свою.
Универсальная LLM
Заголовок раздела «Универсальная LLM»С появлением сильных LLM (вроде ChatGPT) исследователи начали использовать большие модели как судей. Лучшие большие модели-судьи сейчас обычно закрытые (вроде Claude или моделей GPT-o), но разрыв с открытыми моделями очень быстро сокращается благодаря таким качественным моделям, как Qwen 2.5, Command R+ или Llama 3.1-405B-Instruct.
У закрытых моделей, несмотря на их качество, несколько недостатков:
- они доступны через API, значит, модели (а значит, и результаты) могут измениться без предупреждения, и оценки перестанут воспроизводиться;
- это чёрные ящики, их нельзя интерпретировать;
- они могут стать источником утечки данных: вы отправляете данные третьей стороне через интернет (обычно это менее безопасно, чем данные под вашим управлением) и не знаете наверняка, что с ними делают (часто приходится отдельно отказываться от их использования в обучающих наборах).
Зато они дают любому доступ к качественной модели без локальной настройки и без своего железа. Теперь эти плюсы есть и у большинства сильных открытых моделей, доступных через провайдеров, — и они решают первые две проблемы.
Хороший анализ стоимости провайдеров — здесь, если нужно выбрать.
Маленькая специализированная модель-судья
Заголовок раздела «Маленькая специализированная модель-судья»Можно выбрать и крошечных специализированных LLM-судей. Обычно у них пара миллиардов параметров, они работают локально на большинстве современных потребительских видеокарт и либо обучены с нуля, либо дообучены на инструктивных данных. Часто нужно следовать их особому формату промпта.
Существующие модели:
- Flow-Judge-v0.1 (веса), 3,8B параметров — Phi-3.5-mini-instruct, дообученная на синтетическом наборе предпочтений;
- Prometheus (веса, статья), 13B параметров — модель, обученная на синтетическом наборе предпочтений. Есть и v2 на 7B — Mistral-7B-Instruct-v0.2, дообученная на большем синтетическом наборе, с добавленным слиянием весов;
- JudgeLM (статья), от 7B до 33B параметров — модели, обученные на синтетических наборах предпочтений, сгенерированных разными моделями.
Обучить свою
Заголовок раздела «Обучить свою»Можно обучить или дообучить собственного LLM-судью.
Сначала нужно собрать данные предпочтений для вашей задачи. Они могут быть:
- из существующих наборов человеческих предпочтений;
- сгенерированы моделями (можно сделать по описаниям данных из статей о маленьких судьях выше или взять готовые, например коллекции Prometheus: предпочтения и отзывы).
Затем решить: обучать с нуля маленькую модель или взять существующую, которую можно:
- дистиллировать в новую модель поменьше;
- квантовать;
- затем дообучить на этих данных (через PEFT или адаптеры, если модель большая, а вычислений мало):
- судя по всему, начинать с модели награды лучше, чем с instruct-модели.
LLM-as-a-judge: как написать промпт для оценки
Заголовок раздела «LLM-as-a-judge: как написать промпт для оценки»Общие советы по промпту
Заголовок раздела «Общие советы по промпту»Общие рекомендации по составлению самого промпта, которые я встречала:
- Чётко опишите задачу:
Твоя задача — сделать X.Тебе дадут Y.
- Дайте чёткие инструкции по критериям оценки, включая при необходимости подробную шкалу:
Оцени свойство Z по шкале от 1 до 5, где 1 означает…Определи, присутствует ли свойство Z в примере Y. Свойство Z присутствует, если…
- Добавьте шаги «рассуждения» для оценки:
Чтобы оценить эту задачу, сначала внимательно прочитай пример Y и найди…, затем…
- Укажите нужный формат вывода (поля помогают согласованности):
Дай ответ в JSON в формате {"Score": твоя оценка, "Reasoning": рассуждение, которое привело к этой оценке}
Можно и нужно вдохновляться шаблонами промптов MixEval или MTBench.
Ещё несколько наблюдений:
- попарное сравнение лучше коррелирует с предпочтениями людей, чем выставление оценок, и в целом надёжнее;
- если оценка всё-таки нужна, используйте целочисленную шкалу и подробно объясните, что означает каждая
оценка, или используйте аддитивный промпт (
дай 1 балл за такое-то свойство ответа, ещё 1 балл, если…и т. д.); - один промпт на одну оцениваемую способность обычно даёт лучшие и более надёжные результаты.
Как повысить точность суждений
Заголовок раздела «Как повысить точность суждений»Точность можно повысить и следующими, возможно, более дорогими приёмами:
- Примеры few-shot: как и во многих задачах, примеры помогают модели рассуждать. Но они увеличивают длину контекста.
- Эталон: если он есть, добавьте его в промпт — это повышает точность.
- Цепочка рассуждений (CoT): повышает точность, если попросить модель вывести рассуждение до оценки (то же наблюдали здесь).
- Многоходовой анализ: может улучшить обнаружение фактических ошибок.
- Жюри (несколько судей, ответ — агрегат их ответов): даёт лучшие результаты,
чем одна модель:
- это можно сделать заметно дешевле, взяв много маленьких моделей вместо одной большой дорогой;
- можно экспериментировать и с одной моделью при разных температурах.
- Как ни удивительно, сообщество обнаружило, что «ставки» в промпте (
ответь правильно, и получишь котёнка) могут повышать правильность. Результат у вас может отличаться — подстраивайтесь под свою задачу.
Замечание о промптах: в зависимости от того, насколько ответственна ваша задача, чтобы максимально убрать перекосы, стоит изучить работы социологов о том, как составлять хорошие анкеты. Если вы считаете оценщика заменой человека-разметчика, то и смотреть нужно на похожие метрики: согласованность разметчиков, правильную методологию анкет для снижения перекосов и т. д.
Впрочем, большинству не очень нужна воспроизводимая, качественная и непредвзятая оценка — их устроит быстрая и грязная оценка с более-менее нормальными промптами. (И это нормально! Всё зависит от последствий.)
LLM-as-a-judge: как оценить самого оценщика
Заголовок раздела «LLM-as-a-judge: как оценить самого оценщика»Прежде чем использовать LLM-судью в продакшне или в большом масштабе, нужно сначала оценить его качество на вашей задаче и убедиться, что его оценки действительно осмысленны и полезны.
Примечание: это проще, если судья выдаёт двоичные ответы: тогда можно использовать понятные метрики классификации (точность, полноту, precision). Если он выставляет оценки по шкале, оценить качество корреляции с эталоном гораздо труднее.
Итак, выбрав модель-судью и её промпт, сделайте следующее.
1. Выберите эталон
Заголовок раздела «1. Выберите эталон»Оценки судьи нужно сравнить с эталоном (baseline): это могут быть разметки людей, выводы другого судьи, который вы считаете качественным для этой задачи, истинные ответы, тот же судья с другим промптом и т. д.
Много примеров не нужно (может хватить 50), но они должны быть очень представительными для вашей задачи, различающими (в частности, включать пограничные случаи) и максимально качественными.
2. Выберите метрику
Заголовок раздела «2. Выберите метрику»Метрика нужна, чтобы сравнивать оценки судьи с эталоном.
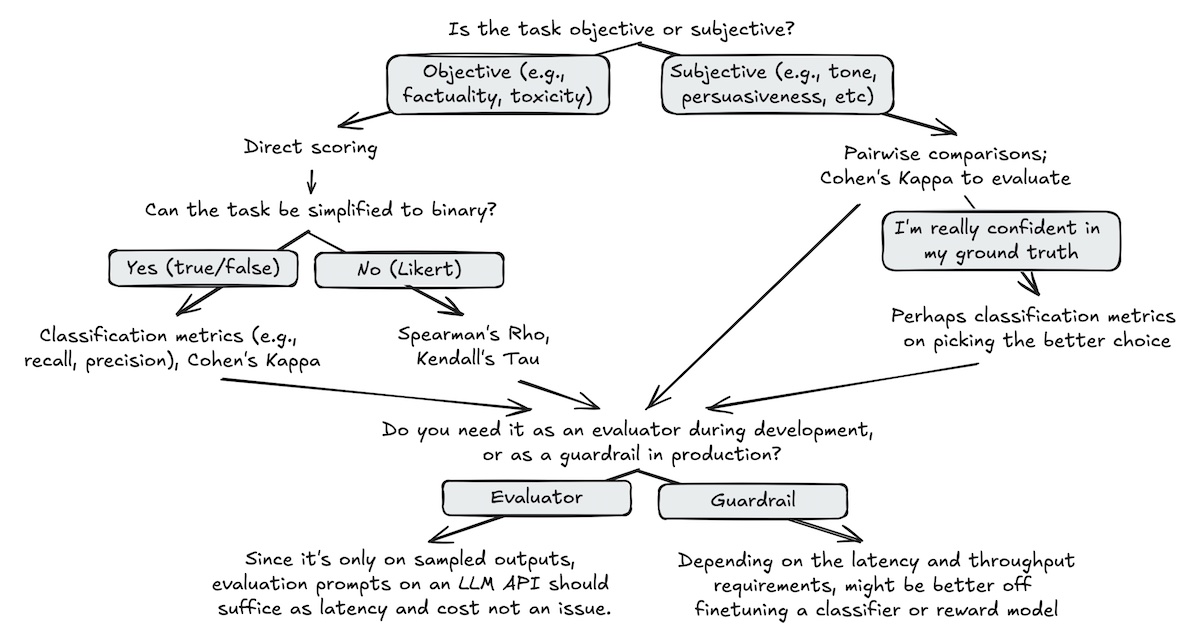
В целом сравнение гораздо проще, если модель предсказывает двоичные классы или делает попарное сравнение: тогда можно посчитать точность (для попарного сравнения) или precision и recall (для двоичных классов) — всё это очень понятные метрики.
Сравнивать корреляцию оценок с оценками людей или другой модели труднее. Чтобы понять почему, советую прочитать отличный раздел блога на эту тему.
Если вы не понимаете, какие метрики брать в каком случае, посмотрите и интересную схему из того же блога ⭐.
3. Оцените оценщика
Заголовок раздела «3. Оцените оценщика»Для этого просто прогоните модель с её промптом на тестовых примерах! Получив оценки, посчитайте по выбранной метрике и эталону, насколько они хороши.
Нужно решить, каков порог приемлемости. В зависимости от сложности задачи для попарного сравнения можно целиться в точность от 80 до 95 %. Что касается корреляций (если вы используете оценки по шкале), в литературе обычно довольны корреляцией Пирсона 0,8 с эталоном. Хотя я видела статьи, где 0,3 объявляли хорошей корреляцией с разметчиками-людьми (^^”), так что смотрите сами.
LLM-as-a-judge: а как же модели награды?
Заголовок раздела «LLM-as-a-judge: а как же модели награды?»Что такое модель награды?
Заголовок раздела «Что такое модель награды?»Модели награды (reward models) учатся предсказывать оценку по разметкам людей для пар «промпт — ответ». Цель — чтобы их предсказания совпадали с предпочтениями людей. После обучения их можно использовать для улучшения других моделей в роли функции награды — заместителя человеческого суждения.
Попарная оценка
Заголовок раздела «Попарная оценка»Самый распространённый тип модели награды — модель Брэдли — Терри, которая выдаёт одно число, и:
Такая модель обучается только на попарных сравнениях ответов, которые собирать проще, чем абсолютные оценки, но она может сравнивать лишь ответы на один и тот же промпт, а не ответы на разные промпты.
Другие модели развили этот подход и предсказывают более тонкую вероятность того, что один ответ лучше другого (пример).
Это позволяет им (теоретически) различать тонкие различия между ответами, но ценой того, что для одного тестового набора нельзя просто сохранить и сравнивать много оценок по разным промптам. Кроме того, при сравнении слишком длинных ответов проблемой становятся длина контекста и память.
Абсолютная оценка
Заголовок раздела «Абсолютная оценка»Некоторые модели награды, например SteerLM, выдают абсолютные оценки, которыми можно оценивать ответы напрямую, без попарных сравнений. Для оценки такие модели удобнее, но данные для них собирать труднее: абсолютные оценки в человеческих предпочтениях обычно менее стабильны, чем попарные.
Недавно предложены модели, выдающие и абсолютные, и относительные оценки, например HelpSteer2-Preference и ArmoRM.
Как использовать модель награды для оценки?
Заголовок раздела «Как использовать модель награды для оценки?»Имея набор промптов, можно сгенерировать ответы языковой моделью и попросить модель награды их оценить.
Для моделей с абсолютными оценками результаты можно усреднить — получится разумная сводная оценка.
Но в более частом случае относительных оценок средняя награда может искажаться выбросами (несколькими очень хорошими или очень плохими ответами), потому что у разных промптов может быть разный масштаб награды (одни промпты гораздо сложнее или проще других).
Вместо этого можно использовать:
- долю побед (win rate): берём эталонный набор ответов и считаем процент ответов модели, ранжированных выше эталонных. Это чуть более подробная картина;
- вероятность победы (win probability): средняя вероятность того, что ответы лучше эталонных, — это даёт более тонкий и плавно меняющийся сигнал.
Плюсы и минусы моделей награды
Заголовок раздела «Плюсы и минусы моделей награды»Модели награды обычно:
- Очень быстрые: получить оценку — это один прямой проход сравнительно небольшой модели (ведь мы получаем только число, а не длинный текст, в отличие от LLM-судей).
- Детерминированные: тот же прямой проход даёт те же оценки.
- Мало подвержены перекосу по позиции: большинство моделей принимает один ответ, так что порядок на них не влияет. У попарных моделей перекос по позиции тоже обычно мал, если обучающие данные были сбалансированы — лучшим был то первый, то второй ответ.
- Не требуют промпт-инжиниринга: модель просто выдаёт оценку для одного или двух ответов в соответствии с данными предпочтений, на которых её обучили.
С другой стороны, они:
- Требуют специального дообучения: это может быть довольно дорого, и хотя они наследуют многие способности базовой модели, на задачах вне обучающего распределения могут работать плохо.
- Теряют эффективность, если их использовать и для обучения с подкреплением, и для оценки (или если применять алгоритмы прямого выравнивания на данных, похожих на обучающие данные модели награды): языковая модель может переобучиться на предпочтения модели награды.
Советы по использованию моделей награды для оценки
Заголовок раздела «Советы по использованию моделей награды для оценки»- Хорошие модели можно найти на лидерборде RewardBench.
- Посмотрите, как модели награды использовались в статье Nemotron.
- Для моделей награды, оценивающих одиночные пары «промпт — ответ», можно закэшировать оценки многих эталонных моделей и легко смотреть, как выступает новая модель.
- Отслеживание доли или вероятности побед по ходу обучения, как в этой недавней статье, помогает заметить деградацию модели и выбрать лучшие чекпоинты.
LLM-as-a-judge: советы и приёмы
Заголовок раздела «LLM-as-a-judge: советы и приёмы»Как смягчить известные перекосы LLM-судей
Заголовок раздела «Как смягчить известные перекосы LLM-судей»flowchart LR B1["Непоследовательность"] --> M1["Несколько запросов, ответ большинства"] B2["Предпочтение своих ответов"] --> M2["Жюри из разных моделей"] B3["Слепота к искажениям входа"] --> M3["Рассуждение до оценки, понятная шкала"] B4["Перекос по позиции"] --> M4["Менять порядок ответов, нормированные вероятности"] B5["Любовь к длинным ответам"] --> M5["Поправка на разницу длины"] B6["Перекос формата"] --> M6["Следовать формату обучения судьи"]
- Внутренняя непоследовательность: судья может давать разные оценки, если спросить его несколько раз (при
температуре больше 0).
- Смягчение: самосогласованность — спрашивать судью несколько раз и брать ответ большинства.
- Предпочтение себя: судьи склонны выше оценивать собственные ответы.
- Смягчение: жюри.
- Слепота к искажениям входа: модели плохо замечают искажённый вход и, как
следствие, плохо выдерживают последовательную шкалу оценок
(расширенные эксперименты — здесь). Например, если
попросить оценить качество текста, к которому добавлен шум в равномерно растущей степени, предсказанные оценки этот
рост не отражают.
- Смягчение:
- просить модель объяснить рассуждение до выставления оценки;
- давать в промпте последовательную шкалу.
- Смягчение:
- Перекос по позиции: судьи склонны предпочитать ответы на определённых позициях.
Например, при попарном сравнении Claude и GPT-3.5 довольно систематически предпочитают то первый, то второй вариант.
- Смягчение:
- случайно менять ответы местами;
- считать логарифмы вероятностей всех вариантов, чтобы получить нормированный ответ.
- Смягчение:
- Перекос многословия (перекос длины): судьям нравятся более длинные ответы.
- Смягчение: учитывать разницу в длине ответов.
- Спорное согласие с ответами людей:
- впрочем, спорно и то, что люди-неэксперты — хороший эталон абсолютно для всех оценок. В некоторых областях (медицина, право, математика и т. д.) опираться на разметчиков-неэкспертов так же плохо, как прямо на LLM.
- Перекос формата: судьи плохо оценивают, если формат промпта слишком далёк
от того, на котором их обучали. Например, модель, обученная попарному сравнению с эталонным ответом, ошибается, если
эталона нет, — и наоборот.
- Смягчение: обращать внимание на формат промпта при обучении (если модель прошла instruction tuning) и следовать ему.
Какие задачи подходят LLM-судье
Заголовок раздела «Какие задачи подходят LLM-судье»LLM-оценщики:
- плохо находят галлюцинации в целом, особенно так называемые частичные галлюцинации (выглядят близко к истине, но слегка отличаются) — см. это и это;
- имеют низкую или средненькую корреляцию с разметчиками-людьми на пересказе (и здесь) и на верности исходнику, а в целом их согласие с людьми непостоянно на широком круге задач.
Оценка людьми: основы
Заголовок раздела «Оценка людьми: основы»Что такое оценка людьми?
Заголовок раздела «Что такое оценка людьми?»Оценка людьми — это просто когда людей просят оценить модели. Здесь мы рассматриваем оценку постфактум: модель уже обучена, у вас есть задача, и люди выставляют оценки.
Систематическая оценка
Заголовок раздела «Систематическая оценка»Есть три основных систематических способа.
Если набора данных у вас нет, но вы хотите исследовать набор способностей, вы даёте людям задачу и правила
оценки (например: попробуйте заставить обе модели выдать токсичный текст; модель получает 0, если текст был токсичным, и 1, если нет) и доступ к одной (или нескольким) моделям, с которыми можно взаимодействовать, а затем
просите выставить оценки и обосновать их.
Если набор данных уже есть (например, набор промптов, на которые модель не должна отвечать), вы прогоняете на
них модель и даёте людям промпт, вывод и правила оценки (модель получает 0, если ответ содержит личную информацию, и 1 в противном случае).
Наконец, если есть и набор данных, и оценки, можно попросить людей проверить ваш метод оценки через разметку ошибок (её можно использовать и как систему оценки в предыдущей категории). Это очень важный шаг при проверке новой системы оценки, но формально он относится к «оценке оценки», так что здесь мы его не рассматриваем.
Примечания:
- Для оценки уже развёрнутых в продакшне моделей можно собирать отзывы пользователей и проводить A/B-тесты.
- Аудиты ИИ (внешняя систематическая оценка моделей) обычно проводят люди, но здесь мы их не рассматриваем.
Неформальная оценка
Заголовок раздела «Неформальная оценка»Есть ещё два менее формальных подхода к оценке людьми.
Вайб-чеки (vibe checks) — ручные оценки, которые проводят отдельные люди, обычно на нераскрытых промптах, чтобы получить общее впечатление о том, как модели справляются со множеством задач (от программирования до качества откровенных рассказов). Их часто публикуют в Twitter и Reddit; результаты в основном анекдотичны и сильно подвержены предвзятости подтверждения (люди находят то, что ищут). Тем не менее они могут быть хорошей отправной точкой для ваших задач.
Арены — краудсорсинговая оценка людьми для ранжирования моделей. Известный пример — LMSYS Chatbot Arena: пользователи общаются с моделями, пока не решат, какая лучше. Голоса затем сводятся в рейтинг Эло (рейтинг по итогам «матчей»), чтобы определить, какая модель «лучшая».
Плюсы и минусы оценки людьми
Заголовок раздела «Плюсы и минусы оценки людьми»Оценка людьми интересна потому, что даёт:
- Гибкость: если достаточно чётко определить, что вы оцениваете, можно получить оценку почти чего угодно!
- Отсутствие загрязнения: если попросить людей придумать новые вопросы для проверки системы, их не должно быть в обучающих данных (надеемся).
- Согласие с предпочтениями людей: это очевидно — ведь именно ими и оценивают. Примечание: при оценке людьми нужно следить, чтобы разметчики были достаточно разнообразны, иначе результаты не обобщатся.
Но есть и ряд ограничений:
- Перекос первого впечатления: люди склонны оценивать качество ответа по первому впечатлению, а не по фактической точности или верности источнику.
- Перекос тона: краудсорсинговые разметчики особенно чувствительны к тону и недооценивают число фактических и логических ошибок в уверенном ответе. Иначе говоря, если модель уверенным тоном говорит неправду, люди гораздо реже это замечают, и оценки смещаются в пользу более напористых моделей. (Эксперты реже попадаются на такие перекосы.)
- Предпочтение себя: люди скорее предпочтут ответы, которые совпадают с их взглядами, мнениями или даже ошибками, чем фактически правильные.
- Перекос идентичности: у людей с разной идентичностью разные ценности, и они очень по-разному оценивают ответы моделей (например, на токсичность).
Систематическая оценка людьми
Заголовок раздела «Систематическая оценка людьми»Плюсы систематической оценки людьми, особенно с оплачиваемыми разметчиками:
- Качественные данные под вашу задачу, на которых потом можно строить дальше (например, если понадобится обучать модели предпочтений).
- Конфиденциальность данных: если вы опираетесь на оплачиваемых разметчиков, особенно своих, данные в относительной безопасности, а при оценке через закрытые API-модели гарантий, что будет с данными, меньше — вы отправляете их внешнему сервису.
- Объяснимость: оценки можно объяснить через людей, которые их ставили.
Дополнительные проблемы систематической оценки людьми:
- Стоимость: если честно платить разметчикам, это быстро становится дорого. И, скорее всего, понадобятся несколько итераций, чтобы отточить инструкции, — ещё расходы.
- Плохая масштабируемость: если только вы не оцениваете продакшн-систему по отзывам пользователей, оценка людьми плохо масштабируется: каждый новый раунд требует собирать (и оплачивать) новых оценщиков.
- Плохая воспроизводимость: если не держать всё время одних и тех же разметчиков и не сделать инструкции абсолютно однозначными, часть оценок вряд ли получится точно воспроизвести.
Неформальная оценка людьми
Заголовок раздела «Неформальная оценка людьми»Плюсы неформальной оценки:
- Меньшая стоимость: вы опираетесь на добрую волю участников.
- Поиск пограничных случаев: творческая свобода пользователей позволяет находить интересные пограничные случаи.
- Лучшая масштабируемость: пока есть много заинтересованных участников, неформальная оценка масштабируется лучше и требует меньше вложений на входе.
Очевидные проблемы неформальных подходов (без отбора разметчиков):
- Высокая субъективность: трудно добиться единообразных оценок от множества людей по общим правилам, тем более что предпочтения разметчиков зависят от культуры. Можно надеяться, что эффект сгладится масштабом голосования — «мудростью толпы» (см. статью о Гальтоне в Википедии).
- Нерепрезентативный рейтинг предпочтений: поскольку в технических уголках интернета перепредставлены молодые западные мужчины, предпочтения могут сильно отличаться от предпочтений населения в целом — и по темам, и по итоговым рейтингам.
- Легко обмануть: при неотфильтрованных краудсорсинговых разметчиках третьей стороне довольно легко повлиять на оценку, например поднять рейтинг конкретной модели (у многих моделей узнаваемый стиль письма).
Оценка людьми: работа с разметчиками
Заголовок раздела «Оценка людьми: работа с разметчиками»Советую прочитать раздел 3 обзора хороших практик качества разметки данных. Если нужно качество продакшн-уровня и есть средства применить все эти методы — вперёд!
Но вот важные правила, которые стоит соблюдать при любом размере проекта, после того как задача и правила оценки определены.
-
Отбор исполнителей и, если можно, денежная мотивация. Скорее всего, вам нужно, чтобы участники:
- соответствовали определённым характеристикам: например, были носителями целевого языка, имели высшее образование, были экспертами в определённой области, были из разных стран и т. д. — зависит от задачи;
- работали качественно. Сейчас особенно важно предусмотреть проверку, не сгенерированы ли ответы LLM, — части разметчиков придётся отказать.
По-моему, если только вы не рассчитываете на очень мотивированных добровольцев, разметчикам всегда лучше честно платить.
-
Разработка инструкций. Потратьте много времени на продумывание инструкций! Для набора данных GAIA это было одним из самых трудоёмких пунктов.
-
Итеративная разметка. Будьте готовы к нескольким раундам: разметчики неправильно поймут ваши инструкции (они двусмысленнее, чем вам кажется)! Несколько итераций позволят им действительно прийти к тому, что вам нужно.
-
Оценка качества и ручной отбор. Нужно контролировать ответы (в частности, через согласованность разметчиков, если её можно получить) и сделать финальный отбор, оставив только самые качественные и уместные ответы.
Помочь могут и специальные инструменты для создания качественных размеченных наборов, например Argilla (её разбор — в нашем переводе главы 10 LLM Course).
Что почитать дальше
Заголовок раздела «Что почитать дальше»- ⭐ Как за пару минут настроить свою платформу разметки Морица Лаурера. Хорошо, чтобы получить практический опыт с открытыми инструментами (Argilla и Hugging Face) и лучше понять, что делать и чего не делать при масштабной разметке людьми.
- ⭐ Руководство по хорошим практикам разметки — обзор всех статей о разметке людьми до 2023 года, очень полный. Немного плотный, но вполне понятный.
- Ещё одно руководство по хорошим практикам разметки от ScaleAI, специализирующейся на оценке людьми. Более лёгкое дополнение к предыдущему.
- Assumptions and Challenges of Capturing Human Labels — статья о том, откуда берутся разногласия разметчиков и как с ними справляться на практике.
Оценка людьми: советы и приёмы
Заголовок раздела «Оценка людьми: советы и приёмы»Несколько практических советов для тех, кто привлекает разметчиков к созданию оценочного набора. Если вы ещё не прочитали раздел «Работа с разметчиками», лучше сначала прочитать его.
Проектирование задачи
Заголовок раздела «Проектирование задачи»- Чем проще, тем лучше. Задачи разметки легко становятся излишне сложными, поэтому делайте их как можно проще. Минимальная когнитивная нагрузка помогает разметчикам сохранять внимание и размечать качественнее.
- Проверьте, что показываете. Показывайте только информацию, нужную для задачи, и убедитесь, что там нет ничего, что может внести дополнительный перекос.
- Цените время разметчиков. То, где и как всё показано, может добавлять работы или когнитивной нагрузки и тем ухудшать результат. Например, сделайте так, чтобы тексты и задание были видны вместе, и избегайте лишней прокрутки. Если вы объединяете задачи и результат одной влияет на другую, показывайте их последовательно. Подумайте, как всё выглядит в инструменте разметки, и нельзя ли упростить ещё.
- Протестируйте схему. Когда задача и инструкции готовы, сначала сами разметьте несколько примеров, прежде чем подключать всю команду, и доработайте что нужно.
Во время разметки
Заголовок раздела «Во время разметки»- Разметчики работают независимо. Лучше, чтобы разметчики не помогали друг другу и не видели чужую работу: они могут распространять свои перекосы и вызывать «дрейф» разметки. Согласованность должна достигаться через подробные инструкции. Новых участников можно сначала обучить на отдельном наборе и/или следить за метриками согласованности, чтобы команда «смотрела в одну сторону».
- Последовательность — главное. Если вы существенно меняете инструкции (поменяли определение или указание,
добавили или убрали метки), подумайте, не нужно ли пройтись по уже размеченным данным. Как минимум отслеживайте
изменения в наборе через метаданные, например
guidelines-v1.
Гибридная разметка: человек и модель
Заголовок раздела «Гибридная разметка: человек и модель»Иногда у команды мало времени и ресурсов, но жертвовать преимуществами оценки людьми не хочется. Тогда можно призвать модели, чтобы ускорить работу.
- Разметка с помощью модели. Предсказания или генерации модели можно использовать как предварительную разметку, чтобы команда не начинала с нуля. Учтите, что так в разметку людей могут попасть перекосы модели, а если модель неточна, работы у разметчиков может даже прибавиться.
- Надзор за моделью-судьёй. Можно сочетать подход «модель как судья» с людьми-контролёрами, которые подтверждают или отбрасывают результаты. Учтите, что здесь действуют перекосы, описанные в разделе «Плюсы и минусы оценки людьми».
- Поиск пограничных случаев. Чтобы работа шла ещё быстрее, используйте жюри моделей, а люди подключаются только там, где модели не согласны или нужно разрешить ничью. Опять же помните о перекосах людей.
Сквозной туториал
Заголовок раздела «Сквозной туториал»Чтобы построить собственную оценку по этим советам, пройдите практический туториал от Argilla. Он показывает, как сделать оценочную задачу для своей предметной области с помощью синтетических данных и ручной оценки в Argilla и distilabel. Туториал начинается с документов предметной области и заканчивается собственной оценочной задачей, на которой можно оценивать модель в lighteval.
Словарик
Заголовок раздела «Словарик»| EN | RU |
|---|---|
| judge model, LLM-as-a-judge | модель-судья, LLM-судья |
| pairwise comparison, scoring | попарное сравнение, оценка по шкале |
| jury | жюри (несколько судей) |
| bias: position, verbosity, self-preference, format | перекос: по позиции, многословия, в пользу себя, формата |
| reward model, Bradley–Terry | модель награды, модель Брэдли — Терри |
| win rate / win probability | доля побед / вероятность победы |
| inter-annotator agreement | согласованность разметчиков |
| guidelines | инструкции для разметчиков |
| vibe check, arena, Elo | вайб-чек, арена, рейтинг Эло |
| error annotation | разметка ошибок |