AI Research Foundations, курс 2, часть 2: свой BPE, эмбеддинги и SLM на подсловах
Перевод лабораторных 2.4–2.6 курса Google DeepMind «Represent Your Language Data»: алгоритм BPE своими руками, эмбеддинги Gemma и косинусная близость, обучение маленькой модели с собственным BPE-токенизатором.
Вторая половина курса 2 «Represent Your Language Data». В первой части вы чистили текст, резали его на символы и слова и посмотрели на подсловный токенизатор Gemma. Теперь вы сами напишете алгоритм кодирования пар байтов (BPE, byte pair encoding), разберётесь, как модель хранит смысл токенов в векторах-эмбеддингах, и обучите маленькую языковую модель уже на своём BPE-токенизаторе.
Как проходить вместе с курсом ChinaAI
Заголовок раздела «Как проходить вместе с курсом ChinaAI»| Лабораторная | Время | Когда делать | Что нужно |
|---|---|---|---|
| 2.4. Реализуйте BPE-токенизатор | 25 мин | Вместе с уроком «Byte Pair Encoding с нуля» | Только Python, pandas |
| 2.5. Эксперименты с эмбеддингами | 25 мин | Вместе с уроком «Слова как векторы»; NumPy — как в уроке «Векторы, скалярное произведение, нормы» | NumPy, CPU |
| 2.6. Обучите SLM со своим BPE-токенизатором | 25 мин + обучение | После урока «Цикл обучения LLM» | Keras на JAX, желательно GPU |
В уроке 4.2.2 курса ChinaAI вы уже писали BPE на русском тексте, и здесь тот же алгоритм на английском. Разница в деталях:
в лабораторной конец слова отмечается специальным символом </w>, а в уроке ChinaAI алгоритм работает на байтах
(как в GPT-2). Сравните оба подхода — это хороший способ проверить, что вы понимаете суть, а не конкретную реализацию.
Лабораторная 2.4. Реализуйте BPE-токенизатор
Заголовок раздела «Лабораторная 2.4. Реализуйте BPE-токенизатор»Ноутбук: gdm_lab_2_4_implement_a_bpe_tokenizer.ipynb · открыть в Colab
Реализуйте подсловный токенизатор на алгоритме кодирования пар байтов (BPE). 25 минут.
В этой лабораторной вы реализуете алгоритм кодирования пар байтов (BPE), о котором шла речь в предыдущем материале. Так у вас появится токенизатор посложнее, чем токенизатор по пробелам, которым вы пользовались в прошлых лабораторных. А с ним, в свою очередь, получится обучить на наборе Africa Galore модель получше.
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»К концу лабораторной вы будете понимать:
- что подаётся на вход алгоритму BPE и что получается на выходе;
- из каких повторяющихся шагов складывается обучение токенизатора;
- как реализовать и запустить полный алгоритм BPE на много шагов слияния.
В этой лабораторной вы:
- напишете код, который превращает каждое слово в список символов с добавленным в конец
</w>; - допишете функцию
get_pair_frequencies, которая считает пары соседних символов; - допишете логику в
merge_pair_in_word, которая заменяет самую частую пару; - будете применять слияния (merges) раз за разом, обновляя корпус и словарь;
- реализуете цикл в
learn_bpe, который выполняет заданное число слияний, и изучите результат.
Импорты
Заголовок раздела «Импорты»from collections import Counter, defaultdict # Чтобы считать пары токенов.import pandas as pd # Чтобы загрузить набор данных.Кодирование пар байтов (BPE)
Заголовок раздела «Кодирование пар байтов (BPE)»Напомним из предыдущей статьи, что алгоритм BPE состоит из таких шагов:
- Инициализация. Весь набор данных (текстовый корпус) разбивается на отдельные символы, а словарь
инициализируется множеством уникальных символов. Пробелы заменяются специальным символом конца слова
(например,
</w>). - Подсчёт. Для каждой пары соседних токенов считается, сколько раз она встречается в корпусе.
- Слияние. Выбирается пара соседних токенов
(p, q), которая встречается в корпусе чаще всех, и в словарь добавляется новый слитый токенpq. - Замена. Все пары соседних токенов
(p, q)в корпусе заменяются новым токеномpq. - Повторение. Шаги 2–4 повторяются, пока не будет достигнут нужный размер словаря.
Задание 1. Инициализация
Заголовок раздела «Задание 1. Инициализация»Вы выполните один шаг алгоритма BPE на наборе Africa Galore, а затем запустите алгоритм на много итераций на корпусе поменьше. Запустите следующую ячейку, чтобы загрузить набор данных.
africa_galore = pd.read_json( "https://storage.googleapis.com/dm-educational/assets/ai_foundations/africa_galore.json")dataset = africa_galore["description"].valuesprint(f"Dataset contains {dataset.shape[0]:,} paragraphs.")Ожидаемый вывод: Dataset contains 232 paragraphs.
Шаг инициализации состоит из трёх частей:
- каждое слово (части текста между пробелами) превращается в список символов;
- в конец списка символов каждого слова добавляется специальный символ конца слова
"</w>"; - множество уникальных символов добавляется в словарь.
EOW_SYMBOL = "</w>"
def bpe_initialize(dataset: list[str]) -> tuple[list[list[str]], set[str]]:    """Шаг инициализации алгоритма кодирования пар байтов.
    Аргументы:      dataset: корпус — список сырых абзацев.
    Возвращает:      corpus: список, где каждое слово корпуса представлено списком символов        и специальным символом конца слова "</w>".      vocabulary: множество уникальных токенов набора данных — словарь        до первого слияния.    """
    corpus = []    vocabulary = {EOW_SYMBOL}    for paragraph in dataset:        for word in paragraph.split(" "):            # Превращаем слово в символы и добавляем символ конца слова ('</w>').            chars =  # Добавьте свой код здесь.            corpus.append(chars)
            # Добавляем символы в словарь. Словарь — это множество (set),            # поэтому уже добавленные символы он просто проигнорирует.            vocabulary.update(chars)
    return corpus, vocabulary
corpus, vocabulary = bpe_initialize(dataset)
# Печатаем первые 10 «слов» корпуса.print("First 10 words: ")for word in corpus[:10]:    print(f"  {word}")
print("\n\nVocabulary:")print(f"  {vocabulary}")
Ожидаемый вывод (начало): ['T', 'h', 'e', '</w>'], ['L', 'a', 'g', 'o', 's', '</w>'], ['a', 'i', 'r', '</w>'], …
Всего в корпусе 19 066 «слов», в начальном словаре — 78 символов (включая </w>).
Задание 2. Считаем пары соседних токенов
Заголовок раздела «Задание 2. Считаем пары соседних токенов»Второй шаг алгоритма BPE — подсчёт пар соседних токенов. Для каждого слова корпуса нужно выписать все пары токенов,
стоящих рядом, и увеличить их счётчики. Например, встретив слово, представленное как ["r", "i", "c", "e", "</w>"],
нужно увеличить на 1 счётчики четырёх пар: (r, i), (i, c), (c, e), (e, </w>).
def get_pair_frequencies(    corpus: list[list[str]]) -> Counter[tuple[str, str], int]:    """    Считает частоты пар соседних символов в корпусе.
    Аргументы:      corpus: список токенизированных слов; каждое слово — список подсловных        токенов. До первого слияния это отдельные символы.
    Возвращает:      Counter, который сопоставляет каждой паре соседних символов (кортежу)        её частоту в корпусе.    """    pairs = Counter()    for word in corpus:        # Проходим по позициям всех токенов, кроме последнего.        for i in range(len(word) - 1):            # Создаём кортеж — пару из i-го и (i+1)-го токена слова `word`.            pair =  # Добавьте свой код здесь.            pairs[pair] += 1    return pairs

pair_freqs = get_pair_frequencies(corpus)print("The 10 most common pair frequencies are:")for freq in pair_freqs.most_common(10):    print(f" {freq}")
В выводе — самые частые пары соседних символов и их число в корпусе. Пары с </w> показывают символы, которыми часто
заканчиваются слова. Например, ("e", "</w>") — самая частая пара: многие слова корпуса оканчиваются на букву «e».
Другие частые пары, вроде ("i", "n"), ("a", "n") и ("t", "h"), — распространённые сочетания букв внутри слов.
Эти сведения нужны на следующем шаге алгоритма BPE: самые частые пары сливаются в новые подсловные токены.
Ожидаемый вывод (первые пять строк): (('e', '</w>'), 2639), (('d', '</w>'), 2146), (('s', '</w>'), 2078),
(('a', 'n'), 1883), (('t', 'h'), 1869).
Задание 3. Сливаем самую частую пару
Заголовок раздела «Задание 3. Сливаем самую частую пару»Третий шаг алгоритма BPE — найти самую частую пару соседних токенов и слить её в новый подсловный токен. Запустите следующую ячейку, чтобы найти самую частую пару и добавить её в словарь.
most_freq_pair, freq = pair_freqs.most_common(1)[0]print(    f"The most frequent pair is {most_freq_pair} with a frequency of {freq:,}.")
new_token = most_freq_pair[0] + most_freq_pair[1]vocabulary.add(new_token)def merge_pair_in_word( word: list[str], pair_to_merge: tuple[str, str]) -> list[str]: """Сливает стоящие рядом вхождения заданной пары символов в слове.
Получает слово (список подсловных токенов) и пару токенов для слияния (кортеж) и возвращает новый список, в котором каждое вхождение пары, стоящей рядом в исходном слове, заменено одной строкой — слитой парой.
Аргументы: word: список подсловных токенов одного слова (между пробелами). pair_to_merge: пара из двух подсловных токенов, которые нужно слить в один.
Возвращает: Новый список подсловных токенов слова после слияния. """ merged_symbol = pair_to_merge[0] + pair_to_merge[1] i = 0 new_word = [] while i < len(word): # Если эта позиция и следующая совпадают с парой — сливаем их. if i < len(word) - 1 and # Добавьте свой код здесь. new_word.append(merged_symbol) i += 2 else: new_word.append(word[i]) i += 1 return new_word
print(f"Before merging: {' '.join(corpus[0])}")new_word = merge_pair_in_word(corpus[0], most_freq_pair)print(f"After merging: {' '.join(new_word)}")Ожидаемый вывод: The most frequent pair is ('e', '</w>') with a frequency of 2,639., затем
Before merging: T h e </w> и After merging: T h e</w>.
Заменяем токены в корпусе
Заголовок раздела «Заменяем токены в корпусе»Когда новый токен добавлен в словарь, можно с помощью функции merge_pair_in_word, которую вы только что написали,
заменить каждое вхождение самой частой пары новым слитым подсловным токеном. Это четвёртый шаг алгоритма BPE.
Запустите следующую ячейку, чтобы выполнить слияния в корпусе.
new_corpus = []for word in corpus:    new_word = merge_pair_in_word(word, most_freq_pair)    new_corpus.append(new_word)
# Каждая итерация BPE даёт новый корпус со слитыми парами.print(    "The first 10 \"words\" in the corpus, with \"e</w>\" being a single token"    " now:")for word in new_corpus[:10]:    print(f"  {word}")
print("\n\nVocabulary:")print(f"  {vocabulary}")
Обратите внимание: оба вхождения слова «the» теперь разбиты на три подсловных токена, потому что последняя «e» слилась с токеном конца слова.
Повторяем
Заголовок раздела «Повторяем»Шаги 2, 3 и 4 теперь можно повторять либо заданное число раз, либо пока не будет достигнут нужный размер словаря. На каждой итерации сливается ровно одна пара токенов, и в словаре становится на один подсловный токен больше.
Функция ниже реализует полный алгоритм BPE, который выполняет заданное число слияний num_merges.
def learn_bpe(    dataset: list[str], num_merges: int) -> tuple[list[tuple[str, str]], list[list[str]]]:    """    Выучивает операции слияния BPE по набору данных.
    Функция реализует базовый алгоритм BPE: раз за разом сливает самые частые    пары соседних символов корпуса и так создаёт подсловные единицы.    Слияния продолжаются, пока не достигнуто заданное число слияний или пока    каждое слово не станет одним токеном.
    Аргументы:      dataset: список абзацев; каждый абзац — строка.      num_merges: сколько операций слияния BPE выполнить.
    Возвращает:      merges: список кортежей; каждый кортеж — слитая пара токенов        (например, [('a', 'b'), ('ab', 'c')]). Порядок кортежей — порядок,        в котором выполнялись слияния.      vocabulary: итоговый словарь всех подсловных токенов.      corpus: итоговый корпус после применения BPE; каждое слово —        список подсловных токенов.    """    # Шаг 1: корпус — список списков символов + </w>.    corpus, vocabulary = bpe_initialize(dataset)
    merges = []    for _ in range(num_merges):        # Шаг 2: считаем частоты всех пар соседних токенов.        pair_freqs = get_pair_frequencies(corpus)        if not pair_freqs:            break
        # Шаг 3: выбираем самую частую пару.        most_freq_pair, freq = pair_freqs.most_common(1)[0]        if freq < 1:            break  # Сливать больше нечего.        merges.append(most_freq_pair)        new_token = most_freq_pair[0] + most_freq_pair[1]        vocabulary.add(new_token)
        # Шаг 4: сливаем эту пару в каждом слове корпуса.        new_corpus = []        for word in corpus:            new_word = merge_pair_in_word(word, most_freq_pair)            new_corpus.append(new_word)        corpus = new_corpus
    # Возвращаем список слияний, словарь и итоговый токенизированный корпус.    return merges, vocabulary, corpus
Запускаем BPE на маленьком корпусе
Заголовок раздела «Запускаем BPE на маленьком корпусе»Запустите следующую ячейку, чтобы применить ваш алгоритм BPE к небольшому набору слов.
sample_text = [        "desert",        "deserted",        "deserts",        "desert",        "tested",        "test",        "deserted",        "desert",        "desertion",        "desertion",        "function",]# Обучаем BPE-токенизатор: 10 операций слияния.merges, vocabulary, tokenized_corpus = learn_bpe(sample_text, num_merges=10)
print("Learned merges (in order):")for i, pair in enumerate(merges, start=1):    print(f" {i}. Merge {pair[0]!r} + {pair[1]!r}  →  {pair[0]+pair[1]!r}")
print("\nFinal tokenized corpus:")for orig, tokenized in zip(sample_text, tokenized_corpus):    print(f"  {orig:8s} → {' '.join(tokenized)}")
Ожидаемый вывод (проверено нами):
Learned merges (in order): 1. Merge 'e' + 's'  →  'es' 2. Merge 'd' + 'es'  →  'des' 3. Merge 'des' + 'e'  →  'dese' 4. Merge 'dese' + 'r'  →  'deser' 5. Merge 'deser' + 't'  →  'desert' 6. Merge 'desert' + '</w>'  →  'desert</w>' 7. Merge 'e' + 'd'  →  'ed' 8. Merge 'ed' + '</w>'  →  'ed</w>' 9. Merge 'i' + 'o'  →  'io' 10. Merge 'io' + 'n'  →  'ion'
Final tokenized corpus:  desert   → desert</w>  deserted → desert ed</w>  deserts  → desert s </w>  desert   → desert</w>  tested   → t es t ed</w>  test     → t es t </w>  deserted → desert ed</w>  desert   → desert</w>  desertion → desert ion </w>  desertion → desert ion </w>  function → f u n c t ion </w>
Посмотрите, что получилось: частое слово «desert» стало одним токеном, а окончания ed</w> и ion — отдельными
подсловами. Слово «function», которое встретилось один раз, почти целиком осталось буквами, но окончание ion оно
разделяет с «desertion».
Вы успешно обучили собственный BPE-токенизатор на маленьком корпусе. В следующих лабораторных вы встроите этот алгоритм в класс, который умеет токенизировать любой текст.
В этой лабораторной вы реализовали алгоритм кодирования пар байтов (BPE) — краеугольный камень современной токенизации текста. Вы увидели, как BPE раз за разом сливает частые пары символов в подсловные токены. Этот процесс очень важен, потому что человеческий язык огромен и постоянно меняется. Особенно он важен, когда словари большие и нужно представлять токены вне словаря. Понимать BPE и другие методы подсловной токенизации необходимо всем, кто работает с языковыми моделями: от этого напрямую зависят качество модели, её эффективность и способность работать с разнообразными текстами.
В следующем модуле курса вы узнаете, как языковые модели кодируют смысл в многомерном векторном пространстве.
Решения
Заголовок раздела «Решения»Задание 1
# Полная реализация функции bpe_initialize.def bpe_initialize(dataset: list[str]) -> tuple[list[list[str]], set[str]]:    corpus = []    vocabulary = {EOW_SYMBOL}    for paragraph in dataset:        for word in paragraph.split(" "):            # Превращаем слово в символы и добавляем символ конца слова ('</w>').            chars = list(word) + [EOW_SYMBOL]            corpus.append(chars)            # Добавляем все символы в словарь (повторы множество проигнорирует).            vocabulary.update(chars)
    return corpus, vocabulary
Задание 2
# Полная реализация функции get_pair_frequencies.def get_pair_frequencies( corpus: list[list[str]]) -> Counter[tuple[str, str], int]: pairs = Counter() for word in corpus: # Проходим по позициям всех токенов, кроме последнего. for i in range(len(word) - 1): # Пара из i-го и (i+1)-го токена слова `word`. pair = (word[i], word[i+1]) pairs[pair] += 1 return pairsЗадание 3
# Полная реализация функции merge_pair_in_word.def merge_pair_in_word(word: list[str], pair_to_merge: tuple[str, str]) -> list[str]: merged_symbol = pair_to_merge[0] + pair_to_merge[1] i = 0 new_word = [] while i < len(word): # Если эта позиция и следующая совпадают с парой — сливаем их. if i < len(word) - 1 and (word[i], word[i + 1]) == pair_to_merge: new_word.append(merged_symbol) i += 2 else: new_word.append(word[i]) i += 1 return new_wordЛабораторная 2.5. Эксперименты с эмбеддингами
Заголовок раздела «Лабораторная 2.5. Эксперименты с эмбеддингами»Ноутбук: gdm_lab_2_5_experiment_with_embeddings.ipynb · открыть в Colab
Исследуйте, как смысл кодируется в многомерных эмбеддингах токенов языковой модели Gemma. 25 минут.
В предыдущих материалах вы узнали, что эмбеддинги токенов (token embeddings) — это многомерные векторы. Вы также разобрали, что хорошие эмбеддинги размещают токены в этом многомерном пространстве так, что токены с похожим смыслом оказываются рядом.
В этой лабораторной вы проверите эти идеи на практике. Вы поработаете с эмбеддингами некоторых токенов Gemma и оцените их сходство, вычисляя косинусную близость (cosine similarity) между парами эмбеддингов. Вы также попробуете разные способы изобразить на плоскости 1152-мерные эмбеддинги модели Gemma.
Работа с эмбеддингами (и вообще с нейросетями) — это постоянно векторы и матрицы. Поэтому в лабораторной есть короткое
введение в пакет numpy, в котором есть типы данных и стандартные функции для векторов и матриц.
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»К концу лабораторной вы будете понимать:
- как слой эмбеддингов LLM (например, Gemma) сопоставляет токенам многомерные векторы;
- как работать с векторами и матрицами в Python с помощью пакета
numpy; - геометрию скалярного произведения и почему косинусная близость отражает смысловую близость через угол;
- чем ограничен взгляд на отдельные измерения эмбеддинга и чем помогает снижение размерности.
В этой лабораторной вы:
- загрузите часть матрицы эмбеддингов Gemma;
- реализуете функции, которые достают эмбеддинги из матрицы и считают скалярные произведения;
- реализуете функцию, которая печатает близость для пар токенов;
- изобразите отдельные измерения эмбеддингов;
- поэкспериментируете с методами снижения размерности, например t-SNE.
Импорты
Заголовок раздела «Импорты»В этой лабораторной вы в основном работаете с пакетом numpy (его импортируют как np) для векторов и матриц.
Ещё понадобятся функции из пакета курса ai_foundations, чтобы рисовать эмбеддинги и снижать размерность.
%%capture# Ставим специальный пакет курса.!pip install "git+https://github.com/google-deepmind/ai-foundations.git@main"
import numpy as np  # Для работы с векторами и матрицами.# Чтобы загружать и проецировать эмбеддинги.from ai_foundations import embeddings as emb# Для обратной связи.from ai_foundations.feedback.course_2 import embeddings as emb_feedback
Загружаем эмбеддинги Gemma
Заголовок раздела «Загружаем эмбеддинги Gemma»Сначала загрузите эмбеддинги Gemma для 24 токенов.
В одной из прошлых лабораторных вы видели, что словарь токенизатора Gemma — больше 260 000 токенов. Значит, и в её таблице эмбеддингов больше 260 000 строк. Чтобы сэкономить память и ускорить вычисления, в этой лабораторной вы будете работать только с 24 эмбеддингами.
Запустите следующую ячейку, чтобы загрузить эмбеддинги и напечатать список соответствующих токенов.
# Загружаем эмбеддинги Gemma.embeddings, labels = emb.load_gemma_embeddings("https://storage.googleapis.com/dm-educational/assets/ai_foundations/gemma_embeddings.npz")
print(f"The number of tokens are {len(labels)}.")print(f"The token labels are:\n  {'\n  '.join(labels)}")
Векторы и матрицы в numpy
Заголовок раздела «Векторы и матрицы в numpy»Задание 1. Задаём векторы и матрицы
Заголовок раздела «Задание 1. Задаём векторы и матрицы»a = # Добавьте свой код здесь.b = # Добавьте свой код здесь.c = # Добавьте свой код здесь.
P = # Добавьте свой код здесь.Q = # Добавьте свой код здесь.R = # Добавьте свой код здесь.# Запустите эту ячейку, чтобы проверить код.emb_feedback.test_numpy_arrays(a, b, c, P, Q, R)Задание 2. Форма векторов и матриц
Заголовок раздела «Задание 2. Форма векторов и матриц»Работая с векторами и матрицами, часто нужно знать их форму (shape) — размеры вектора или матрицы. Для вектора это число элементов, для матрицы — число строк и столбцов.
Форму массива numpy возвращает свойство .shape: кортеж с числом строк и (если это матрица) числом столбцов.
Запустите следующую ячейку, чтобы напечатать заданные вами векторы и матрицы вместе с их формами.
print(f"a = {a}")print(f"Shape of a: {a.shape}")print("-" * 20)
print(f"b = {b}")print(f"Shape of b: {b.shape}")print("-" * 20)
print(f"c = {c}")print(f"Shape of c: {c.shape}")print("-" * 20)
print(f"P =\n{P}")print(f"Shape of P: {P.shape}")print("-" * 20)
print(f"Q =\n{Q}")print(f"Shape of Q: {Q.shape}")print("-" * 20)
print(f"R =\n{R}")print(f"Shape of R: {R.shape}")
Обратите внимание на разницу между c и R: у вектора c форма (3,) — одно измерение, а у матрицы R из одной
строки — (1, 3), два измерения. Для numpy это разные объекты.
embedding_dim = # Ваш код здесь.
print(f"Dimension of Gemma embeddings: {embedding_dim:,}")
# Запустите эту ячейку, чтобы проверить код.emb_feedback.test_embedding_dimension(embedding_dim, embeddings)Задание 3. Доступ к строкам и столбцам
Заголовок раздела «Задание 3. Доступ к строкам и столбцам»Одно из удобств массивов numpy — к отдельным строкам и столбцам матрицы легко обратиться. Для этого, как и у списков,
используются квадратные скобки:
M[row_or_rows, column_or_columns] # M[строка или строки, столбец или столбцы]Если нужны все строки или все столбцы, ставьте заполнитель :. Например, такой код берёт все столбцы третьей строки
матрицы M:
M[2, :]А такой — все строки четвёртого столбца M:
M[:, 3]Как обычно в Python, первая строка и первый столбец имеют индекс 0.
third_row = # Добавьте свой код здесь.seventh_column = # Добавьте свой код здесь.
print(f"Shape of third_row: {third_row.shape}")print(f"Shape of seventh_column: {seventh_column.shape}")
# Запустите эту ячейку, чтобы проверить код.emb_feedback.test_numpy_slicing(third_row, seventh_column, embeddings)Задание 4. Скалярное произведение
Заголовок раздела «Задание 4. Скалярное произведение»Скалярное произведение — одна из самых частых операций в машинном обучении. Для -мерных векторов и это произведение (в этом контексте его ещё называют внутренним, inner product) определяется так:
Словами: перемножьте векторы поэлементно и сложите всё, что получилось. Например, для и : .
Иногда его записывают как . Верхний индекс означает, что вектор нужно транспонировать — превратить вектор-столбец в вектор-строку.
В Python скалярное произведение векторов u и v можно вычислить функцией np.dot или более общей функцией
np.matmul, которая умножает матрицы:
dot_product = np.dot(u, v)
dot_product = np.matmul(u.T, v)
Если вы используете matmul, следите, чтобы второе измерение первого аргумента совпадало с первым измерением второго.
Для этого может понадобиться транспонирование — здесь это u.T.
third_row = # Добавьте свой код здесь.fourth_row = # Добавьте свой код здесь.
dot_product = # Добавьте свой код здесь.
print(f"Dot product: {dot_product:.4f}")
# Запустите эту ячейку, чтобы проверить код.emb_feedback.test_dot_product(dot_product, embeddings)Для эмбеддингов скалярное произведение — важная мера сходства. В оригинале здесь рисунок (inner-products.png): три пары стрелок с тупым, прямым и острым углом между ними. Что он показывает:
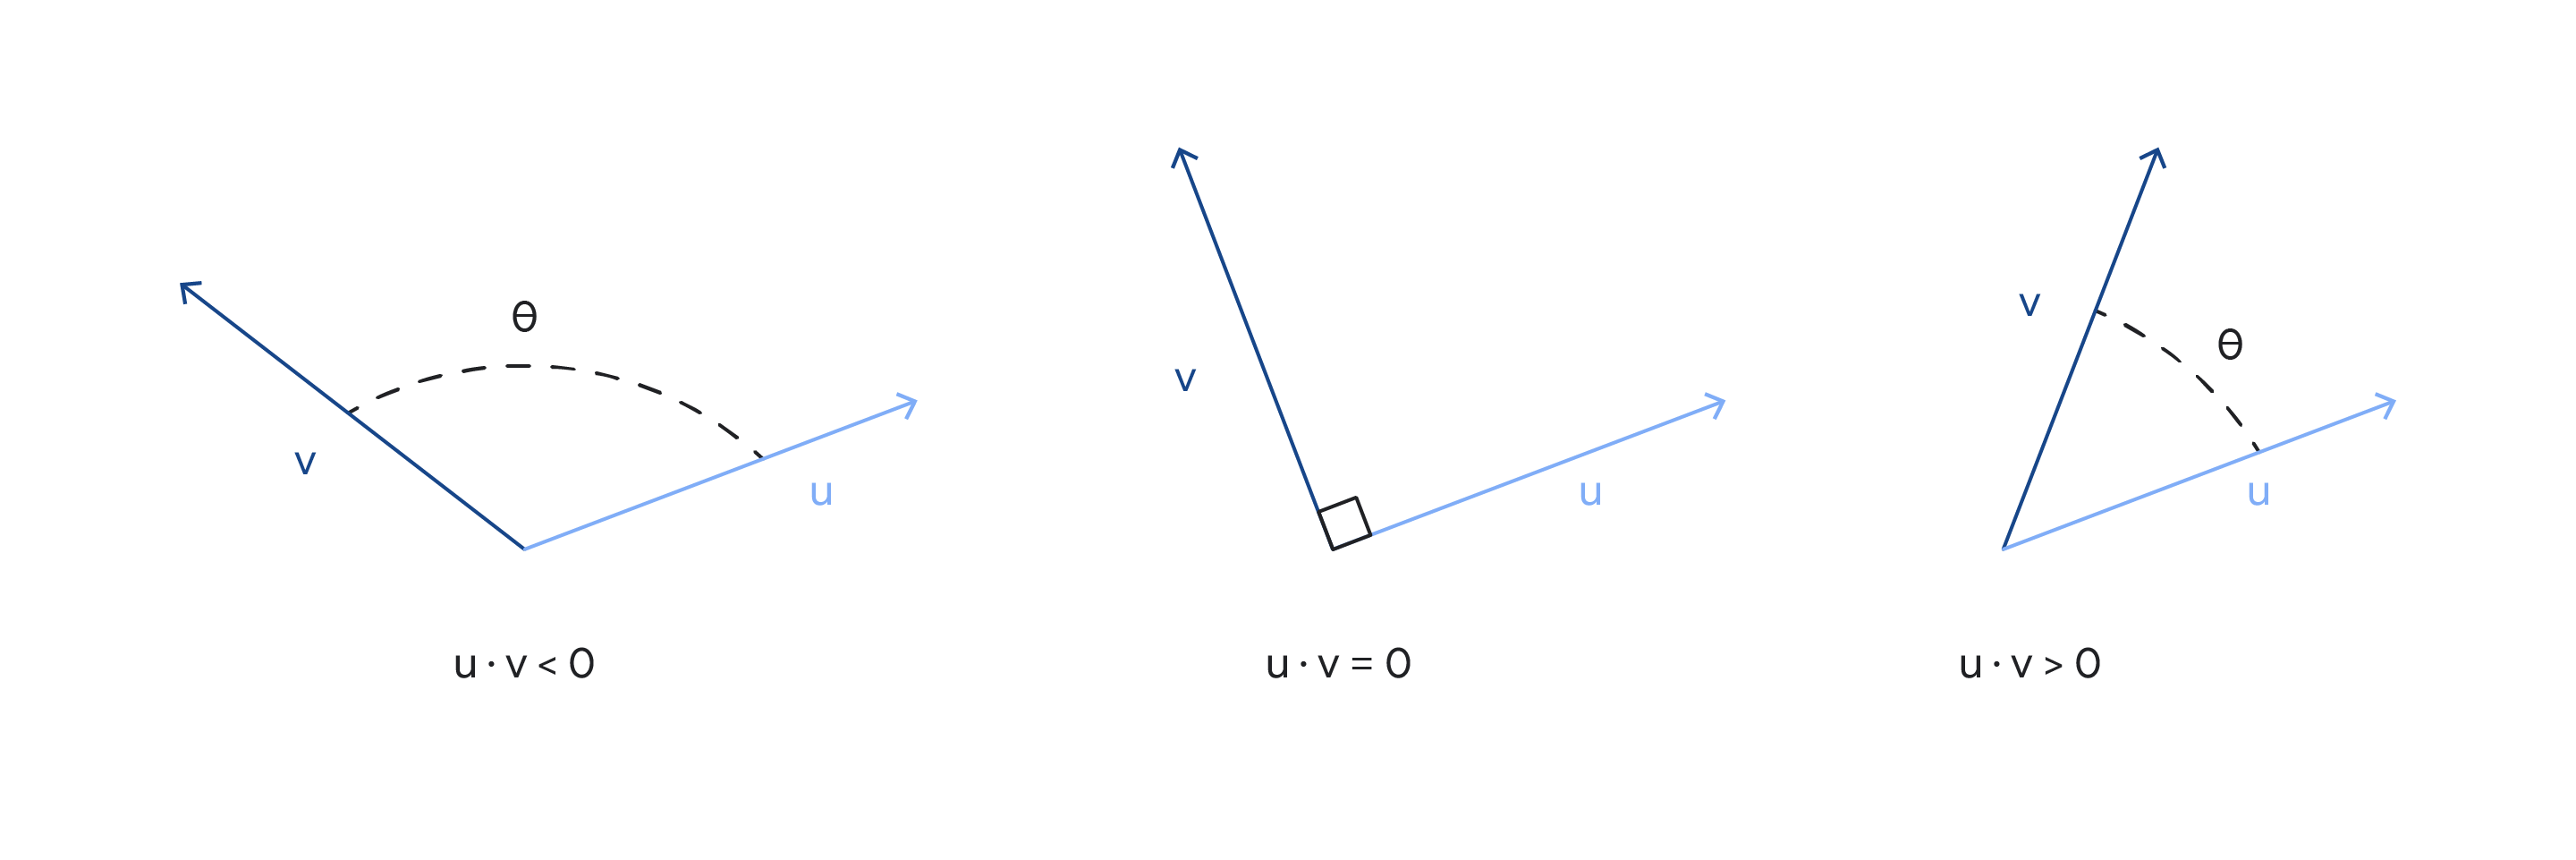
- Если скалярное произведение отрицательно, то есть , угол между векторами больше 90 градусов. Векторы смотрят в противоположные стороны — это признак сильного различия.
- Если скалярное произведение двух эмбеддингов равно нулю, , векторы ортогональны, угол между ними 90 градусов. Грубо говоря, эмбеддинги не связаны друг с другом.
- Если скалярное произведение положительно, , угол меньше 90 градусов. Векторы смотрят в похожем направлении — эмбеддинги похожи.
Когда вы размещали эмбеддинги «apple» и «banana» («яблоко» и «банан») на плоскости, вы, скорее всего, поставили их так, чтобы угол между ними был маленьким, — интуитивно добились .
Косинусная близость
Заголовок раздела «Косинусная близость»Скалярное произведение само по себе уже показывает сходство двух эмбеддингов, но, когда у вектора много измерений, оно может стать очень большим или очень маленьким: вы ведь складываете много чисел. Чтобы сходство меньше зависело от конкретных значений и числа измерений, его полезно нормировать — так, чтобы результат всегда лежал между −1 и +1.
Именно это делает косинусная близость:
где — скалярное произведение векторов, а и — их длины (модули).
Как видно из формулы, косинусная близость измеряет сходство векторов через их скалярное произведение, делённое на длины. Так она отражает косинус угла между векторами, а не их длину. Например, для и : скалярное произведение равно 1, длины — 1 и , косинус — (угол 45°).
Косинусная близость равна +1 для одинаковых направлений, 0 для ортогональных векторов (например, эмбеддингов не связанных друг с другом токенов) и −1 для противоположных векторов (например, эмбеддингов явных антонимов).
Запустите следующую ячейку, чтобы задать функцию, которая вычисляет косинусную близость двух векторов.
def cos_sim(u: np.ndarray, v: np.ndarray) -> float:    """Вычисляет косинусную близость двух одномерных массивов numpy u и v.
    Аргументы:      u: вектор размерности (k,).      v: вектор размерности (k,).
    Возвращает:      Косинусную близость u и v.    """
    dot_uv = np.matmul(u.T,v)
    # np.linalg.norm(u, 2) вычисляет длину вектора u (его L2-норму).    len_u = np.linalg.norm(u, 2)    len_v = np.linalg.norm(v, 2)
    # u . v / (||u|| * ||v||).    cosine_sim = dot_uv / (len_u * len_v)
    # Превращаем массив numpy размера 1x1 в число float.    cosine_sim = cosine_sim.item()
    return cosine_sim
Задание 5. Эмбеддинг заданного токена
Заголовок раздела «Задание 5. Эмбеддинг заданного токена»Чтобы вычислить косинусную близость двух эмбеддингов, сначала нужна функция, которая возвращает эмбеддинг конкретного токена, например «apple».
Для этого нужно узнать индекс токена в матрице эмбеддингов. Список labels, загруженный в начале лабораторной,
содержит все токены, для которых в embeddings есть эмбеддинги. Эмбеддинг первого элемента списка — первая строка
embeddings, эмбеддинг второго элемента — вторая строка и так далее.
Индекс можно узнать методом списка .index. Например, labels.index("apple") возвращает номер строки
с эмбеддингом «apple».
def get_embedding(    token: str, embeddings: np.ndarray = embeddings, labels: list[str] = labels) -> np.ndarray:    """Возвращает эмбеддинг токена `token` из `embeddings`.
    Аргументы:      token: токен, эмбеддинг которого нужно достать.      embeddings: матрица эмбеддингов всех токенов из `labels`.      labels: список токенов в том порядке, в каком их эмбеддинги        идут в `embeddings`.
    Возвращает:      Эмбеддинг (вектор) токена `token`.
    Исключения:      ValueError, если эмбеддинга для `token` нет.    """
    if token not in labels:        raise ValueError(f"No embeddings for {token} exist.")
    token_idx =  # Добавьте свой код здесь.    embedding =  # Добавьте свой код здесь.
    return embedding
# Запустите эту ячейку, чтобы проверить код.emb_feedback.test_get_embedding(get_embedding, embeddings, labels)Задание 6. Вычисляем косинусную близость
Заголовок раздела «Задание 6. Вычисляем косинусную близость»Теперь с помощью cos_sim вы зададите функцию, которая печатает близость эмбеддингов двух токенов.
def print_similarity(    token1: str,    token2: str,    embeddings: np.ndarray = embeddings,    labels: list[str] = labels,) -> float:    """    Вычисляет и печатает косинусную близость эмбеддингов `token1` и `token2`.
    Аргументы:      token1: первый токен.      token2: второй токен.      embeddings: матрица эмбеддингов, в которой есть `token1` и `token2`.      labels: список токенов в том порядке, в каком их эмбеддинги        идут в `embeddings`.
    Возвращает:      Косинусную близость `token1` и `token2`.
    Исключения:      ValueError, если нет эмбеддинга для `token1` или `token2`.    """
    embedding1 = # Добавьте свой код здесь.    embedding2 = # Добавьте свой код здесь.
    similarity = # Добавьте свой код здесь.    print(        f'Cosine similarity between "{token1}" and "{token2}" '        f'\t= {similarity:.2f}'    )    return similarity
# Запустите эту ячейку, чтобы проверить код.emb_feedback.test_print_similarity(print_similarity, get_embedding, cos_sim, embeddings, labels)Теперь этой функцией можно считать близость пар токенов.
print_similarity("king", "king")print_similarity("king", "queen")print_similarity("queen", "king")print_similarity("joy", "happy")print_similarity("good", "bad")print_similarity("sad", "happy")print_similarity("king", "bus")print_similarity("car", "banana")print()Что вы заметили?
Заголовок раздела «Что вы заметили?»В пространстве эмбеддингов хорошо обученной модели вроде Gemma близость тесно связанных токенов должна быть высокой. Так и есть: например, близость «king» и «queen» («король» и «королева») — 0,42. Значит, модель выучила, что эти два токена нужно разместить рядом, у них высокое смысловое сходство. Заметьте также, что косинусная близость симметрична: близость «king» и «queen» в точности равна близости «queen» и «king».
Близость совсем не связанных токенов обычно низкая. Например, близость «king» и «bus» («автобус») — 0,04: в пространстве эмбеддингов модели эти токены не связаны.
Сравнительно высокая близость некоторых антонимов (например, cosine(sad, happy) = 0.22 или cosine(good, bad) = 0.42)
может немного удивить. Но, хотя смыслы в этих парах противоположны, это всё равно пары прилагательных, которые описывают
похожие понятия (чувства или качество).
Как изобразить эмбеддинги
Заголовок раздела «Как изобразить эмбеддинги»Теперь займёмся визуализацией эмбеддингов. Как уже говорилось, модель Gemma 1B использует 1152-мерные эмбеддинги. Изобразить два или даже три измерения легко, а вот 1152-мерное пространство — задача непростая. В этой части лабораторной вы попробуете разные способы изобразить такие многомерные эмбеддинги.
Отдельные измерения
Заголовок раздела «Отдельные измерения»Ячейка ниже рисует отдельные измерения эмбеддингов: вы выбираете два измерения, для каждого токена из его вектора берутся только эти два элемента, и токены наносятся на плоскость. Выбирайте ползунками разные пары измерений и каждый раз запускайте ячейку.
# @title Рисуем отдельные измеренияdimension_1 = 432 #@param {type: 'slider', min:0, max:1151}dimension_2 = 432 #@param {type: 'slider', min:0, max:1151}emb.plot_embeddings_dimensions(embeddings, labels, dim_x=dimension_1, dim_y=dimension_2)Что вы заметили?
Заголовок раздела «Что вы заметили?»Скорее всего, найти пару измерений, в которой появились бы чёткие кластеры, было трудно. Трудно было и придумать, что означают эти измерения. Иногда одно измерение сближает токены с похожей ролью (например, существительные), а иногда — токены со связанным смыслом (например, «banana» и «yellow», «банан» и «жёлтый»).
В следующем задании вы примените более продвинутый метод снижения размерности, который учитывает всю информацию многомерных эмбеддингов.
Эмбеддинги через t-SNE
Заголовок раздела «Эмбеддинги через t-SNE»Как вы, вероятно, заметили, если рисовать любые два измерения эмбеддингов Gemma друг против друга, закономерностей почти не видно. Дело в том, что осмысленные отношения между словами обычно возникают из сочетаний многих измерений. А изобразить можно лишь два или три измерения за раз, так что этот способ не передаёт всей сложности пространства.
Сделать многомерное пространство эмбеддингов понятнее помогают методы снижения размерности (dimensionality reduction). Вместо того чтобы наивно выбирать два-три измерения, они сжимают пространство до меньшего числа измерений, стараясь сохранить как можно больше информации исходного пространства.
Один из таких методов — t-SNE. Он особенно хорошо подходит, чтобы проецировать эмбеддинги для визуализации. t-SNE сохраняет попарные сходства точек данных в пространстве меньшей размерности. Получается «карта с одного взгляда» соседств, скрытых в многомерном пространстве: алгоритм бережно сохраняет локальные расстояния, поэтому близко связанные группы проявляются плотными облачками, которые легко подписать и проверить.
Полученные двумерные точки можно нарисовать и интуитивно увидеть, как слова распределены в многомерном пространстве. Точки, близкие в многомерном пространстве, на картинке t-SNE тоже окажутся рядом.
Запустите следующую ячейку, чтобы построить картинку t-SNE для 24 токенов, с которыми вы работали.
emb.plot_embeddings_tsne(embeddings, labels)Что вы заметили?
Заголовок раздела «Что вы заметили?»На картинке видно, что многие токены с похожим смыслом лежат в векторном пространстве рядом. Например, есть кластер из токенов «mobile», «phone», «computer» и «internet» («мобильный», «телефон», «компьютер», «интернет»). Точно так же рядом «man» и «woman» («мужчина» и «женщина»), «queen» и «king».
При этом некоторые токены, у которых мало общего, вроде «cat» и «car» («кошка» и «машина»), тоже оказались рядом. Скорее всего, это в основном следствие снижения размерности. При проекции на двумерное пространство часть тонкой информации теряется: «cat» и «dog» («собака») спроецированы рядом правильно, но появляются и артефакты — например, близость «cat» и «car».
Вспомните, как вы вручную раскладывали некоторые из этих токенов на двумерной сетке. Получилось похоже? Какие измерения смысла, по-вашему, закодированы на этой картинке?
В этой лабораторной вы исследовали многомерные эмбеддинги токенов модели Gemma, выполняя операции с векторами
и матрицами в библиотеке numpy. Вы реализовали косинусную близость, чтобы математически измерять «близость»
токенов, и убедились, что слова с похожим смыслом (вроде «king» и «queen») лежат в пространстве эмбеддингов рядом.
Затем вы столкнулись с трудностью визуализации этих векторов: рисунки отдельных измерений почти ничего не говорят
об общей структуре. Наконец, с помощью метода снижения размерности t-SNE вы спроецировали эмбеддинги на плоскость
и увидели, как модель организует слова в осмысленные смысловые кластеры, группируя связанные понятия.
Решения
Заголовок раздела «Решения»Задание 1
a = np.array([7, 3, 1, 4])b = np.array([1.5, -2.5])c = np.array([4, 4, 4])
P = np.array([[7, 4], [3, 5], [1, 6], [4, 7]])Q = np.array([[7, 3, 1, 4], [4, 5, 6, 7]])R = np.array([[4, 4, 4]])   # двойные скобки: матрица из одной строки, а не вектор
Задание 2
embedding_dim = embeddings.shape[1] # число столбцовЗадание 3
third_row = embeddings[2, :]seventh_column = embeddings[:, 6]Задание 4
third_row = embeddings[2,:]fourth_row = embeddings[3,:]
dot_product = np.matmul(third_row.T, fourth_row)
Задание 5
def get_embedding(    token: str, embeddings: np.ndarray = embeddings, labels: list[str] = labels) -> np.ndarray:    if token not in labels:        raise ValueError(f"No embeddings for {token} exist.")
    token_idx = labels.index(token)        # номер строки токена    embedding = embeddings[token_idx, :]   # вся строка — это и есть эмбеддинг
    return embedding
Задание 6
def print_similarity(    token1: str,    token2: str,    embeddings: np.ndarray = embeddings,    labels: list[str] = labels,) -> float:    embedding1 = get_embedding(token1, embeddings, labels)    embedding2 = get_embedding(token2, embeddings, labels)
    similarity = cos_sim(embedding1, embedding2)    print(f'Cosine similarity between "{token1}" and "{token2}"  \t= {similarity:.2f}')    return similarity
Лабораторная 2.6. Обучите SLM со своим BPE-токенизатором
Заголовок раздела «Лабораторная 2.6. Обучите SLM со своим BPE-токенизатором»Ноутбук: gdm_lab_2_6_train_an_slm_with_your_bpe_tokenizer.ipynb · открыть в Colab
Обучите свой токенизатор BPE на наборе Africa Galore и обучите с ним языковую модель на основе трансформера. 25 минут.
В этой лабораторной вы примените всё, чему научились в этом курсе и в курсе 1 «Build Your Own Small Language Model». Вы снова обучите маленькую языковую модель (SLM) на наборе Africa Galore. Но в этот раз сначала выучите слияния для подсловного токенизатора BPE, а затем подготовите этим токенизатором данные для обучения модели. Наконец, методом снижения размерности t-SNE из предыдущей лабораторной вы изобразите некоторые эмбеддинги токенов, которые выучила ваша модель.
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»К концу лабораторной вы будете понимать:
- как применить алгоритм BPE, чтобы выучить слияния по текстовому набору данных;
- как получившийся токенизатор делит тексты на подсловные единицы;
- как этим токенизатором подготовить данные для обучения трансформерной языковой модели;
- какие сходства маленькая языковая модель улавливает в своих эмбеддингах токенов.
В этой лабораторной вы:
- загрузите и изучите набор Africa Galore;
- обучите BPE-кодировщик на наборе Africa Galore;
- закодируете и раскодируете примеры слов и предложений (включая выдуманные слова) и посмотрите, как токенизатор справляется со словами вне словаря (out-of-vocabulary, OOV);
- превратите токенизированный корпус в дополненные последовательности чисел (padded numerical index sequences), которые нужны для обучения модели;
- обучите на этом наборе трансформер из предыдущего курса и понаблюдаете за обучением;
- изобразите алгоритмом t-SNE выученные эмбеддинги некоторых токенов.
Писать код в этом ноутбуке не нужно: весь код работает без изменений. Но в некоторых местах полезно менять параметры и смотреть, как это влияет на поведение токенизатора и модели.
Если есть возможность, мы настоятельно советуем запускать лабораторную на экземпляре Colab с GPU.
Импорты
Заголовок раздела «Импорты»В этой лабораторной вы в основном работаете с пакетом ai_foundations. «Под капотом» в нём реализованы методы,
которые задают и обучают SLM на Keras и рисуют выученные эмбеддинги.
%%capture!pip install jax[cuda12]==0.7.2# Ставим специальный пакет курса.!pip install "git+https://github.com/google-deepmind/ai-foundations.git@main"
from collections import Counter  # Чтобы считать токены в BPE-токенизаторе.import os  # Чтобы задать переменные конфигурации Keras.import string  # Чтобы получить строковые константы (алфавит, цифры).
# Следующая строка настраивает Keras: вычисления — на JAX.os.environ["KERAS_BACKEND"] = "jax"
import kerasimport numpy as np  # Для работы с векторами и матрицами.import pandas as pd  # Чтобы загрузить набор Africa Galore.import tqdm  # Чтобы показывать индикаторы прогресса.
from ai_foundations import training  # Чтобы задать и обучить SLM.from ai_foundations import embeddings as emb  # Чтобы рисовать эмбеддинги.
Полная реализация BPE-токенизатора
Заголовок раздела «Полная реализация BPE-токенизатора»Класс BPEWordTokenizer ниже — полная реализация BPE-токенизатора: с методами, которые обучают токенизатор на текстовом
наборе данных (корпусе) и переводят тексты между id токенов и строками.
В основном в класс вошли методы, которые вы сами написали в четвёртой лабораторной этого курса:
__init__— конструктор. Если передан набор данных, строит список слияний и словарь;encode— превращает текст в список id токенов;_split_text— вспомогательный метод дляencode: делит строку на подсловные токены по выученному списку слияний;decode— восстанавливает текст из списка id токенов;join_text— вспомогательный метод дляdecode: собирает текст из токенов BPE;_learn_bpe— выучивает правила слияния по обучающему тексту;_get_pair_frequencies— вспомогательный метод для_learn_bpe: возвращает частоты всех пар соседних токенов;_merge_pairs_in_word— вспомогательный метод для_learn_bpeи_split_text: применяет слияние к одному слову, представленному списком подсловных токенов.
Пройдите по реализации BPEWordTokenizer и разберитесь, что делает каждый метод. Затем запустите ячейку, чтобы задать
класс.
class BPEWordTokenizer:    """    Подсловный токенизатор на основе кодирования пар байтов (BPE).
    Умеет кодировать текст в подсловные токены и раскодировать обратно.    Правила слияния можно выучить по корпусу или передать готовый словарь.
    Атрибуты:        vocabulary: список подсловных токенов, включая специальные.        vocabulary_size: общее число токенов в словаре.        token_to_index: отображение токенов в индексы.        index_to_token: отображение индексов в токены.        pad_token_id: индекс дополняющего токена.        unknown_token_id: индекс неизвестного токена.        tokenized_corpus: сохранённый токенизированный корпус после обучения BPE.    """
    UNKNOWN_TOKEN = "<UNK>"    PAD_TOKEN = "<PAD>"    END_WORD = "</w>"
    def __init__(        self,        texts: list[str] | str,        vocabulary: list[str] | None = None,        num_merges: int = 100,    ):        """Инициализирует BPEWordTokenizer.
        Если словарь не задан, извлекает уникальные токены из корпуса        и выучивает слияния BPE.
        Аргументы:          texts: список строк или одна строка — текстовый корпус.          vocabulary: необязательный список уникальных токенов.          num_merges: сколько раундов слияний выполнить при обучении BPE.        """
        # Приводим вход к списку строк.        if isinstance(texts, str):            texts = [texts]
        if vocabulary is None:            # Выучиваем слияния BPE и строим словарь по токенизированному корпусу.            self.merges, tokenized, vocabulary_set = self._learn_bpe(                texts, num_merges            )            self.tokenized_corpus = tokenized
            # Гарантируем, что базовые латинские буквы и цифры всегда есть            # в словаре.            required_chars = set(                string.ascii_lowercase + string.ascii_uppercase + string.digits            )
            vocabulary_set.update(required_chars)
            # Добавляем в словарь специальные токены: <PAD> первым, <UNK> последним.            self.vocabulary = (                [self.PAD_TOKEN] + sorted(vocabulary_set) + [self.UNKNOWN_TOKEN]            )
        else:            self.vocabulary = vocabulary            self.merges = []  # Если словарь передан, слияния не выучиваем.
        # Строим отображения и запоминаем id специальных токенов.        self.vocabulary_size = len(self.vocabulary)        self.token_to_index = {tok: i for i, tok in enumerate(self.vocabulary)}        self.index_to_token = {i: tok for i, tok in enumerate(self.vocabulary)}        self.pad_token_id = self.token_to_index[self.PAD_TOKEN]        self.unknown_token_id = self.token_to_index[self.UNKNOWN_TOKEN]
    def _split_text(self, text: str) -> list[str]:        """Делит строку на подсловные токены по выученным слияниям BPE.
        Аргументы:          text: строка, которую нужно разделить.
        Возвращает:          Список подсловных токенов, которые вместе дают исходный текст.        """        tokens = []        for word in text.strip().split():            # Делим слово на символы и добавляем специальный токен END_WORD.            chars = list(word) + [self.END_WORD]
            # Сливаем символы по выученным слияниям — строго в порядке обучения.            for pair in self.merges:                chars = self._merge_pairs_in_word(chars, pair)            tokens.extend(chars)        return tokens
    def join_text(self, tokens: list[str]) -> str:        """Склеивает подсловные токены в строку, сохраняя границы слов.
        Аргументы:          tokens: список подсловных токенов.
        Возвращает:          Строку, полученную склейкой токенов.        """        words = []        current_word = []        for token in tokens:            # Проверяем, заканчивается ли токен маркером конца слова.            if token.endswith(self.END_WORD):                current_word.append(token.replace(self.END_WORD, ""))                words.append("".join(current_word))                current_word = []            else:                current_word.append(token)        if current_word:            words.append("".join(current_word))        return " ".join(words).strip()
    def encode(self, text: str) -> list[int]:        """        Кодирует строку в список индексов токенов.
        Аргументы:            text: входной текст.
        Возвращает:            Список целых чисел — id токенов.        """        token_ids = []        for token in self._split_text(text):            # Токена нет в словаре — подставляем id <UNK>.            token_id = self.token_to_index.get(token, self.unknown_token_id)            token_ids.append(token_id)        return token_ids
    def decode(self, token_ids: int | list[int]) -> str:        """        Раскодирует список id токенов обратно в текст.
        Аргументы:          token_ids: один индекс или список id токенов.
        Возвращает:          Раскодированную строку.        """        # Если передан один индекс, превращаем его в список.        if isinstance(token_ids, int):            token_ids = [token_ids]
        tokens = []        for token_id in token_ids:            tokens.append(                self.index_to_token.get(                    token_id,                    self.UNKNOWN_TOKEN + self.END_WORD,                )            )        return self.join_text(tokens)
    def _get_pair_frequencies(self, corpus: list[list[str]]) -> Counter[str]:        """Считает все пары соседних токенов в корпусе.
        Аргументы:          corpus: список списков строк — подсловных токенов.
        Возвращает:          Counter: пара соседних подсловных токенов → её частота.        """        pairs = Counter()        for word in corpus:            for i in range(len(word) - 1):                pair = (word[i], word[i + 1])                # Увеличиваем счётчик на 1.                pairs[pair] += 1        return pairs
    def _merge_pairs_in_word(        self, word: list[str], pair_to_merge: tuple[str, str]    ) -> list[str]:        """Сливает все вхождения пары токенов внутри слова.
        Аргументы:          word: список подсловных токенов одного слова.          pair_to_merge: пара подсловных токенов, которые нужно слить в один.
        Возвращает:          Новый список подсловных токенов слова после слияния.        """
        merged_symbol = pair_to_merge[0] + pair_to_merge[1]        # Быстрая проверка: если какого-то из токенов пары в слове нет, сливать нечего.        if pair_to_merge[0] not in word or pair_to_merge[1] not in word:            return word        i = 0        new_word = []        while i < len(word):            if i < len(word) - 1 and (word[i], word[i + 1]) == pair_to_merge:                new_word.append(merged_symbol)                i += 2            else:                new_word.append(word[i])                i += 1        return new_word
    def _learn_bpe(        self, corpus: list[str], num_merges: int    ) -> tuple[list[tuple[str, str]], list[list[list[str]]], set[str]]:        """        Выучивает слияния BPE по корпусу текстов.
        Аргументы:          corpus: список входных текстов.          num_merges: сколько операций слияния выполнить.
        Возвращает:            merges: список слияний в том порядке, в каком они выучены.            tokenized_corpus: список (абзацев) списков (слов) списков              подсловных токенов.            vocabulary_set: множество подсловных токенов после всех слияний.        """        # Список списков списков для токенизированного корпуса.        tokenized_corpus = []        vocabulary = set([self.END_WORD])        for paragraph in corpus:            sentence_raw_tokens = []            for word in paragraph.strip().split():                # Делим слово на символы и добавляем маркер конца слова.                sentence_raw_tokens.append(list(word) + [self.END_WORD])                vocabulary.update(list(word))            tokenized_corpus.append(sentence_raw_tokens)
        merges = []        for _ in (pbar := tqdm.tqdm(range(num_merges), unit="merges")):            # Собираем одномерный список всех слов корпуса.            flat_corpus = []            for tokenized_paragraph in tokenized_corpus:                flat_corpus.extend(tokenized_paragraph)
            # Ищем самую частую пару соседних токенов.            pair_freqs = self._get_pair_frequencies(flat_corpus)            if not pair_freqs:                break            most_freq_pair, freq = pair_freqs.most_common(1)[0]            if freq < 1:                break            merges.append(most_freq_pair)
            # Применяем слияние к каждому слову каждого абзаца.            new_tokenized_corpus = []            for para_tokens in tokenized_corpus:                new_para_tokens = []                for word_tokens in para_tokens:                    new_para_tokens.append(                        self._merge_pairs_in_word(word_tokens, most_freq_pair)                    )                new_tokenized_corpus.append(new_para_tokens)            tokenized_corpus = new_tokenized_corpus            vocabulary.add(most_freq_pair[0] + most_freq_pair[1])            pbar.set_postfix(vocabulary_size=f"{len(vocabulary):,}")
        return merges, tokenized_corpus, vocabulary
Обучаем BPE-токенизатор
Заголовок раздела «Обучаем BPE-токенизатор»Вы обучите BPE-токенизатор на наборе Africa Galore.
Как вы узнали в этом курсе, обычно первым шагом идёт предобработка набора данных. Но набор Africa Galore сгенерирован специально для курса, дополнительная предобработка ему не нужна, так что этот шаг можно пропустить.
Запустите следующую ячейку, чтобы загрузить набор данных.
africa_galore = pd.read_json( "https://storage.googleapis.com/dm-educational/assets/ai_foundations/africa_galore.json")dataset = africa_galore["description"].valuesprint("Loaded dataset with", dataset.shape[0], "paragraphs.")Теперь классом BPEWordTokenizer выучите слияния по вашему набору данных.
На этом наборе примерно 3000 слияний дают токены для многих частых слов и подслова для частых приставок и суффиксов. Но это лишь рекомендация: можно поэкспериментировать, увеличивая или уменьшая число слияний. Однако прежде чем идти дальше, перезапустите ячейку с 3000 слияний, иначе некоторые задания в конце лабораторной могут не сработать.
Запустите следующую ячейку, чтобы обучить токенизатор. Смотрите, как по мере обучения слияниям растёт размер словаря.
num_merges = 3000
tokenizer = BPEWordTokenizer(dataset, num_merges=num_merges)print(f"\n\nFinal tokenizer vocabulary size: {tokenizer.vocabulary_size:,}\n")
Ожидаемый вывод (проверено нами): после 3000 слияний в словаре 3078 токенов, итоговый размер —
Final tokenizer vocabulary size: 3,081.
Заметьте, что итоговый размер словаря чуть больше, чем после последнего слияния. Дело в том, что конструктор (метод
__init__) добавляет в словарь специальные токены для дополнения и неизвестного токена и следит, чтобы в словаре были
все буквы, цифры и частые символы. То есть после обучения слияний в словарь попадают и несколько токенов, которых
в корпусе нет.
Как ведёт себя ваш токенизатор
Заголовок раздела «Как ведёт себя ваш токенизатор»Чтобы понять, какие токены есть в словаре вашего токенизатора и какие слияния он выучил, посмотрите на токенизацию первых 20 слов набора Africa Galore.
africa_galore_tokenized = tokenizer.tokenized_corpusfor tokens in africa_galore_tokenized[0][:20]: print(" ".join(tokens))Ожидаемый вывод (начало): The</w>, Lago s</w>, air</w>, was</w>, thick</w>, with</w>,
humid ity,</w>, …, cl ub </w>, electr ic.</w>, …, la un ched</w>.
Каждая строка вывода — слово исходного текста Africa Galore, разбитое токенизатором BPEWordTokenizer на подсловные
токены. Посмотрите, как слово «launched» разбито на подслова поменьше и почаще, выученные при обучении: «la», «un»
и ched</w>, где </w> отмечает конец слова. В этом и сила алгоритма BPE: он не хранит слова целиком, а представляет
их последовательностями часто встречающихся кусочков. Так модель может понимать новые или редкие слова, разбивая их
на знакомые части. Проблема слов вне словаря решается, а размер словаря остаётся разумным.
Важное решение при обучении BPE-токенизатора — сколько слияний выполнить. Правильное число зависит от данных, языка и конечной цели. Поэтому оптимальный размер словаря обычно подбирают экспериментами: смотрят, с каким модель работает лучше.
Токенизация неизвестных слов
Заголовок раздела «Токенизация неизвестных слов»Чтобы показать, как BPE-токенизатор обращается с неизвестными словами, токенизируйте фразу «A Zimbabwian dish 😋.» («Зимбабвийское блюдо 😋.»). В ней есть «Zimbabwian» — слово, которого нет в корпусе Africa Galore, и эмодзи «😋».
madeup_tokens = tokenizer.encode("A Zimbabwian dish 😋.")
print(f"Decoded sentence from tokens: {tokenizer.decode(madeup_tokens)}")for token in madeup_tokens:    decoded_token = tokenizer.decode(token)    print(f"Token {token}:\t{decoded_token}")
Как видите, вместо того чтобы отобразить «Zimbabwian» в малоинформативный токен <UNK>, токенизатор делит его на
токены «Zimbab», «wi», «an». Если модель обучалась на слове «Zimbabwe», разбитом на «Zimbab» и «we», она, скорее всего,
сможет связать «Zimbabwian» с «Zimbabwe».
В наборе Africa Galore нет эмодзи, и вы не добавляли в словарь токенизатора символы Unicode вручную, поэтому эмодзи
«😋» отображается в токен <UNK>.
Готовим набор данных для обучения модели
Заголовок раздела «Готовим набор данных для обучения модели»Токенизатор готов, теперь можно подготовить набор данных для обучения SLM. Напомним: данные нужно перевести в id токенов, чтобы они могли служить входом трансформерной языковой модели.
Сначала запустите следующую ячейку: она переведёт обучающий набор вашим BPE-токенизатором в последовательности id токенов.
encoded_tokens = []for paragraph in tqdm.tqdm(dataset, unit="paragraphs"): encoded_tokens.append(tokenizer.encode(paragraph))Затем дополните все последовательности. Напомним: вход трансформера — последовательность определённой длины.
Дополняя короткие последовательности и обрезая длинные, вы добиваетесь, чтобы у всех последовательностей была длина
max_length.
Запустите следующую ячейку, чтобы обрезать и дополнить последовательности функцией Keras
keras.preprocessing.sequence.pad_sequences.
max_length = 300padded_sequences = keras.preprocessing.sequence.pad_sequences( encoded_tokens, maxlen=max_length, padding="post", # дополняем справа truncating="post", # длинные обрезаем справа value=tokenizer.pad_token_id, )Наконец, подготовьте вход и цель для трансформера. Модель обучается предсказывать следующее слово, поэтому цель для каждого токена — следующий токен последовательности.
Запустите следующую ячейку, чтобы создать список входных последовательностей и список целевых, сдвинув вход на один токен.
# Готовим вход и цель для трансформера.# Для каждого примера берём все токены, кроме последнего.input_sequences = padded_sequences[:, :-1]# Для каждого примера берём все токены, кроме первого.target_sequences = padded_sequences[:, 1:]
max_length = input_sequences.shape[1]
Обучаем модель
Заголовок раздела «Обучаем модель»Теперь можно обучать модель. Следующая ячейка создаёт модель и обучает её 100 эпох — тем же способом, что в курсе 1 «Build Your Own Small Language Model». Каждые 10 эпох она печатает генерацию, начинающуюся со слова «Jide»: так видно, как меняются генерации по ходу обучения.
# Фиксируем seed для воспроизводимости.keras.utils.set_random_seed(3112)
model = training.create_model(    max_length=max_length,    vocabulary_size=tokenizer.vocabulary_size,    learning_rate=8e-5)
prompt = "Jide"prompt_ids = tokenizer.encode(prompt)text_gen_callback = training.TextGenerator(    max_tokens=11, start_tokens=prompt_ids, tokenizer=tokenizer, print_every=10)
num_epochs = 100# verbose=2: model.fit печатает по одной строке на эпоху, чтобы было видно,# как падает функция потерь и улучшаются сгенерированные тексты.history = model.fit(    x=input_sequences,    y=target_sequences,    verbose=2,    epochs=num_epochs,    batch_size=2,    callbacks=[text_gen_callback])
Что вы заметили?
Заголовок раздела «Что вы заметили?»После первых эпох модель, скорее всего, генерировала последовательности со «словами», которые были просто случайными наборами букв. Так происходит потому, что теперь модель выбирает не целые слова, а подсловные токены. В начале обучения она ещё не выучила, как правильно соединять подслова, поэтому соединяет их случайно и часто получает строки, которые не являются настоящими словами.
По мере того как при обучении модель находит лучшие параметры, она начинает соединять подслова в настоящие, узнаваемые слова. Это необходимый шаг к конечной цели — генерации связных предложений.
Изображаем эмбеддинги
Заголовок раздела «Изображаем эмбеддинги»Ваша маленькая языковая модель выучивает эмбеддинги токенов так же, как модель Gemma. После обучения их точно так же можно изобразить.
Следующая ячейка достаёт эмбеддинги из вашей модели и выбирает несколько токенов разных категорий: еда и напитки, предлоги, прилагательные и названия стран. Затем t-SNE проецирует эмбеддинги на плоскость, чтобы их можно было нарисовать.
Запустите следующую ячейку, чтобы построить картинку t-SNE и посмотреть, какие кластеры на ней появились.
# Достаём из модели все эмбеддинги в виде матрицы# (первый обучаемый тензор модели — это таблица эмбеддингов токенов).embeddings = model.trainable_weights[0].value
# Задаём категории токенов.food_and_drink = [    "water",    "coffee",    "onions",    "peanut",    "pepper",    "pudding",    "sauce",    "stew",    "carrots,"]prepositions = ["on", "in", "with", "for", "of"]adjectives = ["aromatic", "hot"]countries = ["Egypt", "Congo", "Ghana,", "Tanzania"]
# Составляем список токенов и сопоставляем им категории (для раскраски).tokens = food_and_drink + prepositions + adjectives + countriescategories = (    [0] * len(food_and_drink)    + [1] * len(prepositions)    + [2] * len(adjectives)    + [3] * len(countries))
# Переводим токены в id токенов.token_ids = []for token in tokens:    token_ids.extend(tokenizer.encode(token))
# Проверяем, что каждое слово в токенизаторе — ровно один токен.assert len(token_ids) == len(tokens)
# Достаём эмбеддинги интересующих нас токенов.embeddings_subset = embeddings[token_ids, :]
# Строим картинку t-SNE по эмбеддингам вашей модели.emb.plot_embeddings_tsne(embeddings_subset, tokens, categories)
Обратите внимание на «carrots,» и «Ghana,» с запятой: токенизатор делит текст только по пробелам, поэтому знак
препинания остаётся частью слова, и при 3000 слияниях carrots,</w> и Ghana,</w> стали отдельными токенами. Если
уменьшить num_merges, проверка assert может упасть — об этом и предупреждали выше.
Что вы заметили?
Заголовок раздела «Что вы заметили?»На картинке вы, вероятно, увидели, что предлоги (синие) образуют довольно плотный кластер. Остальные слова, скорее всего, тоже лежат довольно близко, но плотных кластеров могут не образовывать.
Дело в том, что ваша модель обучалась на очень маленьком наборе данных, и некоторые из этих токенов встречаются в очень немногих контекстах. Поэтому модели, возможно, не хватило информации, чтобы выучить смысл некоторых слов. А частые служебные слова вроде предлогов даже в таком маленьком наборе дают много информации: модель выучивает, что у них похожий смысл и похожая роль в предложении.
В этой лабораторной вы обучили маленькую языковую модель с нуля: сначала создали и обучили на наборе Africa Galore собственный токенизатор кодирования пар байтов (BPE). Этим токенизатором вы перевели текст в подсловные токены и подготовили данные для обучения. Обучив трансформер, вы увидели, как его способность генерировать связный текст растёт по мере того, как он учится соединять подслова в осмысленные слова и предложения. Наконец, изобразив выученные эмбеддинги модели методом t-SNE, вы увидели, как модель начинает организовывать токены в осмысленные кластеры: слова с похожей ролью (например, предлоги) оказываются в пространстве эмбеддингов рядом.
Что сделать руками
Заголовок раздела «Что сделать руками»- Русский корпус. Возьмите 200–300 абзацев русского текста (например, статьи Википедии) и обучите на них
BPEWordTokenizerс 1000 слияний. Какие суффиксы и окончания стали отдельными токенами? Сравните с тем, что выучил ваш байтовый BPE из урока «Byte Pair Encoding с нуля». - Число слияний. Обучите токенизатор Africa Galore с 500, 1500 и 3000 слияний и посчитайте среднее число токенов на абзац. Как оно меняется? Что это значит для длины контекста модели?
- Эмбеддинги по-русски. Возьмите любую открытую модель с русским в словаре (например, Qwen из урока
«Слова как векторы») и посчитайте функцией
cos_simблизость пар «король — королева», «король — автобус», «хорошо — плохо». Совпадает ли картина с выводами лабораторной 2.5?
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| byte pair encoding (BPE) | кодирование пар байтов (BPE) |
| merge, merge rule | слияние, правило слияния |
| end-of-word symbol | символ конца слова |
| pair frequencies | частоты пар |
| out-of-vocabulary (OOV) | слово вне словаря |
| token embedding, embedding matrix | эмбеддинг токена, матрица эмбеддингов |
| vector, matrix, shape | вектор, матрица, форма |
| dot product (inner product) | скалярное произведение |
| transpose | транспонирование |
| L2 norm (magnitude) | L2-норма (длина вектора) |
| cosine similarity | косинусная близость |
| orthogonal | ортогональный |
| dimensionality reduction, t-SNE | снижение размерности, t-SNE |
| padding, truncating | дополнение, обрезка |
| function word, preposition | служебное слово, предлог |