Happy-LLM, глава 6: обучение на практике — претрейн, SFT, LoRA
Полный перевод шестой главы книги Datawhale «Строим большую модель с нуля»: предобучение и SFT модели Qwen2.5 через Hugging Face Transformers, Trainer и DeepSpeed ZeRO-2, эффективное дообучение LoRA и библиотека peft, обзор выравнивания предпочтений.
В пятой главе мы с нуля собрали модель LLaMA2 и полностью реализовали её предобучение и дообучение. В этой главе мы подробно разберём, как обучение больших моделей устроено на практике, и сосредоточимся на том, как с помощью популярных фреймворков эффективно обучать модели и оптимизировать производительность.
Совет по чтению: прежде чем приступать к практике этой главы, прочитайте пояснения к практике главы 6 и раздел «Подготовка к учёбе и окружение» (их перевод — на странице-обзоре книги). Основной текст главы идёт по трём линиям: Pretrain, SFT и PEFT. Выравнивание предпочтений — тема для продвинутых: в разделе 6.4 дан общий маршрут и ссылка на дополнительный материал.
6.1 Предобучение модели
Заголовок раздела «6.1 Предобучение модели»В прошлой главе мы шаг за шагом разобрали устройство LLM и процесс её обучения: вручную реализовали структуру модели LLaMA и весь путь Pretrain и SFT — и глубже поняли принципы работы модели и детали обучения. Но на практике самописное обучение LLM упирается в такие проблемы:
- писать структуру LLM вручную — большой объём работы, за новыми архитектурными находками так не угнаться;
- обучение, написанное с нуля, плохо масштабируется на распределённое обучение на нескольких картах, и эффективность у него низкая;
- оно несовместимо с существующими предобученными LLM: готовые веса не загрузить.
Поэтому в этой главе мы познакомимся с главным фреймворком обучения LLM — Transformers — и вместе с распределённым фреймворком deepspeed, фреймворком эффективного дообучения peft и другими популярными инструментами пройдём весь путь Pretrain и SFT на transformers. Так мы лучше состыкуемся с технологиями, которые реально применяют в индустрии.
6.1.1 Знакомство с фреймворком
Заголовок раздела «6.1.1 Знакомство с фреймворком»Transformers — NLP-фреймворк от Hugging Face. Благодаря модульному устройству он единообразно поддерживает сотни популярных архитектур: BERT, GPT, LLaMA, T5, ViT и другие. С Transformers разработчику не нужно заново реализовывать базовые сети: класс AutoModel одной строкой загружает любую предобученную модель. На рисунке 6.1 — главная страница курса Hugging Face Transformers.
Рисунок 6.1. Hugging Face Transformers — главная страница курса (изображение в оригинале).
Встроенный класс Trainer инкапсулирует основную логику распределённого обучения и поддерживает разные стратегии: нативный DDP из PyTorch, DeepSpeed, Megatron-LM и др. Достаточно просто настроить параметры обучения — и можно комбинировать параллелизм по данным, по модели и конвейерный; на кластере из 8 карт A100 так без труда обучают модели на десятки миллиардов параметров. Вместе с компонентами вроде SavingPolicy и LoggingCallback это автоматизирует управление обучением. Фреймворк также интегрируется с Deepspeed, peft, wandb, Swanlab и другими инструментами — подключение делается просто параметрами, и обучение LLM получается быстрым и эффективным.
Примечание переводчика. Классов с именами SavingPolicy и LoggingCallback в transformers нет; по смыслу речь о стратегиях сохранения (
save_strategy,save_steps) и колбэках (TrainerCallback), которые пишут логи.
Для NLP-исследователя эпохи LLM ещё важнее, что Hugging Face построила на базе Transformers огромное AI-сообщество: там открыты сотни миллионов наборов весов предобученных моделей и более 250 тысяч датасетов разных типов. Через фреймворки Transformers, Datasets, Evaluate и другие собраны вместе предобученные модели, датасеты и функции оценки — так разработчик может легко взять любую предобученную модель и на основе открытых моделей и данных разработать и применить свою.
Рисунок 6.2. Сообщество моделей Hugging Face — страница со списком моделей на хабе (изображение в оригинале).
В эпоху LLM структуру моделей меняют и заново предобучают всё реже: в прикладных задачах разработчики в основном берут уже предобученную LLM и делают Post Train и SFT под свои нужды. А поскольку предобученные модели велики, умение легко подключить распределённые фреймворки вроде deepspeed стало обязательным навыком. Поэтому Transformers постепенно стал главным NLP-фреймворком и в науке, и в индустрии: и в бизнес-разработке, и в исследованиях модели всё чаще реализуют именно на нём. Новые открытые LLM, например DeepSeek и Qwen, тоже сразу выкладывают в сообщество Transformers свои предобученные веса и демо вызова модели. С Transformers можно эффективно и удобно обучать и разрабатывать LLM и выдавать результат промышленного уровня. Дальше мы на основе Transformers покажем, как сделать Pretrain и SFT для LLM.
6.1.2 Инициализация LLM
Заголовок раздела «6.1.2 Инициализация LLM»Готовые модели можно инициализировать прямо классом AutoModel из transformers. Параметры любой предобученной модели содержат её конфигурацию. Если нужно обучить LLM с нуля, можно инициализировать её по уже существующей архитектуре. Возьмём для примера архитектуру Qwen-2.5-1.5B:
Рисунок 6.3. Qwen-2.5-1.5B — страница файлов модели на Hugging Face (изображение в оригинале).
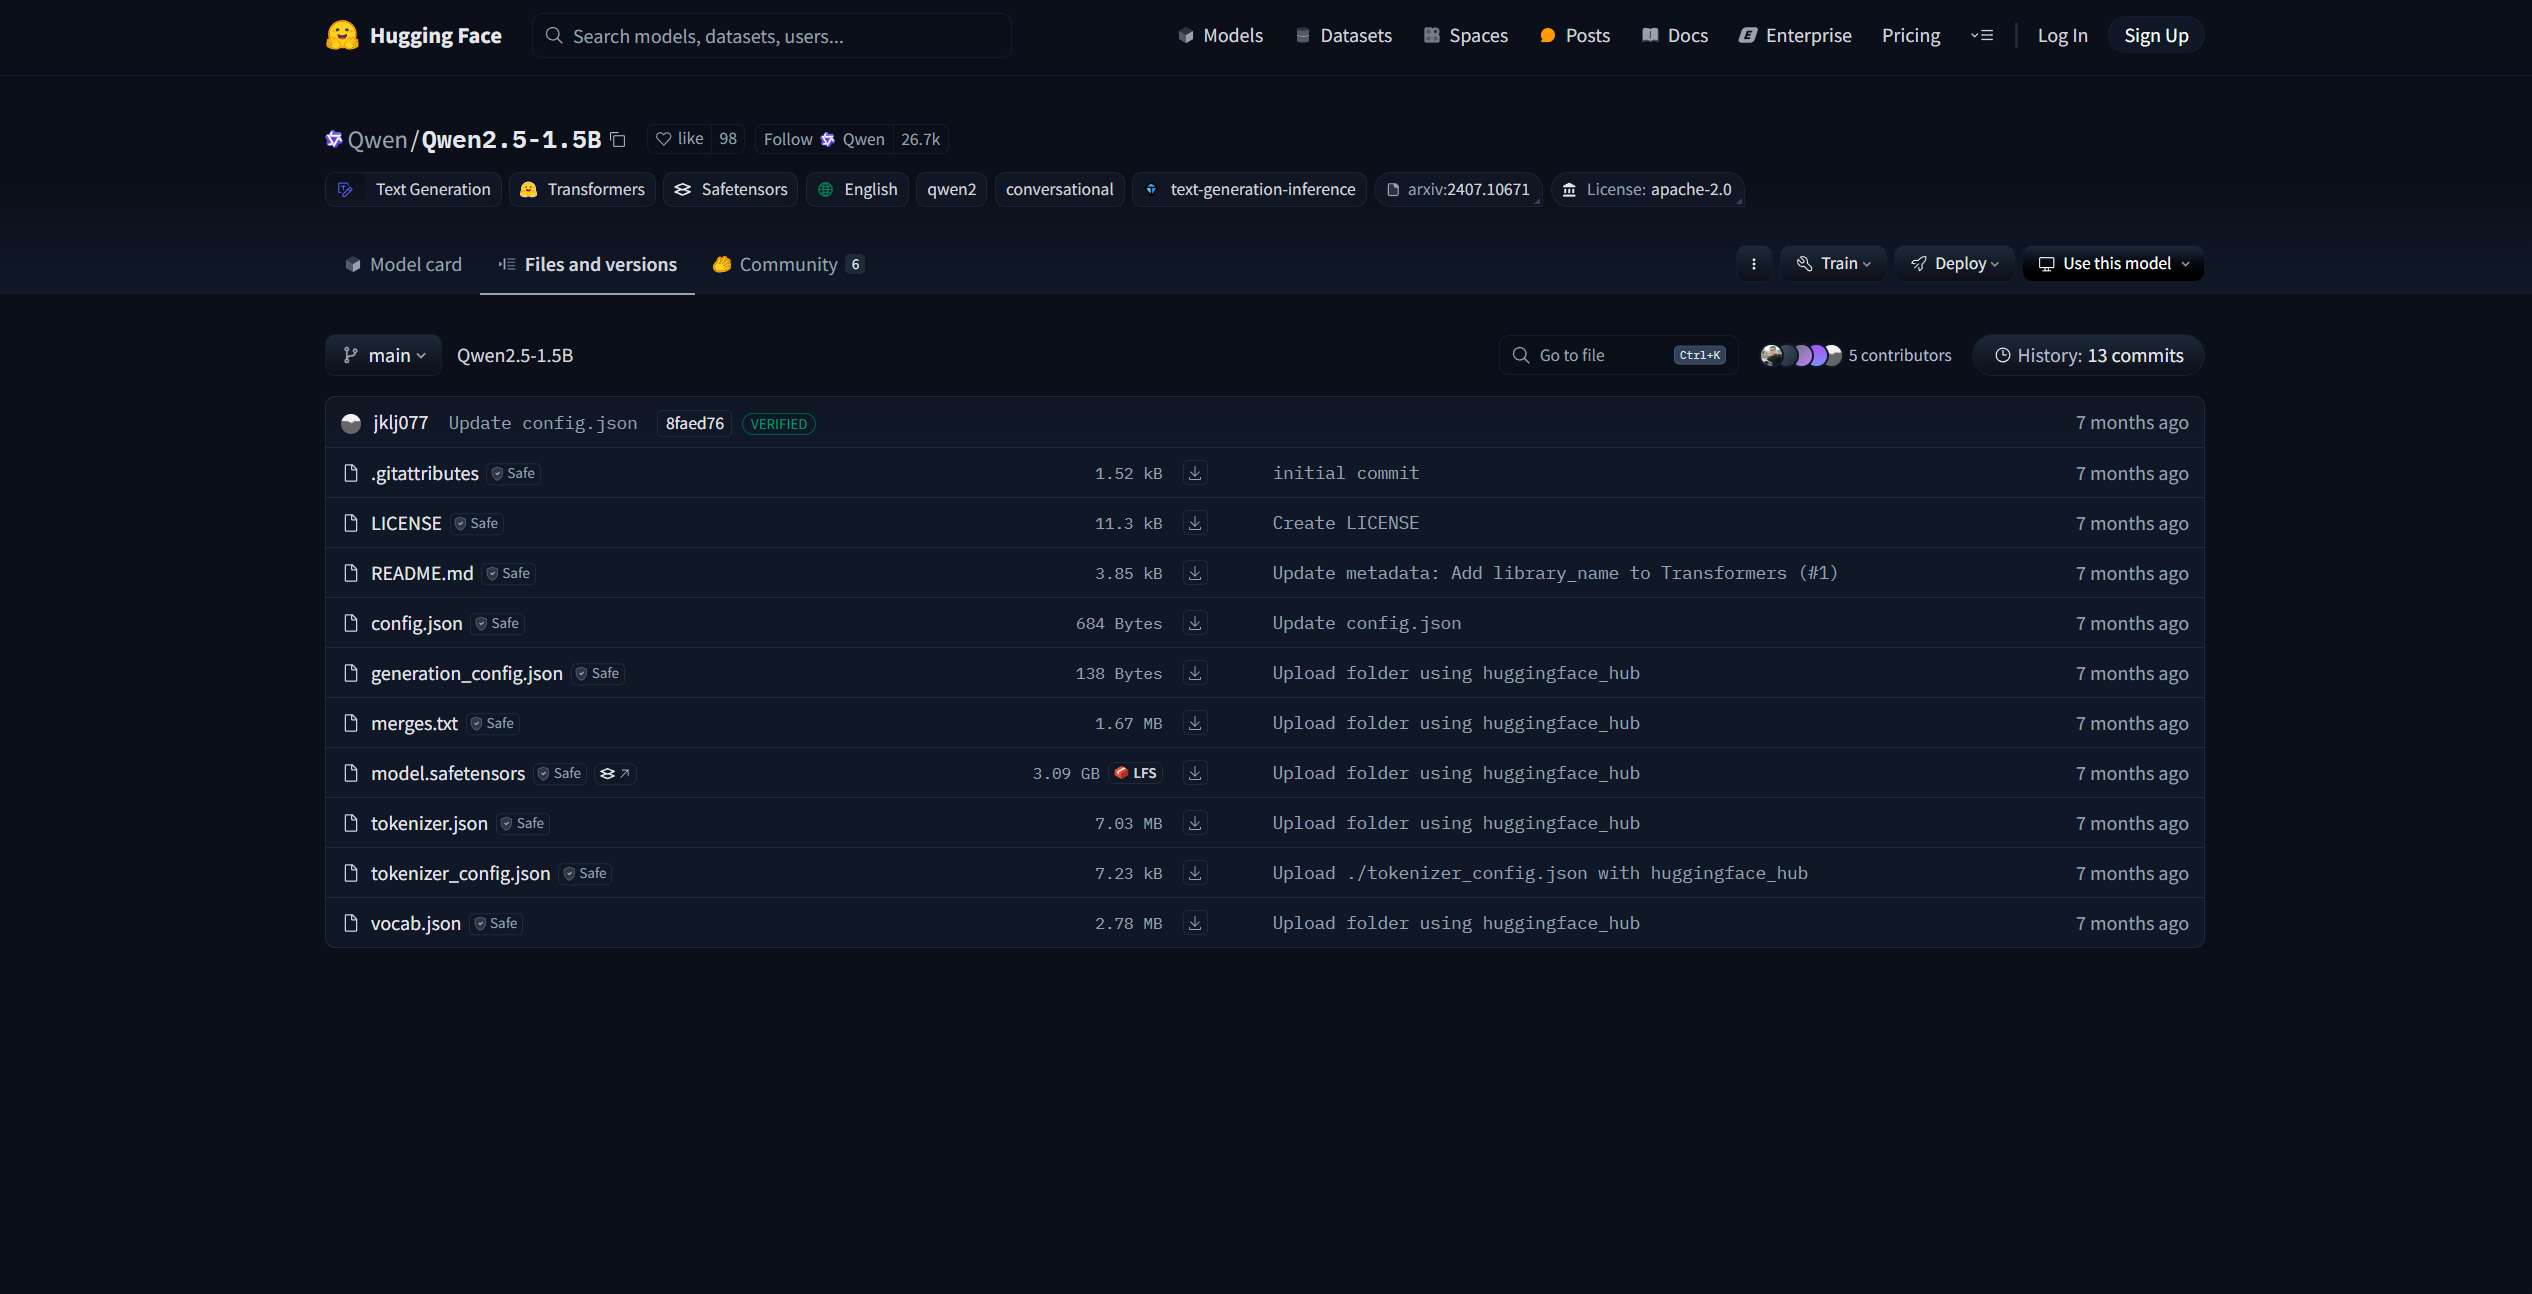
На этой странице сообщества Hugging Face лежат веса Qwen-2.5-1.5B. Файл config.json — это конфигурация модели:
архитектура, размер скрытого слоя, число слоёв и т. д. (рисунок 6.4).
Рисунок 6.4. Файл config.json модели Qwen-2.5-1.5B: поля architectures, hidden_size, num_hidden_layers,
num_attention_heads и другие (изображение в оригинале).
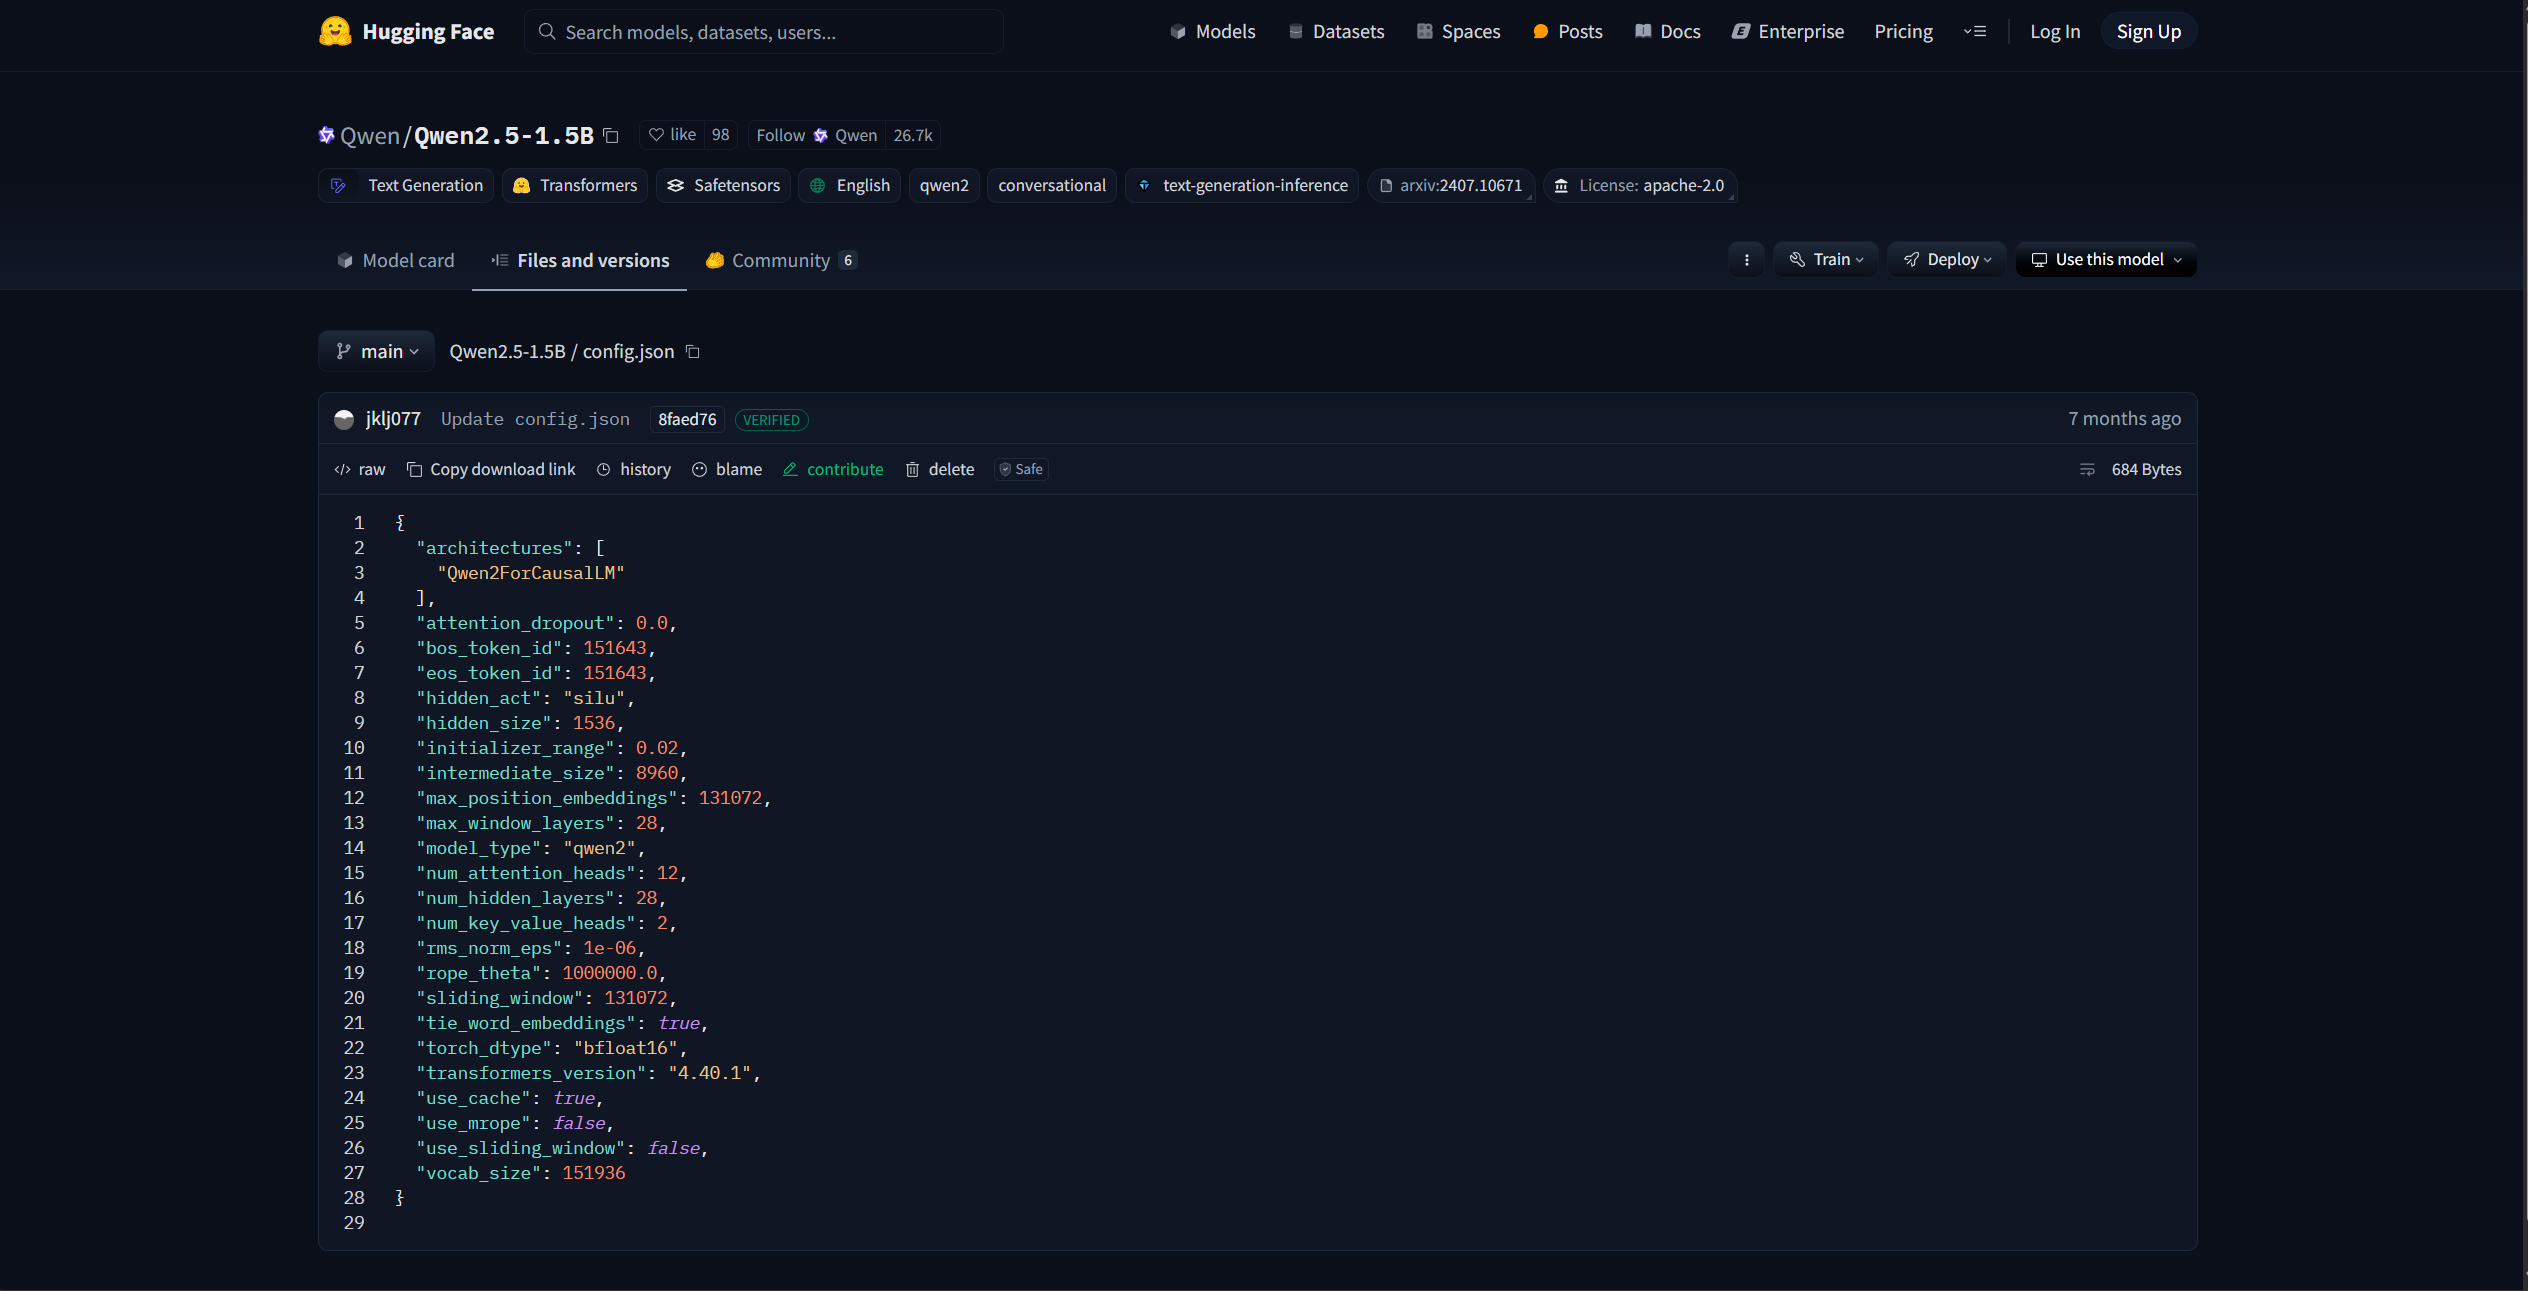
Можно взять эту конфигурацию как есть и инициализировать для обучения модель Qwen-2.5-1.5B, а можно изменить её — например, размер скрытого слоя или число голов внимания — и получить свою структуру модели. Hugging Face даёт инструменты на Python, чтобы удобно скачать нужные веса:
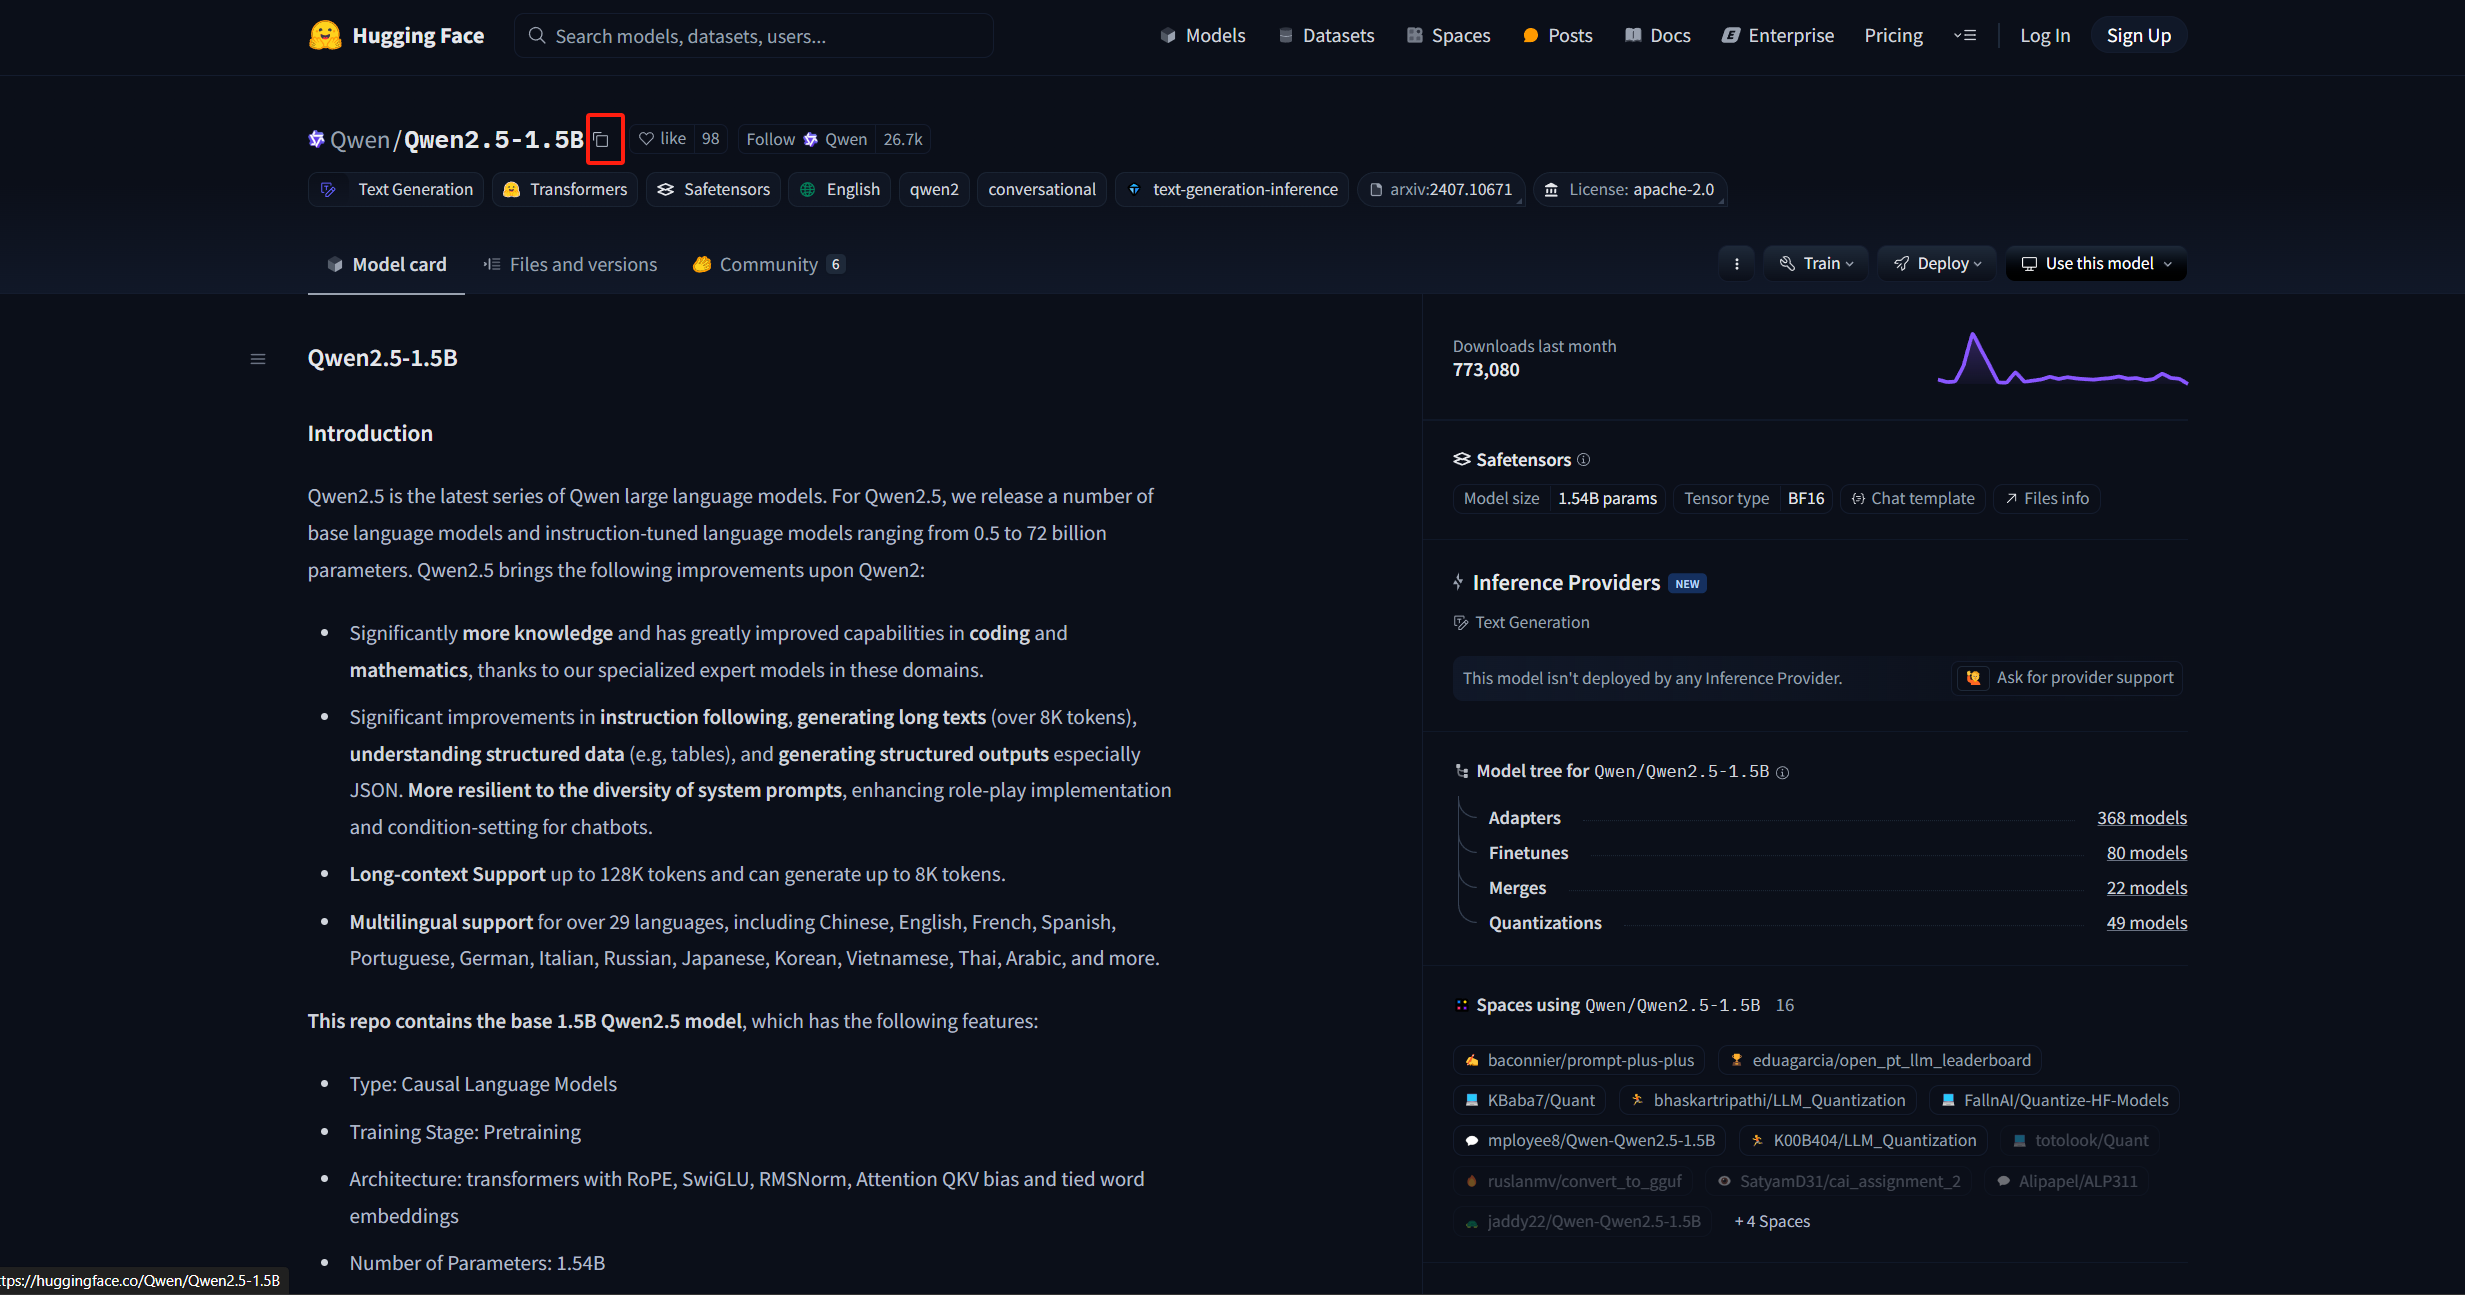
import os# Задаём переменную окружения: здесь используется зеркало Hugging Faceos.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'# Скачиваем модельos.system('huggingface-cli download --resume-download Qwen/Qwen2.5-1.5B --local-dir your_local_dir')Как показано на рисунке 6.5, «Qwen/Qwen2.5-1.5B» — идентификатор скачиваемой модели; для других моделей можно просто скопировать имя модели на Hugging Face:
Рисунок 6.5. Где взять идентификатор модели: кнопка копирования имени рядом с заголовком страницы модели (изображение в оригинале).
Примечание переводчика. Зеркало
hf-mirror.comнужно пользователям из материкового Китая; из России обычно работает и основной адрес. В свежих версияхhuggingface_hubта же команда:hf download Qwen/Qwen2.5-1.5B --local-dir your_local_dir.
После скачивания конфигурацию можно загрузить классом AutoConfig:
# Загружаем заданную конфигурацию модели — здесь на примере Qwen-2.5-1.5B# Загрузка выполняется классом Config из transformersfrom transformers import AutoConfig
# Локальный путь к скачанным параметрамmodel_name_or_path = "qwen-1.5b"config = AutoConfig.from_pretrained(model_name_or_path)
Примечание переводчика. В оригинале переменная объявлена как
model_path, а используетсяmodel_name_or_path; мы привели имена к одному.
Конфигурацию можно и изменить, а затем загрузить так же. По загруженному объекту конфигурации класс AutoModel создаёт соответствующую модель:
# Создаём по этой конфигурации заданную модельfrom transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_config(config,trust_remote_code=True)
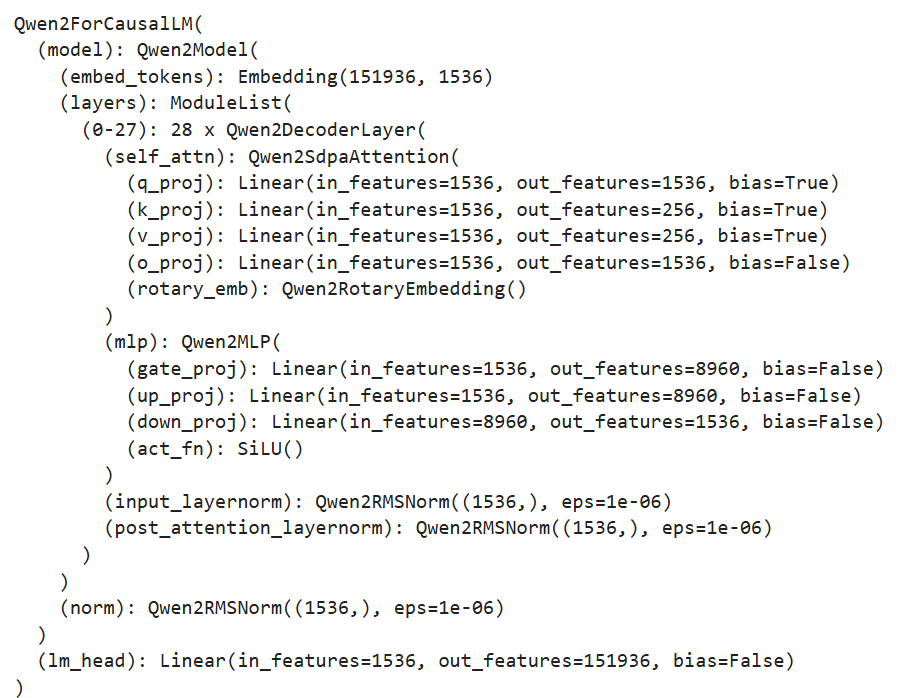
LLM обычно имеют архитектуру CausalLM (каузальная языковая модель), поэтому здесь используется класс AutoModelForCausalLM. Для обучения на задаче классификации можно взять AutoModelForSequenceClassification. Если посмотреть на эту model (рисунок 6.6), видно, что её архитектура совпадает с конфигурацией.
Рисунок 6.6. Вывод структуры модели: Qwen2ForCausalLM с эмбеддингами, 28 слоями декодера (Qwen2DecoderLayer:
self-attention с q_proj, k_proj, v_proj, o_proj, MLP, RMSNorm) и lm_head
(изображение в оригинале).
Эта model — модель Qwen-2.5-1.5B, инициализированная с нуля. На практике LLM редко предобучают с нуля: чаще загружают веса уже предобученной LLM и дообучают её (Post Train) на своём корпусе. Поэтому покажем и то, как инициализировать предобученную модель из скачанных весов:
from transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_pretrained(model_name_or_path,trust_remote_code=True)
Всё аналогично — просто вызываем метод from_pretrained; model_name_or_path здесь — локальный путь к скачанным весам.
Ещё нужно инициализировать tokenizer. Возьмём токенизатор, соответствующий Qwen-2.5-1.5B:
# Загружаем предобученный tokenizerfrom transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained(model_name_or_path)
Загруженный tokenizer сразу готов к работе: им можно токенизировать любой текст.
6.1.3 Подготовка данных для предобучения
Заголовок раздела «6.1.3 Подготовка данных для предобучения»Как и в пятой главе, в качестве данных для предобучения используем открытый датасет «Последовательная обезьяна» (Seq-Monkey) компании Mobvoi; скачать и распаковать его можно так же, как в пятой главе. Библиотека datasets от Hugging Face — сторонняя библиотека в паре с transformers для загрузки и обработки данных. Данные для предобучения загружаются функцией load_dataset:
# Загружаем данные для предобученияfrom datasets import load_dataset
ds = load_dataset('json', data_files='/mobvoi_seq_monkey_general_open_corpus.jsonl')
Учтите: датасет большой, загрузка может занять много времени или упереться в нехватку памяти. Для первых проверок
лучше отделить небольшую часть данных. Загруженный ds — объект DatasetDict; данные по умолчанию лежат под ключом
train, посмотреть их можно так:
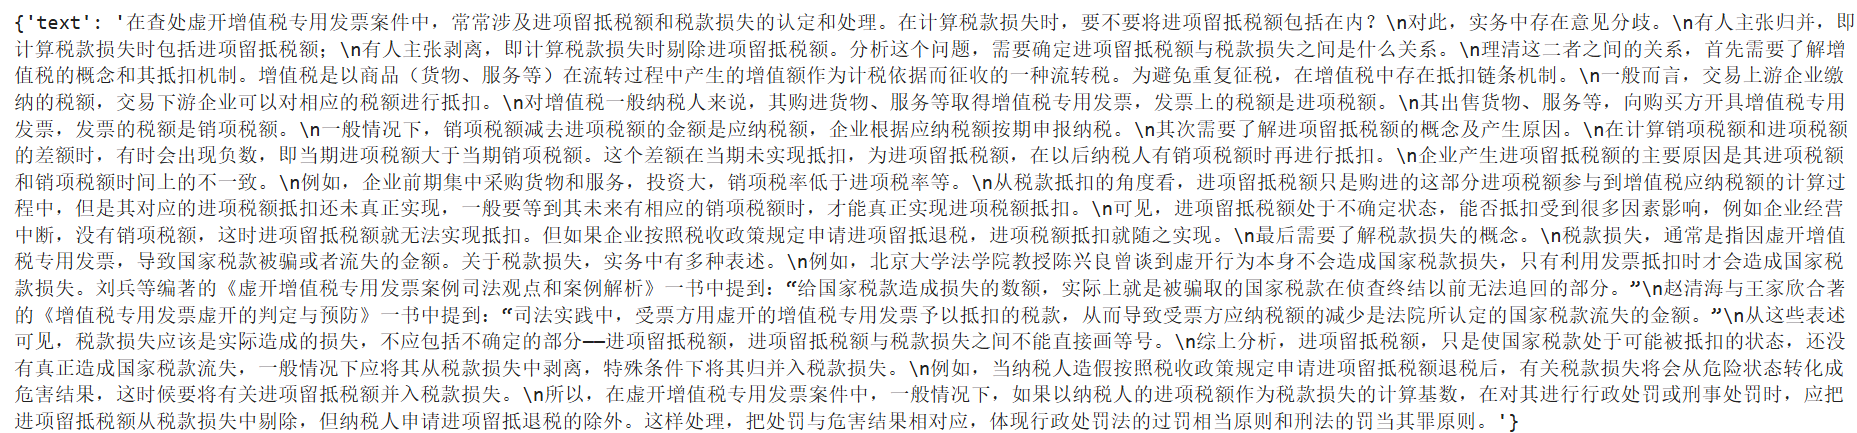
ds["train"][0]Рисунок 6.7. Пример записи датасета: словарь с единственным полем text, в котором лежит китайский текст
(изображение в оригинале).
Через атрибут features можно посмотреть признаки (то есть столбцы) датасета. Имена столбцов надо сохранить: после токенизации исходный текст мы удалим.
# Смотрим признакиcolumn_names = list(ds["train"].features)# columnes_name:["text"]Затем обрабатываем датасет загруженным tokenizer; для пакетной обработки используем функцию map:
# Токенизируем датасетdef tokenize_function(examples):    # Токенизируем заранее загруженным tokenizer    output = tokenizer([item for item in examples["text"]])    return output
# Пакетная обработкаtokenized_datasets = ds.map(    tokenize_function,    batched=True,    num_proc=10,    remove_columns=column_names,    load_from_cache_file=True,    desc="Running tokenizer on dataset",)
В обработанном датасете два столбца: ‘input_ids’ и ‘attention_mask’ — последовательность номеров токенов и маска внимания (отмечает, где padding). Через параметр remove_columns метод map удаляет исходный столбец ‘text’ — в обучении он больше не нужен.
Предобучение — обычно задача CLM (каузального языкового моделирования): если модель за раз учится на нескольких образцах, склеенных в одну последовательность, качеству это не вредит, а данных много и обучение долгое, так что эффективность очень важна. Поэтому при предобучении несколько текстов обычно склеивают и режут на блоки одинаковой длины, а затем обучаются на каждом блоке. Реализуем функцию склейки, которая собирает блоки по 2048 токенов, и применим её через map:
# При предобучении тексты обычно склеивают в отрезки фиксированной длиныfrom itertools import chain
# Берём длину блока 2048block_size = 2048
def group_texts(examples):    # Склеиваем тексты    concatenated_examples = {k: list(chain(*examples[k])) for k in examples.keys()}    # Считаем общую длину склеенного    total_length = len(concatenated_examples[list(examples.keys())[0]])    # Если длина достаточна, отбрасываем хвост, не кратный block_size    if total_length >= block_size:        total_length = (total_length // block_size) * block_size    # Режем на куски по block_size    result = {        k: [t[i : i + block_size] for i in range(0, total_length, block_size)]        for k, t in concatenated_examples.items()    }    # Задача CLM: labels совпадают с input    result["labels"] = result["input_ids"].copy()    return result
# Пакетная обработкаlm_datasets = tokenized_datasets.map(    group_texts,    batched=True,    num_proc=10,    load_from_cache_file=True,    desc=f"Grouping texts in chunks of {block_size}",    batch_size = 40000,)train_dataset = lm_datasets["train"]
Полученный train_dataset можно сразу использовать для CLM-предобучения: каждый образец в нём — 2048 токенов.
Примечание переводчика.
labelsсовпадают сinput_ids, сдвига здесь нет: модели...ForCausalLMв transformers сами сдвигают метки на одну позицию внутри функции потерь. Это и есть упаковка последовательностейупаковка последовательностейEN sequence packingДокументы склеивают в один поток токенов через разделитель и режут на окна фиксированной длины — без паддинга. из урока 5.6.2.
6.1.4 Обучение с Trainer
Заголовок раздела «6.1.4 Обучение с Trainer»Теперь обучаем модель классом Trainer из transformers. Trainer инкапсулирует логику обучения, хорошо оптимизирован по скорости, умеет визуализацию и т. п. — с ним LLM обучается эффективно и удобно.
Сначала задаём гиперпараметры обучения — создаём объект параметров класса TrainingArguments:
from transformers import TrainingArguments# Задаём параметры обучения
training_args = TrainingArguments(    output_dir="output",# куда сохранять результаты обучения    per_device_train_batch_size=4,# batch_size при обучении    gradient_accumulation_steps=4,# шагов накопления градиента: фактический bs = заданный bs * число шагов    logging_steps=10,# через сколько шагов печатать loss    num_train_epochs=1,# число эпох    save_steps=100, # через сколько шагов сохранять веса модели    learning_rate=1e-4,# скорость обучения    gradient_checkpointing=True# включить контрольные точки градиента (gradient checkpointing))
Затем из инициализированных model, tokenizer и training_args, передав подготовленный обучающий датасет, создаём объект trainer:
from transformers import Trainer, default_data_collatorfrom torchdata.datapipes.iter import IterableWrapper
# Тренерtrainer = Trainer(    model=model,    args=training_args,    train_dataset= IterableWrapper(train_dataset),    eval_dataset= None,    tokenizer=tokenizer,    # По умолчанию используется collator для MLM; берём collator для CLM    data_collator=default_data_collator)
Метод train запускает обучение и сохранение по заданным гиперпараметрам:
trainer.train()Примечание: этот код лежит в файле
./code/pretrain.ipynb.
Примечание переводчика.
IterableWrapperиз старого torchdata здесь не обязателен:Trainerпринимает датасет изdatasetsнапрямую (train_dataset=train_dataset). С новыми transformers вместоtokenizer=tokenizerпишитеprocessing_class=tokenizer. Комментарий про MLM неточен: уTrainerпо умолчаниюdefault_data_collator(илиDataCollatorWithPadding, если передан токенизатор), а MLM-collator — это отдельныйDataCollatorForLanguageModeling.
6.1.5 Распределённое обучение с DeepSpeed
Заголовок раздела «6.1.5 Распределённое обучение с DeepSpeed»Предобучение масштабное и долгое, поэтому запускать его в Jupyter Notebook не советуют — легко прерваться. А из-за масштаба обычно нужны несколько карт и распределённое обучение, иначе оно займёт слишком много времени. Покажем, как на основе кода выше реализовать распределённое обучение с фреймворком DeepSpeed и получить предобучение LLM, пригодное для индустрии.
Долгое обучение обычно устроено так: bash-скрипт задаёт гиперпараметры и запускает написанный Python-скрипт обучения.
Весь процесс обучения мы реализуем в одном Python-скрипте (./code/pretrain.py).
Сначала импортируем нужные сторонние библиотеки:
import loggingimport mathimport osimport sysfrom dataclasses import dataclass, fieldfrom torchdata.datapipes.iter import IterableWrapperfrom itertools import chainimport deepspeedfrom typing import Optional,List
import datasetsimport pandas as pdimport torchfrom datasets import load_datasetimport transformersfrom transformers import (    AutoConfig,    AutoModelForCausalLM,    AutoTokenizer,    HfArgumentParser,    Trainer,    TrainingArguments,    default_data_collator,    set_seed,)import datetimefrom transformers.testing_utils import CaptureLoggerfrom transformers.trainer_utils import get_last_checkpointimport swanlab
Сначала нужно описать типы гиперпараметров, чтобы принять значения, заданные в sh-скрипте. В transformers уже есть класс TrainingArguments с основными гиперпараметрами обучения, поэтому нам остаётся описать только то, чего в нём нет: гиперпараметры модели (класс ModelArguments) и данных (класс DataTrainingArguments):
# Классы гиперпараметров@dataclassclass ModelArguments:    """    Параметры модели    """
    model_name_or_path: Optional[str] = field(        default=None,        metadata={            "help": (                "Для дообучения: путь к весам предобученной модели"            )        },    )    config_name: Optional[str] = field(        default=None, metadata={"help": "Для предобучения: путь к файлу Config"}    )    tokenizer_name: Optional[str] = field(        default=None, metadata={"help": "Путь к предобученному Tokenizer"}    )    torch_dtype: Optional[str] = field(        default=None,        metadata={            "help": (                "Тип данных при обучении модели, рекомендуется bfloat16"            ),            "choices": ["auto", "bfloat16", "float16", "float32"],        },    )

@dataclassclass DataTrainingArguments:    """    Параметры обучения (данных)    """
    train_files: Optional[List[str]]  = field(default=None, metadata={"help": "Путь к обучающим данным"})    block_size: Optional[int] = field(        default=None,        metadata={            "help": (                "Длина текстового блока"            )        },    )    preprocessing_num_workers: Optional[int] = field(        default=None,        metadata={"help": "Число потоков для предобработки."},    )
Теперь можно написать главную функцию, которая оборачивает весь процесс обучения. Сначала инструментом HfArgumentParser из transformers загружаем гиперпараметры, заданные в sh-скрипте:
# Загружаем параметры скриптаparser = HfArgumentParser((ModelArguments, DataTrainingArguments, TrainingArguments))model_args, data_args, training_args = parser.parse_args_into_dataclasses()При масштабном обучении ход обучения обычно сохраняют в лог; печатать через print не рекомендуют — так легко потерять важную информацию. Мы используем встроенную в Python библиотеку logging. Сначала настроим лог:
# Настраиваем логlogging.basicConfig(    format="%(asctime)s - %(levelname)s - %(name)s - %(message)s",    datefmt="%m/%d/%Y %H:%M:%S",    handlers=[logging.StreamHandler(sys.stdout)],)
# Ставим уровень логирования INFOtransformers.utils.logging.set_verbosity_info()log_level = training_args.get_process_log_level()logger.setLevel(log_level)datasets.utils.logging.set_verbosity(log_level)transformers.utils.logging.set_verbosity(log_level)transformers.utils.logging.enable_default_handler()transformers.utils.logging.enable_explicit_format()
Здесь уровень лога — INFO. В logging пять уровней: DEBUG, INFO, WARNING, ERROR и CRITICAL; если задать уровень, выводятся сообщения только этого уровня и выше. После настройки там, где нужно что-то записать, просто вызываем logger, указывая уровень записи, например:
# Записываем общую информацию об обученииlogger.warning( f"Process rank: {training_args.local_rank}, device: {training_args.device}, n_gpu: {training_args.n_gpu}" + f"distributed training: {bool(training_args.local_rank != -1)}, 16-bits training: {training_args.fp16}")logger.info(f"Training/evaluation parameters {training_args}")Дальше о логировании в скрипте говорить не будем.
Примечание переводчика. В показанных фрагментах не видно строки
logger = logging.getLogger(__name__)— в файлеpretrain.pyона стоит в начале, после импортов.
При масштабном обучении прерывания почти неизбежны, поэтому через фиксированные интервалы сохраняют checkpoint (контрольную точку), а после прерывания продолжают с последней. Значит, сначала надо проверить, есть ли старый checkpoint, и продолжить обучение с него:
# Проверяем checkpointlast_checkpoint = Noneif os.path.isdir(training_args.output_dir): # Автоматически находим checkpoint встроенной в transformers функцией get_last_checkpoint last_checkpoint = get_last_checkpoint(training_args.output_dir) if last_checkpoint is None and len(os.listdir(training_args.output_dir)) > 0: raise ValueError( f"Выходной каталог ({training_args.output_dir}) не пуст " ) elif last_checkpoint is not None and training_args.resume_from_checkpoint is None: logger.info( f"Продолжаем обучение с {last_checkpoint}" )Затем инициализируем модель описанным выше способом; инициализацию с нуля и из готовой предобученной модели объединим в одном месте:
# Инициализируем модельif model_args.config_name is not None: # с нуля (from scratch) config = AutoConfig.from_pretrained(model_args.config_name) logger.warning("Вы инициализируете модель с нуля") logger.info(f"Путь к конфигурации модели: {model_args.config_name}") logger.info(f"Конфигурация модели: {config}") model = AutoModelForCausalLM.from_config(config,trust_remote_code=True) n_params = sum({p.data_ptr(): p.numel() for p in model.parameters()}.values()) logger.info(f"Предобучаем новую модель - Total size={n_params/2**20:.2f}M params")elif model_args.model_name_or_path is not None: logger.warning("Вы инициализируете предобученную модель") logger.info(f"Путь к весам модели: {model_args.model_name_or_path}") model = AutoModelForCausalLM.from_pretrained(model_args.model_name_or_path,trust_remote_code=True) n_params = sum({p.data_ptr(): p.numel() for p in model.parameters()}.values()) logger.info(f"Продолжаем предобученную модель - Total size={n_params/2**20:.2f}M params")else: logger.error("config_name и model_name_or_path не могут быть пустыми одновременно") raise ValueError("config_name и model_name_or_path не могут быть пустыми одновременно")Дальше так же загружаем tokenizer и готовим данные для предобучения — это в точности совпадает с кодом выше, и мы не будем его повторять; подробности читатель найдёт в коде. Обучаем тоже через Trainer:
logger.info("Инициализируем Trainer")trainer = Trainer(    model=model,    args=training_args,    train_dataset= IterableWrapper(train_dataset),    tokenizer=tokenizer,    data_collator=default_data_collator)
# Загрузка из checkpointcheckpoint = Noneif training_args.resume_from_checkpoint is not None:    checkpoint = training_args.resume_from_checkpointelif last_checkpoint is not None:        checkpoint = last_checkpoint
logger.info("Начинаем обучение")train_result = trainer.train(resume_from_checkpoint=checkpoint)trainer.save_model()
Обратите внимание: выше мы проверили, есть ли checkpoint, поэтому здесь через resume_from_checkpoint обучение продолжается с контрольной точки.
При масштабном обучении особенно важно следить за ходом обучения и падением loss, поэтому в скрипте для мониторинга используется swanlab. В начале скрипта swanlab инициализируется:
# Инициализируем SwanLabswanlab.init(project="pretrain", experiment_name="from_scrach")После запуска обучения терминал выведет url мониторинга swanlab — по нему можно следить за ходом обучения. Подробно об использовании swanlab здесь говорить не будем: читатель найдёт материалы сам.
Закончив с кодом, задаём значения гиперпараметров в sh-скрипте (./code/pretrain.sh) и запускаем обучение через
Deepspeed — так получается эффективное распределённое обучение на нескольких картах:
# Задаём видимые видеокартыCUDA_VISIBLE_DEVICES=0,1
deepspeed pretrain.py \    --config_name autodl-tmp/qwen-1.5b \    --tokenizer_name autodl-tmp/qwen-1.5b \    --train_files autodl-tmp/dataset/pretrain_data/mobvoi_seq_monkey_general_open_corpus_small.jsonl \    --per_device_train_batch_size 16 \    --gradient_accumulation_steps 4 \    --do_train \    --output_dir autodl-tmp/output/pretrain \    --evaluation_strategy  no \    --learning_rate 1e-4 \    --num_train_epochs 1 \    --warmup_steps 200 \    --logging_dir autodl-tmp/output/pretrain/logs \    --logging_strategy steps \    --logging_steps 5 \    --save_strategy steps \    --save_steps 100 \    --preprocessing_num_workers 10 \    --save_total_limit 1 \    --seed 12 \    --block_size 2048 \    --bf16 \    --gradient_checkpointing \    --deepspeed ./ds_config_zero2.json \    --report_to swanlab    # --resume_from_checkpoint ${output_model}/checkpoint-20400 \
После установки библиотеки Deepspeed многокарточное обучение запускается прямо командой deepspeed. Команда выше
в основном задаёт значения гиперпараметров — их можно взять за образец. В четвёртой главе мы разбирали принцип
распределённого обучения DeepSpeed и стадии ZeRO; здесь обучаем с ZeRO-2. Как конфигурация DeepSpeed подгружается
файл ds_config_zero.json:
{    "fp16": {        "enabled": "auto",        "loss_scale": 0,        "loss_scale_window": 1000,        "initial_scale_power": 16,        "hysteresis": 2,        "min_loss_scale": 1    },    "bf16": {        "enabled": "auto"    },    "optimizer": {        "type": "AdamW",        "params": {            "lr": "auto",            "betas": "auto",            "eps": "auto",            "weight_decay": "auto"        }    },
    "scheduler": {        "type": "WarmupLR",        "params": {            "warmup_min_lr": "auto",            "warmup_max_lr": "auto",            "warmup_num_steps": "auto"        }    },
    "zero_optimization": {        "stage": 2,        "offload_optimizer": {            "device": "none",            "pin_memory": true        },        "allgather_partitions": true,        "allgather_bucket_size": 2e8,        "overlap_comm": true,        "reduce_scatter": true,        "reduce_bucket_size": 2e8,        "contiguous_gradients": true    },
    "gradient_accumulation_steps": "auto",    "gradient_clipping": "auto",    "steps_per_print": 100,    "train_batch_size": "auto",    "train_micro_batch_size_per_gpu": "auto",    "wall_clock_breakdown": false}
Наконец, запускаем в терминале bash-скрипт pretrain.sh — и обучение начинается.
Примечание переводчика. Файл в репозитории называется
ds_config_zero2.json, как и в команде запуска. СтрокаCUDA_VISIBLE_DEVICES=0,1безexportне передаётся процессу deepspeed; надёжнееdeepspeed --include localhost:0,1 pretrain.py …илиexport CUDA_VISIBLE_DEVICES=0,1. Значения"auto"в конфиге DeepSpeed подставляются из аргументовTrainingArguments: например,train_batch_size=per_device_train_batch_size×gradient_accumulation_steps× число карт = 16 × 4 × 2 = 128 последовательностей, то есть 128 × 2048 ≈ 262 тыс. токенов за шаг оптимизатора.
6.2 Дообучение модели с учителем (SFT)
Заголовок раздела «6.2 Дообучение модели с учителем (SFT)»В предыдущем разделе мы показали, как быстро и эффективно предобучить модель с фреймворком Transformers. В этом разделе, опираясь на него, покажем, как с Transformers дообучить с учителем (SFT) предобученную модель.
6.2.1 Pretrain против SFT
Заголовок раздела «6.2.1 Pretrain против SFT»Сначала вспомним, в чём главное различие между предобучением LLM и дообучением с учителем. Как говорилось в четвёртой главе, готовые LLM обычно обучают в три этапа: Pretrain — SFT — RLHF. На этапе Pretrain модель самостоятельно (без разметки) моделирует огромные массивы текста и усваивает правила языка и знания о мире, заключённые в текстах. На этапе SFT предобученную модель обычно дообучают на инструкциях (instruction tuning): учат выполнять задачу по инструкции пользователя, чтобы модель следовала инструкциям — планировала, действовала и отвечала по запросу. И Pretrain, и SFT используют CLM-моделирование; главное различие в том, что Pretrain обучается на огромных неразмеченных текстах и модель прямо решает задачу «предскажи следующий токен», а SFT использует пары «инструкция — ответ», и модель по входной инструкции моделирует последующий ответ. В реализации это выражается так: в Pretrain loss считается по всему тексту — модель должна предсказывать весь текст; а в SFT loss считается только по ответу, а по части с инструкцией — нет.
Поэтому по сравнению с кодом Pretrain из прошлого раздела в SFT нужно поменять только обработку данных — построить
из пар «инструкция — ответ» обучающие образцы; остальное реализовано точно так же, как в Pretrain. Код этого раздела —
скрипт ./code/finetune.py.
6.2.2 Подготовка данных для дообучения
Заголовок раздела «6.2.2 Подготовка данных для дообучения»Как и в пятой главе, для SFT используем открытый датасет BelleGroup от компании Beike.
При SFT задают шаблон чата (Chat Template) — он описывает, как превратить диалог в текстовую последовательность, которую модель может моделировать. Когда модель, уже прошедшую SFT, дообучают под свою задачу, обычно смотрят её шаблон чата и подстраиваются под него — чтобы не повредить умение следовать инструкциям, выученное при SFT. Мы делаем SFT поверх модели после Pretrain, поэтому шаблон можно задать свой. Раз для Pretrain мы взяли структуру модели Qwen-2.5-1.5B, здесь продолжим использовать шаблон чата Qwen-2.5. Если у читателя не хватило ресурсов на Pretrain из прошлого раздела, базовой моделью для SFT можно взять официальную Qwen-2.5-1.5B.
Сначала определим несколько служебных токенов. У служебных токенов особая роль при обучении: они отмечают начало текстовой последовательности (BOS), её конец (EOS), перевод строки и т. д. Служебные токены помогают модели не путать смысловые части при обучении:
# Для разных tokenizer их нужно задавать по-своему# BOSim_start = tokenizer("<|im_start|>").input_ids# EOSim_end = tokenizer("<|im_end|>").input_ids# Метка «не считать loss». В оригинале: IGNORE_TOKEN_ID = tokenizer.pad_token_id# (см. примечание переводчика ниже) — правильно -100, его пропускает CrossEntropyLossIGNORE_TOKEN_ID = -100# Перевод строкиnl_tokens = tokenizer('\n').input_ids# Обозначения ролей_system = tokenizer('system').input_ids + nl_tokens_user = tokenizer('human').input_ids + nl_tokens_assistant = tokenizer('assistant').input_ids + nl_tokensВ шаблоне чата моделей Qwen обычно три роли: System, User и Assistant. System — системный промпт, он «включает» способности модели; по умолчанию это «You are a helpful assistant.», и при SFT его обычно не меняют. User — промпт пользователя; в датасете роль собеседника называется «human», поэтому мы заменили «user» на «human». Assistant — ответ LLM, то есть текст, который модель должна научиться воспроизводить при SFT.
Датасет состоит из многоходовых диалогов, поэтому несколько реплик надо склеить в одну текстовую последовательность:
# Склеиваем многоходовые диалогиinput_ids, targets = [], []# Много образцовfor i in tqdm(range(len(sources))): # source — один многоходовой диалог source = sources[i] # Начинаем с реплики user if source[0]["from"] != "human": source = source[1:] # Вход и целевая последовательность input_id, target = [], [] # system: [BOS]system\nYou are a helpful assistant.[EOS]\n system = im_start + _system + tokenizer(system_message).input_ids + im_end + nl_tokens input_id += system # system учить не нужно target += im_start + [IGNORE_TOKEN_ID] * (len(system)-3) + im_end + nl_tokens assert len(input_id) == len(target) # Склеиваем по очереди for j, sentence in enumerate(source): # sentence — одна реплика role = roles[sentence["from"]] # user: <|im_start|>human\ninstruction[EOS]\n # assistant: <|im_start|>assistant\nresponse[EOS]\n _input_id = tokenizer(role).input_ids + nl_tokens + \ tokenizer(sentence["value"]).input_ids + im_end + nl_tokens input_id += _input_id if role == '<|im_start|>human': # user учить не нужно _target = im_start + [IGNORE_TOKEN_ID] * (len(_input_id)-3) + im_end + nl_tokens elif role == '<|im_start|>assistant': # assistant учить нужно _target = im_start + [IGNORE_TOKEN_ID] * len(tokenizer(role).input_ids) + \ _input_id[len(tokenizer(role).input_ids)+1:-2] + im_end + nl_tokens else: print(role) raise NotImplementedError target += _target assert len(input_id) == len(target) # В конце дополняем (PAD) input_id += [tokenizer.pad_token_id] * (max_len - len(input_id)) target += [IGNORE_TOKEN_ID] * (max_len - len(target)) input_ids.append(input_id[:max_len]) targets.append(target[:max_len])Этот код следует логике шаблона чата Qwen; читатель может изменить его под себя. Суть в том, что текст User учить не нужно, поэтому в targets текст User закрыт значением IGNORE_TOKEN_ID, а текст Assistant оставлен как есть — по нему считается loss. В современных LLM IGNORE_TOKEN_ID обычно равен -100.
Примечание переводчика. В оригинальном коде (и в файле
finetune.py) стоитIGNORE_TOKEN_ID = tokenizer.pad_token_id. Это ошибка:CrossEntropyLossв PyTorch и transformers пропускает только метку-100(ignore_index), а позиции с номером pad-токена (у Qwen это 151643) попадут в loss — модель будет учиться предсказывать<|endoftext|>на месте промпта и паддинга. Сам текст главы правильно говорит про -100; в исходном скрипте Qwen, на котором основан этот код, тоже стоит -100. Переменнаяrolesв файле задана так:{"human": "<|im_start|>human", "assistant": "<|im_start|>assistant"}, аsystem_messageпо умолчанию — «You are a helpful assistant.».
Закончив склейку, превращаем последовательности номеров токенов в torch.tensor и возвращаем словарь, который
нужен Dataset:
input_ids = torch.tensor(input_ids)targets = torch.tensor(targets)
return dict(    input_ids=input_ids,    labels=targets,    attention_mask=input_ids.ne(tokenizer.pad_token_id),)
Реализовав эту логику обработки, нужно описать свой класс Dataset, который вызывает её для обработки данных:
class SupervisedDataset(Dataset):
    def __init__(self, raw_data, tokenizer, max_len: int):        super(SupervisedDataset, self).__init__()        # Загружаем и предобрабатываем данные        sources = [example["conversations"] for example in raw_data]        # preprocess — описанная выше логика предобработки        data_dict = preprocess(sources, tokenizer, max_len)
        self.input_ids = data_dict["input_ids"]        self.labels = data_dict["labels"]        self.attention_mask = data_dict["attention_mask"]
    def __len__(self):        return len(self.input_ids)
    def __getitem__(self, i) -> Dict[str, torch.Tensor]:        return dict(            input_ids=self.input_ids[i],            labels=self.labels[i],            attention_mask=self.attention_mask[i],        )
Класс наследует Dataset из Torch и его можно сразу передать в Trainer. Закончив с данными, берём скрипт из прошлого раздела и меняем в нём обработку данных; обучение модели дальше почти такое же. Вот логика главной функции:
# Загружаем параметры скриптаparser = HfArgumentParser((ModelArguments, DataTrainingArguments, TrainingArguments))model_args, data_args, training_args = parser.parse_args_into_dataclasses()
# Инициализируем SwanLabswanlab.init(project="sft", experiment_name="qwen-1.5b")
# Настраиваем логlogging.basicConfig(    format="%(asctime)s - %(levelname)s - %(name)s - %(message)s",    datefmt="%m/%d/%Y %H:%M:%S",    handlers=[logging.StreamHandler(sys.stdout)],)
# Ставим уровень логирования INFOtransformers.utils.logging.set_verbosity_info()log_level = training_args.get_process_log_level()logger.setLevel(log_level)datasets.utils.logging.set_verbosity(log_level)transformers.utils.logging.set_verbosity(log_level)transformers.utils.logging.enable_default_handler()transformers.utils.logging.enable_explicit_format()
# Записываем общую информацию об обученииlogger.warning(    f"Process rank: {training_args.local_rank}, device: {training_args.device}, n_gpu: {training_args.n_gpu}"    + f"distributed training: {bool(training_args.local_rank != -1)}, 16-bits training: {training_args.fp16}")logger.info(f"Training/evaluation parameters {training_args}")
# Проверяем checkpointlast_checkpoint = Noneif os.path.isdir(training_args.output_dir):    last_checkpoint = get_last_checkpoint(training_args.output_dir)    if last_checkpoint is None and len(os.listdir(training_args.output_dir)) > 0:        raise ValueError(            f"Выходной каталог ({training_args.output_dir}) не пуст "        )    elif last_checkpoint is not None and training_args.resume_from_checkpoint is None:        logger.info(            f"Продолжаем обучение с {last_checkpoint}"        )
# Задаём seed генератора случайных чиселset_seed(training_args.seed)
# Инициализируем модельlogger.warning("Загружаем предобученную модель")logger.info(f"Путь к весам модели: {model_args.model_name_or_path}")model = AutoModelForCausalLM.from_pretrained(model_args.model_name_or_path,trust_remote_code=True)n_params = sum({p.data_ptr(): p.numel() for p in model.parameters()}.values())logger.info(f"Продолжаем предобученную модель - Total size={n_params/2**20:.2f}M params")
# Инициализируем Tokenizertokenizer = AutoTokenizer.from_pretrained(model_args.model_name_or_path)logger.info("Tokenizer загружен")
# Загружаем данные для дообученияwith open(data_args.train_files) as f:    lst = [json.loads(line) for line in f.readlines()[:10000]]logger.info("Обучающий набор загружен")logger.info(f"Путь к обучающему набору: {data_args.train_files}")logger.info(f'Всего обучающих образцов: {len(lst)}')# logger.info(f"Пример из обучающего набора: {ds["train"][0]}")
train_dataset = SupervisedDataset(lst, tokenizer=tokenizer, max_len=2048)
logger.info("Инициализируем Trainer")trainer = Trainer(    model=model,    args=training_args,    train_dataset= IterableWrapper(train_dataset),    tokenizer=tokenizer)
# Загрузка из checkpointcheckpoint = Noneif training_args.resume_from_checkpoint is not None:    checkpoint = training_args.resume_from_checkpointelif last_checkpoint is not None:        checkpoint = last_checkpoint
logger.info("Начинаем обучение")train_result = trainer.train(resume_from_checkpoint=checkpoint)trainer.save_model()
Запуск — так же через deepspeed в sh-скрипте; повторяться не будем, исходник — ./code/finetune.sh.
Примечание переводчика. Обратите внимание на
f.readlines()[:10000]: скрипт берёт только первые 10 тысяч диалогов из 3,5 млн — это учебная настройка. Вся предобработка делается сразу в__init__и держит тензоры в памяти: при 10 тысячах образцов × 2048 токенов это ≈160 МБ наinput_idsи столько же наlabels(int64), а для всего датасета так уже не сделать — понадобится ленивая обработка черезdatasets.map.
6.3 Эффективное дообучение
Заголовок раздела «6.3 Эффективное дообучение»В предыдущих разделах мы подробно разобрали принципы и практику Pretrain, SFT и RLHF моделей на фреймворке Transformers. Но у LLM много параметров и много обучающих данных, и такое обучение (особенно SFT и RLHF) меняет все параметры модели — нагрузка на ресурсы огромна. Для компаний и исследовательских групп с ограниченными ресурсами очень важно уметь быстро и эффективно дообучить модель под свою область или задачу и дёшево решать целевые задачи с LLM.
Примечание переводчика. RLHF в этой главе на практике не разбирается — его теория в главе 4, а сама глава 6 ограничивается обзором выравнивания в разделе 6.4.
6.3.1 Способы эффективного дообучения
Заголовок раздела «6.3.1 Способы эффективного дообучения»У дорогого полного дообучения сейчас два основных решения.
Adapt Tuning. В модель добавляют слои Adapter (адаптеры); при дообучении исходные параметры замораживают и обновляют только слои Adapter.
Конкретно: в каждый слой предобученной модели вставляют параметры для целевой задачи — модуль Adapter; при дообучении основную часть модели замораживают и обучают только параметры, специфичные для задачи (рисунок 6.8).
Рисунок 6.8. Adapt Tuning. Слева — слой Transformer, в который после блока внимания и после полносвязного блока вставлено по адаптеру; справа — устройство адаптера: проекция вниз, нелинейность, проекция вверх и обходная (остаточная) связь (изображение в оригинале).
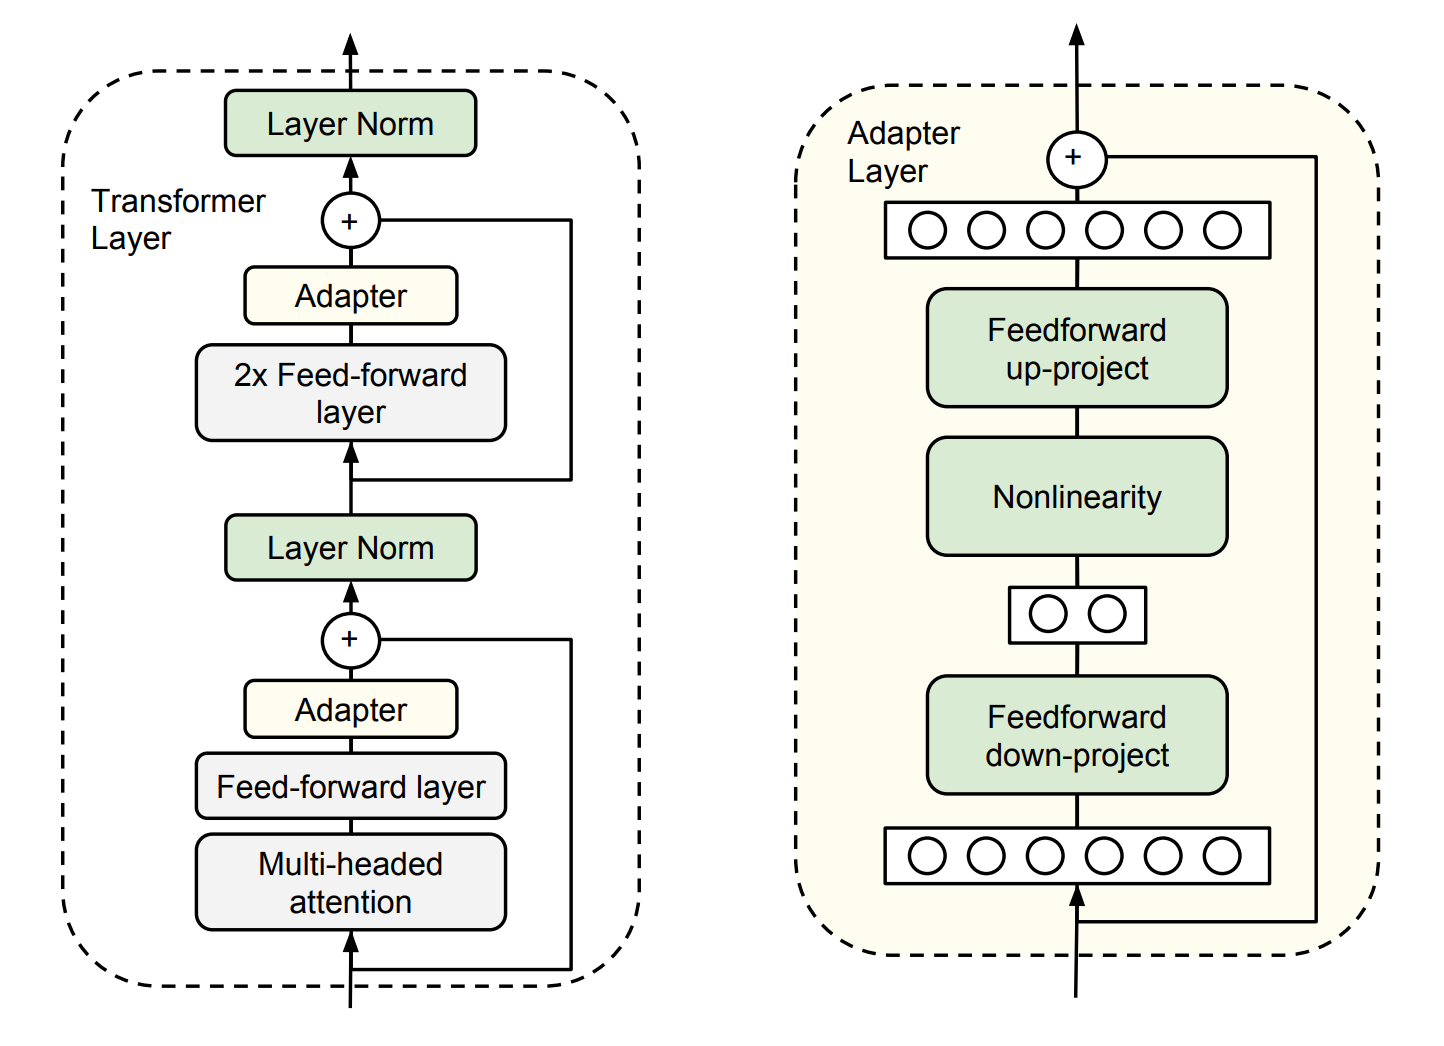
Каждый модуль Adapter состоит из двух полносвязных подслоёв. Первый принимает на вход выход блока Transformer и проецирует исходную размерность в ; размер ограничивает число параметров адаптера, обычно . На выходе второй подслой восстанавливает размерность: проецирует обратно в — это и есть выход модуля Adapter (правая часть рисунка выше).
LoRA на самом деле — улучшенный вариант Adapt Tuning. Но у Adapt Tuning есть проблема задержки при выводе: из-за дополнительных параметров и вычислений дообученная модель считает медленнее исходной.
Prefix Tuning. Этот способ замораживает предобученную языковую модель и добавляет к ней обучаемый префикс, свой для каждой задачи; так для разных задач можно хранить разные префиксы, и дообучение стоит дёшево. Конкретно: перед входными токенами строят последовательность виртуальных токенов (virtual tokens), связанных с задачей, — это prefix; при дообучении обновляются только параметры префикса, остальные заморожены.
Популярный сейчас способ малого дообучения P-tuning — по сути улучшенный Prefix Tuning. Но у Prefix Tuning есть неустранимый недостаток: доступная модели длина последовательности уменьшается. Виртуальные токены занимают часть контекста, поэтому чем выше качество дообучения (чем длиннее префикс), тем меньше длины остаётся модели.
6.3.2 Дообучение LoRA
Заголовок раздела «6.3.2 Дообучение LoRA»Если большая модель отображает данные в пространство высокой размерности и обрабатывает их там, то можно предположить, что для узкой маленькой задачи такая сложная модель не нужна — возможно, задачу можно решить в некотором подпространстве, и тогда не обязательно оптимизировать все параметры. Определим так: если, оптимизируя параметры в некотором подпространстве, мы достигаем определённого уровня качества полной оптимизации (скажем, 90% точности), то ранг матрицы параметров этого подпространства называют внутренним рангом (intrinsic rank) текущей задачи.
Предобученная модель сама по себе неявно понижает внутренний ранг, а после дообучения под конкретную задачу матрицы весов модели имеют ещё более низкий внутренний ранг. Причём чем проще целевая задача, тем ниже её внутренний ранг (Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning). Поэтому ту часть параметров, которая обновляется, можно случайно спроецировать в меньшее подпространство — и она всё равно будет эффективно обучаться; можно понимать это так, что для конкретной задачи эти матрицы весов не обязаны быть полного ранга. Можно косвенно обучать некоторые полносвязные (плотные) слои нейросети, оптимизируя матрицы разложения ранга для изменений этих слоёв в процессе адаптации, — то есть добиваться эффекта дообучения, оптимизируя только матрицы разложения ранга плотных слоёв.
Например, пусть предобученные параметры — , внутренний ранг матрицы весов плотного слоя для конкретной задачи соответствует , а параметры, дообученные под эту задачу, — . Тогда:
Эта и есть матрица разложения ранга, которую оптимизирует LoRA.
Примечание переводчика. В статье Aghajanyan и др. формула записана как : — все параметров модели, — вектор из обучаемых чисел, — фиксированная случайная проекция размера . Обучается только , а не . Смысл: если маленький в случайном подпространстве даёт 90% качества полного дообучения, задаче хватает «степеней свободы». LoRA делает следующий шаг: подпространство не случайное, а обучаемое — это пара матриц и ниже. Подробнее — раздел «Почему это работает: внутренняя размерность» урока 6.2.1.
По сравнению с другими методами эффективного дообучения у LoRA такие преимущества:
- Для разных задач можно строить маленькие модули LoRA и, разделяя общие параметры предобученной модели, эффективно переключаться между задачами.
- LoRA использует адаптивный оптимизатор (Adaptive Optimizer) и не требует считать градиенты и хранить состояния оптимизатора для большей части параметров — обучение эффективнее, требования к железу ниже.
- У LoRA простая линейная конструкция: при развёртывании обучаемые матрицы сливаются с замороженными весами, и задержки при выводе нет.
- LoRA ортогональна другим методам, их можно сочетать.
Поэтому LoRA стала основным методом эффективного дообучения LLM; особенно при ограниченных ресурсах и малом количестве размеченных данных дообучение LoRA часто оказывается первым выбором.
6.3.3 Принцип дообучения LoRA
Заголовок раздела «6.3.3 Принцип дообучения LoRA»(1) Низкоранговая параметризация матрицы обновления
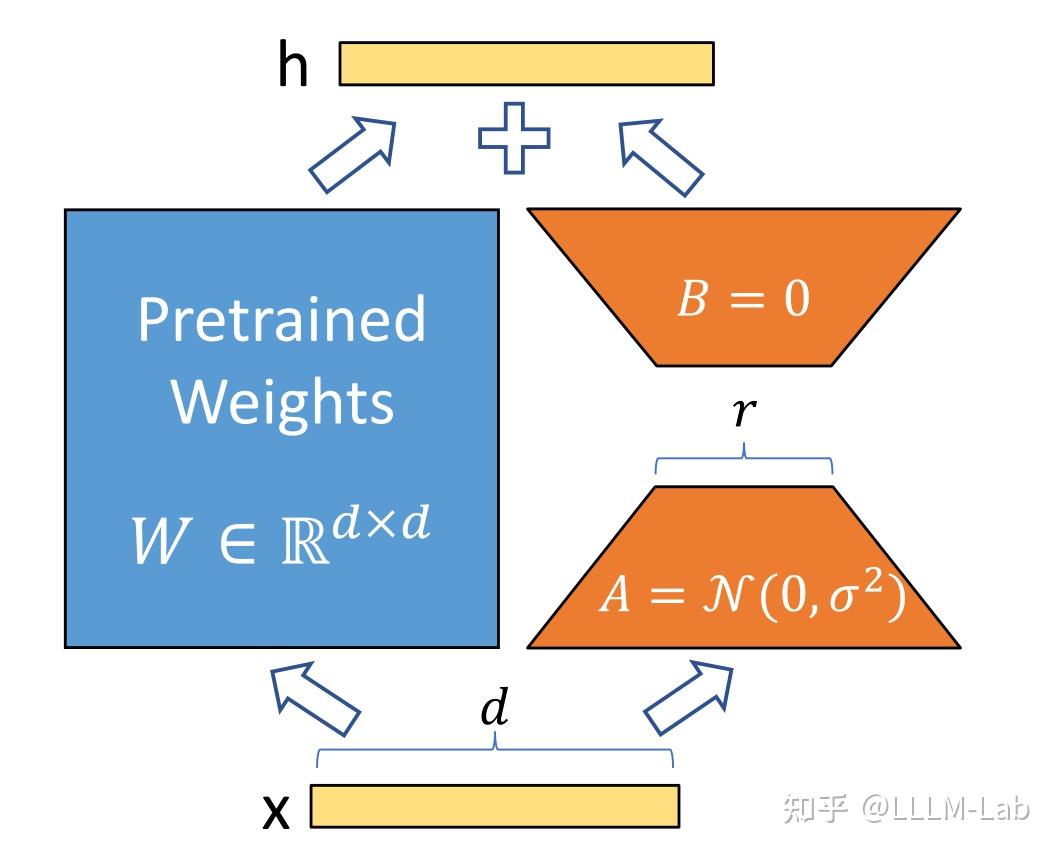
Заголовок раздела «(1) Низкоранговая параметризация матрицы обновления»LoRA предполагает, что и у обновления весов внутренний ранг низок. Для предобученной матрицы весов ( — выходная размерность предыдущего слоя, — входная размерность следующего) обновление представляется низкоранговым разложением:
При обучении заморожена и не обновляется, обучаемые параметры содержатся в и .
Поэтому прямой проход LoRA выглядит так:
В начале обучения инициализируют случайным гауссовым шумом, — нулями, затем оптимизируют их Adam.
Читаем формулу. Выход слоя — это выход исходного замороженного слоя плюс поправка : вход сначала сжимается матрицей до чисел, потом разжимается матрицей обратно. Так как в начале, поправка тоже ноль, и обучение стартует ровно с исходной модели. Пример: , — у 2 359 296 чисел, у и вместе , то есть ≈1%. (Пример переводчика.)
Идея обучения показана на рисунке 6.9.
Рисунок 6.9. LoRA: вход идёт по двум путям — через замороженные предобученные веса и через обучаемую пару матриц (инициализация гауссовым шумом) и (инициализация нулями); результаты складываются (изображение в оригинале).
(2) Применение к Transformer
Заголовок раздела «(2) Применение к Transformer»В Transformer технику LoRA в основном применяют к четырём матрицам весов модуля внимания — , , , , — а веса MLP замораживают.
Абляционные эксперименты показали, что лучший результат даёт одновременная настройка и .
При этих условиях число обучаемых параметров равно:
где — число матриц весов, к которым применена LoRA, — входная и выходная размерность Transformer, — заданный ранг LoRA.
Обычно r берут равным 4, 8 или 16.
Примечание переводчика. Здесь — это выходная проекция внимания (в статье LoRA — ), а не замороженные веса из формулы выше. Формула для верна для квадратных матриц : у каждой пары , по чисел. Пример: Qwen2.5-1.5B (, 28 слоёв), LoRA на и с : , . На деле из-за GQA матрица у Qwen2.5-1.5B не квадратная (), и
peftнасчитает 1 089 536 параметров — ≈0,07% модели. Вывод о «лучше всего и » относится к опытам 2021 года на GPT-3; сейчас LoRA обычно ставят на все линейные слои, включая MLP (target_modules="all-linear"), — см. урок 6.2.1.
6.3.4 Реализация LoRA в коде
Заголовок раздела «6.3.4 Реализация LoRA в коде»Сейчас LoRA-дообучение обычно делают библиотекой peft. peft — сторонняя библиотека от Hugging Face; в ней собраны многие методы эффективного дообучения — LoRA, Adapt Tuning, P-tuning и другие, — и с ней удобно делать LoRA-дообучение модели.
Здесь мы кратко разберём код LoRA в библиотеке peft и посмотрим, как реализовано LoRA-дообучение.
(1) Порядок работы
Заголовок раздела «(1) Порядок работы»Внутри LoRA-дообучение устроено так:
- Определить слои, к которым применяется LoRA. Сейчас peft поддерживает LoRA для трёх типов слоёв: nn.Linear, nn.Embedding и nn.Conv2d.
- Каждый такой слой заменить слоем LoRA. Слой LoRA — это исходный слой, к результату которого добавлена обходная ветвь: низкоранговое разложение (матрицы и ) моделирует обновление параметров.
- Заморозить исходные параметры, дообучить, обновляя параметры слоёв LoRA.
(2) Выбор слоёв LoRA
Заголовок раздела «(2) Выбор слоёв LoRA»Для LoRA-дообучения сначала задают его параметры; один из важных — target_modules. Обычно это список строк, каждая строка — имя слоя, к которому применяется LoRA, например:
target_modules = ["q_proj","v_proj"]Здесь q_proj — это механизма внимания, v_proj — . Слои для LoRA можно выбрать под архитектуру модели и требования задачи.
При создании LoRA-модели этот параметр читается, и в исходной модели находятся соответствующие слои — в основном сопоставлением имён слоёв регулярным выражением (модуль re):
# Находим среди компонентов модели те, в имени которых есть "q_proj", "v_proj"target_module_found = re.fullmatch(self.peft_config.target_modules, key)# key здесь — имя компонента модели(3) Замена слоёв LoRA
Заголовок раздела «(3) Замена слоёв LoRA»Для каждого найденного целевого слоя создаётся новый слой LoRA, который его заменяет.
В реализации слой LoRA — это класс Linear на основе базового класса Lora; он наследует одновременно nn.Linear и LoraLayer. LoraLayer — базовый класс LoRA, он в основном задаёт гиперпараметры LoRA:
class LoraLayer: def __init__( self, r: int, # ранг LoRA lora_alpha: int, # параметр нормировки (масштаба) lora_dropout: float, # доля dropout в слое LoRA merge_weights: bool, # в режиме eval: прибавлять ли матрицы LoRA к исходным весам ): self.r = r self.lora_alpha = lora_alpha # Необязательный dropout if lora_dropout > 0.0: self.lora_dropout = nn.Dropout(p=lora_dropout) else: self.lora_dropout = lambda x: x # Отмечаем, что веса не слиты self.merged = False self.merge_weights = merge_weights self.disable_adapters = Falsenn.Linear — это реализация линейного слоя в PyTorch. Класс Linear — собственно слой LoRA; основное в нём:
class Linear(nn.Linear, LoraLayer):    # Слой LoRA    def __init__(        self,        in_features: int,        out_features: int,        r: int = 0,        lora_alpha: int = 1,        lora_dropout: float = 0.0,        fan_in_fan_out: bool = False,        merge_weights: bool = True,        **kwargs,    ):        # Вызываем конструкторы обоих базовых классов        nn.Linear.__init__(self, in_features, out_features, **kwargs)        LoraLayer.__init__(self, r=r, lora_alpha=lora_alpha, lora_dropout=lora_dropout, merge_weights=merge_weights)
        self.fan_in_fan_out = fan_in_fan_out        # Собственно обучаемые параметры        if r > 0:            # Матрица параметров A            self.lora_A = nn.Linear(in_features, r, bias=False)            # Матрица параметров B            self.lora_B = nn.Linear(r, out_features, bias=False)            # Коэффициент масштаба            self.scaling = self.lora_alpha / self.r            # Замораживаем исходные параметры, обновляем только A и B            self.weight.requires_grad = False        # Инициализируем A и B        self.reset_parameters()        if fan_in_fan_out:            self.weight.data = self.weight.data.T
При замене weight и bias исходного слоя просто копируются в новый слой LoRA, и новый слой переносится на нужное устройство.
(4) Обучение
Заголовок раздела «(4) Обучение»После замены слоёв LoRA остаётся дообучить модель. Исходные параметры в слоях LoRA заморожены, поэтому при обучении обновляются только параметры A и B — так и достигается эффективность. В остальном обучение похоже на обычное дообучение (Fine-tune), повторяться не будем. Из-за LoRA соответственно меняется функция forward:
    def forward(self, x: torch.Tensor):        if self.disable_adapters:            if self.r > 0 and self.merged:                self.weight.data -= (                    transpose(self.lora_B.weight @ self.lora_A.weight, self.fan_in_fan_out) * self.scaling                )                self.merged = False
            return F.linear(x, transpose(self.weight, self.fan_in_fan_out), bias=self.bias)        '''Основная ветвь'''        elif self.r > 0 and not self.merged:            result = F.linear(x, transpose(self.weight, self.fan_in_fan_out), bias=self.bias)            if self.r > 0:                result += self.lora_B(self.lora_A(self.lora_dropout(x))) * self.scaling            return result        else:            return F.linear(x, transpose(self.weight, self.fan_in_fan_out), bias=self.bias)
Из-за слияния параметров в коде несколько ветвей; нам достаточно прочитать вторую — ветвь elif. Прямой проход с LoRA устроен, как в формуле выше: сначала произведение исходных параметров на вход, затем к нему прибавляется произведение A и B на вход.
Примечание переводчика. Это код старой версии peft (≈0.2, 2023); в современной peft слои LoRA устроены иначе (
peft.tuners.lora.layer.Linearоборачивает исходный слой, а не наследует его), но формула та же:result = base_layer(x) + lora_B(lora_A(dropout(x))) * scaling, гдеscaling = lora_alpha / r. Множитель в формулах раздела 6.3.3 не показан — его роль разобрана в уроке 6.2.1.
6.3.5 LoRA-дообучение с peft
Заголовок раздела «6.3.5 LoRA-дообучение с peft»peft хорошо всё инкапсулирует и позволяет удобно и эффективно дообучать большие модели. Возьмём для примера SFT из второго раздела и кратко покажем, как дообучить большую модель с peft. Для RLHF общая схема та же.
Сначала импортируем нужные библиотеки:
import torch.nn as nnfrom transformers import AutoTokenizer, AutoModelfrom peft import get_peft_model, LoraConfig, TaskType, PeftModelfrom transformers import TrainerЗатем загружаем исходную модель и токенизатор — как во втором разделе:
# Загружаем базовую модельtokenizer = AutoTokenizer.from_pretrained(MODEL_PATH, trust_remote_code=True)model = AutoModel.from_pretrained( MODEL_PATH, trust_remote_code=True)Примечание переводчика.
AutoModelзагружает модель без языковой «головы» (lm_head) — для обучения генерации нуженAutoModelForCausalLM, как в разделе 6.2.AutoModelв этом примере — наследие старого кода для ChatGLM, где черезtrust_remote_codeзагружался класс уже с головой.
Затем задаём параметры peft:
peft_config = LoraConfig( task_type=TaskType.CAUSAL_LM, inference_mode=False, r=8, lora_alpha=32, lora_dropout=0.1, )Учтите, что для разных моделей параметры LoRA могут отличаться. Например, для ChatGLM target_modules указывать не нужно — peft найдёт слои сам; для BaiChuan их нужно указать вручную. task_type — тип задачи модели; у больших моделей это обычно CAUSAL_LM, то есть классическая языковая модель.
Затем получаем LoRA-модель:
model = get_peft_model(model, peft_config)Под капотом get_peft_model выполняет как раз то, что мы разобрали выше.
Наконец, обучаем Trainer из transformers — занятая видеопамять при обучении заметно сократится:
trainer = Trainer( model=model, args=training_args, train_dataset= IterableWrapper(train_dataset), tokenizer=tokenizer)trainer.train()Для DPO и KTO точно так же добавляют параметры LoRA и получают LoRA-модель через get_peft_model — больше ничего менять
не нужно. Но учтите: LoRA-дообучение сильно снижает занятость видеокарты и хорошо работает при адаптации под целевые
задачи, но если задача требует выучить соответствующие знания, LoRA, меняющая только низкоранговые матрицы, плохо
справляется с «вливанием» знаний, и результат обычно слабый. Поэтому использовать LoRA для предобучения или
дообучения (пост-тренинга) модели не рекомендуется.
Примечание переводчика. «Для ChatGLM peft найдёт слои сам» — потому что для популярных архитектур в peft есть таблица слоёв по умолчанию (для Qwen2 и LLaMA это
q_projиv_proj). Чтобы увидеть, сколько параметров обучается, вызовитеmodel.print_trainable_parameters(). Последний абзац стоит читать так: LoRA хорошо меняет поведение и формат ответов, но плохо добавляет в модель новые факты; для этого нужно продолженное предобучение всех весов или RAG (глава 7).
6.4 Выравнивание предпочтений
Заголовок раздела «6.4 Выравнивание предпочтений»Выше мы прошли три линии обучения: Pretrain, SFT и эффективное дообучение. Для большой модели, которая работает с реальными пользователями, этого обычно недостаточно. Модель уже хорошо моделирует язык и умеет следовать инструкциям, но стиль ответов, безопасность, полезность и стабильность ещё нужно ограничивать и исправлять дальнейшим пост-обучением; этот шаг обычно называют выравниванием предпочтений (preference alignment).
6.4.1 Зачем нужно выравнивание предпочтений
Заголовок раздела «6.4.1 Зачем нужно выравнивание предпочтений»Pretrain больше занят изучением закономерностей языка и знаний о мире, SFT — тем, чтобы модель научилась следовать инструкциям, а выравнивание предпочтений делает упор на то, «какой ответ больше соответствует ожиданиям людей». Например, в ответах на вопросы, генерации кода или сложных рассуждениях модель должна не просто дать ответ, но и выражаться ясно, отвечать безопасно, рассуждать устойчиво и по возможности избегать ответов не по теме и вредного вывода.
В процессе обучения выравнивание предпочтений идёт после SFT и это очень важное звено пост-обучения (Post-Training). Его главная идея — не заставлять модель дальше просто подгонять текст, а научить её среди нескольких вариантов ответа склоняться к тому, который люди предпочитают.
6.4.2 Обзор основных методов
Заголовок раздела «6.4.2 Обзор основных методов»Основные методы выравнивания предпочтений сейчас такие:
- RLHFобучение с подкреплением на основе отзывов людей (RLHF)EN reinforcement learning from human feedback (RLHF): сначала строят данные о предпочтениях и модель награды, затем обновляют модель-политику обучением с подкреплением. Это самый классический путь выравнивания.
- DPOпрямая оптимизация предпочтений (DPO)EN direct preference optimization (DPO)Rafailov и др., 2023. Обучение на парах предпочтений без reward model и без RL-цикла.: модель оптимизируют прямо по данным о предпочтениях, без явного обучения модели награды; процесс обучения относительно проще.
- KTO: тоже метод прямой оптимизации предпочтений; больше упирает на то, чтобы модель устойчиво различала «хорошие» и «плохие» ответы.
Детали у методов разные, но все они опираются на качественные данные о предпочтениях и обычно строятся поверх SFT-модели.
6.4.3 Связь с предыдущими разделами главы
Заголовок раздела «6.4.3 Связь с предыдущими разделами главы»С инженерной точки зрения выравнивание предпочтений — не совершенно новая отдельная система, а надстройка над предыдущими разделами главы:
- В
6.1мы научились инициализировать модель на Transformers, готовить данные и организовывать обучение. - В
6.2мы построили данные для SFT и провели обучение с учителем — обычно именно это и есть стартовая модель перед выравниванием. - В
6.3мы разобрали LoRA/QLoRA и подключениеpeft— эти методы так же применимы к DPO, KTO и другим задачам выравнивания и снижают стоимость обучения.
Поэтому, переходя к практике выравнивания, вы обнаружите, что по-настоящему новое сосредоточено в организации данных о предпочтениях, способе моделирования награды и устройстве функции потерь предпочтений, а загрузку модели, эффективное по параметрам обучение и большую часть инженерной настройки можно переиспользовать.
6.4.4 Советы по учёбе и практике
Заголовок раздела «6.4.4 Советы по учёбе и практике»Если вы впервые систематически изучаете обучение больших моделей, сначала полностью освойте Pretrain, SFT и PEFT из этой главы, а потом читайте дополнительный материал «6.4 Выравнивание предпочтений». На практике лучше начать с облегчённых методов оптимизации предпочтений вроде DPO, а затем постепенно разобраться в модели награды и полной цепочке RLHF. Так можно составить целостное представление о пост-обучении, не слишком усложняя инженерную часть.
Примечание переводчика. В курсе этому маршруту соответствуют уроки 6.3.2 RLHF и 6.3.3 DPO; готовые реализации DPO и KTO есть в библиотеке TRL (
DPOTrainer,KTOTrainer), иpeft_configпередаётся в них одной строкой.
Литература
[1] Neil Houlsby, Andrei Giurgiu, Stanislaw Jastrzebski, Bruna Morrone, Quentin de Laroussilhe, Andrea Gesmundo, Mona Attariyan, and Sylvain Gelly. (2019). Parameter-Efficient Transfer Learning for NLP. arXiv preprint arXiv:1902.00751.
[2] Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang, and Weizhu Chen. (2021). LoRA: Low-Rank Adaptation of Large Language Models. arXiv preprint arXiv:2106.09685.
[3] Armen Aghajanyan, Luke Zettlemoyer, and Sonal Gupta. (2020). Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning. arXiv preprint arXiv:2012.13255.
[4] Xiang Lisa Li and Percy Liang. (2021). Prefix-Tuning: Optimizing Continuous Prompts for Generation. arXiv preprint arXiv:2101.00190.
От переводчика: как пройти главу
Заголовок раздела «От переводчика: как пройти главу»flowchart LR A["Скачать Qwen2.5-1.5B<br/>и данные"] --> B["6.1 Pretrain:<br/>tokenize, group_texts, Trainer"] B --> C["DeepSpeed ZeRO-2<br/>на нескольких картах"] A --> D["6.2 SFT:<br/>ChatML и маска -100"] D --> E["6.3 LoRA через peft"] E --> F["6.4 DPO / RLHF<br/>(уроки 6.3.x)"]
- Начните с ноутбука
code/pretrain.ipynbна маленьком куске корпуса: убедитесь, чтоgroup_textsвыдаёт блоки ровно по 2048 токенов, а loss падает. - Распечатайте один образец SFT после
preprocess: декодируйтеinput_idsи отдельно — токены, гдеlabels != -100. Во втором должен остаться только текст ответов ассистента (плюс<|im_end|>). Это главный тест главы. - Повторите SFT с LoRA: добавьте
LoraConfigиget_peft_modelвfinetune.py, сравните пиковую видеопамять с полным дообучением. - Удобная готовая обёртка над тем же самым — LLaMA-Factory, см. урок 6.2.2.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| pretraining | предобучение |
| supervised fine-tuning, SFT | дообучение с учителем |
| post-training | пост-обучение |
| distributed training | распределённое обучение |
| gradient accumulation | накопление градиента |
| gradient checkpointing | контрольные точки градиента (пересчёт активаций) |
| resume from checkpoint | продолжение с контрольной точки |
| block (chunk) | блок текста |
| chat template | шаблон чата |
| special token | служебный токен |
| parameter-efficient fine-tuning, PEFT | эффективное по параметрам дообучение |
| adapter | адаптер |
| prefix tuning | настройка префикса |
| intrinsic rank | внутренний ранг |
| low-rank decomposition | низкоранговое разложение |
| preference alignment | выравнивание предпочтений |
| reward model | модель награды |