Deep Learning Tuning Playbook, часть 3: длительность обучения, конвейер и частые вопросы
Перевод заключительной части руководства Google Research: сколько шагов обучать, конвейер данных, оценка и чекпоинты, учёт экспериментов, расписания learning rate, гиперпараметры Adam, квазислучайный поиск, неустойчивость обучения, разогрев и обрезка градиента, формулы оптимизаторов.
Третья, заключительная часть перевода Deep Learning Tuning Playbook. Предыдущая — часть 2: научный подход к улучшению модели. Здесь — практические вопросы: сколько шагов обучать, как устроить оценку и чекпоинты, как вести учёт экспериментов, и большой раздел частых вопросов: расписания learning rate, подбор гиперпараметров Adam, квазислучайный поиск, отладка неустойчивого обучения, разогрев и обрезка градиента, формулы популярных оптимизаторов.
Сколько шагов обучать
Заголовок раздела «Сколько шагов обучать»- Задачи обучения (workloads) бывают двух типов: ограниченные вычислениями и не ограниченные.
- Когда обучение ограничено вычислениями (compute-bound), его ограничивает то, сколько мы готовы ждать, а не то,
сколько у нас обучающих данных, или какой-то другой фактор.
- В этом случае, если удастся каким-то образом обучать дольше или эффективнее, потери на обучающей выборке должны снизиться, а при правильной настройке — улучшиться и потери на валидации.
- Иначе говоря, ускорить обучение — то же самое, что улучшить его, и «оптимальное» время обучения — всегда «столько, сколько можем себе позволить».
- Впрочем, то, что задача ограничена вычислениями, не значит, что дольше или быстрее обучать — единственный способ улучшить результаты.
- Когда обучение не ограничено вычислениями, мы можем позволить себе обучать сколько угодно, и в какой-то момент
дальнейшее обучение уже мало помогает (или даже вызывает проблемное переобучение).
- В этом случае можно ожидать, что удастся обучить модель до очень низких потерь на обучающей выборке — до такой степени, что дальнейшее обучение может чуть-чуть снизить потери на обучении, но заметно не снизит потери на валидации.
- Особенно когда обучение не ограничено вычислениями, более щедрый бюджет времени обучения упрощает настройку — в первую
очередь настройку расписаний затухания learning rate, потому что они особенно сильно взаимодействуют с бюджетом
обучения.
- Иначе говоря, при очень скупом бюджете времени обучения может понадобиться идеально настроенное расписание затухания learning rate, чтобы получить хорошую долю ошибок.
- Независимо от того, ограничена задача вычислениями или нет, методы, которые увеличивают разброс градиентов (между
батчами), обычно замедляют прогресс обучения и потому могут увеличить число шагов, нужное, чтобы достичь заданных потерь
на валидации. Большой разброс градиентов может быть вызван:
- меньшим размером батча;
- добавлением аугментации данных;
- добавлением некоторых видов регуляризации (например, dropout).
Когда обучение не ограничено вычислениями
Заголовок раздела «Когда обучение не ограничено вычислениями»- Наша главная цель — обучать достаточно долго, чтобы модель достигла лучшего возможного результата, и при этом не транжирить шаги обучения.
- Если сомневаетесь, обучайте дольше. При правильном выборе чекпоинта задним числом (оптимальный выбор) и достаточно частых чекпоинтах качество от более долгого обучения никогда не должно ухудшаться.
- Никогда не подбирайте число
max_train_stepsвнутри исследования. Выберите значение и используйте его во всех испытаниях. По этим испытаниям постройте график того, на каком шаге выбор чекпоинта задним числом находит лучший результат, — и уточните выборmax_train_steps.- Например, если лучший шаг всегда приходится на первые 10% обучения, максимальное число шагов слишком велико.
- И наоборот, если лучший шаг стабильно оказывается в последних 25% обучения, нам, возможно, поможет обучать дольше и заново настроить расписание затухания.
- Идеальное число шагов обучения может меняться при изменении архитектуры или данных (например, при добавлении аугментации данных).
- Ниже мы описываем, как выбрать начальное значение-кандидат для
max_train_steps, исходя из числа шагов, нужного, чтобы «идеально подогнать» модель к обучающей выборке с постоянным learning rate.- Заметим: выражение «идеально подогнать к обучающей выборке» мы используем не в точном или математически строгом
смысле. Это лишь неформальное описание очень низких потерь на обучении.
- Например, при обучении с логарифмической функцией потерь (log loss) без членов регуляризации потери на обучении могут продолжать медленно улучшаться вплоть до пределов точности чисел с плавающей точкой: веса сети неограниченно растут, а предсказания модели на обучающей выборке становятся всё увереннее. В этом случае можно сказать, что модель «идеально подогналась» к обучающей выборке примерно тогда, когда доля ошибок классификации на обучающей выборке стала нулевой.
- Найденное начальное значение
max_train_stepsможет понадобиться увеличить, если вырастет шум градиента в процедуре обучения.- Например, если в модель добавлены аугментация данных или регуляризаторы вроде dropout.
- Возможно,
max_train_stepsудастся уменьшить, если процесс обучения каким-то образом улучшится.- Например, при лучше настроенном оптимизаторе или лучше настроенном расписании learning rate.
- Заметим: выражение «идеально подогнать к обучающей выборке» мы используем не в точном или математически строгом
смысле. Это лишь неформальное описание очень низких потерь на обучении.
Алгоритм выбора начального max_train_steps по перебору learning rate
Заголовок раздела «Алгоритм выбора начального max_train_steps по перебору learning rate»- Эта процедура предполагает, что модель можно не только «идеально» подогнать к обучающей выборке, но и сделать это с постоянным learning rate.
- Если всю обучающую выборку можно идеально подогнать, значит, существует конфигурация (с некоторым значением
max_train_steps), которая это делает; найдите любую такую конфигурацию и возьмите еёmax_train_stepsза отправную точкуN. - Запустите перебор постоянного learning rate (то есть поиск по сетке значений learning rate) без аугментации данных
и без регуляризации, где каждое испытание обучается
Nшагов. - Число шагов, за которое самое быстрое испытание перебора достигает идеального качества на обучении, — наша начальная
догадка для
max_train_steps. - ВНИМАНИЕ: неудачные пространства поиска позволяют обмануть самих себя.
- Например, если все learning rate в исследовании слишком малы, можно ошибочно решить, что нужно очень большое значение
max_train_steps. - Как минимум нужно проверить, что оптимальный learning rate исследования не лежит на границе пространства поиска.
- Например, если все learning rate в исследовании слишком малы, можно ошибочно решить, что нужно очень большое значение
Когда обучение ограничено вычислениями
Заголовок раздела «Когда обучение ограничено вычислениями»- Иногда потери на обучении продолжают улучшаться бесконечно, и ограничивающим фактором становятся наше терпение и вычислительные ресурсы.
- Если потери на обучении (или даже на валидации) улучшаются бесконечно, всегда ли надо обучать так долго, как можем себе
позволить? Не обязательно.
- Возможно, настраивать эффективнее, запуская больше коротких экспериментов, а самые длинные запуски «рабочей длины» (production length) оставить для моделей, которые мы надеемся запустить.
- Когда время обучения в испытаниях приближается к пределу нашего терпения, эксперименты по настройке становятся более показательными для возможных кандидатов на запуск, но таких экспериментов мы успеваем провести меньше.
- Вероятно, на многие вопросы можно ответить, обучая всего около 10% рабочей длины, но всегда есть риск, что выводы при таком ограничении времени не будут верны для экспериментов в 20% рабочей длины, не говоря уже о 100%.
- Разумный подход — настраивать в несколько раундов с растущим ограничением числа шагов на испытание.
- Раундов можно сделать сколько угодно, но обычно практичнее всего 1–3.
- По сути, нужно получить как можно больше понимания задачи на испытаниях с очень быстрой отдачей, балансируя тщательность настройки и её значимость для итоговых, самых длинных запусков.
- Когда при данном ограничении времени на испытание получены полезные выводы, можно увеличить время обучения и продолжить настройку, при необходимости перепроверяя выводы, сделанные на коротких запусках.
- В качестве отправной точки мы рекомендуем два раунда настройки:
- Раунд 1: более короткие запуски, чтобы найти хорошие гиперпараметры модели и оптимизатора.
- Раунд 2: совсем немного длинных запусков в хороших точках гиперпараметров, чтобы получить итоговую модель.
- Главный вопрос при переходе от раунда
iк раундуi+1— как подстроить расписания затухания learning rate.- Типичная ошибка при подстройке расписаний между раундами — потратить все дополнительные шаги обучения на слишком маленький learning rate.
Раунд 1
Заголовок раздела «Раунд 1»- К сожалению, нет гарантии, что хорошие гиперпараметры, найденные на коротком, неполном обучении, останутся хорошим выбором при существенном увеличении длины обучения. Однако для некоторых видов гиперпараметров связь обычно достаточно сильна, чтобы раунд 1 был полезен.
- Какие значения гиперпараметров, найденные на коротких запусках, по нашим ожиданиям переносятся на длинные запуски? Для
всего этого нужны дополнительные исследования. Но, исходя из того, что мы знаем сейчас, вот подозрения авторов в порядке
убывания вероятности переноса:
- Переносятся с очень большой вероятностью
- Неустойчивость в начале обучения можно устранить в первом раунде настройки на меньшем числе шагов. Пожалуй, эти
гиперпараметры — самое близкое к гарантированному переносу, что у нас есть:
- длина разогрева (warmup);
- инициализация.
- Неустойчивость в начале обучения можно устранить в первом раунде настройки на меньшем числе шагов. Пожалуй, эти
гиперпараметры — самое близкое к гарантированному переносу, что у нас есть:
- Скорее всего, переносятся
- Архитектура модели: резкий выигрыш в архитектуре обычно переносится, но контрпримеров, вероятно, много.
- Могут переноситься
- Алгоритм оптимизации и гиперпараметры оптимизатора: думаем, переносятся «приблизительно». Это определённо слабее, чем пункты выше.
- Аугментация данных.
- Регуляризация.
- Если идеально подогнать модель к обучающей выборке нельзя, модель может быть в режиме, где регуляризация вряд ли сильно поможет.
- Вряд ли переносятся
- Расписание learning rate: идеально — вряд ли.
- Эта статья предполагает, что переносится даже расписание затухания, но мы
не считаем, что это верно в общем случае. Пример: если настроить затухание по корню (sqrt decay) на малом числе
шагов, а затем растянуть на большое, бо́льшая часть обучения пройдёт со слишком маленькими шагами.
- Вероятно, в пределе очень большого бюджета обучения «достаточно хорошо» работает большинство расписаний, но при настройке, скорее всего, можно получить заметный прирост качества.
- Статья Understanding Short-Horizon Bias in Stochastic Meta-Optimization описывает опасности близорукого выбора learning rate.
- Эта статья предполагает, что переносится даже расписание затухания, но мы
не считаем, что это верно в общем случае. Пример: если настроить затухание по корню (sqrt decay) на малом числе
шагов, а затем растянуть на большое, бо́льшая часть обучения пройдёт со слишком маленькими шагами.
- Расписание learning rate: идеально — вряд ли.
- Переносятся с очень большой вероятностью
Раунд 2
Заголовок раздела «Раунд 2»- Запустите лучшую конфигурацию гиперпараметров из раунда 1.
- (Предположение) 🤖 Потратьте дополнительные шаги на то, чтобы продлить период обучения с высоким learning rate.
- Например, при линейном расписании сохраните длину затухания из раунда 1 и удлините период постоянного learning rate в начале.
- Для косинусного затухания просто сохраните базовый learning rate из раунда 1 и увеличьте
max_train_steps, как в статье о Chinchilla.
- Больше раундов может иметь смысл для команд с очень зрелыми конвейерами моделирования и настройки и очень длинными
и дорогими рабочими запусками обучения, но часто это перебор.
- Мы описали, как переходить от шага 1 к шагу 2. Если бы время анализа нас не волновало, а эффективное использование
вычислений было бы главной заботой, то в идеале длину запусков обучения (а значит, и общее время исследования)
следовало бы увеличивать экспоненциально на протяжении многих раундов настройки.
- В каждом раунде мы систематически убеждаемся, что наши решения по-прежнему верны.
- Новые идеи проходят через конвейер, который постепенно снижает их риск с помощью всё более длинных экспериментов
от шага
iк шагуi+1.
- Мы описали, как переходить от шага 1 к шагу 2. Если бы время анализа нас не волновало, а эффективное использование
вычислений было бы главной заботой, то в идеале длину запусков обучения (а значит, и общее время исследования)
следовало бы увеличивать экспоненциально на протяжении многих раундов настройки.
Дополнительные советы по конвейеру обучения
Заголовок раздела «Дополнительные советы по конвейеру обучения»Оптимизация конвейера входных данных
Заголовок раздела «Оптимизация конвейера входных данных»Коротко: причины того, что конвейер упирается во входные данные, и способы это исправить сильно зависят от задачи; используйте профилировщик и следите за типичными проблемами.
- Чтобы диагностировать конвейер, упирающийся во входные данные (input-bound), используйте подходящий профилировщик. Например, Perfetto для JAX или TensorFlow profiler для TensorFlow.
- В конечном счёте конкретные причины и способы исправления сильно зависят от задачи. Более широкие инженерные соображения (например, минимизация места на диске) могут оправдать менее производительный конвейер входных данных.
- Типичные причины:
- Данные лежат не рядом с процессом обучения, что даёт задержки ввода-вывода (так бывает при чтении обучающих данных по сети).
- Дорогая предобработка данных «на лету» (подумайте о том, чтобы сделать её один раз заранее и сохранить).
- Непреднамеренные барьеры синхронизации, мешающие предзагрузке (prefetching) в конвейере данных. Например, при синхронизации метрик между устройством и хостом в CommonLoopUtils (ссылка).
- Типичные советы:
- Настройте конвейер входных данных на предзагрузку примеров (например, tf.data.Dataset.prefetch).
- Удаляйте неиспользуемые признаки и метаданные из каждого примера как можно раньше в конвейере.
- Увеличьте число параллельных заданий, порождающих примеры для конвейера входных данных. Например, с помощью tf.data service.
Оценка качества модели
Заголовок раздела «Оценка качества модели»Коротко: проводите оценку с бо́льшим размером батча, чем при обучении. Запускайте оценку через равные промежутки в шагах, а не во времени.
Настройки оценки
Заголовок раздела «Настройки оценки»- Оценивать качество модели можно в нескольких режимах.
- Онлайн-оценка — метрики собираются, когда модель выдаёт предсказания в рабочей среде.
- Офлайн-оценка — метрики собираются, когда модель запускают на заранее собранных обучающей, валидационной и тестовой выборках, представляющих рабочую среду.
- Периодическая оценка — метрики собираются во время обучения; они могут быть приближением офлайн-оценки и (или) считаться на части данных, используемых в офлайн-оценке.
- Онлайн-оценка — золотой стандарт, но на этапе разработки модели она часто непрактична.
- В зависимости от задачи офлайн-оценка может быть довольно сложной и вычислительно дорогой.
- Периодическая оценка — самый практичный и экономный вариант, но она может не вполне отражать рабочую среду.
- Наша цель при периодической оценке — использовать удобное приближение офлайн-оценки, не жертвуя надёжностью сигнала, который мы получаем во время обучения.
Периодическая оценка
Заголовок раздела «Периодическая оценка»- Мы проводим периодическую оценку во время обучения, чтобы следить за его ходом в реальном времени, упростить выбор чекпоинта задним числом и изучить кривые обучения после обучения.
- Простейшая конфигурация — выполнять и обучение, и периодическую оценку на одном вычислительном экземпляре, периодически
чередуя обучение и оценку.
- В этом случае размер батча для оценки должен быть не меньше размера батча при обучении: во время оценки не нужно хранить активации модели, поэтому вычислительные требования на пример ниже.
- Периодическую оценку следует проводить через равные промежутки в шагах, а не во времени.
- Оценка через промежутки времени может затруднить интерпретацию кривых обучения, особенно когда задания обучения вытесняются (preemption), возникают сетевые задержки и т. п.
- Периодичность в метриках на валидации или тесте (при перемешанном разбиении на обучение, валидацию и тест) может указывать на ошибки реализации, например пересечение тестовых данных с обучающими или плохо перемешанные обучающие данные. Оценка через равные промежутки в шагах помогает такие проблемы заметить.
- Неполные батчи бывают, когда размер оценочной выборки не делится на размер батча. Следите, чтобы дополненные примеры правильно взвешивались и не смещали функцию потерь. Часто таким дополненным примерам можно дать вес ноль.
- Сохраняйте при каждой оценке достаточно сведений для офлайн-анализа. В идеале — предсказания на подборке отдельных
примеров: для отладки они бывают бесценны.
- Артефакты вроде SavedModel позволяют легко изучить модель по ходу дела, когда задания оценки завершатся.
Выбор выборки для периодической оценки
Заголовок раздела «Выбор выборки для периодической оценки»- Задание периодической оценки может не успевать за разумное время вычислить метрики на полной офлайн-выборке для оценки. Поэтому для периодической оценки часто приходится делать подвыборку.
- Составляя подвыборку, мы учитываем следующие факторы:
-
Размер выборки
- Проверьте, что качество на подвыборке, которую использует периодическое задание, совпадает с качеством на всей офлайн-выборке для оценки, то есть между подвыборкой и полным набором нет перекоса.
- Набор для периодической оценки должен быть достаточно маленьким, чтобы на нём целиком было легко получить предсказания модели, но достаточно большим, чтобы улучшения модели можно было точно измерить (то есть чтобы их не заглушал шум в метках).
- Он должен быть достаточно большим, чтобы выдержать много таких оценок в последовательных испытаниях и всё равно давать точные оценки. То есть чтобы со временем не «подогнаться» адаптивно к валидационной выборке так, что это не обобщается на отложенную тестовую выборку. Впрочем, на практике это соображение редко имеет значение.
-
Несбалансированные наборы данных
- На несбалансированных наборах данных качество на редких классах часто шумное.
- Для наборов, где в каком-то классе мало примеров, записывайте число верно предсказанных примеров, чтобы лучше понимать улучшения точности (рост чувствительности на 0,05 звучит впечатляюще, но не был ли это всего один лишний верный пример?).
-
Размер выборки
Сохранение чекпоинтов и выбор лучшего задним числом
Заголовок раздела «Сохранение чекпоинтов и выбор лучшего задним числом»Коротко: обучайте фиксированное число шагов и выбирайте лучший чекпоинт запуска задним числом.
- Большинство фреймворков глубокого обучения поддерживают сохранение чекпоинтов модели, то есть периодическое сохранение текущего состояния модели на диск. Это делает задание обучения устойчивым к прерываниям вычислительного экземпляра.
- Лучший чекпоинт часто не последний, особенно когда качество на валидационной выборке со временем не растёт, а колеблется около некоторого значения.
- Настройте конвейер так, чтобы во время обучения он отслеживал N лучших чекпоинтов, встреченных к текущему моменту. Тогда в конце обучения выбор модели сводится к выбору лучшего чекпоинта, встреченного за время обучения. Мы называем это оптимальным выбором чекпоинта задним числом (retrospective optimal checkpoint selection).
- Поддерживать раннюю остановку «на ходу» (prospective early stopping) обычно не нужно: бюджет испытаний задан заранее, а N лучших чекпоинтов сохраняются.
# Примечание переводчика: хранить N лучших чекпоинтов в PyTorch.import heapq, os, torch
N = 3best = []   # куча из (-val_loss, step, path): на вершине — худший из хранимых
def maybe_save(model, step, val_loss):    path = f"ckpt_step{step}.pt"    if len(best) < N or -val_loss > best[0][0]:        torch.save(model.state_dict(), path)        heapq.heappush(best, (-val_loss, step, path))        if len(best) > N:            _, _, worst_path = heapq.heappop(best)   # выкидываем худший            os.remove(worst_path)# В конце обучения: max(best) — чекпоинт с наименьшими потерями на валидации.
Учёт экспериментов
Заголовок раздела «Учёт экспериментов»Коротко: отслеживая разные эксперименты, обязательно записывайте ряд главных вещей — например, лучшее качество чекпоинта в исследовании и краткое описание исследования.
- Нам показалось полезным вести учёт результатов экспериментов в электронной таблице — для тех задач моделирования,
над которыми мы работали. В ней часто такие столбцы:
- название исследования;
- ссылка на место, где хранится конфигурация исследования;
- заметки или краткое описание исследования;
- число проведённых испытаний;
- качество лучшего чекпоинта исследования на валидационной выборке;
- конкретные команды для воспроизведения или заметки о том, какие незакоммиченные изменения понадобились для запуска обучения.
- Найдите систему учёта, которая фиксирует хотя бы перечисленные сведения и удобна тем, кто её ведёт. Неучтённые эксперименты всё равно что не существуют.
Детали реализации batch normalization
Заголовок раздела «Детали реализации batch normalization»Коротко: сегодня batch norm часто можно заменить на LayerNorm, но там, где нельзя, при изменении размера батча или числа хостов есть хитрые детали.
- Batch norm нормализует активации по их среднему и дисперсии в текущем батче, но на нескольких устройствах эти статистики на каждом устройстве свои, если их явно не синхронизировать.
- По отдельным свидетельствам (в основном на ImageNet), вычисление нормализующих статистик всего по ~64 примерам на практике работает лучше (см. Ghost Batch Norm в этой статье).
- Разделение общего размера батча и числа примеров, по которым считаются статистики batch norm, особенно полезно при сравнении размеров батча.
- Реализации ghost batch norm не всегда правильно обрабатывают случай, когда размер батча на устройство больше виртуального размера батча. В этом случае на каждом устройстве нужно делать подвыборку батча, чтобы получить нужное число примеров для статистик batch norm.
- Экспоненциальные скользящие средние, используемые batch norm в режиме тестирования, — это просто линейная комбинация статистик обучения, поэтому их нужно синхронизировать только перед сохранением в чекпоинт. Однако некоторые популярные реализации batch norm эти скользящие средние не синхронизируют и сохраняют их только с первого устройства.
Особенности многохостовых конвейеров
Заголовок раздела «Особенности многохостовых конвейеров»Коротко: в журналировании, оценке, генераторах случайных чисел, чекпоинтах и шардировании данных многохостовое обучение позволяет очень легко внести ошибки!
- Следите, чтобы конвейер вёл журнал и сохранял чекпоинты только на одном хосте.
- Перед оценкой или сохранением чекпоинта убедитесь, что статистики batch norm синхронизированы между хостами.
- Критически важно иметь зёрна генератора случайных чисел, одинаковые на всех хостах (для инициализации модели), и зёрна, различные на разных хостах (для перемешивания и предобработки данных), — поэтому помечайте их соответствующим образом.
- Для производительности обычно рекомендуется шардировать (распределять) файлы данных между хостами.
Частые вопросы
Заголовок раздела «Частые вопросы»Какое семейство расписаний затухания learning rate лучше?
Заголовок раздела «Какое семейство расписаний затухания learning rate лучше?»- Это открытый вопрос. Непонятно, как построить набор строгих экспериментов, чтобы уверенно ответить, какое расписание затухания learning rate «лучшее».
- Хотя мы не знаем лучшего семейства расписаний, мы уверены, что важно иметь какое-то (непостоянное) расписание и что его настройка имеет значение.
- В разные моменты процесса оптимизации лучше всего работают разные learning rate. Расписание повышает вероятность, что модель попадёт на хороший learning rate.
Какое затухание learning rate взять по умолчанию?
Заголовок раздела «Какое затухание learning rate взять по умолчанию?»- Мы предпочитаем линейное или косинусное затухание; вероятно, хороши и многие другие семейства расписаний.
# Примечание переводчика: разогрев + косинусное затухание в PyTorch.import math, torch
model = torch.nn.Linear(10, 1)opt = torch.optim.AdamW(model.parameters(), lr=3e-4)warmup, total = 1_000, 10_000
def lr_lambda(step):    if step < warmup:        return step / warmup                              # линейный разогрев от 0 до 1    progress = (step - warmup) / (total - warmup)         # от 0 до 1 после разогрева    return 0.5 * (1 + math.cos(math.pi * progress))       # косинус от 1 до 0
sched = torch.optim.lr_scheduler.LambdaLR(opt, lr_lambda)# В цикле обучения после opt.step(): sched.step()
Почему в некоторых статьях сложные расписания learning rate?
Заголовок раздела «Почему в некоторых статьях сложные расписания learning rate?»- Нередко встречаются статьи со сложными кусочными расписаниями затухания learning rate (LR).
- Читатели часто гадают, как авторы пришли к такому сложному расписанию.
- Многие сложные расписания затухания LR — результат настройки расписания в зависимости от качества на валидации
«по ходу дела»:
- Запускается одно обучение с каким-нибудь простым затуханием LR (или постоянным learning rate).
- Обучение идёт, пока качество не перестаёт расти. Тогда обучение ставят на паузу и продолжают с этой точки, возможно, с более крутым затуханием LR (или меньшим постоянным learning rate). Процесс повторяется до дедлайна конференции или запуска.
- Бездумно копировать получившееся расписание обычно плохая идея: лучшее конкретное расписание чувствительно к массе
других выборов гиперпараметров.
- Лучше копировать алгоритм, который породил расписание, но это редко возможно, если расписание порождено произвольным человеческим суждением.
- Такое расписание, зависящее от ошибки на валидации, можно использовать, если оно полностью автоматизировано, но
расписания с человеком в цикле, зависящие от ошибки на валидации, хрупки и плохо воспроизводимы, поэтому мы советуем их
избегать.
- Прежде чем публиковать результаты, полученные с таким расписанием, постарайтесь сделать его полностью воспроизводимым.
Как подбирать гиперпараметры Adam?
Заголовок раздела «Как подбирать гиперпараметры Adam?»- Как говорилось выше, делать общие утверждения о пространствах поиска и о том, сколько точек из них выбирать, очень
трудно. Заметим, что не все гиперпараметры Adam одинаково важны. Следующие практические правила соответствуют разным
«бюджетам» — числу испытаний в исследовании.
- Если испытаний в исследовании меньше 10, настраивайте только (базовый) learning rate.
- Если 10–25 испытаний — learning rate и .
- Если больше 25 испытаний — learning rate, и .
- Если можно провести существенно больше 25 испытаний, настраивайте дополнительно .
Почему на этапе исследования квазислучайный поиск, а не более сложные алгоритмы оптимизации чёрного ящика?
Заголовок раздела «Почему на этапе исследования квазислучайный поиск, а не более сложные алгоритмы оптимизации чёрного ящика?»- Квазислучайный поиск (на основе последовательностей с низким расхождением, low-discrepancy sequences) мы предпочитаем более изощрённым инструментам оптимизации чёрного ящика, когда он используется в итеративном процессе настройки, цель которого — максимально углубить понимание задачи настройки (это мы называем «этапом исследования»). Байесовская оптимизация и похожие инструменты больше подходят для этапа использования.
- Квазислучайный поиск на основе случайно сдвинутых последовательностей с низким расхождением можно представить как «поиск по сетке с дрожанием и перемешиванием»: он равномерно, но случайно исследует заданное пространство поиска и раскладывает точки поиска равномернее, чем случайный поиск.
- Преимущества квазислучайного поиска перед более изощрёнными инструментами оптимизации чёрного ящика (например,
байесовской оптимизацией, эволюционными алгоритмами):
- Неадаптивная выборка пространства поиска позволяет менять цель настройки при анализе задним числом, не перезапуская
эксперименты.
- Например, обычно мы хотим найти лучшее испытание по ошибке на валидации, достигнутой в любой момент обучения. Но неадаптивность квазислучайного поиска позволяет найти лучшее испытание по итоговой ошибке на валидации, ошибке на обучении или какой-то другой метрике оценки, не перезапуская ни одного эксперимента.
- Квазислучайный поиск ведёт себя последовательно и статистически воспроизводимо.
- Исследование полугодовой давности должно воспроизводиться, даже если реализация алгоритма поиска изменилась, — при условии, что сохранились те же свойства равномерности. В изощрённой программе байесовской оптимизации реализация может существенно измениться между версиями, и воспроизвести старый поиск будет гораздо труднее. Откатиться к старой реализации не всегда возможно (например, если инструмент оптимизации работает как сервис).
- Равномерное исследование пространства поиска упрощает рассуждения о результатах и о том, что они говорят
о пространстве поиска.
- Например, если лучшая точка квазислучайного поиска лежит на границе пространства поиска, это хороший (хотя и не железный) сигнал, что границы пространства поиска нужно изменить. Этот раздел разбирает это подробнее. А адаптивный алгоритм оптимизации чёрного ящика мог забросить середину пространства поиска из-за нескольких неудачных ранних испытаний, даже если там есть столь же хорошие точки: именно такая неравномерность и нужна хорошему алгоритму оптимизации, чтобы ускорить поиск.
- При квазислучайном поиске (и других неадаптивных алгоритмах поиска), в отличие от адаптивных алгоритмов, запуск разного числа испытаний параллельно или последовательно не даёт статистически разных результатов.
- Более изощрённые алгоритмы поиска не всегда правильно обрабатывают невыполнимые точки, особенно если их создавали не с расчётом на подбор гиперпараметров нейросетей.
- Квазислучайный поиск прост и особенно хорошо работает, когда много испытаний настройки идут параллельно.
- По нашему опыту¹, адаптивному алгоритму очень трудно обыграть квазислучайный поиск с вдвое большим бюджетом, особенно когда много испытаний нужно запускать параллельно (и потому почти нет возможности использовать результаты прошлых испытаний при запуске новых).
- Без опыта в байесовской оптимизации и других продвинутых методах оптимизации чёрного ящика мы можем не получить тех преимуществ, которые они в принципе способны дать. Трудно сравнивать продвинутые алгоритмы оптимизации чёрного ящика в реалистичных условиях настройки глубокого обучения. Это очень активная область исследований, и у более изощрённых алгоритмов свои подводные камни для неопытных пользователей. Эксперты в этих методах получают хорошие результаты, но при большом параллелизме пространство поиска и бюджет обычно значат гораздо больше.
- Неадаптивная выборка пространства поиска позволяет менять цель настройки при анализе задним числом, не перезапуская
эксперименты.
- И всё же, если вычислительные ресурсы позволяют запускать параллельно лишь немного испытаний, а последовательно можно провести много, байесовская оптимизация становится гораздо привлекательнее, хотя и затрудняет интерпретацию результатов настройки.
¹ Бен Рехт и Кевин Джеймисон отметили, насколько сильна как базовый уровень случайная выборка с вдвое большим бюджетом (похожие доводы приводит статья о Hyperband), но, конечно, можно найти пространства поиска и задачи, где современные методы байесовской оптимизации разносят случайный поиск с вдвое большим бюджетом. Однако по нашему опыту обыграть случайный поиск с вдвое большим бюджетом гораздо труднее в режиме большого параллелизма, поскольку у байесовской оптимизации нет возможности увидеть результаты предыдущих испытаний.
Где найти реализацию квазислучайного поиска?
Заголовок раздела «Где найти реализацию квазислучайного поиска?»- В Open-Source Vizier есть
реализация квазислучайного поиска.
Задайте
algorithm="QUASI_RANDOM_SEARCH"в этом примере использования. - Альтернативная реализация есть здесь.
- Обе реализации порождают для заданного пространства поиска последовательность Холтона (Halton sequence) — задуманную как сдвинутая и перемешанная последовательность Холтона, как рекомендуется в https://arxiv.org/abs/1706.03200.
- Если алгоритма квазислучайного поиска на основе последовательности с низким расхождением нет под рукой, можно заменить
его псевдослучайным равномерным поиском, хотя он, вероятно, будет чуть менее эффективен.
- В 1–2 измерениях приемлем и поиск по сетке, но не в больших размерностях (см. Bergstra & Bengio, 2012).
# Примечание переводчика: квазислучайный поиск через SciPy (последовательность Холтона).from scipy.stats import qmc
sampler = qmc.Halton(d=2, scramble=True, seed=0)      # 2 гиперпараметраu = sampler.random(n=16)                               # 16 точек в [0, 1)^2# Переводим в логарифмические диапазоны: lr ∈ [1e-4, 1e-2], weight decay ∈ [1e-5, 1e-1].lo, hi = [-4, -5], [-2, -1]points = 10 ** qmc.scale(u, lo, hi)for lr, wd in points:    print(f"lr={lr:.2e}  weight_decay={wd:.2e}")
Сколько испытаний нужно, чтобы получить хорошие результаты квазислучайным поиском?
Заголовок раздела «Сколько испытаний нужно, чтобы получить хорошие результаты квазислучайным поиском?»Рисунок 3 в оригинале (have_we_sampled_enough.png): ResNet-50 настраивали на ImageNet в 100 испытаниях. Бутстрепом смоделировали разные бюджеты настройки и для каждого бюджета построили «ящики с усами» лучших результатов. При бюджете в 6 испытаний ящики очень широкие, к 20 испытаниям заметно сужаются.

- Ответить на этот вопрос в общем виде нельзя, но можно посмотреть на конкретные примеры.
- Как показывает рисунок 3, число испытаний в исследовании может существенно влиять на результаты.
- Обратите внимание, насколько велики межквартильные размахи при 6 испытаниях по сравнению с 20.
- Даже при 20 испытаниях разница между особенно удачными и неудачными исследованиями, вероятно, будет больше, чем типичный разброс между повторными обучениями этой модели с разными случайными зёрнами при фиксированных гиперпараметрах, — а он для этой задачи составляет примерно ±0,1% при доле ошибок на валидации около 23%.
Как отлаживать сбои оптимизации и бороться с ними?
Заголовок раздела «Как отлаживать сбои оптимизации и бороться с ними?»Коротко: если у модели трудности с оптимизацией, важно исправить их прежде, чем пробовать что-то другое. Диагностика и исправление сбоев обучения — активная область исследований.
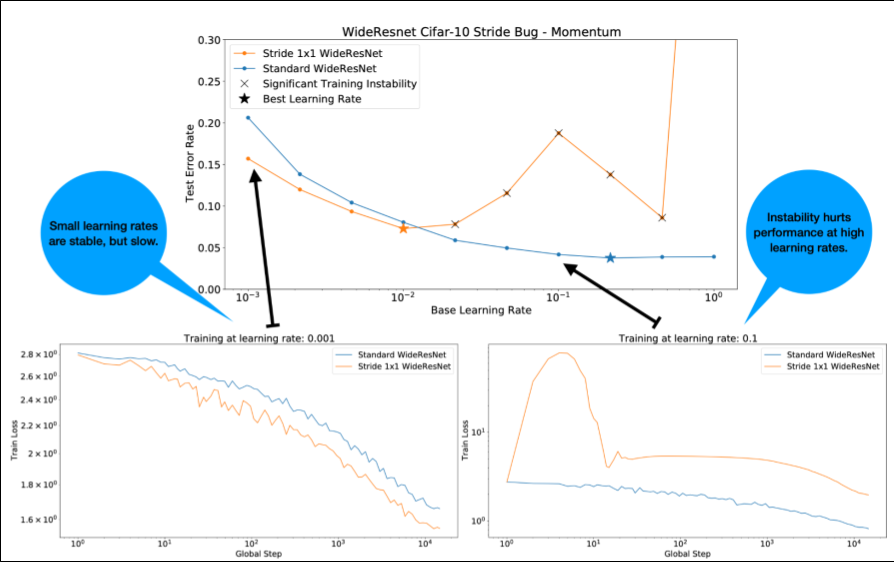
Рисунок 4 в оригинале (stride_instability.png): изменение шага свёртки (stride) в одном остаточном блоке WideResNet (2×2 → 1×1) делает обучение неустойчивым. При малых learning rate качество не страдает, но большие learning rate из-за неустойчивости больше не обучаются. 1000 шагов разогрева learning rate устраняют этот конкретный случай неустойчивости и позволяют устойчиво обучаться с максимальным learning rate 0,1.
Как распознать неустойчивую задачу
Заголовок раздела «Как распознать неустойчивую задачу»- Любая задача станет неустойчивой, если learning rate слишком велик. Неустойчивость — проблема лишь тогда, когда из-за неё приходится брать слишком маленький learning rate.
- Стоит различать как минимум два типа неустойчивости обучения:
- неустойчивость при инициализации или в начале обучения;
- внезапная неустойчивость в середине обучения.
- Проблемы устойчивости в задаче можно искать систематически:
- Переберите learning rate и найдите лучший — lr*.
- Постройте кривые потерь на обучении для learning rate чуть выше lr*.
- Если при learning rate больше lr* потери неустойчивы (в какие-то периоды обучения растут, а не падают), то, вероятно, исправление неустойчивости улучшит обучение.
- Записывайте во время обучения L2-норму полного градиента функции потерь: выбросы могут давать ложную неустойчивость в середине обучения. Это поможет выбрать обрезку градиента или обновления.
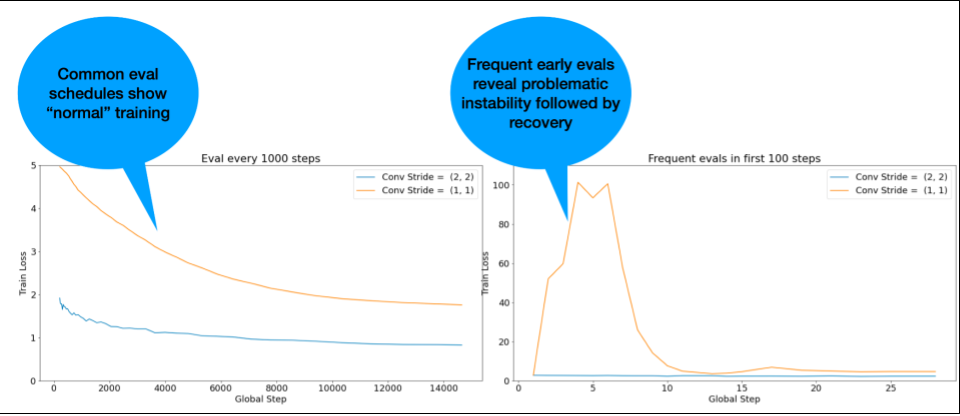
ВНИМАНИЕ: у некоторых моделей бывает очень ранняя неустойчивость, после которой они восстанавливаются, и обучение идёт медленно, но устойчиво. Типичные расписания оценки могут не заметить таких проблем, если оценка проводится недостаточно часто!
Чтобы проверить это, можно провести укороченный запуск всего на ~500 шагов с lr = 2 * текущий лучший, но оценивать
на каждом шаге.
Рисунок 5 в оригинале (more_frequent_evals.png): иллюстрирует ценность более частых оценок в начале обучения — при редкой оценке ранний всплеск потерь не виден, при оценке на каждом шаге он заметен. Полезно, если есть подозрение, что модель страдает от неустойчивости в начале обучения.
Возможные исправления типичных неустойчивостей
Заголовок раздела «Возможные исправления типичных неустойчивостей»- Примените разогрев learning rate.
- Лучше всего — при неустойчивости в начале обучения.
- Примените обрезку градиента.
- Хороша и при ранней, и при поздней неустойчивости; может исправить некоторые плохие инициализации, с которыми не справляется разогрев.
- Попробуйте другой оптимизатор.
- Иногда Adam справляется с неустойчивостью, с которой не справляется Momentum. Это активная область исследований.
- Можно убедиться, что используются лучшие практики и инициализации для данной архитектуры (примеры ниже).
- Добавьте остаточные связи и нормализацию, если их ещё нет в модели.
- Нормализация должна быть внутри остаточной ветви, например
x + f(Norm(x)). - Известно, что
Norm(x + f(x))создаёт проблемы. - Попробуйте инициализировать остаточные ветви нулём (например, инициализация ReZero).
- Уменьшите learning rate.
- Это крайняя мера.
Разогрев learning rate
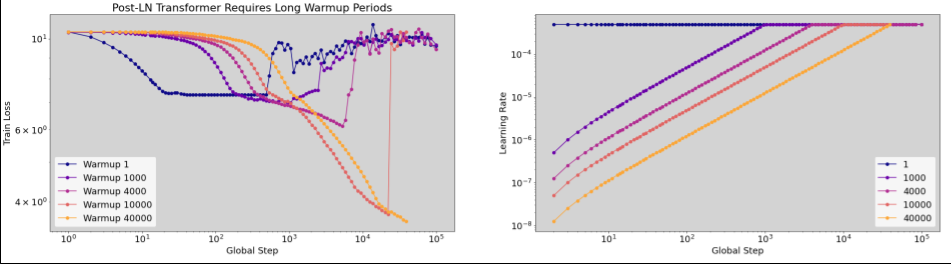
Заголовок раздела «Разогрев learning rate»Рисунок 6 в оригинале (instability_during_warmup.png): пример неустойчивости в период разогрева (обратите внимание: горизонтальная ось логарифмическая). В этом случае для успешного обучения понадобилось 40 тысяч шагов разогрева.
Когда применять разогрев
Заголовок раздела «Когда применять разогрев»Рисунок 7a в оригинале (axis_model_with_instability.png): пример графика по оси гиперпараметра для модели с неустойчивым обучением. Лучший learning rate — на краю допустимого. «Невыполнимым» считается испытание, которое даёт NaN или нехарактерно большие значения потерь.
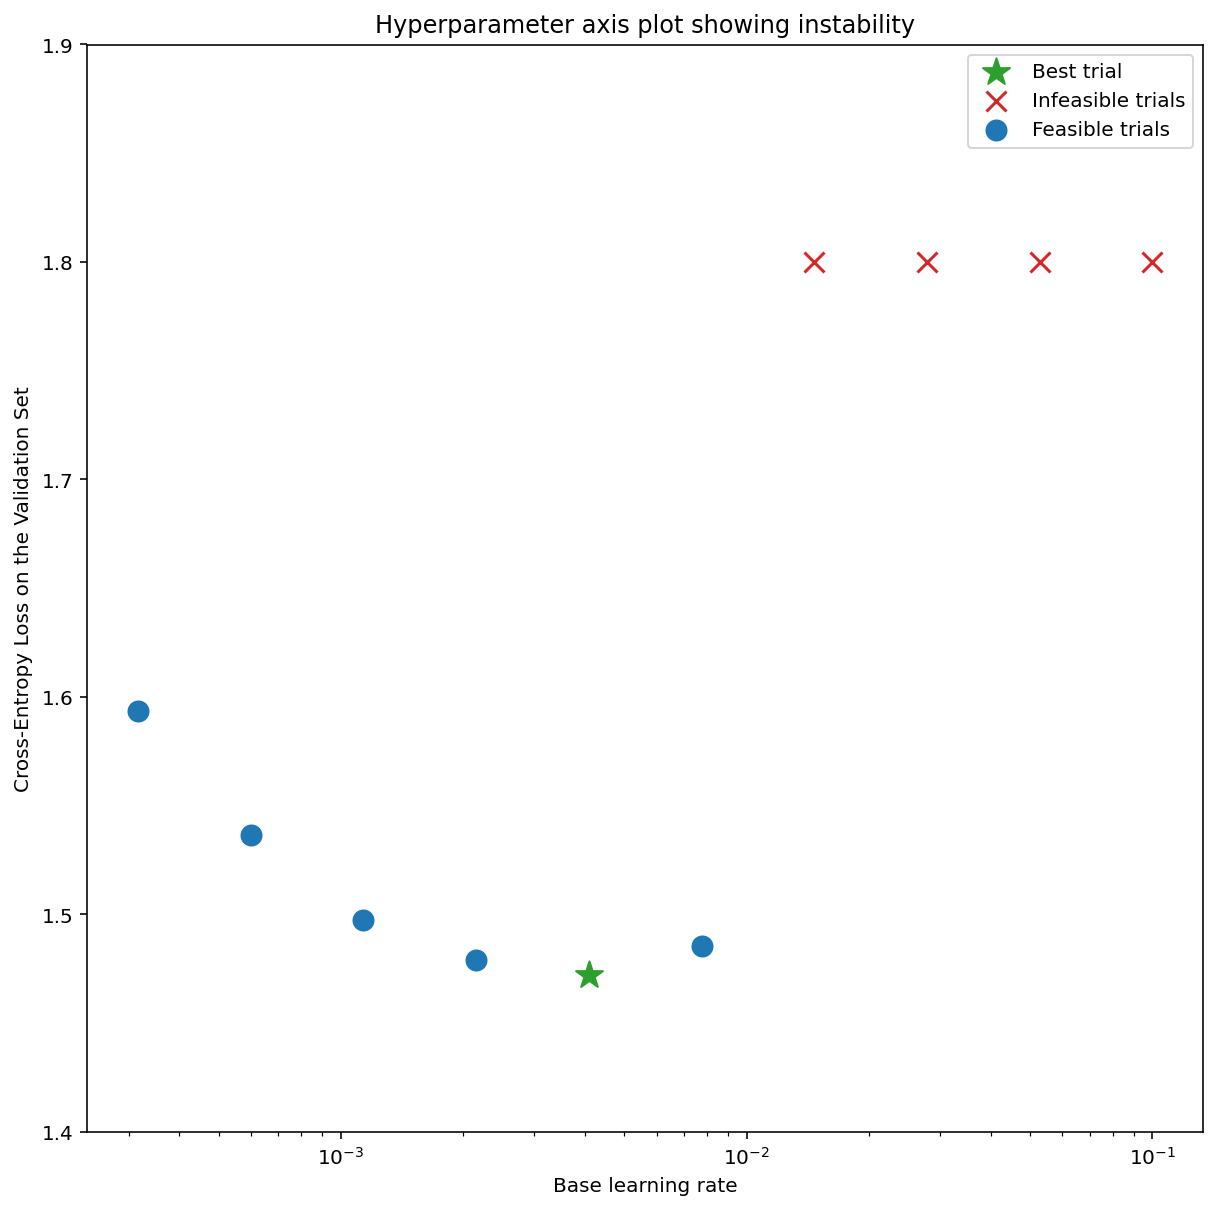
Рисунок 7b в оригинале (loss_model_with_instability.png): потери на обучении модели, обученной с learning rate, при котором видна неустойчивость.
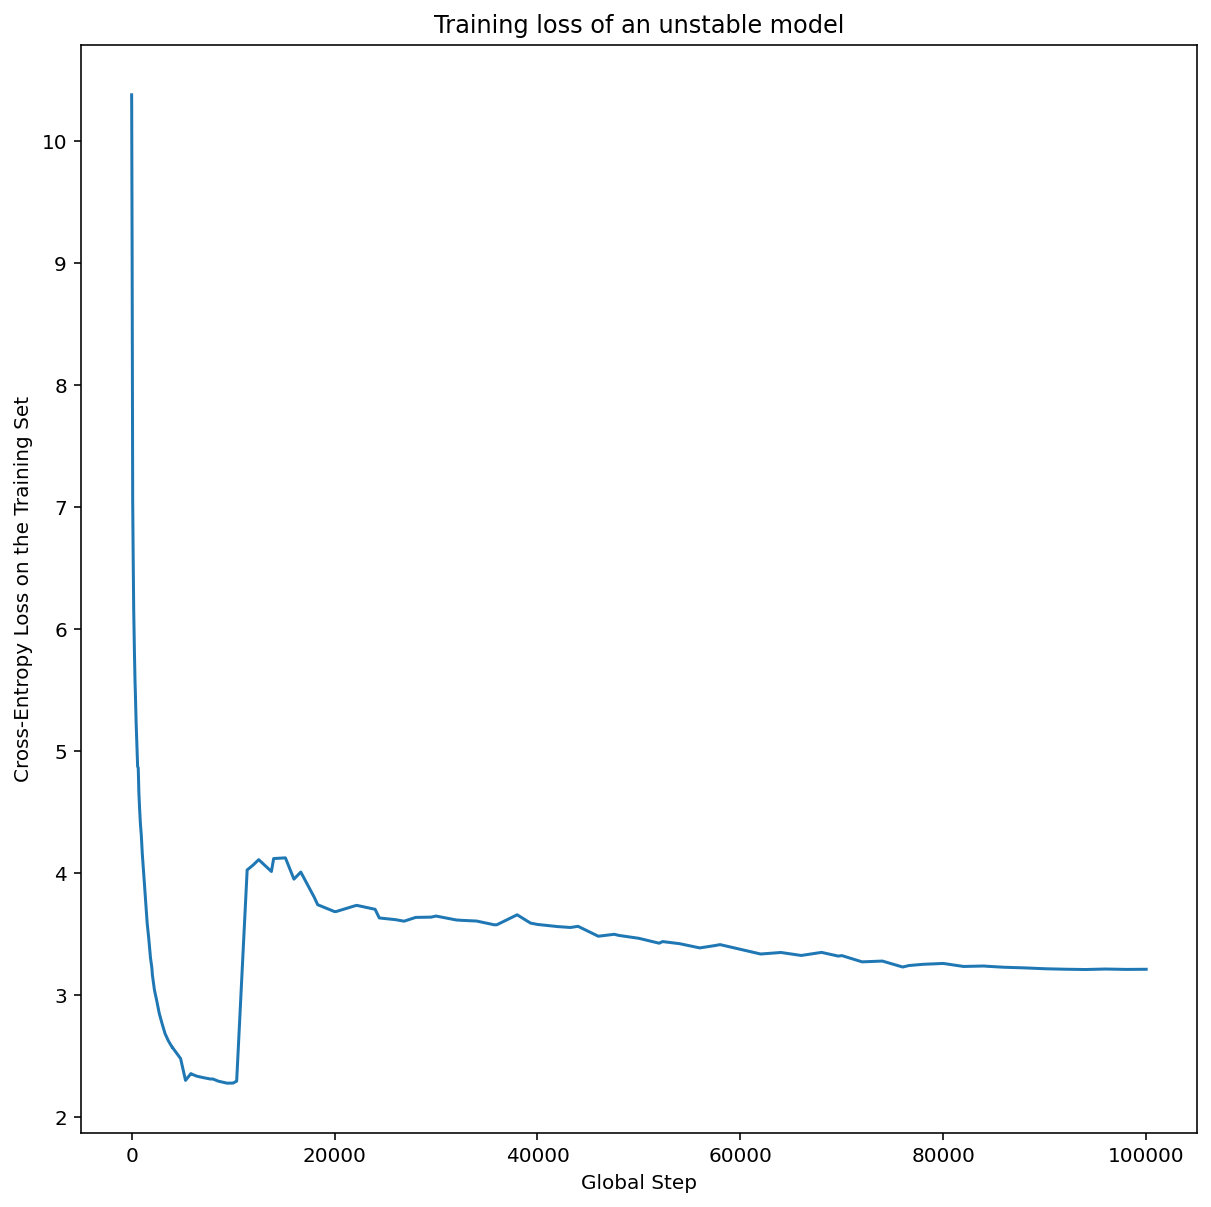
- Рисунок 7a показывает график по оси гиперпараметра, указывающий на неустойчивость оптимизации: лучший learning rate находится прямо на границе неустойчивости.
- Рисунок 7b показывает, как это перепроверить: посмотреть на потери на обучении модели, обученной с learning rate в 5 или 10 раз больше этого пика. Если на графике после устойчивого спада потери внезапно растут (например, на рисунке — около шага 10 тысяч), то модель, вероятно, страдает от неустойчивости оптимизации.
Как применять разогрев
Заголовок раздела «Как применять разогрев»Рисунок 8 в оригинале (beneficial_effect_warmup.png): полезное действие разогрева learning rate на неустойчивость обучения.
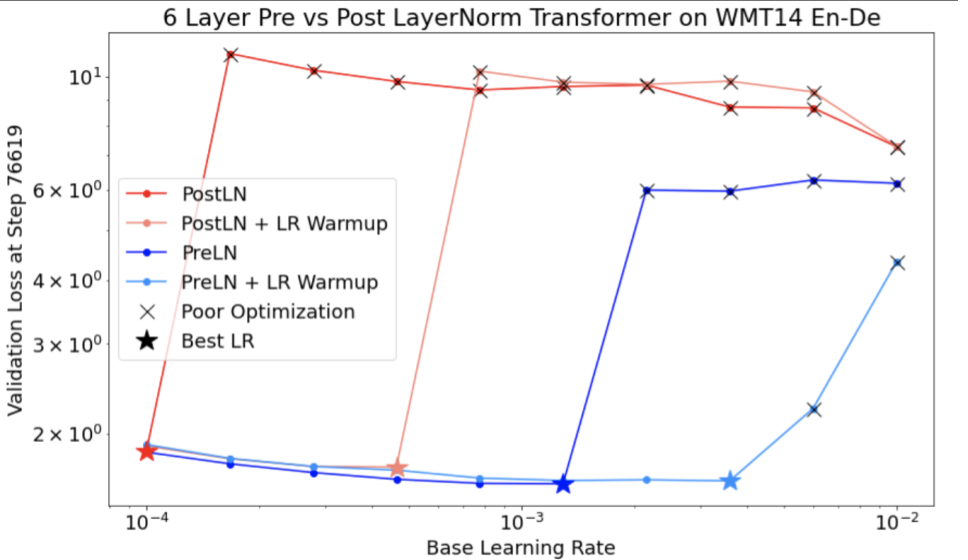
- Опираясь на раздел выше, считаем, что практик уже нашёл learning rate, при котором модель становится неустойчивой. Это
unstable_base_learning_rate. - Разогрев — это расписание learning rate, добавленное в начало, которое поднимает learning rate от 0 до некоторого
устойчивого
base_learning_rate, хотя бы на порядок большего, чемunstable_base_learning_rate. По умолчанию стоит попробоватьbase_learning_rate, в 10 раз большийunstable_base_learning_rate. Впрочем, всю процедуру можно повторить и для чего-то вроде 100×unstable_base_learning_rate. Конкретное расписание:- подъём от 0 до
base_learning_rateзаwarmup_stepsшагов; - обучение с постоянной скоростью
post_warmup_stepsшагов.
- подъём от 0 до
- Наша цель — найти наименьшее
warmup_steps, позволяющее выйти на пиковые learning rate, намного большиеunstable_base_learning_rate. - Значит, для каждого
base_learning_rateнужно настроитьwarmup_stepsиpost_warmup_steps. Обычно можно положитьpost_warmup_stepsравным2*warmup_steps. - Разогрев можно настраивать независимо от существующего расписания затухания.
warmup_stepsстоит перебирать по нескольким порядкам величины. Например, исследование может попробовать [10, 10³, 10⁴, 10⁵]. Наибольшая выполнимая точка не должна превышать 10%max_train_steps. - Когда найдено
warmup_steps, при котором обучение сbase_learning_rateне «взрывается», его следует применить к базовой модели. По сути, мы добавляем это расписание в начало существующего и с помощью описанного выше оптимального выбора чекпоинта сравниваем этот эксперимент с базовым. Например, если исходно было 10 000max_train_stepsи мы добавили 1000 шагов разогрева, новая процедура обучения должна длиться всего 11 000 шагов. - Если для устойчивого обучения нужен длинный разогрев (больше 5%
max_train_steps), возможно, придётся увеличитьmax_train_steps, чтобы это учесть. - «Типичного» значения для всего многообразия задач на самом деле нет. Некоторым моделям хватает 100 шагов, а другим (особенно трансформерам) может понадобиться 40 тысяч и больше.
Обрезка градиента
Заголовок раздела «Обрезка градиента»Рисунок 9 в оригинале (gradient_clipping.png): иллюстрация того, как обрезка градиента устраняет неустойчивость в начале обучения.
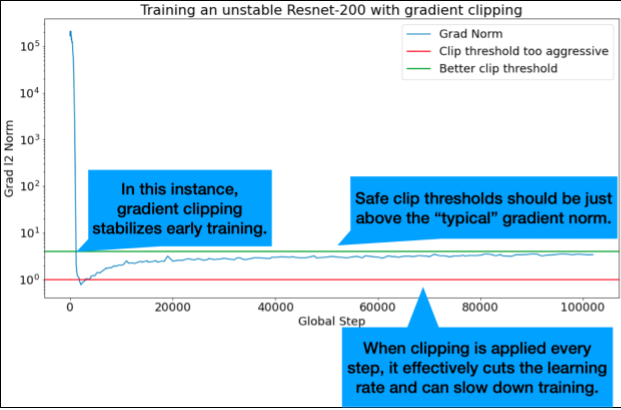
- Обрезка градиента (gradient clipping) полезнее всего, когда возникают проблемы с большими градиентами или выбросами градиента.
- Обрезка может исправить и неустойчивость в начале обучения (большая норма градиента в начале), и неустойчивость в середине обучения (внезапные всплески градиента посреди обучения).
- Иногда более длинный разогрев исправляет неустойчивость, которую обрезка не исправляет: см.
раздел выше.
- 🤖 А как насчёт обрезки во время разогрева?
- Идеальный порог обрезки — чуть выше «типичной» нормы градиента.
- Пример того, как можно делать обрезку градиента:
- если норма градиента больше порога обрезки , то , где — новый градиент. Читается так: градиент сохраняет направление, а его длина становится равной порогу.
- Записывайте во время обучения норму градиента до обрезки. По умолчанию стройте:
- график нормы градиента от шага;
- гистограмму норм градиента по всем шагам.
- Выбирайте порог обрезки градиента по 90-му перцентилю норм градиента.
- Порог зависит от задачи, но 90% — хорошая отправная точка. Если не сработает, порог можно настроить.
- 🤖 А как насчёт какой-нибудь адаптивной стратегии?
- Если обрезка градиента не устранила проблемы неустойчивости, можно усилить её (то есть уменьшить порог).
- Чрезвычайно агрессивная обрезка градиента — по сути странный способ уменьшить learning rate. Если оказалось, что обрезка чрезвычайно агрессивная, вероятно, проще уменьшить learning rate.
- Обычно мы считаем «чрезвычайно агрессивной» ситуацию, когда обрезается больше 50% обновлений.
- Если для борьбы с неустойчивостью нужна чрезвычайно агрессивная обрезка градиента, можно с тем же успехом уменьшить learning rate.
# Примечание переводчика: журнал норм градиента и порог по 90-му перцентилю в PyTorch.import torch
norms = []# ... в цикле обучения, после loss.backward():#     total = torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=float("inf"))#     norms.append(total.item())          # с max_norm=inf функция ничего не обрезает, только считает норму# После нескольких сотен шагов:#     threshold = torch.quantile(torch.tensor(norms), 0.9).item()#     ... и дальше: torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=threshold)#     доля обрезанных шагов = (torch.tensor(norms) > threshold).float().mean() — держите её заметно ниже 50%
Почему learning rate и другие параметры оптимизации называют гиперпараметрами? Они же не параметры никакого априорного распределения.
Заголовок раздела «Почему learning rate и другие параметры оптимизации называют гиперпараметрами? Они же не параметры никакого априорного распределения.»- Действительно, у термина «гиперпараметр» есть точный смысл в байесовском машинном обучении, и называть learning rate и большинство других настраиваемых в глубоком обучении параметров «гиперпараметрами» — злоупотребление терминологией.
- Мы бы предпочли термин «метапараметр» для learning rate, параметров архитектуры и всего остального, что настраивается в глубоком обучении: так не возникает путаницы от неправильного употребления слова «гиперпараметр» (путаница особенно вероятна при обсуждении байесовской оптимизации, где у вероятностных моделей поверхности отклика есть собственные настоящие гиперпараметры).
- К сожалению, хотя термин «гиперпараметр» и может путать, он стал чрезвычайно распространён в сообществе глубокого обучения.
- Поэтому в документе вроде этого, рассчитанном на широкую аудиторию, где многие вряд ли знают эту тонкость, мы решили поддержать один источник путаницы в надежде избежать другого.
- Впрочем, в научной статье мы могли бы поступить иначе и советуем другим в большинстве контекстов использовать «метапараметр».
Почему размер батча не стоит подбирать ради качества на валидации?
Заголовок раздела «Почему размер батча не стоит подбирать ради качества на валидации?»- Изменение размера батча без изменения каких-либо других деталей конвейера обучения часто влияет на качество на валидационной выборке.
- Однако разница в качестве на валидации между двумя размерами батча обычно исчезает, если конвейер обучения оптимизировать отдельно для каждого размера батча.
- Сильнее всего с размером батча взаимодействуют — и поэтому важнее всего настраиваются отдельно для каждого размера —
гиперпараметры оптимизатора (например, learning rate, момент) и гиперпараметры регуляризации.
- Меньшие батчи вносят в алгоритм обучения больше шума из-за разброса выборки, и этот шум может действовать как регуляризатор. Поэтому большие батчи могут быть более склонны к переобучению и требовать более сильной регуляризации и (или) дополнительных приёмов регуляризации.
- Кроме того, при смене размера батча может понадобиться изменить число шагов обучения.
- С учётом всех этих эффектов сейчас нет убедительных доказательств того, что размер батча влияет на максимально достижимое качество на валидации (см. Shallue et al. 2018).
Каковы правила обновления популярных алгоритмов оптимизации?
Заголовок раздела «Каковы правила обновления популярных алгоритмов оптимизации?»Обозначения: — параметры на шаге , — градиент функции потерь, и — learning rate на шаге , , , , — коэффициенты затухания скользящих средних, — маленькая добавка против деления на ноль. (Пояснение переводчика.)
Стохастический градиентный спуск (SGD)
Заголовок раздела «Стохастический градиентный спуск (SGD)»Шаг против градиента, длина шага — learning rate.
Momentum
Заголовок раздела «Momentum»— «скорость»: накопленная с затуханием сумма прошлых градиентов.
Нестеров
Заголовок раздела «Нестеров»Шаг делается так, будто мы «заглянули вперёд» по направлению скорости.
RMSProp
Заголовок раздела «RMSProp»— скользящее среднее квадратов градиента: шаг делится на «типичный размер» градиента по каждой координате.
— скользящее среднее градиента (момент), — его квадрата, — поправка смещения: в первые шаги и занижены, потому что стартуют с нуля.
Adam с «заглядыванием вперёд» Нестерова.
Благодарности
Заголовок раздела «Благодарности»- Мы в долгу перед Максом Билески, Роем Фростигом, Зельдой Марие, Стэном Билески, Мохаммадом Норузи, Крисом Дюбуа и Чарльзом Саттоном, которые прочитали рукопись и дали ценные отзывы.
- Для нескольких графиков мы повторно использовали экспериментальные данные, исходно полученные Наманом Агарвалом для другого совместного исследования.
- Благодарим Уилла Чена за бесценные советы по оформлению документа.
- Благодарим также Рохана Анила за полезные обсуждения.
Как цитировать
Заголовок раздела «Как цитировать»@misc{tuningplaybookgithub, author = {Varun Godbole and George E. Dahl and Justin Gilmer and Christopher J. Shallue and Zachary Nado}, title = {Deep Learning Tuning Playbook}, url = {http://github.com/google-research/tuning_playbook}, year = {2023}, note = {Version 1.0}}Разделы оригинала «Contributing» (как предлагать изменения через GitHub, соглашение CLA, правила сообщества Google) не переведены — они относятся к участию в репозитории, а не к содержанию руководства.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| compute-bound / not compute-bound | ограниченный / не ограниченный вычислениями |
max_train_steps | максимальное число шагов обучения |
| learning rate sweep | перебор learning rate |
| production length | рабочая длина (запуска) |
| learning rate decay (linear, cosine) | затухание learning rate (линейное, косинусное) |
| warmup | разогрев |
| input-bound pipeline | конвейер, упирающийся во входные данные |
| prefetching | предзагрузка |
| online / offline / periodic evaluation | онлайн- / офлайн- / периодическая оценка |
| retrospective optimal checkpoint selection | оптимальный выбор чекпоинта задним числом |
| experiment tracking | учёт экспериментов |
| ghost batch norm | «призрачная» батч-нормализация |
| multi-host | многохостовый |
| RNG seed | зерно генератора случайных чисел |
| low-discrepancy sequence, Halton sequence | последовательность с низким расхождением, последовательность Холтона |
| training instability | неустойчивость обучения |
| gradient clipping | обрезка градиента |
| metaparameter | метапараметр |
| update rule | правило обновления |