Deep Learning Tuning Playbook, часть 2: научный подход к улучшению модели
Перевод центральной части руководства Google Research: пошаговая стратегия настройки, исследование против использования, научные, мешающие и фиксированные гиперпараметры, кривые обучения, графики изоляции и решение, принимать ли изменение.
Вторая из трёх частей перевода Deep Learning Tuning Playbook. Это сердце документа: как организовать работу над моделью так, чтобы каждое изменение было обосновано, а не случайно «повезло». Дальше — часть 3: длительность обучения, конвейер и частые вопросы.
Научный подход к улучшению качества модели
Заголовок раздела «Научный подход к улучшению качества модели»В рамках этого документа конечная цель разработки в машинном обучении — максимизировать полезность развёрнутой модели. Хотя многие стороны процесса разработки различаются от задачи к задаче (например, сроки, доступные вычислительные ресурсы, тип модели), обычно на любой задаче можно использовать одни и те же основные шаги и принципы.
Наши советы ниже исходят из следующих предположений:
- Уже есть полностью работающий конвейер обучения и конфигурация, которая даёт разумный результат.
- Вычислительных ресурсов достаточно, чтобы проводить осмысленные эксперименты по настройке и запускать хотя бы несколько заданий обучения параллельно.
Стратегия пошаговой настройки
Заголовок раздела «Стратегия пошаговой настройки»Коротко: начните с простой конфигурации и постепенно улучшайте её, накапливая понимание задачи. Следите, чтобы любое улучшение опиралось на весомые доказательства, — так вы не добавите ненужной сложности.
- Наша конечная цель — найти конфигурацию, которая даёт максимальное качество модели.
- Иногда цель — максимально улучшить модель к фиксированному сроку (например, к сдаче на соревнование).
- В других случаях мы хотим улучшать модель бесконечно (например, постоянно совершенствуя модель, работающую в продакшене).
- В принципе, можно было бы максимизировать качество, поручив алгоритму автоматически перебирать всё пространство
возможных конфигураций, но на практике это невозможно.
- Пространство возможных конфигураций огромно, и пока нет алгоритмов настолько изощрённых, чтобы эффективно искать в нём без подсказок человека.
- Большинство алгоритмов автоматического поиска опираются на составленное вручную пространство поиска (search space) — множество конфигураций, среди которых ищут, — и от этого пространства многое зависит.
- Самый эффективный способ максимизировать качество — начать с простой конфигурации и постепенно добавлять возможности
и улучшения, накапливая понимание задачи.
- В каждом раунде настройки мы используем алгоритмы автоматического поиска и постоянно обновляем пространства поиска по мере роста понимания.
- По ходу исследования мы естественным образом находим всё лучшие конфигурации, и наша «лучшая» модель постоянно
улучшается.
- Обновление лучшей конфигурации мы называем запуском (launch) — оно может соответствовать, а может и не соответствовать реальному выпуску модели в продакшен.
- Для каждого запуска нужно убедиться, что изменение опирается на весомые доказательства, а не на случайность удачной конфигурации, — чтобы не добавлять в конвейер обучения ненужной сложности.
В общих чертах наша стратегия пошаговой настройки — это повторение четырёх шагов:
- Сформулировать цель следующего раунда экспериментов подходящего масштаба.
- Спланировать и провести набор экспериментов, который продвигает к этой цели.
- Извлечь из результатов всё, что можно.
- Решить, запускать ли новую лучшую конфигурацию.
Дальше в этом разделе стратегия разобрана гораздо подробнее.
flowchart LR
A["1. Цель раунда"] --> B["2. Спланировать и провести эксперименты"]
B --> C["3. Извлечь выводы"]
C --> D{"4. Запускать новую конфигурацию?"}
D -->|"да: новая база"| A
D -->|"нет"| AИсследование против использования
Заголовок раздела «Исследование против использования»Коротко: большую часть времени наша главная цель — лучше понять задачу.
- Можно подумать, что большую часть времени мы пытаемся максимизировать качество на валидационной выборке, но на практике
мы тратим основное время на то, чтобы лучше понять задачу, и сравнительно мало — на жадную погоню за ошибкой на
валидации.
- Иначе говоря, большую часть времени мы тратим на «исследование» (exploration) и лишь немного — на «использование» (exploitation).
- В долгосрочной перспективе понимание задачи критически важно, если мы хотим максимизировать итоговое качество.
Приоритет понимания над краткосрочными выигрышами помогает:
- не запускать ненужные изменения, которые оказались в удачных запусках лишь по историческому стечению обстоятельств;
- понять, к каким гиперпараметрам ошибка на валидации чувствительнее всего, какие гиперпараметры сильнее всего взаимодействуют и поэтому должны настраиваться заново вместе, а какие относительно нечувствительны к другим изменениям и потому могут быть зафиксированы в будущих экспериментах;
- подсказать новые возможности, которые стоит попробовать, например новые регуляризаторы, если мешает переобучение;
- найти возможности, которые не помогают и потому могут быть удалены, — это упрощает будущие эксперименты;
- распознать момент, когда улучшения от подбора гиперпараметров, скорее всего, исчерпались;
- сузить пространства поиска вокруг оптимального значения и повысить эффективность настройки.
- Когда мы в конце концов будем готовы действовать жадно, можно сосредоточиться только на ошибке на валидации, даже если эксперименты не дают максимума сведений о структуре задачи настройки.
Выбор цели следующего раунда экспериментов
Заголовок раздела «Выбор цели следующего раунда экспериментов»Коротко: у каждого раунда экспериментов должна быть ясная цель, и он должен быть достаточно узким, чтобы эксперименты действительно продвигали к ней.
- У каждого раунда экспериментов должна быть ясная цель, и он должен быть достаточно узким, чтобы эксперименты действительно продвигали к ней: если пытаться добавить несколько возможностей или ответить на несколько вопросов сразу, может не получиться разделить их влияние на результаты.
- Примеры целей:
- попробовать возможное улучшение конвейера (например, новый регуляризатор, другой вариант предобработки и т. п.);
- понять влияние конкретного гиперпараметра модели (например, функции активации);
- жадно минимизировать ошибку на валидации.
Планирование следующего раунда экспериментов
Заголовок раздела «Планирование следующего раунда экспериментов»Коротко: определите, какие гиперпараметры для цели эксперимента научные, какие мешающие, а какие фиксированные. Создайте последовательность исследований, которые сравнивают разные значения научных гиперпараметров, оптимизируя по мешающим. Выберите пространство поиска мешающих гиперпараметров так, чтобы уравновесить затраты ресурсов и научную ценность.
Научные, мешающие и фиксированные гиперпараметры
Заголовок раздела «Научные, мешающие и фиксированные гиперпараметры»- Для данной цели каждый гиперпараметр будет либо научным (scientific), либо мешающим (nuisance), либо
фиксированным (fixed).
- Научные гиперпараметры — те, чьё влияние на качество модели мы пытаемся измерить.
- Мешающие гиперпараметры — те, по которым нужно оптимизировать, чтобы честно сравнить разные значения научных гиперпараметров. Это похоже на статистическое понятие мешающих параметров.
- Фиксированные гиперпараметры в текущем раунде экспериментов имеют закреплённые значения. Это гиперпараметры,
значения которых не нужно (или мы не хотим) менять при сравнении разных значений научных гиперпараметров.
- Фиксируя часть гиперпараметров в наборе экспериментов, мы должны смириться с тем, что выводы из экспериментов могут оказаться неверными при других значениях фиксированных гиперпараметров. Иначе говоря, фиксированные гиперпараметры добавляют оговорки к любым выводам из экспериментов.
- Например, если цель — «выяснить, уменьшит ли ошибку на валидации модель с большим числом скрытых слоёв», то число
скрытых слоёв — научный гиперпараметр.
- Learning rate — мешающий гиперпараметр: честно сравнить модели с разным числом скрытых слоёв можно, только если learning rate подобран отдельно для каждого числа слоёв (оптимальный learning rate обычно зависит от архитектуры модели).
- Функция активации может быть фиксированным гиперпараметром, если прошлые эксперименты показали, что лучший выбор функции активации не зависит от глубины модели, или если мы согласны ограничить выводы о числе скрытых слоёв только этой конкретной функцией активации. А может быть и мешающим, если мы готовы подбирать её отдельно для каждого числа скрытых слоёв.
- Будет ли конкретный гиперпараметр научным, мешающим или фиксированным, — не его внутреннее свойство: это зависит от цели
эксперимента.
- Например, выбор функции активации может быть научным гиперпараметром (что лучше для нашей задачи — ReLU или tanh?), мешающим (лучше ли лучшая 5-слойная модель лучшей 6-слойной, если разрешить несколько разных функций активации?) или фиксированным (для сетей с ReLU — помогает ли добавить batch normalization в определённое место?).
- Планируя новый раунд экспериментов, мы сначала определяем научные гиперпараметры для цели эксперимента.
- На этом этапе все остальные гиперпараметры мы считаем мешающими.
- Затем часть мешающих гиперпараметров мы превращаем в фиксированные.
- Будь ресурсы безграничны, мы оставили бы все ненаучные гиперпараметры мешающими, чтобы выводы из экспериментов не содержали оговорок о значениях фиксированных гиперпараметров.
- Однако чем больше мешающих гиперпараметров мы пытаемся настроить, тем выше риск настроить их недостаточно хорошо для
каждого значения научных гиперпараметров и прийти к неверным выводам.
- Как описано ниже, этот риск можно уменьшить, увеличив вычислительный бюджет, но часто наш максимальный бюджет меньше, чем нужно для настройки всех ненаучных гиперпараметров.
- Мы превращаем мешающий гиперпараметр в фиксированный, когда, по нашему суждению, оговорки от его фиксации менее
обременительны, чем затраты на то, чтобы включить его в число мешающих.
- Чем сильнее мешающий гиперпараметр взаимодействует с научными, тем вреднее фиксировать его значение. Например, лучшая сила затухания весов (weight decay) обычно зависит от размера модели, поэтому сравнивать модели разного размера при одном конкретном значении weight decay не слишком информативно.
- Хотя тип каждого гиперпараметра зависит от цели эксперимента, для некоторых категорий гиперпараметров есть
практические правила:
- Из разных гиперпараметров оптимизатора (например, learning rate, момент, параметры расписания learning rate,
beta в Adam и т. д.) хотя бы часть будет мешающими, потому что они сильнее всего взаимодействуют с другими
изменениями.
- Научными они бывают редко: цель вроде «какой learning rate лучше всего для текущего конвейера?» мало что проясняет — лучшее значение легко может измениться со следующим же изменением конвейера.
- Хотя иногда мы фиксируем часть из них из-за ограничений ресурсов или когда есть особенно весомые доказательства,
что они не взаимодействуют с научными параметрами, в общем случае следует считать, что гиперпараметры
оптимизатора нужно настраивать отдельно, чтобы честно сравнивать разные значения научных гиперпараметров, и потому
фиксировать их не следует.
- Кроме того, у нас нет априорных причин предпочитать одно значение гиперпараметра оптимизатора другому (например, обычно они никак не влияют на вычислительную стоимость прямого прохода или градиентов).
- Напротив, выбор оптимизатора обычно научный или фиксированный гиперпараметр.
- Научный — если цель эксперимента включает честное сравнение двух или более оптимизаторов (например, «выяснить, какой оптимизатор даёт наименьшую ошибку на валидации за заданное число шагов»).
- Фиксированным его можно сделать по разным причинам, в том числе: (1) прошлые эксперименты убеждают нас, что лучший оптимизатор для нашей задачи не зависит от текущих научных гиперпараметров; и/или (2) мы предпочитаем сравнивать значения научных гиперпараметров с этим оптимизатором, потому что его кривые обучения легче анализировать; и/или (3) мы предпочитаем этот оптимизатор, потому что он занимает меньше памяти, чем альтернативы.
- Гиперпараметры, которые вводит приём регуляризации, обычно мешающие, но использовать ли сам приём регуляризации —
научный или фиксированный гиперпараметр.
- Например, dropout усложняет код, поэтому, решая, включать ли его, мы сделаем «без dropout» против «с dropout»
научным гиперпараметром, а долю dropout (dropout rate) — мешающим.
- Если по итогам такого эксперимента мы решим добавить dropout в конвейер, то в будущих экспериментах доля dropout станет мешающим гиперпараметром.
- Например, dropout усложняет код, поэтому, решая, включать ли его, мы сделаем «без dropout» против «с dropout»
научным гиперпараметром, а долю dropout (dropout rate) — мешающим.
- Гиперпараметры архитектуры часто научные или фиксированные, потому что изменения архитектуры влияют на стоимость
обслуживания и обучения, задержку и требования к памяти.
- Например, число слоёв обычно научный или фиксированный гиперпараметр: оно, как правило, резко влияет на скорость обучения и расход памяти.
- Из разных гиперпараметров оптимизатора (например, learning rate, момент, параметры расписания learning rate,
beta в Adam и т. д.) хотя бы часть будет мешающими, потому что они сильнее всего взаимодействуют с другими
изменениями.
- Иногда наборы мешающих и фиксированных гиперпараметров зависят от значений научных гиперпараметров.
- Например, мы хотим выяснить, какой из оптимизаторов — момент Нестерова или Adam — даёт наименьшую ошибку на валидации.
Научный гиперпараметр —
optimizer, принимающий значения{"Nesterov_momentum", "Adam"}. Значениеoptimizer="Nesterov_momentum"вводит мешающие/фиксированные гиперпараметры{learning_rate, momentum}, а значениеoptimizer="Adam"— мешающие/фиксированные гиперпараметры{learning_rate, beta1, beta2, epsilon}. - Гиперпараметры, которые есть только при определённых значениях научных гиперпараметров, называют условными (conditional hyperparameters).
- Не стоит считать два условных гиперпараметра одинаковыми только потому, что у них одно имя! В примере выше условный
гиперпараметр
learning_rate— это разные гиперпараметры дляoptimizer="Nesterov_momentum"и дляoptimizer="Adam". Его роль в двух алгоритмах похожа (хотя и не одинакова), но диапазоны значений, хорошо работающих в каждом из оптимизаторов, обычно различаются на несколько порядков.
- Например, мы хотим выяснить, какой из оптимизаторов — момент Нестерова или Adam — даёт наименьшую ошибку на валидации.
Научный гиперпараметр —
Набор исследований
Заголовок раздела «Набор исследований»- Определив научные и мешающие гиперпараметры, мы планируем «исследование» (study) или последовательность исследований,
чтобы продвинуться к цели эксперимента.
- Исследование задаёт набор конфигураций гиперпараметров, которые нужно запустить для последующего анализа. Каждую конфигурацию называют «испытанием» (trial).
- Создание исследования обычно включает выбор гиперпараметров, которые будут меняться от испытания к испытанию, выбор значений, которые они могут принимать («пространство поиска»), выбор числа испытаний и выбор алгоритма автоматического поиска, который выберет столько испытаний из пространства поиска. Или же исследование можно создать, задав набор конфигураций гиперпараметров вручную.
- Цель исследований — запустить конвейер с разными значениями научных гиперпараметров, одновременно «исключив оптимизацией» (optimizing away, или «оптимизируя по») мешающие гиперпараметры, чтобы сравнения разных значений научных гиперпараметров были как можно честнее.
- В простейшем случае мы делаем отдельное исследование для каждой конфигурации научных параметров, и в каждом
исследовании настраиваем мешающие гиперпараметры.
- Например, если цель — выбрать лучший оптимизатор из момента Нестерова и Adam, можно создать одно исследование,
в котором
optimizer="Nesterov_momentum", а мешающие гиперпараметры —{learning_rate, momentum}, и другое, в которомoptimizer="Adam", а мешающие гиперпараметры —{learning_rate, beta1, beta2, epsilon}. Сравнивать два оптимизатора мы будем, выбрав лучшее испытание из каждого исследования. - Для оптимизации по мешающим гиперпараметрам можно использовать любой алгоритм оптимизации без градиентов, включая байесовскую оптимизацию или эволюционные алгоритмы, хотя на этапе исследования мы предпочитаем квазислучайный поиск из-за ряда его преимуществ в этой ситуации. Когда исследование закончено, мы предпочитаем современную программу байесовской оптимизации, если она доступна.
- Например, если цель — выбрать лучший оптимизатор из момента Нестерова и Adam, можно создать одно исследование,
в котором
- В более сложном случае, когда нужно сравнить много значений научных гиперпараметров и делать столько независимых
исследований непрактично, можно включить научные параметры в то же пространство поиска, что и мешающие
гиперпараметры, и с помощью алгоритма поиска выбирать значения и научных, и мешающих гиперпараметров в одном
исследовании.
- При таком подходе проблемы могут создать условные гиперпараметры: трудно задать пространство поиска, если набор мешающих гиперпараметров не одинаков для всех значений научных.
- В этом случае наше предпочтение квазислучайного поиска перед более изощрёнными инструментами оптимизации чёрного ящика ещё сильнее: он гарантирует относительно равномерную выборку значений научных гиперпараметров. Каким бы ни был алгоритм поиска, нужно как-то убедиться, что он перебирает научные параметры равномерно.
Баланс между информативностью и доступностью экспериментов
Заголовок раздела «Баланс между информативностью и доступностью экспериментов»- Планируя исследование или последовательность исследований, нужно распределить ограниченный бюджет так, чтобы
в достаточной мере выполнить три пожелания:
- сравнить достаточно много разных значений научных гиперпараметров;
- настроить мешающие гиперпараметры в достаточно большом пространстве поиска;
- достаточно плотно выбирать точки в пространстве поиска мешающих гиперпараметров.
- Чем лучше выполнены эти три пожелания, тем больше выводов можно извлечь из эксперимента.
- Сравнение как можно большего числа значений научных гиперпараметров расширяет охват выводов из эксперимента.
- Включение как можно большего числа мешающих гиперпараметров и как можно более широкие диапазоны для каждого из них
повышают уверенность, что «хорошее» значение мешающих гиперпараметров существует в пространстве поиска для
каждой конфигурации научных гиперпараметров.
- Иначе сравнения значений научных гиперпараметров могут оказаться нечестными: мы не обыскали те области пространства мешающих параметров, где для некоторых значений научных параметров могли бы найтись лучшие значения.
- Как можно более плотная выборка в пространстве поиска мешающих гиперпараметров повышает уверенность, что процедура
поиска найдёт любые хорошие значения мешающих гиперпараметров, которые в этом пространстве есть.
- Иначе сравнения значений научных параметров могут оказаться нечестными из-за того, что каким-то значениям больше повезло с выборкой мешающих гиперпараметров.
- К сожалению, улучшение по любому из трёх направлений требует либо увеличить число испытаний, а значит, и затраты
ресурсов, либо найти способ сэкономить ресурсы по другому направлению.
- У каждой задачи свои особенности и вычислительные ограничения, поэтому, как распределить ресурсы между тремя пожеланиями, решают с опорой на знание предметной области.
- Проведя исследование, мы всегда пытаемся понять, достаточно ли хорошо в нём настроены мешающие гиперпараметры (то есть достаточно ли большое пространство обыскано достаточно тщательно), чтобы честно сравнить научные гиперпараметры (подробнее — ниже).
Как извлечь выводы из результатов экспериментов
Заголовок раздела «Как извлечь выводы из результатов экспериментов»Коротко: помимо исходной научной цели каждой группы экспериментов, пройдитесь по списку дополнительных вопросов и, если обнаружатся проблемы, переработайте эксперименты и запустите их заново.
- В конечном счёте у каждой группы экспериментов есть конкретная цель, и мы хотим оценить, какие доказательства
эксперименты дают в её пользу.
- Однако, задав правильные вопросы, мы часто находим проблемы, которые нужно исправить, прежде чем эксперименты смогут
заметно продвинуть к исходной цели.
- Если не задать этих вопросов, можно сделать неверные выводы.
- Эксперименты бывают дорогими, поэтому стоит пользоваться возможностью извлечь из каждой группы экспериментов и другие полезные выводы, даже если они не относятся напрямую к текущей цели.
- Однако, задав правильные вопросы, мы часто находим проблемы, которые нужно исправить, прежде чем эксперименты смогут
заметно продвинуть к исходной цели.
- Прежде чем анализировать набор экспериментов ради исходной цели, стоит задать себе дополнительные вопросы:
- Достаточно ли велико пространство поиска?
- Если оптимальная точка исследования лежит у границы пространства поиска по одному или нескольким измерениям, поиск, вероятно, недостаточно широк. В этом случае нужно провести ещё одно исследование с расширенным пространством поиска.
- Достаточно ли точек мы выбрали из пространства поиска?
- Если нет — запустите больше точек или умерьте амбиции в целях настройки.
- Какая доля испытаний в каждом исследовании невыполнима (infeasible), то есть расходится, даёт совсем плохие
значения потерь или вообще не запускается из-за нарушения какого-то неявного ограничения?
- Если невыполнимых точек в исследовании очень много, стоит изменить пространство поиска, чтобы не выбирать такие точки; иногда для этого нужно перепараметризовать пространство поиска.
- Иногда большое число невыполнимых точек указывает на ошибку в коде обучения.
- Есть ли у модели проблемы с оптимизацией?
- Что можно узнать из кривых обучения лучших испытаний?
- Например, согласуются ли кривые обучения лучших испытаний с проблемным переобучением?
- Достаточно ли велико пространство поиска?
- При необходимости, исходя из ответов на эти вопросы, уточните последнее исследование (или группу исследований): улучшите пространство поиска и (или) выберите больше испытаний — или предпримите другие исправляющие действия.
- Ответив на эти вопросы, можно переходить к оценке доказательств, которые эксперименты дают в пользу исходной цели (например, к оценке, полезно ли изменение).
Неудачные границы пространства поиска
Заголовок раздела «Неудачные границы пространства поиска»- Пространство поиска подозрительно, если лучшая выбранная из него точка близка к его границе. Расширив диапазон поиска в этом направлении, мы могли бы найти точку ещё лучше.
- Чтобы проверить границы пространства поиска, мы любим наносить завершённые испытания на то, что мы называем
базовыми графиками по оси гиперпараметра (basic hyperparameter axis plots): по вертикали — значение целевой
метрики на валидации, по горизонтали — один из гиперпараметров (например, learning rate). Каждая точка графика —
одно испытание.
- Значение целевой метрики на валидации для каждого испытания обычно должно быть лучшим значением, которого оно достигло за всё обучение.
Рисунок 1 в оригинале (неудачные границы, приемлемые границы): два графика доли ошибок (чем ниже, тем лучше) от начального learning rate по логарифмической шкале. На левом точки с наименьшей ошибкой прижаты к правому краю диапазона — лучший learning rate, возможно, лежит за его пределами. На правом минимум ошибки находится внутри диапазона, а по краям ошибка растёт. Красными крестиками отмечены невыполнимые (разошедшиеся) испытания.
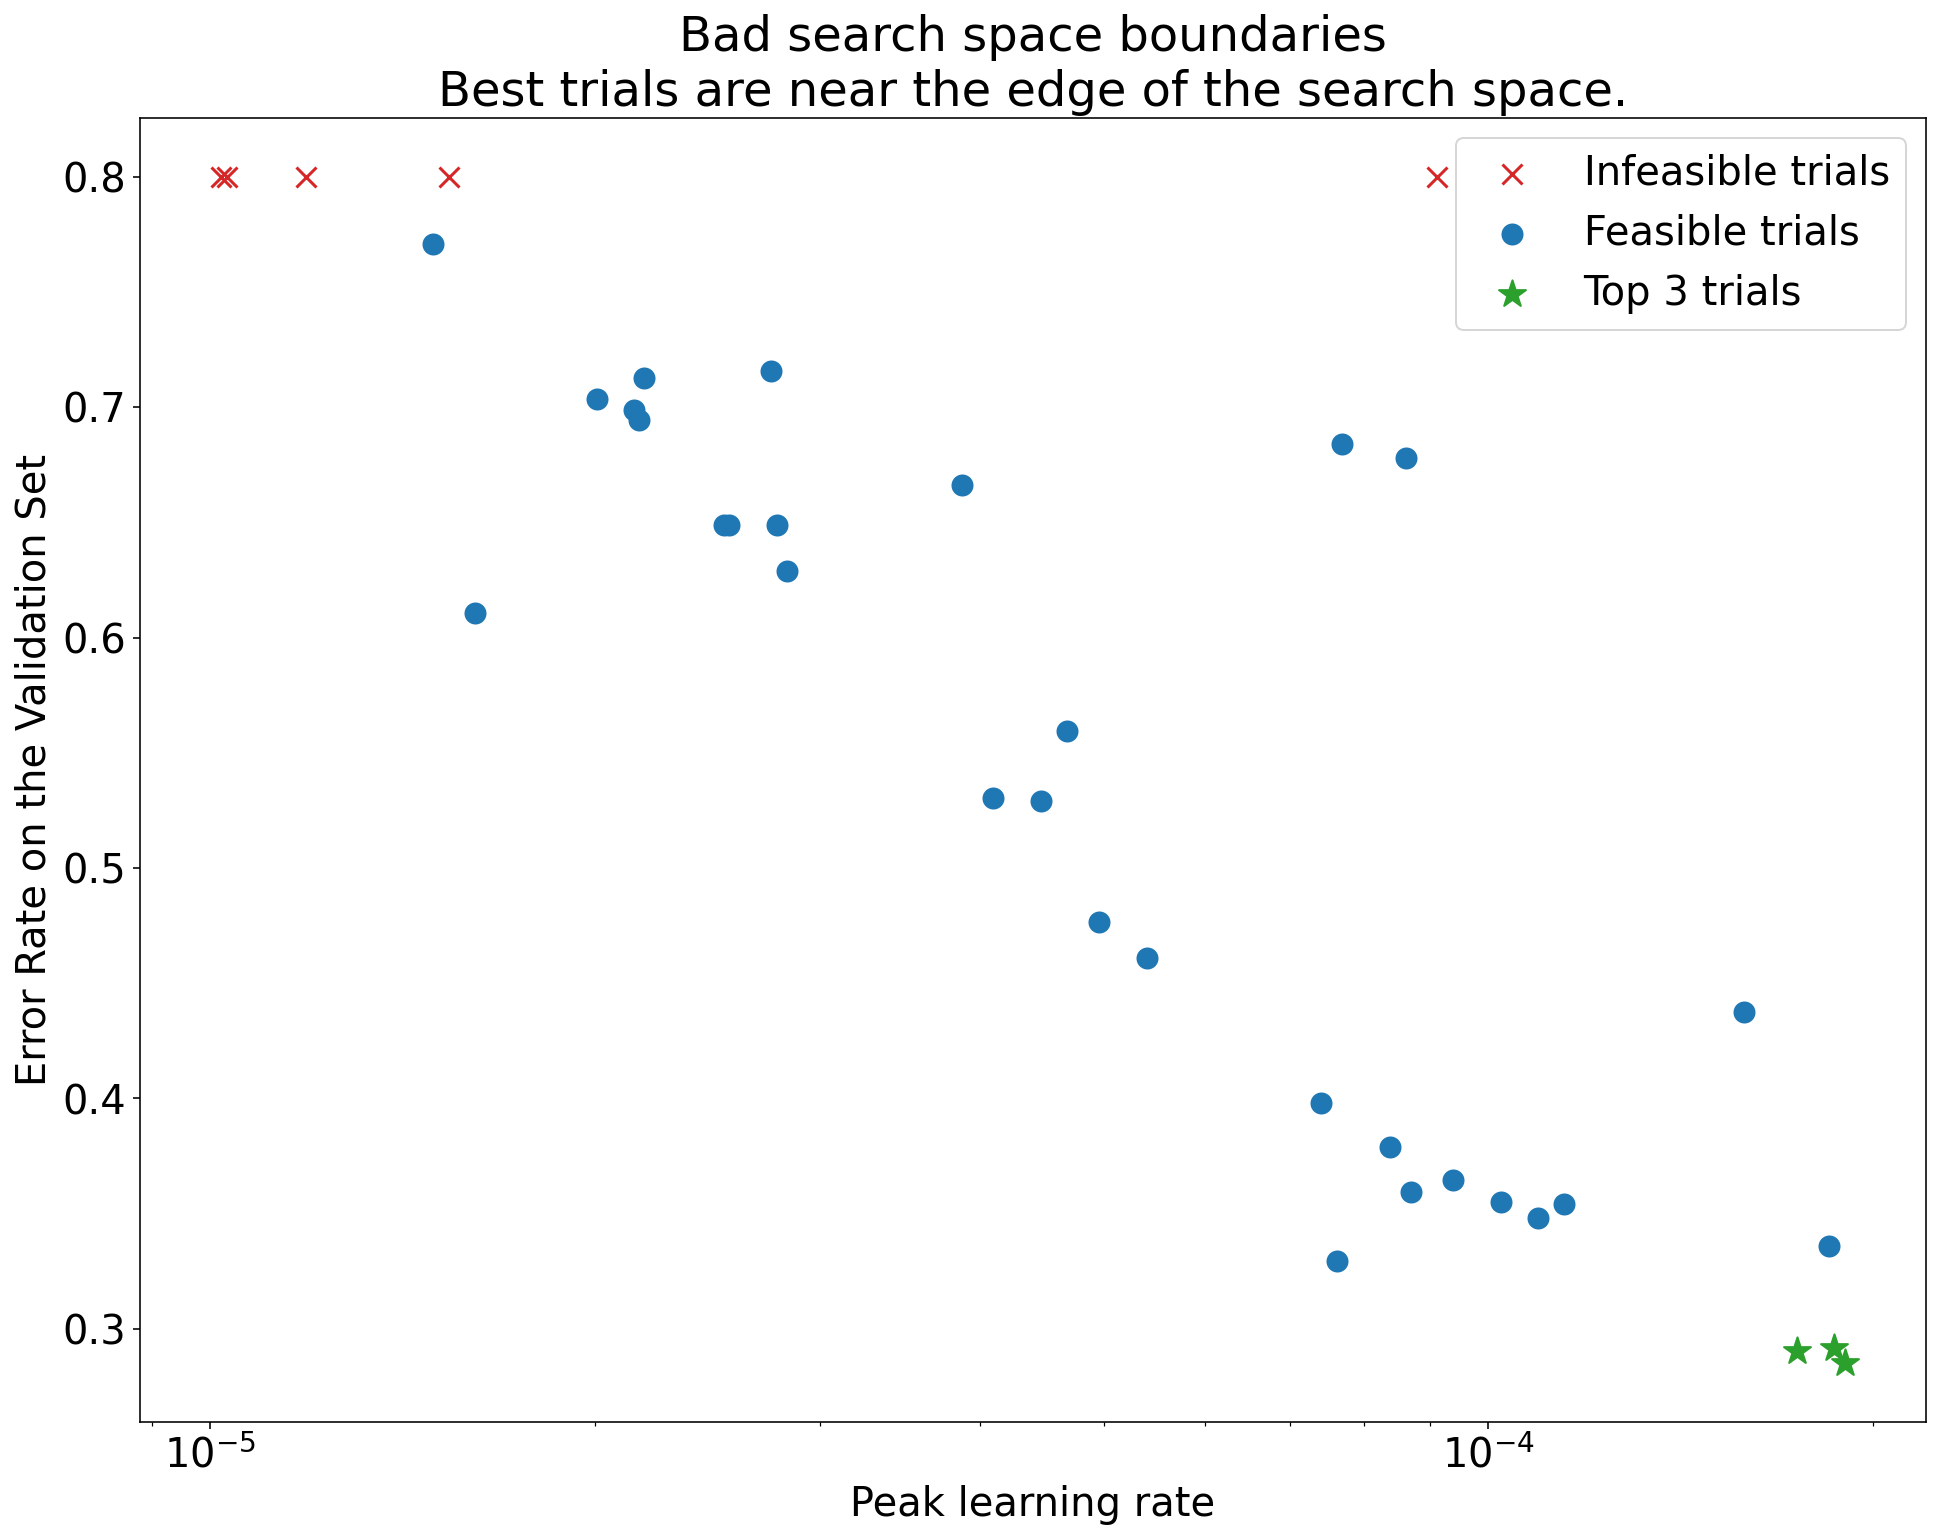
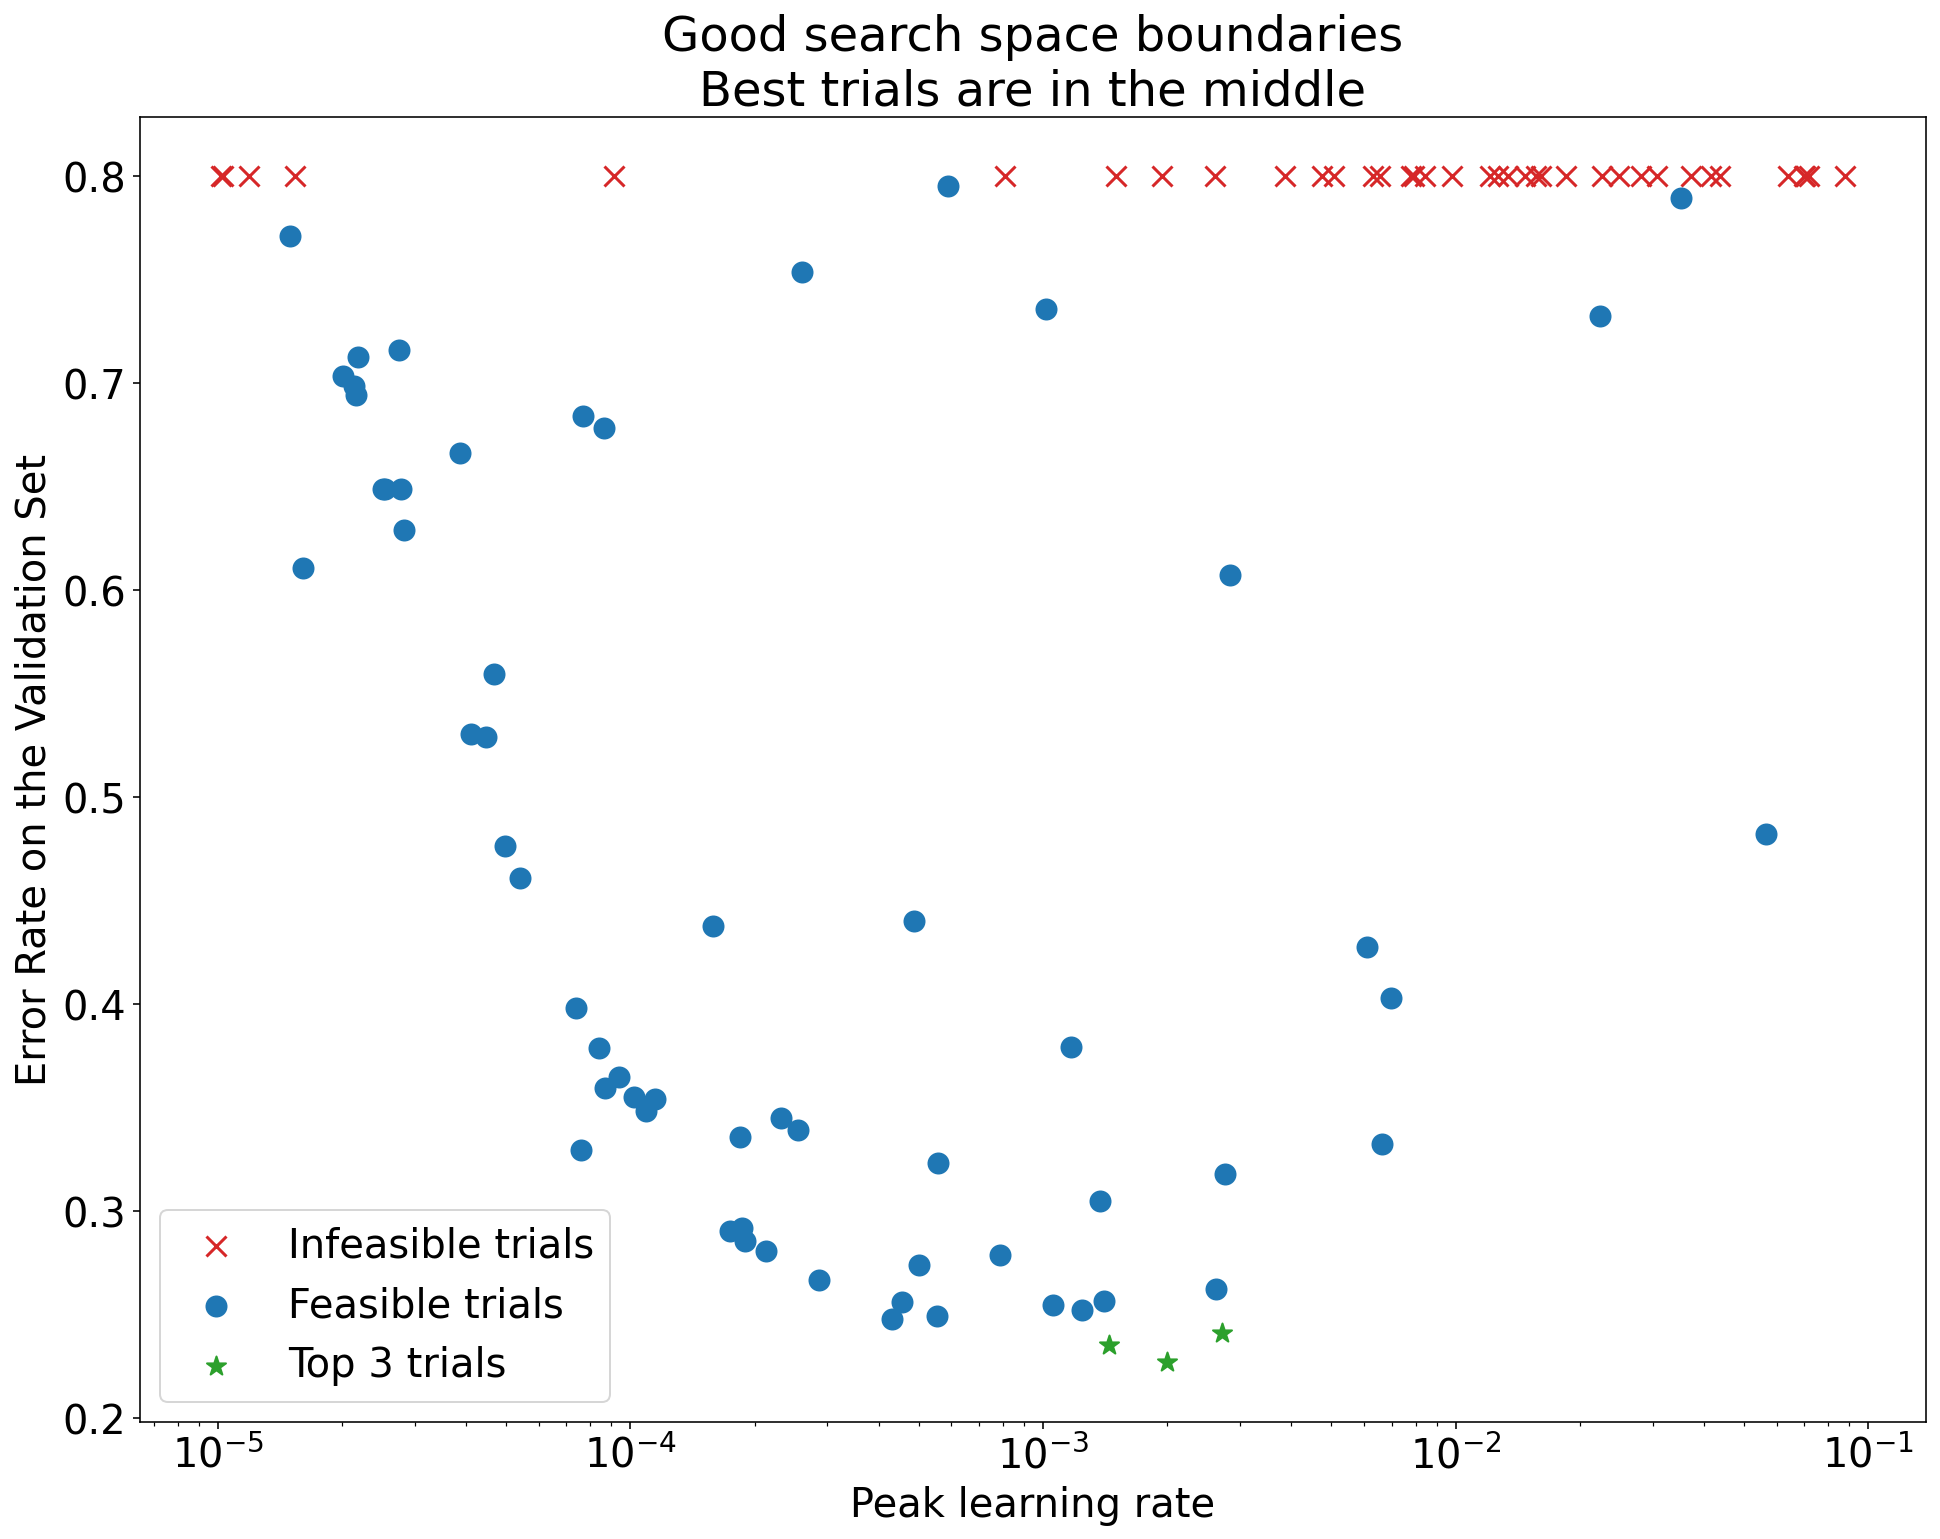
- Графики на рисунке 1 показывают долю ошибок (чем ниже, тем лучше) в зависимости от начального learning rate.
- Если лучшие точки скапливаются у края пространства поиска (по какому-то измерению), границы пространства поиска, возможно, нужно расширять, пока лучшая наблюдаемая точка не перестанет быть близкой к границе.
- Часто в исследовании есть «невыполнимые» испытания, которые расходятся или дают очень плохие результаты (на графиках
выше они отмечены красными крестиками).
- Если все испытания с learning rate выше некоторого порога невыполнимы, а лучшие испытания имеют learning rate у края этой области, модель может страдать от неустойчивости, которая не даёт ей использовать большие learning rate.
Слишком мало точек в пространстве поиска
Заголовок раздела «Слишком мало точек в пространстве поиска»- В общем случае очень трудно понять, достаточно ли плотно выбраны точки в пространстве поиска. 🤖
- Больше испытаний, конечно, лучше, но и стоит это очевидно больше.
- Понять, когда точек достаточно, так трудно, что обычно мы выбираем столько точек, сколько можем себе позволить, и калибруем интуитивную уверенность, снова и снова рассматривая разные графики по осям гиперпараметров и пытаясь почувствовать, сколько точек попало в «хорошую» область пространства поиска.
Изучаем кривые обучения
Заголовок раздела «Изучаем кривые обучения»Коротко: изучение кривых обучения — простой способ распознать типичные виды сбоев, и оно помогает решить, что делать дальше в первую очередь.
- Хотя во многих случаях главная цель экспериментов требует смотреть только на ошибку на валидации в каждом испытании, сводить каждое испытание к одному числу нужно осторожно: так можно скрыть важные подробности того, что происходит под поверхностью.
- Для каждого исследования мы всегда смотрим на кривые обучения (ошибку на обучающей и на валидационной выборке в зависимости от шага обучения за всё время обучения) хотя бы нескольких лучших испытаний.
- Даже если для главной цели эксперимента это не нужно, изучение кривых обучения — простой способ распознать типичные виды сбоев, и оно помогает расставить приоритеты дальнейших действий.
- Изучая кривые обучения, мы ищем ответы на следующие вопросы.
- Есть ли у каких-нибудь испытаний проблемное переобучение?
- Проблемное переобучение — это когда ошибка на валидации в какой-то момент обучения начинает расти.
- Когда мы исключаем оптимизацией мешающие гиперпараметры, выбирая «лучшее» испытание для каждого значения научных
гиперпараметров, нужно проверить на проблемное переобучение как минимум каждое из лучших испытаний, соответствующих
сравниваемым значениям научных гиперпараметров.
- Если какое-то из лучших испытаний проблемно переобучается, обычно стоит перезапустить эксперимент с дополнительными
приёмами регуляризации и (или) лучше настроить существующие параметры регуляризации, прежде чем сравнивать значения
научных гиперпараметров.
- Это может не относиться к случаю, когда среди научных гиперпараметров есть параметры регуляризации: тогда неудивительно, что слабые значения этих параметров приводят к проблемному переобучению.
- Уменьшить переобучение часто несложно с помощью распространённых приёмов регуляризации, которые почти не усложняют код и не требуют дополнительных вычислений (например, dropout, сглаживание меток (label smoothing), weight decay), поэтому добавить один или несколько из них в следующий раунд экспериментов обычно не проблема.
- Например, если научный гиперпараметр — «число скрытых слоёв», а лучшее испытание с наибольшим числом скрытых слоёв проблемно переобучилось, мы обычно предпочтём попробовать его снова с дополнительной регуляризацией, а не сразу выбрать меньшее число скрытых слоёв.
- Даже если ни одно из «лучших» испытаний не переобучается проблемно, проблема всё равно может быть, если это
происходит в каком-либо из испытаний.
- Выбор лучшего испытания подавляет конфигурации с проблемным переобучением и отдаёт предпочтение тем, где его нет. Иначе говоря, он отдаёт предпочтение конфигурациям с более сильной регуляризацией.
- Однако регуляризатором может служить всё, что ухудшает обучение, даже если так не задумывалось. Например, выбор меньшего learning rate может регуляризовать обучение, затрудняя оптимизацию, но обычно мы не хотим выбирать learning rate таким способом.
- Поэтому нужно помнить: «лучшее» испытание для каждого значения научных гиперпараметров может быть выбрано так, что предпочтение получат «плохие» значения каких-то научных или мешающих гиперпараметров.
- Если какое-то из лучших испытаний проблемно переобучается, обычно стоит перезапустить эксперимент с дополнительными
приёмами регуляризации и (или) лучше настроить существующие параметры регуляризации, прежде чем сравнивать значения
научных гиперпараметров.
- Велик ли разброс ошибки на обучении или валидации от шага к шагу в конце обучения?
- Если да, это может помешать сравнивать разные значения научных гиперпараметров (каждое испытание случайно заканчивается на «удачном» или «неудачном» шаге) и воспроизвести результат лучшего испытания в продакшене (рабочая модель может закончить обучение не на том же «удачном» шаге, что в исследовании).
- Самые вероятные причины разброса от шага к шагу — разброс между батчами (из-за случайного выбора примеров обучающей выборки в каждый батч), маленькие валидационные выборки и слишком высокий learning rate в конце обучения.
- Возможные средства: увеличить размер батча, собрать больше валидационных данных, использовать затухание learning rate или усреднение Поляка (Polyak averaging).
- Продолжают ли испытания улучшаться к концу обучения?
- Если да, это значит, что мы в режиме, ограниченном вычислениями (compute-bound), и нам может помочь увеличение числа шагов обучения или изменение расписания learning rate.
- Вышло ли качество на обучающей и валидационной выборках на плато задолго до последнего шага обучения?
- Если да, это значит, что мы в режиме, не ограниченном вычислениями, и, возможно, можно уменьшить число шагов обучения.
- Перечислить всё невозможно, но изучение кривых обучения может выявить и многое другое (например, рост потерь на обучающей выборке в ходе обучения обычно указывает на ошибку в конвейере обучения).
Полезно ли изменение: графики изоляции
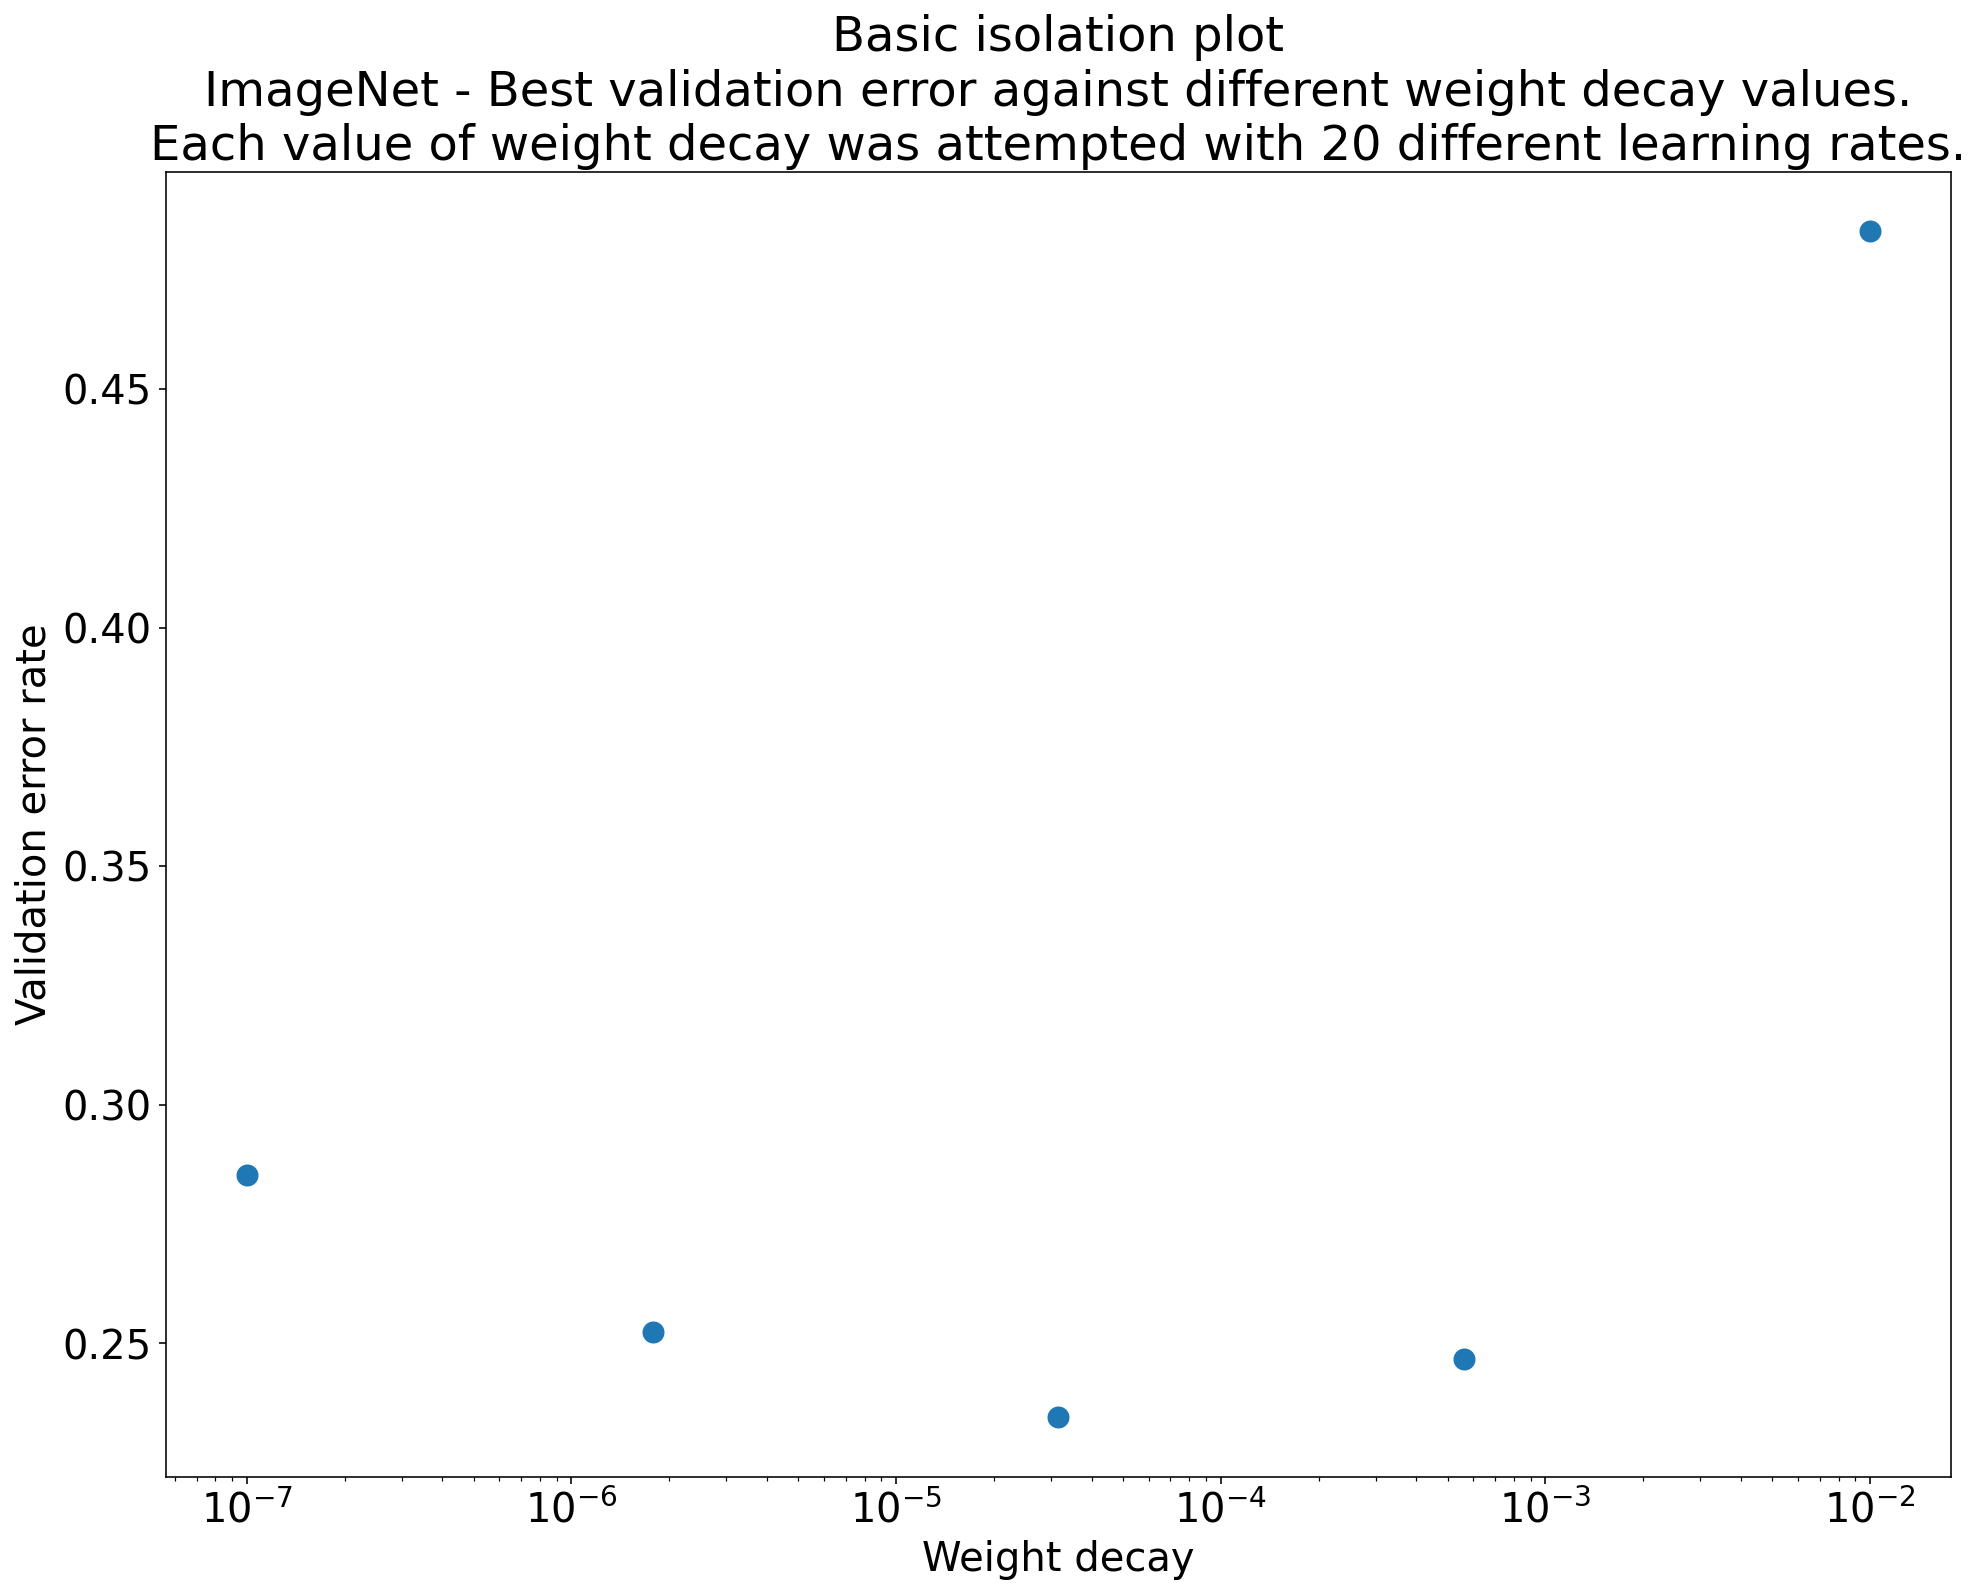
Заголовок раздела «Полезно ли изменение: графики изоляции»Рисунок 2 в оригинале (isolation_plot.png): график изоляции, исследующий лучшее значение weight decay для ResNet-50, обученной на ImageNet. По горизонтали — сила weight decay (логарифмическая шкала), по вертикали — ошибка на валидации; каждая точка — лучшее испытание при данном weight decay после подбора learning rate. Кривая имеет минимум внутри диапазона.
- Часто цель набора экспериментов — сравнить разные значения научного гиперпараметра.
- Например, мы можем хотеть найти значение weight decay, дающее наименьшую ошибку на валидации.
- График изоляции (isolation plot) — частный случай базового графика по оси гиперпараметра. Каждая точка графика
изоляции — качество лучшего испытания по некоторым (или всем) мешающим гиперпараметрам.
- Иначе говоря, мы рисуем качество модели после того, как мешающие гиперпараметры «исключены оптимизацией».
- График изоляции упрощает сравнение разных значений научного гиперпараметра «яблоки с яблоками».
- Например, рисунок 2
показывает значение weight decay, дающее лучшее качество на валидации для конкретной конфигурации ResNet-50, обученной
на ImageNet.
- Если наша цель — решить, включать ли weight decay вообще, мы сравним лучшую точку этого графика с базовым вариантом без weight decay. Для честного сравнения у базового варианта learning rate тоже должен быть подобран так же хорошо.
- Если данные получены (квази)случайным поиском и для графика изоляции рассматривается непрерывный гиперпараметр, график изоляции можно приблизить: разбить значения по горизонтальной оси базового графика на интервалы и в каждой вертикальной полосе, заданной интервалом, взять лучшее испытание.
# Примечание переводчика: приближённый график изоляции из результатов случайного поиска.import numpy as np
rng = np.random.default_rng(0)wd = 10 ** rng.uniform(-6, -2, 200)          # научный гиперпараметр: weight decaylr = 10 ** rng.uniform(-4, -1, 200)          # мешающий: learning rate# Выдуманная «ошибка на валидации»: минимум около wd=1e-4 и lr=1e-2, плюс шум.err = 0.2 + 0.02 * (np.log10(wd) + 4) ** 2 + 0.03 * (np.log10(lr) + 2) ** 2 \      + rng.normal(0, 0.005, 200)
bins = np.linspace(-6, -2, 9)                 # 8 полос по log10(wd)idx = np.digitize(np.log10(wd), bins) - 1for b in range(8):    mask = idx == b    if mask.any():        best = err[mask].min()                # лучшее испытание в полосе = «исключили» lr        print(f"log10(wd) ∈ [{bins[b]:.1f}, {bins[b+1]:.1f}): лучшая ошибка {best:.3f}")
Автоматизируйте полезные графики
Заголовок раздела «Автоматизируйте полезные графики»- Чем больше усилий требует построение графиков, тем реже мы смотрим на них так часто, как следовало бы, поэтому инфраструктуру стоит настроить так, чтобы она строила как можно больше графиков автоматически.
- Как минимум мы автоматически строим базовые графики по осям всех гиперпараметров, которые меняются в эксперименте.
- Кроме того, мы автоматически строим кривые обучения для всех испытаний и делаем так, чтобы было как можно проще найти несколько лучших испытаний каждого исследования и изучить их кривые обучения.
- Можно добавить и много других полезных графиков и визуализаций. Описанные выше — хорошая отправная точка, но, перефразируя Джеффри Хинтона, «каждый раз, когда вы рисуете что-то новое, вы узнаёте что-то новое».
Принимать ли изменение конвейера или конфигурацию гиперпараметров
Заголовок раздела «Принимать ли изменение конвейера или конфигурацию гиперпараметров»Коротко: решая, вносить ли изменение в модель или процедуру обучения или принять новую конфигурацию гиперпараметров, нужно помнить о разных источниках разброса в результатах.
- Пытаясь улучшить модель, мы можем заметить, что кандидат на изменение поначалу даёт меньшую ошибку на валидации, чем
текущая конфигурация, а повторив эксперимент, обнаружить, что устойчивого преимущества нет. Неформально самые важные
источники разброса, которые могут дать такой непоследовательный результат, можно разделить на широкие категории:
- Разброс процедуры обучения (training procedure variance), разброс повторного обучения (retrain variance) или
разброс испытаний (trial variance): различия между запусками обучения с одинаковыми гиперпараметрами, но разными
случайными зёрнами (seed).
- Например, источниками разброса испытаний могут быть разная случайная инициализация, перемешивание обучающих данных, маски dropout, порядок операций аугментации данных и порядок параллельных арифметических операций.
- Разброс поиска гиперпараметров (hyperparameter search variance), или разброс исследования (study variance):
различия в результатах, вызванные нашей процедурой выбора гиперпараметров.
- Например, можно провести один и тот же эксперимент с конкретным пространством поиска, но с двумя разными зёрнами квазислучайного поиска — и выбрать разные значения гиперпараметров.
- Разброс сбора данных и выборки: разброс от любого случайного разбиения на обучающую, валидационную и тестовую выборки или, в более общем смысле, от процесса порождения обучающих данных.
- Разброс процедуры обучения (training procedure variance), разброс повторного обучения (retrain variance) или
разброс испытаний (trial variance): различия между запусками обучения с одинаковыми гиперпараметрами, но разными
случайными зёрнами (seed).
- Можно, конечно, сравнивать оценки доли ошибок на конечной валидационной выборке скрупулёзными статистическими тестами, но часто один только разброс испытаний даёт статистически значимые различия между двумя обученными моделями с одинаковыми гиперпараметрами.
- О разбросе исследования мы больше всего беспокоимся, когда пытаемся делать выводы шире уровня отдельной точки
в пространстве гиперпараметров.
- Разброс исследования зависит от числа испытаний и от пространства поиска; мы видели случаи, когда он больше разброса испытаний, и случаи, когда гораздо меньше.
- Поэтому, прежде чем принять изменение-кандидат, стоит запустить лучшее испытание N раз, чтобы оценить разброс
испытаний от запуска к запуску.
- Обычно достаточно заново оценивать разброс испытаний только после крупных изменений конвейера, но в некоторых задачах могут понадобиться более свежие оценки.
- В других задачах оценка разброса испытаний слишком дорога, чтобы оно того стоило.
- В конце концов, хотя мы хотим принимать только изменения (включая новые конфигурации гиперпараметров), которые дают настоящие улучшения, требовать полной уверенности, что что-то помогает, — тоже неверно.
- Поэтому, если новая точка гиперпараметров (или другое изменение) даёт результат лучше базового (по возможности
с учётом разброса повторного обучения и новой точки, и базовой), её, вероятно, стоит принять как новую базу для
будущих сравнений.
- Однако принимать стоит только изменения, улучшения от которых перевешивают добавленную ими сложность.
Когда исследование закончено
Заголовок раздела «Когда исследование закончено»Коротко: инструменты байесовской оптимизации — привлекательный вариант, когда мы закончили искать хорошие пространства поиска и решили, какие гиперпараметры вообще стоит настраивать.
- В какой-то момент наши приоритеты сместятся от того, чтобы лучше понять задачу настройки, к тому, чтобы получить одну лучшую конфигурацию для запуска или другого использования.
- К этому моменту должно быть уточнённое пространство поиска, которое с запасом содержит окрестность лучшего наблюдавшегося испытания и в котором точки выбраны в достаточном количестве.
- Наша исследовательская работа должна была выявить самые важные гиперпараметры для настройки (и разумные диапазоны для них), по которым можно построить пространство поиска для итогового автоматического исследования с максимально большим бюджетом настройки.
- Поскольку нам больше не важно максимально углубить понимание задачи настройки, многие
преимущества квазислучайного поиска
теряют силу, и для автоматического поиска лучшей конфигурации гиперпараметров стоит использовать инструменты
байесовской оптимизации.
- Open-Source Vizier реализует множество изощрённых алгоритмов настройки ML-моделей, включая алгоритмы байесовской оптимизации.
- Если в пространстве поиска заметная доля расходящихся точек (точек, где потери на обучении становятся NaN или даже на много стандартных отклонений хуже среднего), важно использовать инструменты оптимизации чёрного ящика, которые правильно обрабатывают расходящиеся испытания (отличный способ решить эту проблему — в статье Bayesian Optimization with Unknown Constraints). Open-Source Vizier поддерживает расходящиеся точки, помечая испытания как невыполнимые, хотя, в зависимости от настройки, может и не использовать предпочитаемый нами подход из Gelbart et al.
- На этом этапе стоит также подумать о проверке качества на тестовой выборке.
- В принципе, можно даже влить валидационную выборку в обучающую и заново обучить лучшую конфигурацию, найденную байесовской оптимизацией. Однако это уместно, только если с этой конкретной задачей не будет будущих запусков (например, разовое соревнование на Kaggle).
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| incremental tuning strategy | стратегия пошаговой настройки |
| search space | пространство поиска |
| launch | запуск (обновление лучшей конфигурации) |
| exploration / exploitation | исследование / использование |
| scientific / nuisance / fixed hyperparameter | научный / мешающий / фиксированный гиперпараметр |
| conditional hyperparameter | условный гиперпараметр |
| study / trial | исследование / испытание |
| optimizing away | исключить оптимизацией |
| quasi-random search | квазислучайный поиск |
| Bayesian optimization | байесовская оптимизация |
| black-box optimization | оптимизация чёрного ящика |
| infeasible trial | невыполнимое испытание |
| basic hyperparameter axis plot | базовый график по оси гиперпараметра |
| training curves | кривые обучения |
| problematic overfitting | проблемное переобучение |
| label smoothing | сглаживание меток |
| Polyak averaging | усреднение Поляка |
| compute-bound | ограниченный вычислениями |
| isolation plot | график изоляции |
| trial / study variance | разброс испытаний / исследования |
| random seed | случайное зерно (seed) |