Happy-LLM, глава 8.2: On-Policy Distillation
Полный перевод раздела 8.2 книги Datawhale «Строим большую модель с нуля»: чем on-policy дистилляция отличается от офлайновой, обратная KL как потокенное преимущество, почему учитель должен оценивать ту же траекторию ученика, и синхронная реализация OPD на DeepMath через PyTRIO.
8.2 On-Policy Distillation
Заголовок раздела «8.2 On-Policy Distillation»Источник кода: раздел составлен по файлам
01-demo-sync.pyи02-demo-async.pyиз открытого репозитория автора agentic-rl-lab/02-opd/general-opd. В тексте по частям разобрана синхронная версия01-demo-sync.py; асинхронная оставлена как полная сопутствующая реализация.
Дистилляция способностей большой модели обычно строится из более сильного Teacher (учителя) и меньшего Student (ученика). Классическая дистилляция знаний использует заранее собранные данные: Student учится воспроизводить распределение вероятностей Teacher на этих фиксированных примерах. Но Student в ходе обучения постоянно меняется, и между фиксированными данными и состояниями, в которые Student попадает на самом деле, может возникнуть расхождение.
On-Policy Distillation (OPD, дистилляция на собственной политике) позволяет Student генерировать ответы текущей политикой, а затем Teacher оценивает каждый токен траектории, которую Student уже прошёл. Так каждый раунд обучения приходится на текущее распределение состояний Student. Teacher не нужно заново генерировать набор ответов и не нужно участвовать в обратном распространении — он только даёт действиям Student плотную вероятностную обратную связь.
В последние годы OPD стала важным направлением обучения больших моделей. Её используют для переноса способности к рассуждению, восстановления утраченных способностей и непрерывного обучения, а с потоком данных обучения с подкреплением она сочетается естественно: rollout Student соответствует on-policy траектории, logprob Teacher — потокенному сигналу обучения, а после обновления Student генерирует следующую партию траекторий.
8.2.1 От офлайновой дистилляции к On-Policy Distillation
Заголовок раздела «8.2.1 От офлайновой дистилляции к On-Policy Distillation»Пусть Teacher — это , Student — . Офлайновая дистилляция сначала фиксирует датасет , а затем минимизирует различие распределений на его состояниях:
Такой подход прост в реализации, а результат зависит от того, покрывает ли датасет состояния, которые встретятся Student при выводе. Допустим, в фиксированных данных в основном качественные траектории Teacher, а Student при реальной генерации рано выдаёт ошибочный токен: состояния, в которые он попадёт после этого, могли ни разу не встретиться в данных дистилляции, и указания Teacher этот участок траектории вне распределения не покроют.
OPD берёт состояния у текущего Student:
а затем Teacher вычисляет условные вероятности для этого же ответа Student:
Одна итерация обучения делится на три шага:
- Student rollout: Student генерирует ответ текущими весами;
- Teacher feedback: Teacher вычисляет logprob на точно тех же prompt и ответе;
- Student update: по разности вероятностей двух моделей строится потокенный сигнал, и Student обновляется.
flowchart LR
S["Student:<br/>генерирует ответ<br/>текущими весами"] --> TR["Траектория Student:<br/>prompt + completion"]
TR --> T["Teacher:<br/>только прямой проход<br/>по той же траектории"]
T --> K["Reverse KL:<br/>потокенный advantage"]
K --> S
Рисунок 8.3. OPD получает отзыв Teacher на собственной траектории Student (изображение в оригинале). Подзаголовок: «Student генерирует ответ текущей политикой; Teacher на точно том же ответе даёт плотную потокенную обратную связь». Нижняя левая часть — «один и тот же ответ Student», одинаковая последовательность токенов: prompt (маска 0) и токены . Logprob Student: . Logprob Teacher: . Разность : . Подпись: «Teacher должен оценивать тот же целевой токен при том же префиксе». Нижняя правая часть — «потокенный сигнал reverse KL»: , затем ; «: Student предпочитает этот токен сильнее», «: Teacher даёт большую вероятность». Внизу красная рамка: «ограничение на данные: токенизатор, граница prompt и позиции logprob у Student и Teacher должны быть строго выровнены».
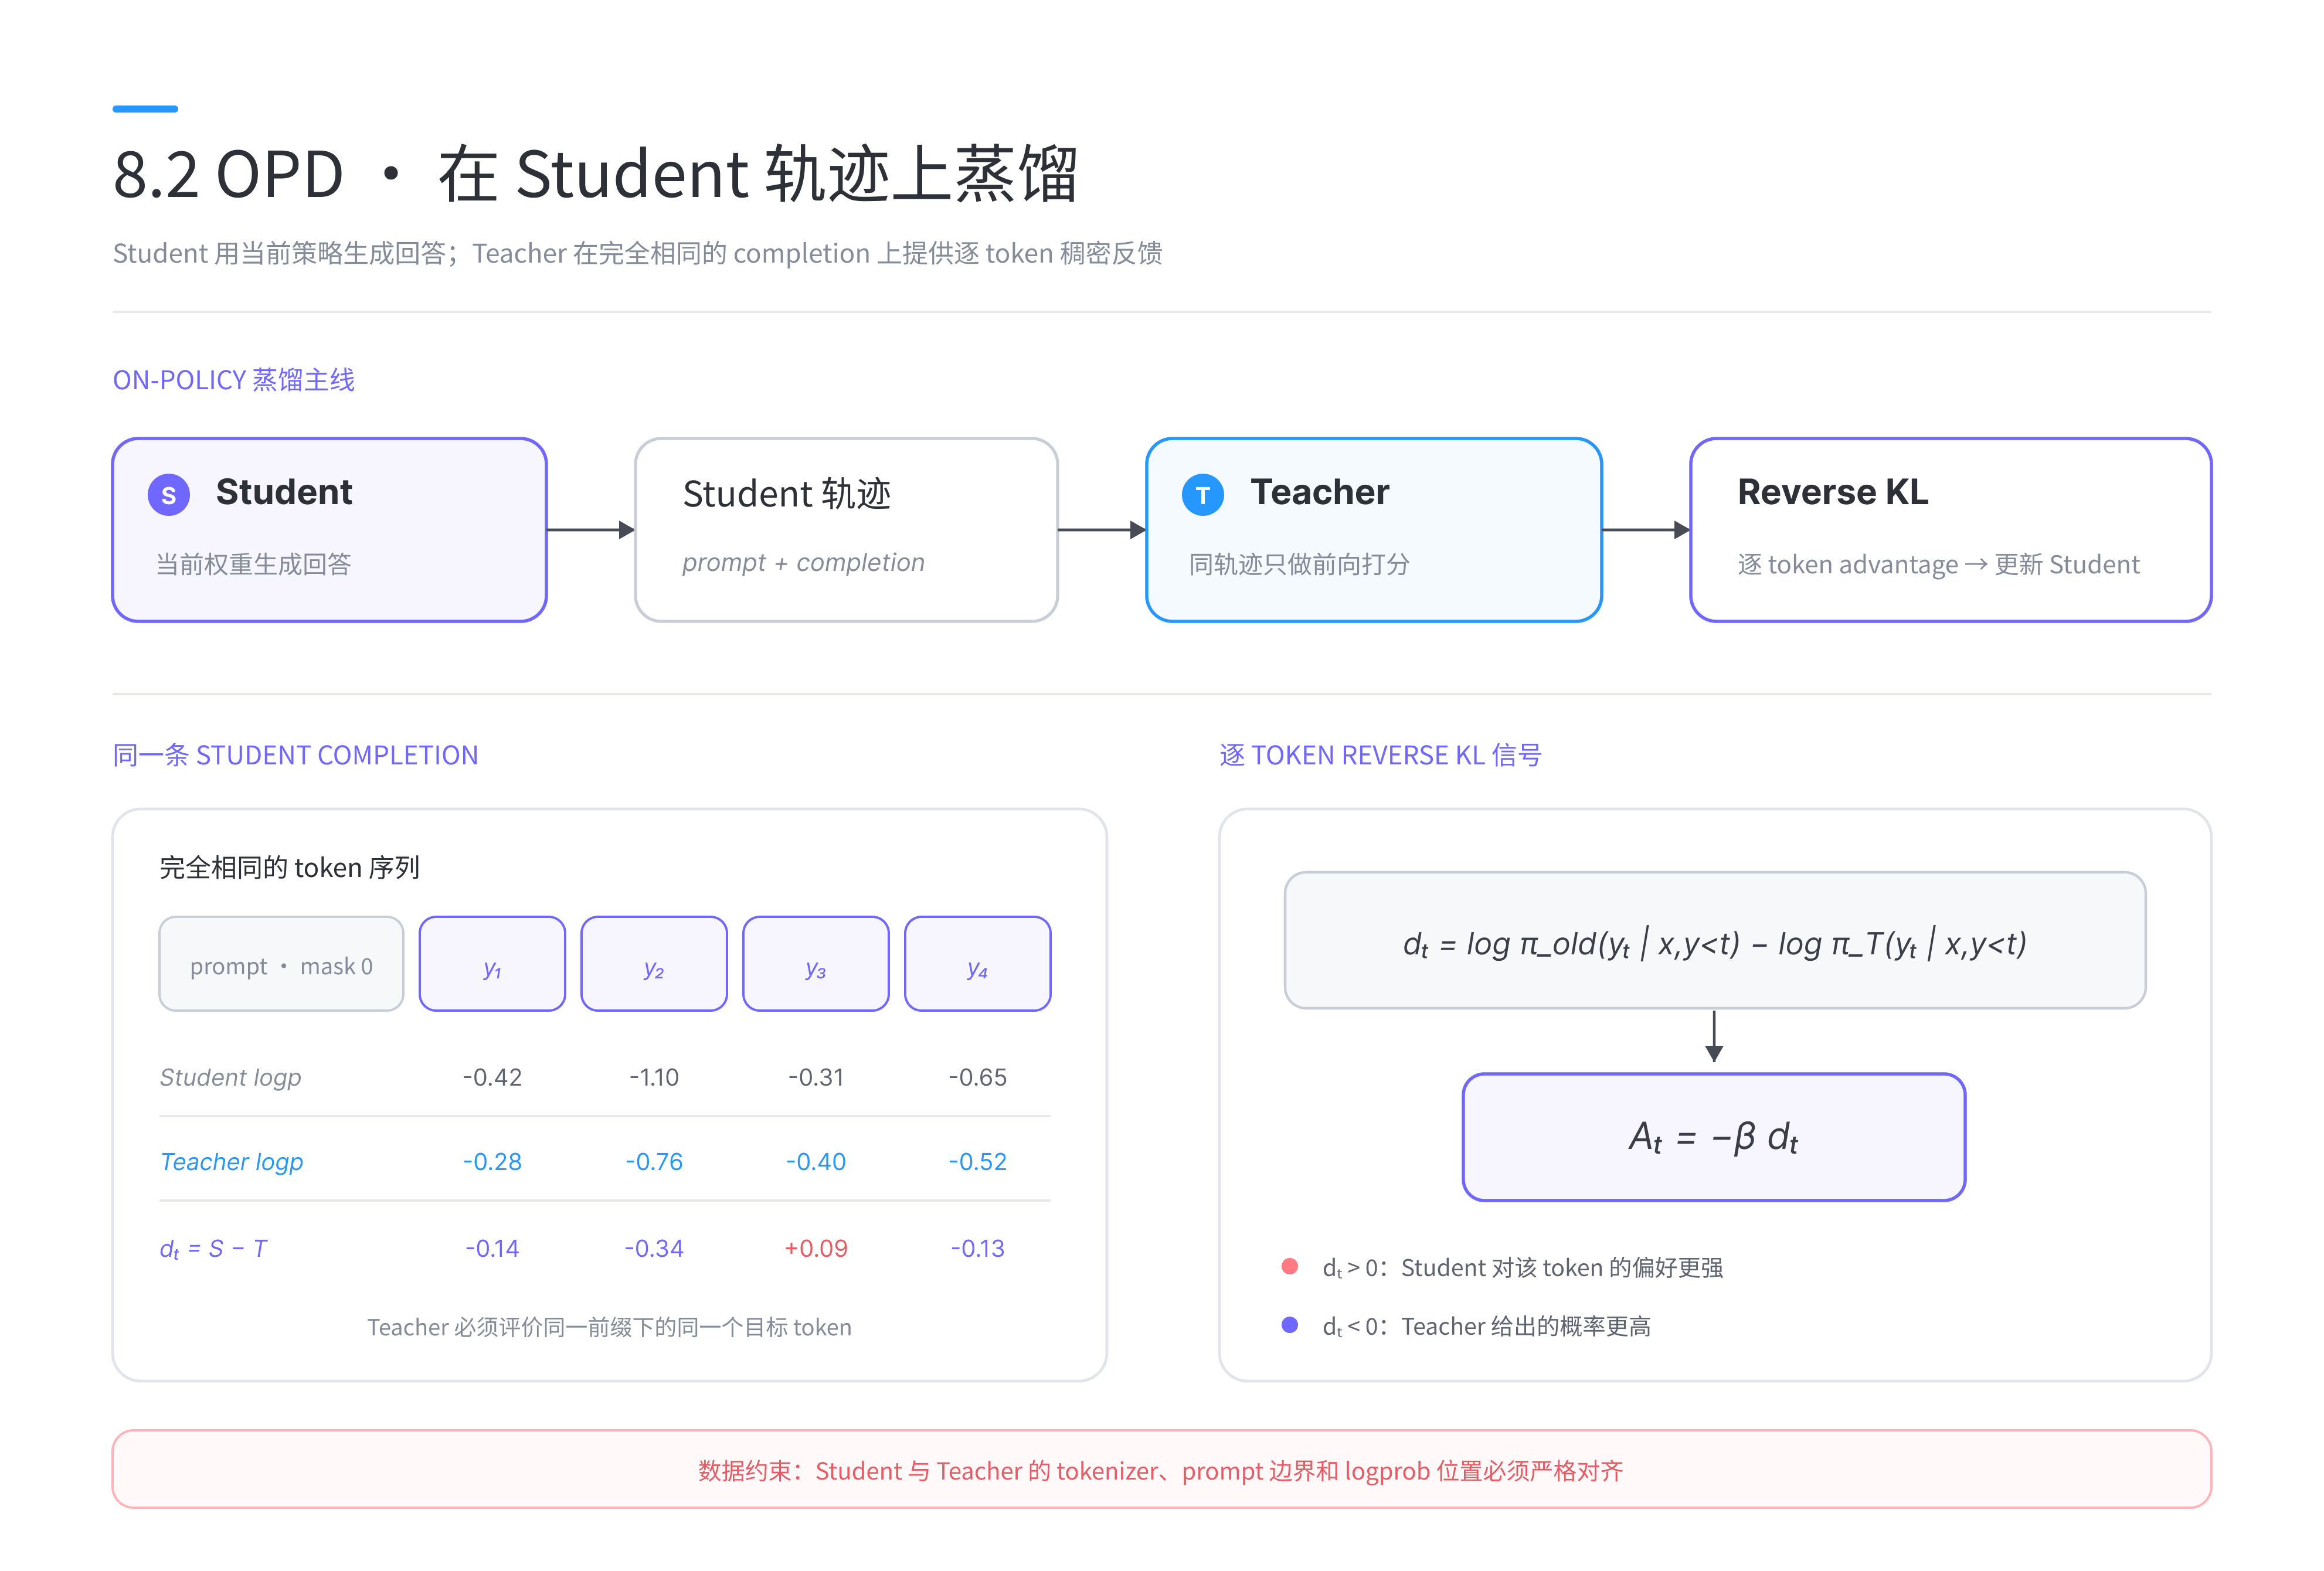
На рисунке 8.3 Teacher выполняет только прямой проход. Действия, которые Student выбрал при сэмплировании, тоже не участвуют в обратном распространении: градиент идёт от построенной цели обучения обратно к параметрам текущего Student. Эта граница остановки градиента позволяет OPD прямо переиспользовать существующую инфраструктуру rollout и оптимизации политики.
8.2.2 Reverse KL и потокенный сигнал обучения
Заголовок раздела «8.2.2 Reverse KL и потокенный сигнал обучения»В OPD можно выбрать разные меры расхождения распределений. В этой главе используется reverse KL (обратная KL-дивергенция):
Для -го токена, который Student действительно выбрал при сэмплировании, получаем оценку методом Монте-Карло:
При Student предпочитает этот токен сильнее, чем Teacher; при Teacher даёт ему большую вероятность. Чтобы минимизировать reverse KL, в этой главе advantage обучения записывается так:
где управляет силой дистилляции. Так каждый токен ответа получает собственный сигнал обучения — плотность сигнала намного выше, чем у единственной награды 0/1 в конце ответа.
Считаем по рисунку (от переводчика). При (значение по умолчанию
--kl-penalty-coef 1.0) четыре токена получают advantage . Токен Teacher считает заметно вероятнее ( против у Student) — его вероятность будут тянуть вверх сильнее всех; токен Student любит больше учителя ( против ) — его немного подавят. Средняя оценка обратной KL по этим токенам: . Отрицательное среднее не противоречие: одна выборка даёт шумную оценку, а сама KL неотрицательна только в ожидании.
Reverse KL сильно «ищет моду» (mode-seeking): Student в первую очередь сосредоточивается на областях, которым Teacher уже дал высокую вероятность, — это подходит, чтобы сжать в маленькую модель уверенное поведение Teacher. При этом на результат дистилляции влияют разрыв в способностях Teacher и Student, стиль рассуждений и совместимость токенизаторов. Больший Teacher — лишь кандидат: Teacher ещё должен давать на текущих траекториях Student ценный и усваиваемый новый сигнал.
Примечание переводчика. «Ищет моду» значит: обратная KL сильно штрафует Student за токены, которые Teacher считает маловероятными, и слабо — за то, что Student не покрывает все варианты учителя. Ученик выбирает один хороший способ отвечать, а не размазывает вероятность по всем. Прямая KL (как в классической дистилляции на логитах) ведёт себя наоборот — «покрывает массу». Подробно с картинкой — урок 1.3.3.
Таблица 8.2 сравнивает источники данных у GRPO и у примера OPD этой главы.
| Пункт | GRPO | OPD |
|---|---|---|
| Откуда траектории | текущая политика | текущий Student |
| Откуда обратная связь | среда или правило-проверяльщик | распределение вероятностей Teacher |
| Гранулярность сигнала | обычно награда за всю траекторию | каждый токен ответа |
| Нужен ли эталонный ответ | обычно нужен проверяемый результат | достаточно данных только с prompt |
| Нужна ли дополнительная модель | можно обойтись без Value Model | нужен прямой проход Teacher |
| Главные риски | взлом награды (reward hacking), вырожденные группы | несовместимость Teacher, неподходящий разрыв в способностях |
Таблица 8.2. GRPO и OPD.
8.2.3 Teacher обязан оценивать ту же траекторию Student
Заголовок раздела «8.2.3 Teacher обязан оценивать ту же траекторию Student»Ключевое ограничение на данные в OPD: Teacher и Student должны оценивать один и тот же целевой токен при одном и том же префиксе. Если Teacher сам сгенерирует ответ, а Student будет учиться на нём, это откат к обычной схеме дистилляции на синтетических данных.
В PyTRIO можно сначала склеить prompt и ответ Student, а затем вызвать у Teacher compute_logprobs():
def completion_teacher_logprobs(    teacher_client,    prompt_ids: list[int],    completion_ids: list[int],):    all_ids = prompt_ids + completion_ids    all_logprobs = teacher_client.compute_logprobs(        trio.ModelInput.from_ints(all_ids)    ).result()
    start = len(prompt_ids)    end = start + len(completion_ids)    return [float(x) for x in all_logprobs[start:end]]
Разные SDK могут определять позицию logprob со сдвигом на одну позицию, поэтому нельзя угадывать срез только по длине массива. Надёжнее всего построить очень короткую известную последовательность, убедиться, что значение в каждой позиции означает «logprob текущего токена», а не «logprob следующего токена», и затем проверить границу prompt и ответа. Код этой главы уже выровнен по соглашению о возвращаемых значениях PyTRIO 0.2.6.
Примечание переводчика. Как сделать такую проверку: возьмите последовательность из трёх токенов
[a, b, c]. Если сервис возвращает «logprob текущего токена», то позиция 0 пустая (None— у первого токена нет контекста), позиция 1 — , позиция 2 — . Сравните позицию 2 с тем, что вернётsample()для продолжения[a, b]с выбранным токеномc: числа должны совпасть.
Teacher и Student должны ещё иметь совместимые токенизаторы. Если одна и та же группа номеров токенов в двух моделях означает разные строки, разность вероятностей не имеет правильного смысла, даже если длины массивов одинаковы. До настоящего обучения проверьте:
text = "A short tokenizer alignment test."student_ids = student_tokenizer.encode(text, add_special_tokens=False)teacher_ids = teacher_tokenizer.encode(text, add_special_tokens=False)
assert student_ids == teacher_ids
Для моделей одного семейства с разными шаблонами чата полный prompt нужно один раз отрисовать токенизатором Student, а затем дать Teacher прямо оценить соответствующую последовательность токенов. Не применяйте два шаблона чата по отдельности — иначе контекст, который видят две стороны, уже будет разным.
Примечание переводчика. Одна английская фраза — слабая проверка: проверьте ещё русский и китайский текст, код и служебные токены шаблона (
<|im_start|>,<think>). Пару из примера ниже (Qwen3.5-4B и Qwen3.6-27B) авторы взяли из одного семейства, но проверку всё равно стоит выполнить; у Qwen и Llama словари заведомо разные (см. урок 4.2.3).
8.2.4 Синхронный OPD с нуля
Заголовок раздела «8.2.4 Синхронный OPD с нуля»В папке OPD тоже два независимых скрипта — синхронный и асинхронный:
| Файл | Способ выполнения | Назначение |
|---|---|---|
01-demo-sync.py | синхронный | основная учебная линия, разобранная в тексте по частям |
02-demo-async.py | асинхронный | параллельно обрабатывает rollout Student и запросы logprob к Teacher |
Ниже в порядке кода 01-demo-sync.py реализуем один полный раунд OPD — от prompt из DeepMath до обновления Student.
(1) Готовим параметры и данные DeepMath
По умолчанию скрипт скачивает данные в папку datasets/DeepMath-103K рядом с кодом:
SCRIPT_DIR = Path(__file__).resolve().parentDEFAULT_DATA_DIR = SCRIPT_DIR / "datasets" / "DeepMath-103K"DEEPMATH_SHARDS = 10Параметры parse_args() делятся на четыре группы:
- параметры данных:
dataset_repo,dataset_dir,num_shards,sample_size; - параметры моделей: исходная модель Student, ранг LoRA, исходная модель Teacher или путь к весам Teacher;
- параметры обучения: step, batch, group, длина генерации, коэффициент KL и параметры оптимизатора;
- параметры журнала: проект SwanLab, имя эксперимента и режим журнала.
DeepMath-103K на ModelScope состоит из 10 parquet-фрагментов (шардов). shard_name() даёт имя удалённого файла,
modelscope_file_url() — адрес для скачивания, а download_if_needed() сначала пишет во временный файл и потом
атомарно заменяет его, чтобы при обрыве не остался недокачанный фрагмент.
Функция загрузки отдаёт локальные parquet в Hugging Face Datasets и оставляет только нужное для обучения поле
question:
def load_deepmath(args: argparse.Namespace):    shard_paths = []
    for index in range(args.num_shards):        remote_path = shard_name(index)        local_path = args.dataset_dir / remote_path        download_if_needed(            modelscope_file_url(                args.dataset_repo,                args.dataset_revision,                remote_path,            ),            local_path,            args.force_download,        )        shard_paths.append(str(local_path))
    dataset = load_dataset(        "parquet",        data_files=shard_paths,        split="train",        cache_dir=str(            args.dataset_dir / ".datasets_cache"        ),    )
    if "question" not in dataset.column_names:        raise ValueError(            "DeepMath must contain 'question', "            f"got {dataset.column_names}"        )
    dataset = dataset.shuffle(seed=args.seed)    if args.sample_size > 0:        dataset = dataset.select(            range(min(args.sample_size, len(dataset)))        )    return dataset
--num-shards 1 подходит для первой сквозной проверки, --num-shards 10 покрывает весь датасет. --sample-size
задаёт, сколько примеров после загрузки реально попадёт в пул prompt.
(2) Превращаем задачу в prompt для Student
OPD использует данные только с prompt и не читает эталонные решения из DeepMath. build_prompt() передаёт задачу
и требования к ответу токенизатору Student:
def build_prompt( tokenizer, question: str, suffix: str, enable_thinking: bool,) -> list[int]: content = ( question.strip() if not suffix else f"{question.strip()}\n\n{suffix}" ) messages = [{"role": "user", "content": content}] prompt = tokenizer.apply_chat_template( messages, tokenize=False, add_generation_prompt=True, enable_thinking=enable_thinking, ) return tokenizer.encode( prompt, add_special_tokens=False, )Prompt отрисовывается один раз. Затем Teacher прямо оценивает ту же группу токенов, и контекст у обеих сторон полностью совпадает.
(3) Создаём Student и Teacher
Student использует клиент LoRA-обучения, Teacher — клиент сэмплирования, который делает только прямой проход:
service_client = trio.ServiceClient()
training_client = (    service_client.create_lora_training_client(        base_model=args.base_model,        rank=args.lora_rank,        seed=args.seed,    ))tokenizer = training_client.get_tokenizer()
teacher_client = service_client.create_sampling_client(    base_model=(        args.teacher_base_model        or args.base_model    ),    model_path=args.teacher_model_path,)
teacher_model_path может указывать на уже сохранённые веса для сэмплирования. Teacher не вызывает
forward_backward() и optim_step(): его параметры в ходе OPD не меняются.
Примечание переводчика. Через
teacher_model_pathучителем можно сделать собственную модель — например, ту, что вы обучили GRPO в разделе 8.1 (путь печатается в конце обучения:Saved weights … path: …). Так OPD используют для «восстановления способностей»: специализированный учитель передаёт навык ученику.
(4) Teacher оценивает ту же траекторию Student
Rollout Student возвращает токены ответа и logprob старой политики. Teacher должен увидеть prompt_ids + completion_ids,
а затем из результата вырезается участок ответа:
def completion_teacher_logprobs(    teacher_client,    prompt_ids: list[int],    completion_ids: list[int],):    all_ids = prompt_ids + completion_ids    all_logprobs = teacher_client.compute_logprobs(        trio.ModelInput.from_ints(all_ids)    ).result()
    completion_logprobs = all_logprobs[        len(prompt_ids):    ]
    if (        len(completion_logprobs)        != len(completion_ids)        or any(            value is None            for value in completion_logprobs        )    ):        raise ValueError(            "Invalid teacher logprobs "            "for completion tokens"        )
    return [        float(value)        for value in completion_logprobs    ]
Проверки длины и None защищают выравнивание токенов. Только после них -й токен ответа Student, старый logprob
Student и logprob Teacher образуют одну обучающую позицию.
(5) Строим потокенный Datum для OPD
OPD и GRPO используют одну и ту же схему importance_sampling; разница — в advantage. GRPO копирует один групповой
advantage на весь ответ, а OPD записывает каждому токену ответа собственный advantage обратной KL:
def build_opd_datum(    prompt_ids: list[int],    completion_ids: list[int],    old_logprobs,    advantages,):    prompt_loss_len = len(prompt_ids) - 1
    input_ids = (        prompt_ids        + completion_ids[:-1]    )    target_ids = (        [0] * prompt_loss_len        + completion_ids    )    padded_logprobs = (        [0.0] * prompt_loss_len        + list(old_logprobs)    )    padded_advantages = (        [0.0] * prompt_loss_len        + list(advantages)    )
    if not (        len(input_ids)        == len(target_ids)        == len(padded_logprobs)        == len(padded_advantages)    ):        raise ValueError(            "OPD datum fields must "            "have the same length"        )
    return trio.Datum(        model_input=trio.ModelInput.from_ints(            input_ids        ),        loss_fn_inputs={            "target_tokens": np.asarray(                target_ids,                dtype=np.int64,            ),            "logprobs": np.asarray(                padded_logprobs,                dtype=np.float32,            ),            "advantages": np.asarray(                padded_advantages,                dtype=np.float32,            ),        },    )
Правило сдвига вправо в точности такое же, как в GRPO. На участке prompt три входа потерь по-прежнему заполнены нулями, а на участке ответа один к одному лежат токен Student, старый logprob Student и OPD-advantage этого токена.
(6) Генерируем траектории Student и считаем reverse KL
В начале каждого шага код обновляет sampler Student раз в sampler_refresh_steps шагов. По умолчанию это 1, поэтому
каждый шаг использует самые свежие веса Student:
if ( student_sampler is None or step % args.sampler_refresh_steps == 0): student_sampler = ( training_client .save_weights_and_get_sampling_client() )Синхронная версия обрабатывает задачи текущего батча по очереди. Для каждого prompt Student сначала генерирует
group_size траекторий, затем Teacher оценивает каждый непустой ответ:
result = student_sampler.sample(    prompt=trio.ModelInput.from_ints(        prompt_ids    ),    num_samples=args.group_size,    sampling_params=sampling_params,    return_text=False,).result()
for sequence in result.sequences:    completion_ids = sequence.tokens    if not completion_ids:        continue
    student_lps = [        float(value)        for value in sequence.logprobs    ]    teacher_lps = completion_teacher_logprobs(        teacher_client,        prompt_ids,        completion_ids,    )
    reverse_kl = (        np.asarray(student_lps)        - np.asarray(teacher_lps)    )    advantages = (        -args.kl_penalty_coef        * reverse_kl    )
    datums.append(        build_opd_datum(            prompt_ids,            completion_ids,            student_lps,            advantages,        )    )    reverse_kls.extend(reverse_kl.tolist())    completion_token_counts.append(        len(completion_ids)    )
group_size здесь расширяет покрытие состояний Student для одного prompt. Каждая траектория получает сигнал Teacher
независимо, центрирования внутри группы в стиле GRPO нет.
(7) Обновляем Student, пишем метрики и сохраняем веса
Собрав весь батч, код выполняет один прямой-обратный проход и одно обновление оптимизатора:
if not datums:    raise RuntimeError(        "No OPD datums were built"    )
fwd_bwd = training_client.forward_backward(    datums,    loss_fn="importance_sampling",)optim = training_client.optim_step(adam)
fwd_bwd_result = fwd_bwd.result()optim.result()
tokens/s одного шага OPD — это общее число токенов ответов, делённое на время всего шага. В это время входят
сэмплирование Student, logprob Teacher, прямой-обратный проход Student, обновление оптимизатора и необходимое
обновление sampler:
completion_tokens_total = int( sum(completion_token_counts))metrics = { "data/datums": len(datums), "data/completion_tokens_mean": float( np.mean(completion_token_counts) ), "data/completion_tokens_total": ( completion_tokens_total ), "data/completion_tokens_per_second": ( completion_tokens_total / step_elapsed_time ), "opd/reverse_kl_mean": float( np.mean(reverse_kls) ), "opd/reverse_kl_std": float( np.std(reverse_kls) ), "train/learning_rate": args.learning_rate, "time/step_elapsed_time": step_elapsed_time,}После обучения сохраняются веса Student для сэмплирования:
save_result = ( training_client .save_weights_for_sampler( args.save_weights_name ) .result())print(f"Saved weights: {save_result.path}")Примечание переводчика. Почему потеря
importance_samplingс таким advantage минимизирует обратную KL. На первом шаге после rollout , и градиент потерь равен — это градиент политики с «наградой» за каждый токен. Градиент же KL по параметрам политики, если вычислять его на её собственных выборках, равен (плюс слагаемое с нулевым средним). Знаки противоположны, значит шаг по нашей цели — шаг вниз по KL. В книге используется упрощение «каждый токен оценивается отдельно, без учёта влияния на будущие токены»: так же OPD устроена в статье Agarwal и др. (GKD, 2023) из списка литературы главы.
8.2.5 Запуск синхронной и асинхронной версий
Заголовок раздела «8.2.5 Запуск синхронной и асинхронной версий»Пробный шаг синхронной версии сам скачает один фрагмент DeepMath и возьмёт из него не больше 20 prompt:
python docs/chapter8/opd/01-demo-sync.py \ --steps 1 \ --batch-size 1 \ --group-size 1 \ --max-tokens 512 \ --sample-size 20 \ --num-shards 1 \ --swanlab-mode disabledАсинхронная версия использует тот же алгоритм и параметры:
python docs/chapter8/opd/02-demo-async.py \ --steps 1 \ --batch-size 4 \ --group-size 2 \ --max-tokens 512 \ --sample-size 20 \ --num-shards 1 \ --swanlab-mode disabledАсинхронный OPD использует параллелизм на двух уровнях:
| Этап обучения | Синхронная версия | Асинхронная версия |
|---|---|---|
| Создание Student / Teacher | синхронный интерфейс клиента | create_lora_training_client_async() и create_sampling_client_async() |
| Rollout Student | sample().result() по одному prompt | параллельные sample_async() внутри батча |
| Оценка Teacher | compute_logprobs().result() по одному ответу | параллельные compute_logprobs_async() внутри одного prompt |
| Сборка батча | Datum добавляются по очереди | общая сборка после двух уровней asyncio.gather() |
| Обновление Student | синхронный future + .result() | отправка через async API, затем ещё раз await future |
| Точка входа | main(args) | asyncio.run(main(args)) |
В тексте разобрана только синхронная версия: она прямо показывает причинную цепочку «сэмплирование Student → оценка Teacher → reverse KL → обновление Student». Асинхронная версия сохраняет то же выравнивание токенов, advantage и цель оптимизации.
По умолчанию пример использует Qwen/Qwen3.5-4B как Student и Qwen/Qwen3.6-27B как Teacher. Какие модели реально
доступны, смотрите в списке, который возвращает текущий сервис PyTRIO. При обучении следите одновременно за:
opd/reverse_kl_mean: средняя разница между токенами, выбранными Student, и вероятностями Teacher;opd/reverse_kl_std: разброс сигнала дистилляции по токенам;data/completion_tokens_total: сколько токенов на этом шаге оценил Teacher;data/completion_tokens_per_second: полезная пропускная способность всего шага OPD по токенам ответов;trainer/*: метрики обучения, которые возвращает PyTRIO;- отдельной оценкой на задаче и оценкой общих способностей: они подтверждают реальное изменение способностей после дистилляции.
Падение reverse KL означает, что распределение сэмплирования Student приближается к Teacher. Правильность на задаче всё равно нужно подтвердить фиксированной отложенной (held-out) оценкой. При скачках loss или падении способностей по порядку проверьте выравнивание токенов, качество Teacher, коэффициент KL, скорость обучения, частоту обновления sampler и долю обрезанных ответов.
До сих пор и GRPO, и OPD работали в одноходовой структуре «модель генерирует ответ, внешний модуль даёт сигнал обучения». Следующий раздел, Search-R1, ещё сильнее меняет форму траектории: прежде чем закончить ответ, модель может приостановить генерацию, вызвать поисковую среду, прочитать observation (наблюдение) и затем решить, что делать дальше.
От переводчика: что сделать руками
Заголовок раздела «От переводчика: что сделать руками»- Посчитайте advantage. Logprob Student , Teacher , . Ответ: , . Какой токен ученик будет усиливать сильнее всего и почему третий токен на обучение не влияет?
- Проверка токенизаторов. Загрузите токенизаторы двух моделей Qwen разных поколений и одной Llama через
AutoTokenizerи прогоните проверку из 8.2.3 на русском, китайском тексте и строке с<think>. - OPD локально. В TRL есть
GKDTrainer(обобщённая on-policy дистилляция по статье Agarwal и др.): параметрlmbdaзадаёт долю обучения на собственных генерациях ученика,beta— коэффициент обобщённой дивергенции Йенсена–Шеннона, которая плавно переходит от прямой KL к обратной. На ваших 4 GPU пара «ученик Qwen 0.5–1.5B, учитель 7B» помещается целиком; учитель занимает отдельную карту. - Сравните с уроком 6.4.4: какие из шести строк таблицы 8.2 там разобраны подробнее.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| (knowledge) distillation | дистилляция (знаний) |
| on-policy distillation, OPD | on-policy дистилляция |
| offline distillation | офлайновая дистилляция |
| teacher / student | учитель / ученик |
| state distribution | распределение состояний |
| out-of-distribution | вне распределения |
| dense feedback | плотная обратная связь |
| reverse KL | обратная KL-дивергенция |
| mode-seeking | поиск моды |
| stop-gradient | остановка градиента |
| tokenizer alignment | совместимость (выравнивание) токенизаторов |
| shard | фрагмент (шард) данных |
| throughput | пропускная способность |
| held-out evaluation | оценка на отложенных данных |