Happy-LLM, глава 8.1: RL для больших моделей — GRPO с нуля
Полный перевод введения и раздела 8.1 восьмой главы книги Datawhale «Строим большую модель с нуля»: языковая модель как RL-политика, переход от PPO к GRPO, проверяемые награды, отношение вероятностей и пошаговая сборка синхронного GRPO на GSM8K через PyTRIO.
Глава 8. Обучение с подкреплением для больших моделей
Заголовок раздела «Глава 8. Обучение с подкреплением для больших моделей»В четвёртой главе мы, начав с обучения с подкреплением на обратной связи от людей (Reinforcement Learning from Human Feedback, RLHF), познакомились с моделью награды, оптимизацией политики с проксимальным ограничением (Proximal Policy Optimization, PPO) и базовым процессом выравнивания по инструкциям. Шестая глава дала инженерную основу обучения больших моделей, а седьмая наделила модель способностями планировать, помнить и вызывать инструменты.
Когда агент по-настоящему попадает в среду — поиск, исполнение кода, — одного дообучения с учителем уже не хватает, чтобы покрыть все возможные траектории взаимодействия. Модель должна сама пробовать действия, по итоговому результату судить, удачна ли траектория, и закреплять успешный опыт в политике. Так обучение с подкреплением больших моделей постепенно переходит от задачи «сделать ответ ближе к предпочтениям» к задаче «научить модель действовать в среде».
Глава построена вокруг четырёх связанных тем. Сначала мы разберём широко применяемый сегодня в RL для больших моделей алгоритм Group Relative Policy Optimization (GRPO) и составим полную картину: rollout, reward, advantage и обновление политики. Затем познакомимся с On-Policy Distillation (OPD) и посмотрим, как Student (ученик) на собственном распределении состояний постоянно получает от Teacher (учителя) указания по каждому токену. Наконец, на примерах Search-R1 и ReTool расширим тот же фреймворк обучения на поисковик и интерпретатор кода и проведём две работающие практики Agentic RL.
flowchart LR
P["Текущая политика:<br/>генерирует траектории"] --> G["Групповая выборка:<br/>G ответов на prompt"]
G --> E["Среда / Teacher:<br/>награда за результат<br/>или оценка каждого токена"]
E --> U["Обновление политики:<br/>logprob · advantage · update"]
U --> P
Рисунок 8.1. Структура восьмой главы (изображение в оригинале). Подзаголовок рисунка: «от базовой оптимизации политики к интерактивному агенту; все четыре раздела используют одну и ту же линию on-policy обучения». Ниже скелета — четыре карточки, «два вида сигнала обучения + два вида сред для агента»: 8.1 GRPO — групповое относительное обучение (много выборок на одну задачу, преимущество строится внутри группы; проверяемая награда за результат; основа оптимизации политики; «базовый алгоритм»); 8.2 OPD — дистилляция на траекториях Student (Teacher даёт плотную обратную связь по каждому токену; on-policy дистилляция; reverse KL; «передний край»); 8.3 Search-R1 — искать и рассуждать попеременно (запрос, наблюдение, новое решение; среда с поисковым инструментом; награда за многоходовую траекторию; «практика Agentic RL»); 8.4 ReTool — стратегическое использование кода (исполнить, наблюдать, исправиться; среда с интерпретатором кода; обратная связь об ошибках и восстановление; «практика Agentic RL»). Пунктир под карточками: «Search-R1 и ReTool переиспользуют скелет выборки, награды и обновления из GRPO и заменяют только слой взаимодействия со средой». Внизу: «учебная реализация на PyTRIO · rollout / logprob / advantage / update».
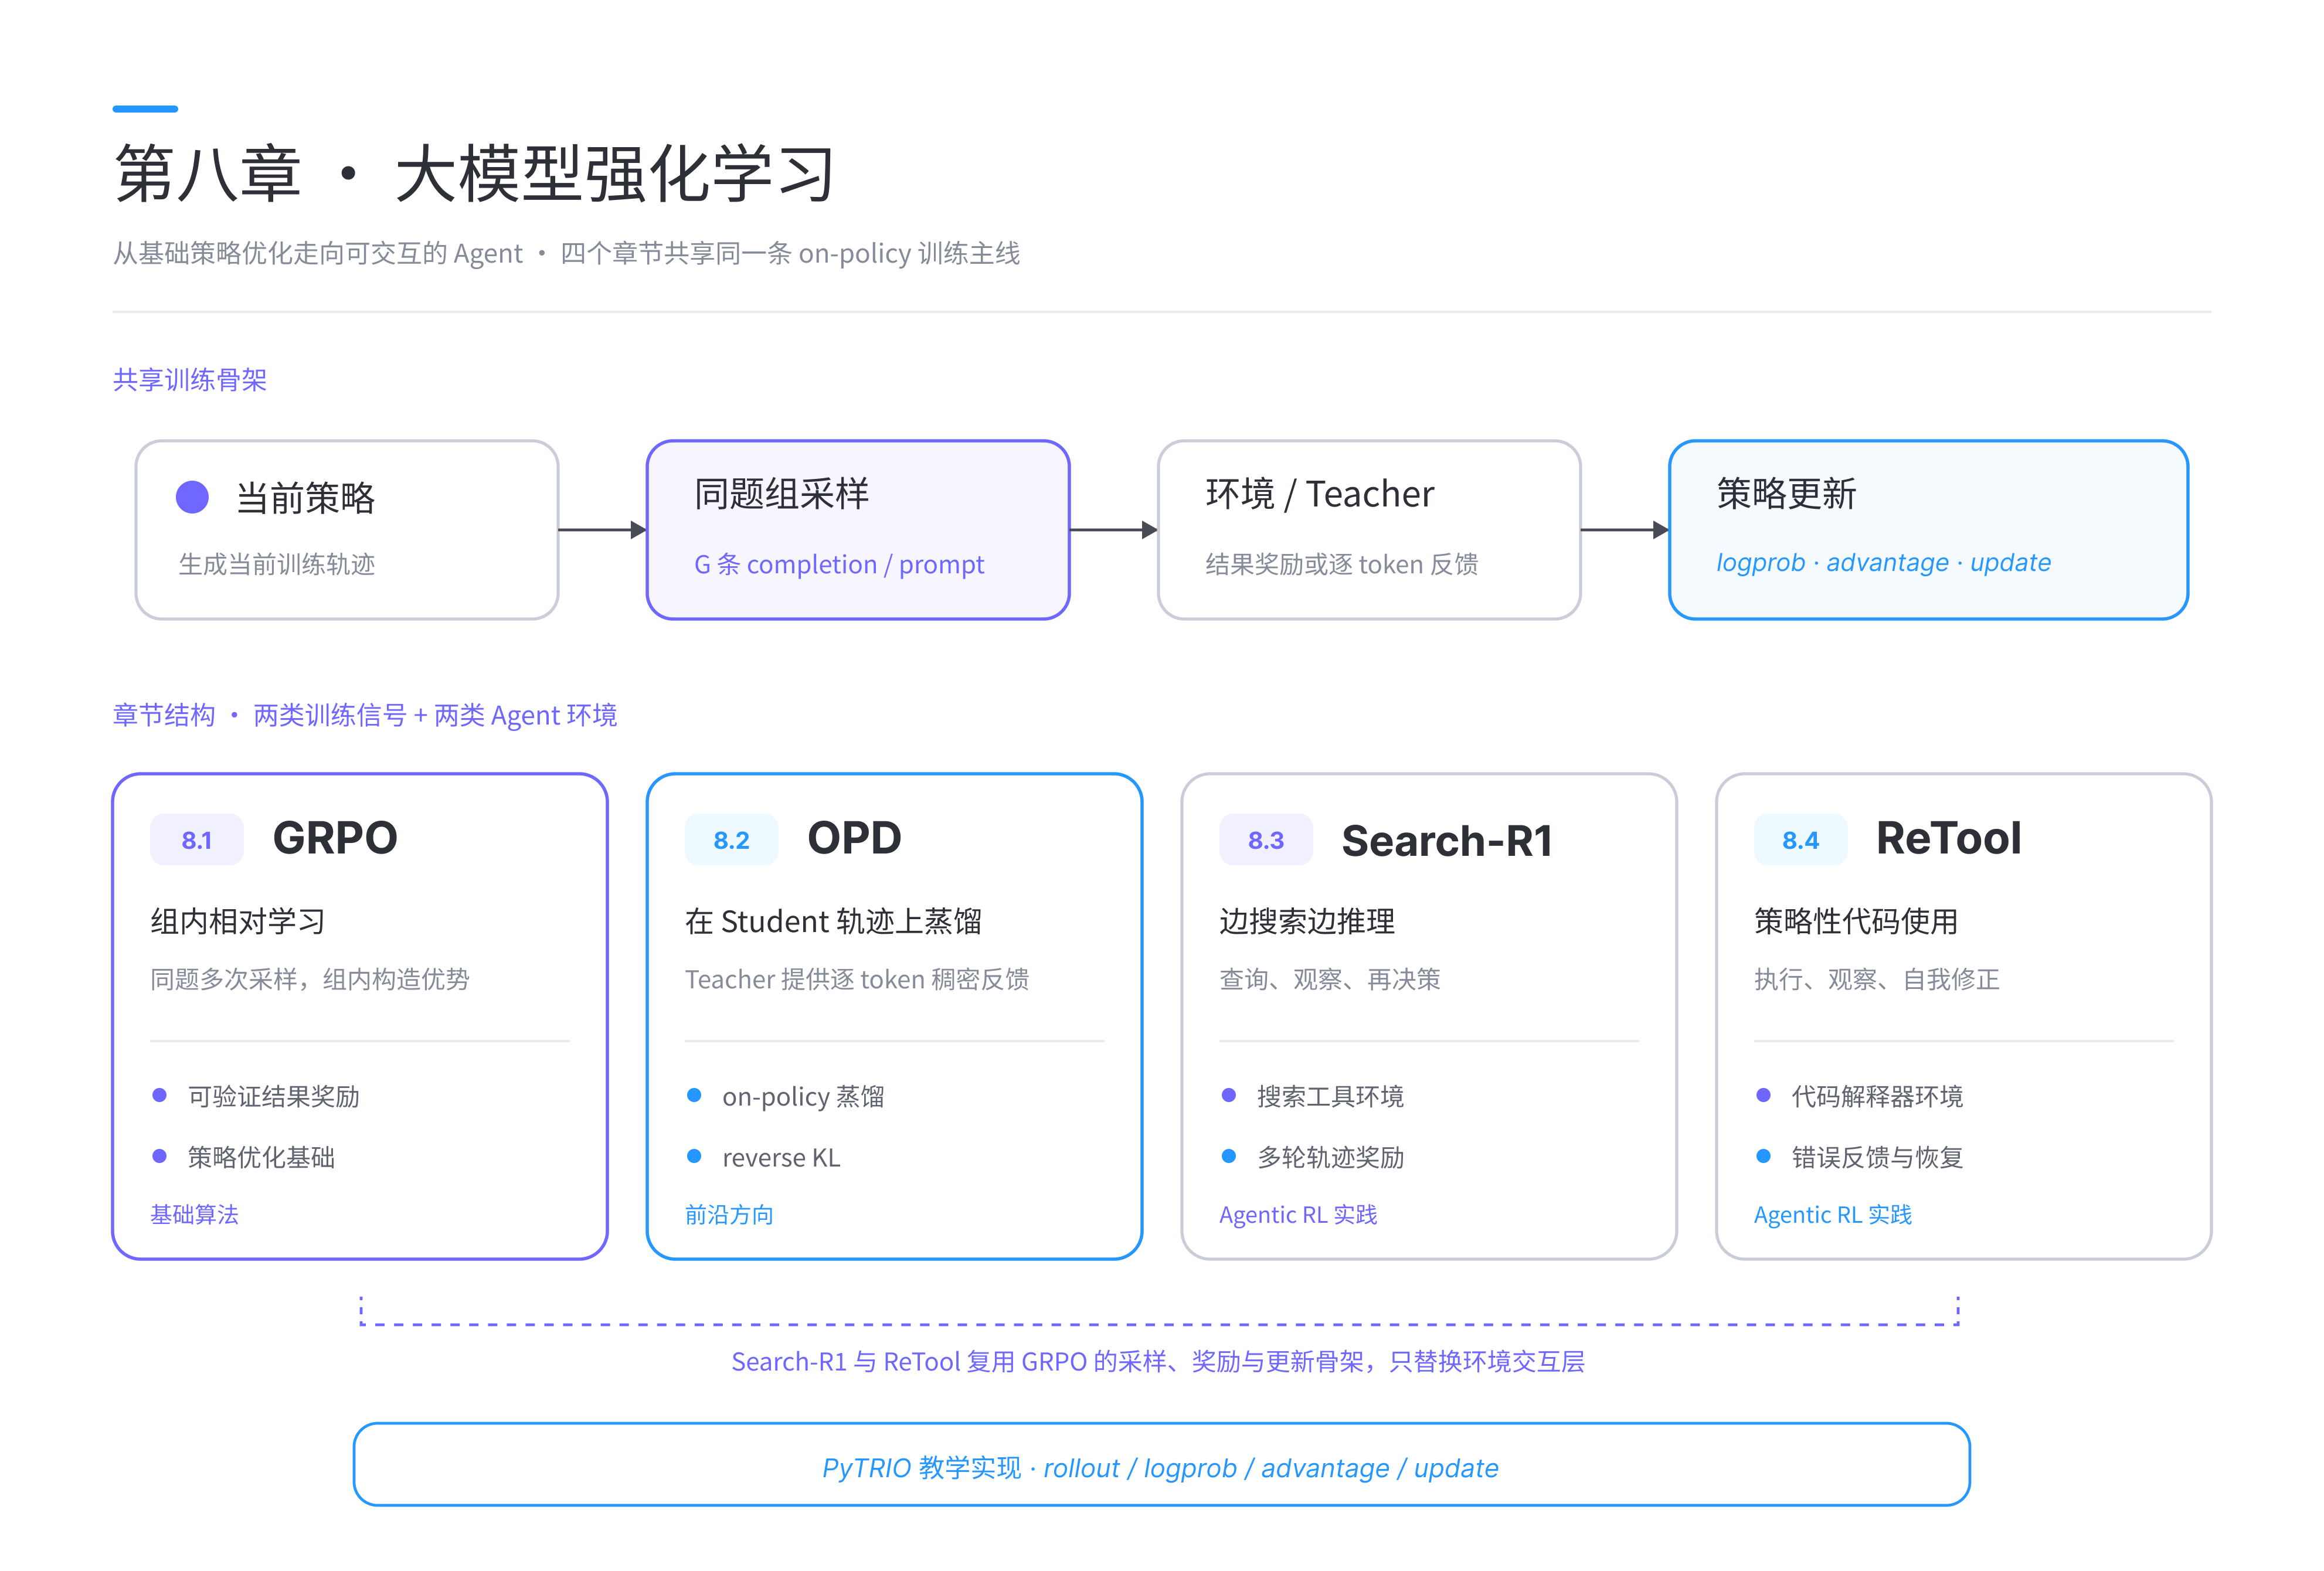
Все примеры главы используют PyTRIO 0.2.6. PyTRIO связывает локальные обработку данных, взаимодействие со средой и управление обучением с удалёнными генерацией (сэмплированием) модели, прямым и обратным проходами и управлением весами. Задачи у четырёх примеров разные, но основная цепочка всегда сводится к следующему:
- текущей политикой сгенерировать одну траекторию или группу траекторий;
- по результату или по отзыву Teacher посчитать сигнал обучения;
- выровнять prompt, response, logprob старой политики и advantage в структуру
Datum; - вызвать
forward_backward()иoptim_step(), чтобы обновить политику; - обновить клиент сэмплирования, чтобы следующий rollout шёл уже на новых весах.
Код к главе лежит в docs/chapter8. Установите общие зависимости из корня репозитория:
uv venv --python 3.13source .venv/bin/activateuv pip install -r docs/chapter8/requirements.txttrio loginСписок моделей, которые поддерживает сервис PyTRIO, постоянно обновляется; перед настоящим экспериментом текущий список можно посмотреть так:
import pytrio as trio
service_client = trio.ServiceClient()print(service_client.get_supported_models())
Дополнительное чтение: если вы хотите узнать больше алгоритмов Agentic RL и запускаемых практик, читайте другой открытый проект автора — agentic-rl-lab. Кроме материала этой главы, там есть разборы принципов, код обучения и журналы экспериментов для OPSD, DAPO, GSPO, ALFWorld и других алгоритмов и сред.
Примечание: автор выбрал для примеров главы PyTrio, а не Verl, чтобы снизить инженерный порог и стоимость экспериментов в Agentic RL. При минимальных пробных настройках из текста автор старается уложить базовые эксперименты всех четырёх примеров в 200 юаней, чтобы читатель своими руками прошёл замкнутый цикл rollout, reward, advantage и обновления политики. Реальная стоимость зависит от модели, длины генерации, числа шагов обучения и масштаба оценки.
8.1 GRPO
Заголовок раздела «8.1 GRPO»Источник кода: раздел составлен по файлам
01-demo-sync.pyи02-demo-async.pyиз открытого репозитория автора agentic-rl-lab/01-grpo. В тексте по частям разобрана синхронная версия01-demo-sync.py; асинхронная оставлена как полная сопутствующая реализация.
GRPO впервые систематически предложили в DeepSeekMath. Он сохраняет идею on-policy обновления из PPO, но относительное преимущество оценивает по группе ответов на одну и ту же задачу, и поэтому обходится без отдельно обучаемой Value Model (модели ценности). Для математики, кода и логики с проверяемыми ответами этот метод может прямо использовать награду за результат; он стал одним из самых распространённых базовых алгоритмов RL для больших моделей.
8.1.1 От языковой модели к политике обучения с подкреплением
Заголовок раздела «8.1.1 От языковой модели к политике обучения с подкреплением»Авторегрессионная языковая модель получает prompt и по очереди генерирует последовательность токенов . С точки зрения вероятностного моделирования вероятность полного ответа можно записать так:
где — политика языковой модели с параметрами . Если поместить языковую модель в рамки обучения с подкреплением, получится соответствие из таблицы 8.1.
| Понятие RL | Что это для большой языковой модели |
|---|---|
| Состояние | prompt и уже сгенерированные токены |
| Действие | следующий токен |
| Политика | распределение вероятностей модели по следующему токену |
| Траектория | полный ответ или многоходовое взаимодействие с вызовами инструментов |
| Среда | проверяльщик ответов из датасета, поисковик, интерпретатор кода и т. п. |
| Награда | правильность ответа, формат, результат выполнения инструмента и другая обратная связь |
Таблица 8.1. Соответствие понятий RL и языковой модели.
Одну генерацию модели обычно называют rollout. Цель обучения — повысить вероятность действий из траекторий с высокой наградой и одновременно понизить вероятность действий из траекторий с низкой. Самая наглядная форма градиента политики:
где — функция преимущества (advantage). Положительное преимущество значит, что траекторию стоит поощрить; отрицательное — что текущей политике нужно реже делать подобное.
Пространство действий большой модели — весь словарь, а один ответ может содержать от сотен до тысяч токенов. При обучении нужно ещё и ограничивать, насколько сильно меняется политика, чтобы одно обновление не разрушило уже имеющиеся способности модели. Поэтому по-настоящему трудная часть обычно сводится к двум вопросам: как получить устойчивый advantage и как безопасно обновлять политику с его помощью.
Читаем формулу (от переводчика). — это сумма логарифмов вероятностей всех токенов ответа. Градиент этой суммы показывает, куда сдвинуть веса, чтобы ответ стал вероятнее. Умножение на решает направление: при шагаем «к» этому ответу, при — «от» него, при ответ на обучение не влияет.
8.1.2 От PPO к GRPO
Заголовок раздела «8.1.2 От PPO к GRPO»PPO обычно использует Value Model, чтобы оценить ценность состояния , и уже вместе с отдачей вычисляет advantage. В сценарии больших моделей Value Model часто сравнима по размеру с моделью-политикой — это дополнительные затраты видеопамяти, обучения и синхронизации. Ошибки оценки ценности к тому же переходят в обновление политики.
GRPO вместо этого сравнивает ответы внутри группы. Для задачи сначала берут ответов из старой политики :
Проверяльщик выдаёт каждому награду . Классический GRPO стандартизирует награды средним и стандартным отклонением внутри группы:
Тогда в одной задаче ответы с высоким баллом получают положительный advantage, а с низким — отрицательный. Трудность самой задачи гасится групповой базой (baseline), и политика может сосредоточиться на том, «какой способ генерации лучше при одинаковых условиях».
Рисунок 8.2. Групповая выборка и обновление политики в GRPO
(изображение в оригинале).
Левая половина — «групповое относительное преимущество»: одна задача → 8 траекторий с наградами
, , , , , , ,
; среднее группы ; формула , «advantage
траектории делят все её токены ответа». Итог: — поощрить; — подавить;
— подавить сильнее; «одинаковые награды в группе → все → полезного градиента нет».
Правая половина — «потокенная маска потерь» для многоходовой траектории system + user → assistant (поиск, рассуждение)
→ tool (наблюдение) → assistant (итоговый ответ): advantage ; старые вероятности , из rollout, ,
из rollout; маска обучения ; целевые токены строго сдвинуты на один вправо. Вывод: importance_sampling
даёт вклад в loss только на токенах ассистента с advantage ; токены system, user и tool — только контекст;
«награда принадлежит траектории, а advantage по маске превращается в потокенный сигнал».
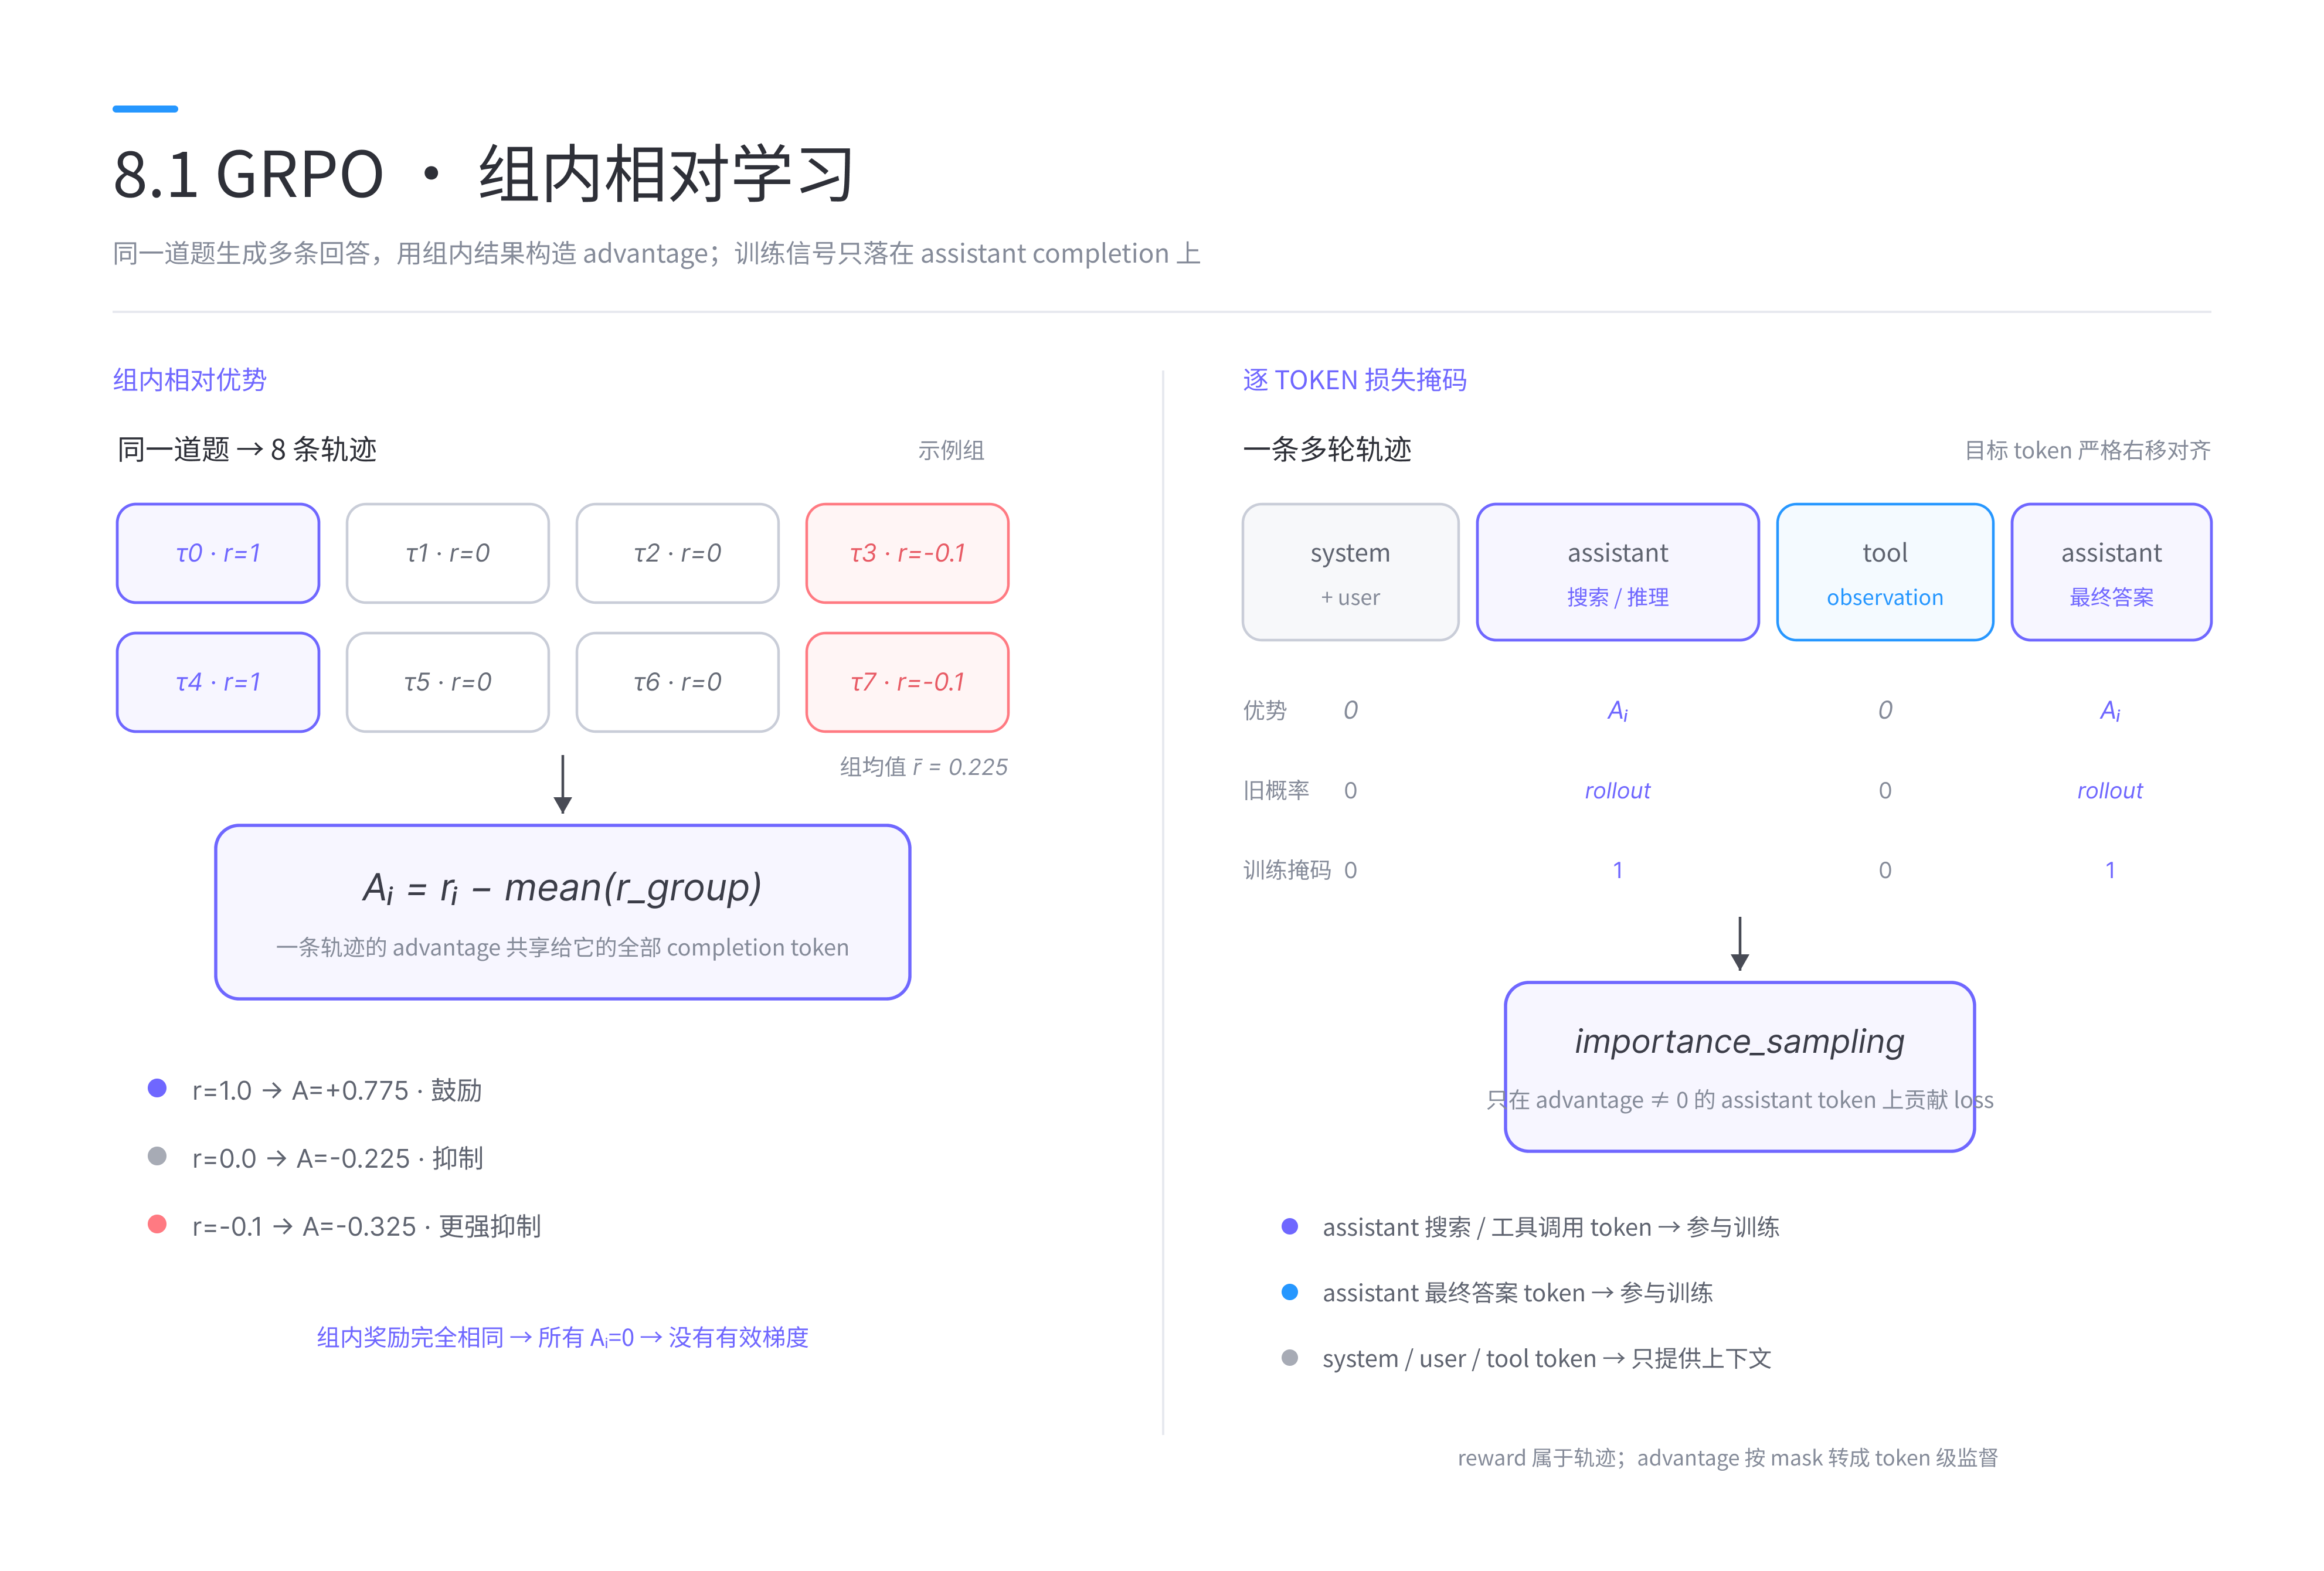
Например, на одну математическую задачу взяли 4 ответа, и правило-проверяльщик выдал награды . Среднее по группе ; если только вычесть среднее, четыре advantage будут:
Два правильных ответа поощряются, два неправильных подавляются. Чтобы напрямую показать групповую базу, код этой главы по умолчанию использует:
В полном эксперименте можно добавить и нормировку на стандартное отклонение. Обе записи выражают одну идею сравнения внутри группы, но масштаб градиента у них разный, поэтому при сравнении экспериментов способ вычисления advantage нужно зафиксировать.
Пример (от переводчика). Для стандартное отклонение (по генеральной совокупности) равно , и с нормировкой advantage станут — вдвое больше, чем без неё. Для группы : среднее , без нормировки , std , с нормировкой . Нормировка сильнее «раздувает» редкий успех на трудной задаче — об этом смещении и о вариантах вроде Dr. GRPO — урок 6.4.3.
Здесь есть легко упускаемый вырожденный случай. Когда все ответы группы правильные или все неправильные, каждый равен 0, и такие данные не дают полезного градиента политики. Если в журнале обучения доля таких вырожденных группвырожденная группаEN degenerate group (zero-variance group)Все ответы группы получили одинаковую награду — все преимущества нулевые, градиента нет. долго остаётся высокой, обычно нужно поменять сложность задач, температуру сэмплирования, исходную модель или размер группы (group size).
8.1.3 Награда и обучение с проверяемыми наградами
Заголовок раздела «8.1.3 Награда и обучение с проверяемыми наградами»GRPO отвечает только за то, чтобы превратить награды внутри группы в относительные преимущества; что модель в итоге выучит, по-прежнему определяет качество награды. В математике и коде обычно можно использовать детерминированный проверяльщик на правилах; такое обучение называют Reinforcement Learning with Verifiable Rewards (RLVR, обучение с подкреплением на проверяемых наградахпроверяемое вознаграждениеEN verifiable reward (RLVR)).
В этой главе пример — GSM8K: модель должна записать итоговое число внутри \boxed{}. Минимальная логика проверки такая:
def extract_boxed(text: str) -> str | None:    matches = re.findall(r"\\boxed\{([^}]+)\}", text)    if not matches:        return None    return matches[-1].strip()

def normalize_answer(text: str) -> str:    return text.replace(",", "").strip().rstrip(".")

def grade_answer(response: str, ground_truth: str) -> float:    answer = extract_boxed(response)    if answer is None:        return 0.0    return 1.0 if normalize_answer(answer) == normalize_answer(ground_truth) else 0.0
Награда по правилам проста, дешева и вычисляется повторяемо. Но если в правилах есть дыра, модель может научиться пользоваться ею, чтобы получать высокий балл. Проектируя reward, проверьте как минимум следующее:
- Надёжно ли извлекается ответ: один и тот же правильный ответ может быть записан целым числом, десятичной дробью, обыкновенной дробью или числом с запятыми;
- Не перевешивает ли награда за формат правильность: формат может быть только вспомогательным ограничением — неправильный ответ в правильном формате не должен получать основную награду;
- Надёжен ли эталонный ответ: ошибочная метка даёт модели сигнал обучения с обратным знаком;
- Не раскрывает ли проверяльщик информацию: модель не должна прямо видеть эталонный ответ через prompt или вывод инструмента;
- Различает ли награда ответы: множество групп «все 0» или «все 1» лишают GRPO сигнала относительного сравнения.
До настоящего обучения полезно сохранить rollout исходной модели и офлайн вручную проверить партию троек «ответ — извлечённый результат — reward». Этот шаг часто выявляет проблемы раньше, чем подбор скорости обучения.
Примечание переводчика. Посмотрите на регулярное выражение
\\boxed\{([^}]+)\}: оно останавливается на первой}. Ответ\boxed{\frac{1}{2}}превратится в\frac{1— это и есть «ненадёжное извлечение» из первого пункта списка. Для GSM8K (ответы — целые числа) этого хватает; для MATH используют библиотеки вродеmath-verify(она есть вrequirements.txtглавы и применяется в ReTool). Почему модели «взламывают» награду — взлом наградывзлом награды (reward hacking)EN reward hackingПолитика находит способ получить высокую награду, не делая того, что задумали люди., урок 6.4.2.
8.1.4 Отношение вероятностей политик и функция потерь обновления
Заголовок раздела «8.1.4 Отношение вероятностей политик и функция потерь обновления»Rollout сгенерирован старой политикой, а обновление параметров делается на текущей. Для -го токена -го ответа определим отношение вероятностей новой и старой политики:
Самую прямую цель с выборкой по значимостивыборка по значимости (importance sampling)EN importance samplingПеревзвешивание сэмплов старой политики отношением π_new / π_old — основа PPO. (importance sampling) можно записать так:
Если отношение вероятностей слишком далеко отходит от 1, градиент могут определять немногие токены. PPO ограничивает размер одного обновления «обрезанной» целью:
Классическая цель GRPO в DeepSeekMath использует обрезку в стиле PPO и добавляет ограничение по KL-расхождению
с эталонной политикой. Синхронная версия этой главы 01-demo-sync.py по умолчанию выбирает встроенную в PyTRIO потерю
importance_sampling — так удобнее увидеть связь между old_logprobs, advantages и текущей политикой; если поменять
аргумент командной строки на --loss-fn ppo, будет использоваться встроенная потеря PPO.
Поэтому GRPO и PPO нужно понимать на разных уровнях:
- GRPO описывает, как делать групповую выборку на одну задачу и получать advantage из наград внутри группы;
- importance sampling или PPO описывают, как превратить advantage в градиент политики.
Читаем формулу (от переводчика). Пусть старая политика дала токену вероятность 0,20, а после нескольких шагов текущая даёт 0,30: . При и обычная цель даёт , обрезанная — : дальше тянуть вероятность этого токена вверх уже невыгодно, градиент по нему равен нулю. Если же (политика ещё не менялась — так бывает на первом шаге после свежего rollout), обе цели совпадают с обычным градиентом политики. Обрезка — урок 6.0.3.
8.1.5 Синхронный GRPO с нуля
Заголовок раздела «8.1.5 Синхронный GRPO с нуля»В этом разделе мы в порядке выполнения синхронного скрипта разберём по частям полный код обучения GRPO. В папке к разделу два файла, каждый запускается сам по себе:
| Файл | Способ выполнения | Назначение |
|---|---|---|
01-demo-sync.py | синхронный | основная учебная линия, разобранная в тексте по частям |
02-demo-async.py | асинхронный | параллельно обрабатывает rollout разных prompt одного батча |
Оба файла используют одинаковые данные, reward, advantage, Datum и loss. Ниже разобрана только синхронная версия: читатель сначала поймёт одно полное обновление, следуя линейному потоку управления.
(1) Задаём конфигурацию обучения и данные rollout
Скрипт оставляет только две потери обновления политики, которые прямо предоставляет PyTRIO, — importance_sampling
и ppo:
LOSS_FNS = ("importance_sampling", "ppo")GRPOConfig собирает в одном месте параметры модели, сэмплирования, оптимизатора и SwanLab. RolloutSample хранит
всё, что понадобится при обучении по одному ответу (completion):
@dataclassclass RolloutSample:    """Один результат сэмплирования и logprobs старой политики, нужные для importance_sampling."""
    tokens: list[int]    logprobs: list[float]    text: str    reward: float    advantage: float
logprobs здесь обязательно должны быть взяты у Student во время rollout. Пересчитанные после обновления политики
logprob — это уже logprob новой политики, и вероятности старой политики они не заменят. parse_args() превращает
аргументы командной строки в GRPOConfig и через choices=LOSS_FNS разрешает только эти две встроенные потери.
Примечание переводчика. По умолчанию в
parse_args()заданы: модельQwen/Qwen3.5-4B, LoRA ранга 32, 10 шагов, 4 задачи в батче, группа из 4 ответов, до 1024 новых токенов, температура 1,0, Adam со скоростью обучения 4e-5 и . Модель политики обучается именно как LoRA-адаптер (create_lora_training_client).
(2) Загружаем GSM8K и строим prompt
Эталонный ответ GSM8K стоит после ####. От модели же требуется записать итоговое число внутри \boxed{}. Код делает
одинаковую лёгкую нормализацию ответов с обеих сторон:
def extract_boxed(text: str) -> str | None:    """Берём последний \\boxed{...} как итоговый ответ модели."""    matches = re.findall(r"\\boxed\{([^}]+)\}", text)    if not matches:        return None    return matches[-1].strip()

def normalize_answer(text: str) -> str:    """Ответ GSM8K нормализуем слегка, чтобы 1,000 и 1000 не считались разными."""    return text.replace(",", "").strip().rstrip(".")

def grade_answer(response: str, ground_truth: str) -> float:    """1, если ответ в boxed точно совпадает с эталоном, иначе 0."""    answer = extract_boxed(response)    if answer is None:        return 0.0    return 1.0 if normalize_answer(answer) == normalize_answer(ground_truth) else 0.0

def extract_gsm8k_answer(answer_text: str) -> str:    """Итоговый ответ GSM8K стоит после `####`."""    match = re.search(r"####\s*(.+)", answer_text)    if match is None:        raise ValueError(f"No GSM8K final answer found: {answer_text!r}")    return normalize_answer(match.group(1))
build_prompt() передаёт один few-shot пример и текущую задачу в собственный шаблон чата модели, а затем кодирует
в токены:
def build_prompt(tokenizer: Any, question: str) -> list[int]: messages = [ *FEWSHOT_PREFIX, {"role": "user", "content": question + QUESTION_SUFFIX}, ] prompt_text = tokenizer.apply_chat_template( messages, tokenize=False, add_generation_prompt=True, enable_thinking=False, ) prompt_tokens = tokenizer.encode(prompt_text, add_special_tokens=False) if not prompt_tokens: raise ValueError("Prompt tokens are empty") return prompt_tokensОбучающий набор загружается через load_dataset("openai/gsm8k", "main", split="train"). pick_batch() в коротких
пробных запусках разрешает «прокручивать» данные по кругу; с флагом --all-data каждый обучающий пример используется
не больше одного раза.
Примечание переводчика.
QUESTION_SUFFIXв файле — « Provide a numerical answer without units, written inside\boxed{}.» («Дай числовой ответ без единиц измерения внутри\boxed{}»), а few-shot пример — вопрос «How many r’s are in strawberry?» с образцовым ответом.enable_thinking=Falseвыключает у Qwen3.5 режим рассуждений в<think>, чтобы ответы были короче и дешевле.
(3) Сэмплируем группу ответов на одну задачу
run_rollout_group() — ядро rollout в GRPO. Один вызов sample() принимает один prompt и через num_samples=group_size
возвращает группу ответов на эту задачу:
def run_rollout_group(    sampling_client: Any,    tokenizer: Any,    prompt_tokens: list[int],    ground_truth: str,    sampling_params: trio.SamplingParams,    group_size: int,) -> list[RolloutSample]:    result = sampling_client.sample(        prompt=trio.ModelInput.from_ints(prompt_tokens),        num_samples=group_size,        sampling_params=sampling_params,        return_text=True,    ).result()
    rewards: list[float] = []    raw_samples: list[tuple[list[int], list[float], str]] = []
    for sequence in result.sequences:        text = sequence.text        if text is None:            text = tokenizer.decode(sequence.tokens, skip_special_tokens=True)
        tokens = list(sequence.tokens)        logprobs = [float(value) for value in sequence.logprobs]        if len(tokens) != len(logprobs):            raise ValueError(                f"Generated token/logprob length mismatch: "                f"{len(tokens)} != {len(logprobs)}"            )
        reward = grade_answer(text, ground_truth)        rewards.append(reward)        raw_samples.append((tokens, logprobs, text))
    mean_reward = sum(rewards) / len(rewards)    return [        RolloutSample(            tokens=tokens,            logprobs=logprobs,            text=text,            reward=reward,            advantage=reward - mean_reward,        )        for (tokens, logprobs, text), reward        in zip(raw_samples, rewards, strict=True)    ]
Этот код по очереди делает четыре вещи:
- сохраняет токены ответа (completion token);
- сохраняет logprob, который старая политика при сэмплировании дала каждому токену ответа;
- правилом-проверяльщиком получает reward 0 или 1;
- вычисляет
advantage = reward - mean_reward.
Когда все ответы группы правильные или все неправильные, каждый advantage равен 0. Главный цикл помечает такую группу как вырожденную и пропускает её, чтобы не отправлять Datum без сигнала обучения.
(4) Строим Datum PyTRIO со сдвигом вправо
Авторегрессионная модель по токену в текущей позиции предсказывает следующий. Пусть длина prompt — , длина ответа — ; скрипт строит четыре массива, каждый длины :
def build_grpo_datum(    prompt_tokens: list[int],    sample: RolloutSample,) -> trio.Datum:    if not sample.tokens:        raise ValueError("Cannot train on an empty completion")
    observation_len = len(prompt_tokens) - 1    input_tokens = prompt_tokens + sample.tokens[:-1]    target_tokens = [0] * observation_len + sample.tokens    padded_logprobs = [0.0] * observation_len + sample.logprobs    padded_advantages = (        [0.0] * observation_len        + [sample.advantage] * len(sample.tokens)    )
    if not (        len(input_tokens)        == len(target_tokens)        == len(padded_logprobs)        == len(padded_advantages)    ):        raise ValueError("GRPO datum fields must have the same token length")
    return trio.Datum(        model_input=trio.ModelInput.from_ints(input_tokens),        loss_fn_inputs={            "target_tokens": np.asarray(target_tokens, dtype=np.int64),            "logprobs": np.asarray(padded_logprobs, dtype=np.float32),            "advantages": np.asarray(padded_advantages, dtype=np.float32),        },    )
Участок prompt только даёт контекст, поэтому target_tokens, logprobs и advantages там заполнены нулями. На участок
ответа кладутся настоящие целевые токены, logprob старой политики и групповой advantage, общий для всего ответа.
Пример: 3 токена prompt и 2 токена ответа:
prompt       = [x1, x2, x3]completion   = [y1, y2]
model_input  = [x1, x2, x3, y1]target       = [ 0,  0, y1, y2]old_logprob  = [ 0,  0, l1, l2]advantage    = [ 0,  0,  A,  A]
С позиции последнего токена prompt x3 начинается предсказание y1, поэтому длина маски prompt —
len(prompt_tokens) - 1.
Примечание переводчика. Ноль в
targetна позициях prompt — не «токен номер 0», а заглушка: эти позиции выключаются нулевым advantage, и в loss они ничего не вносят. Итоговая длина: , как в примере. Тот же приём «маска потерь на prompt» вы видели в SFT (урок 6.1.2), только здесь вместо метки -100 работает нулевой advantage.
(5) Выбираем importance sampling или PPO
importance_sampling и ppo используют один и тот же батч Datum GRPO — нужно только переключить loss_fn. Обе потери
реализованы внутри PyTRIO:
fwd_bwd_future = training_client.forward_backward( datums, loss_fn=config.loss_fn,)При выборе importance_sampling обучение прямо умножает отношение вероятностей новой и старой политики на advantage.
При выборе ppo PyTRIO применяет к тем же данным обрезку PPO. Rollout, reward и построение группового advantage
в GRPO не меняются.
(6) Собираем один шаг синхронного обучения
main() сначала создаёт клиент обучения, параметры сэмплирования и оптимизатор:
service_client = trio.ServiceClient()training_client = service_client.create_lora_training_client(    base_model=config.base_model,    rank=config.lora_rank,)tokenizer = training_client.get_tokenizer()
sampling_params = trio.SamplingParams(    max_tokens=config.max_tokens,    temperature=config.temperature,    top_p=config.top_p,    stop=get_stop_sequences(tokenizer),)adam_params = trio.AdamParams(    learning_rate=config.learning_rate,    beta1=config.beta1,    beta2=config.beta2,)
На каждом шаге (step) сначала из текущих обучаемых весов создаётся новый sampler (клиент сэмплирования), затем по порядку задач выполняется rollout:
for step in range(effective_steps):    batch_rows = pick_batch(        train_data,        step,        config.batch_size,        config.all_data,    )    sampling_client = (        training_client.save_weights_and_get_sampling_client()    )
    datums: list[trio.Datum] = []    prompt_mean_rewards: list[float] = []    rollout_lengths: list[int] = []    n_degenerate = 0
    for row in tqdm(        batch_rows,        desc=f"GRPO step {step}",        unit="prompt",    ):        prompt_tokens = build_prompt(tokenizer, row["question"])        ground_truth = extract_gsm8k_answer(row["answer"])        rollout_samples = run_rollout_group(            sampling_client=sampling_client,            tokenizer=tokenizer,            prompt_tokens=prompt_tokens,            ground_truth=ground_truth,            sampling_params=sampling_params,            group_size=config.group_size,        )
        rewards = [sample.reward for sample in rollout_samples]        prompt_mean_rewards.append(sum(rewards) / len(rewards))        rollout_lengths.extend(            len(sample.tokens) for sample in rollout_samples        )
        if all(            sample.advantage == 0.0            for sample in rollout_samples        ):            n_degenerate += 1            continue
        for sample in rollout_samples:            datums.append(                build_grpo_datum(prompt_tokens, sample)            )
Место, где обновляется sampler, воплощает ограничение on-policy: после обновления на шаге шаг генерирует траектории заново, уже на новых весах. Синхронная версия, отправив задачи прямого-обратного прохода и оптимизации, явно ждёт их результатов:
optim_future = training_client.optim_step(adam_params)fwd_bwd_result = fwd_bwd_future.result()optim_future.result()loss_metrics = dict(fwd_bwd_result.metrics)В конце скрипт считает среднюю награду батча, долю вырожденных групп, среднюю длину генерации, число полезных обучающих
токенов и loss_mean, а также сохраняет LoRA-веса, пригодные для сэмплирования:
final_weights = training_client.save_weights_for_sampler( name=run_name).result()print( f"Saved weights name: {run_name}, " f"path: {final_weights.path}")Примечание переводчика. Обратите внимание на порядок:
forward_backwardиoptim_stepотправляются на сервис почти одновременно (это «future» — обещание результата), а ждём мы их потом. Сервис выполняет их по очереди, поэтому шаг оптимизатора всё равно применится к только что посчитанным градиентам; зато сетевые задержки не складываются. Если в батче все группы вырожденные,datumsпуст — в файле этот случай обрабатывается отдельно, шаг пропускается.
8.1.6 Запуск синхронной и асинхронной версий
Заголовок раздела «8.1.6 Запуск синхронной и асинхронной версий»Сначала войдите в TRIO, затем из корня репозитория запустите пробный шаг синхронной версии:
trio login
python docs/chapter8/grpo/01-demo-sync.py \    --steps 1 \    --batch-size 1 \    --group-size 4 \    --max-tokens 512 \    --loss-fn importance_sampling \    --swanlab-mode disabled
Асинхронная версия использует точно такие же параметры обучения:
python docs/chapter8/grpo/02-demo-async.py \ --steps 1 \ --batch-size 4 \ --group-size 4 \ --max-tokens 512 \ --loss-fn importance_sampling \ --swanlab-mode disabledДанные алгоритма в асинхронной версии те же, меняется только способ выполнения:
| Этап обучения | Синхронная версия | Асинхронная версия |
|---|---|---|
| Rollout одной задачи | sample(...).result() | await sample_async(...) |
| Несколько задач в батче | обрабатываются по очереди | обрабатываются параллельно через asyncio.gather() |
| Обновление sampler | синхронный возврат | await save_weights_and_get_sampling_client_async() |
| Прямой-обратный проход | forward_backward(), затем .result() | forward_backward_async(), затем ещё раз await future |
| Оптимизатор | optim_step(), затем .result() | optim_step_async(), затем ещё раз await future |
| Точка входа | main(config) | asyncio.run(main(config)) |
Синхронная версия в тексте нужна, чтобы выработать интуицию алгоритма. Асинхронная подходит для настоящих экспериментов, где в батче несколько независимых prompt: параллельные удалённые запросы сокращают время последовательного ожидания.
При обучении в первую очередь смотрите на метрики, которые код действительно записывает:
| Метрика | Смысл | Тревожный признак |
|---|---|---|
reward | среднее по prompt батча от доли правильных ответов | долго не растёт — проверьте reward, сложность данных и скорость обучения |
frac_degenerate | доля групп «все правильно» или «все неправильно» | слишком высокая — не хватает полезного относительного преимущества |
rollout/avg_gen_len | средняя длина ответа в токенах | близка к max_tokens — проверьте обрезку |
train_tokens | число токенов ответов с ненулевым advantage | 0 — на этом шаге нет сигнала обучения |
loss_mean | основная потеря текущего обновления политики | резко скачет — проверьте скорость обучения и отношение вероятностей |
Итак, у нас есть первая линия обучения главы: текущая политика сэмплирует группами, среда-правило выдаёт награду за результат, сравнение внутри группы даёт advantage, PyTRIO обновляет политику. Следующий раздел, OPD, сохранит тот же on-policy поток данных, но заменит сигнал обучения на отзыв Teacher о каждом токене.
От переводчика: как пройти раздел без PyTRIO
Заголовок раздела «От переводчика: как пройти раздел без PyTRIO»- Посчитайте вручную. Для групп , и найдите advantage без нормировки и с нормировкой. Проверьте числа с рисунка 8.2 (, , ).
- Datum на бумаге. Для prompt из 5 токенов и ответа из 3 выпишите четыре массива
build_grpo_datum(длина 7). - Проверяльщик. Скопируйте
extract_boxed,normalize_answer,grade_answerи проверьте на строках"\\boxed{1,000}","\\boxed{1000.}","\\boxed{\\frac{1}{2}}","ответ 42". Какие случаи ломаются? - Тот же алгоритм локально. Часть 2 урока 6.4.5 запускает GRPO
через TRL на ваших GPU. Сопоставьте:
num_generationsв TRL — этоgroup_size,reward_funcs—grade_answer,loss_type— выбор между вариантами потерь, аmax_completion_length—max_tokens.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| reinforcement learning | обучение с подкреплением |
| policy | политика |
| trajectory | траектория |
| rollout | генерация траектории (rollout) |
| reward | награда |
| advantage | преимущество |
| group-relative advantage | групповое относительное преимущество |
| value model | модель ценности (критик) |
| degenerate group | вырожденная группа |
| verifiable reward | проверяемая награда |
| grader / verifier | проверяльщик |
| policy ratio | отношение вероятностей политик |
| importance sampling | выборка по значимости |
| clipping | обрезка |
| reference policy | эталонная политика |
| synchronous / asynchronous | синхронный / асинхронный |