Happy-LLM, глава 8.4: ReTool и итоги главы
Полный перевод раздела 8.4 и заключения восьмой главы книги Datawhale «Строим большую модель с нуля»: RL для стратегического использования интерпретатора кода — протокол инструмента, маска вывода интерпретатора, награда ±1 через math-verify, PPO с асимметричной обрезкой, песочница и её пределы, оценка на AIME 2025.
8.4 ReTool
Заголовок раздела «8.4 ReTool»Источник кода: раздел составлен по полной многофайловой реализации из открытого репозитория автора agentic-rl-lab/05-retool. Текст следует настоящей цепочке вызовов:
prepare_data.py,protocol.py,sandbox.py,rollout.py,reward.py,train.py,eval.pyиanalysis.py.
Поисковый инструмент помогает модели получать внешние знания, а интерпретатор кода — точно считать, выполнять символьные преобразования и проверять перебором. Модель уже умеет вызывать инструмент Python по подсказке промпта или по данным обучения с учителем, но «умеет вызывать» ещё не значит «вызывает в нужный момент». Одни задачи быстрее решить в уме, для других удобнее написать короткую программу, а иногда код падает и его нужно исправить по сообщению об ошибке.
ReTool учит такому стратегическому использованию инструмента обучением с подкреплением. Модель сама решает, вызывать ли интерпретатор кода, какой код писать, как читать результат выполнения и когда дать итоговый ответ. Среда даёт награду только за итоговый математический ответ, и решения об инструментах в успешных траекториях усиливаются вместе со всей траекторией.
Предупреждение о безопасности: сопутствующий
sandbox.py— это лишь локальный subprocess с ограничениями ресурсов, а не надёжная защищённая песочница. Код, сгенерированный моделью, всё равно может читать файлы, доступные текущей учётной записи, наследует переменные окружения и имеет доступ к сети. Настоящее обучение нужно проводить в одноразовом контейнере, виртуальной машине с минимальными правами или специальном сервисе-песочнице, убрав учётные данные PyTRIO, SwanLab, SSH и облачных сервисов.
Цепочка кода ReTool похожа на Search-R1, но среда вместо поискового сервиса — процесс Python:
prepare_data.py / data.py ↓ читаем математические задачи и эталонные ответыprotocol.py ↓ разбираем вызовы code_interpretersandbox.py ↓ выполняем код, возвращаем stdout / stderr / timeoutrollout.py ↓ дописываем результат выполнения и продолжаем генерациюreward.py ↓ проверяем последний \boxed{}train.py ↓ feedback mask, PPO, optim_stepeval.py / analysis.py ↓ сравнительная оценка: только текст против ReToolНиже мы снова пойдём по реальным вызовам функций, а не будем смотреть только на текстовый формат вызова инструмента.
8.4.1 От формата вызова инструмента к стратегии его использования
Заголовок раздела «8.4.1 От формата вызова инструмента к стратегии его использования»Типичная траектория ReTool:
User: Посчитай число целых решений, удовлетворяющих условию.
Assistant -> code_interpreter(    "count = ...\nprint(count)")Tool: 37
Assistant: По результату перебора ответ \boxed{37}
Если код содержит ошибку, модель может исправиться по traceback:
Assistant -> code_interpreter("print(sum(values))")Tool: NameError: name 'values' is not defined
Assistant -> code_interpreter(    "values = [...]\nprint(sum(values))")Tool: 128
Assistant: \boxed{128}
С точки зрения обучения с подкреплением траекторию вместе образуют код, ошибки выполнения, числовые результаты и итоговый ответ. Интерпретатор кода — это среда, вызовы инструмента и ответ на естественном языке, которые генерирует Assistant, — действия, а stdout или stderr — observation.
flowchart LR
P["Задача:<br/>сумма элементов<br/>списка [17, 23, 41, 47]"] --> C1["Вызов кода 1:<br/>print(sum(values))<br/>(действие)"]
C1 --> E["Ошибка выполнения:<br/>NameError: values<br/>is not defined (stderr)"]
E --> C2["Исправленный код 2:<br/>values=[17,23,41,47]<br/>print(sum(values))"]
C2 --> OK["Успех:<br/>stdout: 128"]
OK --> A["Итоговый ответ:<br/>128 — верно"]
Рисунок 8.5. Многоходовое выполнение кода и награда за результат в ReTool (изображение в оригинале). Подзаголовок: «код, stdout и сообщения об ошибках вместе образуют обучаемую многоходовую траекторию; награда за итоговый ответ обучает стратегию использования инструмента». Под верхней цепочкой: «сообщение об ошибке попадает в контекст, и политика по нему исправляет следующий вызов». Нижняя левая часть — interpreter feedback mask, надзор по токенам одной траектории: prompt , вызов кода , stderr , исправленный код , stdout , итоговый ответ ; «рассуждения ассистента, вызовы кода и итоговый ответ участвуют в обучении; stdout / stderr / timeout — только observation среды». Нижняя правая часть — «награда за итоговый результат»: итоговый ответ верен, reward = 1 → групповое преимущество ; «успешные вызовы и самоисправление усиливаются вместе». Внизу красная рамка: «граница безопасности: локальный subprocess — только для обучения; настоящее обучение — в изолированной песочнице, с лимитами ресурсов и сетевой политикой».
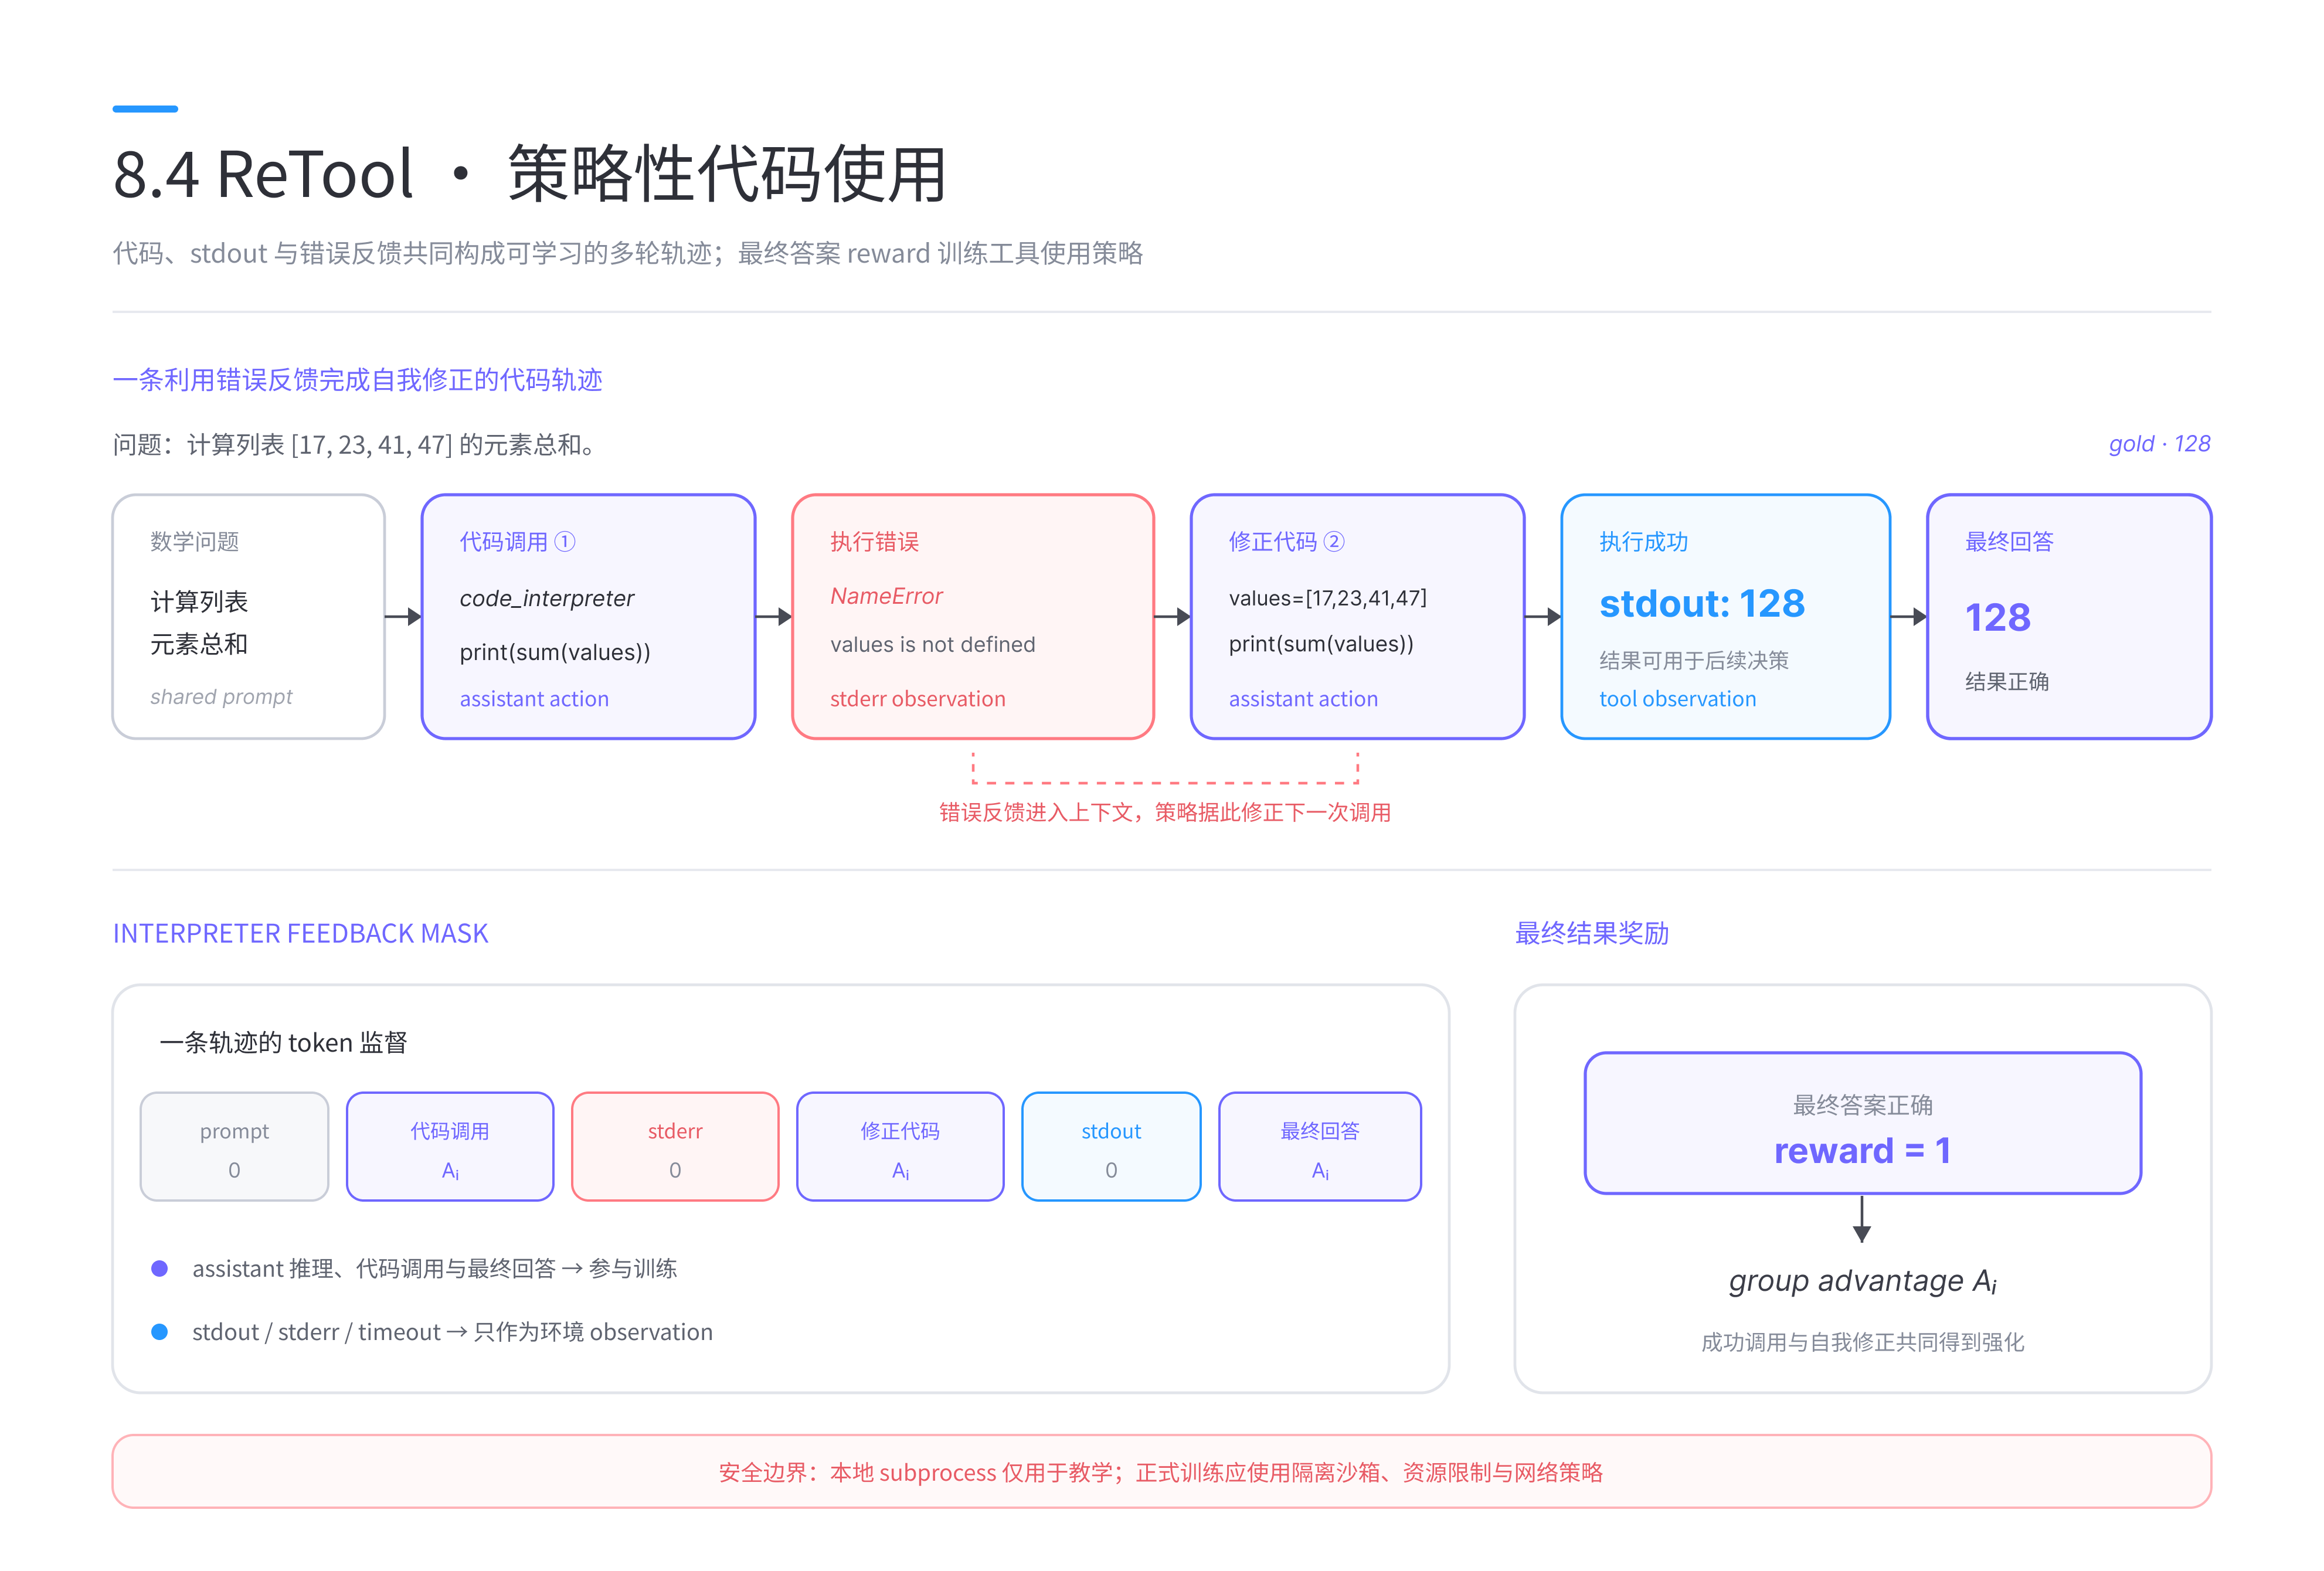
ReTool не нужно отдельно начислять баллы за «вызвал инструмент». Награда за итоговый ответ через advantage на уровне траектории передаётся предыдущим действиям с кодом. Так положительный сигнал получают только способы использования инструмента, которые действительно помогли решить задачу, а лишние или сбивающие с толку вызовы подавляются вместе с неудачными траекториями.
8.4.2 Cold-start, обучающие данные и протокол инструмента
Заголовок раздела «8.4.2 Cold-start, обучающие данные и протокол инструмента»Исходный ReTool состоит из двух этапов:
- Cold-start SFT (холодный старт): на траекториях с вызовами кода и результатами выполнения модель сначала осваивает протокол и базовую форму взаимодействия;
- Reinforcement Learning: модель сама делает rollout и по награде за итоговый ответ учится, когда и как использовать инструмент.
Холодный старт нужен, чтобы начальная политика выдавала определённую долю допустимых вызовов инструмента. Если исходная модель совсем не умеет выводить протокол инструмента, ранние траектории почти все неудачны, и GRPO трудно извлечь из сравнения внутри группы осмысленный сигнал для исследования.
Код этой главы берёт Qwen3.5, у которой уже есть собственная (native) способность к function calling, и сразу показывает обучение второго этапа на PyTRIO, поэтому отдельного процесса Cold-start SFT к нему не приложено. Это важная граница между учебной реализацией и настройками исходной статьи. Если заменить модель на исходную, не умеющую вызывать инструменты, сначала нужно подготовить данные для SFT, убедиться, что доля допустимых вызовов достигла уровня, пригодного для обучения, и только потом запускать RL.
Примечание переводчика. Это тот же рецепт, что у DeepSeek-R1: немного «холодных» данных SFT, чтобы задать формат, потом RL (урок 6.4.2). Проверить «пригодный уровень» просто: прогоните исходную модель на сотне задач и посчитайте долю ответов, где
parse_assistantвернулtoolилиanswer, а неinvalid, и долю групп, где есть хотя бы один правильный ответ.
Данные для RL взяты из DAPO-Math-17k. Исходные задачи обёрнуты в единый шаблон с требованием Answer: $Answer, который
конфликтует с требуемым в этом разделе форматом \boxed{}, поэтому prepare_data.py сначала снимает внешний шаблон
и оставляет только задачу и эталонный ответ:
def normalize_row(    index: int,    row: dict[str, Any],) -> dict[str, Any] | None:    prompt = row.get("prompt")    if not isinstance(prompt, list) or not prompt:        return None
    question = strip_dapo_template(        str(prompt[0].get("content") or "")    )    reward_model = row.get("reward_model") or {}    ground_truth = (        reward_model.get("ground_truth")        if isinstance(reward_model, dict)        else None    )    if isinstance(ground_truth, list):        ground_truth = (            ground_truth[0] if ground_truth else None        )    answer = str(ground_truth or "").strip()    if not question or not answer:        return None
    return {        "id": str(            row.get("extra_info", {}).get("index")            or index        ),        "question": question,        "answer": answer,        "data_source": str(            row.get("data_source") or "dapo_math"        ),    }
Как и в Search-R1, в обучающих примерах нет эталонного кода и числа вызовов инструмента. Политика должна сама исследовать, вызывать ли интерпретатор и какой код генерировать.
Интерпретатор кода описан структурированным определением инструмента:
CODE_TOOL = { "type": "function", "function": { "name": "code_interpreter", "description": ( "Run Python code and return printed output. " "Each execution starts fresh." ), "parameters": { "type": "object", "properties": { "code": {"type": "string"}, }, "required": ["code"], }, },}Примечание переводчика. Описание инструмента: «Выполняет код Python и возвращает напечатанный вывод. Каждый запуск начинается с чистого листа». Системный промпт
protocol.pyв переводе: «Ты решаешь математические задачи шаг за шагом с помощью интерпретатора Python. Используй code_interpreter, когда вычисления, символьные преобразования или перебор помогают решить задачу точно и быстро. Вызывай его не больше одного раза за ход и жди результата. Результат — это то, что код печатает через print(); всегда печатай значения, которые хочешь увидеть. Каждый запуск независим: переменные, файлы и состояние не сохраняются, определяй всё заново. Код должен завершаться за несколько секунд и тратить мало памяти; не читай и не пиши файлы; при переборе держи пространство поиска маленьким. Если выполнение вернуло ошибку, разберись и при необходимости повтори с исправленным кодом. Закончи ровно одной строкой\boxed{<итоговый ответ>}. Не вызывай инструмент и не давай итоговый ответ в одном ходе».
protocol.py так же строго разбирает вызовы инструмента. Код на Python может содержать знаки сравнения, кавычки
и многострочный текст, поэтому здесь проверяются только число вызовов, их положение и то, что код не пуст:
def parse_assistant(text: str) -> ParsedAssistant:    matches = list(TOOL_CALL_PATTERN.finditer(text))    if not matches:        kind = (            "invalid" if "<tool_call>" in text else "answer"        )        return ParsedAssistant(            kind=kind,            content=text.strip(),        )
    if len(matches) != 1 or text[matches[0].end():].strip():        return ParsedAssistant(            kind="invalid",            content=text.strip(),        )
    code = matches[0].group(1).strip()    if not code:        return ParsedAssistant(            kind="invalid",            content=text.strip(),        )
    content = text[:matches[0].start()].strip()    return ParsedAssistant(        kind="tool",        content=content,        code=code,    )
У допустимого вывода только три пути: tool идёт в среду выполнения кода, answer заканчивает траекторию и получает
награду за результат, invalid заканчивает траекторию и считается неправильным ответом. Система не пытается
догадками «починить» почти правильные, но неполные вызовы инструмента — иначе определение действий в обучающей среде
стало бы неустойчивым.
Конечный автомат rollout похож на Search-R1, только действие в среде — code_interpreter(code) вместо search(query).
Каждая траектория ограничена такими бюджетами:
- максимальное число вызовов кода;
- максимальное число ходов Assistant;
- число токенов генерации одного хода и результата выполнения;
- число токенов всей траектории;
- время одного выполнения;
- число параллельных локальных исполнителей.
Один вызов кода не сохраняет переменные Python и состояние процесса. Модель должна в каждом вызове заново определять нужные данные — так смысл траектории яснее, и меньше скрытых зависимостей между разными запусками.
8.4.3 Как результат выполнения встраивается в настоящую траекторию токенов
Заголовок раздела «8.4.3 Как результат выполнения встраивается в настоящую траекторию токенов»ReTool тоже не может декодировать текст Assistant и заново токенизировать его. protocol.py с помощью
сообщения-заглушки Assistant извлекает закрывающие токены шаблона, а затем приклеивает токены observation, соответствующие
реальному результату выполнения, после настоящего ответа модели:
def build_next_prompt(    tokenizer: Any,    messages_before_assistant: list[dict[str, Any]],    previous_prompt_tokens: list[int],    completion_tokens: list[int],    next_tool_message: dict[str, Any],) -> list[int]:    canonical_prompt = build_prompt(        tokenizer,        messages_before_assistant,    )    placeholder_message = {        "role": "assistant",        "content": "x",    }    messages_with_assistant = [        *messages_before_assistant,        placeholder_message,    ]    canonical_assistant_end = _render_chat(        tokenizer,        messages_with_assistant,        add_generation_prompt=False,    )
    placeholder_tokens = _encoded_text_tokens(        tokenizer, "x"    )    canonical_action = [        *canonical_prompt,        *placeholder_tokens,    ]    if canonical_assistant_end[        :len(canonical_action)    ] != canonical_action:        raise ValueError(            "Не удалось найти границу конца хода assistant в chat template"            " (не совпадает даже заглушка)"        )    assistant_closing_tokens = canonical_assistant_end[        len(canonical_action):    ]
    canonical_next_prompt = build_prompt(        tokenizer,        [*messages_with_assistant, next_tool_message],    )    if canonical_next_prompt[        :len(canonical_assistant_end)    ] != canonical_assistant_end:        raise ValueError(            "После добавления tool observation chat template переписал историю сообщений"        )    observation_tokens = canonical_next_prompt[        len(canonical_assistant_end):    ]
    overlap = _suffix_prefix_overlap(        completion_tokens,        assistant_closing_tokens,    )    return [        *previous_prompt_tokens,        *completion_tokens,        *assistant_closing_tokens[overlap:],        *observation_tokens,    ]
Заглушка здесь нужна потому, что шаблон чата Qwen может заново разделить реально сэмплированный текст на reasoning
(рассуждение) и content (содержимое ответа). Сообщение-заглушка используется только чтобы вычислить фиксированную
границу шаблона, а настоящие действия модели всегда берутся из completion_tokens. prompt_tokens следующего хода
обязаны начинаться с полных токенов предыдущего хода, иначе train.py откажется строить Datum.
Примечание переводчика. Разница с Search-R1 тонкая. Там граница конца хода вычислялась через пустое сообщение ассистента, здесь — через сообщение «x». Причина: если ответ модели содержит
<think>…</think>, шаблон Qwen при отрисовке может переложить рассуждение в отдельное поле и изменить текст. С односимвольной заглушкой такого не случится, а закрывающие токены (<|im_end|>и перевод строки) от содержимого не зависят.
8.4.4 Награда за результат и маска вывода интерпретатора
Заголовок раздела «8.4.4 Награда за результат и маска вывода интерпретатора»В этой главе из конца итогового ответа извлекается последний , и math_verify проверяет, математически ли
эквивалентны предсказание и эталонный ответ:
def extract_last_boxed(text: str) -> str | None:    marker = "\\boxed{"    index = text.rfind(marker)    if index < 0:        return None
    start = index + len(marker)    depth = 1    for position in range(start, len(text)):        if text[position] == "{":            depth += 1        elif text[position] == "}":            depth -= 1            if depth == 0:                return text[start:position]    return None

def answers_equivalent(    prediction: str,    reference: str,) -> bool:    try:        return bool(            verify(                parse(f"${reference}$"),                parse(f"${prediction}$"),            )        )    except Exception:        return False

def score_answer(    text: str,    reference: str,) -> RewardResult:    answer = extract_last_boxed(        text[-ANSWER_WINDOW_CHARS:]    )    if answer is None:        return RewardResult(            -1.0, False, False, None        )
    correct = answers_equivalent(        answer.strip(),        reference.strip(),    )    return RewardResult(        1.0 if correct else -1.0,        correct,        True,        answer,    )
Примечание переводчика. Сравните с проверяльщиком GSM8K из 8.1: там регулярное выражение обрывалось на первой
}, здесь счётчик глубины скобокdepthкорректно извлекает\boxed{\frac{1}{2}}→\frac{1}{2}.math_verifyсчитает эквивалентными, например,1/2,0.5и\frac{1}{2}.ANSWER_WINDOW_CHARSв файле равен 300: ответ ищется только в последних 300 символах, как в официальной реализации, — чтобы\boxed{}из середины рассуждения не засчитывался за итог.
Функция награды:
Затем по траекториям одной задачи вычисляется центрированный advantage:
Результат выполнения кода — это observation среды. Он должен быть в контексте модели и при этом не должен попадать в потерю политики. В статье ReTool это называют interpreter feedback mask (маской вывода интерпретатора); в этой главе используется то же выравнивание токенов, что и в Search-R1:
| Участок токенов | Остаётся ли в контексте | old logprob | advantage |
|---|---|---|---|
| Исходный prompt | да | 0 | 0 |
| Рассуждения Assistant и вызовы кода | да | logprob из rollout | advantage траектории |
| stdout, stderr или сообщение о таймауте | да | 0 | 0 |
| Итоговый ответ | да | logprob из rollout | advantage траектории |
Сопутствующий код использует потерю PPO из PyTRIO:
PPO_LOSS_CONFIG = {    "clip_low_threshold": 0.8,    "clip_high_threshold": 1.28,}
training_client.forward_backward(    datums,    loss_fn="ppo",    loss_fn_config=PPO_LOSS_CONFIG,).result()
В исходной статье ReTool на этапе обучения с подкреплением используется PPO. Эта глава сохраняет многоходовые траектории с кодом, награду за результат и interpreter feedback mask, но добавляет групповую выборку по одной задаче и центрированный advantage; поэтому цепочку обучения можно описать так: «GRPO строит относительное преимущество, обрезка PPO управляет обновлением политики».
Здесь используются несимметричные границы отношения вероятностей. Когда отношение к старой политике ниже 0,8 или выше 1,28, PPO ограничивает соответствующее обновление. Какими бы ни были параметры обрезки, sampler для rollout нужно обновлять из текущих весов перед началом каждого шага обучения.
Примечание переводчика. Границы и — это ровно Clip-Higher из DAPO (, ), откуда и датасет DAPO-Math-17k: верхнюю границу раздвигают, чтобы редкие удачные токены могли быстрее набирать вероятность и политика не теряла разнообразие (энтропию). См. урок 6.4.3. Числа для примера: группа из 4 траекторий с наградами даёт и advantage . Награды вместо просто удваивают масштаб advantage — сравнивать по величине потерь с 8.1 и 8.3 нельзя.
8.4.5 Среда выполнения кода и границы безопасности
Заголовок раздела «8.4.5 Среда выполнения кода и границы безопасности»Выполнять код, сгенерированный моделью, по-настоящему рискованно. sandbox.py этой главы использует локальный
subprocess и добавляет такие инженерные ограничения:
- Python запускается со списком аргументов, без оболочки (shell);
- на каждый вызов создаётся отдельный процесс;
- задаются предел реального времени (wall-clock timeout) и предел процессорного времени;
- при таймауте завершается вся группа дочерних процессов;
- ограничивается число потоков BLAS и других числовых библиотек;
- stdout и stderr пишутся во временные файлы, а обратно читается ограниченный объём;
- ограничивается число параллельных выполнений;
- вычищаются служебные метки, способные сломать шаблон чата.
Точка входа выполнения — LocalPythonSandbox.run_code(). Код модели сначала вкладывается в загрузочный фрагмент
(bootstrap), который задаёт предел процессорного времени, а затем передаётся новому процессу Python списком аргументов:
def run_code(self, code: str) -> ExecResult:    started = time.perf_counter()    self.stats.calls += 1    bootstrap = _BOOTSTRAP.format(        cpu=int(self.timeout) + 5,        code=repr(code),    )    env = {        **os.environ,        **_CHILD_ENV_OVERRIDES,    }
    with self._semaphore:        with (            tempfile.TemporaryFile() as stdout_file,            tempfile.TemporaryFile() as stderr_file,        ):            process = subprocess.Popen(                [                    self.python,                    "-B",                    "-c",                    bootstrap,                ],                stdout=stdout_file,                stderr=stderr_file,                env=env,                start_new_session=True,            )            timed_out = False            try:                returncode = process.wait(                    timeout=self.timeout                )            except subprocess.TimeoutExpired:                timed_out = True                os.killpg(                    process.pid,                    signal.SIGKILL,                )                returncode = None                process.wait()
            stdout = _truncate_tail(                _read_capped(stdout_file)            )            stderr = _truncate_tail(                _read_capped(stderr_file)            )
    latency = time.perf_counter() - started    ok = not timed_out and returncode == 0    if timed_out:        self.stats.timeouts += 1    elif ok:        self.stats.successes += 1    else:        self.stats.errors += 1    self.stats.latency_total += latency    return ExecResult(        ok,        stdout,        stderr,        returncode,        timed_out,        latency,    )
stdout и stderr пишутся во временные файлы, а не в PIPE, и родительский процесс читает лишь ограниченное число байт
с конца файла — поэтому, даже если модель печатает без остановки, весь вывод не окажется в памяти родительского
процесса. При таймауте используется отдельная группа процессов, созданная через start_new_session=True, и killpg()
завершает всю группу дочерних процессов разом.
Примечание переводчика. Загрузочный фрагмент
_BOOTSTRAP— три строки:import resource,resource.setrlimit(resource.RLIMIT_CPU, (cpu, cpu))иexec(compile(code, '<sandbox>', 'exec')). Таймаут по умолчанию — 30 секунд, предел процессорного времени — на 5 секунд больше. Вывод ограничен 4096 символами на stdout и столько же на stderr._CHILD_ENV_OVERRIDESлишь ставитOMP_NUM_THREADS=1и аналоги для OpenBLAS, MKL, vecLib — остальное окружение, включая ключи, дочерний процесс наследует.resourceесть только в Linux и macOS.
Результат выполнения приводится к единому tool observation:
def format_tool_content( self, result: ExecResult,) -> str: if result.timed_out: return ( "Error: execution timed out after " f"{self.timeout:.0f} seconds." ) if result.ok: return sanitize_tool_content(result.stdout) if result.stderr: return sanitize_tool_content(result.stderr) return ( "Error: process exited with code " f"{result.returncode}." )При успехе возвращается stdout, при синтаксических ошибках и исключениях во время выполнения — исходный stderr, при
таймауте — фиксированный текст ошибки. Текущий run_code() не дописывает за модель print() автоматически, поэтому
системный промпт явно требует печатать значения, которые модель хочет увидеть; если ничего не напечатано, observation
успешного выполнения — пустая строка.
Эти меры в основном защищают от случайных бесконечных циклов, потоков вывода и расхода ресурсов. Надёжной защищённой изоляции они не дают. Локальный дочерний процесс всё ещё может читать файлы, доступные учётной записи, ходить в сеть, читать унаследованные переменные окружения или использовать уязвимости хост-системы.
Поэтому перед запуском ReTool обязательно соблюдайте требования безопасности:
- не выполняйте код модели прямо на машине с рабочими учётными данными, закрытыми ключами или чувствительными данными;
- используйте одноразовый контейнер, виртуальную машину с минимальными правами или специальный сервис-песочницу;
- по умолчанию отключайте сеть, делайте файловую систему только для чтения и сводите видимые каталоги к минимуму;
- убирайте лишние переменные окружения и учётные данные облачных сервисов;
- задавайте жёсткие пределы на процессор, память, число процессов, диск и время выполнения;
- сохраняйте код, статусы завершения и метрики ресурсов, чтобы можно было разобрать аномальные траектории.
«Independent execution» в описании инструмента означает, что вызовы не делят состояние Python, а не изоляцию на уровне хост-машины. Даже учебный пробный запуск сначала поместите в изолированную среду.
8.4.6 Как продвигается многоходовой rollout с кодом
Заголовок раздела «8.4.6 Как продвигается многоходовой rollout с кодом»rollout.py отдельно хранит обучаемые действия Assistant, полное состояние траектории и вызовы кода, которые «уже
сгенерированы, но ещё не выполнены»:
@dataclassclass AssistantTurn:    prompt_tokens: list[int]    completion_tokens: list[int]    logprobs: list[float]    text: str

@dataclassclass Trajectory:    example: MathExample    group_index: int    messages: list[dict[str, Any]]    next_prompt_tokens: list[int] | None = None    question_index: int = 0    turns: list[AssistantTurn] = field(        default_factory=list    )    code_calls: int = 0    final_text: str = ""    reward: float = -1.0    advantage: float = 0.0    valid_format: bool = False    correct: bool = False    done: bool = False

@dataclass(frozen=True)class PendingExecution:    trajectory: Trajectory    code: str    call_id: str    messages_before_assistant: list[dict[str, Any]]    assistant_text: str    prompt_tokens: list[int]    completion_tokens: list[int]
begin_advance() обрабатывает один вывод Assistant и решает, заканчивается ли траектория или идёт в среду выполнения:
def begin_advance(    trajectory: Trajectory,    prompt_tokens: list[int],    sequence: Any,    tokenizer: Any,    config: RolloutConfig,) -> PendingExecution | None:    tokens, logprobs, text = read_sequence(        sequence, tokenizer    )    text = text.strip()    trajectory.turns.append(        AssistantTurn(            prompt_tokens,            tokens,            logprobs,            text,        )    )    parsed = parse_assistant(text)
    can_code = (        parsed.kind == "tool"        and trajectory.code_calls        < config.max_code_calls        and len(trajectory.turns)        < config.max_assistant_turns    )    if not can_code:        trajectory.messages.append(            {"role": "assistant", "content": text}        )        trajectory.final_text = text        trajectory.done = True        return None
    call_id = (        f"code-{trajectory.question_index}-"        f"{trajectory.group_index}-"        f"{trajectory.code_calls + 1}"    )    messages_before_assistant = list(        trajectory.messages    )    trajectory.messages.append(        {"role": "assistant", "content": text}    )    return PendingExecution(        trajectory,        parsed.code or "",        call_id,        messages_before_assistant,        text,        prompt_tokens,        tokens,    )
В одном раунде выполнить код могут попросить многие траектории сразу. Их можно выполнять параллельно, но каждая траектория всё равно должна дождаться своего observation, прежде чем начать следующий ход генерации:
async def execute_pending_async(    pendings: list[PendingExecution],    sandbox: LocalPythonSandbox,) -> list[ExecResult]:    return list(        await asyncio.gather(            *(                sandbox.arun_code(p.code)                for p in pendings            )        )    )

async def advance_round(    responses: list[Any],    requests: list[SampleRequest],    trajectories: list[Trajectory],    tokenizer: Any,    sandbox: LocalPythonSandbox,    config: RolloutConfig,    progress_callback: Callable[[int], None] | None,) -> None:    pendings: list[PendingExecution] = []    for request, response in zip(        requests, responses, strict=True    ):        trajectory = trajectories[            request.trajectory_index        ]        pending = begin_advance(            trajectory,            request.prompt_tokens,            response.sequences[0],            tokenizer,            config,        )        if pending is not None:            pendings.append(pending)        elif (            trajectory.done            and progress_callback is not None        ):            progress_callback(1)
    if not pendings:        return    results = await execute_pending_async(        pendings, sandbox    )    for pending, result in zip(        pendings, results, strict=True    ):        finish_advance(            pending,            result,            tokenizer,            sandbox,            config,        )        if (            pending.trajectory.done            and progress_callback is not None        ):            progress_callback(1)
finish_advance() вызывает format_tool_content() из прошлого раздела и затем строит непрерывные токены функцией
build_next_prompt() из раздела 8.4.3. Если результат выполнения слишком длинный, fit_tool_content() раз за разом
оставляет его хвост — traceback и итоговое число обычно в конце; если результат всё равно не помещается в бюджет
траектории, эта траектория сразу заканчивается.
Ветвление на первом ходе такое же, как в Search-R1: на каждый вопрос отправляется один prompt с num_samples=group_size.
Каждая возвращённая последовательность через copy.deepcopy(root) становится независимой траекторией. После
возвращения результатов выполнения prompt у ветвей уже разные, и все последующие запросы идут с num_samples=1 — до
итогового ответа или до исчерпания бюджетов на вызовы кода, ходы и токены.
Только когда все траектории закончились, конечный автомат по очереди вызывает score_trajectory()
и assign_group_advantages(). Поэтому traceback одной траектории может влиять на код, который она сгенерирует дальше,
но не выходит за её границы и не влияет на другие ветви той же группы.
8.4.7 Обучение ReTool на PyTRIO
Заголовок раздела «8.4.7 Обучение ReTool на PyTRIO»Сначала по текущим весам создаётся клиент сэмплирования и генерируются многоходовые траектории для задач:
sampling_client = (    training_client.save_weights_and_get_sampling_client())
trajectories = rollout_batch(    sampling_client=sampling_client,    tokenizer=tokenizer,    sandbox=sandbox,    examples=batch,    config=rollout_config,)
rollout_batch() выполняет следующее:
- на первом ходе сэмплирует
group_sizeветвей для одной задачи; - разбирает вызовы
code_interpreterв каждой ветви; - параллельно выполняет код модели и дописывает tool observation;
- продолжает сэмплирование для незаконченных траекторий;
- извлекает итоговый ответ, считает reward и групповой advantage.
На каждом шаге обучения заново вызывается save_weights_and_get_sampling_client(), чтобы old logprob при rollout
брались у текущей политики до обновления. Если все траектории задачи верны или все неверны, центрированный advantage
равен 0, и build_training_datums() пропускает эту группу; если Datum не осталось, на этом шаге optim_step() не
выполняется.
Затем каждая полная траектория превращается в один Datum. build_datum() в ReTool следует тем же правилам
расширения префикса, что и в разделе 8.3.6; основной цикл:
for turn_index, turn in enumerate(trajectory.turns):    if turn_index == 0:        delta_observation = turn.prompt_tokens    elif turn.prompt_tokens[        :len(full_tokens)    ] == full_tokens:        delta_observation = turn.prompt_tokens[            len(full_tokens):        ]    else:        raise ValueError(            "Prompt следующего хода не является продолжением уже собранной траектории"        )
    full_tokens.extend(delta_observation)    full_tokens.extend(turn.completion_tokens)    old_logprobs_by_token.extend(        [0.0] * len(delta_observation)    )    old_logprobs_by_token.extend(turn.logprobs)    advantages_by_token.extend(        [0.0] * len(delta_observation)    )    advantages_by_token.extend(        [trajectory.advantage]        * len(turn.completion_tokens)    )
input_tokens = full_tokens[:-1]target_tokens = full_tokens[1:]old_logprobs = old_logprobs_by_token[1:]advantages = advantages_by_token[1:]
datum = trio.Datum(    model_input=trio.ModelInput.from_ints(        input_tokens    ),    loss_fn_inputs={        "target_tokens": np.asarray(            target_tokens, dtype=np.int64        ),        "logprobs": np.asarray(            old_logprobs, dtype=np.float32        ),        "advantages": np.asarray(            advantages, dtype=np.float32        ),    },)
В delta_observation входят исходная задача, символ конца хода Assistant и текст stdout, stderr или таймаута — их
advantage равен 0; рассуждения Assistant, вызовы кода и итоговый ответ делят advantage траектории. Это и есть
interpreter feedback mask в реальном коде.
Длины траекторий сильно различаются, поэтому код ещё динамически раскладывает их по микробатчам:
datums = build_training_datums(trajectories)micro_batches = pack_micro_batches(datums)
for micro_batch in micro_batches:    weighted = weight_micro_batch_for_global_mean(        micro_batch,        total_samples=len(trajectories),    )    training_client.forward_backward(        weighted,        loss_fn="ppo",        loss_fn_config=PPO_LOSS_CONFIG,    ).result()
if micro_batches:    training_client.optim_step(adam_params).result()
PyTRIO усредняет примеры внутри одного forward_backward(). Если микробатчи разного размера, прямое накопление
завысит вес маленьких микробатчей. В этой главе advantage масштабируется пропорционально доле примеров микробатча от
всех траекторий:
Так динамическое разбиение меняет только способ выполнения, но не смысл градиента как среднего по всем примерам.
Примечание переводчика. Здесь есть тонкость, которой в 8.3 не было. Масштабировать advantage можно, потому что потеря PPO при одном знаке advantage тоже линейна по нему: обрезка зависит только от отношения вероятностей и знака , а умножение на положительное знак не меняет. Значит, приём с весами корректен и для
ppo.
8.4.8 Запуск и оценка ReTool
Заголовок раздела «8.4.8 Запуск и оценка ReTool»В папке к разделу такие файлы:
| Файл | Назначение |
|---|---|
prepare_data.py | готовит обучающий и dev-наборы DAPO-Math-17k |
data.py | загружает математические примеры в едином формате |
protocol.py | описывает инструмент кода и протокол многоходовых сообщений |
sandbox.py | выполняет код Python и записывает метрики ресурсов |
rollout.py | выполняет конечный автомат «сгенерировать — запустить — наблюдать» |
reward.py | извлекает и проверяет математическую эквивалентность |
train.py | строит feedback mask и микробатчи, выполняет PPO |
eval.py | единая оценка в режимах text-only и ReTool |
analysis.py | сводит метрики разных контрольных точек |
train.jsonl из DAPO-Math-17k, который генерирует prepare_data.py, идёт на RL, и ещё отдельно выделяется 50 задач
dev.jsonl для быстрой проверки. Настоящий eval.py использует фиксированные 30 задач AIME 2025, чтобы не сообщать
результаты прямо на обучающих задачах.
В режиме ReTool val_n кандидатов на каждую задачу генерирует тот же многоходовый конечный автомат:
config = RolloutConfig(    group_size=args.val_n,    max_code_calls=args.max_code_calls,    max_assistant_turns=args.max_assistant_turns,    max_trajectory_tokens=(        args.max_trajectory_tokens    ),    max_assistant_tokens=args.max_assistant_tokens,    max_tool_response_tokens=(        args.max_tool_response_tokens    ),    temperature=args.temperature,    top_p=args.top_p,    seed=args.seed,)
trajectories = await rollout_batch_async(    sampling_client,    tokenizer,    sandbox,    examples,    config,)
Режим text-only не регистрирует инструмент кода и просто сэмплирует val_n одноходовых ответов на ту же задачу. Оба
режима в итоге записывают JSONL по каждой задаче и считают сводку:
Average@N: средняя доля правильных среди всех сгенерированных ответов;Pass@N: доля задач, где хотя бы один кандидат правильный;format_rate: доля ответов, из которых можно извлечь допустимый\boxed{};mean_code_callsиmean_turns: стоимость использования инструмента и длина траектории.
Пример (от переводчика). 30 задач,
val_n = 12, всего 360 ответов. Если правильных 90, тоAverage@12= 90 / 360 = 25%. Если эти 90 правильных ответов приходятся на 14 разных задач,Pass@12= 14 / 30 ≈ 47%. Average показывает надёжность одного ответа, Pass — «потолок» при многих попытках. Подробнее о pass@k — урок 8.3.4; о том, почему 30 задач — шумная оценка, — урок 7.3.1 (одна задача AIME — это 3,3 процентного пункта).
Поэтому, сравнивая контрольные точки, нужно зафиксировать как минимум набор задач, val_n, temperature, top-p,
максимальную длину траектории и логику извлечения ответа; а сравнивая text-only и ReTool, нужно ещё сообщать задержку
выполнения и число вызовов кода.
Сначала подготовьте данные:
python docs/chapter8/retool/prepare_data.pyУбедившись, что исполнитель кода находится в изолированной среде, выполните пробный шаг:
python docs/chapter8/retool/train.py \ --max-steps 1 \ --questions-per-batch 1 \ --group-size 4 \ --max-code-calls 2 \ --sandbox-workers 2 \ --swanlab-mode disabledПодготовив локальные данные AIME 2025, можно сначала запустить контроль без инструментов, а затем оценку ReTool с теми же параметрами сэмплирования:
python docs/chapter8/retool/eval.py \    --mode text-only \    --val-n 12 \    --temperature 1.0 \    --top-p 0.7 \    --output docs/chapter8/retool/eval-results/aime25-text-only-base.jsonl
python docs/chapter8/retool/eval.py \    --mode retool \    --val-n 12 \    --temperature 1.0 \    --top-p 0.7 \    --output docs/chapter8/retool/eval-results/aime25-retool-base.jsonl
При оценке обученной модели добавьте к обеим командам одинаковый --model-path trio://.... Только когда исходная
модель, контрольная точка, text-only и ReTool используют одни и те же настройки сэмплирования, разницу можно
приписать обучению или среде с инструментом.
Метрики обучения должны охватывать три уровня — задачу, политику и среду:
- Результат задачи: доля правильных, доля допустимых , доля вырожденных групп;
- Поведение с инструментом: доля траекторий с вызовом кода, среднее число вызовов на траекторию, доля правильных без вызовов;
- Самоисправление: доля случаев, когда после ошибки первого запуска модель повторила попытку и в итоге ответила верно;
- Состояние среды: доля успешных выполнений, доля исключений, доля таймаутов, средняя задержка;
- Устойчивость политики: отношение вероятностей PPO (probability ratio), доля обрезанных токенов (clip fraction), длина ответа;
- Эффективность системы: время rollout, исполнителя, удалённого обучения и сохранения контрольных точек.
При оценке режимы text-only и ReTool можно запускать по отдельности. Чтобы увидеть чистый выигрыш от среды с инструментом, обоим нужны один и тот же набор задач, одинаковые параметры сэмплирования и один и тот же проверяльщик ответов. Режим с инструментом должен также сообщать дополнительную задержку и стоимость выполнения, потому что рост точности обычно сопровождается большим числом обращений к среде.
Итак, мы прошли путь от одноходовой награды за результат в GRPO и потокенного отзыва Teacher в OPD до многоходового взаимодействия со средой в Search-R1 и ReTool. Итоги главы ниже снова сводят четыре модуля в один поток данных «rollout — обратная связь — advantage — обновление политики».
Итоги главы
Заголовок раздела «Итоги главы»Глава, начав с GRPO, шаг за шагом построила путь обучения с подкреплением для больших моделей, который можно расширить до агентов.
GRPO строит групповое относительное преимущество по нескольким выборкам на одну задачу и обходится без отдельно обучаемой Value Model. Он раскладывает алгоритм на три ясных уровня: политика генерирует rollout, среда выдаёт reward, потеря обновления оптимизирует модель по отношению вероятностей новой и старой политики. Будет ли обучение работать, вместе определяют правильная награда, выравнивание токенов и on-policy обновление sampler.
OPD сохраняет on-policy rollout, но заменяет награду по правилам на потокенную вероятностную обратную связь Teacher по траекториям Student. Reverse KL даёт каждому действию плотный сигнал, и маленькая модель может учиться способностям Teacher в тех состояниях, в которые она сама попадает. Токенизаторы Teacher и Student, режим рассуждений и взаимодополняемость способностей нужно проверить до обучения.
Search-R1 и ReTool расширяют траекторию до многоходового взаимодействия со средой. Результаты поиска и выполнения кода попадают в контекст, но через observation mask исключаются из потери политики; поисковые запросы, код, рассуждения и итоговый ответ, сгенерированные моделью, делят общий сигнал результата на уровне траектории. Оба переиспользуют групповую выборку и относительное преимущество GRPO и заменяют только протокол инструмента, реализацию среды и награду.
Четыре примера в итоге сходятся в один поток данных PyTRIO:
Освоив этот поток, новую задачу Agentic RL можно начинать проектировать с пяти вопросов:
- Какие действия может выполнять агент и какое observation вернёт среда?
- При каком условии траектория заканчивается и как бюджет её ограничивает?
- Отражает ли reward устойчиво итоговую цель задачи?
- Какие токены — действия политики, а какие обязательно нужно закрыть маской?
- Строго ли выровнены rollout, старые logprob, advantage и текущие веса?
Только когда на все пять вопросов есть проверяемые ответы, демо с инструментом готово к обучению с подкреплением.
Учиться дальше: из-за объёма и роли главы в книге она сосредоточена на GRPO, OPD, Search-R1 и ReTool, и многие методы Agentic RL и интерактивные среды разобрать по отдельности не удалось. Если вы хотите изучить OPSD, DAPO, GSPO, ALFWorld и другие темы, загляните в постоянно обновляемый автором репозиторий agentic-rl-lab. Там будут и дальше собираться принципы алгоритмов, запускаемый код и реальные журналы обучения.
Литература
Заголовок раздела «Литература»- Shao, Z. et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024.
- Schulman, J. et al. Proximal Policy Optimization Algorithms. 2017.
- Agarwal, R. et al. On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes. 2023.
- Li, Y. et al. Rethinking On-Policy Distillation of Large Language Models: Phenomenology, Mechanism, and Recipe. 2026.
- Sun, J. et al. EasyOPD: An Easy-to-use On-Policy Distillation Framework for Large Language Models. 2026.
- Jin, B. et al. Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning. 2025.
- Feng, J. et al. ReTool: Reinforcement Learning for Strategic Tool Use in LLMs. 2025.
- PyTRIO. Loss Function Guide.
- PyTRIO. Search-R1 Example.
- Agentic-RL Lab (Сун Чжисюэ). agentic-rl-lab.
От переводчика: что сделать руками
Заголовок раздела «От переводчика: что сделать руками»- Проверяльщик. Установите
math-verifyи проверьтеanswers_equivalentна парах("1/2", "0.5"),("\\frac{1}{2}", "0.5"),("x+1", "1+x"),("128", "128.0"),("3", "\\sqrt{9}"). Что из этого засчитывается? - Песочница. Запустите
LocalPythonSandbox().run_code(...)на четырёх фрагментах:print(2**10),1/0,while True: pass,import os; print(os.environ.get("HOME")). Последний пример наглядно показывает, почему это не изоляция. Затем повторите с вариантом через Docker из врезки выше. - Пять вопросов. Ответьте на пять вопросов из итогов главы для своей задачи — например, агента, который пишет SQL-запросы к учебной базе: какие действия, что возвращает среда, когда конец, какая награда, что маскировать.
- Без PyTRIO. Многоходовой RL с интерпретатором кода есть в примерах verl; в курсе подход к агентному RL и песочницам разобран в уроке 8.3.4.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| code interpreter | интерпретатор кода |
| strategic tool use | стратегическое использование инструментов |
| cold start | холодный старт |
| self-correction | самоисправление |
| interpreter feedback mask | маска вывода интерпретатора |
| mathematical equivalence | математическая эквивалентность |
| asymmetric clipping | несимметричная обрезка |
| sandbox | песочница |
| subprocess / process group | дочерний процесс / группа процессов |
| timeout | таймаут |
| credentials | учётные данные |
| disposable container | одноразовый контейнер |
| placeholder message | сообщение-заглушка |
| text-only baseline | контроль без инструментов |
| self-correction rate | доля самоисправлений |