Разведочный анализ, визуализация и признаки
Как смотреть на данные до модели: распределения, выбросы, корреляции и парадокс Симпсона, утечки и дубликаты, честные графики в matplotlib и первые признаки — от one-hot до target encoding, через который протекает целевая переменная.
Зачем это нужно
Заголовок раздела «Зачем это нужно»Андрей Карпатый в «Рецепте обучения нейросетей» ставит первым шагом не выбор архитектуры, а «стать единым целым с данными»: часами листать примеры, смотреть на распределения, искать дубликаты, битые записи и странные закономерности, не написав ни строчки кода модели. Причина простая: модель выучит всё, что есть в данных, включая ошибки разметки, утечки и перекосы. Обнаружить их после обучения гораздо дороже.
Разведочный анализ данныхразведочный анализ данных (EDA)EN exploratory data analysis (EDA)Систематический первый взгляд на данные до модели — распределения, выбросы, связи, утечки, дубликаты. (EDA, exploratory data analysis) — это систематический первый взгляд на таблицу до модели. Он отвечает на вопросы: как распределены признаки, где выбросы и пропуски, что с чем связано, нет ли подозрительно хороших признаков, сбалансированы ли классы. В мире LLM ровно то же делают с корпусом претрейна (урок 5.1.2: длины, языки, дубликаты, мусор) и с результатами эвалов (урок 7.3: где модель ошибается, не перекошен ли набор). Чек-лист из конца урока пригодится вам там без изменений.
Работаем с логами LLM-сервиса из прошлого урока: logs = make_logs(), 2000 запросов, задержки,
токены и статусы.
Порядок разведки
Заголовок раздела «Порядок разведки»flowchart LR A["Структура:<br/>shape, типы,<br/>пропуски"] --> B["Каждый признак:<br/>распределение,<br/>выбросы"] B --> C["Связи:<br/>корреляции,<br/>группы"] C --> D["Цель:<br/>дисбаланс,<br/>утечки"] D --> E["Дубликаты<br/>и чистка"] E --> F["Признаки<br/>для модели"]
Первый шаг вы уже умеете: shape, info, describe, value_counts из урока 2.4.1. Дальше — по порядку.
Распределения и логарифмическая шкала
Заголовок раздела «Распределения и логарифмическая шкала»В describe у задержки среднее 4032 мс, медиана 2802 мс, максимум 51 208 мс. Среднее намного больше медианы:
у распределения тяжёлый правый хвост. Так устроены почти все «размеры» в мире: длины текстов в токенах, цены,
доходы, время ответа. Число, которое это измеряет, — асимметрия (skewness): для симметричного распределения
она около 0, у нашей задержки logs["latency_ms"].skew() равна 3.35.
На обычной гистограмме такой признак выглядит как высокий столбик у нуля и длинный пустой хвост: формы не видно. Помогает логарифмическая шкалалогарифмическая шкалаEN logarithmic scaleРавные отрезки означают умножение (×10), а не прибавление. Степенные законы на ней — прямые линии. (урок 1.0.2): равные отступы по оси означают равные отношения (1000 → 10 000 → 100 000), а не равные разности. После логарифма асимметрия задержки падает до 0.17 — распределение становится почти симметричным «колоколом» (левый верхний график на рисунке ниже).
Для моделей вывод такой: признак с тяжёлым хвостом часто заменяют на (np.log1p). Линейной модели
это помогает: разница между 1000 и 2000 токенов становится такой же, как между 10 000 и 20 000. Деревьям всё равно:
они сравнивают с порогом, а логарифм порядок не меняет.
Выбросы: ошибка или редкость?
Заголовок раздела «Выбросы: ошибка или редкость?»Выброс (outlier) — значение, далёкое от основной массы. Стандартный детектор — правило межквартильного размаха (IQR). Квартили и — значения, ниже которых лежит 25% и 75% данных; — ширина «середины». Выбросами считают всё, что дальше от краёв середины:
Читаем: «отступаем от первого квартиля вниз и от третьего вверх на полторы ширины середины; всё, что за этими границами, — подозрительно». Именно эти границы рисуют «усы» у ящика с усамиящик с усами (boxplot)EN box plotЯщик — от Q1 до Q3 с линией медианы; усы — до Q1 − 1.5·IQR и Q3 + 1.5·IQR; точки за усами — кандидаты в выбросы. (boxplot).
На числах. У задержки , , . Верхняя граница мс. За ней 144 запроса — 7% данных, и 140 из них приходятся на две большие модели. Это не ошибки: большие модели генерируют медленнее, и длинный ответ на deepseek-v3 законно идёт 15 секунд. Правило, придуманное для симметричных данных, на тяжёлом хвосте «ловит» нормальные значения. Если применить его к логарифму задержки, выбросов остаётся 5 (четыре запроса дольше 28 секунд и один быстрее 0.3 секунды), а если считать по логарифму внутри каждой модели отдельно — 7 (по сырой задержке внутри моделей — всё ещё 85).
Отсюда правило работы с выбросами:
- Найти — IQR, z-оценка больше 3 (у нас 28 точек), а лучше — график.
- Понять, что это. Опечатка (площадь квартиры 3540 м² вместо 35.4), сбой датчика, единицы измерения (секунды вперемешку с миллисекундами) — ошибки. Долгий запрос на большой модели — редкость, но правда.
- Решить. Ошибки исправить или удалить. Редкие настоящие значения оставить, а модели помочь: логарифм, устойчивая к выбросам метрика (MAE вместо MSE, урок 2.2.3), обрезка по перцентилю.
Удалять «всё, что за усами» вслепую нельзя: вы выбросите самые интересные случаи.
Связи: корреляция и её ловушки
Заголовок раздела «Связи: корреляция и её ловушки»Коэффициент корреляции Пирсонакорреляция (коэффициент Пирсона)EN correlation (Pearson coefficient)Число от −1 до 1 — сила ЛИНЕЙНОЙ связи двух признаков; косинус угла между центрированными векторами. Корреляция Спирмена — то же по рангам. измеряет, насколько два признака связаны линейно:
Числитель — сумма произведений отклонений от средних: положительная, если и вместе бывают выше или вместе ниже своих средних. Знаменатель нормирует, и всегда лежит от −1 до 1. Это косинус угла между центрированными векторами и — то самое косинусное сходство из урока 1.1.1.
На числах. , . Средние 2.5 и 5, отклонения
и . Числитель , знаменатель ,
итого . В pandas: df[cols].corr() — сразу вся матрица.
В логах: completion_tokens и latency_ms — 0.72, prompt_tokens и latency_ms — 0.01 (в нашей синтетике
задержка от длины промпта не зависит). Четыре ловушки корреляции:
- Нелинейность. Для на отрезке от −1 до 1 корреляция ровно 0, хотя полностью определяется . значит «нет линейной связи», а не «нет связи». Смотрите на диаграмму рассеяния.
- Выбросы. Добавьте к четырём точкам выше одну пятую — и станет −0.61. Одна точка перевернула знак.
Устойчивая альтернатива — корреляция Спирмена: та же формула, но по рангам (
corr(method="spearman")). - Смешение групп. Внутри каждой модели корреляция токенов ответа и задержки 0.92–0.95, а по всем данным — 0.72: у моделей разная скорость, и облака точек смещены друг относительно друга (левый нижний график ниже).
- Корреляция — не причинность. Продажи мороженого коррелируют с числом утоплений: обоих больше летом.
Парадокс Симпсона
Заголовок раздела «Парадокс Симпсона»Самый коварный случай смешения групп. Две модели прошли по 100 вопросов из двух категорий:
| Лёгкие | Трудные | Всего | |
|---|---|---|---|
| Модель A | 18 из 20 (90%) | 48 из 80 (60%) | 66 из 100 (66%) |
| Модель B | 64 из 80 (80%) | 10 из 20 (50%) | 74 из 100 (74%) |
A точнее B в каждой категории, но хуже в сумме. Противоречия нет: модели A достались в основном трудные вопросы, модели B — лёгкие, и общая точность — это среднее, взвешенное по составу. Это парадокс Симпсонапарадокс СимпсонаEN Simpson's paradoxСвязь в каждой группе направлена в одну сторону, а в объединённых данных — в другую из-за разного состава групп.. Когда в урок 7.3 вы будете сравнивать модели на бенчмарках, первым вопросом должно быть «на одних и тех же ли вопросах?», а вторым — «как выглядит разбивка по категориям?».
Целевая переменная: дисбаланс и утечки
Заголовок раздела «Целевая переменная: дисбаланс и утечки»Пусть мы хотим предсказывать, закончится ли запрос таймаутом. Первым делом — доли классов:
print(logs["status"].value_counts(normalize=True).round(3)) # ok 0.938, timeout 0.032, error 0.030Таймаутов 3.2%. Это дисбаланс классовдисбаланс классовEN class imbalance из урока 2.2.3: модель «никогда не таймаут» получит 96.8% accuracy и не принесёт пользы. Сразу выбираем метрику (recall, PR-кривые, ROC-AUC) и при разбиении сохраняем доли классов (стратификация, урок 2.4.4).
Утечки через пропуски, идентификаторы и время
Заголовок раздела «Утечки через пропуски, идентификаторы и время»Вспомним утечка данныхутечка данныхEN data leakage из урока 2.1.2: признак, которого не будет
в момент предсказания. Простой детектор — обучить модель на каждом признаке по отдельности и посмотреть на
ROC-AUC. Признак latency_ms.isna() даёт для таймаутов AUC = 1.0: у таймаутов задержку не записали. Но
предсказывать таймаут нужно до ответа модели, когда задержки ещё нет. Это утечка через пропуск. Честный признак
вроде completion_tokens даёт 0.45 — у нас таймауты случайны.
Типичные каналы утечек в таблицах:
- Пропуски и служебные поля, заполняемые по итогам события (задержка у таймаута, «причина отказа», «дата расторжения договора»).
- Идентификаторы. Если записи нумеровали после сортировки по чему-то, связанному с ответом (сначала все одобренные заявки, потом отклонённые), номер строки предсказывает ответ. В соревнованиях Kaggle утечки через ID и порядок строк находили не раз.
- Время. Признак «сколько всего запросов у пользователя за неделю» (
groupby("user_id")["ts"].transform("size")) для запроса в понедельник знает будущее. Честный вариант — «сколько было до этого запроса»:groupby("user_id").cumcount()на отсортированных по времени данных. - Признаки-следствия цели. Комиссия агента = 3% от цены сделки; число звонков в отдел удержания у ушедших клиентов.
Правило: про каждый признак спросите «известен ли он в момент, когда модель будет делать предсказание?». Признак, который в одиночку даёт AUC 0.99, — почти всегда утечка, а не удача.
Дубликаты
Заголовок раздела «Дубликаты»df.duplicated().sum() считает строки, полностью повторяющие предыдущие. В логах их 0, но по паре
(user_id, prompt) повторов 1647: пользователи отправляют одни и те же запросы. Это нормально для логов, но если
повторы окажутся и в train, и в test, модель будет проверяться на том, что уже видела. Для текстов дубликаты ищут
после нормализации (регистр, пробелы, знаки препинания), а почти-дубликаты — через MinHash (урок 5.1.2). У LLM это
та же проблема, что и загрязнение бенчмарков.
Графики в matplotlib
Заголовок раздела «Графики в matplotlib»Четыре графика закрывают почти всю разведку. Код запускайте локально (matplotlib — урок 0.3.3):
import matplotlib.pyplot as pltimport numpy as np
fig, axes = plt.subplots(2, 2, figsize=(11, 8))
ax = axes[0, 0]                                            # 1) распределение задержки в лог-шкалеbins = np.logspace(np.log10(200), np.log10(60_000), 40)    # корзины равной ширины на лог-осиax.hist(logs["latency_ms"].dropna(), bins=bins)ax.set_xscale("log")ax.set_xlabel("задержка, мс (лог-шкала)"); ax.set_ylabel("запросов")ax.set_title(f"Задержка (n = {logs['latency_ms'].notna().sum()})")
ax = axes[0, 1]                                            # 2) ящики с усами по моделямorder = ["qwen3-8b", "qwen3-32b", "deepseek-v3"]ax.boxplot([logs.loc[logs["model"] == m, "latency_ms"].dropna() for m in order])ax.set_xticks([1, 2, 3], order)                            # подписи под ящикамиax.set_yscale("log"); ax.set_ylabel("задержка, мс (лог-шкала)"); ax.set_title("Задержка по моделям")
ax = axes[1, 0]                                            # 3) диаграмма рассеяния, цвет — модельfor m in order:    g = logs[logs["model"] == m]    ax.scatter(g["completion_tokens"], g["latency_ms"], s=6, alpha=0.5, label=m)ax.set_xlabel("токенов в ответе"); ax.set_ylabel("задержка, мс"); ax.legend(); ax.set_title("Токены ответа и задержка")
ax = axes[1, 1]                                            # 4) тепловая карта корреляцийcols = ["prompt_tokens", "completion_tokens", "latency_ms"]corr = logs[cols].corr()im = ax.imshow(corr, vmin=-1, vmax=1, cmap="RdBu_r")       # симметричная шкала: 0 — белыйax.set_xticks(range(3), cols, rotation=20); ax.set_yticks(range(3), cols)for i in range(3):    for j in range(3):        ax.text(j, i, f"{corr.iloc[i, j]:.2f}", ha="center", va="center")   # число в каждой клеткеfig.colorbar(im, ax=ax); ax.set_title("Корреляции Пирсона")
fig.tight_layout()fig.savefig("eda_overview.png", dpi=90)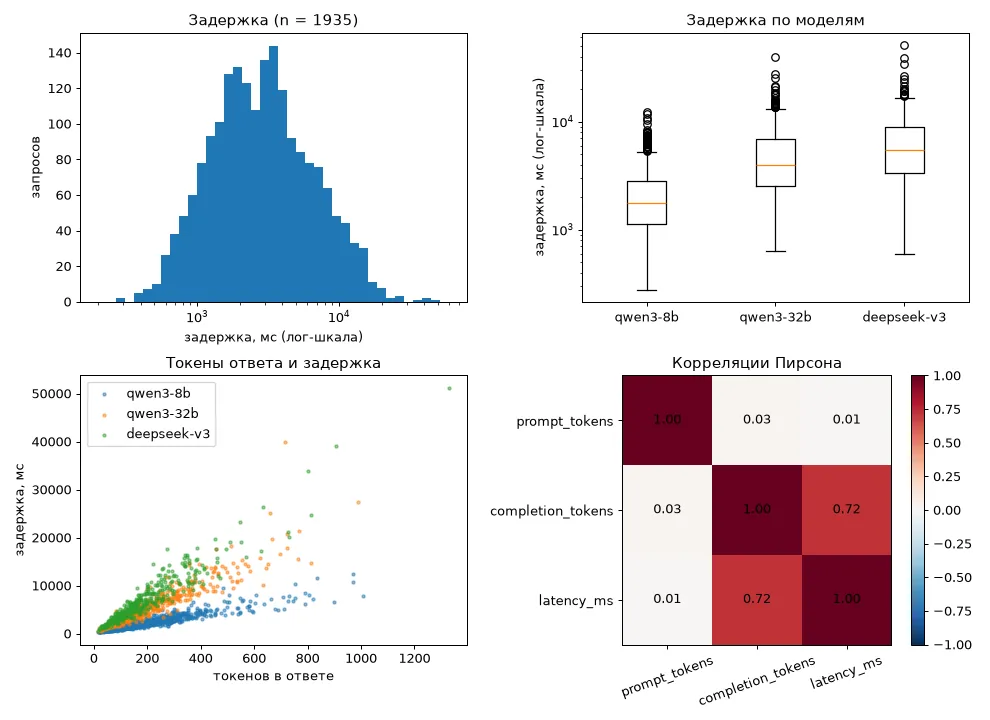
Что читается с картинки. Гистограмма в лог-шкале — колокол без странных пиков, значит, задержки записаны единообразно. «Ящики» показывают, что медиана у qwen3-8b втрое ниже, чем у deepseek-v3, а кружки над усами — те самые «выбросы», которые на деле просто длинные ответы. Диаграмма рассеяния — три веера с разным наклоном: наклон — это секунды на токен, как в линейной регрессии из урока 2.2.1.
Small multiples («много маленьких») — один и тот же график для каждой группы рядом, в общих осях:
fig, axes = plt.subplots(1, 3, sharex=True, sharey=True) и по гистограмме на модель. Глаз сравнивает формы мгновенно,
но только если оси общие: иначе одинаковые на вид столбики значат разное.
Признаки: из сырых столбцов — в числа для модели
Заголовок раздела «Признаки: из сырых столбцов — в числа для модели»конструирование признаковконструирование признаков (feature engineering)EN feature engineeringПревращение сырых столбцов в признаки для модели: масштабирование, логарифм, кодирование категорий, признаки из дат и текста. — превращение сырых столбцов в признаки, удобные модели. Главные приёмы:
Числа. Стандартизация (урок 2.2.1) нужна линейным моделям, kNN и нейросетям; деревьям — нет. Тяжёлые хвосты —
через np.log1p. Статистики (среднее, стандартное отклонение) считают только по train — это правило урока 2.1.2
никуда не делось.
Категории. Модель умножает признаки на веса, а «deepseek-v3» на вес не умножишь. Самый простой перевод —
one-hot кодированиеone-hot кодирование (унитарный код)EN one-hot encodingВектор длины V из нулей с единицей в позиции номера токена. Все one-hot векторы попарно ортогональны.-кодирование: по столбцу-индикатору на каждое значение (pd.get_dummies(logs["model"]) даёт
три столбца из нулей и единиц). Беда — категории с тысячами значений (город, промокод, ID товара): столбцов станет
тысячи, большинство почти пустые.
Target encodingкодирование средним целевой переменной (target encoding)EN target encodingКатегория → среднее цели по ней. Без out-of-fold и сглаживания протекает целевой переменной: у редких категорий кодировка почти равна метке. заменяет категорию средним значением цели по ней: промокоду — долю ушедших клиентов среди его владельцев. Один плотный столбец вместо тысячи. Но здесь спрятана утечка: среднее по категории включает ответ самой строки. У промокода, встретившегося один раз, кодировка в точности равна метке.
Эксперимент: 1000 клиентов, 500 случайных промокодов, метки случайные (20% единиц) — предсказывать нечего.
| Способ кодирования | ROC-AUC на тех же данных |
|---|---|
| среднее цели по категории (наивно) | 0.919 |
| то же со сглаживанием, | 0.911 |
| out-of-fold: среднее по другим фолдам | 0.529 |
Наивная кодировка «нашла» сигнал в шуме, как отбор признаков в эксперименте урока 2.1.2. Лекарства два:
- Out-of-fold. Делим train на 5 частей; кодировку для строк части считаем по остальным четырём частям.
Строка никогда не видит своего ответа. Так работает
TargetEncoderв scikit-learn (с версии 1.3), а CatBoost считает среднее только по «предыдущим» строкам в случайной перестановке (урок 2.3.1). - Сглаживание тянет кодировку редких категорий к общему среднему:
где — сколько раз встретилась категория, — среднее цели в ней, — общее среднее, — «сила доверия» общему среднему. Категория из 3 строк, все три — единицы, общее среднее 0.2, : вместо 1.0. Само по себе сглаживание утечку не убирает (0.911 в таблице), но в паре с out-of-fold делает кодировку устойчивой.
Даты. Из ts получаются час, день недели, «выходной ли», «дней с регистрации». Час — циклический признак: 23:00
и 00:00 соседние, а числа 23 и 0 далеки. Переводят в точку на окружности:
. Для 0 часов это , для 23 — , расстояние
между ними 0.26, а между полуночью и полуднем — 2.
Текст. Длина в символах и байтах, доля кириллицы, наличие слов «переведи/übersetze/translate» (урок 2.4.1). Настоящее представление смысла текста — эмбеддинги (ступень 4), и в таблицах их тоже используют как признаки.
Пропуски. Заполняют медианой (по train!) и добавляют столбец-индикатор «был пропуск» — факт отсутствия значения
часто информативен. Бустинг (урок 2.4.3) умеет работать с NaN сам.
Чек-лист разведочного анализа
Заголовок раздела «Чек-лист разведочного анализа»- Структура: сколько строк и столбцов, типы, пропуски по столбцам, что означает одна строка.
- Каждый признак: гистограмма (при тяжёлом хвосте — в лог-шкале), диапазон, невозможные значения, выбросы.
- Категории:
value_counts, редкие и неожиданные значения, разные написания одного и того же. - Связи: матрица корреляций и диаграммы рассеяния для пар с высокой корреляцией; разбивка по группам (Симпсон!).
- Цель: доли классов или распределение; одиночные признаки с подозрительно высоким качеством.
- Утечки: про каждый признак — «известен ли он в момент предсказания?»; ID, время, пропуски.
- Дубликаты: полные, по ключевым полям, почти-дубликаты; повторы между train и test.
- Запишите выводы — что починили, что оставили и почему. Это начало отчёта (урок 2.4.4).
Для текстов и сырых рабочих выгрузок к чек-листу добавляются ещё пять пунктов — они в уроке 11.1.1.
Практика
Заголовок раздела «Практика»Перед вами «объявления о квартирах» — синтетика с тремя спрятанными проблемами: выбросом, утечкой и дубликатами.
Реализуйте функции разведки, найдите проблемы, почистите данные и соберите small multiples из гистограмм. Рисуем
через matplotlib.figure.Figure без pyplot: так графики работают и в браузере, а тесты проверяют их устройство
(число графиков, заголовки, столбики).
import numpy as np
import pandas as pd
from matplotlib.figure import Figure   # рисуем без pyplot: так графики работают и в браузере


def make_flats(seed=7):
    """Синтетические объявления о продаже квартир (цены условные, млн ₽). В данных спрятаны три проблемы."""
    rng = np.random.default_rng(seed)
    n = 300
    district = rng.choice(["Центр", "Север", "Юг", "Запад"], size=n, p=[0.2, 0.3, 0.3, 0.2])
    area = rng.normal(55, 15, n).clip(20, 120).round(1)
    rooms = np.clip(np.round(area / 22 + rng.normal(0, 0.4, n)), 1, 5).astype(int)
    year = rng.integers(1965, 2025, n)
    floor = rng.integers(1, 26, n)
    per_m2 = pd.Series(district).map({"Центр": 0.32, "Север": 0.19, "Юг": 0.17, "Запад": 0.22}).to_numpy()
    price = area * per_m2 * (1 + 0.006 * (year - 1995)) * rng.lognormal(0, 0.15, n)
    df = pd.DataFrame({
        "listing_id": np.arange(1001, 1001 + n),
        "district": district, "area": area, "rooms": rooms, "year": year, "floor": floor,
        "commission": (0.03 * price * rng.normal(1, 0.01, n)).round(3),
        "price": price.round(2),
    })
    df.loc[42, "area"] = 3540.0
    dup = df.sample(6, random_state=1)
    return pd.concat([df, dup], ignore_index=True)


def iqr_bounds(s, k=1.5):
    """Границы «усов» по правилу IQR: (Q1 − k·IQR, Q3 + k·IQR), где IQR = Q3 − Q1.

    Квартили считайте методом Series.quantile (по умолчанию — линейная интерполяция).
    Вернуть кортеж из двух float.
    """
    # TODO: ваш код
    ...


def find_outliers(df, col, k=1.5):
    """Список меток индекса (по возрастанию) строк, где df[col] выходит за границы iqr_bounds."""
    # TODO: ваш код
    ...


def count_duplicates(df):
    """Сколько строк полностью повторяют одну из ПРЕДЫДУЩИХ строк (первое вхождение не считаем)."""
    # TODO: ваш код
    ...


def find_leaks(df, target, threshold=0.95):
    """Подозрительные признаки: числовые столбцы (кроме target), у которых |корреляция Пирсона|
    с target ≥ threshold. Вернуть список имён, отсортированный по убыванию |корреляции|.
    """
    # TODO: ваш код
    ...


def clean(df, target="price"):
    """Почистить данные по итогам разведки, по шагам:

    1) убрать полные дубликаты строк (оставить первое вхождение);
    2) убрать строки — грубые выбросы по площади: find_outliers(..., "area", k=3);
    3) убрать столбцы-утечки: find_leaks на данных после шагов 1–2.
    Вернуть новую таблицу; исходную не менять.
    """
    # TODO: ваш код
    ...


def overview_figure(df, cols):
    """Small multiples: Figure с гистограммой каждого столбца из cols в один ряд.

    Заголовок каждого графика (ax.set_title) — имя столбца. Вернуть объект Figure.
    Подсказка: fig = Figure(figsize=(4 * len(cols), 3)); axes = fig.subplots(1, len(cols), squeeze=False)[0]
    """
    # TODO: ваш код
    ...


# «Запустить»: разведка по чек-листу урока
flats = make_flats()
print(flats.shape)
print(flats.describe().round(2), "\n")
print("границы IQR для area:", iqr_bounds(flats["area"]))
print("выбросы area (k=3):", find_outliers(flats, "area", k=3))
print("дубликатов:", count_duplicates(flats))
print("подозрение на утечку:", find_leaks(flats, "price"))
cleaned = clean(flats)
if cleaned is not None:
    print("после чистки:", cleaned.shape, "корреляция area–price:", round(cleaned["area"].corr(cleaned["price"]), 3))
fig = overview_figure(flats, ["area", "year", "price"])
if fig is not None:
    print("графиков в фигуре:", len(fig.axes))
После решения посмотрите на число из «Запустить»: с опечаткой 3540 м² корреляция площади и цены — 0.05, без неё — 0.68. Одна строка из трёхсот почти полностью «спрятала» главный признак.
Проверь себя
Заголовок раздела «Проверь себя»- Разведка идёт по чек-листу: структура → распределения → выбросы → связи → цель и утечки → дубликаты → признаки. Каждый шаг — график и вопрос «так и должно быть?».
- Тяжёлые хвосты смотрят в лог-шкале и по медиане и перцентилям. Правило IQR находит кандидатов в выбросы, но решает человек: опечатку исправить, редкую правду оставить.
- Корреляция ловит только линейную связь, ломается от одной точки и от смешения групп; парадокс Симпсона переворачивает выводы при разном составе групп.
- Признак, который в одиночку предсказывает цель почти идеально, — почти всегда утечка: пропуск, ID, будущее время, следствие цели.
- One-hot — для категорий с небольшим числом значений; target encoding — только out-of-fold и со сглаживанием.
Дальше: градиентный бустинг изнутри — как каждое новое дерево делает шаг градиентного спуска в пространстве функций и чем отличаются XGBoost, LightGBM и CatBoost.