Градиентный бустинг изнутри
Бустинг как градиентный спуск в пространстве функций: остатки и p − y как антиградиенты, шаг Ньютона в листьях, регуляризованная цель XGBoost, гиперпараметры LightGBM на числах, отличия трёх библиотек, важность признаков и SHAP.
Зачем это нужно
Заголовок раздела «Зачем это нужно»В уроке 2.3.1 вы собрали бустинг из «пней» на остатках и узнали, что XGBoost,
LightGBM и CatBoost — стандарт для таблиц. Чтобы вызвать fit, этого хватает. Но у LightGBM больше сотни параметров,
и без понимания механики их подбирают наугад. Сегодня откроем капот: что делает дерево, когда мы предсказываем
вероятность; откуда в XGBoost вторые производные и что значат reg_lambda и min_split_gain; как learning_rate,
num_leaves и сабсэмплинг меняют качество — на числах; как не обмануться важностью признаков. Заодно встретим
старого знакомого: p − y — градиент cross-entropy по логитам, как в каждой LLM (урок 1.3.2).
Градиентный спуск в пространстве функций
Заголовок раздела «Градиентный спуск в пространстве функций»Напомним рецепт из урока 2.3.1: — константа, затем каждое новое дерево учится на остатках , и , где — темп обучения (shrinkage).
Теперь посмотрим на это глазами урока 1.4.1. Пусть в train примеров. Соберём предсказания модели на них в вектор — это чисел, которые мы можем двигать. Функция потерь — обычная функция этого вектора: . Её градиент по — вектор из чисел:
Читаем: «насколько вырастет потеря на примере , если чуть-чуть увеличить предсказание для него». Шаг градиентного спуска был бы . Но такой шаг определён только в точках train, а нам нужно предсказывать для любых новых . Поэтому мы обучаем дерево приближать антиградиент по признакам и делаем шаг деревом: оно обобщает «куда двигаться» на всё пространство признаков. Это и есть идея Фридмана (2001): градиентный бустингградиентный бустингEN gradient boosting (GBDT)Реализации — XGBoost, LightGBM, CatBoost. — градиентный спуск, где каждый шаг — новая функция.
| Функция потерь | Антиградиент — на что учится дерево |
|---|---|
| MSE: | остаток |
| MAE: | знак остатка: или |
| log-loss (бинарная cross-entropy), — логит | , где |
Для MSE остатки — это просто антиградиент; вот почему бустинг из урока 2.3.1 был градиентным. Для MAE дерево учится на знаках: каждый пример тянет с силой 1, и выброс не перетягивает модель (устойчивость MAE, урок 2.2.3).
Классификация: снова p − y
Заголовок раздела «Классификация: снова p − y»Для бинарной классификации бустинг предсказывает логит , а вероятность получается сигмоидой , как в логистической регрессии (урок 2.2.2). Функция потерь — бинарная cross-entropy, и её производная по логиту — та самая из уроков 1.3.2 и 2.2.2. Значит, дерево учится на : «насколько вероятность не дотягивает до ответа».
На числах. Пример класса 1, текущий логит : , дерево получит цель . Пример класса 0 с : , цель — сильный толчок вниз, модель уверенно ошибается. Пример класса 1 с : , цель . Для классов на каждом раунде строят деревьев, по одному на класс, и дерево класса учится на — градиенте softmax-cross-entropy.
Значения в листьях: шаг Ньютона
Заголовок раздела «Значения в листьях: шаг Ньютона»Дерево, обученное на антиградиент, задаёт структуру — какие примеры попадают в один лист. А значение листа можно выбрать точнее: то число , которое сильнее всего уменьшает потерю на примерах этого листа. Для MSE это среднее остатков (как у обычного регрессионного дерева). Для log-loss точного ответа формулой нет, и берут один шаг метода Ньютонаметод НьютонаEN Newton's methodШаг оптимизации с учётом кривизны: приблизить функцию параболой g·w + ½·h·w² и прыгнуть в её минимум w = −g/h. В бустинге так считают значения листьев..
Идея Ньютона: градиентный спуск знает только наклон и не знает, насколько далеко идти. Если знать ещё кривизну — вторую производную — функцию можно приблизить параболой и сразу прыгнуть в её минимум . Крутая парабола (большое ) — шаг короче, пологая — длиннее. Для log-loss , и значение листа
Читаем: «сумма антиградиентов, делённая на сумму кривизн». На числах. В лист попали 4 примера с метками
, у всех пока (). Числитель , знаменатель ,
значение листа — 1.0. Идеальный ответ для этого листа — логит доли единиц :
Ньютон за один шаг почти попал, а среднее остатков дало бы всего . Так устроен
GradientBoostingClassifier в scikit-learn, а XGBoost и LightGBM обобщают эту идею.
XGBoost: второй порядок и регуляризация
Заголовок раздела «XGBoost: второй порядок и регуляризация»Тяньци Чэнь пошёл дальше и сделал вторые производные частью выбора разбиений. Цель на шаге — потеря плюс штраф за сложность нового дерева с листьями и весами листьев :
Первое слагаемое раскладывают в ряд Тейлора до второго порядка: (та же парабола, что у Ньютона). Пусть и — суммы и по примерам листа . Тогда для каждого листа задача — минимизировать параболу , и её минимум
Это шаг Ньютона, у которого знаменатель увеличен на : L2-штраф из урока 2.1.2 прижимает значения листов к нулю. Подставив обратно, получают формулу выигрыша от разбиения узла на левую и правую части:
Читаем: «насколько качество двух детей лучше качества родителя, минус плата за лишний лист». Если выигрыш отрицательный, узел не делят.
На числах. Те же 4 примера с : для класса 1 , для класса 0 , у всех . В узле , . При вес листа — вдвое меньше, чем без штрафа. Разобьём узел на и : , , , .
При выигрыш отрицательный, и разбиение не делается: на четырёх примерах оно не стоит лишнего листа.
Так читаются параметры XGBoost: reg_lambda — это , gamma (в LightGBM min_split_gain) — это ,
min_child_weight — минимальная сумма в листе. Для MSE , и это просто минимальное число примеров.
Посмотрите после этого раздела видео StatQuest «XGBoost Part 1: Regression» (26 минут, ссылка в источниках): тот же
вывод выигрыша и роль и на четырёх точках, с картинками.
Гиперпараметры на числах
Заголовок раздела «Гиперпараметры на числах»Возьмём синтетику Фридмана — классический тест для бустинга:
плюс шум с . Признаков 10, из них — чистый шум. 2000 строк на обучение, 1000 на валидацию.
Стандартное отклонение около 5, а ниже RMSE 1.0 не опуститься: это уровень шума. Все модели — LightGBM
с ранней остановкой (терпение 100 деревьев) и, если в таблице не сказано иное, с num_leaves = 8 и
learning_rate = 0.05, как в коде из практики.
learning_rate | Лучшее число деревьев | RMSE на валидации | Время, с |
|---|---|---|---|
| 0.3 | 192 | 1.331 | 0.10 |
| 0.1 | 280 | 1.223 | 0.12 |
| 0.03 | 841 | 1.200 | 0.29 |
| 0.01 | 2178 | 1.213 | 0.88 |
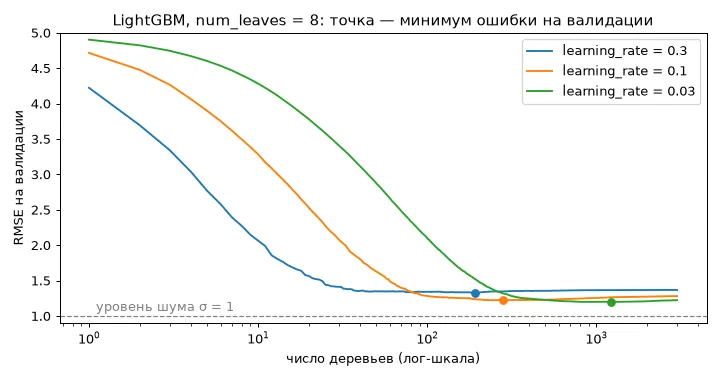
Большой шаг быстро спускается и рано начинает переобучаться: после 192-го дерева ошибка на валидации растёт.
Маленький шаг идёт дольше, но приходит ниже. Дальше 0.03 выигрыша почти нет (0.01 даже чуть хуже из-за шума
валидации), а время растёт пропорционально числу деревьев. Практическое правило: learning_rate 0.03–0.1, число
деревьев — ранней остановкой, никакого перебора n_estimators.
num_leaves | 2 | 4 | 8 | 16 | 31 | 64 | 128 |
|---|---|---|---|---|---|---|---|
| RMSE на валидации | 1.786 | 1.181 | 1.200 | 1.239 | 1.289 | 1.362 | 1.368 |
Пни (num_leaves = 2) не могут выразить взаимодействие : каждое дерево смотрит на один признак, и сумма
пней — сумма функций от отдельных признаков. Уже 4 листа ловят взаимодействие. Дальше деревья переобучаются:
на 2000 строк по умолчанию 31 лист — это много. num_leaves (или max_depth) — главный рычаг сложности, рядом
с ним min_data_in_leaf (минимум примеров в листе, по умолчанию 20) и lambda_l2.
Сабсэмплинг — идея случайного леса внутри бустинга (Фридман назвал это стохастическим градиентным бустингом):
каждое дерево видит случайную долю строк (bagging_fraction с bagging_freq = 1) и признаков (feature_fraction).
Деревья становятся разнообразнее, переобучение — слабее:
| Строк / признаков на дерево | 100% / 100% | 80% / 100% | 80% / 80% | 50% / 50% |
|---|---|---|---|---|
RMSE на валидации (num_leaves = 8) | 1.200 | 1.194 | 1.176 | 1.187 |
Выигрыш скромный, но бесплатный. Порядок настройки, который работает почти всегда: learning_rate = 0.05
и ранняя остановка → num_leaves и min_data_in_leaf → сабсэмплинг и lambda_l2 → в конце уменьшить
learning_rate и снова найти число деревьев. Как перебирать комбинации честно — тема следующего урока.
XGBoost, LightGBM, CatBoost: чем отличаются
Заголовок раздела «XGBoost, LightGBM, CatBoost: чем отличаются»Гистограммы. Перебирать все пороги дорого: для каждого признака нужно отсортировать значений. LightGBM
(а также XGBoost в режиме tree_method="hist", с версии 2.0 он выбран по умолчанию) один раз разбивает каждый признак на корзины — по умолчанию до 255 (в XGBoost — до 256) —
и дальше перебирает только границы корзин, суммируя и по корзинам. Это гистограмма из урока 0.3.3,
только вместо числа точек в корзине — суммы градиентов. Сколько корзин нужно:
max_bin | 7 | 15 | 63 | 255 |
|---|---|---|---|---|
| RMSE на валидации | 1.641 | 1.310 | 1.198 | 1.200 |
С 63 корзин потери точности нет. Отличие вашего бустинга от LightGBM с пнями в задании ниже — тоже от гистограмм.
Рост по листьям. XGBoost по умолчанию растит дерево «по уровням»: делит все узлы текущей глубины. LightGBM растит по листьямрост дерева по листьямEN leaf-wise tree growthСтратегия LightGBM: каждый раз делить один лист с наибольшим выигрышем. Альтернатива — рост по уровням (XGBoost по умолчанию).: каждый раз делит один лист с наибольшим выигрышем, где бы он ни был.
flowchart LR
subgraph L1["По уровням (XGBoost): глубина 2 — 4 листа"]
  A1["корень"] --> B1["узел"]
  A1 --> C1["узел"]
  B1 --> D1["лист"]
  B1 --> E1["лист"]
  C1 --> F1["лист"]
  C1 --> G1["лист"]
end
subgraph L2["По листьям (LightGBM): 4 листа, делим самый выгодный"]
  A2["корень"] --> B2["узел"]
  A2 --> C2["лист"]
  B2 --> D2["узел"]
  B2 --> E2["лист"]
  D2 --> F2["лист"]
  D2 --> G2["лист"]
end
При одинаковом числе листьев рост по листьям обычно точнее, но легче переобучается на маленьких данных: поэтому
у LightGBM главный параметр — num_leaves, а не глубина. Ещё два ускорения из статьи LightGBM: GOSS (в выборку
для дерева берут все примеры с большими градиентами и случайную долю остальных) и EFB (склеивание
взаимоисключающих разреженных признаков, например one-hot столбцов, в один).
| XGBoost | LightGBM | CatBoost | |
|---|---|---|---|
| Авторы | Тяньци Чэнь (DMLC), 2014–2016 | Microsoft Research Asia, 2017 | Яндекс, 2017 |
| Деревья | по уровням, режим hist | по листьям | симметричные: один вопрос на весь уровень |
| Особенность | регуляризованная цель второго порядка | гистограммы, GOSS, EFB — скорость | ordered boosting, категории «из коробки» |
Пропуски NaN | для каждого разбиения учится, в какую ветку их слать | так же | по умолчанию считает пропуск меньше любого значения |
| Категориальные признаки | есть поддержка | есть поддержка | сильнейшая: ordered target statistics |
Пропуски — приятная особенность всех трёх. XGBoost и LightGBM при обучении пробуют отправить строки с NaN и налево,
и направо и запоминают лучшее направление; CatBoost по умолчанию ставит их левее всех значений. Заполнять пропуски для бустинга не обязательно. CatBoost, напомним из урока 2.3.1,
борется с утечкой целевой переменной: target statistics для категорий и остатки для бустинга считаются только по
«прошлым» примерам случайной перестановки — та же идея out-of-fold, что в target encoding из
прошлого урока.
Важность признаков и SHAP
Заголовок раздела «Важность признаков и SHAP»Когда модель обучена, первый вопрос заказчика: «на что она смотрит?». Обучим LightGBM на тех же данных (код — в практике) и сравним способы ответить.
важность признаковважность признаковEN feature importanceSplit — число разбиений по признаку, gain — суммарное уменьшение потери, permutation — рост ошибки на валидации при перемешивании признака. Описывает модель, а не причинность. бывает разной:
- split — сколько раз признак использовался в разбиениях;
- gain — насколько суммарно уменьшилась потеря от этих разбиений;
- перестановочная (permutation) — насколько вырастет ошибка на валидации, если перемешать значения признака и разрушить его связь с ответом.
| Признак | (шум) | |||||
|---|---|---|---|---|---|---|
| split, разбиений | 742 | 671 | 534 | 502 | 400 | 243–283 |
| gain, доля | 0.224 | 0.227 | 0.084 | 0.365 | 0.091 | по 0.002 |
| рост RMSE при перестановке | 2.47 | 2.56 | 1.14 | 2.96 | 1.12 | около 0 |
По числу разбиений шумные признаки выглядят лишь вдвое слабее полезного : их можно делить сотни раз с крошечной пользой. По gain и перестановке видно правду. Вторая ловушка — коррелированные признаки: если добавить почти точную копию , gain поделится между ними (0.204 и 0.163 вместо 0.365), и каждый будет выглядеть вдвое менее важным. Третья — важность описывает модель, а не мир: «модель опирается на признак» не значит «признак вызывает ответ».
SHAP: вклад признаков в один прогноз
Заголовок раздела «SHAP: вклад признаков в один прогноз»Важность — одно число на признак для всей модели. А часто нужно объяснить конкретный прогноз: почему этому клиенту отказали? Ответ даёт теория игр. Представим, что признаки — игроки, которые вместе «заработали» отклонение прогноза от среднего, и разделим выигрыш честно. Значение ШеплиSHAP (значения Шепли)EN SHAP (Shapley additive explanations)Вклад каждого признака в конкретный прогноз по теории игр: базовое значение плюс сумма вкладов равно прогнозу. Для деревьев — точный алгоритм TreeSHAP. признака — его средний вклад по всем порядкам, в которых игроки могли присоединяться к команде.
На числах. Два признака. Средний прогноз (никто не известен) — 2; известен только первый — 6; только второй — 3; оба — 9. Вклад первого, если он пришёл первым: ; если вторым: . Значение Шепли — среднее: . Для второго: и , . Проверка: — базовое значение плюс вклады равно прогнозу. Это свойство аддитивности держится всегда.
Для признаков порядков , но для деревьев есть точный быстрый алгоритм TreeSHAP (Лундберг и соавторы).
В LightGBM он встроен: booster.predict(X, pred_contrib=True), отдельная библиотека не нужна. Для первой строки
валидации базовое значение 14.41, вклады признаков от −1.89 до 0.87, сумма 9.73 — ровно прогноз модели. Средний
модуль SHAP по строкам — ещё один, самый надёжный из перечисленных способ ранжировать признаки.
Практика
Заголовок раздела «Практика»Задание: свой бустинг против LightGBM
Заголовок раздела «Задание: свой бустинг против LightGBM»Напишите векторизованный поиск лучшего пня по всем признакам, бустинг на пнях для MSE и функцию, которая снимает
кривую RMSE на валидации у LightGBM. Данные — синтетика Фридмана из 5 признаков (400 строк train, 200 validation).
Тесты проверят, что ваш пень совпадает с медленным перебором, бустинг опускает RMSE с 4.9 ниже 1.95, кривая LightGBM
с num_leaves = 2 почти повторяет вашу, а 4 листа обгоняют пни.
Новое в поиске пня — формула суммы квадратов отклонений через суммы: для чисел
. После сортировки признака суммы слева от каждого порога
даёт np.cumsum, и SSE всех порогов считается одной строкой без цикла.
import lightgbm as lgb
import numpy as np


def make_data(seed=0):
    """Синтетика Фридмана: y = 10·sin(π·x0·x1) + 20·(x2 − 0.5)² + 10·x3 + 5·x4 + шум (σ = 1).

    600 точек: первые 400 — train, остальные 200 — validation.
    """
    rng = np.random.default_rng(seed)
    X = rng.uniform(0, 1, (600, 5))
    y = 10 * np.sin(np.pi * X[:, 0] * X[:, 1]) + 20 * (X[:, 2] - 0.5) ** 2 + 10 * X[:, 3] + 5 * X[:, 4]
    y = y + rng.normal(0, 1, 600)
    return X[:400], y[:400], X[400:], y[400:]


def rmse(y, pred):
    return float(np.sqrt(np.mean((np.asarray(y) - np.asarray(pred)) ** 2)))


def best_stump(X, r):
    """Лучший «пень» по MSE для целей r: перебрать ВСЕ признаки j и пороги t.

    Пень отвечает left, если X[:, j] <= t, иначе right; left и right — средние r в своих листьях.
    Пороги — середины между соседними РАЗЛИЧНЫМИ значениями признака (как в уроке 2.3.1).
    Лучший — с минимальной суммой квадратов ошибок; при равенстве — первый найденный
    (меньший номер признака, затем меньший порог).
    Вернуть кортеж (j, t, left, right).

    Подсказка для скорости: отсортируйте признак, тогда суммы r и r² слева от каждого порога
    даёт np.cumsum, и SSE всех порогов считается одной формулой без цикла по порогам.
    """
    # TODO: ваш код
    ...


def predict_stump(stump, X):
    """Предсказание пня (готово)."""
    j, t, left, right = stump
    return np.where(X[:, j] <= t, left, right)


def boost_stumps(X_tr, y_tr, X_val, y_val, n_rounds=200, lr=0.1):
    """Градиентный бустинг на пнях для MSE.

    F0 = среднее y_tr (одинаковое для train и val). На каждом раунде:
    остатки r = y_tr − F_tr (антиградиент MSE) → пень best_stump(X_tr, r) →
    F_tr += lr · пень(X_tr), F_val += lr · пень(X_val).
    Вернуть список длины n_rounds: RMSE на валидации после каждого раунда.
    """
    # TODO: ваш код
    ...


def lgbm_curve(X_tr, y_tr, X_val, y_val, n_rounds=200, lr=0.1, num_leaves=2):
    """То же в LightGBM: список RMSE на валидации после каждого раунда.

    params = {"objective": "regression", "metric": "rmse", "learning_rate": lr,
              "num_leaves": num_leaves, "verbose": -1, "num_threads": 1}
    Обучите lgb.train(params, lgb.Dataset(X_tr, y_tr), num_boost_round=n_rounds,
    valid_sets=[lgb.Dataset(X_val, y_val)], callbacks=[lgb.record_evaluation(res)]),
    где res = {} — словарь, куда LightGBM запишет историю: res["valid_0"]["rmse"].
    """
    # TODO: ваш код
    ...


# «Запустить»: сравниваем кривые
X_tr, y_tr, X_val, y_val = make_data()
print("бейзлайн (всегда среднее):", round(rmse(y_val, np.full(len(y_val), y_tr.mean())), 3))
own = boost_stumps(X_tr, y_tr, X_val, y_val)
if own is not None:
    print("свой бустинг, RMSE на раундах 1/10/50/100/200:", [round(own[i], 3) for i in (0, 9, 49, 99, 199)])
for leaves in (2, 4):
    curve = lgbm_curve(X_tr, y_tr, X_val, y_val, num_leaves=leaves)
    if curve is not None:
        print(f"LightGBM, num_leaves={leaves}:", [round(float(curve[i]), 3) for i in (0, 9, 49, 99, 199)])
LightGBM с ранней остановкой, важностью и SHAP (локально)
Заголовок раздела «LightGBM с ранней остановкой, важностью и SHAP (локально)»Код, которым получены таблицы урока. Установка: pip install lightgbm.
import numpy as npimport lightgbm as lgb
rng = np.random.default_rng(1)X = rng.uniform(0, 1, (3000, 10))                     # 10 признаков, из них x5…x9 — чистый шумy = (10 * np.sin(np.pi * X[:, 0] * X[:, 1]) + 20 * (X[:, 2] - 0.5) ** 2     + 10 * X[:, 3] + 5 * X[:, 4] + rng.normal(0, 1, 3000))X_tr, y_tr, X_val, y_val = X[:2000], y[:2000], X[2000:], y[2000:]
params = {"objective": "regression", "metric": "rmse", "learning_rate": 0.05,          "num_leaves": 8, "verbose": -1, "seed": 0,          "num_threads": 1}                     # на 2000 строк один поток быстрее; на больших данных уберитеbooster = lgb.train(params, lgb.Dataset(X_tr, y_tr), num_boost_round=5000,                    valid_sets=[lgb.Dataset(X_val, y_val)],                    callbacks=[lgb.early_stopping(100, verbose=False)])   # стоп, если 100 деревьев без улучшенияpred = booster.predict(X_val)                          # по умолчанию — с лучшим числом деревьевprint("лучшее число деревьев:", booster.best_iteration)print("RMSE на валидации:", round(float(np.sqrt(np.mean((y_val - pred) ** 2))), 3))
split = booster.feature_importance("split")            # сколько раз признак использовали в разбиенияхgain = booster.feature_importance("gain")              # суммарное уменьшение loss от этих разбиенийprint("split:", split)print("gain, доли:", np.round(gain / gain.sum(), 3))
contrib = booster.predict(X_val, pred_contrib=True)    # SHAP: (n, 10 + 1), последний столбец — базовое значениеprint("SHAP первой строки:", np.round(contrib[0], 2))print("сумма вкладов:", round(float(contrib[0].sum()), 2), " прогноз:", round(float(pred[0]), 2))
лучшее число деревьев: 600RMSE на валидации: 1.2split: [742 671 534 502 400 265 283 243 277 283]gain, доли: [0.224 0.227 0.084 0.365 0.091 0.002 0.002 0.002 0.002 0.002]SHAP первой строки: [-0.06 0.87 -1.47 -1.89 -1.87 -0.08 -0.07 -0.03 -0.03 -0.06 14.41]сумма вкладов: 9.73 прогноз: 9.73Числа могут слегка отличаться в другой версии LightGBM. Поменяйте num_leaves на 2 и 64, learning_rate на 0.3 и
сравните с таблицами. Перестановочную важность даёт sklearn.inspection.permutation_importance, графики SHAP —
библиотека shap.
Проверь себя
Заголовок раздела «Проверь себя»- Градиентный бустинг — градиентный спуск в пространстве функций: каждое дерево приближает антиградиент потери по предсказаниям. Для MSE это остатки, для log-loss — , тот же градиент, что у softmax-cross-entropy в LLM.
- Структуру дерева задаёт антиградиент, а значения листьев выбирают шагом Ньютона: . XGBoost делает вторые производные частью цели: , разбиение — только если выигрыш больше .
- Главные рычаги LightGBM:
learning_rate(0.03–0.1) и ранняя остановка,num_leavesиmin_data_in_leaf, сабсэмплинг строк и признаков. Гистограммы с 63–255 корзинами почти не теряют точности. - XGBoost — регуляризованная цель второго порядка, LightGBM — гистограммы и рост по листьям, CatBoost — ordered
boosting и категории. Все три сами справляются с
NaN. - Важность по числу разбиений обманывает; смотрите gain, перестановочную важность и SHAP, а SHAP-вклады строки в сумме с базой дают её прогноз.
Как бустинг работает ранжировщиком в настоящей системе — ленте рекомендаций маркетплейса, — в уроке 11.2.3.
Дальше: проект с честной валидацией — Pipeline без утечек, стратегии кросс-валидации, подбор гиперпараметров и одна-единственная проверка на отложенном тесте.