Happy-LLM, глава 2: архитектура Transformer
Конспект второй главы книги Datawhale «Строим большую модель с нуля»: внимание, маски, многоголовое внимание, энкодер и декодер, нормализация, остаточные связи, позиционное кодирование и сборка Transformer на PyTorch.
Вторая глава книги «Строим большую модель с нуля» (Happy-LLM) — теоретическое ядро всей книги. Авторы выводят формулу внимания из простой аналогии со словарём, объясняют маску, многоголовое внимание, устройство энкодера и декодера и в конце собирают классический Transformer на PyTorch. Обучать его в этой главе не будут: обучение начнётся в главе 5, уже на LLaMA-подобной модели.
Ниже — конспект своими словами. Структура повторяет оригинал, а пояснения, числовые примеры и код написаны заново для этой страницы. Полный авторский код главы лежит в репозитории книги.
Коротко
Заголовок раздела «Коротко»- RNN и LSTM плохо распараллеливаются и плохо помнят далёкие слова. Transformer полностью заменяет рекуррентность вниманием.
- Внимание (attention) — это «мягкий поиск по словарю»: запрос (Query) сравнивается с ключами (Key), сходства превращаются в веса через softmax, а ответ — взвешенная сумма значений (Value).
- Итоговая формула: . Деление на не даёт softmax «залипнуть» в одну позицию.
- Самовнимание — когда Q, K и V получаются из одной и той же последовательности. Маска закрывает будущие токены, чтобы модель училась предсказывать следующее слово параллельно по всей строке.
- Многоголовое внимание запускает несколько вниманий параллельно и склеивает результаты.
- Блок Transformer = внимание + полносвязная сеть (FFN), обёрнутые в нормализацию слоя и остаточные связи. Книга использует Pre-Norm, как современные LLM.
- Порядок слов модель узнаёт из позиционного кодирования: в оригинальном Transformer это синусы и косинусы разных частот.
Как читать вместе с курсом
Заголовок раздела «Как читать вместе с курсом»| Раздел главы | Урок курса |
|---|---|
| 2.1.1 Почему не RNN | 4.1.5 RNN и LSTM |
| 2.1.2–2.1.3 Формула внимания | 4.4.1 Интуиция внимания, 4.4.2 Self-attention |
| 2.1.4–2.1.6 Самовнимание, маска, много голов | 4.4.2, 4.4.3 Multi-head |
| 2.2 Энкодер и декодер, LayerNorm, остаточные связи | 4.5.1 Блок Transformer |
| 2.3.2 Позиционное кодирование | 4.5.2 Позиционное кодирование |
Новичку: вывод синусоидального кодирования через ряд Тейлора и комплексные числа в конце раздела 2.3.2 можно отложить — для практики достаточно понимать саму формулу и её два свойства.
2.1 Механизм внимания
Заголовок раздела «2.1 Механизм внимания»2.1.1 Зачем понадобилось внимание
Заголовок раздела «2.1.1 Зачем понадобилось внимание»Авторы начинают с трёх классических типов нейросетей:
- полносвязные (FNN, частный случай — многослойный перцептрон, MLP): каждый нейрон слоя связан со всеми нейронами соседних слоёв, данные текут в одну сторону;
- свёрточные (CNN): маленькое окно-фильтр скользит по входу, параметров гораздо меньше;
- рекуррентные (RNN): у сети есть цикл, и на каждом шаге она получает собственное прошлое состояние.
Текст — последовательность, поэтому до 2017 года в NLP царили RNN и LSTM (на двунаправленной LSTM построен и ELMo из главы 1). Но у них два неустранимых недостатка:
- Последовательные вычисления. Шаг нельзя посчитать раньше шага . Видеокарта, которая умеет делать тысячи операций одновременно, простаивает.
- Короткая память. Чем дальше друг от друга два слова, тем труднее сети уловить связь между ними. Вентили LSTM смягчают проблему, но не решают её.
Васвани и соавторы взяли механизм внимания — его, как подчёркивает книга, придумали в компьютерном зрении и сначала использовали как добавку к RNN — и построили сеть целиком из внимания. Так появился Transformer, прародитель и основа всех современных LLM.
Интуиция внимания: глядя на картинку, мы не разглядываем каждый пиксель, а фокусируемся на главном. Так и модель может «сосредоточиться» на нескольких важных токенах. Три действующих лица — Query (запрос), Key (ключ) и Value (значение). Пример в духе книги: в новостной заметке мы ищем дату. Запрос — это вектор со смыслом «когда?», ключи и значения — векторы всех слов заметки. Сравнив запрос с ключами, получаем веса — сколько внимания отдать каждому токену; сложив значения с этими весами, получаем ответ.
2.1.2 Выводим формулу внимания
Заголовок раздела «2.1.2 Выводим формулу внимания»Книга выводит формулу из обычного словаря Python. Повторим ход мысли на своих числах. Пусть есть словарь «товар → цена»:
prices = {"морковь": 30, "огурец": 20, "стул": 4}Запрос «морковь» точно совпадает с ключом — ответ 30. А если запрос «овощ»? Логично взять обе цены овощей и проигнорировать стул, то есть сложить значения с весами. Допустим, сходства запроса с ключами равны . Превратим их в веса через softmax:
Ответ: . Это и есть внимание: мягкий поиск, при котором каждый ключ даёт вклад пропорционально своему сходству с запросом.
Откуда взять сходство? Из векторов слов (глава 1): у близких по смыслу слов векторы смотрят в похожую сторону, и их скалярное произведение велико. Сложим векторы всех ключей в матрицу (по строке на ключ) — тогда сходства запроса со всеми ключами сразу дают . Шаги вывода:
- Один запрос, значения — числа: .
- Значения — векторы размерности , запросов много (матрица ): .
- Масштабирование. Если размерность велика, скалярные произведения становятся большими по модулю, softmax выдаёт почти «один против всех», а градиенты почти исчезают. Поэтому делим на :
Читается так: для каждого запроса считаем сходство со всеми ключами, делим на корень из размерности, нормируем в веса и смешиваем значения с этими весами.
Почему именно корень? У двух случайных векторов со стандартными нормальными координатами скалярное произведение имеет разброс (стандартное отклонение) около . Мы проверили симуляцией: при разброс ≈2, при ≈8, при ≈23; после деления на — везде ≈1. А вот как деление меняет softmax: оценки дают веса , а те же оценки, делённые на , — .
2.1.3 Внимание в коде
Заголовок раздела «2.1.3 Внимание в коде»В книге функция внимания занимает несколько строк PyTorch. Вот наш вариант с подробными комментариями:
import mathimport torch
def attention(q, k, v, mask=None):    """Масштабированное скалярное внимание.
    q, k, v: тензоры формы (..., длина, d) — последние две оси: позиции и признаки.    mask: тензор, который прибавляется к оценкам (0 — можно смотреть, -inf — нельзя).    """    d_k = q.size(-1)                                    # размерность ключей    scores = q @ k.transpose(-2, -1) / math.sqrt(d_k)   # сходство каждого запроса с каждым ключом    if mask is not None:        scores = scores + mask                          # закрываем запрещённые позиции    weights = scores.softmax(dim=-1)                    # по строке веса в сумме дают 1    return weights @ v, weights                         # смешиваем значения с весами
torch.manual_seed(0)x = torch.randn(1, 5, 8)        # 1 пример, 5 токенов, у каждого вектор из 8 чиселout, w = attention(x, x, x)     # самовнимание: q, k и v из одной последовательностиprint(out.shape, w.shape)       # torch.Size([1, 5, 8]) torch.Size([1, 5, 5])print(w[0].sum(dim=-1))         # каждая строка весов в сумме даёт 1
2.1.4 Самовнимание
Заголовок раздела «2.1.4 Самовнимание»В «классическом» внимании запросы берутся из одной последовательности, а ключи и значения — из другой. Так устроено перекрёстное внимание (cross-attention) в декодере Transformer: запросы идут от уже сгенерированного текста, ключи и значения — от выхода энкодера.
В энкодере используется самовнимание (self-attention): Q, K и V получаются из одного и того же входа
умножением на три разные обучаемые матрицы , , . В результате каждый токен «смотрит» на все токены
своей же фразы и собирает из них нужную информацию. В коде это просто вызов attention(x, x, x) — как в примере выше
(там для простоты без матриц ).
2.1.5 Маска: не подглядывать в будущее
Заголовок раздела «2.1.5 Маска: не подглядывать в будущее»Языковую модель учат предсказывать следующий токен по предыдущим. Для строки <BOS> мама мыла раму <EOS> это четыре
задачи: по <BOS> предсказать «мама», по <BOS> мама — «мыла» и так далее. Решать их по очереди долго, а Transformer
ценен именно параллельностью. Решение — маска: все четыре задачи решаются за один проход, но каждой позиции
запрещено смотреть на позиции правее.
Маска — квадратная матрица, у которой над главной диагональю стоит , а на диагонали и ниже — нули. Её прибавляют к оценкам перед softmax. Так как , запрещённые позиции получают нулевой вес.
import torch
T = 4                                                    # длина последовательностиmask = torch.triu(torch.full((T, T), float("-inf")), diagonal=1)  # -inf строго выше диагоналиprint(mask)# tensor([[0., -inf, -inf, -inf],#         [0.,   0., -inf, -inf],#         [0.,   0.,   0., -inf],#         [0.,   0.,   0.,   0.]])
scores = torch.zeros(T, T)                               # пусть все оценки одинаковыprint((scores + mask).softmax(dim=-1))# Строка 0: [1, 0, 0, 0]; строка 1: [0.5, 0.5, 0, 0]; строка 3: [0.25, 0.25, 0.25, 0.25]
В книге маска хранится сразу для максимальной длины и имеет форму (1, max_len, max_len): первая ось нужна для
трансляции (broadcasting) на все примеры батча, а при вычислении берут срез под фактическую длину.
2.1.6 Многоголовое внимание
Заголовок раздела «2.1.6 Многоголовое внимание»Одно внимание улавливает один тип связей. Но в предложении их много: кто действие совершает, к чему относится местоимение, какие слова стоят рядом. Поэтому Transformer запускает вниманий («голов») параллельно, каждое со своими матрицами, и склеивает результаты:
Книга ссылается на рисунок из статьи «Attention Is All You Need», где две головы на одной и той же фразе явно смотрят на разные вещи (рисунок 2.4 в оригинале).
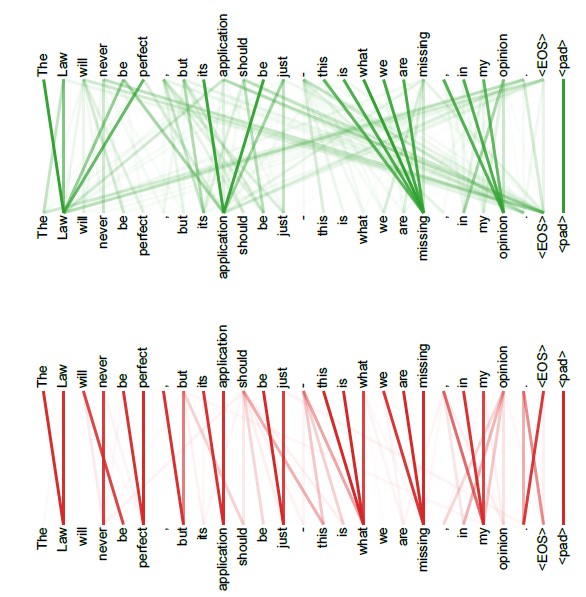
Главный инженерный приём раздела: не нужно держать отдельных маленьких матриц. Одна большая матрица
— это те же матриц, поставленные рядом. Поэтому делают одно умножение, а потом «нарезают» результат
на головы через view и transpose. Наш компактный вариант:
import mathimport torchimport torch.nn as nn
class MultiHeadAttention(nn.Module):    def __init__(self, dim, n_heads, max_len, causal=False, dropout=0.0):        super().__init__()        assert dim % n_heads == 0, "размер модели должен делиться на число голов"        self.n_heads, self.head_dim = n_heads, dim // n_heads        # Три большие проекции вместо 3·h маленьких: результат тот же, но быстрее        self.wq = nn.Linear(dim, dim, bias=False)        self.wk = nn.Linear(dim, dim, bias=False)        self.wv = nn.Linear(dim, dim, bias=False)        self.wo = nn.Linear(dim, dim, bias=False)       # смешивает выходы голов        self.drop = nn.Dropout(dropout)        self.causal = causal        if causal:            mask = torch.triu(torch.full((max_len, max_len), float("-inf")), diagonal=1)            self.register_buffer("mask", mask)          # буфер: едет на GPU вместе с моделью, но не обучается
    def forward(self, q_in, k_in, v_in):        B, T, _ = q_in.shape        S = k_in.shape[1]                                # длина последовательности ключей        # (B, T, dim) -> (B, T, h, head_dim) -> (B, h, T, head_dim)        q = self.wq(q_in).view(B, T, self.n_heads, self.head_dim).transpose(1, 2)        k = self.wk(k_in).view(B, S, self.n_heads, self.head_dim).transpose(1, 2)        v = self.wv(v_in).view(B, S, self.n_heads, self.head_dim).transpose(1, 2)        scores = q @ k.transpose(-2, -1) / math.sqrt(self.head_dim)   # (B, h, T, S)        if self.causal:            scores = scores + self.mask[:T, :S]          # обрезаем маску под фактическую длину        weights = self.drop(scores.softmax(dim=-1))        out = weights @ v                                # (B, h, T, head_dim)        # Склеиваем головы обратно: (B, h, T, head_dim) -> (B, T, h·head_dim)        out = out.transpose(1, 2).contiguous().view(B, T, -1)        return self.wo(out)
mha = MultiHeadAttention(dim=16, n_heads=4, max_len=32, causal=True)x = torch.randn(2, 10, 16)print(mha(x, x, x).shape)                                # torch.Size([2, 10, 16])
Зачем contiguous(): после transpose данные в памяти лежат «вразнобой», а view требует непрерывного блока. Если
забыть этот вызов, PyTorch выдаст ошибку view size is not compatible with input tensor's size and stride — книга
отдельно предупреждает об этом в комментариях к коду.
2.2 Энкодер и декодер
Заголовок раздела «2.2 Энкодер и декодер»2.2.1 Задача Seq2Seq
Заголовок раздела «2.2.1 Задача Seq2Seq»Transformer создавался для задач «последовательность → последовательность» (Seq2Seq): на входе , на выходе , причём длины могут не совпадать. Почти любую задачу NLP можно так сформулировать: классификация — это выход длины 1, разметка частей речи — выход той же длины, что и вход. Первой задачей Transformer был машинный перевод.
Общая схема: энкодер превращает вход в набор векторов, хранящих смысл, декодер по ним порождает выход. В оригинальной модели 6 слоёв энкодера и 6 слоёв декодера; выход верхнего слоя энкодера подаётся в каждый слой декодера.
flowchart LR
X["Исходная фраза"] --> E["Энкодер<br/>N слоёв:<br/>самовнимание + FFN"]
E -- "ключи и значения" --> D["Декодер<br/>N слоёв:<br/>маскированное самовнимание,<br/>перекрёстное внимание, FFN"]
Y["Уже сгенерированные токены"] --> D
D --> L["Linear + softmax"] --> O["Следующий токен"]
2.2.2 Полносвязная сеть (FFN)
Заголовок раздела «2.2.2 Полносвязная сеть (FFN)»В каждом слое после внимания стоит FFN: линейный слой расширяет вектор, функция активации ReLU, второй линейный слой сжимает обратно. Плюс dropout против переобучения — он работает только при обучении, поэтому на многих схемах его не рисуют. FFN применяется к каждой позиции отдельно: внимание «собирает» информацию с других токенов, FFN её «переваривает».
2.2.3 Нормализация слоя
Заголовок раздела «2.2.3 Нормализация слоя»Глубокая сеть страдает от того, что распределение входов каждого слоя «плывёт», пока обучаются слои ниже. Нормализация приводит входы к среднему 0 и дисперсии 1. Книга сравнивает два варианта.
Батч-нормализация (Batch Norm) считает статистику по примерам мини-батча для каждого признака :
Здесь — размер батча, — крошечное число, чтобы не делить на ноль. Недостатки для текста, которые перечисляет книга: при маленьком батче статистика шумная; у фраз разной длины «одна и та же позиция» несопоставима; на тесте могут встретиться фразы длиннее всех обучающих, и для дальних позиций статистики просто нет; хранить и пересчитывать статистику на каждом шаге дорого.
Нормализация слоя (Layer Norm) считает те же среднее и дисперсию, но по признакам одного вектора. Формула та же — меняется только ось. Пример: вектор имеет среднее 3 и стандартное отклонение ; после нормализации — примерно . Затем результат умножается на обучаемый масштаб и сдвигается на обучаемое смещение.
2.2.4 Остаточные связи
Заголовок раздела «2.2.4 Остаточные связи»Чтобы глубокая сеть не деградировала, каждый подслой оборачивают остаточной связью (residual connection): выход подслоя прибавляется к его входу. Информация с нижних слоёв может пройти наверх напрямую, а подслой учит только «поправку». В книге используется вариант Pre-Norm — нормализация перед подслоем:
2.2.5–2.2.6 Слой энкодера и слой декодера
Заголовок раздела «2.2.5–2.2.6 Слой энкодера и слой декодера»- Слой энкодера: самовнимание без маски + FFN, каждое с Pre-Norm и остаточной связью. Энкодер — стопка из таких слоёв и финальная LayerNorm.
- Слой декодера: три подслоя. Первый — маскированное самовнимание (токен видит только себя и предыдущих). Второй — перекрёстное внимание: запросы от декодера, ключи и значения от выхода энкодера. Третий — FFN.
Наш код блоков (использует MultiHeadAttention из примера выше):
import torch.nn as nnimport torch.nn.functional as F
class FFN(nn.Module):    def __init__(self, dim, hidden, dropout=0.0):        super().__init__()        self.up = nn.Linear(dim, hidden, bias=False)    # расширяем        self.down = nn.Linear(hidden, dim, bias=False)  # сжимаем обратно        self.drop = nn.Dropout(dropout)
    def forward(self, x):        return self.drop(self.down(F.relu(self.up(x))))
class EncoderLayer(nn.Module):    def __init__(self, dim, n_heads, max_len):        super().__init__()        self.norm1, self.norm2 = nn.LayerNorm(dim), nn.LayerNorm(dim)        self.attn = MultiHeadAttention(dim, n_heads, max_len, causal=False)        self.ffn = FFN(dim, 4 * dim)
    def forward(self, x):        n = self.norm1(x)        x = x + self.attn(n, n, n)                      # самовнимание + остаточная связь        return x + self.ffn(self.norm2(x))              # FFN + остаточная связь
class DecoderLayer(nn.Module):    def __init__(self, dim, n_heads, max_len):        super().__init__()        self.norm1, self.norm2, self.norm3 = nn.LayerNorm(dim), nn.LayerNorm(dim), nn.LayerNorm(dim)        self.self_attn = MultiHeadAttention(dim, n_heads, max_len, causal=True)        self.cross_attn = MultiHeadAttention(dim, n_heads, max_len, causal=False)        self.ffn = FFN(dim, 4 * dim)
def forward(self, x, enc_out): n = self.norm1(x) x = x + self.self_attn(n, n, n) # смотрим только назад n = self.norm2(x) x = x + self.cross_attn(n, enc_out, enc_out) # запросы наши, ключи и значения — от энкодера return x + self.ffn(self.norm3(x))2.3 Собираем Transformer
Заголовок раздела «2.3 Собираем Transformer»2.3.1 Слой эмбеддингов
Заголовок раздела «2.3.1 Слой эмбеддингов»Сначала токенизатор превращает текст в номера токенов. Пример из книги (в оригинале — китайская фраза, здесь её русский перевод): при словаре из четырёх элементов фраза «я люблю тебя» превращается в номера 0, 1, 2 для «я», «люблю», «тебя». Настоящие токенизаторы режут на слова, подслова или символы, а словари бывают на десятки и сотни тысяч элементов — об этом глава 5.
Слой эмбеддингов (nn.Embedding) — это обучаемая таблица размера (размер словаря × размерность модели). Номер токена —
это номер строки: вход формы (батч, длина) превращается в тензор (батч, длина, размерность).
2.3.2 Позиционное кодирование
Заголовок раздела «2.3.2 Позиционное кодирование»Внимание само по себе не видит порядок: для него «я люблю тебя» и «тебя люблю я» — один и тот же набор токенов. Поэтому к эмбеддингу каждого токена прибавляют вектор позиции. Оригинальный Transformer использует синусы и косинусы:
Что здесь написано: чётные координаты вектора позиции — синусы, нечётные — косинусы; у первых координат частота высокая, у последних — низкая. Пример при (наш расчёт):
| pos | ||||
|---|---|---|---|---|
| 0 | 0,0000 | 1,0000 | 0,0000 | 1,0000 |
| 1 | 0,8415 | 0,5403 | 0,0100 | 1,0000 |
| 2 | 0,9093 | −0,4161 | 0,0200 | 0,9998 |
| 3 | 0,1411 | −0,9900 | 0,0300 | 0,9996 |
(При и знаменатель равен .) Книга разбирает такой же пример на фразе «I like to code» и показывает, как эти числа складываются с векторами слов.
Два свойства, ради которых выбрали синусы:
- Любая длина. Формула работает для позиции, которой не было при обучении: если самая длинная обучающая фраза была 20 токенов, для 21-го вектор всё равно посчитается.
- Относительные позиции. По формулам синуса и косинуса суммы выражается через линейно, так что модели легко понять «на сколько позиций дальше».
Дальше в книге идёт математическое обоснование (авторы ссылаются на рассуждение в стиле Су Цзяньлиня, автора RoPE). Идея своими словами: разложим модель с позиционными добавками в ряд Тейлора; единственный член, зависящий сразу от двух позиций и , имеет вид . Хотим, чтобы он зависел только от разности . Если считать пару координат комплексным числом, решение — , то есть пара . Для большой размерности берут много таких пар с частотами : с ростом расстояния скалярное произведение кодировок стремится к нулю, а число 10000 подобрано экспериментально. Тот же ход мысли потом приведёт к RoPE, которое используется в LLaMA (глава 5).
Код синусоидального кодирования (наш вариант):
import mathimport torchimport torch.nn as nn
class SinusoidalPE(nn.Module):    def __init__(self, max_len, dim):        super().__init__()        pos = torch.arange(max_len).unsqueeze(1)                  # (max_len, 1): номера позиций        freq = torch.exp(torch.arange(0, dim, 2) * (-math.log(10000.0) / dim))  # 1 / 10000^(2i/d)        pe = torch.zeros(max_len, dim)        pe[:, 0::2] = torch.sin(pos * freq)                       # чётные координаты        pe[:, 1::2] = torch.cos(pos * freq)                       # нечётные координаты        self.register_buffer("pe", pe)                            # не обучается
    def forward(self, x):                                         # x: (B, T, dim)        return x + self.pe[: x.size(1)]
print(SinusoidalPE(4, 4).pe)   # совпадает с таблицей выше
2.3.3 Вся модель целиком
Заголовок раздела «2.3.3 Вся модель целиком»Сборка по схеме из статьи «Attention Is All You Need» (рисунок 2.7 в оригинале):
номера токенов → эмбеддинги → + позиционное кодирование → dropout → слоёв энкодера → слоёв декодера →
линейный слой (lm_head) до размера словаря → softmax.
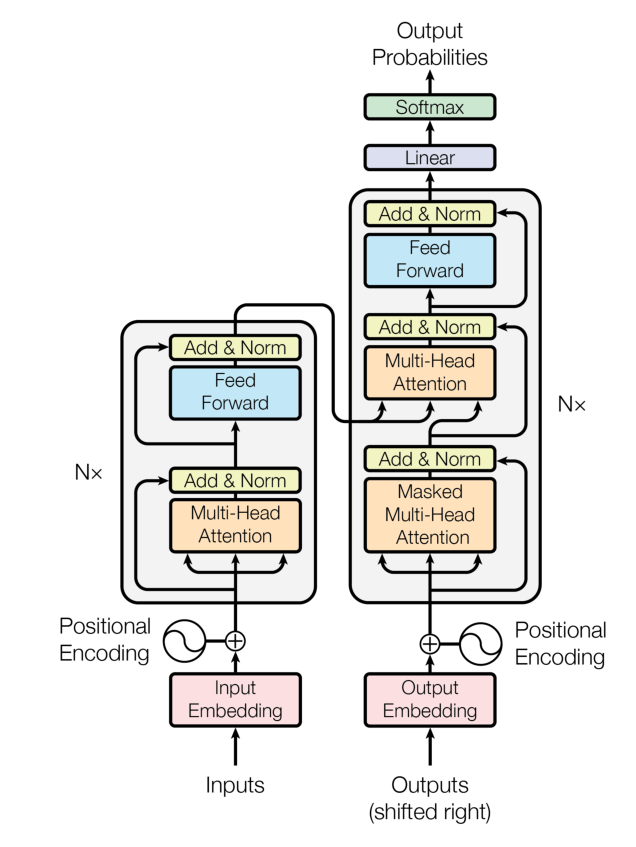
Книга делает важное замечание: на рисунке в статье нормализация стоит после подслоя (Post-Norm), а в опубликованном коде авторов — перед ним (Pre-Norm). Современные LLM используют Pre-Norm, потому что обучение стабильнее, и книга следует этому выбору.
В авторском классе Transformer есть три метода: подсчёт параметров, инициализация весов (нормальное распределение
со стандартным отклонением 0,02 для линейных слоёв и эмбеддингов) и прямой проход, который при наличии целевых токенов
считает функцию потерь — перекрёстную энтропию. Без целей модель считает логиты только для последней позиции: этого
достаточно, чтобы сгенерировать следующий токен. Вот как это выглядит в нашей сборке из блоков выше:
import torchimport torch.nn as nnimport torch.nn.functional as F
class Transformer(nn.Module):    def __init__(self, vocab_size, dim=64, n_heads=4, n_layers=2, max_len=128):        super().__init__()        self.emb = nn.Embedding(vocab_size, dim)        self.pe = SinusoidalPE(max_len, dim)        self.encoder = nn.ModuleList([EncoderLayer(dim, n_heads, max_len) for _ in range(n_layers)])        self.decoder = nn.ModuleList([DecoderLayer(dim, n_heads, max_len) for _ in range(n_layers)])        self.norm_enc, self.norm_dec = nn.LayerNorm(dim), nn.LayerNorm(dim)        self.lm_head = nn.Linear(dim, vocab_size, bias=False)
    def forward(self, src, tgt, targets=None):        x = self.pe(self.emb(src))                      # вход энкодера        for layer in self.encoder:            x = layer(x)        enc_out = self.norm_enc(x)
        y = self.pe(self.emb(tgt))                      # вход декодера        for layer in self.decoder:            y = layer(y, enc_out)        logits = self.lm_head(self.norm_dec(y))         # (B, T, vocab_size)
        loss = None        if targets is not None:                         # перекрёстная энтропия по всем позициям            loss = F.cross_entropy(logits.view(-1, logits.size(-1)), targets.view(-1))        return logits, loss
model = Transformer(vocab_size=1000)src = torch.randint(0, 1000, (2, 12))                   # 2 исходные фразы по 12 токеновtgt = torch.randint(0, 1000, (2, 9))                    # 2 целевые фразы по 9 токеновlogits, loss = model(src, tgt[:, :-1], targets=tgt[:, 1:])print(logits.shape, round(loss.item(), 2))              # torch.Size([2, 8, 1000]) и потеря около ln(1000) ≈ 6.9print(sum(p.numel() for p in model.parameters()))       # число параметров
До обучения модель угадывает токены наугад, поэтому потеря близка к — это полезная контрольная точка: если на старте потеря сильно больше, что-то сломано.
Глава заканчивается обещанием: обучать «рукодельный» Transformer не будем, книга посвящена LLM, а в главе 5 тем же способом будет собрана и обучена своя маленькая LLaMA.
Что сделать руками
Заголовок раздела «Что сделать руками»- Посчитайте вручную пример со словарём для запроса «мебель» со сходствами . Веса получатся примерно , ответ — около 4,7.
- Запустите код маски и проверьте, что в строке 2 веса равны .
- Соберите
MultiHeadAttentionи проверьте утверждение книги: если склеить веса четырёх голов по 4×16 в одну матрицу 16×16, результат не изменится. Подсказка: сравнитеtorch.allcloseвыходов. - Уберите деление на при
dim=512и посмотрите на максимальный вес в строках внимания: он почти везде будет близок к 1. - Запустите сборку
Transformer, проверьте начальную потерю ≈6,9 и посчитайте число параметров. - Сравните с авторским кодом в папке
docs/chapter2/codeрепозитория книги и с уроком 4.5.1.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| attention | механизм внимания |
| query / key / value | запрос / ключ / значение |
| self-attention | самовнимание |
| masked (causal) self-attention | маскированное самовнимание |
| multi-head attention | многоголовое внимание |
| feed-forward network, FFN | полносвязная сеть прямого распространения |
| convolutional neural network | свёрточная сеть |
| recurrent neural network | рекуррентная сеть |
| encoder / decoder | энкодер / декодер |
| layer normalization | нормализация слоя |
| batch normalization | батч-нормализация |
| residual connection | остаточная связь |
| positional encoding | позиционное кодирование |
| vocabulary | словарь |
| cross-entropy | перекрёстная энтропия |