Happy-LLM, глава 8.3: Search-R1 — агент учится искать
Полный перевод раздела 8.3 книги Datawhale «Строим большую модель с нуля»: обучение модели самой решать, когда и что искать — инструмент search, поисковые бэкенды как среда, многоходовой rollout, непрерывность токенов, маска наблюдений, микробатчи и оценка на NQ и HotpotQA.
8.3 Search-R1
Заголовок раздела «8.3 Search-R1»Источник кода: раздел составлен по полной многофайловой реализации из открытого репозитория автора agentic-rl-lab/03-search-r1. Текст следует настоящей цепочке вызовов:
prepare_data.py,protocol.py,search.py,rollout.py,reward.py,train.py,eval.pyиanalyse.py.
Большая языковая модель хранит внутри огромный объём знаний, но эти знания ограничены временны́м охватом обучающих данных, ёмкостью параметров и покрытием «длинного хвоста» редких фактов. В генерации с дополнением найденным (Retrieval-Augmented Generation, RAG) система обычно заранее находит документы и передаёт результат модели для ответа. Search-R1 передаёт решения о поиске самой модели: модель может решить, когда искать, что искать, нужно ли искать дальше с учётом новых данных и когда закончить и дать ответ.
Из-за этого один ответ становится многоходовой траекторией:
где — вызов поиска или итоговый ответ, сгенерированные моделью, а — observation, которое вернула поисковая среда. Награду за результат модель получает только после всей траектории, а GRPO затем отличает успешные пути поиска от неудачных.
Сопутствующая реализация — не отдельный скрипт обучения, а цепочка исполнения из 9 файлов. Читая код, сначала ухватите эту основную линию:
prepare_data.py / data.py ↓ читаем вопросы и эталонные ответыprotocol.py ↓ строим prompt, разбираем вызовы searchsearch.py ↓ выполняем поиск и возвращаем observationrollout.py ↓ генерируем полную многоходовую траекторию, reward и групповой advantagetrain.py ↓ observation mask, Datum, importance_sampling, optim_stepeval.py / analyse.py ↓ оценка в фиксированной среде и сводка результатовОбучаются только токены Assistant, сгенерированные языковой моделью. Поисковый сервис, за который отвечает search.py,
относится к среде; protocol.py соединяет действия модели и observation среды в непрерывную траекторию; rollout.py
управляет обоими; и только в конце train.py превращает траекторию в Datum, который PyTRIO может использовать для
обновления. Ниже разберём код по этой настоящей цепочке вызовов.
8.3.1 От фиксированного поиска к самостоятельному
Заголовок раздела «8.3.1 От фиксированного поиска к самостоятельному»Обучающие примеры Search-R1 содержат только вопрос и эталонный ответ — ни поисковых запросов, написанных людьми, ни
образцовых траекторий поиска. prepare_data.py приводит исходные поля NQ и HotpotQA к такой структуре JSONL:
{"id":"...","question":"...","answers":["..."],"data_source":"nq"}Логика очистки оставляет только поля, нужные для награды за результат:
def normalize_row(row: dict[str, Any]) -> dict[str, Any] | None: question = str(row.get("question") or "").strip() answers = extract_answers(row) if not question or not answers: return None return { "id": str(row.get("id") or ""), "question": question, "answers": answers, "data_source": str( row.get("data_source") or "unknown" ), }data.py затем превращает каждую строку в SearchExample:
@dataclass(frozen=True)class SearchExample: id: str question: str answers: list[str] data_source: strЭта граница данных очень важна. Поисковые запросы, число поисков и способ использования найденного текущая политика должна исследовать сама во время rollout; если бы обучающий набор уже давал фиксированные траектории поиска, задача была бы ближе к подражанию траекториям, а не к Search-R1, о котором идёт речь.
Различия фиксированного RAG и поискового агента видны в таблице 8.3.
| Этап | Фиксированный RAG | Search-R1 |
|---|---|---|
| Искать ли | решает внешний процесс | решает модель по текущему состоянию |
| Поисковый запрос | задан заранее или генерируется один раз | можно многократно переписывать по observation |
| Число раундов поиска | обычно фиксировано | решает политика, с ограничением на максимум |
| Что обучается | модель ответа или поисковик (ретривер) | единая политика поисковых действий и итогового ответа |
| Награда | обычно потеря обучения с учителем на ответе | награда за результат всей траектории |
Таблица 8.3. Фиксированный RAG и Search-R1.
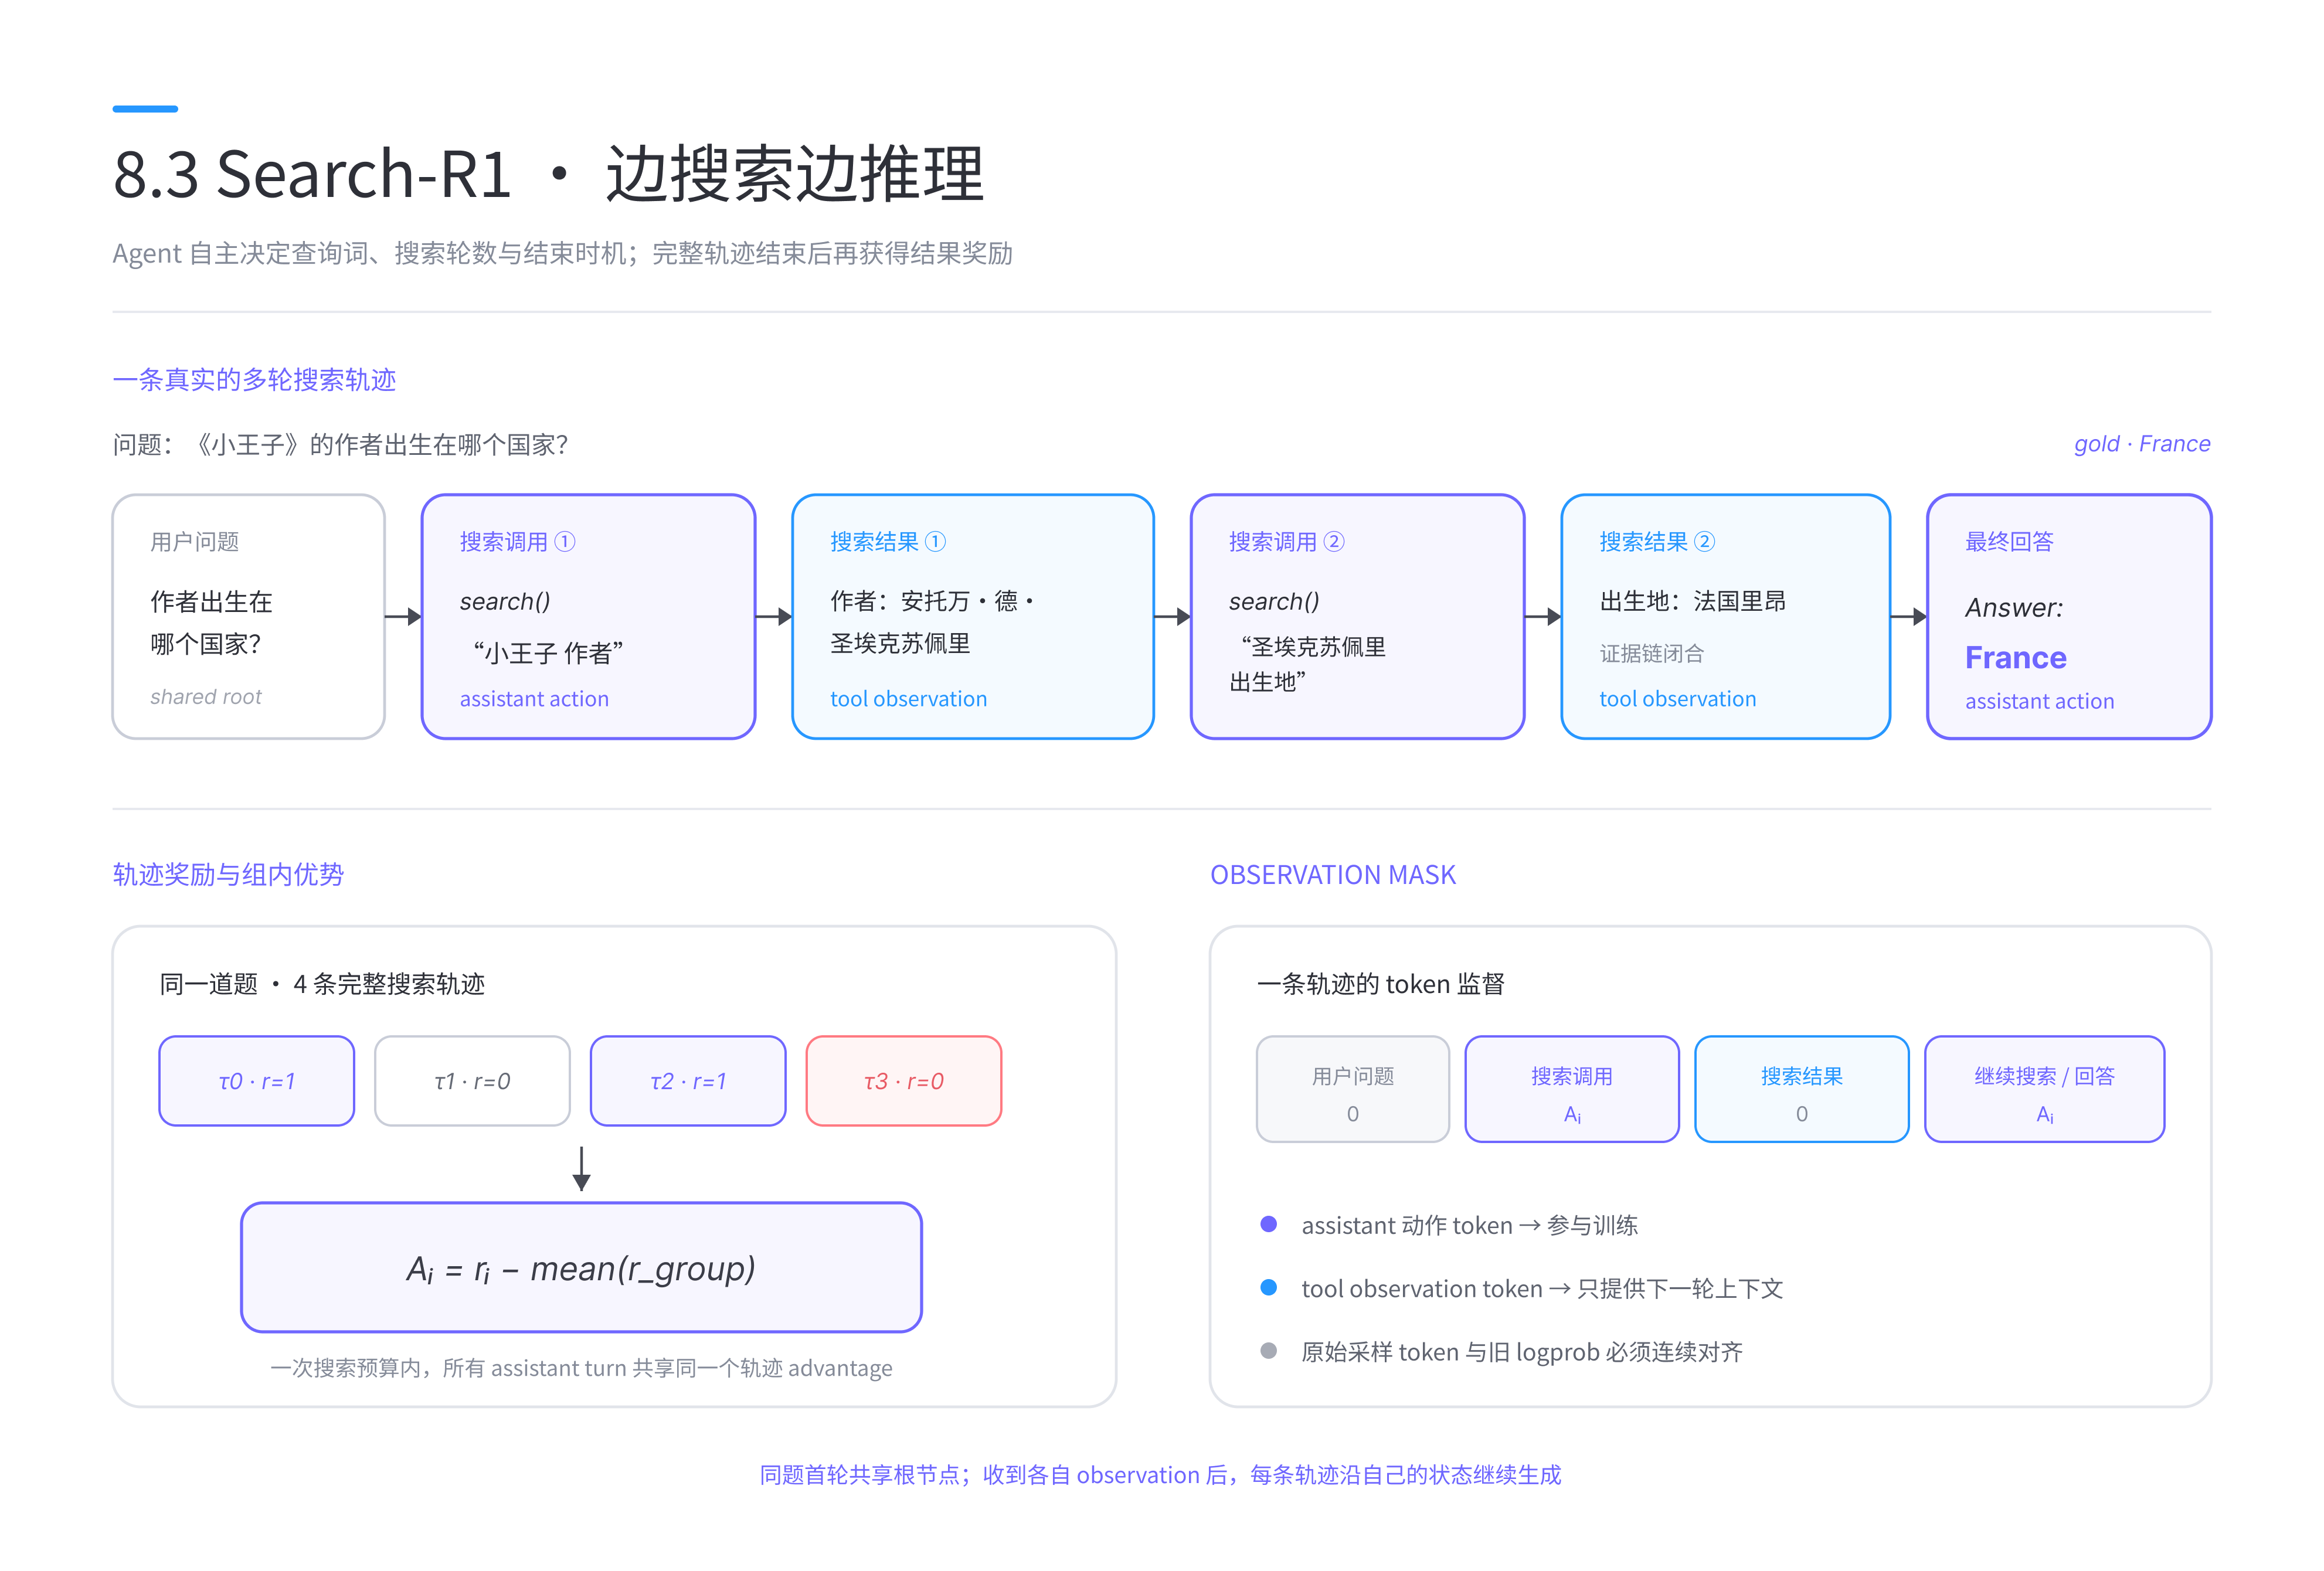
Например, вопрос «В какой стране родился автор „Маленького принца“?» требует сначала установить автора, а затем найти его место рождения. Модель может построить такую траекторию:
User: What country was the author of The Little Prince born in?
Assistant -> search("The Little Prince author")Tool: Antoine de Saint-Exupéry ...
Assistant -> search("Antoine de Saint-Exupéry birthplace country")Tool: He was born in Lyon, France ...
Assistant: Answer: France
Второй запрос зависит от первого observation, поэтому его нельзя определить заранее, до начала rollout. Код обучения должен хранить состояние среды и разбирать действие модели после каждого хода Assistant.
flowchart LR
Q["Вопрос:<br/>где родился автор<br/>«Маленького принца»?<br/>(общий корень)"] --> S1["Вызов поиска 1:<br/>search «автор Маленького принца»<br/>(действие ассистента)"]
S1 --> O1["Результат 1:<br/>Антуан де Сент-Экзюпери<br/>(наблюдение)"]
O1 --> S2["Вызов поиска 2:<br/>search «место рождения<br/>Сент-Экзюпери»"]
S2 --> O2["Результат 2:<br/>Лион, Франция<br/>(цепочка доказательств замкнута)"]
O2 --> A["Итоговый ответ:<br/>Answer: France"]
Рисунок 8.4. Многоходовый поиск и маска наблюдений в Search-R1 (изображение в оригинале). Подзаголовок: «агент сам решает, что искать, сколько раундов поиска делать и когда остановиться; награду за результат получает после окончания всей траектории». Нижняя левая часть — «награда за траекторию и групповое преимущество»: одна задача, 4 полные траектории поиска с наградами , , , ; ; «в пределах одного бюджета поиска все ходы ассистента делят один advantage траектории». Нижняя правая часть — «маска наблюдений», надзор по токенам одной траектории: вопрос пользователя , вызов поиска , результат поиска , продолжение поиска или ответ ; «токены действий ассистента участвуют в обучении; токены наблюдений инструмента — только контекст следующего хода; исходные сэмплированные токены и старые logprob должны быть непрерывно выровнены». Внизу: «на одну задачу первый ход общий (корень); получив свои наблюдения, каждая траектория продолжает генерацию из собственного состояния».
В статье Search-R1 действия и наблюдения обозначены текстовыми тегами <search>... </search>,
<information>... </information> и т. п. В этой главе используется модель Qwen3.5-4B и её собственный (native)
шаблон function calling:
SEARCH_TOOL = { "type": "function", "function": { "name": "search", "description": "Search the web for evidence.", "parameters": { "type": "object", "properties": { "query": {"type": "string"}, }, "required": ["query"], }, },}Оба протокола несут одинаковый смысл для обучения с подкреплением: Assistant выдаёт обучаемое действие, поисковый бэкенд возвращает observation среды. Собственный шаблон модели уменьшает конфликт между базовыми способностями модели и форматом инструментов и к тому же сохраняет структурированные сообщения инструмента.
Примечание переводчика. Описание инструмента (
"Search the web for evidence."— «Искать в сети подтверждения») оставлено по-английски, как и все промпты этого проекта: модель обучают на английских вопросах NQ и HotpotQA. Системный промпт изprotocol.pyв переводе: «Ты отвечаешь на фактические вопросы с помощью поискового инструмента. Ищи, когда нужны подтверждения. Можно вызывать search несколько раз с краткими английскими запросами. Вызывай search ровно один раз за ход ассистента и жди результата, прежде чем искать снова. Когда будешь готов, закончи ровно одной непустой строкой в форматеAnswer: <короткий ответ>. Не вызывай инструмент и не давай итоговый ответ в одном ходе» — и дальше разобран пример про «Маленького принца» в пять шагов.
Определив инструмент, нужно ещё строго разбирать вывод модели на три состояния: допустимый поиск, итоговый ответ или
недопустимый вывод. Парсер в protocol.py требует, чтобы в одном ходе был ровно один полный вызов search и чтобы
после вызова инструмента не было «подмешанного» итогового ответа:
def parse_assistant(text: str) -> ParsedAssistant:    matches = list(TOOL_CALL_PATTERN.finditer(text))    if not matches:        kind = (            "invalid" if "<tool_call>" in text else "answer"        )        return ParsedAssistant(            kind=kind,            content=text.strip(),        )
    if len(matches) != 1 or text[matches[0].end():].strip():        return ParsedAssistant(            kind="invalid",            content=text.strip(),        )
    query = matches[0].group(1).strip()    if not query or "<" in query or ">" in query:        return ParsedAssistant(            kind="invalid",            content=text.strip(),        )
    content = text[:matches[0].start()].strip()    return ParsedAssistant(        kind="tool",        content=content,        query=query,    )
Отдельного действия «стоп» здесь нет. Если в выводе нет допустимого вызова инструмента, ход считается итоговым ответом
и траектория заканчивается; потом reward.py проверит, соответствует ли он формату Answer: <short answer>. Вывод
с обрывком <tool_call> помечается как invalid — он тоже заканчивает траекторию и получает штраф за формат.
Примечание переводчика.
TOOL_CALL_PATTERNв файле ищет XML-подобную разметку, в которой Qwen3.5 записывает вызовы инструментов:<tool_call><function=search><parameter=query>…</parameter></function></tool_call>. Это и есть «родной формат»: вызов инструмента для модели — просто текст с особыми тегами, который шаблон чата превращает в структуру. Пример трёх исходов:«Ищу.<tool_call>…query…</tool_call>»→tool;«Answer: Paris»→answer;«<tool_call><function=search>»(обрыв) →invalid.
8.3.2 Как поисковый бэкенд становится observation среды
Заголовок раздела «8.3.2 Как поисковый бэкенд становится observation среды»search.py предоставляет три бэкенда: DeepSeek Search, Wikipedia и Чжиху (Zhihu). Rollout не зависит ни от какого формата
HTTP-ответа — только от единого SearchResult:
@dataclass(frozen=True)class SearchItem:    title: str    content: str    source: str | None = None    url: str | None = None

@dataclass(frozen=True)class SearchResult:    ok: bool    items: list[SearchItem]    latency: float    status: int | None = None    error: str | None = None
Точка входа обучения создаёт бэкенд по аргументам командной строки, а дальнейший конечный автомат всегда вызывает один
и тот же интерфейс search(query):
def create_search_client( backend: str, env_path: str | Path | None = None, *, model: str = "deepseek-v4-flash", timeout: float | None = None,) -> SearchClient: resolved_timeout = resolve_search_timeout( backend, timeout ) if backend == "deepseek": return DeepSeekSearchClient.from_env( env_path, model=model, timeout=resolved_timeout, ) if backend == "wikipedia": return WikipediaSearchClient( timeout=resolved_timeout ) if backend == "zhihu": return ZhihuSearchClient.from_env( env_path, timeout=resolved_timeout, ) raise ValueError(f"Неподдерживаемый поисковый бэкенд: {backend}")Возьмём для примера бэкенд Wikipedia, которому не нужен ключ: сам поиск происходит в _request(). Один запрос к API
выполняет полнотекстовый поиск и сразу возвращает заголовки, начальные фрагменты текста и URL трёх первых страниц:
def _request( self, query: str, started: float,) -> SearchResult: params = urllib.parse.urlencode( { "action": "query", "format": "json", "formatversion": 2, "generator": "search", "gsrsearch": query, "gsrlimit": 3, "prop": "extracts|info", "explaintext": 1, "exintro": 1, "exchars": 1200, "inprop": "url", "redirects": 1, "utf8": 1, } ) request = urllib.request.Request( f"{WIKIPEDIA_SEARCH_ENDPOINT}?{params}", headers={ "Accept": "application/json", "Accept-Encoding": "gzip", "User-Agent": WIKIPEDIA_USER_AGENT, }, ) with urllib.request.urlopen( request, timeout=self.timeout, ) as response: body = response.read() if response.headers.get( "Content-Encoding" ) == "gzip": body = gzip.decompress(body) payload = json.loads(body.decode("utf-8")) pages = payload.get("query", {}).get( "pages", [] ) if not isinstance(pages, list): raise TypeError( "В ответе поиска Wikipedia поле pages — не список" ) if any( not isinstance(page, dict) for page in pages ): raise TypeError( "В ответе поиска Wikipedia page — не объект" ) ordered_pages = sorted( pages, key=lambda page: int( page.get("index", 1_000_000) ), ) items = [ SearchItem( title=str( page.get("title") or "Untitled" ).strip(), content=str( page.get("extract") or "" ).strip(), source="Wikipedia", url=str( page.get("fullurl") or "" ).strip(), ) for page in ordered_pages if str(page.get("extract") or "").strip() ] return SearchResult( ok=True, items=items, latency=time.perf_counter() - started, status=response.status, )Внешний search() ещё отвечает за ограничение частоты запросов, timeout, ограниченное число повторов при ответах
429 и 5xx и копит статистику успешности и задержек. Если после повторов запрос всё равно не удался, он не обрушивает
весь rollout исключением, а возвращает SearchResult(ok=False, error=...). rollout.py передаст модели и текст ошибки
как observation — модель сможет ответить или переписать запрос.
Читаем параметры (от переводчика). Это MediaWiki API:
generator=search+gsrsearch— полнотекстовый поиск,gsrlimit=3— три страницы,prop=extractsсexintroиexplaintext— вводный раздел статьи простым текстом,exchars=1200— не длиннее 1200 символов,inprop=url— добавить ссылку. Ответ сортируется по полюindex, то есть по релевантности поиска.
Результаты разных бэкендов в итоге форматируются как читаемые доказательства:
[1] Title: ... Content: ... Source: ... URL: ...Возвращать только заголовки или ссылки обычно мало: модели на самом деле нужен content, на который можно опереться
в следующем шаге рассуждения. max_tool_response_tokens и max_trajectory_tokens ещё раз ограничивают длину
доказательств перед тем, как observation попадёт в траекторию.
8.3.3 Конечный автомат многоходового rollout
Заголовок раздела «8.3.3 Конечный автомат многоходового rollout»Одноходовому GRPO хватает одного sample(). В Search-R1 каждая траектория может пройти разное число поисковых вызовов,
и тренеру приходится раз за разом выполнять «сгенерировать — разобрать — вызвать среду — дописать observation».
В этой главе траектория хранится как Trajectory:
@dataclassclass AssistantTurn:    prompt_tokens: list[int]    completion_tokens: list[int]    logprobs: list[float]    text: str

@dataclassclass Trajectory:    example: SearchExample    group_index: int    messages: list[dict[str, Any]]    next_prompt_tokens: list[int] | None = None    question_index: int = 0    turns: list[AssistantTurn] = field(default_factory=list)    search_calls: int = 0    final_text: str = ""    reward: float = -0.1    advantage: float = 0.0    valid_format: bool = False    exact_match: bool = False    done: bool = False
Каждый AssistantTurn хранит полный prompt перед сэмплированием этого хода, токены, сгенерированные моделью,
и соответствующие logprob старой политики. Результаты поиска лежат в messages и в prompt следующего хода, но
logprob от rollout у них нет: эти токены пришли из среды.
Запросы к PyTRIO на самом деле отправляет sample_requests_async(). В одном ходе разные вопросы или уже разошедшиеся
траектории можно сэмплировать параллельно:
async def sample_requests_async( sampling_client: Any, requests: list[SampleRequest], config: RolloutConfig, tokenizer: Any,) -> list[Any]: tasks = [] for request in requests: params = trio.SamplingParams( max_tokens=request.max_tokens, seed=request.seed, stop=stop_sequences(tokenizer), temperature=config.temperature, top_p=config.top_p, ) tasks.append( sampling_client.sample_async( prompt=trio.ModelInput.from_ints( request.prompt_tokens ), num_samples=request.num_samples, sampling_params=params, return_text=True, ) ) return list(await asyncio.gather(*tasks))Когда сэмплирование вернулось, consume_assistant() сначала сохраняет исходные токены и old logprob, затем вызывает
парсер протокола из прошлого раздела. Допустимый поиск становится PendingSearch; итоговый ответ, недопустимый формат
или исчерпанный бюджет заканчивают текущую траекторию:
def consume_assistant(    trajectory: Trajectory,    prompt_tokens: list[int],    sequence: Any,    tokenizer: Any,    config: RolloutConfig,) -> PendingSearch | None:    tokens, logprobs, text = read_sequence(        sequence, tokenizer    )    trajectory.turns.append(        AssistantTurn(            prompt_tokens,            tokens,            logprobs,            text,        )    )    parsed = parse_assistant(text)
    can_search = (        parsed.kind == "tool"        and trajectory.search_calls        < config.max_search_calls        and len(trajectory.turns)        < config.max_assistant_turns    )    if not can_search:        trajectory.messages.append(            {"role": "assistant", "content": text}        )        trajectory.final_text = text        trajectory.done = True        return None
    call_id = (        f"search-{trajectory.question_index}-"        f"{trajectory.group_index}-"        f"{trajectory.search_calls + 1}"    )    messages_before_assistant = list(        trajectory.messages    )    trajectory.messages.append(        {"role": "assistant", "content": text}    )    return PendingSearch(        trajectory=trajectory,        messages_before_assistant=(            messages_before_assistant        ),        assistant_text=text,        prompt_tokens=prompt_tokens,        completion_tokens=tokens,        call_id=call_id,        query=parsed.query or "",    )
resolve_searches() пулом потоков параллельно вызывает поисковый бэкенд для разных траекторий и затем в исходном
порядке сопоставляет результаты ожидающим траекториям:
def resolve_searches( pending_searches: list[PendingSearch], search_client: SearchClient, tokenizer: Any, config: RolloutConfig,) -> int: if not pending_searches: return 0 workers = min( config.search_concurrency, len(pending_searches), ) with ThreadPoolExecutor( max_workers=workers ) as pool: results = list( pool.map( search_client.search, [ pending.query for pending in pending_searches ], ) ) return sum( finish_search( pending, result, tokenizer, config, ) for pending, result in zip( pending_searches, results, strict=True, ) )Каждый результат затем записывается обратно в свою траекторию функцией finish_search():
def finish_search(    pending: PendingSearch,    result: SearchResult,    tokenizer: Any,    config: RolloutConfig,) -> bool:    fitted = fit_tool_content(        tokenizer,        pending.messages_before_assistant,        pending.assistant_text,        pending.prompt_tokens,        pending.completion_tokens,        pending.call_id,        result,        config,    )    if fitted is None:        pending.trajectory.final_text = (            pending.assistant_text        )        pending.trajectory.done = True        return True
    content, next_prompt_tokens = fitted    pending.trajectory.messages.append(        tool_message(pending.call_id, content)    )    pending.trajectory.next_prompt_tokens = (        next_prompt_tokens    )    pending.trajectory.search_calls += 1    return False
fit_tool_content() добавляет найденные доказательства по одному. Как только observation превышает бюджет одного
вызова инструмента или бюджет всей траектории, следующие доказательства перестают добавляться; если не помещается даже
один результат, траектория сразу заканчивается. Так «сколько текста вернул поисковый сервис» и «сколько текста реально
увидела модель» становятся двумя явно разделёнными границами.
Примечание переводчика. Обратите внимание: траектория, у которой не поместился результат, заканчивается на ходе с вызовом инструмента. Её
final_text— это текст с<tool_call>, а не строкаAnswer: …, поэтому она получит награду за неверный формат. Бюджет контекста тем самым тоже «учит» модель: слишком долгий поиск невыгоден.
Группа траекторий GRPO на первом ходе имеет полностью одинаковый prompt. Код одним запросом генерирует group_size
ветвей:
first_requests: list[SampleRequest] = []for index, trajectory in enumerate(roots): request = make_request( tokenizer, trajectory, index, config.group_size, config.seed + index, config, ) if request: first_requests.append(request)Каждая последовательность (sequence) из ответа сэмплирования глубоко копируется из корневой траектории в независимую ветвь, после чего её поисковое действие разбирается отдельно:
responses = asyncio.run(    sample_requests_async(        sampling_client,        first_requests,        config,        tokenizer,    ))pending_searches: list[PendingSearch] = []for request, response in zip(    first_requests,    responses,    strict=True,):    root = roots[request.trajectory_index]    if len(response.sequences) != config.group_size:        raise ValueError(            "Число выборок первого хода не совпадает с group_size"        )
    for group_index, sequence in enumerate(        response.sequences    ):        branch = copy.deepcopy(root)        branch.group_index = group_index        pending = consume_assistant(            branch,            request.prompt_tokens,            sequence,            tokenizer,            config,        )        trajectories.append(branch)        if pending is not None:            pending_searches.append(pending)
resolve_searches(    pending_searches,    search_client,    tokenizer,    config,)
После поиска у разных ветвей уже разные observation и история действий. На следующих ходах для каждой незаконченной
траектории отдельно ставится num_samples=1:
while any(not item.done for item in trajectories):    requests: list[SampleRequest] = []    for index, trajectory in enumerate(trajectories):        if trajectory.done:            continue        request = make_request(            tokenizer,            trajectory,            index,            1,            (                config.seed                + index                + len(trajectory.turns) * 10_000            ),            config,        )        if request:            requests.append(request)
    if not requests:        break    responses = asyncio.run(        sample_requests_async(            sampling_client,            requests,            config,            tokenizer,        )    )
    pending_searches = []    for request, response in zip(        requests, responses, strict=True    ):        if len(response.sequences) != 1:            raise ValueError(                "На следующих ходах сэмплируется ровно одна ветвь"            )        trajectory = trajectories[            request.trajectory_index        ]        pending = consume_assistant(            trajectory,            request.prompt_tokens,            response.sequences[0],            tokenizer,            config,        )        if pending is not None:            pending_searches.append(pending)
    resolve_searches(        pending_searches,        search_client,        tokenizer,        config,    )
Такая реализация «общий корень, затем ветвление» одновременно выполняет два условия: траектории одной задачи можно сравнивать внутри группы GRPO, а каждая ветвь может действовать дальше по своим результатам поиска. Несколько запросов сэмплирования к PyTRIO и поисковых запросов выполняются параллельно, и это сокращает ожидание, которое приносит многоходовое взаимодействие со средой.
Конечному автомату ещё нужны чёткие границы:
max_search_calls: сколько раз максимум одна траектория может вызвать поиск;max_assistant_turns: сколько максимум ходов Assistant генерируется;max_assistant_tokens: предел токенов на одно действие (один ход);max_tool_response_tokens: предел токенов на одно observation;max_trajectory_tokens: общий предел токенов на весь контекст;- timeout и concurrency (параллелизм) поиска: ограничивают ожидание внешнего сервиса и нагрузку на него.
Эти ограничения и контролируют стоимость обучения, и определяют, к какой части среды агент имеет доступ. При оценке нужно сохранять ту же конфигурацию — иначе больший бюджет поиска сам по себе может повысить долю правильных ответов.
Примечание переводчика. Значения по умолчанию в
train.py: 8 вопросов на шаг, группа из 8 траекторий, до 4 поисков, до 6 ходов ассистента, до 1024 токенов на ход и на один результат поиска, до 8192 токенов на траекторию; бэкенд по умолчанию — DeepSeek Search (нужен ключ в.env), модель —Qwen/Qwen3.5-4Bс LoRA ранга 32. Значит, на один шаг обучения — 64 траектории и до 256 поисковых запросов.
8.3.4 Протокол инструментов и непрерывность токенов
Заголовок раздела «8.3.4 Протокол инструментов и непрерывность токенов»Самая частая ошибка многоходового обучения — токены после повторной отрисовки шаблона чата не совпадают с реально сэмплированными. Токенизатор может почистить пробелы, нормализовать текст вызова инструмента или сам добавить символ конца хода. Если на этапе обучения заново кодировать текст модели, старые logprob перестанут один к одному соответствовать целевым токенам.
В этой главе соблюдаются два принципа:
- для действий Assistant всегда хранятся исходные токены, которые вернул sampler;
- через шаблон чата вычисляются только вновь добавляемые символ конца хода и токены observation инструмента.
Полная задача build_next_prompt() — извлечь из шаблона чата только приращение «конец хода Assistant + новое
observation» и приклеить его после настоящего ответа, который вернул sampler:
def build_next_prompt(    tokenizer: Any,    messages_before_assistant: list[dict[str, Any]],    assistant_text: str,    previous_prompt_tokens: list[int],    completion_tokens: list[int],    next_tool_message: dict[str, Any],) -> list[int]:    canonical_prompt = build_prompt(        tokenizer,        messages_before_assistant,    )
    empty_assistant_end = _render_chat(        tokenizer,        [            *messages_before_assistant,            {"role": "assistant", "content": ""},        ],        add_generation_prompt=False,    )    if empty_assistant_end[        :len(canonical_prompt)    ] != canonical_prompt:        raise ValueError(            "По пустому сообщению assistant не удалось выделить границу конца хода в chat template"        )    assistant_closing_tokens = empty_assistant_end[        len(canonical_prompt):    ]
    assistant_message = {        "role": "assistant",        "content": assistant_text,    }    messages_with_assistant = [        *messages_before_assistant,        assistant_message,    ]    canonical_assistant_end = _render_chat(        tokenizer,        messages_with_assistant,        add_generation_prompt=False,    )    canonical_next_prompt = build_prompt(        tokenizer,        [*messages_with_assistant, next_tool_message],    )    if canonical_next_prompt[        :len(canonical_assistant_end)    ] != canonical_assistant_end:        raise ValueError(            "После добавления tool observation chat template переписал историю сообщений"        )
    observation_tokens = canonical_next_prompt[        len(canonical_assistant_end):    ]    overlap = _suffix_prefix_overlap(        completion_tokens,        assistant_closing_tokens,    )    return [        *previous_prompt_tokens,        *completion_tokens,        *assistant_closing_tokens[overlap:],        *observation_tokens,    ]
overlap обрабатывает случай, когда sampler уже вернул часть символов конца хода Assistant, — чтобы не дописать токены
дважды. messages нужны для записи протокола и отладки, а next_prompt_tokens — это то, что действительно отправляется
sampler на следующем ходе; путать их нельзя.
Пример (от переводчика). Пусть конец хода в шаблоне — токены
[<|im_end|>, \n], а sampler остановился на стоп- токене и вернул ответ, оканчивающийся на<|im_end|>. Тогда самый длинный «хвост ответа = начало закрывающих токенов» — это один токен,overlap = 1, и дописывается только\n. Если sampler вернул ответ без<|im_end|>,overlap = 0и дописываются оба токена.
При построении обучающих данных для следующего хода выполняется ещё одна проверка:
if turn.prompt_tokens[:len(full_tokens)] != full_tokens: raise ValueError( "Prompt следующего хода не является продолжением уже собранной траектории" )Эти два уровня проверок рано выявляют переписывание шаблона, дублирование конца хода и ошибки склейки observation. В Agentic RL непрерывность токенов — часть правильности алгоритма: траектория может выглядеть разумно на уровне текста и всё равно давать неверный градиент из-за сдвига границ токенов.
Примечание переводчика. Типичный пример «переписывания истории» — шаблоны рассуждающих моделей, которые при отрисовке удаляют блоки
<think>…</think>из прошлых ходов ассистента. Тогда префикс следующего prompt не совпадёт с тем, что модель видела при генерации, и первая проверка выдаст ошибку. Вот почему код сравнивает токены, а не текст.
8.3.5 Награда, групповое преимущество и маска наблюдений
Заголовок раздела «8.3.5 Награда, групповое преимущество и маска наблюдений»В этой главе используются задачи с коротким ответом из NQ и HotpotQA. В конце модель должна вывести ровно одну строку:
Answer: <short answer>Награда по правилам — три уровня:
reward.py сначала извлекает единственную строку итогового ответа, затем приводит к одному виду регистр, пунктуацию,
английские артикли и пробелы:
def normalize_answer(text: str) -> str:    lowered = text.lower()    without_punctuation = "".join(        char        for char in lowered        if not unicodedata.category(char).startswith("P")    )    without_articles = ARTICLE_PATTERN.sub(        " ", without_punctuation    )    return " ".join(without_articles.split())

def extract_answer(text: str) -> str | None:    matches = ANSWER_PATTERN.findall(text)    if len(matches) != 1:        return None    answer = matches[0].strip()    return answer or None

def score_answer(    text: str,    references: list[str],) -> RewardResult:    answer = extract_answer(text)    if answer is None:        return RewardResult(            -0.1, False, False, None        )    normalized = normalize_answer(answer)    exact_match = any(        normalized == normalize_answer(reference)        for reference in references    )    return RewardResult(        float(exact_match),        True,        exact_match,        answer,    )
Этот код оценивает только итоговый результат задачи — никаких дополнительных баллов за «сколько раз искал» или «запрос выглядит хорошо». Для полных траекторий одного вопроса по-прежнему используется групповая база GRPO:
В статье Search-R1 рассматриваются разные способы оптимизации, включая PPO и GRPO. В этой главе выбрана схема GRPO с группами по одной задаче, чтобы Search-R1 строил advantage тем же способом, что и раздел 8.1.
Примечание переводчика.
ANSWER_PATTERN—^\s*Answer:\s*(.*?)\s*$с флагами «без учёта регистра» и «многострочный»;ARTICLE_PATTERNудаляет слова a, an, the. Пример: ответAnswer: The Eiffel Tower.и эталонeiffel towerпосле нормализации оба даютeiffel tower— награда 1. Две строкиAnswer:в выводе — уже недопустимый формат, . Такую метрику называют точное совпадениеточное совпадение (EM)EN exact matchМетрика «1, если нормализованный ответ совпал с эталоном, иначе 0». Всё решает нормализация и извлечение ответа..
rollout_batch() обязан дождаться окончания всех траекторий группы, и только потом выполнить такую функцию:
def assign_group_advantages(    trajectories: list[Trajectory],) -> int:    groups: dict[int, list[Trajectory]] = {}    for trajectory in trajectories:        groups.setdefault(            trajectory.question_index, []        ).append(trajectory)
    degenerate = 0    for group in groups.values():        mean_reward = sum(            item.reward for item in group        ) / len(group)        for item in group:            item.advantage = (                item.reward - mean_reward            )        if all(            item.advantage == 0.0 for item in group        ):            degenerate += 1    return degenerate
Когда награды всей группы одинаковы, все advantage равны 0, и группа не даёт полезного градиента. Код обучения пропускает такие траектории и записывает долю вырожденных групп. Групповое среднее нельзя считать после разбиения на micro-batch (микробатчи) — иначе база сравнения уже изменится.
Этот advantage присваивается всем токенам, сгенерированным в каждом ходе Assistant траектории. Observation поиска — лишь состояние, нужное для следующего решения, а не действие политики, поэтому logprob и advantage у токенов observation равны 0:
full_tokens.extend(delta_observation)old_logprobs_by_token.extend(    [0.0] * len(delta_observation))advantages_by_token.extend(    [0.0] * len(delta_observation))
full_tokens.extend(turn.completion_tokens)old_logprobs_by_token.extend(turn.logprobs)advantages_by_token.extend(    [trajectory.advantage]    * len(turn.completion_tokens))
Такая observation mask (маска наблюдений) делает две вещи. Во-первых, тренер не требует от модели предсказывать текст, который вернул поисковик; во-вторых, observation остаётся в контексте, и последующие токены Assistant могут опираться на эти доказательства.
Вызовы поиска и итоговый ответ делят один advantage на уровне траектории. Если итоговый ответ верен, поощряются и спланированные запросы, и поисковые слова, и токены ответа, которые привели к успеху; если неверен — подавляется вся цепочка действий. Именно поэтому награда за результат (outcome reward) способна обучить стратегию использования инструментов.
Пример (от переводчика). По рисунку 8.4: награды , среднее , advantage . В траектории из двух поисков и ответа все три хода ассистента получат на каждый токен; тексты из Википедии между ними — 0. Если бы модель «зазубрила» текст Википедии без маски, она училась бы генерировать чужие статьи — ровно то, чего маска не допускает.
8.3.6 Построение многоходового Datum для PyTRIO
Заголовок раздела «8.3.6 Построение многоходового Datum для PyTRIO»build_datum() в train.py сводит вместе непрерывность токенов и маску наблюдений из предыдущих разделов. Вот полная
основная реализация:
def build_datum(    trajectory: Trajectory,) -> TrainingDatum:    if not trajectory.turns:        raise ValueError(            "Нельзя построить обучающий Datum из траектории без ходов assistant"        )
    full_tokens: list[int] = []    old_logprobs_by_token: list[float] = []    advantages_by_token: list[float] = []    assistant_token_count = 0
    for turn_index, turn in enumerate(        trajectory.turns    ):        if len(turn.completion_tokens) != len(            turn.logprobs        ):            raise ValueError(                f"В ходе assistant №{turn_index + 1} "                "длины токенов и logprob не совпадают"            )
        if turn_index == 0:            delta_observation = turn.prompt_tokens        elif turn.prompt_tokens[            :len(full_tokens)        ] == full_tokens:            delta_observation = turn.prompt_tokens[                len(full_tokens):            ]        else:            raise ValueError(                f"Prompt хода assistant №{turn_index + 1} "                "не является продолжением уже собранной траектории, "                "logprob сэмплирования нельзя безопасно выровнять"            )
        full_tokens.extend(delta_observation)        full_tokens.extend(turn.completion_tokens)        old_logprobs_by_token.extend(            [0.0] * len(delta_observation)        )        old_logprobs_by_token.extend(turn.logprobs)        advantages_by_token.extend(            [0.0] * len(delta_observation)        )        advantages_by_token.extend(            [trajectory.advantage]            * len(turn.completion_tokens)        )        assistant_token_count += len(            turn.completion_tokens        )
    if assistant_token_count == 0:        raise ValueError(            "Нельзя построить обучающий Datum из траектории без токенов assistant"        )    if not (        len(full_tokens)        == len(old_logprobs_by_token)        == len(advantages_by_token)    ):        raise ValueError(            "У полной траектории не совпадают длины токенов, logprob и advantage"        )
    input_tokens = full_tokens[:-1]    target_tokens = full_tokens[1:]    old_logprobs = old_logprobs_by_token[1:]    advantages = advantages_by_token[1:]    if not (        len(input_tokens)        == len(target_tokens)        == len(old_logprobs)        == len(advantages)    ):        raise ValueError(            "У Datum не совпадают длины input, target, logprobs и advantages"        )    if len(input_tokens) > MAX_TRAIN_CONTEXT_TOKENS:        raise ValueError(            f"Datum длиннее {MAX_TRAIN_CONTEXT_TOKENS} токенов"        )
    datum = trio.Datum(        model_input=trio.ModelInput.from_ints(            input_tokens        ),        loss_fn_inputs={            "target_tokens": np.asarray(                target_tokens,                dtype=np.int64,            ),            "logprobs": np.asarray(                old_logprobs,                dtype=np.float32,            ),            "advantages": np.asarray(                advantages,                dtype=np.float32,            ),        },    )    return TrainingDatum(datum, len(input_tokens))
На первом ходе delta_observation — это системный промпт, описание инструментов и вопрос пользователя; на следующих —
конец предыдущего хода, результаты поиска и начало нового хода Assistant. В них сохраняются настоящие целевые токены,
но old logprob и advantage равны 0. Только токены Assistant, реально сгенерированные sampler, несут old logprob из
rollout и advantage траектории.
Примечание переводчика. Сравните со сдвигом в 8.1: там prompt «отрезали» вручную (
len(prompt) - 1нулей), здесь сначала собирают всю последовательность токенов, а потом сдвигают одним движением:input = full[:-1],target = full[1:], а logprob и advantage сдвигают так же, как target. Результат тот же, но способ работает для любого числа ходов.MAX_TRAIN_CONTEXT_TOKENSв файле равен 8192.
Награды всей группы должны быть посчитаны полностью — только тогда получится правильное групповое среднее. Обновлять политику сразу после окончания одной траектории нельзя: награды других ветвей той же группы ещё неизвестны.
Длины многоходовых траекторий сильно различаются, и если положить все данные в один батч с дополнением (padding),
впустую уйдёт много токенов. Сопутствующий код раскладывает Datum по нескольким micro-batch по длине примеров
и перевзвешивает потерю пропорционально доле траекторий каждого микробатча в полном rollout. Так удаётся держать
под контролем объём padding в одном батче и при этом сохранить смысл градиента как среднего по всем примерам.
8.3.7 От rollout к одному обновлению параметров
Заголовок раздела «8.3.7 От rollout к одному обновлению параметров»Внешний цикл train.py соединяет все предыдущие модули в полный шаг обучения. Ключевой порядок менять нельзя:
batch = take_batch(    examples,    step * args.questions_per_batch,    args.questions_per_batch,)
sampling_client = (    training_client    .save_weights_and_get_sampling_client())
trajectories = rollout_batch(    sampling_client=sampling_client,    tokenizer=tokenizer,    search_client=search_client,    examples=batch,    config=rollout_config,)
datums = build_training_datums(trajectories)micro_batches = pack_micro_batches(datums)
trainer_results = []for micro_batch in micro_batches:    weighted_datums = (        weight_micro_batch_for_global_mean(            micro_batch,            total_samples=len(trajectories),        )    )    result = training_client.forward_backward(        weighted_datums,        loss_fn="importance_sampling",    ).result()    trainer_results.append(result)
if micro_batches:    training_client.optim_step(        adam_params    ).result()
Первое: save_weights_and_get_sampling_client() в начале каждого шага выгружает текущие LoRA-веса, поэтому old logprob
берутся у текущей политики до этого обновления. Второе: rollout_batch() внутри уже посчитал награды и advantage для
целых групп, а build_training_datums() пропускает траектории с нулевым advantage. Третье: все micro-batch только
накапливают градиенты, и для всего логического батча в конце вызывается один optim_step().
PyTRIO усредняет потери по примерам внутри одного forward_backward(). Если в -м микробатче траекторий,
а в полном батче rollout — траекторий, код сначала умножает advantage этого микробатча на :
Реализация только заново упаковывает Datum, не меняя целевые токены и old logprob:
micro_batch_weight = np.float32( len(micro_batch) / total_samples)weighted_datums = []for item in micro_batch: loss_inputs = item.datum.loss_fn_inputs weighted_datums.append( trio.Datum( model_input=item.datum.model_input, loss_fn_inputs={ "target_tokens": ( loss_inputs["target_tokens"] .to_numpy() ), "logprobs": ( loss_inputs["logprobs"] .to_numpy() ), "advantages": ( loss_inputs["advantages"] .to_numpy() * micro_batch_weight ), }, ) )Поэтому динамическое разбиение на батчи меняет только padding и расход видеопамяти при выполнении, но не меняет градиент логического батча как среднее по примерам.
Проверим формулу (от переводчика). траекторий с потерями разложены на микробатчи из 5 и 3. Каждый
forward_backwardусредняет: и . С весами и сумма равна — среднему по всем восьми. Без весов траектории из маленького микробатча весили бы больше. Умножать можно именно advantage, потому что потеряimportance_samplingлинейна по нему. Тот же приём — накопление градиентанакопление градиентовEN gradient accumulationГрадиенты складываются (+=), а не перезаписываются. Внутри графа так учитываются все пути к узлу; на уровне обучения — шаг оптимизатора делают раз в несколько микробатчей. с правильной нормировкой.
8.3.8 Запуск, оценка и границы эксперимента
Заголовок раздела «8.3.8 Запуск, оценка и границы эксперимента»Код Search-R1 разделён по обязанностям: данные, протокол, среда, rollout и обучение:
| Файл | Назначение |
|---|---|
prepare_data.py | готовит данные NQ и HotpotQA |
data.py | загружает примеры в едином формате JSONL |
protocol.py | описывает поисковый инструмент и протокол многоходовых сообщений |
search.py | оборачивает поисковые бэкенды и приводит результаты к единому формату |
rollout.py | выполняет конечный автомат многоходового поиска |
reward.py | извлекает короткий ответ и считает награду по правилам |
train.py | строит маску наблюдений и микробатчи, обновляет политику |
eval.py | оценивает в той же среде исходную модель (Base Model) или контрольную точку |
analyse.py | сводит результаты оценки |
Для оценки не написана отдельная упрощённая логика поиска — переиспользуется тот же rollout_batch(). Главное отличие —
на каждый вопрос остаётся одна траектория: сравнение внутри группы, нужное при обучении, больше не требуется:
config = RolloutConfig(    group_size=1,    max_search_calls=args.max_search_calls,    max_assistant_turns=args.max_assistant_turns,    max_trajectory_tokens=(        args.max_trajectory_tokens    ),    max_assistant_tokens=args.max_assistant_tokens,    max_tool_response_tokens=(        args.max_tool_response_tokens    ),    search_concurrency=args.search_concurrency,    temperature=args.temperature,    top_p=args.top_p,    seed=args.seed,)
batch_trajectories = rollout_batch(    sampling_client,    tokenizer,    search_client,    batch,    config,)
Если model_path пуст, eval.py создаёт sampler исходной модели; если передать путь, который вернул
save_weights_for_sampler(), оценивается обученная контрольная точка. Обе модели используют одинаковые протокол,
поисковый бэкенд, бюджет, набор вопросов и проверяльщик ответов.
Сначала подготовьте данные:
python docs/chapter8/search-r1/prepare_data.pyБэкенду Wikipedia не нужен API Key — он подходит, чтобы проверить всю цепочку:
python docs/chapter8/search-r1/train.py \ --max-steps 1 \ --questions-per-batch 1 \ --group-size 4 \ --max-search-calls 2 \ --search-backend wikipedia \ --search-concurrency 3 \ --swanlab-mode disabledОцените исходную модель в той же среде Wikipedia:
python docs/chapter8/search-r1/eval.py \ --search-backend wikipedia \ --batch-size 8 \ --output docs/chapter8/search-r1/eval_result/base.jsonlДля оценки обученных весов сэмплирования оставьте остальные параметры без изменений и добавьте только путь к контрольной точке:
python docs/chapter8/search-r1/eval.py \ --search-backend wikipedia \ --batch-size 8 \ --model-path 'trio://runxxxxxxxxxx' \ --output docs/chapter8/search-r1/eval_result/checkpoint.jsonlУбедившись, что процесс работает, постепенно увеличивайте число вопросов, group size, число поисков и бюджет траектории. В эксперименте нужно записывать как минимум:
- exact match итогового ответа;
- долю ответов в допустимом формате;
- среднее число вызовов поиска и долю траекторий без поиска;
- долю неудачных поисков, таймаутов и обрезанных observation;
- среднюю длину траектории и число полезных обучающих токенов на шаг;
- долю вырожденных групп;
- время каждого этапа: rollout, поиск и обучение.
Результаты поиска зависят от внешних систем. Онлайн-страницы обновляются, ранжирование поисковых сервисов тоже может меняться. Сравнивая исходную модель и обученную контрольную точку, фиксируйте набор вопросов, поисковый бэкенд, бюджет поиска, параметры сэмплирования и временное окно оценки. Для строго воспроизводимых экспериментов уровня статьи корпус и индекс поиска можно зафиксировать как снимок только для чтения.
В этой главе обновляется только политика языковой модели, поисковый бэкенд остаётся неизменным. Если обучаться должен и сам поисковик, нужно дополнительно определить пространство поисковых действий, версию индекса и распределение заслуг (credit assignment) между модулями — это уже выходит за рамки примера этого раздела.
Search-R1 показал, как расширить групповое относительное преимущество GRPO на многоходовые поисковые траектории с внешними observation. Следующий раздел, ReTool, сохранит тот же многоходовый rollout и маску наблюдений, заменит среду — вместо поисковика будет интерпретатор кода — и будет обновлять политику встроенной в PyTRIO потерей PPO.
От переводчика: что сделать руками
Заголовок раздела «От переводчика: что сделать руками»- Парсер и награда без GPU. Скопируйте
parse_assistant(сTOOL_CALL_PATTERNиз примечания) иscore_answerи прогоните десяток строк: правильный вызов, два вызова в одном ходе, вызов +Answer:, обрыв<tool_call>,Answer: The Beatlesпротив эталонаbeatles. - Поиск как среда. Вызовите MediaWiki API с параметрами из
_request()для запросаAntoine de Saint-Exupéry birthplace: что вернётся, сколько символов, сколько это токенов в токенизаторе Qwen? - Маска на бумаге. Для траектории «prompt 50 токенов → ход 1 (20) → результат поиска (300) → ход 2 (8)» посчитайте длину Datum и сколько позиций получат ненулевой advantage. Ответ: позиций, из них с advantage.
- Локально. Тот же цикл без PyTRIO умеют verl (многоходовые rollout с инструментами) и slime; как китайские лаборатории строят агентный RL, разобрано в уроке 8.3.4.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| agentic RL | агентное обучение с подкреплением |
| autonomous search | самостоятельный поиск |
| search backend | поисковый бэкенд |
| observation | наблюдение |
| observation mask | маска наблюдений |
| multi-turn trajectory | многоходовая траектория |
| state machine | конечный автомат |
| shared root / branching | общий корень / ветвление |
| tool protocol | протокол инструментов |
| token continuity | непрерывность токенов |
| end-of-turn token | символ конца хода |
| outcome reward | награда за результат |
| exact match | точное совпадение |
| budget | бюджет (предел) |
| micro-batch | микробатч |
| credit assignment | распределение заслуг |
| checkpoint | контрольная точка |