Diffusion Models Course, юнит 1: введение и библиотека Diffusers
Перевод юнита 1 курса Hugging Face о диффузионных моделях: как работают диффузионные модели и ноутбук «Введение в Diffusers» — данные, планировщик шума, U-Net, цикл обучения, генерация и публикация модели бабочек 32×32 на Hub.
Это перевод юнита 1 курса Diffusion Models Course от Hugging Face: вводный текст юнита и первый ноутбук «Introduction to 🤗 Diffusers». Второй ноутбук юнита — диффузионная модель с нуля — на отдельной странице. Карта курса — в README оригинала.
Юнит 1: введение в диффузионные модели
Заголовок раздела «Юнит 1: введение в диффузионные модели»Добро пожаловать в юнит 1 курса Hugging Face о диффузионных моделях! В этом юните вы узнаете основы того, как работают диффузионные модели и как создать свою с помощью библиотеки 🤗 Diffusers.
Начинаем юнит 🚀
Заголовок раздела «Начинаем юнит 🚀»Шаги этого юнита:
- Убедитесь, что записались на курс, чтобы получать уведомления о новых материалах.
- Прочитайте вводный материал ниже и те дополнительные ресурсы, которые покажутся интересными.
- Откройте ноутбук Introduction to Diffusers ниже, чтобы применить теорию на практике с библиотекой 🤗 Diffusers.
- Обучите и опубликуйте свою диффузионную модель с помощью ноутбука или учебного скрипта по ссылке.
- (Необязательно) Углубитесь с ноутбуком Diffusion Models from Scratch, если хотите увидеть минимальную реализацию с нуля и разобраться в разных проектных решениях.
- (Необязательно) Посмотрите это видео — неформальный разбор материала юнита.
📢 Не забудьте присоединиться к Discord, где можно обсуждать материал и
делиться тем, что получилось, в канале #diffusion-models-class.
Что такое диффузионные модели?
Заголовок раздела «Что такое диффузионные модели?»Диффузионные модели — сравнительно недавнее пополнение в семействе алгоритмов, которые называют «генеративными моделями». Цель генеративного моделирования — научиться генерировать данные, например изображения или звук, по набору обучающих примеров. Хорошая генеративная модель создаёт разнообразные результаты, похожие на обучающие данные, но не являющиеся их точными копиями. Как этого добиваются диффузионные модели? Для наглядности возьмём случай генерации изображений.
(В оригинале — рисунок из статьи DDPM (arXiv:2006.11239): цепочка изображений от чистой картинки до чистого шума ; стрелки вправо — прямой процесс , добавляющий шум, стрелки влево — обратный процесс , который учится его убирать.)
flowchart LR
X0["x₀<br/>картинка"] -- "+ шум" --> X1["x₁"] -- "+ шум" --> X2["…"] -- "+ шум" --> XT["x_T<br/>чистый шум"]
XT -. "модель убирает шум" .-> X2b["…"] -.-> X1b["x₁"] -.-> X0b["x₀<br/>новая картинка"]
Секрет успеха диффузионных моделей — в итеративности процесса диффузии. Генерация начинается со случайного шума, который постепенно уточняется за несколько шагов, пока не проявится изображение. На каждом шаге модель оценивает, как перейти от текущего входа к полностью очищенной от шума версии. Но поскольку на каждом шаге мы делаем лишь небольшое изменение, ошибки этой оценки на ранних этапах (где предсказать итоговый результат крайне трудно) исправляются в последующих обновлениях.
Обучить такую модель сравнительно просто по сравнению с некоторыми другими видами генеративных моделей. Мы раз за разом:
- загружаем несколько изображений из обучающих данных;
- добавляем шум — в разном количестве. Помните: мы хотим, чтобы модель хорошо оценивала, как «исправить» (очистить от шума) и совсем зашумлённые изображения, и почти идеальные;
- подаём зашумлённые версии входов в модель;
- оцениваем, насколько хорошо модель очищает эти входы от шума;
- по этой информации обновляем веса модели.
Чтобы генерировать новые изображения обученной моделью, мы начинаем с полностью случайного входа и раз за разом пропускаем его через модель, каждый раз немного обновляя по её предсказанию. Как мы увидим, есть множество методов сэмплирования, которые стараются упростить этот процесс, чтобы получать хорошие изображения за как можно меньшее число шагов.
Каждый из этих шагов мы подробно покажем в практических ноутбуках юнита 1. В юните 2 разберём, как изменить этот процесс, чтобы получить дополнительный контроль над результатом через дополнительные условия (например, метку класса) или техники вроде guidance («направления»). А юниты 3 и 4 посвящены очень мощной диффузионной модели Stable Diffusion, которая генерирует изображения по текстовым описаниям.
Практические ноутбуки
Заголовок раздела «Практические ноутбуки»Теперь вы знаете достаточно, чтобы взяться за ноутбуки! Два ноутбука подходят к одной идее с разных сторон.
| Глава | Где запустить |
|---|---|
| Introduction to Diffusers | Colab, Kaggle, Gradient, Studio Lab |
| Diffusion Models from Scratch | Colab, Kaggle, Gradient, Studio Lab |
В ноутбуке Introduction to Diffusers мы показываем описанные выше шаги на строительных блоках библиотеки diffusers. Вы быстро увидите, как создать, обучить свою диффузионную модель на любых данных и сэмплировать из неё. К концу ноутбука вы сможете читать и менять учебный скрипт обучения, чтобы обучать диффузионные модели и делиться ими со всем миром! Этот ноутбук также знакомит с главным упражнением юнита: всем вместе подобрать хорошие «рецепты обучения» диффузионных моделей разного масштаба — подробнее в следующем разделе.
В ноутбуке Diffusion Models from Scratch мы показываем те же шаги (добавление шума к данным, создание модели, обучение и сэмплирование), но реализованные с нуля на PyTorch — как можно проще. Затем сравниваем этот «игрушечный пример» с версией из diffusers и отмечаем, чем они отличаются и где сделаны улучшения. Цель — познакомиться с разными компонентами и проектными решениями, чтобы, глядя на новую реализацию, вы быстро узнавали ключевые идеи.
Время проекта
Заголовок раздела «Время проекта»Разобравшись в основах, попробуйте обучить одну или несколько диффузионных моделей! Несколько идей — в конце ноутбука Introduction to Diffusers. Обязательно делитесь результатами, рецептами обучения и находками с сообществом, чтобы мы вместе нашли лучшие способы обучать эти модели.
Дополнительные материалы
Заголовок раздела «Дополнительные материалы»The Annotated Diffusion Model — очень подробный разбор кода и теории DDPM с математикой и кодом всех компонентов. Там же ссылки на статьи для дальнейшего чтения.
Документация Hugging Face о безусловной генерации изображений — примеры обучения диффузионных моделей официальным учебным скриптом, включая код создания своего датасета.
Видео AI Coffee Break о диффузионных моделях: https://www.youtube.com/watch?v=344w5h24-h8
Видео Янника Килчера о DDPM: https://www.youtube.com/watch?v=W-O7AZNzbzQ
Нашли ещё отличные материалы? Сообщите нам, и мы добавим их в список.
Ноутбук: введение в 🤗 Diffusers
Заголовок раздела «Ноутбук: введение в 🤗 Diffusers»(В оригинале — логотип библиотеки diffusers.)
В этом ноутбуке вы обучите свою первую диффузионную модель генерировать изображения милых бабочек 🦋. По пути вы познакомитесь с основными компонентами библиотеки 🤗 Diffusers — это хорошая основа для более продвинутых применений, которые мы разберём дальше в курсе.
Погрузимся!
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»В этом ноутбуке вы:
- увидите в действии мощный нестандартный конвейер (pipeline) диффузионной модели и узнаете, как сделать свою версию;
- создадите свой мини-конвейер:
- вспомнив основные идеи диффузионных моделей;
- загрузив данные для обучения с Hub;
- разобравшись, как планировщик (scheduler) добавляет шум к этим данным;
- создав и обучив модель U-Net;
- собрав всё вместе в работающий конвейер;
- отредактируете и запустите скрипт для более долгого обучения, который берёт на себя:
- обучение на нескольких GPU через 🤗 Accelerate;
- логирование эксперимента, чтобы следить за важными показателями;
- выгрузку итоговой модели на Hugging Face Hub.
❓ Если появятся вопросы, пишите в канал #diffusion-models-class на Discord-сервере Hugging Face. Если ещё не
зарегистрировались, это можно сделать здесь: https://huggingface.co/join/discord
Что нужно заранее
Заголовок раздела «Что нужно заранее»Прежде чем браться за ноутбук:
- 📖 прочитайте материалы юнита 1;
- 🤗 создайте аккаунт на Hugging Face Hub, если его ещё нет: https://huggingface.co/join
Шаг 1: подготовка
Заголовок раздела «Шаг 1: подготовка»Выполните следующую ячейку, чтобы установить библиотеку diffusers и ещё несколько зависимостей:
%pip install -qq -U diffusers datasets transformers accelerate ftfy pyarrow==9.0.0(Примечание переводчика: версия pyarrow==9.0.0 из 2022 года с современным Python и datasets уже не ставится —
уберите её из команды. Знак % — синтаксис ноутбука; в терминале пишите pip install -U diffusers datasets transformers accelerate ftfy.)
Затем откройте https://huggingface.co/settings/tokens и создайте токен доступа с правом записи, если его ещё нет.
(В оригинале — скриншот страницы создания токена.)
Войти с этим токеном можно из командной строки (huggingface-cli login) или выполнив следующую ячейку:
from huggingface_hub import notebook_login
notebook_login()
Вывод:
Login successfulYour token has been saved to /root/.huggingface/token(В новых версиях huggingface_hub команда называется hf auth login.)
Затем нужно установить Git-LFS, чтобы выгружать чекпойнты модели:
%%capture!sudo apt -qq install git-lfs!git config --global credential.helper store(Примечание переводчика: для выгрузки через HfApi, как ниже в ноутбуке, Git-LFS сейчас не нужен — шаг можно
пропустить.)
Наконец, импортируем библиотеки, которые будем использовать, и зададим несколько вспомогательных функций, которые пригодятся дальше в ноутбуке:
import numpy as npimport torchimport torch.nn.functional as Ffrom matplotlib import pyplot as pltfrom PIL import Image

def show_images(x):    """Получает батч изображений x, делает из них сетку и превращает в картинку PIL"""    x = x * 0.5 + 0.5  # переводим из (-1, 1) обратно в (0, 1)    grid = torchvision.utils.make_grid(x)    grid_im = grid.detach().cpu().permute(1, 2, 0).clip(0, 1) * 255    grid_im = Image.fromarray(np.array(grid_im).astype(np.uint8))    return grid_im

def make_grid(images, size=64):    """Получает список картинок PIL и ставит их в одну строку, чтобы удобно смотреть"""    output_im = Image.new("RGB", (size * len(images), size))    for i, im in enumerate(images):        output_im.paste(im.resize((size, size)), (i * size, 0))    return output_im

# На Mac может понадобиться device = 'mps' (не проверялось)device = torch.device("cuda" if torch.cuda.is_available() else "cpu")(torchvision здесь используется, а импортируется ниже, в шаге 2, — к моменту вызова функции он уже будет загружен.)
Всё, мы готовы!
DreamBooth: забегая вперёд
Заголовок раздела «DreamBooth: забегая вперёд»Если вы хоть немного следили за соцсетями об ИИ в последние месяцы, вы слышали о Stable Diffusion. Это мощная латентная диффузионная модель с текстовым условием (не волнуйтесь, мы узнаем, что всё это значит). Но у неё есть недостаток: она не знает, как выглядим мы с вами, если только мы не настолько знамениты, чтобы наши фото заполонили интернет.
DreamBooth позволяет создать свой вариант модели с дополнительным знанием о конкретном лице, предмете или стиле. Команда Corridor Crew сняла отличное видео, где с помощью этой техники рассказывает истории с одними и теми же персонажами, — хороший пример того, на что она способна:
from IPython.display import YouTubeVideo
YouTubeVideo("W4Mcuh38wyM")
Вот пример с моделью, обученной на 5 фотографиях популярной детской игрушки «Мистер Картофельная Голова».
Сначала загрузим конвейер. Он скачает с Hub веса модели и прочее. Поскольку для демонстрации в одну строку скачается несколько гигабайт, эту ячейку можно пропустить и просто полюбоваться результатом!
from diffusers import StableDiffusionPipeline
# Множество моделей от сообщества — на https://huggingface.co/sd-dreambooth-librarymodel_id = "sd-dreambooth-library/mr-potato-head"
# Загружаем конвейерpipe = StableDiffusionPipeline.from_pretrained(model_id, torch_dtype=torch.float16).to(    device)
Когда конвейер загрузится, можно генерировать изображения так:
prompt = "an abstract oil painting of sks mr potato head by picasso"image = pipe(prompt, num_inference_steps=50, guidance_scale=7.5).images[0]image(Промпт: «абстрактная картина маслом: sks мистер картофельная голова кисти Пикассо».)
Упражнение: попробуйте сами с разными промптами. Токен sks здесь — уникальный идентификатор нового понятия: что
будет, если его убрать? Можно также поэкспериментировать с числом шагов сэмплирования (насколько мало можно сделать?)
и с guidance_scale — параметром, который задаёт, насколько сильно модель будет стараться соответствовать промпту.
В этом волшебном конвейере происходит очень много всего! К концу курса вы будете знать, как это всё работает. А пока посмотрим, как обучить диффузионную модель с нуля.
MVP (минимально жизнеспособный конвейер)
Заголовок раздела «MVP (минимально жизнеспособный конвейер)»Основной API 🤗 Diffusers делится на три главных компонента:
- Конвейеры (pipelines): высокоуровневые классы, которые позволяют быстро и удобно генерировать примеры из популярных обученных диффузионных моделей.
- Модели (models): популярные архитектуры для обучения новых диффузионных моделей, например U-Net.
- Планировщики (schedulers): разные способы генерировать изображения из шума при инференсе, а также создавать зашумлённые изображения для обучения.
Конвейеры отлично подходят конечным пользователям, но раз вы здесь, на курсе, мы предполагаем, что вам интересно, что происходит под капотом! Поэтому в оставшейся части ноутбука мы построим свой конвейер, который генерирует маленькие изображения бабочек. Вот итоговый результат в действии:
from diffusers import DDPMPipeline
# Загружаем конвейер бабочекbutterfly_pipeline = DDPMPipeline.from_pretrained(    "johnowhitaker/ddpm-butterflies-32px").to(device)
# Генерируем 8 изображенийimages = butterfly_pipeline(batch_size=8).images
# Смотрим на результатmake_grid(images)
(В оригинале — строка из восьми маленьких разноцветных бабочек 32×32.)
Возможно, не так впечатляет, как пример с DreamBooth, но ведь мы обучаем с нуля примерно на 0,0001% данных, на которых обучали Stable Diffusion. Кстати об обучении: вспомните из введения к юниту, что обучение диффузионной модели выглядит примерно так:
- Загружаем несколько изображений из обучающих данных.
- Добавляем шум в разном количестве.
- Подаём зашумлённые версии входов в модель.
- Оцениваем, насколько хорошо модель очищает эти входы от шума.
- По этой информации обновляем веса модели и повторяем.
Разберём эти шаги по очереди в следующих разделах, пока не получим работающий цикл обучения, а затем посмотрим, как сэмплировать из обученной модели и как упаковать всё в конвейер, чтобы им было легко делиться. Начнём с данных…
Шаг 2: скачиваем обучающий датасет
Заголовок раздела «Шаг 2: скачиваем обучающий датасет»В этом примере возьмём датасет изображений с Hugging Face Hub, а именно эту коллекцию из 1000 фотографий бабочек. Датасет совсем маленький, поэтому мы также добавили закомментированные строки для нескольких датасетов покрупнее. Если хотите взять свою коллекцию изображений, можно загрузить картинки из папки с помощью закомментированного кода.
import torchvisionfrom datasets import load_datasetfrom torchvision import transforms
dataset = load_dataset("huggan/smithsonian_butterflies_subset", split="train")
# Или загружаем изображения из локальной папки# dataset = load_dataset("imagefolder", data_dir="path/to/folder")
# Обучаем на квадратных картинках 32×32 пикселя, но можно попробовать и побольшеimage_size = 32# Уменьшите размер батча, если не хватает памяти GPUbatch_size = 64
# Задаём аугментации данныхpreprocess = transforms.Compose(    [        transforms.Resize((image_size, image_size)),  # меняем размер        transforms.RandomHorizontalFlip(),  # случайно отражаем по горизонтали (аугментация)        transforms.ToTensor(),  # превращаем в тензор со значениями в (0, 1)        transforms.Normalize([0.5], [0.5]),  # переводим в (-1, 1)    ])

def transform(examples):    images = [preprocess(image.convert("RGB")) for image in examples["image"]]    return {"images": images}

dataset.set_transform(transform)
# Создаём загрузчик данных, который выдаёт преобразованные изображения батчамиtrain_dataloader = torch.utils.data.DataLoader(    dataset, batch_size=batch_size, shuffle=True)
(Почему именно (−1, 1): шум, который мы будем добавлять, — стандартное нормальное распределение со средним 0, и
удобно, чтобы картинки тоже были отцентрованы вокруг нуля. Normalize([0.5], [0.5]) делает :
0 превращается в −1, а 1 — в 1.)
Можно взять батч изображений и посмотреть на некоторые из них так:
xb = next(iter(train_dataloader))["images"].to(device)[:8]print("X shape:", xb.shape)show_images(xb).resize((8 * 64, 64), resample=Image.NEAREST)Вывод:
X shape: torch.Size([8, 3, 32, 32])(Восемь картинок, 3 цветовых канала, 32×32 пикселя. В оригинале под выводом — строка из восьми бабочек и
предупреждение Pillow о том, что Image.NEAREST устарело; в новых версиях пишите Image.Resampling.NEAREST.)
Мы держимся маленького датасета с картинками 32 пикселя, чтобы обучение в этом ноутбуке не занимало слишком много времени.
Шаг 3: задаём планировщик
Заголовок раздела «Шаг 3: задаём планировщик»Наш план обучения: взять эти входные изображения, добавить к ним шум и подать зашумлённые изображения в модель. А при
инференсе мы будем по предсказаниям модели постепенно убирать шум. В diffusers оба этих процесса берёт на себя
планировщик (scheduler).
Расписание шума определяет, сколько шума добавляется на разных временных шагах (timesteps). Вот как можно создать планировщик с настройками по умолчанию для обучения и сэмплирования DDPM (по статье «Denoising Diffusion Probabilistic Models»):
from diffusers import DDPMScheduler
noise_scheduler = DDPMScheduler(num_train_timesteps=1000)
Статья DDPM описывает процесс порчи данных, который на каждом «временном шаге» добавляет немного шума. Имея для какого-то шага, следующую (чуть более зашумлённую) версию получаем так:
То есть берём , умножаем на и добавляем шум, масштабированный . Это задано для каждого по некоторому расписанию и определяет, сколько шума добавляется на шаге. Нам не обязательно проделывать эту операцию 500 раз, чтобы получить : есть другая формула, которая даёт для любого сразу из :
Математические обозначения всегда выглядят пугающе! К счастью, планировщик всё это делает за нас. Можно построить
графики (подписан как sqrt_alpha_prod) и (подписан как
sqrt_one_minus_alpha_prod), чтобы увидеть, как вход () и шум масштабируются и смешиваются на разных шагах:
plt.plot(noise_scheduler.alphas_cumprod.cpu() ** 0.5, label=r"${\sqrt{\bar{\alpha}_t}}$")plt.plot((1 - noise_scheduler.alphas_cumprod.cpu()) ** 0.5, label=r"$\sqrt{(1 - \bar{\alpha}_t)}$")plt.legend(fontsize="x-large");(В оригинале — график: доля сигнала плавно падает от 1 почти до 0 за 1000 шагов, а доля шума растёт от 0 почти до 1.)
Упражнение: посмотрите, как меняется график при других значениях beta_start, beta_end и beta_schedule,
подставив один из закомментированных вариантов:
# Вариант, где добавляется слишком мало шума:# noise_scheduler = DDPMScheduler(num_train_timesteps=1000, beta_start=0.001, beta_end=0.004)# «Косинусное» расписание, которое может быть лучше для маленьких изображений:# noise_scheduler = DDPMScheduler(num_train_timesteps=1000, beta_schedule='squaredcos_cap_v2')Какой бы планировщик вы ни выбрали, теперь им можно добавлять шум в разном количестве функцией
noise_scheduler.add_noise:
timesteps = torch.linspace(0, 999, 8).long().to(device)noise = torch.randn_like(xb)noisy_xb = noise_scheduler.add_noise(xb, noise, timesteps)print("Noisy X shape", noisy_xb.shape)show_images(noisy_xb).resize((8 * 64, 64), resample=Image.NEAREST)Вывод:
Noisy X shape torch.Size([8, 3, 32, 32])(В оригинале — те же восемь бабочек при шагах от 0 до 999: слева чёткие, справа неотличимые от шума.)
И здесь тоже исследуйте, как влияют разные расписания шума и параметры. Это видео отлично объясняет часть математики выше подробнее и хорошо вводит в эти понятия.
Шаг 4: задаём модель
Заголовок раздела «Шаг 4: задаём модель»Переходим к главному компоненту — самой модели.
Большинство диффузионных моделей используют архитектуры, которые являются каким-то вариантом U-Net, — её мы здесь и возьмём.
(В оригинале — схема U-Net: слева «спуск» — блоки, уменьшающие изображение (зелёные), внизу самое маленькое разрешение, справа «подъём» — блоки, увеличивающие его обратно (красные), и стрелки обходных связей между соответствующими уровнями. Ссылка на рисунок.)
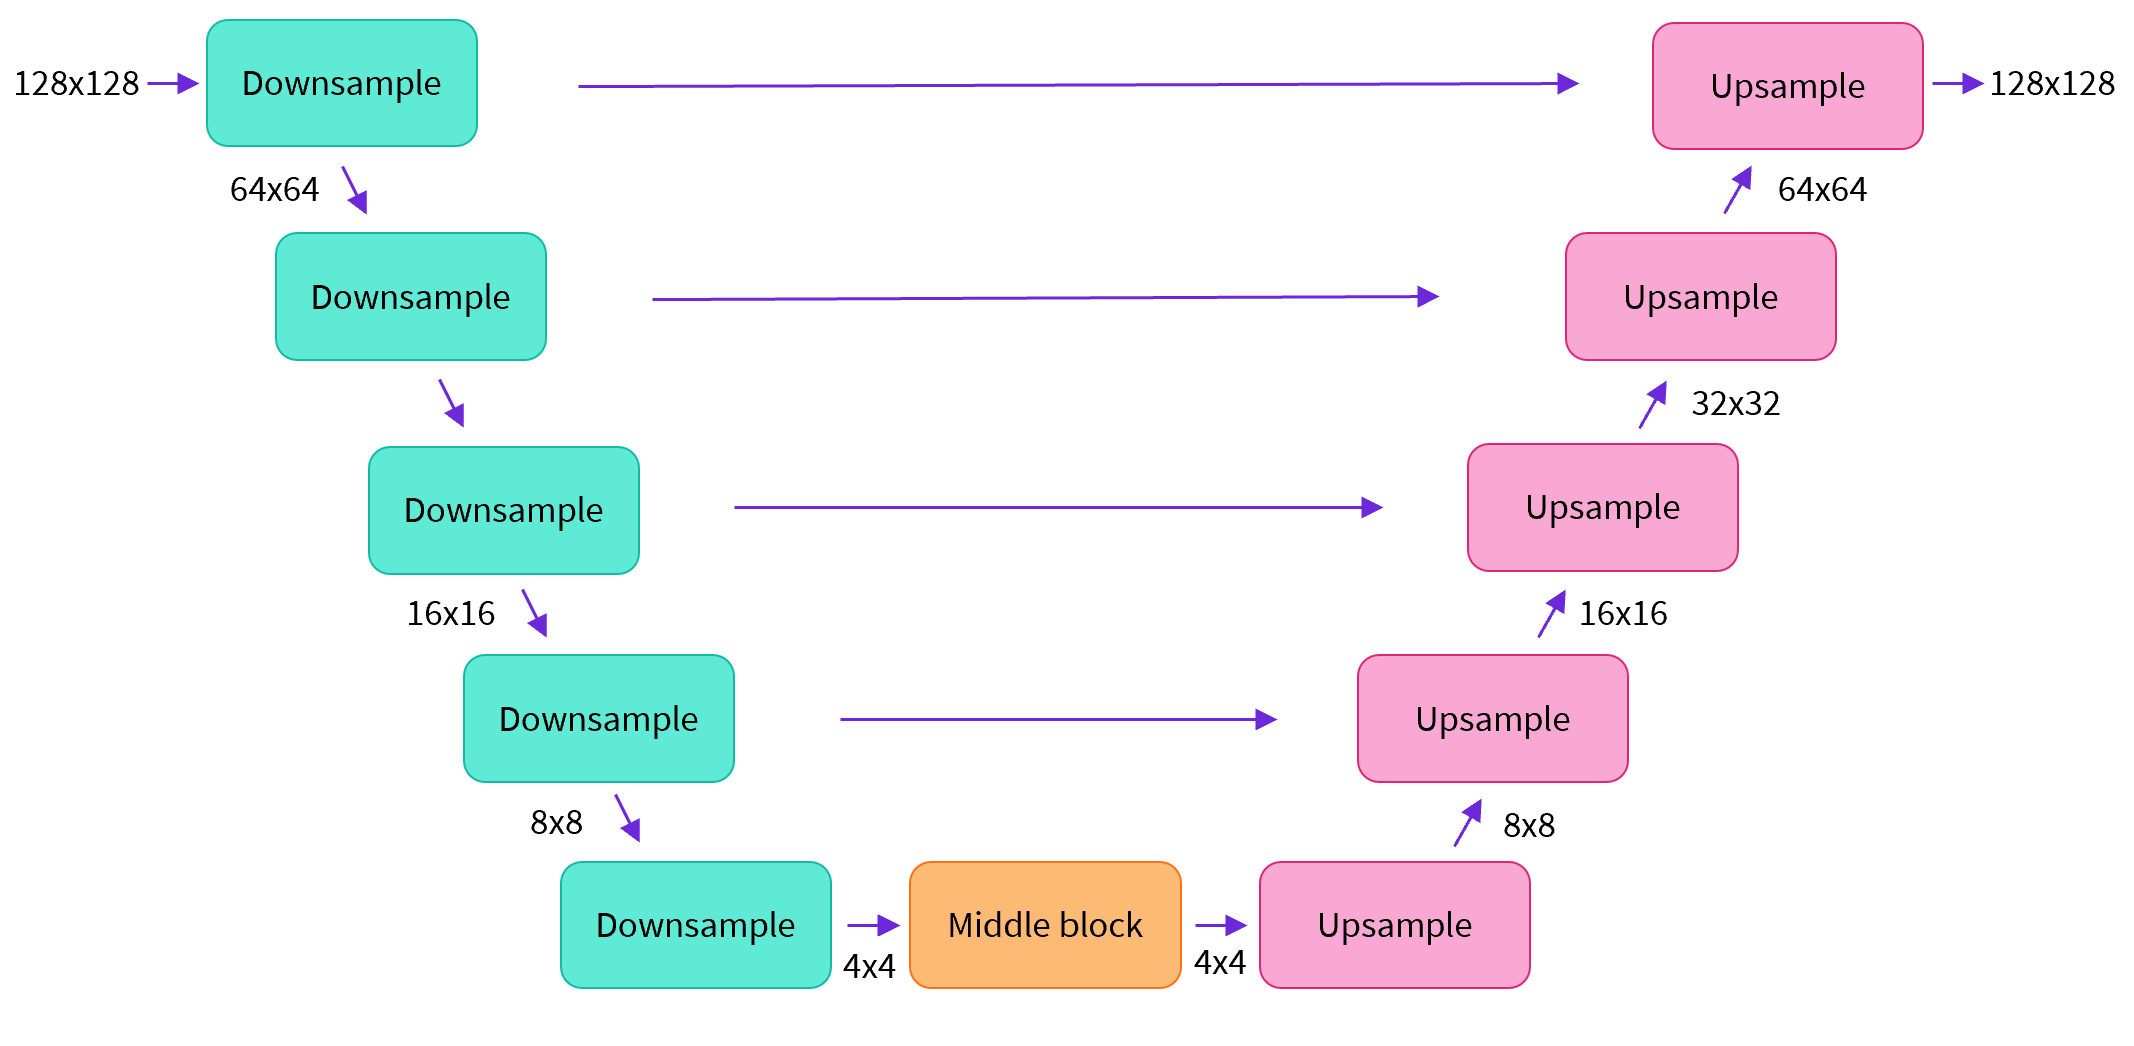
flowchart LR
IN["Вход 32×32"] --> D1["Down 32→16"] --> D2["Down 16→8"] --> D3["Down 8→4<br/>+ внимание"] --> M["Середина 4×4"]
M --> U3["Up 4→8<br/>+ внимание"] --> U2["Up 8→16"] --> U1["Up 16→32"] --> OUT["Выход 32×32"]
D1 -. "обходная связь" .-> U1
D2 -. "обходная связь" .-> U2
D3 -. "обходная связь" .-> U3
Коротко:
- входное изображение проходит через несколько блоков слоёв ResNet, каждый из которых уменьшает размер изображения вдвое;
- затем через столько же блоков, которые снова его увеличивают;
- обходные связи (skip connections) соединяют признаки на пути вниз с соответствующими слоями на пути вверх.
Ключевая особенность этой модели — она предсказывает изображения того же размера, что и вход, а это ровно то, что нам нужно.
В Diffusers есть удобный класс UNet2DModel, который создаёт нужную архитектуру на PyTorch.
Создадим U-Net для нашего размера изображений. Обратите внимание: down_block_types соответствуют блокам уменьшения
(зелёные на схеме выше), а up_block_types — блокам увеличения (красные на схеме):
from diffusers import UNet2DModel
# Создаём модельmodel = UNet2DModel(    sample_size=image_size,  # целевое разрешение изображения    in_channels=3,  # число входных каналов, 3 для цветных (RGB) изображений    out_channels=3,  # число выходных каналов    layers_per_block=2,  # сколько слоёв ResNet в каждом блоке U-Net    block_out_channels=(64, 128, 128, 256),  # больше каналов -> больше параметров    down_block_types=(        "DownBlock2D",  # обычный блок уменьшения на ResNet        "DownBlock2D",        "AttnDownBlock2D",  # блок уменьшения на ResNet с пространственным self-attention        "AttnDownBlock2D",    ),    up_block_types=(        "AttnUpBlock2D",        "AttnUpBlock2D",  # блок увеличения на ResNet с пространственным self-attention        "UpBlock2D",        "UpBlock2D",  # обычный блок увеличения на ResNet    ),)model.to(device);
При входах большего разрешения стоит взять больше блоков уменьшения и увеличения, а слои внимания оставить только на самых низких разрешениях (внизу), чтобы сэкономить память. Позже поговорим о том, как подбирать лучшие настройки под свою задачу.
(Почему внимание только внизу: self-attention сравнивает каждую позицию с каждой, и затраты растут как квадрат числа позиций. Карта 32×32 — это 1024 позиции и около миллиона пар, карта 4×4 — 16 позиций и 256 пар. Само внимание — в уроке 4.4.)
Проверим, что батч данных и случайные шаги дают выход той же формы, что и вход:
with torch.no_grad(): model_prediction = model(noisy_xb, timesteps).samplemodel_prediction.shapeВывод:
torch.Size([8, 3, 32, 32])В следующем разделе посмотрим, как обучить эту модель.
Шаг 5: цикл обучения
Заголовок раздела «Шаг 5: цикл обучения»Пора обучать! Ниже — типичный цикл оптимизации на PyTorch: проходим по данным батч за батчем и на каждом шаге обновляем параметры модели оптимизатором — в нашем случае AdamW со скоростью обучения 0,0004.
Для каждого батча данных мы:
- выбираем случайные временные шаги;
- зашумляем данные соответственно;
- пропускаем зашумлённые данные через модель;
- сравниваем предсказания модели с целью (здесь — с шумом) с помощью среднеквадратичной ошибки как функции потерь;
- обновляем параметры модели через
loss.backward()иoptimizer.step().
По ходу мы ещё записываем значения loss, чтобы потом построить график.
NB: этот код работает почти 10 минут — можете пропустить эти две ячейки и взять предобученную модель, если торопитесь. Или посмотрите, как ускоряет обучение уменьшение числа каналов в каждом слое в определении модели выше.
Официальный учебный пример diffusers обучает на этом датасете модель побольше и в большем разрешении — это хороший образец менее минималистичного цикла обучения:
# Задаём планировщик шумаnoise_scheduler = DDPMScheduler(    num_train_timesteps=1000, beta_schedule="squaredcos_cap_v2")
# Цикл обученияoptimizer = torch.optim.AdamW(model.parameters(), lr=4e-4)
losses = []
for epoch in range(30):    for step, batch in enumerate(train_dataloader):        clean_images = batch["images"].to(device)        # Выбираем шум, который добавим к изображениям        noise = torch.randn(clean_images.shape).to(clean_images.device)        bs = clean_images.shape[0]
        # Выбираем случайный временной шаг для каждого изображения        timesteps = torch.randint(            0, noise_scheduler.num_train_timesteps, (bs,), device=clean_images.device        ).long()
        # Добавляем к чистым изображениям шум с силой, соответствующей шагу        noisy_images = noise_scheduler.add_noise(clean_images, noise, timesteps)
        # Получаем предсказание модели        noise_pred = model(noisy_images, timesteps, return_dict=False)[0]
        # Считаем loss        loss = F.mse_loss(noise_pred, noise)        loss.backward(loss)        losses.append(loss.item())
        # Обновляем параметры модели оптимизатором        optimizer.step()        optimizer.zero_grad()
    if (epoch + 1) % 5 == 0:        loss_last_epoch = sum(losses[-len(train_dataloader) :]) / len(train_dataloader)        print(f"Epoch:{epoch+1}, loss: {loss_last_epoch}")
Вывод:
Epoch:5, loss: 0.16273280512541533Epoch:10, loss: 0.11161588924005628Epoch:15, loss: 0.10206522420048714Epoch:20, loss: 0.08302505919709802Epoch:25, loss: 0.07805309211835265Epoch:30, loss: 0.07474562455900013Построив график loss, видим, что модель сначала быстро улучшается, а потом продолжает улучшаться медленнее (это лучше видно в логарифмическом масштабе справа):
fig, axs = plt.subplots(1, 2, figsize=(12, 4))axs[0].plot(losses)axs[1].plot(np.log(losses))plt.show()(В оригинале — два графика: loss по шагам в обычном и логарифмическом масштабе; кривая резко падает в первые сотни шагов и дальше медленно снижается с сильным разбросом — из-за случайных шагов в каждом батче.)
Вместо того чтобы запускать код обучения выше, можно взять модель из конвейера:
# Раскомментируйте, чтобы загрузить модель, которую я обучил раньше:# model = butterfly_pipeline.unetШаг 6: генерируем изображения
Заголовок раздела «Шаг 6: генерируем изображения»Как получить изображения этой моделью?
Вариант 1: создать конвейер
Заголовок раздела «Вариант 1: создать конвейер»from diffusers import DDPMPipeline
image_pipe = DDPMPipeline(unet=model, scheduler=noise_scheduler)pipeline_output = image_pipe()pipeline_output.images[0]Сохранить конвейер в локальную папку можно так:
image_pipe.save_pretrained("my_pipeline")Смотрим содержимое папки:
!ls my_pipeline/Вывод:
model_index.json scheduler unetПодпапки scheduler и unet содержат всё нужное, чтобы воссоздать эти компоненты. Например, в папке unet лежат
веса модели (diffusion_pytorch_model.bin) и файл конфигурации с описанием архитектуры U-Net.
!ls my_pipeline/unet/Вывод:
config.json diffusion_pytorch_model.bin(В новых версиях diffusers веса сохраняются в безопасном формате diffusion_pytorch_model.safetensors.)
Вместе эти файлы содержат всё нужное, чтобы воссоздать конвейер. Их можно вручную выгрузить на Hub, чтобы поделиться конвейером с другими, или посмотреть код, который делает это через API, в следующем разделе.
Вариант 2: написать цикл сэмплирования
Заголовок раздела «Вариант 2: написать цикл сэмплирования»Если заглянуть в метод forward конвейера, видно, что происходит при вызове image_pipe():
# ??image_pipe.forwardМы начинаем со случайного шума и проходим по шагам планировщика от самого зашумлённого к наименее зашумлённому, на каждом шаге убирая немного шума по предсказанию модели:
# Случайная стартовая точка (8 случайных изображений):sample = torch.randn(8, 3, 32, 32).to(device)
for i, t in enumerate(noise_scheduler.timesteps):
    # Получаем предсказание модели    with torch.no_grad():        residual = model(sample, t).sample
    # Обновляем sample шагом планировщика    sample = noise_scheduler.step(residual, t, sample).prev_sample
show_images(sample)
Функция noise_scheduler.step() делает математику, нужную, чтобы правильно обновить sample. Методов сэмплирования
много — в следующем юните мы увидим, как подставить другой сэмплер, чтобы ускорить генерацию изображений уже обученными
моделями, и подробнее поговорим о теории сэмплирования из диффузионных моделей.
(Примечание переводчика: в новых версиях у конвейеров нет метода forward — смотрите ??image_pipe.__call__. Цикл
делает 1000 шагов — столько же, сколько шагов шума при обучении; на RTX 4080 для батча из восьми картинок 32×32
это секунды или десятки секунд.)
Шаг 7: выгружаем модель на Hub
Заголовок раздела «Шаг 7: выгружаем модель на Hub»В примере выше мы сохранили конвейер в локальную папку. Чтобы выгрузить модель на Hub, нужен репозиторий модели,
куда отправить файлы. Имя репозитория определим по идентификатору модели, который хотим ей дать (можете заменить
model_name на своё; оно лишь должно содержать ваш логин — это и делает функция get_full_repo_name()):
from huggingface_hub import get_full_repo_name
model_name = "sd-class-butterflies-32"hub_model_id = get_full_repo_name(model_name)hub_model_id
Вывод:
'lewtun/sd-class-butterflies-32'(Если в вашей версии huggingface_hub функции get_full_repo_name нет, задайте имя сами:
hub_model_id = "ваш-логин/sd-class-butterflies-32".)
Затем создадим репозиторий модели на 🤗 Hub и отправим туда модель:
from huggingface_hub import HfApi, create_repo
create_repo(hub_model_id)api = HfApi()api.upload_folder(    folder_path="my_pipeline/scheduler", path_in_repo="", repo_id=hub_model_id)api.upload_folder(folder_path="my_pipeline/unet", path_in_repo="", repo_id=hub_model_id)api.upload_file(    path_or_fileobj="my_pipeline/model_index.json",    path_in_repo="model_index.json",    repo_id=hub_model_id,)
(Примечание переводчика: этот код кладёт содержимое папок scheduler и unet в корень репозитория, и файлы
config.json из двух папок перезаписывают друг друга. Надёжнее выгрузить всю папку одной командой:
api.upload_folder(folder_path="my_pipeline", repo_id=hub_model_id) — или вызвать image_pipe.push_to_hub(hub_model_id).)
Остаётся создать хорошую карточку модели, чтобы наш генератор бабочек было легко найти на Hub (можете дополнить и отредактировать описание!):
from huggingface_hub import ModelCard
content = f"""---license: mittags:- pytorch- diffusers- unconditional-image-generation- diffusion-models-class---
# Model Card for Unit 1 of the [Diffusion Models Class 🧨](https://github.com/huggingface/diffusion-models-class)
This model is a diffusion model for unconditional image generation of cute 🦋.
## Usage
```pythonfrom diffusers import DDPMPipeline
pipeline = DDPMPipeline.from_pretrained('{hub_model_id}')image = pipeline().images[0]image```"""
card = ModelCard(content)card.push_to_hub(hub_model_id)
(Текст карточки: «Карточка модели для юнита 1 курса о диффузионных моделях. Это диффузионная модель для безусловной
генерации изображений милых 🦋» — и раздел «Использование» с кодом. Блок между --- в начале — метаданные: лицензия
и теги, по которым модель находят на Hub.)
Теперь, когда модель на Hub, её можно скачать откуда угодно методом from_pretrained() класса DDPMPipeline:
from diffusers import DDPMPipeline
image_pipe = DDPMPipeline.from_pretrained(hub_model_id)pipeline_output = image_pipe()pipeline_output.images[0]
Отлично, работает!
Масштабируемся с 🤗 Accelerate
Заголовок раздела «Масштабируемся с 🤗 Accelerate»Этот ноутбук сделан для учёбы, поэтому я старался, чтобы код был как можно минималистичнее и чище. Из-за этого мы опустили кое-что, что понадобится, если обучать модель побольше на гораздо большем объёме данных: поддержку нескольких GPU, логирование хода обучения и примеров изображений, перерасчёт активаций для больших батчей, автоматическую выгрузку моделей и так далее. К счастью, большинство этих возможностей есть в учебном скрипте здесь.
Скачать файл можно так:
!wget https://github.com/huggingface/diffusers/raw/main/examples/unconditional_image_generation/train_unconditional.pyОткройте файл: вы увидите, где задаётся модель и какие настройки доступны. Я запустил скрипт такой командой:
# Дадим новой модели имя для Hubmodel_name = "sd-class-butterflies-64"hub_model_id = get_full_repo_name(model_name)hub_model_idВывод:
'lewtun/sd-class-butterflies-64'!accelerate launch train_unconditional.py \ --dataset_name="huggan/smithsonian_butterflies_subset" \ --resolution=64 \ --output_dir={model_name} \ --train_batch_size=32 \ --num_epochs=50 \ --gradient_accumulation_steps=1 \ --learning_rate=1e-4 \ --lr_warmup_steps=500 \ --mixed_precision="no"(Примечание переводчика: на вашей машине скрипт сам распределит обучение на 4 GPU, если один раз выполнить
accelerate config и указать 4 процесса, или запустить accelerate launch --num_processes 4 train_unconditional.py ….
--mixed_precision="bf16" ускорит обучение на RTX 4080. Скрипт берёт зависимости из папки примеров diffusers —
если чего-то не хватает, поставьте pip install -r по файлу requirements.txt из той же папки репозитория.)
Как и раньше, выгрузим модель на Hub и создадим хорошую карточку (и редактируйте её как хотите!):
create_repo(hub_model_id)api = HfApi()api.upload_folder(    folder_path=f"{model_name}/scheduler", path_in_repo="", repo_id=hub_model_id)api.upload_folder(    folder_path=f"{model_name}/unet", path_in_repo="", repo_id=hub_model_id)api.upload_file(    path_or_fileobj=f"{model_name}/model_index.json",    path_in_repo="model_index.json",    repo_id=hub_model_id,)
content = f"""---license: mittags:- pytorch- diffusers- unconditional-image-generation- diffusion-models-class---
# Model Card for Unit 1 of the [Diffusion Models Class 🧨](https://github.com/huggingface/diffusion-models-class)
This model is a diffusion model for unconditional image generation of cute 🦋.
## Usage
```pythonfrom diffusers import DDPMPipeline
pipeline = DDPMPipeline.from_pretrained('{hub_model_id}')image = pipeline().images[0]image```"""
card = ModelCard(content)card.push_to_hub(hub_model_id)
Примерно через 45 минут результат такой:
pipeline = DDPMPipeline.from_pretrained(hub_model_id).to(device)images = pipeline(batch_size=8).imagesmake_grid(images)(В оригинале — восемь бабочек 64×64, заметно более чётких и разнообразных, чем у модели 32×32.)
Упражнение: попробуйте найти настройки обучения и модели, которые дают хороший результат как можно быстрее, и поделитесь находками с сообществом. Покопайтесь в скрипте, попробуйте понять код и спрашивайте обо всём, что кажется непонятным.
Куда двигаться дальше
Заголовок раздела «Куда двигаться дальше»Надеемся, это дало вам почувствовать, что можно делать с библиотекой 🤗 Diffusers! Возможные следующие шаги:
- Обучите безусловную диффузионную модель на новом датасете — бонусные очки, если создадите его сами. Хорошие датасеты изображений для этой задачи есть в организации HugGan на Hub. Только уменьшите разрешение картинок, если не хотите очень долго ждать обучения!
- Попробуйте DreamBooth, чтобы создать свой вариант конвейера Stable Diffusion, — через этот Space или этот ноутбук.
- Измените учебный скрипт, чтобы исследовать разные гиперпараметры U-Net (число слоёв, каналов и т. д.), разные расписания шума и прочее.
- Посмотрите ноутбук Diffusion Models from Scratch — другой взгляд на основные идеи этого юнита.
Удачи, и ждите юнит 2!
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| generative model | генеративная модель |
| diffusion model | диффузионная модель |
| noise, denoise | шум, очистить от шума |
| forward (corruption) process / reverse process | прямой процесс (порча шумом) / обратный процесс |
| timestep | временной шаг |
| noise schedule, scheduler | расписание шума, планировщик |
| sampling, sampler | сэмплирование, сэмплер |
| pipeline | конвейер |
| U-Net, skip connection | U-Net, обходная связь |
| unconditional generation | безусловная генерация |
| data augmentation | аугментация данных |
| model card | карточка модели |