Happy-LLM, глава 7: приложения LLM — оценка, RAG, агенты
Полный перевод седьмой главы книги Datawhale «Строим большую модель с нуля»: бенчмарки и рейтинги LLM, Tiny-RAG с нуля (нарезка документов, эмбеддинги, векторное хранилище, промпт) и Tiny-Agent на function calling OpenAI-совместимого API.
В предыдущих главах мы систематически разобрали базовые знания о больших моделях, методы их обучения и дообучения. Эта глава посвящена ключевым технологиям и фреймворкам применения больших моделей на практике: оценке больших моделей, RAG (Retrieval-Augmented Generation, генерации с дополнением найденным) и Agent (агентам). Она поможет читателю глубже понять реальные сценарии применения больших моделей и способы их реализации.
7.1 Оценка LLM
Заголовок раздела «7.1 Оценка LLM»В последние годы, с бурным развитием искусственного интеллекта, большие предобученные языковые модели (кратко — большие модели) стали главной движущей силой технического прогресса. В обработке естественного языка и других задачах они показали поразительные способности. Но чтобы точно измерить качество большой модели, нужна научная и разумная оценка.
Что такое оценка большой модели? Это количественное измерение и сравнение того, как модель справляется с разными задачами, с помощью стандартизированных методов и датасетов. Оценка охватывает не только точность модели в конкретных задачах, но и её способность к обобщению, скорость вывода, потребление ресурсов и другие стороны. Оценка позволяет полнее понять реальное поведение модели и её потенциал для применения в реальном мире.
Разработка большой модели стоит дорого — это огромные вычислительные ресурсы и данные, — поэтому оценка критически важна, чтобы убедиться в реальной ценности модели. Во-первых, оценка показывает, как модель справляется с разными задачами, и помогает исследователям и компаниям судить о её применимости и надёжности. Во-вторых, оценка может вскрыть скрытые слабости модели — например, предвзятость или проблемы устойчивости — и дать основу для дальнейших улучшений. Кроме того, честная и открытая оценка даёт науке и индустрии общий стандарт и способствует обмену технологиями и прогрессу.
7.1.1 Датасеты для оценки LLM
Заголовок раздела «7.1.1 Датасеты для оценки LLM»При оценке больших моделей очень важно использовать стандартизированные наборы для оценки. Сейчас основные наборы оценивают модель по следующим направлениям; у каждого своё назначение и типичные сценарии применения:
-
Общие наборы:
- MMLU (Massive Multitask Language Understanding): MMLU оценивает понимание модели во множестве задач из разных дисциплин и областей знаний. В нём есть задания по истории, математике, физике, биологии, праву и т. д.; он всесторонне проверяет запас знаний модели и понимание языка в разных дисциплинах.
-
Наборы на использование инструментов:
- BFCL V2: оценивает модель в сложных задачах с использованием инструментов, особенно правильность и эффективность при многошаговых операциях. Такие задачи обычно включают взаимодействие с базой данных или выполнение конкретных команд и моделируют реальное использование инструментов.
-
Математические наборы:
- GSM8K: датасет задач по математике уровня начальной школы; проверяет математические рассуждения и логический анализ модели. Задания — арифметика, решение простых уравнений, рассуждения с числами и т. п. Задачи GSM8K кажутся простыми, но модель должна понять смысл условия и правильно посчитать — это двойной вызов: логическое рассуждение и понимание языка.
- MATH: проверяет модель на более сложных математических задачах, включая алгебру и геометрию.
-
Наборы на рассуждение:
- ARC Challenge: оценивает научные рассуждения модели, особенно ответы на вопросы здравого смысла и научные вопросы; типичные применения — решение экзаменационных задач по естественным наукам и разработка энциклопедических вопросно-ответных систем.
- GPQA: оценивает способность отвечать на открытые вопросы в условиях zero-shot (без примеров); обычно применяется в чат-ботах поддержки и вопросно-ответных системах — помогает модели давать разумные ответы, когда у неё нет данных по конкретной области.
- HellaSwag: оценивает способность выбрать самое логичное продолжение в сложном контексте; подходит для сценариев, где нужны глубокое понимание и рассуждение: продолжение историй, генерация диалогов.
-
Наборы на понимание длинных текстов:
- InfiniteBench/En.MC: оценивает понимание прочитанного в длинных текстах, особенно научной литературы; подходит для автоматического реферирования научных статей, анализа длинных отчётов.
- NIH/Multi-needle: проверяет понимание и обобщение в длинных документах с множеством фрагментов; применяется при разборе правительственных отчётов, анализе длинных внутренних документов компаний и в других сценариях с огромным объёмом информации.
-
Многоязычные наборы:
- MGSM: оценивает решение математических задач на разных языках, то есть многоязычную приспособляемость модели; особенно подходит для математического образования в международной среде и межъязыковой технической поддержки.
Разнообразие этих наборов помогает всесторонне оценить большую модель в разных задачах и сценариях и убедиться, что она эффективна и точна в самых разных задачах. Например, в MMLU некоторые большие модели отлично справляются с историей, физикой и другими дисциплинами, показывая глубокое понимание многих областей знаний; в математической оценке GSM8K новейшие модели в арифметике и решении уравнений приблизились к некоторым человеческим ориентирам или даже превзошли их, показывая потенциал в сложных математических рассуждениях. Такие реальные результаты демонстрируют прогресс моделей в сложных задачах и их потенциал для применения.
Примечание переводчика. Несколько описаний в оригинале неточны. GPQA — это не «открытые вопросы для чат-ботов поддержки», а 448 очень трудных вопросов с вариантами ответа по биологии, физике и химии, составленных специалистами так, чтобы ответ нельзя было быстро найти поиском (Google-proof). NIH — это «иголка в стоге сена» (needle in a haystack): в длинный текст прячут факт и проверяют, найдёт ли его модель; Multi-needle — то же с несколькими фактами. BFCL (Berkeley Function Calling Leaderboard) с тех пор вырос до версий V3 и V4 с многоходовыми и агентными задачами. Ловушки бенчмарков — загрязнение данных, насыщение, подгонка под тест — разобраны в уроке 7.3.1.
7.1.2 Основные рейтинги
Заголовок раздела «7.1.2 Основные рейтинги»Оценка больших моделей не ограничивается конкретными датасетами: многие организации публикуют по результатам оценок рейтинги моделей (лидерборды, лидербордлидерборд (рейтинговая таблица)EN leaderboardТаблица моделей, отсортированных по результату на бенчмарке или по голосам людей. Полезна для обзора, опасна как единственная цель (закон Гудхарта).). Эти рейтинги — важный ориентир для науки и индустрии: они помогают понять, какие технологии и модели сейчас на переднем крае. Вот основные рейтинги.
Open LLM Leaderboard
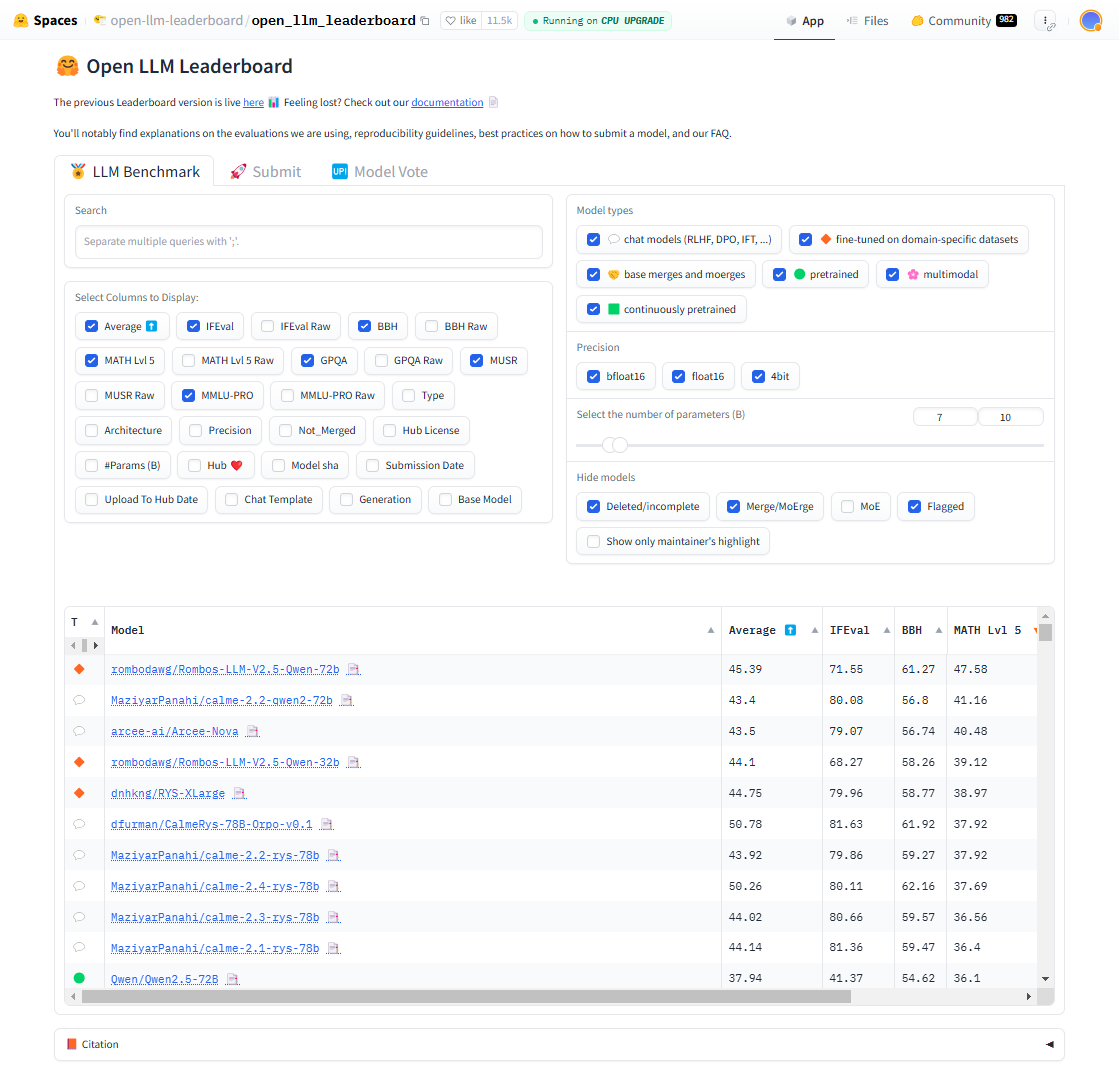
Заголовок раздела «Open LLM Leaderboard»Open LLM Leaderboard — открытый рейтинг от Hugging Face. Он собирает результаты оценки многих открытых больших моделей и помогает понять, как разные модели справляются с разными задачами. Рейтинг оценивает модели несколькими стандартизированными тестами и постоянно обновляется, отражая новейший технический прогресс, — это ценная точка сравнения для исследователей и разработчиков (рисунок 7.1).
Рисунок 7.1. Open LLM Leaderboard — таблица открытых моделей со средним баллом и баллами по отдельным тестам (изображение в оригинале).
Lmsys Chatbot Arena Leaderboard
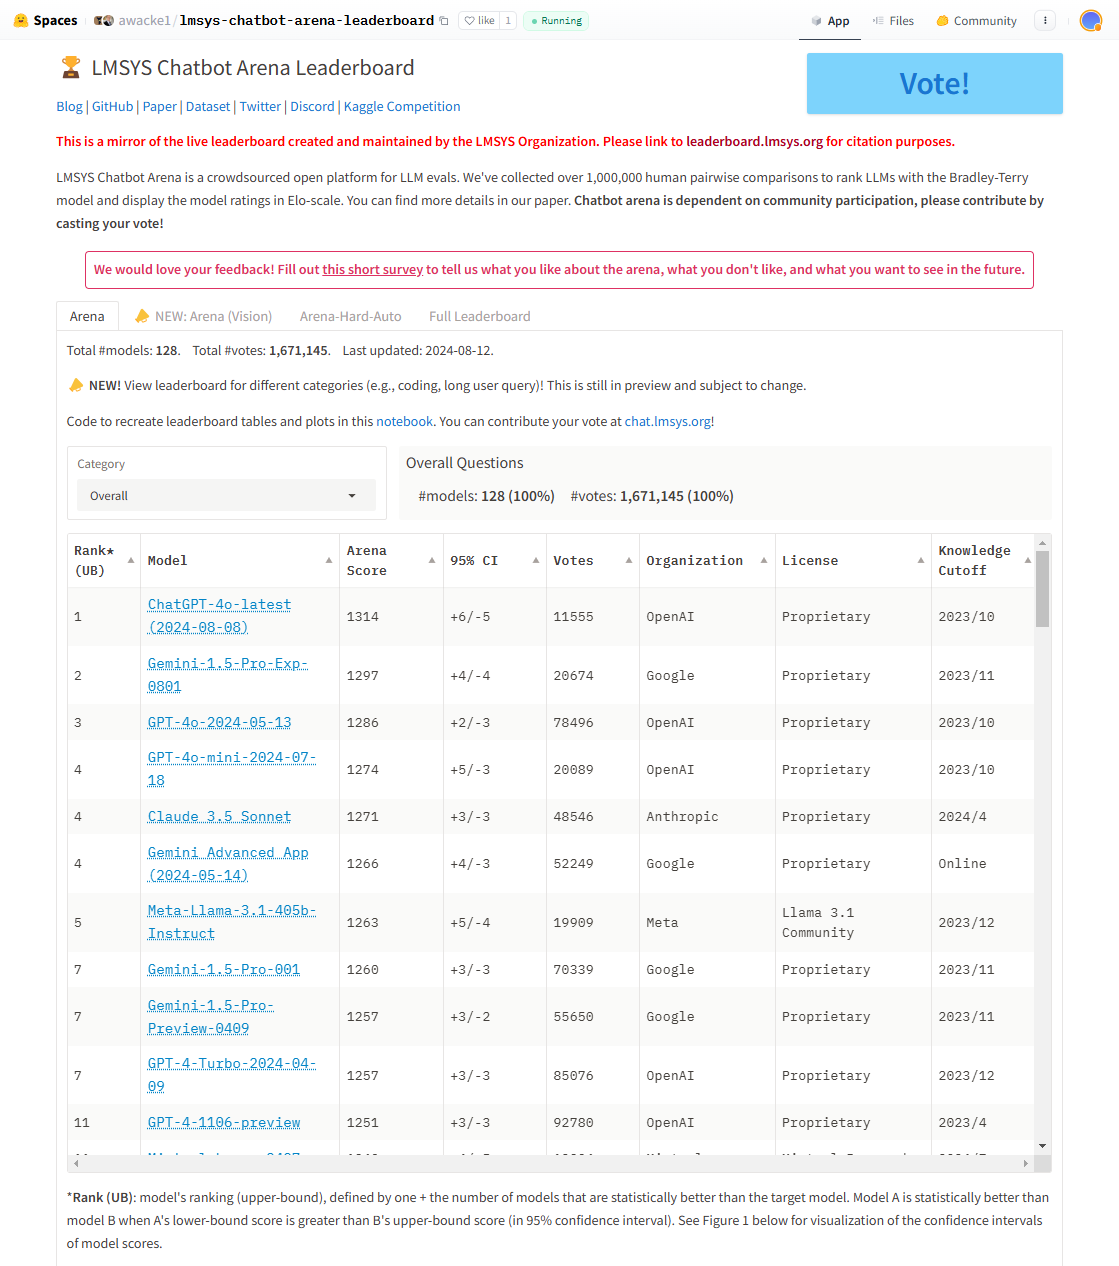
Заголовок раздела «Lmsys Chatbot Arena Leaderboard»Рейтинг чат-ботов от lmsys: многомерная оценка показывает, как разные большие модели справляются с диалогом. Рейтинг оценивает качество диалога через взаимодействие реальных пользователей с моделями и прежде всего проверяет способность модели к генерации естественного языка, понимание контекста и удовлетворённость пользователей. Сейчас это важный инструмент оценки чат-ботов (рисунок 7.2).
Рисунок 7.2. Lmsys Chatbot Arena Leaderboard — рейтинг моделей по голосам пользователей (изображение в оригинале).
OpenCompass
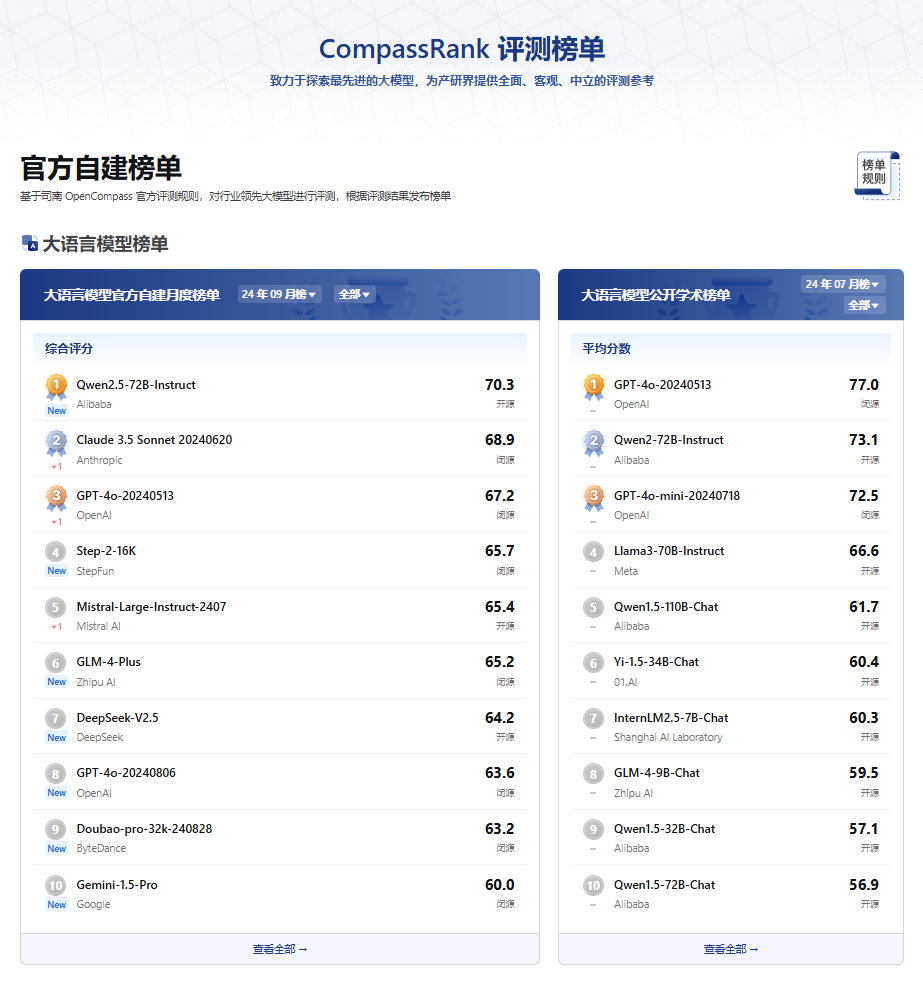
Заголовок раздела «OpenCompass»OpenCompass — китайский рейтинг, который оценивает большие модели на разных языках и задачах и служит ориентиром для применений, специфичных для китайского рынка. Он сочетает тесты понимания китайского языка и многоязычных способностей, чтобы учесть местные потребности, и особенно внимательно смотрит на точность, устойчивость и приспособляемость моделей в китайском контексте — важный ориентир для китайских компаний и исследователей при выборе модели.
Рисунок 7.3. OpenCompass — страница рейтинга (изображение в оригинале).
Примечание переводчика. Положение дел изменилось: в 2025 году Hugging Face закрыла Open LLM Leaderboard (он остался в архиве); Chatbot Arena выделилась из LMSYS в отдельный проект LMArena, а с января 2026 года называется Arena (arena.ai). Как устроен рейтинг по голосам и чем он слаб — в уроке 7.3.1. Для русского языка аналогичную роль играет бенчмарк MERA.
7.1.3 Специализированные рейтинги
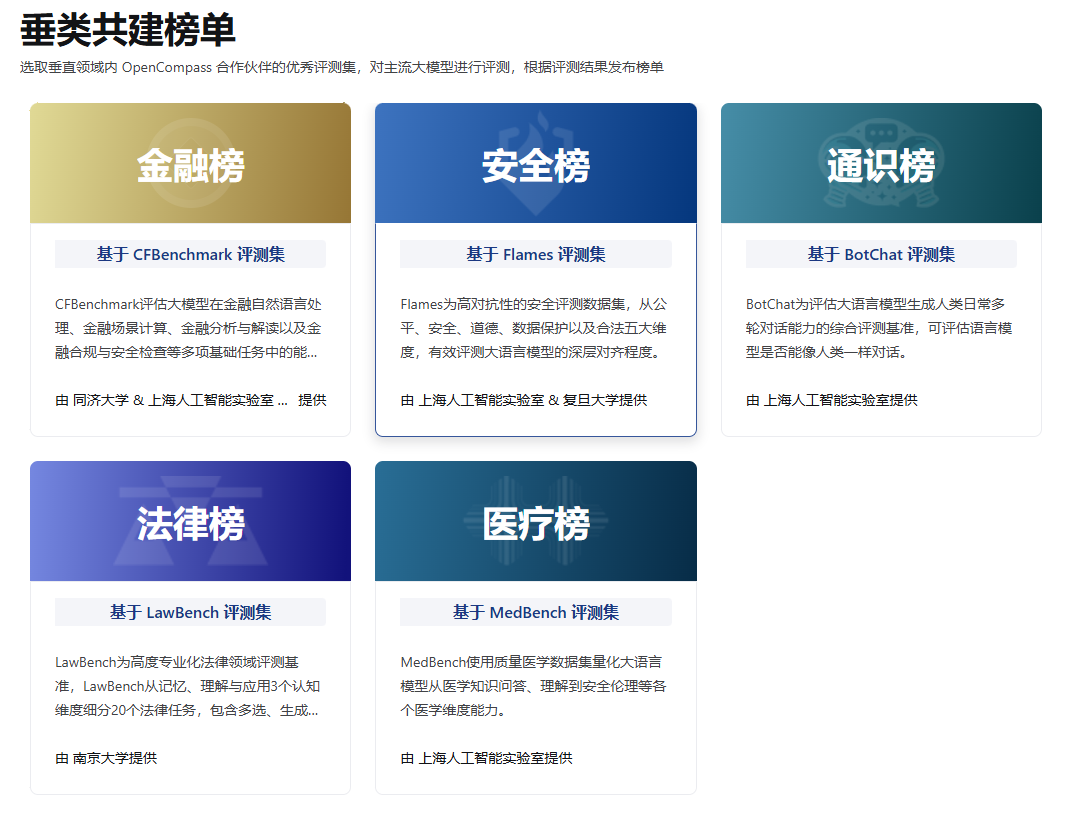
Заголовок раздела «7.1.3 Специализированные рейтинги»Кроме того, есть рейтинги больших моделей для конкретных задач в отдельных областях (рисунок 7.4). Они сосредоточены на конкретной прикладной сфере и помогают понять, на что модель способна в данной вертикали:
-
Финансовый рейтинг: на основе набора CFBenchmark оценивает модели в финансовой обработке языка, финансовом прогнозировании и расчётах, финансовом анализе и проверке безопасности и других базовых задачах. Подготовлен Университетом Тунцзи вместе с Шанхайской лабораторией искусственного интеллекта и Oriental Finance.
-
Рейтинг безопасности: на основе набора Flames оценивает стойкость моделей по пяти измерениям: справедливость, безопасность, защита данных и законность. Помогает глубже понять безопасность модели. Подготовлен Шанхайской лабораторией искусственного интеллекта и Фуданьским университетом.
-
Рейтинг общего общения: на основе набора BotChat оценивает, насколько хорошо модель ведёт повседневные многоходовые диалоги и достигает ли она в разговоре человеческого уровня. Подготовлен Шанхайской лабораторией искусственного интеллекта.
-
Юридический рейтинг: на основе набора LawBench оценивает понимание, рассуждение и применение в области права: ответы на юридические вопросы, генерацию текстов, анализ судебных прецедентов и т. п. Подготовлен Нанкинским университетом.
-
Медицинский рейтинг: на основе набора MedBench оценивает модели в ответах на вопросы по медицинским знаниям, понимании вопросов безопасности и этики и т. п. Подготовлен Шанхайской лабораторией искусственного интеллекта.
Рисунок 7.4. Рейтинги по вертикальным областям — карточки финансового, безопасности, общего общения, юридического и медицинского рейтингов OpenCompass (изображение в оригинале).
Примечание переводчика. В пункте про Flames названо «пять измерений», а перечислено четыре; в самой статье о Flames пятое — мораль (morality).
7.2 RAG
Заголовок раздела «7.2 RAG»7.2.1 Основной принцип RAG
Заголовок раздела «7.2.1 Основной принцип RAG»Большие языковые модели (LLM) обладают сильными способностями к пониманию и генерации языка, но при генерации сталкиваются с рядом трудностей. Например, LLM иногда порождают неточный или вводящий в заблуждение текст — это называют «галлюцинациями» (галлюцинациягаллюцинацияEN hallucination) больших моделей. Кроме того, обучающие данные модели могут устареть: особенно перед лицом свежей информации точность и актуальность ответов трудно гарантировать. Со специальными знаниями конкретных областей LLM тоже справляются неэффективно и не могут глубоко понять сложное предметное знание. Поэтому повышение качества и эффективности генерации больших моделей стало важным направлением исследований.
На этом фоне и появилась технология генерации с дополнением найденным (Retrieval-Augmented Generation, RAG) — одна из крупных инноваций в области ИИ. Прежде чем сгенерировать ответ, RAG сначала находит релевантную информацию во внешней большой базе документов и включает её в процесс генерации, направляя и улучшая ответ языковой модели. Такой процесс не только сильно повышает точность и релевантность сгенерированного текста, но и делает его актуальнее.
Суть RAG — соединить «поиск» и «генерацию»: когда пользователь задаёт вопрос, система сначала модулем поиска находит связанные с вопросом фрагменты текста, а затем передаёт эти фрагменты языковой модели как дополнительную информацию, и модель на их основе генерирует более точный и надёжный ответ. Так RAG эффективно смягчает проблему «галлюцинаций»: ответ опирается на реальные документы, поэтому его можно проследить до источника и ему больше доверия. А поскольку подключаются свежие источники, RAG сильно ускоряет обновление знаний: система может вовремя усваивать и отражать последние изменения в предметной области.
7.2.2 Строим фреймворк RAG
Заголовок раздела «7.2.2 Строим фреймворк RAG»Дальше я шаг за шагом проведу вас через реализацию простой модели RAG. Это упрощённая версия RAG, которую мы называем Tiny-RAG. В Tiny-RAG оставлены только основные функции RAG — поиск и генерация; её цель — помочь лучше понять принцип и реализацию RAG.
Шаг 1. Устройство RAG
Заголовок раздела «Шаг 1. Устройство RAG»RAG перед генерацией ответа языковой моделью сначала находит релевантную информацию в обширной базе документов, а затем использует её, чтобы направлять генерацию. Это сильно повышает точность и релевантность текста. RAG эффективно смягчает проблему галлюцинаций, ускоряет обновление знаний и делает ответы прослеживаемыми — так большие языковые модели становятся практичнее и надёжнее в реальных приложениях.
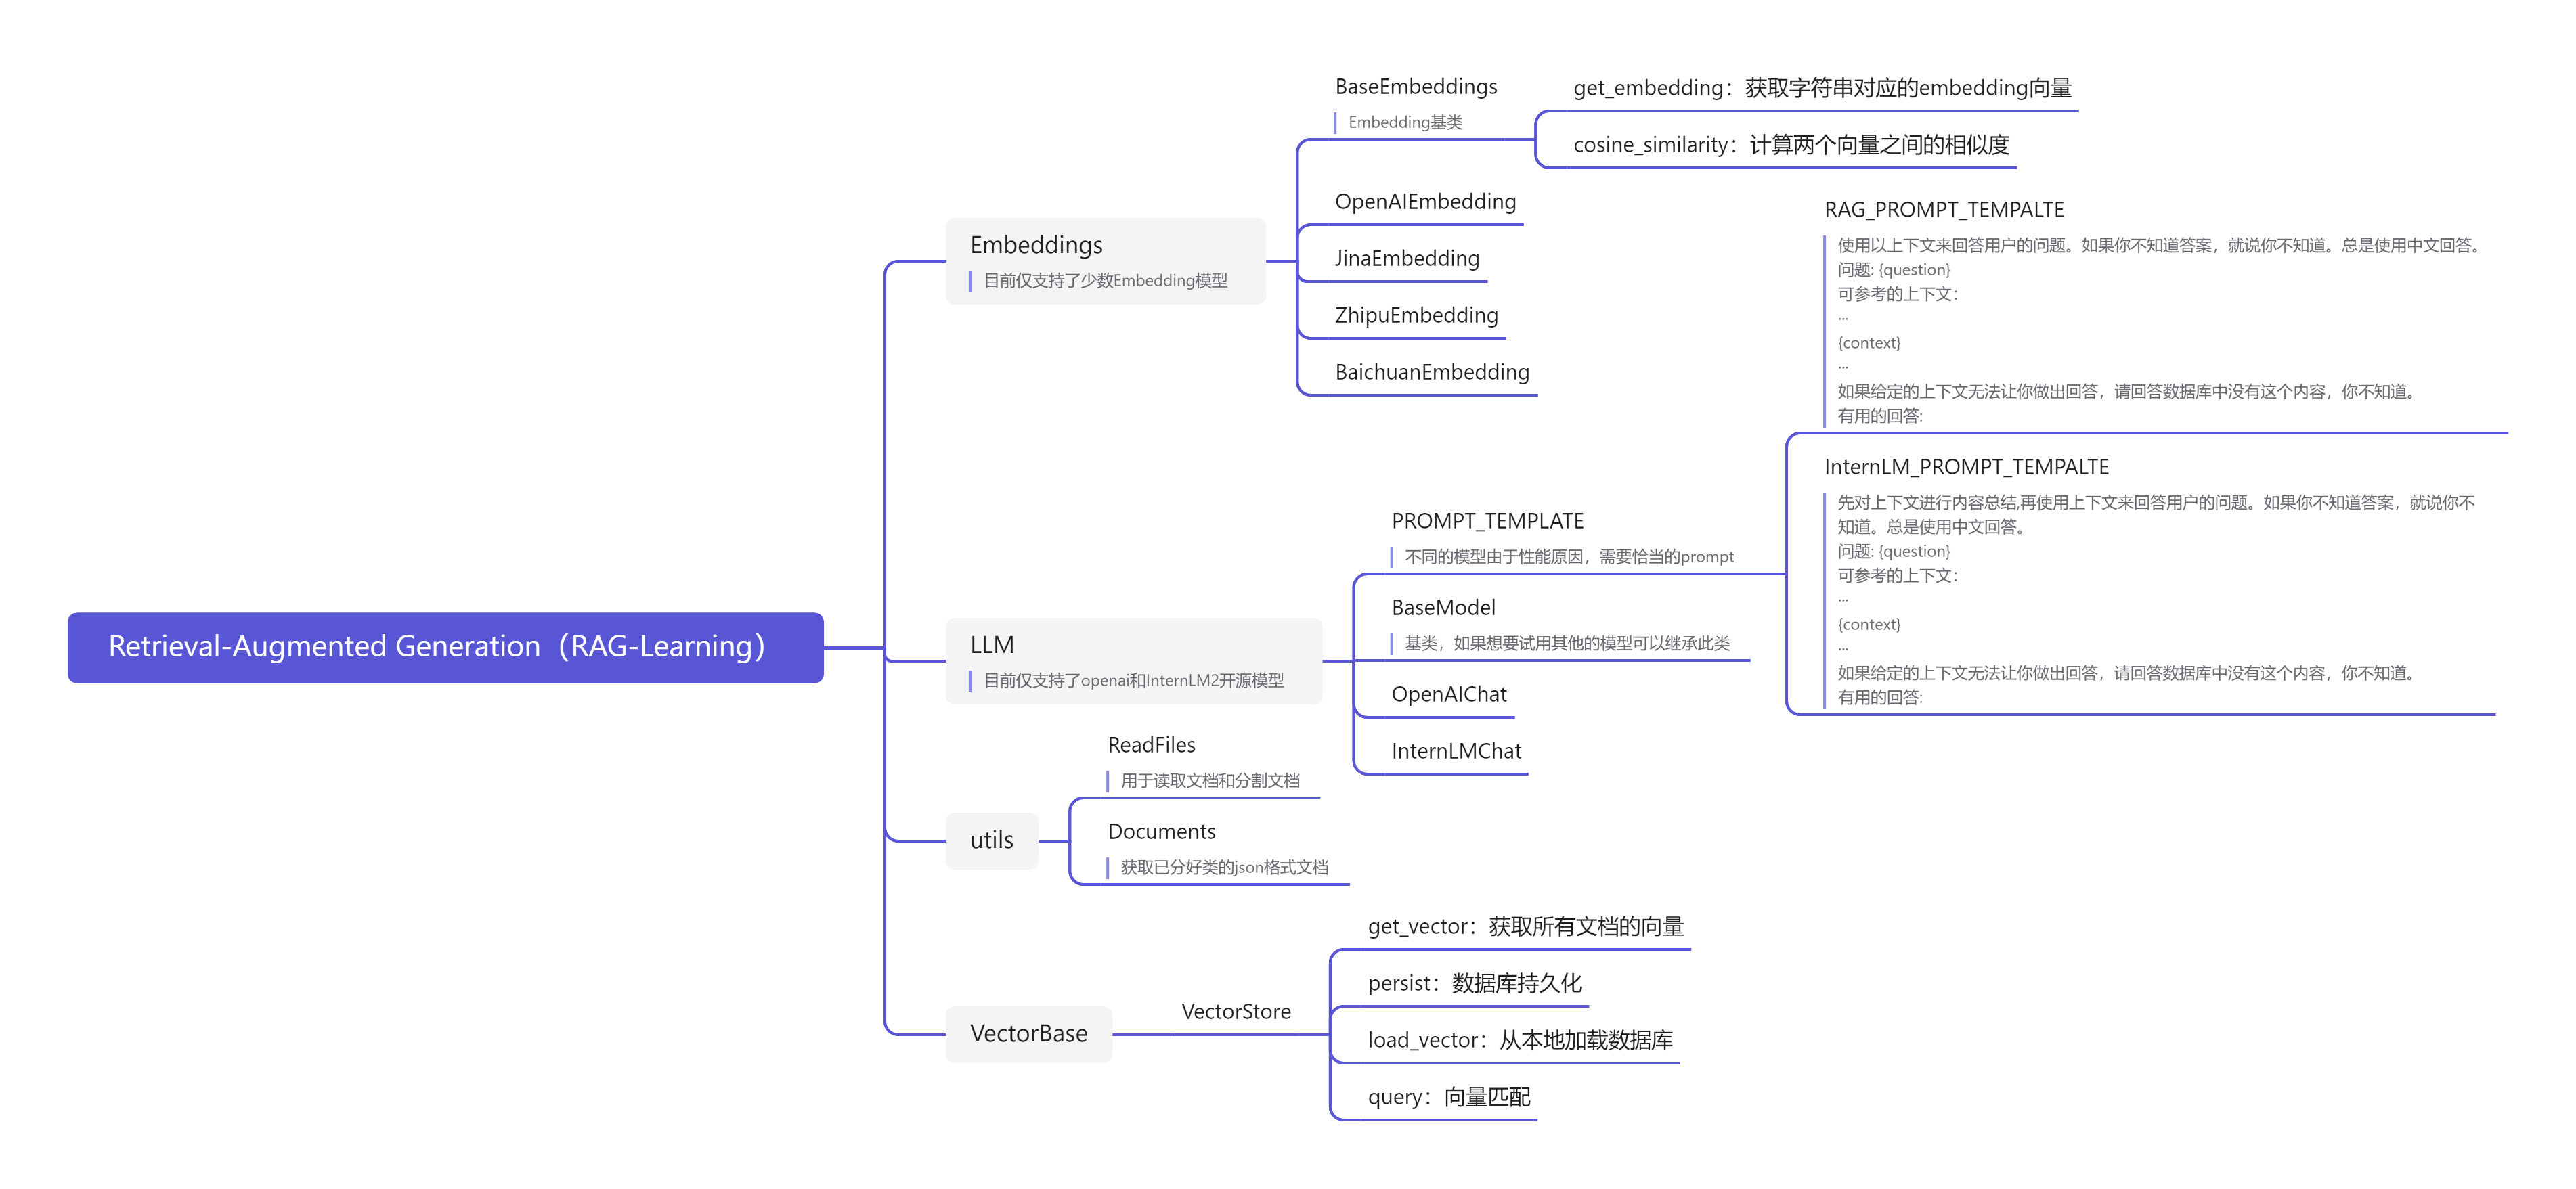
Из каких базовых частей состоит RAG?
- Модуль векторизации: превращает фрагменты документов в векторы.
- Модуль загрузки и нарезки документов: загружает документы и режет их на фрагменты.
- База данных: хранит фрагменты документов и их векторные представления.
- Модуль поиска: по Query (вопросу) находит релевантные фрагменты документов.
- Модуль большой модели: по найденным документам отвечает на вопрос пользователя.
Это и есть все модули TinyRAG (рисунок 7.5).
Рисунок 7.5. Структура проекта TinyRAG — интеллект-карта модулей: Embeddings (базовый класс BaseEmbeddings
с методами get_embedding — получить вектор строки и cosine_similarity — сходство двух векторов; наследники
OpenAIEmbedding, JinaEmbedding, ZhipuEmbedding, BaichuanEmbedding), LLM (BaseModel, OpenAIChat, InternLMChat
и шаблоны промптов), utils (ReadFiles — чтение и нарезка документов, Documents — загрузка размеченных json-документов)
и VectorBase (VectorStore с методами get_vector, persist, load_vector, query)
(изображение в оригинале).
Теперь разберёмся, как выглядит процесс RAG:
- Индексация: режем библиотеку документов на короткие фрагменты и кодировщиком строим векторный индекс.
- Поиск: по сходству вопроса и фрагментов находим релевантные фрагменты документов.
- Генерация: генерируем ответ на вопрос, опираясь на найденный контекст.
Схема процесса — на рисунке 7.6; источник рисунка — Retrieval-Augmented Generation for Large Language Models: A Survey.
flowchart LR
subgraph IDX["Индексация (заранее)"]
  D["Документы"] --> C["Нарезка на фрагменты"] --> EM["Эмбеддинги"] --> DB[("Векторная база")]
end
Q["Вопрос"] --> QE["Эмбеддинг вопроса"] --> S["Поиск похожих фрагментов"]
DB --> S
S --> P["Промпт: вопрос + найденный контекст"] --> L["LLM"] --> A["Ответ"]Шаг 2. Загрузка и нарезка документов
Заголовок раздела «Шаг 2. Загрузка и нарезка документов»Теперь реализуем класс загрузки и нарезки документов: он загружает документы и режет их на фрагменты.
Документом может быть статья, книга, диалог, код и другой текст — например, файлы pdf, md, txt. Полный код — в файле RAG/utils.py. Код поддерживает загрузку файлов pdf, md, txt и других типов — достаточно написать соответствующую функцию.
def read_file_content(cls, file_path: str): # Выбираем способ чтения по расширению файла if file_path.endswith('.pdf'): return cls.read_pdf(file_path) elif file_path.endswith('.md'): return cls.read_markdown(file_path) elif file_path.endswith('.txt'): return cls.read_text(file_path) else: raise ValueError("Unsupported file type")Прочитанный документ нужно нарезать. Можно задать максимальную длину в токенах и резать документ по ней. Резать лучше
по предложениям (грубо — по \n) и следить, чтобы соседние фрагменты немного перекрывались: это повышает точность
поиска.
def get_chunk(cls, text: str, max_token_len: int = 600, cover_content: int = 150):    chunk_text = []
    curr_len = 0    curr_chunk = ''
    token_len = max_token_len - cover_content    lines = text.splitlines()  # считаем, что текст делится на строки по символу перевода строки
    for line in lines:        # Сохраняем пробелы внутри, убираем только пробелы в начале и конце строки        line = line.strip()        line_len = len(enc.encode(line))
        if line_len > max_token_len:            # Если одна строка длиннее лимита, режем её на несколько блоков            # Сначала сохраняем текущий блок (если в нём что-то есть)            if curr_chunk:                chunk_text.append(curr_chunk)                curr_chunk = ''                curr_len = 0
            # Режем длинную строку по числу токенов            line_tokens = enc.encode(line)            num_chunks = (len(line_tokens) + token_len - 1) // token_len
            for i in range(num_chunks):                start_token = i * token_len                end_token = min(start_token + token_len, len(line_tokens))
                # Декодируем кусок токенов обратно в текст                chunk_tokens = line_tokens[start_token:end_token]                chunk_part = enc.decode(chunk_tokens)
                # Добавляем перекрытие (кроме первого блока)                if i > 0 and chunk_text:                    prev_chunk = chunk_text[-1]                    cover_part = prev_chunk[-cover_content:] if len(prev_chunk) > cover_content else prev_chunk                    chunk_part = cover_part + chunk_part
                chunk_text.append(chunk_part)
            # Сбрасываем состояние текущего блока            curr_chunk = ''            curr_len = 0
        elif curr_len + line_len + 1 <= token_len:  # +1 — на перевод строки            # Текущая строка помещается в текущий блок            if curr_chunk:                curr_chunk += '\n'                curr_len += 1            curr_chunk += line            curr_len += line_len        else:            # Текущая строка не помещается — начинаем новый блок            if curr_chunk:                chunk_text.append(curr_chunk)
            # Начинаем новый блок с перекрытием            if chunk_text:                prev_chunk = chunk_text[-1]                cover_part = prev_chunk[-cover_content:] if len(prev_chunk) > cover_content else prev_chunk                curr_chunk = cover_part + '\n' + line                curr_len = len(enc.encode(cover_part)) + 1 + line_len            else:                curr_chunk = line                curr_len = line_len
    # Добавляем последний блок (если в нём что-то есть)    if curr_chunk:        chunk_text.append(curr_chunk)
    return chunk_text
Примечание переводчика.
enc— токенизатор tiktoken, вutils.pyон создаётся так:enc = tiktoken.get_encoding("cl100k_base"). Обратите внимание на единицы: лимитmax_token_lenсчитается в токенах, а перекрытиеcover_contentберётся как последние 150 символов предыдущего блока (prev_chunk[-cover_content:]). С параметрами по умолчанию полезная часть блока — до 600 − 150 = 450 токенов плюс перекрытие. Другие способы нарезки — в уроке 8.2.1 (чанкингчанкинг (нарезка документов)EN chunkingРазбиение документов на фрагменты (чанки) для индексации. Каждый чанк получает свой эмбеддинг.).
Шаг 3. Векторизация
Заголовок раздела «Шаг 3. Векторизация»Сначала своими руками напишем класс векторизации — это основа архитектуры RAG. Он превращает фрагменты документов в векторы: отображает отрезок текста в вектор.
Начнём с базового класса BaseEmbeddings: тогда для другой модели достаточно унаследовать этот класс и доработать его —
код легко расширять.
class BaseEmbeddings:    """    Base class for embeddings    """    def __init__(self, path: str, is_api: bool) -> None:        """        Инициализация базового класса эмбеддингов        Args:            path (str): путь к модели или данным            is_api (bool): использовать ли API. True — онлайн-сервис по API, False — локальная модель        """        self.path = path        self.is_api = is_api
    def get_embedding(self, text: str, model: str) -> List[float]:        """        Получить векторное представление (эмбеддинг) текста        Args:            text (str): входной текст            model (str): имя используемой модели        Returns:            List[float]: вектор-эмбеддинг текста        Raises:            NotImplementedError: метод нужно реализовать в подклассе        """        raise NotImplementedError
    @classmethod    def cosine_similarity(cls, vector1: List[float], vector2: List[float]) -> float:        """        Посчитать косинусное сходство двух векторов        Args:            vector1 (List[float]): первый вектор            vector2 (List[float]): второй вектор        Returns:            float: косинусное сходство векторов, в диапазоне [-1, 1]        """        # Превращаем входные списки в массивы numpy с типом float32        v1 = np.array(vector1, dtype=np.float32)        v2 = np.array(vector2, dtype=np.float32)
        # Проверяем, нет ли в векторах бесконечностей или NaN        if not np.all(np.isfinite(v1)) or not np.all(np.isfinite(v2)):            return 0.0
        # Скалярное произведение векторов        dot_product = np.dot(v1, v2)        # Нормы (длины) векторов        norm_v1 = np.linalg.norm(v1)        norm_v2 = np.linalg.norm(v2)
        # Знаменатель — произведение норм        magnitude = norm_v1 * norm_v2        # Особый случай: знаменатель равен 0        if magnitude == 0:            return 0.0
        # Возвращаем косинусное сходство        return dot_product / magnitude
У базового класса BaseEmbeddings два основных метода: get_embedding и cosine_similarity. get_embedding
получает векторное представление текста, cosine_similarity считает косинусное сходствокосинусное сходствоEN cosine similarityКосинус угла между векторами — скалярное произведение, делённое на произведение длин. Для нормированных векторов равно скалярному произведению.
двух векторов. При инициализации класса задаются путь к модели и то, работает ли модель по API; например, для Embedding
API от OpenAI нужно задать self.is_api=True.
Наследнику BaseEmbeddings достаточно реализовать метод get_embedding — метод cosine_similarity унаследуется.
В этом и польза базового класса.
class OpenAIEmbedding(BaseEmbeddings):    """    class for OpenAI embeddings    """    def __init__(self, path: str = '', is_api: bool = True) -> None:        super().__init__(path, is_api)        if self.is_api:            self.client = OpenAI()            # Берём ключ SiliconFlow из переменной окружения            self.client.api_key = os.getenv("OPENAI_API_KEY")            # Берём базовый URL SiliconFlow из переменной окружения            self.client.base_url = os.getenv("OPENAI_BASE_URL")
    def get_embedding(self, text: str, model: str = "BAAI/bge-m3") -> List[float]:        """        По умолчанию здесь используется бесплатная модель эмбеддингов BAAI/bge-m3 от SiliconFlow        """        if self.is_api:            text = text.replace("\n", " ")            return self.client.embeddings.create(input=[text], model=model).data[0].embedding        else:            raise NotImplementedError
Примечание: здесь по умолчанию используется платформа API больших моделей SiliconFlow, доступная пользователям в Китае.
Примечание переводчика. Подойдёт любой OpenAI-совместимый провайдер эмбеддингов: в файле
.envзадайтеOPENAI_API_KEYиOPENAI_BASE_URL(образец —RAG/.env_example) и, если нужно, другое имя модели. BGE-M3 многоязычная и хорошо работает с русским текстом; её можно запустить и локально (библиотекаsentence-transformersилиFlagEmbedding), тогдаis_api=Falseи методget_embeddingнужно дописать самим.
Шаг 4. База данных и векторный поиск
Заголовок раздела «Шаг 4. База данных и векторный поиск»Нарезав документы и загрузив модель эмбеддингов, нужно спроектировать векторную базу данных (векторная база данныхвекторная база данныхEN vector database), где будут храниться фрагменты документов и их векторы, и модуль поиска, который по Query находит релевантные фрагменты.
Функции векторной базы:
persist: сохранить базу на диск.load_vector: загрузить базу с диска.get_vector: получить векторные представления документов.query: найти по вопросу релевантные фрагменты документов.
Полный код — в файле VectorBase.py.
class VectorStore:    def __init__(self, document: List[str] = ['']) -> None:        self.document = document
    def get_vector(self, EmbeddingModel: BaseEmbeddings) -> List[List[float]]:        # Получаем векторные представления документов        pass
    def persist(self, path: str = 'storage'):        # Сохраняем базу на диск        pass
    def load_vector(self, path: str = 'storage'):        # Загружаем базу с диска        pass
    def query(self, query: str, EmbeddingModel: BaseEmbeddings, k: int = 1) -> List[str]:        # Находим по вопросу релевантные фрагменты документов        pass
Метод query векторизует вопрос пользователя, затем ищет в базе релевантные фрагменты документов и возвращает результат.
def query(self, query: str, EmbeddingModel: BaseEmbeddings, k: int = 1) -> List[str]: query_vector = EmbeddingModel.get_embedding(query) result = np.array([self.get_similarity(query_vector, vector) for vector in self.vectors]) return np.array(self.document)[result.argsort()[-k:][::-1]].tolist()Читаем код (от переводчика).
result— массив сходств вопроса с каждым фрагментом.argsort()возвращает номера фрагментов по возрастанию сходства,[-k:]берёт k последних (самых похожих),[::-1]переворачивает — самый похожий первым. Пример: сходства[0.2, 0.9, 0.5],k=2→argsort()=[0, 2, 1]→[-2:]=[2, 1]→[::-1]=[1, 2]: сначала фрагмент 1, потом 2. Это полный перебор; в настоящих базах вместо него — приближённый поиск (приближённый поиск ближайших соседейприближённый поиск ближайших соседей (ANN)EN approximate nearest neighbor search (ANN)Поиск похожих векторов без полного перебора (HNSW, IVF, PQ) ценой небольшой потери полноты., HNSWHNSW (иерархический граф «малого мира»)EN Hierarchical Navigable Small World (HNSW)Один из самых распространённых ANN-индексов в векторных БД — многослойный граф, по которому поиск спускается от редких верхних слоёв к плотным нижним; предложен Ю. Мальковым и Д. Яшуниным (arXiv:1603.09320).), см. урок 8.2.2.
Шаг 5. Модуль большой модели
Заголовок раздела «Шаг 5. Модуль большой модели»Следующий модуль — большая модель: она отвечает на вопрос пользователя по найденным документам.
Сначала напишем базовый класс, чтобы легко подключать другие модели.
class BaseModel:    def __init__(self, path: str = '') -> None:        self.path = path
    def chat(self, prompt: str, history: List[dict], content: str) -> str:        pass
    def load_model(self):        pass
В BaseModel два метода: chat и load_model. Для открытых моделей, запускаемых локально, нужно реализовать
load_model, для моделей по API — не нужно. Здесь мы снова используем доступную пользователям в Китае платформу API
больших моделей SiliconFlow. Плюс API-сервиса в том, что пользователю не нужны локальные вычислительные ресурсы, —
это сильно снижает порог входа для учащихся.
from openai import OpenAI
class OpenAIChat(BaseModel):    def __init__(self, model: str = "Qwen/Qwen2.5-32B-Instruct") -> None:        self.model = model
    def chat(self, prompt: str, history: List[dict], content: str) -> str:        client = OpenAI()        client.api_key = os.getenv("OPENAI_API_KEY")        client.base_url = os.getenv("OPENAI_BASE_URL")        history.append({'role': 'user', 'content': RAG_PROMPT_TEMPLATE.format(question=prompt, context=content)})        response = client.chat.completions.create(                model=self.model,                messages=history,                max_tokens=2048,                temperature=0.1            )        return response.choices[0].message.content
Напишем промпт специально для RAG:
RAG_PROMPT_TEMPLATE="""Используй контекст, чтобы ответить на вопрос пользователя. Если не знаешь ответа, так и скажи, что не знаешь. Всегда отвечай на русском языке.Вопрос: {question}Контекст, на который можно опереться:···{context}···Если по данному контексту ответить нельзя, ответь, что в базе данных этого нет и ты не знаешь.Полезный ответ:"""Примечание переводчика. В оригинале промпт на китайском и требует «всегда отвечай по-китайски»; мы перевели промпт целиком и заменили язык ответа на русский. Две строки «Если не знаешь — скажи» и «Если по контексту нельзя ответить — скажи» — простейшая защита от галлюцинаций: модели явно разрешают отказаться. Значки
···просто выделяют контекст; надёжнее обрамлять его тегами вроде<context>…</context>.
Вот так мы можем использовать модель InternLM2 для RAG!
Примечание переводчика. Фраза про InternLM2 осталась от ранней версии Tiny-RAG; в коде главы модель — Qwen2.5-32B-Instruct через API.
Шаг 6. Демо Tiny-RAG
Заголовок раздела «Шаг 6. Демо Tiny-RAG»Теперь посмотрим на демо Tiny-RAG!
from VectorBase import VectorStorefrom utils import ReadFilesfrom LLM import OpenAIChatfrom Embeddings import OpenAIEmbedding
# База ещё не сохраненаdocs = ReadFiles('./data').get_content(max_token_len=600, cover_content=150) # берём содержимое всех файлов из каталога data и нарезаемvector = VectorStore(docs)embedding = OpenAIEmbedding() # создаём EmbeddingModelvector.get_vector(EmbeddingModel=embedding)vector.persist(path='storage') # сохраняем векторы и документы в каталог storage; в следующий раз базу можно просто загрузить
# vector.load_vector('./storage') # загрузить базу с диска
question = 'В чём принцип RAG?'
content = vector.query(question, EmbeddingModel=embedding, k=1)[0]chat = OpenAIChat(model='Qwen/Qwen2.5-32B-Instruct')print(chat.chat(question, [], content))
Можно и загрузить уже подготовленную базу с диска:
from VectorBase import VectorStorefrom utils import ReadFilesfrom LLM import OpenAIChatfrom Embeddings import OpenAIEmbedding
# После того как база сохраненаvector = VectorStore()
vector.load_vector('./storage') # загружаем базу с диска
question = 'В чём принцип RAG?'
embedding = OpenAIEmbedding() # создаём EmbeddingModel (в оригинале — ZhipuEmbedding(), см. примечание)
content = vector.query(question, EmbeddingModel=embedding, k=1)[0]chat = OpenAIChat(model='Qwen/Qwen2.5-32B-Instruct')print(chat.chat(question, [], content))
Примечание: весь код раздела 7.2 лежит в Happy-LLM Chapter7 RAG.
Примечание переводчика. Во втором фрагменте оригинал создаёт
ZhipuEmbedding(), которого нет ни в импортах, ни вEmbeddings.py, — мы заменили наOpenAIEmbedding(). Важно: вопрос нужно векторизовать той же моделью эмбеддингов, что и документы, иначе векторы окажутся в разных пространствах и поиск сломается. Демо берёт лишь один лучший фрагмент (k=1) — для ответов на сложные вопросы обычно берут 3–5 фрагментов и склеивают их в контекст.
7.3 Agent
Заголовок раздела «7.3 Agent»7.3.1 Что такое LLM Agent?
Заголовок раздела «7.3.1 Что такое LLM Agent?»Проще говоря, агент на основе большой модели — это система, в которой LLM служит «мозгом», а ещё ей даны способности самостоятельно планировать, помнить и использовать инструменты. Она уже не просто пассивно отвечает на подсказку (Prompt) пользователя, а умеет:
- Понимать цель (Goal Understanding): принимать относительно сложную или высокоуровневую цель (например, «спланируй мне поездку в Пекин на выходные и забронируй билеты и отель»).
- Самостоятельно планировать (Planning): раскладывать большую цель на ряд выполнимых шагов (например, «найти достопримечательности Пекина», «узнать погоду», «сравнить цены на билеты», «найти подходящий отель», «вызвать API бронирования» и т. д.).
- Помнить (Memory): иметь кратковременную память (помнить контекст текущей задачи) и долговременную (учиться на прошлых взаимодействиях или во внешней базе знаний и извлекать оттуда информацию).
- Использовать инструменты (Tool Use): вызывать внешние API, плагины или среду исполнения кода, чтобы получать информацию (поисковик, база данных), выполнять действия (отправить письмо, забронировать услугу) или вычислять.
- Рефлексировать и повторять (Reflection & Iteration): (у более продвинутых агентов) оценивать своё поведение и результаты, учиться на них и корректировать дальнейший план.
Обычная LLM похожа на эрудированного библиотекаря, который может только рассуждать на бумаге, а LLM Agent — скорее универсальный личный помощник: он не только много знает, но и бегает по поручениям и даже сам ищет лучший вариант.
flowchart TB
U["Запрос пользователя"] --> I["Обработка и понимание запроса"] --> T{"Оценка задачи"}
T -- "простая задача" --> G["Сразу сгенерировать ответ"]
T -- "сложная задача" --> P["Спланировать шаги"] --> S["Выбор инструмента"] --> X["Вызов инструмента"]
K["Внешние знания и инструменты"] -.-> S
K -.-> X
G --> M["Сведение и анализ результатов"] --> R["Генерация ответа"]
X --> R
R --> F["Обратная связь от пользователя"]
F -. "итеративное улучшение" .-> UСоединив сильные способности большой языковой модели к пониманию и генерации языка с ключевыми модулями планирования, памяти и использования инструментов, LLM Agent получает самостоятельность и умение решать сложные задачи, которых нет у обычных больших моделей. Поэтому у LLM Agent широкий потенциал во многих вертикальных областях (право, медицина, финансы и др.). Принцип работы агента показан на рисунке 7.7.
7.3.2 Типы LLM Agent
Заголовок раздела «7.3.2 Типы LLM Agent»Понятие LLM Agent ещё быстро развивается, но по замыслу и упору в способностях агентов можно грубо разделить на несколько типов.
Агенты, ориентированные на задачу (Task-Oriented Agents):
- Особенности: сосредоточены на выполнении чётко определённых задач в конкретной области — поддержка клиентов, генерация кода, анализ данных и т. п.
- Как работают: обычно у них есть заданный процесс и определённый набор вызываемых инструментов. LLM в основном отвечает за понимание намерения пользователя, заполнение «слотов» задачи, генерацию ответов или вызов подходящих инструментов.
- Примеры: чат-бот для бронирования ресторанов, помощник программиста (например, GitHub Copilot в некоторых продвинутых функциях проявляет свойства агента).
Агенты планирования и рассуждения (Planning & Reasoning Agents):
- Особенности: упор на умение самостоятельно разбивать сложную задачу, составлять многошаговый план и корректировать его по обратной связи от среды. Обычно им нужны более сильные способности к рассуждению.
- Как работают: часто используют особые схемы мышления, например ReActReAct (рассуждение + действие)EN ReAct (Reason + Act)Парадигма агента, где модель чередует Thought → Action → Observation (Yao и др., 2022). (Reason+Act): модель сначала «думает» (Reasoning) — анализирует ситуацию и нужные действия, затем «действует» (Action) — вызывает инструмент, а потом по результату инструмента начинает следующий круг размышлений. Техники промптинга вроде Chain-of-Thought (цепочка рассужденийцепочка рассужденийEN chain of thought (CoT)) — тоже основа их рассуждений.
- Примеры: исследовательский агент, который для ответа на сложный вопрос сочетает веб-поиск, калькулятор, запросы к базе данных и другие инструменты; агент, который сам выполняет задачу вроде «напиши отчёт на тему X и добавь графики с данными».
Многоагентные системы (Multi-Agent Systems):
- Особенности: несколько агентов с разными ролями или способностями работают вместе ради более крупной цели.
- Как работают: агенты могут общаться, сотрудничать, спорить и даже соревноваться. Например, один агент планирует, другой исполняет, третий проверяет.
- Примеры: имитация команды разработчиков (агент — менеджер продукта, агент — программист, агент — тестировщик) для автоматического написания и тестирования кода; имитация структуры компании для бизнес-планирования. Такие системы помогают строить фреймворки AutoGen, ChatDev и другие.
Агенты исследования и обучения (Exploration & Learning Agents):
- Особенности: такие агенты не только выполняют задачи, но и во взаимодействии со средой сами учатся новому, осваивают навыки или улучшают свою стратегию — похоже на понятие агента в обучении с подкреплением.
- Как работают: могут иметь более сложные механизмы памяти и рефлексии и корректировать будущие планы и действия по опыту успехов и неудач.
- Примеры: агент, который сам исследует незнакомую программную среду и учится в ней работать; агент, который всё лучше играет в игру.
Примечание переводчика. Последний тип — мостик к главе 8: там агента учат пользоваться поиском и интерпретатором кода обучением с подкреплением. Планирование, память и многоагентные системы подробнее — в уроке 8.3.3.
7.3.3 Строим Tiny-Agent своими руками
Заголовок раздела «7.3.3 Строим Tiny-Agent своими руками»Построим на основе библиотеки openai и её функции tool_calls маленького агента — Tiny-Agent. Это простой агент,
ориентированный на задачу: по вводу пользователя он отвечает на несложные вопросы.
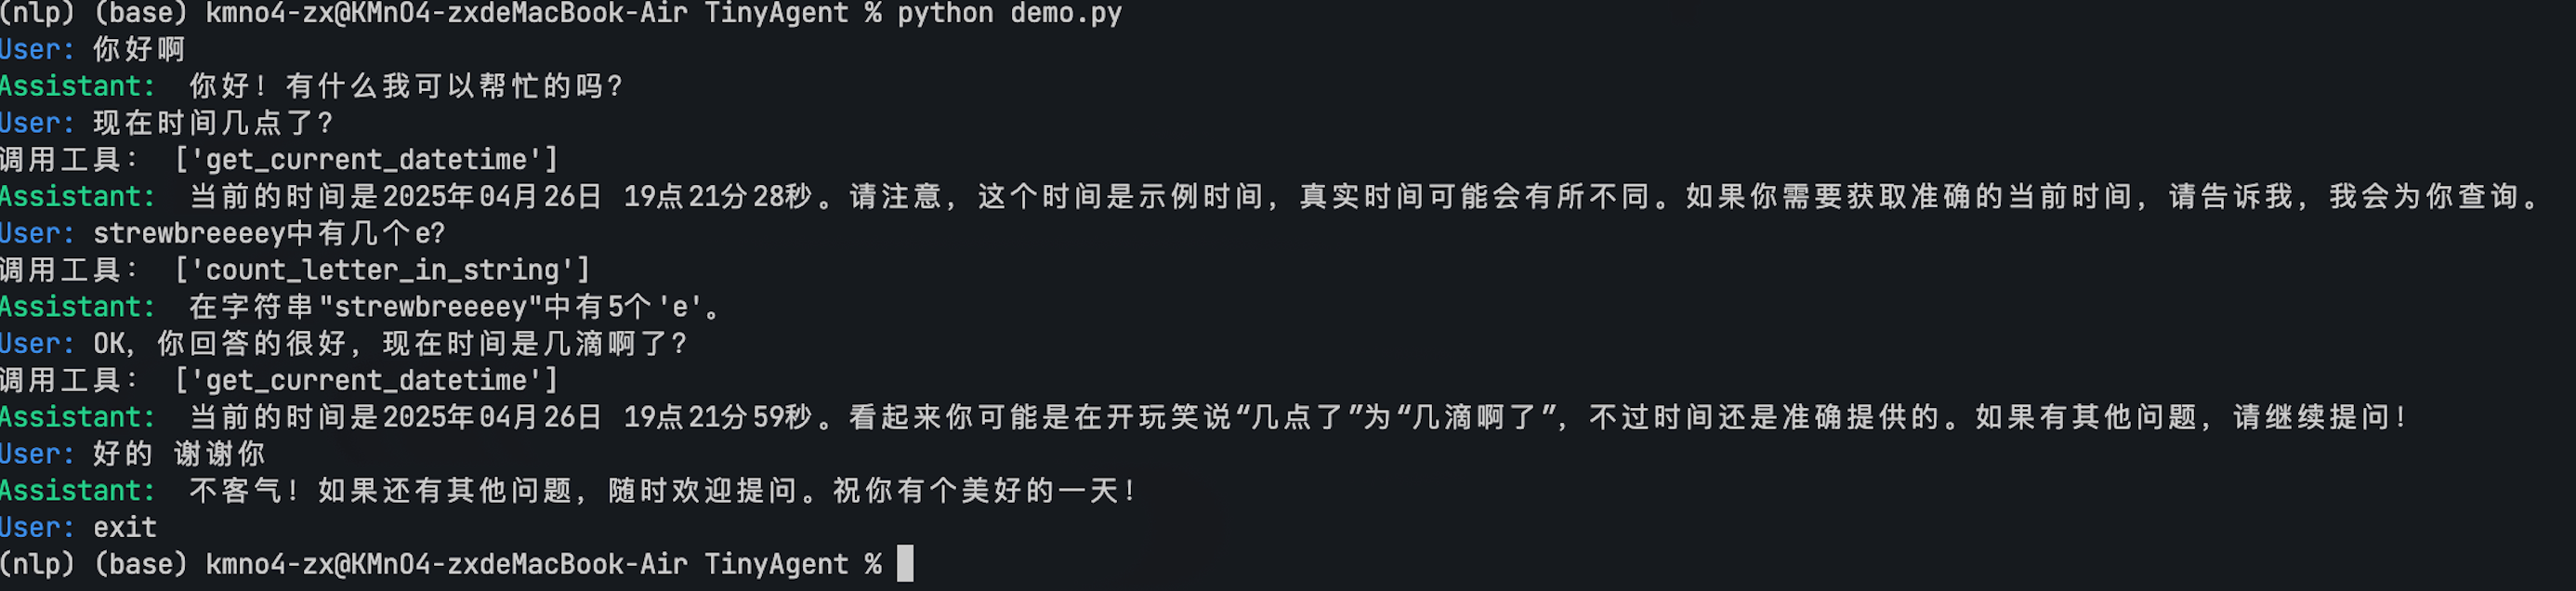
Итоговый результат — на рисунке 7.8.
Рисунок 7.8. Пример работы: в терминале пользователь задаёт вопросы, агент вызывает инструменты и отвечает (изображение в оригинале).
Шаг 1. Инициализируем клиент и модель
Заголовок раздела «Шаг 1. Инициализируем клиент и модель»Сначала нужен клиент, через который вызывается большая модель. Здесь используем библиотеку openai и направим её
на сервис, совместимый с OpenAI API, например SiliconFlow. Заодно
укажем модель, например Qwen/Qwen2.5-32B-Instruct.
from openai import OpenAI
# Инициализируем клиент OpenAIclient = OpenAI(    api_key="YOUR_API_KEY",  # замените своим API Key    base_url="https://api.siliconflow.cn/v1", # адрес API SiliconFlow)
# Задаём имя моделиmodel_name = "Qwen/Qwen2.5-32B-Instruct"
Внимание: замените
YOUR_API_KEYдействующим API Key от SiliconFlow или другого провайдера.
Шаг 2. Описываем функции-инструменты
Заголовок раздела «Шаг 2. Описываем функции-инструменты»В файле src/tools.py опишем функции-инструменты, которыми может пользоваться агент. У каждой функции должна быть
понятная строка документации (docstring) с описанием назначения и параметров — по ней автоматически строится
JSON Schema инструмента.
from datetime import datetime
# Получить текущие дату и времяdef get_current_datetime() -> str:    """    Получить текущие дату и время.    :return: строка с текущими датой и временем.    """    current_datetime = datetime.now()    formatted_datetime = current_datetime.strftime("%Y-%m-%d %H:%M:%S")    return formatted_datetime
def count_letter_in_string(a: str, b: str):    """    Посчитать, сколько раз буква встречается в строке.    :param a: строка, в которой ищем.    :param b: буква, которую считаем.    :return: число вхождений буквы в строку.    """    return str(a.count(b))
def search_wikipedia(query: str) -> str:    """    Найти в Википедии краткие описания первых трёх страниц по запросу.    :param query: строка запроса.    :return: строка с описаниями первых трёх страниц.    """    page_titles = wikipedia.search(query)    summaries = []    for page_title in page_titles[: 3]:  # берём первые три заголовка страниц        try:            # Функция page модуля wikipedia возвращает объект страницы Википедии с заданным заголовком.            wiki_page = wikipedia.page(title=page_title, auto_suggest=False)            # Берём краткое описание страницы            summaries.append(f"Страница: {page_title}\nОписание: {wiki_page.summary}")        except (                wikipedia.exceptions.PageError,                wikipedia.exceptions.DisambiguationError,        ):            pass    if not summaries:        return "В Википедии не нашлось подходящих результатов"    return "\n\n".join(summaries)# ... (могут быть и другие функции-инструменты)
Примечание переводчика. Для
search_wikipediaнуженimport wikipedia(пакетwikipediaизAgent/requirements.txt); в файле репозитория импорт есть. Там же лежат инструментыadd,mul,compareиget_current_temperature, которые используются ниже. Docstring здесь — не просто комментарий: он станет полемdescriptionинструмента, и по нему модель решает, когда инструмент вызывать.
Чтобы OpenAI API понял эти инструменты, их нужно преобразовать в особый формат JSON Schema. Это делает
вспомогательная функция function_to_json из src/utils.py.
# src/utils.py (фрагмент)import inspect
def function_to_json(func) -> dict:    # ... (детали реализации функции)    # Возвращаем словарь в формате схемы инструмента OpenAI    return {        "type": "function",        "function": {            "name": func.__name__,            "description": inspect.getdoc(func),            "parameters": {                "type": "object",                "properties": parameters,                "required": required,            },        },    }
Примечание переводчика. Пропущенные «детали» в файле таковы:
inspect.signature(func)даёт список параметров; аннотация каждого параметра переводится в тип JSON по таблицеstr → "string",int → "integer",float → "number",bool → "boolean",list → "array",dict → "object"(неизвестное —"string"); вrequiredпопадают параметры без значения по умолчанию. Дляcompare(a: float, b: float)получится"properties": {"a": {"type": "number"}, "b": {"type": "number"}}, "required": ["a", "b"].
Шаг 3. Пишем класс Agent
Заголовок раздела «Шаг 3. Пишем класс Agent»В файле src/core.py опишем класс Agent. Он ведёт историю диалога, вызывает OpenAI API, обрабатывает запросы на
вызов инструментов и выполняет функции-инструменты.
# src/core.py (фрагмент)from openai import OpenAIimport jsonfrom typing import List, Dict, Anyfrom utils import function_to_json# Импортируем описанные функции-инструментыfrom tools import get_current_datetime, add, compare, count_letter_in_string
SYSTEM_PROMPT = """Ты ИИ-ассистент по имени «Без лука, имбиря и чеснока». Отвечай на том же языке, на котором пишет пользователь.Когда для ответа на вопрос пользователя нужен инструмент, ты можешь вызвать подходящую функцию из предоставленного списка инструментов."""
class Agent:    def __init__(self, client: OpenAI, model: str = "Qwen/Qwen2.5-32B-Instruct", tools: List=[], verbose : bool = True):        self.client = client        self.tools = tools        self.model = model        self.messages = [            {"role": "system", "content": SYSTEM_PROMPT},        ]        self.verbose = verbose
    def get_tool_schema(self) -> List[Dict[str, Any]]:        # Получаем JSON-схемы всех инструментов        return [function_to_json(tool) for tool in self.tools]
    def handle_tool_call(self, tool_call):        # Обрабатываем вызов инструмента        function_name = tool_call.function.name        function_args = tool_call.function.arguments        function_id = tool_call.id
        function_call_content = eval(f"{function_name}(**{function_args})")
        return {            "role": "tool",            "content": function_call_content,            "tool_call_id": function_id,        }
    def get_completion(self, prompt) -> str:
        self.messages.append({"role": "user", "content": prompt})
        # Получаем ответ модели        response = self.client.chat.completions.create(            model=self.model,            messages=self.messages,            tools=self.get_tool_schema(),            stream=False,        )
        # Проверяем, вызвала ли модель инструменты        if response.choices[0].message.tool_calls:            self.messages.append({"role": "assistant", "content": response.choices[0].message.content})            # Обрабатываем вызовы инструментов            tool_list = []            for tool_call in response.choices[0].message.tool_calls:                # Обрабатываем вызов и добавляем результат в список сообщений                self.messages.append(self.handle_tool_call(tool_call))                tool_list.append([tool_call.function.name, tool_call.function.arguments])            if self.verbose:                print("Вызов инструментов:", response.choices[0].message.content, tool_list)            # Снова получаем ответ модели — теперь с результатами инструментов            response = self.client.chat.completions.create(                model=self.model,                messages=self.messages,                tools=self.get_tool_schema(),                stream=False,            )
        # Добавляем ответ модели в список сообщений        self.messages.append({"role": "assistant", "content": response.choices[0].message.content})        return response.choices[0].message.content
Примечание переводчика. «Без лука, имбиря и чеснока» — перевод сетевого ника одного из авторов книги. В тексте оригинала в
__init__опечаткаSYSREM_PROMPT— мы исправили наSYSTEM_PROMPT. Важнее другое: в тексте главы показана старая версия класса, у которой две проблемы, и в файлеAgent/src/core.pyрепозитория обе уже исправлены.
eval(f"{function_name}(**{function_args})")исполняет как код Python строку, которую сгенерировала модель. Это опасно (через аргументы можно подсунуть любой код) и ненадёжно (JSON-литералыtrue/null— не Python). В репозитории так:args = json.loads(function_args), функция берётся из словаряself.tool_map = {tool.__name__: tool for tool in self.tools}и вызываетсяfunc(**args); результат приводится к строкеstr(...). Принцип наименьших привилегийпринцип наименьших привилегийEN principle of least privilege — в уроке 8.3.2.- Перед сообщениями с ролью
toolв историю нужно положить сообщение ассистента вместе с полемtool_calls(id и аргументы каждого вызова), иначе OpenAI и многие совместимые API вернут ошибку «tool message without preceding tool_calls». В репозитории это сделано.И ещё: здесь ровно один раунд инструментов. Если после результата модель захочет вызвать ещё один инструмент, этот код его не выполнит. Настоящий агентный цикл повторяет «запрос → вызовы → результаты» до ответа без
tool_calls(с лимитом шагов) — см. урок 8.3.1.
Агент работает так:
- Принимает ввод пользователя.
- Вызывает большую модель (например, Qwen) и сообщает ей доступные инструменты и их схемы.
- Если модель решает вызвать инструмент, агент разбирает запрос и выполняет соответствующую функцию Python.
- Агент возвращает модели результат выполнения инструмента.
- Модель по результату инструмента генерирует окончательный ответ.
- Агент возвращает окончательный ответ пользователю.
Процесс вызова инструментов агентом — на рисунке 7.9.
flowchart TB
Q["Запрос (Query)"] --> L1["LLM"]
L1 -- "нужен инструмент: вызов" --> TB["Ящик инструментов:<br/>tool 1, tool 2, …, tool n"]
TB -- "результат инструмента" --> L2["LLM"]
L1 --> L2
L2 --> A["Ответ (Answer)"]
L1 -. "инструмент не нужен" .-> A
Шаг 4. Запускаем агента
Заголовок раздела «Шаг 4. Запускаем агента»Теперь можно создать и запустить агента. В разделе if __name__ == "__main__": файла demo.py есть простой пример
диалога в командной строке.
# demo.py (фрагмент)if __name__ == "__main__":    client = OpenAI(        api_key="YOUR_API_KEY", # замените своим API Key        base_url="https://api.siliconflow.cn/v1",    )
    # Создаём экземпляр Agent: передаём client, имя модели и список функций-инструментов    agent = Agent(        client=client,        model="Qwen/Qwen2.5-32B-Instruct",        tools=[get_current_datetime, add, compare, count_letter_in_string],        verbose=True # True — видно информацию о вызовах инструментов    )
    # Запускаем цикл интерактивного диалога    while True:        # Цветной вывод отделяет ввод пользователя от ответа ИИ        prompt = input("\033[94mUser: \033[0m")  # приглашение пользователя — синим        if prompt.lower() == "exit":            break        response = agent.get_completion(prompt)        print("\033[92mAssistant: \033[0m", response)  # ответ ассистента — зелёным
Пример диалога:
User: ПриветAssistant: Привет! Чем могу помочь?User: Что больше: 9.12 или 9 .2?Вызов инструментов: ['compare']Assistant: 9.2 больше, чем 9.12.User: Почему?Assistant: Сравнивая 9.12 и 9.2, их можно записать как 9.12 и 9.20. Первые цифры после запятой равны, а во втором разряде после запятой у 9.20 стоит 0, а у 9.12 — 2, поэтому при равном первом разряде 9.20 (то есть 9.2) больше 9.12. Значит, 9.2 больше, чем 9.12.User: Сколько букв r в слове strawberry?Вызов инструментов: ['count_letter_in_string']Assistant: В слове "strawberry" 3 буквы 'r'.User: Ты уверен?Вызов инструментов: ['count_letter_in_string']Assistant: Да, уверен. В слове "strawberry" действительно 3 буквы 'r'. Давайте проверим ещё раз: буква 'r' в "strawberry" действительно встречается 3 раза.User: Хорошо ты тонкий, который час?Вызов инструментов: ['get_current_datetime']Assistant: Сейчас 26 апреля 2025 года, 17:01:33. Кстати, я заметил, что вы написали «ты тонкий» — похоже, это опечатка. Если у вас есть другие вопросы или нужна помощь, скажите!User: exitПримечание переводчика. Диалог переведён целиком. Объяснение модели про 9.20 и 9.12 само по себе путаное (вывод верный, рассуждение — нет: сравнивать надо первый же разряд после запятой: 2 > 1), — хороший пример того, почему вычисления лучше отдавать инструменту. В оригинале пользователь хотел написать по-китайски «ты молодец», но опечатался и набрал похожее слово — получилось «ты тонкий», и модель это заметила. Вопросы про 9.11/9.9 и буквы r в strawberry — классические ловушки для LLM: модель видит токены, а не цифры и буквы (см. урок 4.2.1).
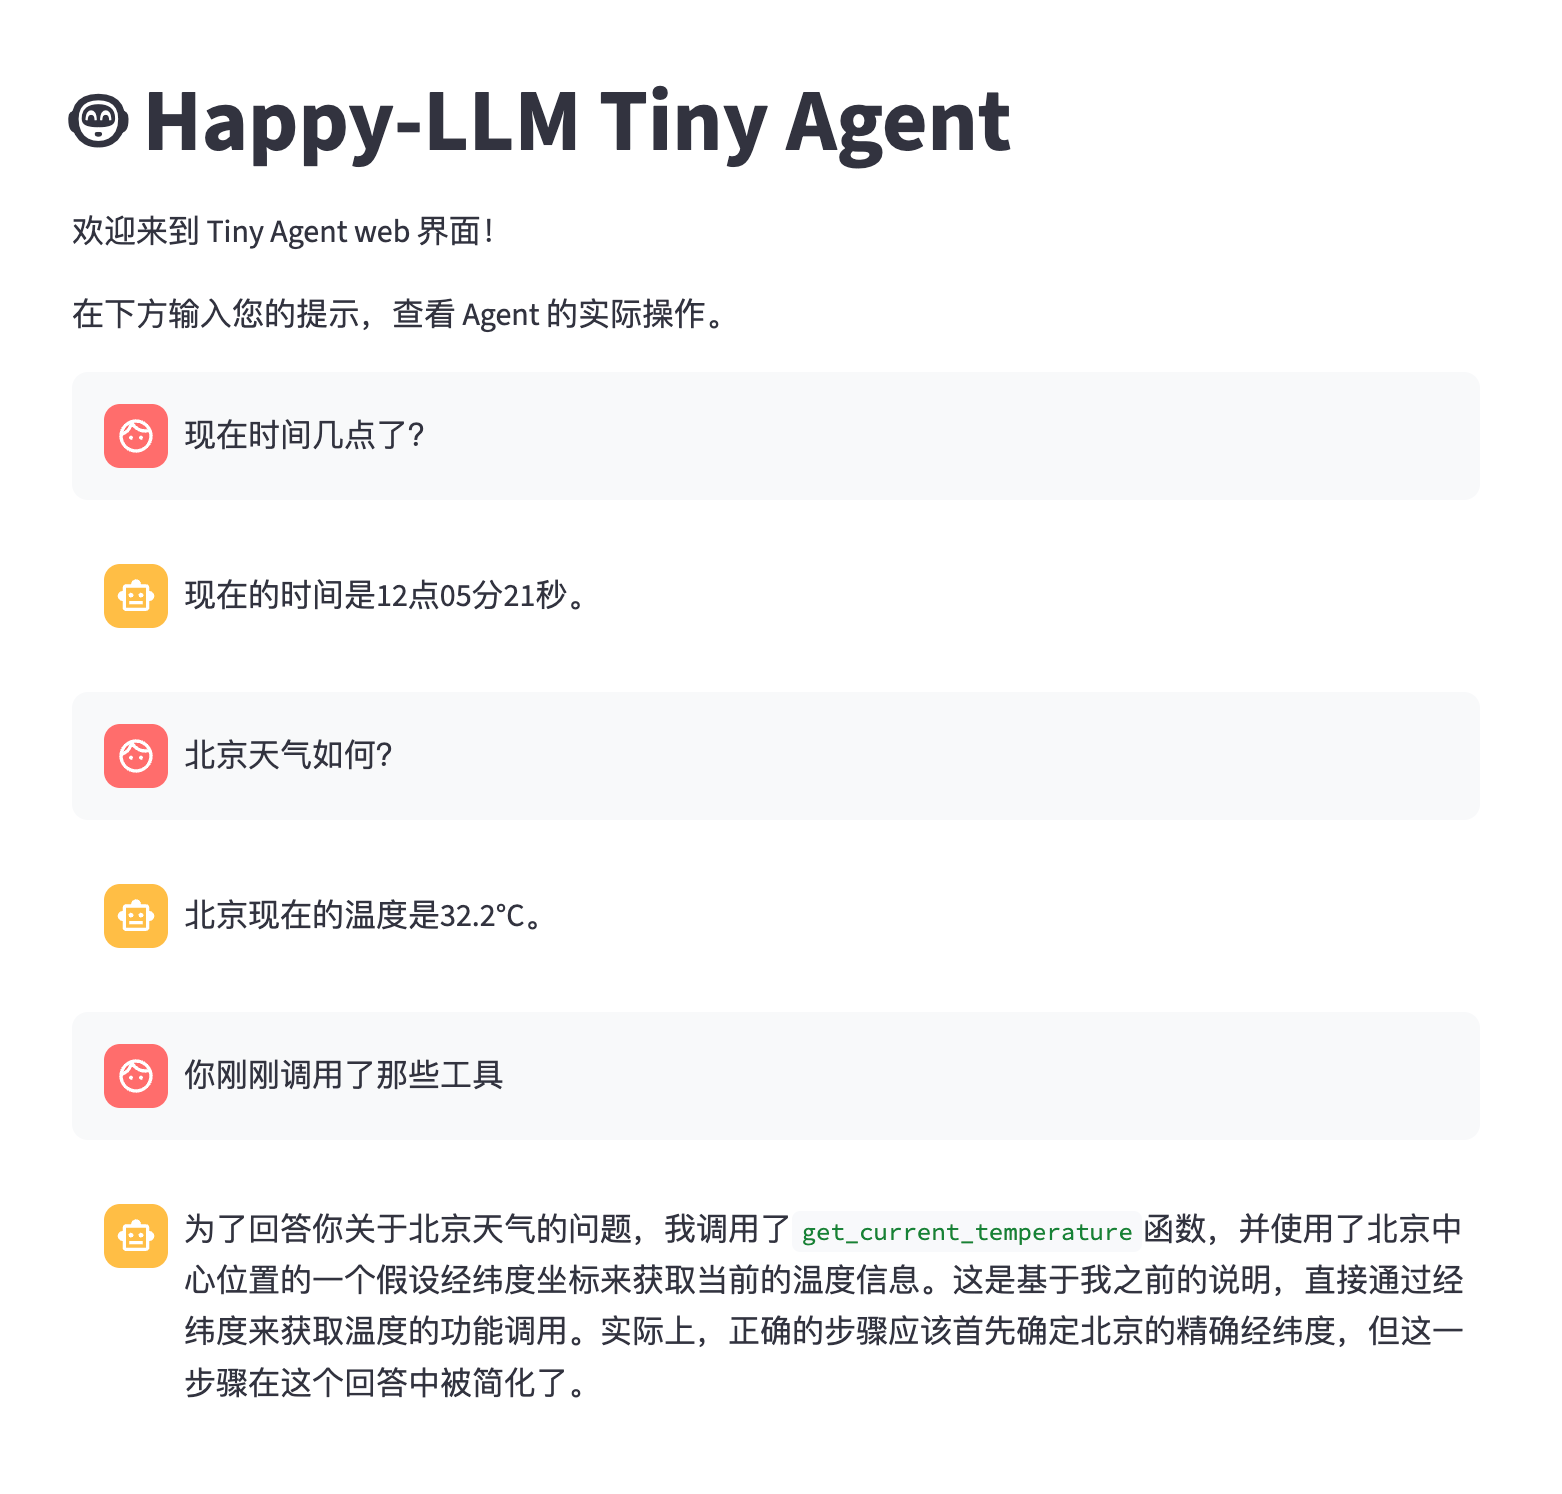
Ещё мы подготовили приложение на Streamlit, которое запускается локально и показывает возможности агента. Запуск —
streamlit run web_demo.py; вот как работает агент.
Рисунок 7.10. Демо на Streamlit: веб-чат, в котором видны вопросы пользователя, вызовы инструментов и ответы агента (изображение в оригинале).
Литература
[1] Hugging Face. (2023). Open LLM Leaderboard: платформа для сравнения открытых больших языковых моделей. https://huggingface.co/spaces/open-llm-leaderboard/open_llm_leaderboard
[2] awacke1. (2023). LMSYS Chatbot Arena Leaderboard: платформа оценки больших языковых моделей на арене. https://huggingface.co/spaces/awacke1/lmsys-chatbot-arena-leaderboard
[3] Команда OpenCompass. (2023). OpenCompass: единая платформа оценки больших моделей. https://rank.opencompass.org.cn/home
[4] Команда финансового рейтинга OpenCompass. (2024). CFBENCHMARK: рейтинг больших моделей в финансовой области. https://specialist.opencompass.org.cn/CFBenchmark
[5] Команда рейтинга безопасности OpenCompass. (2024). Flames: рейтинг безопасности больших моделей. https://flames.opencompass.org.cn/leaderboard
[6] Команда рейтинга общего общения OpenCompass. (2024). BotChat: оценка общих диалоговых способностей больших моделей. https://botchat.opencompass.org.cn/
[7] Команда юридического рейтинга OpenCompass. (2024). LawBench: оценка больших моделей в юридической области. https://lawbench.opencompass.org.cn/leaderboard
[8] Команда медицинского рейтинга OpenCompass. (2024). MedBench: оценка больших моделей в медицинской области. https://medbench.opencompass.org.cn/leaderboard
[9] Zhi Jing, Yongye Su, and Yikun Han. (2024). When Large Language Models Meet Vector Databases: A Survey. arXiv preprint arXiv:2402.01763.
[10] Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Meng Wang, and Haofen Wang. (2024). Retrieval-Augmented Generation for Large Language Models: A Survey. arXiv preprint arXiv:2312.10997.
[11] Zhiruo Wang, Jun Araki, Zhengbao Jiang, Md Rizwan Parvez, and Graham Neubig. (2023). Learning to Filter Context for Retrieval-Augmented Generation. arXiv preprint arXiv:2311.08377.
[12] Ori Ram, Yoav Levine, Itay Dalmedigos, Dor Muhlgay, Amnon Shashua, Kevin Leyton-Brown, and Yoav Shoham. (2023). In-Context Retrieval-Augmented Language Models. arXiv preprint arXiv:2302.00083.
От переводчика: что сделать руками
Заголовок раздела «От переводчика: что сделать руками»- Tiny-RAG на своих документах. Склонируйте репозиторий, перейдите в
docs/chapter7/RAG, создайте.envпо образцу.env_example(ключ и адрес любого OpenAI-совместимого провайдера), положите вdata/пару своих.md-файлов на русском и запуститеdemo.py. Задайте вопрос, ответа на который в документах нет, — модель должна сказать «не знаю». - Посмотрите на нарезку. Распечатайте
len(docs)и два соседних фрагмента: убедитесь, что конец первого повторяется в начале второго (150 символов). - Поменяйте
k. Сравните ответы приk=1иk=3(склейте три фрагмента через"\n\n"). - Агент. В
docs/chapter7/Agentзапуститеdemo.py, затем добавьте свой инструмент — например,convert_currency(amount: float, rate: float)— с понятным docstring и проверьте, что модель его вызывает. - Цикл. Перепишите
get_completionв циклwhile response.choices[0].message.tool_calls:с лимитом 5 шагов и задайте вопрос, требующий двух инструментов подряд («сколько дней до Нового года?»). - Локально вместо API. Поднимите модель через vLLM или Ollama (OpenAI-совместимый сервер, урок 7.2.2)
и укажите его адрес в
base_url— код не изменится.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| evaluation / benchmark | оценка / набор для оценки (бенчмарк) |
| leaderboard | рейтинг (лидерборд) |
| generalization | способность к обобщению |
| robustness | устойчивость |
| hallucination | галлюцинация |
| retrieval-augmented generation, RAG | генерация с дополнением найденным |
| chunking | нарезка документов |
| embedding | векторизация / эмбеддинг |
| cosine similarity | косинусное сходство |
| vector database | векторная база данных |
| persistence | сохранение на диск |
| prompt template | шаблон промпта |
| agent | агент |
| planning / memory / tool use | планирование / память / использование инструментов |
| reflection | рефлексия |
| multi-agent system | многоагентная система |
| tool calling | вызов инструментов |