How To Scale Your Model, главы 5–6: как параллелить обучение трансформера
Перевод пятой главы книги Google DeepMind о параллелизме при обучении — параллелизм данных, FSDP (ZeRO), тензорный параллелизм, их сочетание, конвейер, масштабирование между подами, критические размеры батча — и краткое изложение шестой главы с расчётом обучения LLaMA 3-70B.
Здесь мы обсудим четыре главные схемы параллелизма, используемые при обучении LLM: параллелизм данных, полностью шардированный параллелизм данных (FSDP), тензорный параллелизм и конвейерный параллелизм. Для каждой мы посчитаем, в какой момент связь становится узким местом. — подзаголовок главы 5.
Что мы понимаем под масштабированием?
Заголовок раздела «Что мы понимаем под масштабированием?»Цель «масштабирования модели» — иметь возможность увеличивать число чипов для обучения или инференса и получать при этом пропорциональный, линейный рост пропускной способности (это мы называем сильным масштабированием, strong scaling). Производительность одного чипа зависит от компромисса между пропускной способностью памяти и FLOPs, а производительность на уровне кластера — от того, удаётся ли скрыть связь между чипами, совмещая её с полезными FLOPs. Это нетривиально: с ростом числа чипов растёт нагрузка на связь, а объём вычислений на устройство, которым её можно скрыть, уменьшается. Как мы видели в главе 3, умножения шардированных матриц часто требуют дорогих AllGather или ReduceScatter, которые могут мешать TPU делать полезную работу. Цель этой главы — выяснить, когда они становятся слишком дорогими.
В этой главе мы обсудим четыре распространённые схемы параллелизма: (чистый) параллелизм данных, полностью шардированный параллелизм данных (FSDP / шардирование ZeRO), тензорный параллелизм (его ещё называют параллелизмом модели) и (кратко) конвейерный параллелизм. Для каждой покажем, какую стоимость связи она требует и с какого момента эта стоимость становится узким местом для вычислений1. В этой главе можно думать только о стоимости связи между чипами: при достаточно большом батче на чип передача данных из HBM в MXU уже совмещена с вычислениями.
Для простоты расчётов используем такие обозначения.
| Обозначение | Смысл (параметры модели) |
|---|---|
| D | dmodel (скрытая размерность, размерность остаточного потока) |
| F | dff (размерность прямого слоя) |
| B | измерение батча (число токенов в батче; общее, а не на устройство) |
| T | длина последовательности |
| L | число слоёв модели |
| Обозначение | Смысл (характеристики железа) |
|---|---|
| C | FLOPs/s на чип |
| W | пропускная способность сети (двусторонняя, часто с индексом, например или ) |
| X | число чипов вдоль оси сетки X |
| Y | число чипов вдоль другой оси сетки, Y |
| Z | число чипов вдоль третьей оси сетки, Z |
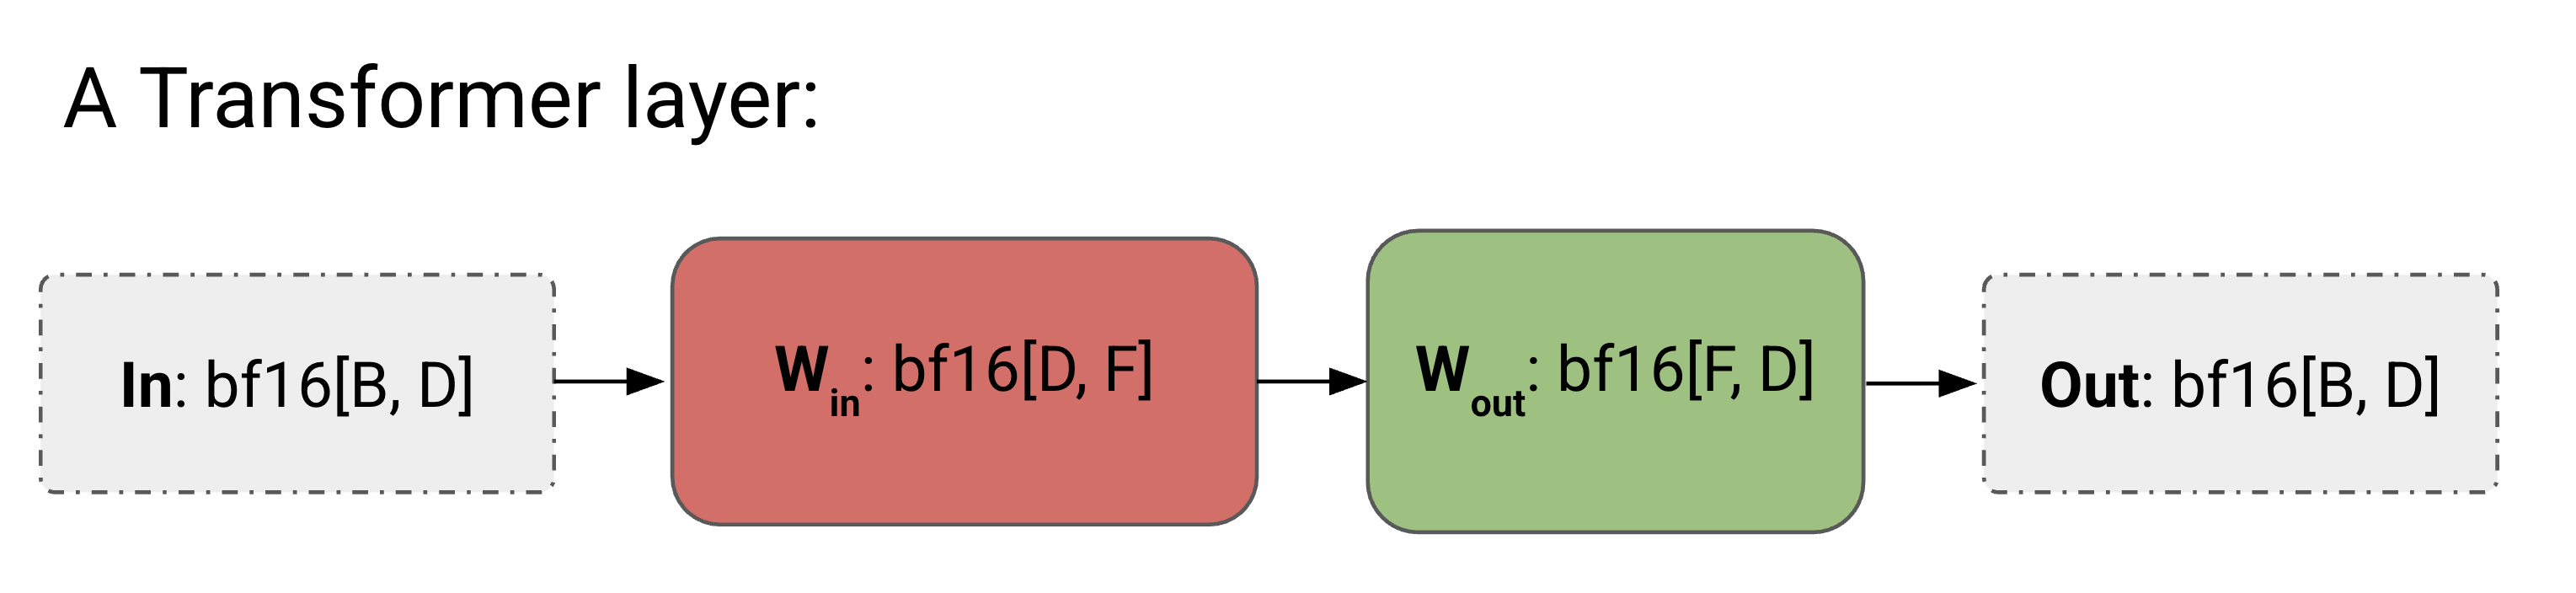
Для простоты будем приближать трансформер стопкой блоков MLP: как мы видели в главе 4, у больших моделей внимание — сравнительно малая доля FLOPs. Гейтовое умножение тоже опустим, и у каждого слоя останется простая структура.
Рисунок в оригинале (transformer-layer.png):
упрощённый слой трансформера. Каждый блок FFW — стопка из двух матриц: Win: bf16[D, F] (повышающая
проекция) и Wout: bf16[F, D] (понижающая проекция), вход — In: bf16[B, D].
Полный алгоритм нашего маленького трансформера без параллелизма
Прямой проход: нужно вычислить Loss[B]
- Tmp[B, F] = In[B, D] *D Win[D, F]
- Out[B, D] = Tmp[B, F] *F Wout[F, D]
- Loss[B] = …
Обратный проход: нужно вычислить dWout[F, D], dWin[D, F]
- dOut[B, D] = …
- dWout[F, D] = Tmp[B, F] *B dOut[B, D]
- dTmp[B, F] = dOut[B, D] *D Wout[F, D]
- dWin[D, F] = In[B, D] *B dTmp[B, F]
- dIn[B, D] = dTmp[B, F] *F Win[D, F] (нужно для предыдущих слоёв)
Он приведён для сравнения с алгоритмами, где добавлена связь.
Вот 4 схемы параллелизма, которые мы обсудим. Каждую можно считать однозначно заданной шардированием In, Win, Wout и Out на схеме выше.
1. Параллелизм данных: активации шардированы по батчу, параметры и состояние оптимизатора реплицированы на каждом устройстве. Связь возникает только в обратном проходе.
2. Полностью шардированный параллелизм данных (FSDP, или ZeRO-3): активации шардированы по батчу (как в чистом параллелизме данных), параметры шардированы по той же оси сетки и собираются AllGather «точно к сроку» перед использованием в прямом проходе. Состояние оптимизатора тоже шардировано по батчу. Сокращает дублирование памяти.
3. Тензорный параллелизм (его ещё называют шардированием Megatron или параллелизмом модели): активации шардированы по D (), параметры — по F (). Активации собираются AllGather перед каждым блоком и разбрасываются ReduceScatter после. Совместим с FSDP.
4. Конвейерный параллелизм: веса шардированы по измерению слоёв, активации разбиты на микробатчи и «прокатываются» вдоль измерения слоёв. Связь между стадиями конвейера минимальна (активации просто передаются на один переход). Вольно обращаясь с нотацией:
flowchart LR
DP["DP: батч шардирован, веса копиями"] --> FSDP["FSDP: + веса и оптимизатор шардированы"]
FSDP --> MIX["FSDP + TP: веса шардированы по двум осям"]
TP["TP: активации по D, веса по F"] --> MIX
MIX --> PP["+ PP: слои по стадиям"]
Параллелизм данных
Заголовок раздела «Параллелизм данных»Запись:
Когда модель помещается на один чип даже с крошечным батчем (больше 240 токенов, чтобы упираться в вычисления), всегда стоит использовать простой параллелизм данных. Чистый параллелизм данных делит активации между любым числом TPU, пока TPU меньше, чем размер батча. В прямом проходе связи нет, но в конце каждого шага каждый TPU выполняет AllReduce своих локальных градиентов, чтобы синхронизировать их перед обновлением параметров.
Рисунок в оригинале (data-parallelism.png): чистый параллелизм данных (прямой проход). Активации (слева) полностью шардированы по батчу, а веса полностью реплицированы, так что у каждого TPU одинаковая копия весов. Значит, общая память весов растёт в N раз, но в прямом проходе связь не нужна.
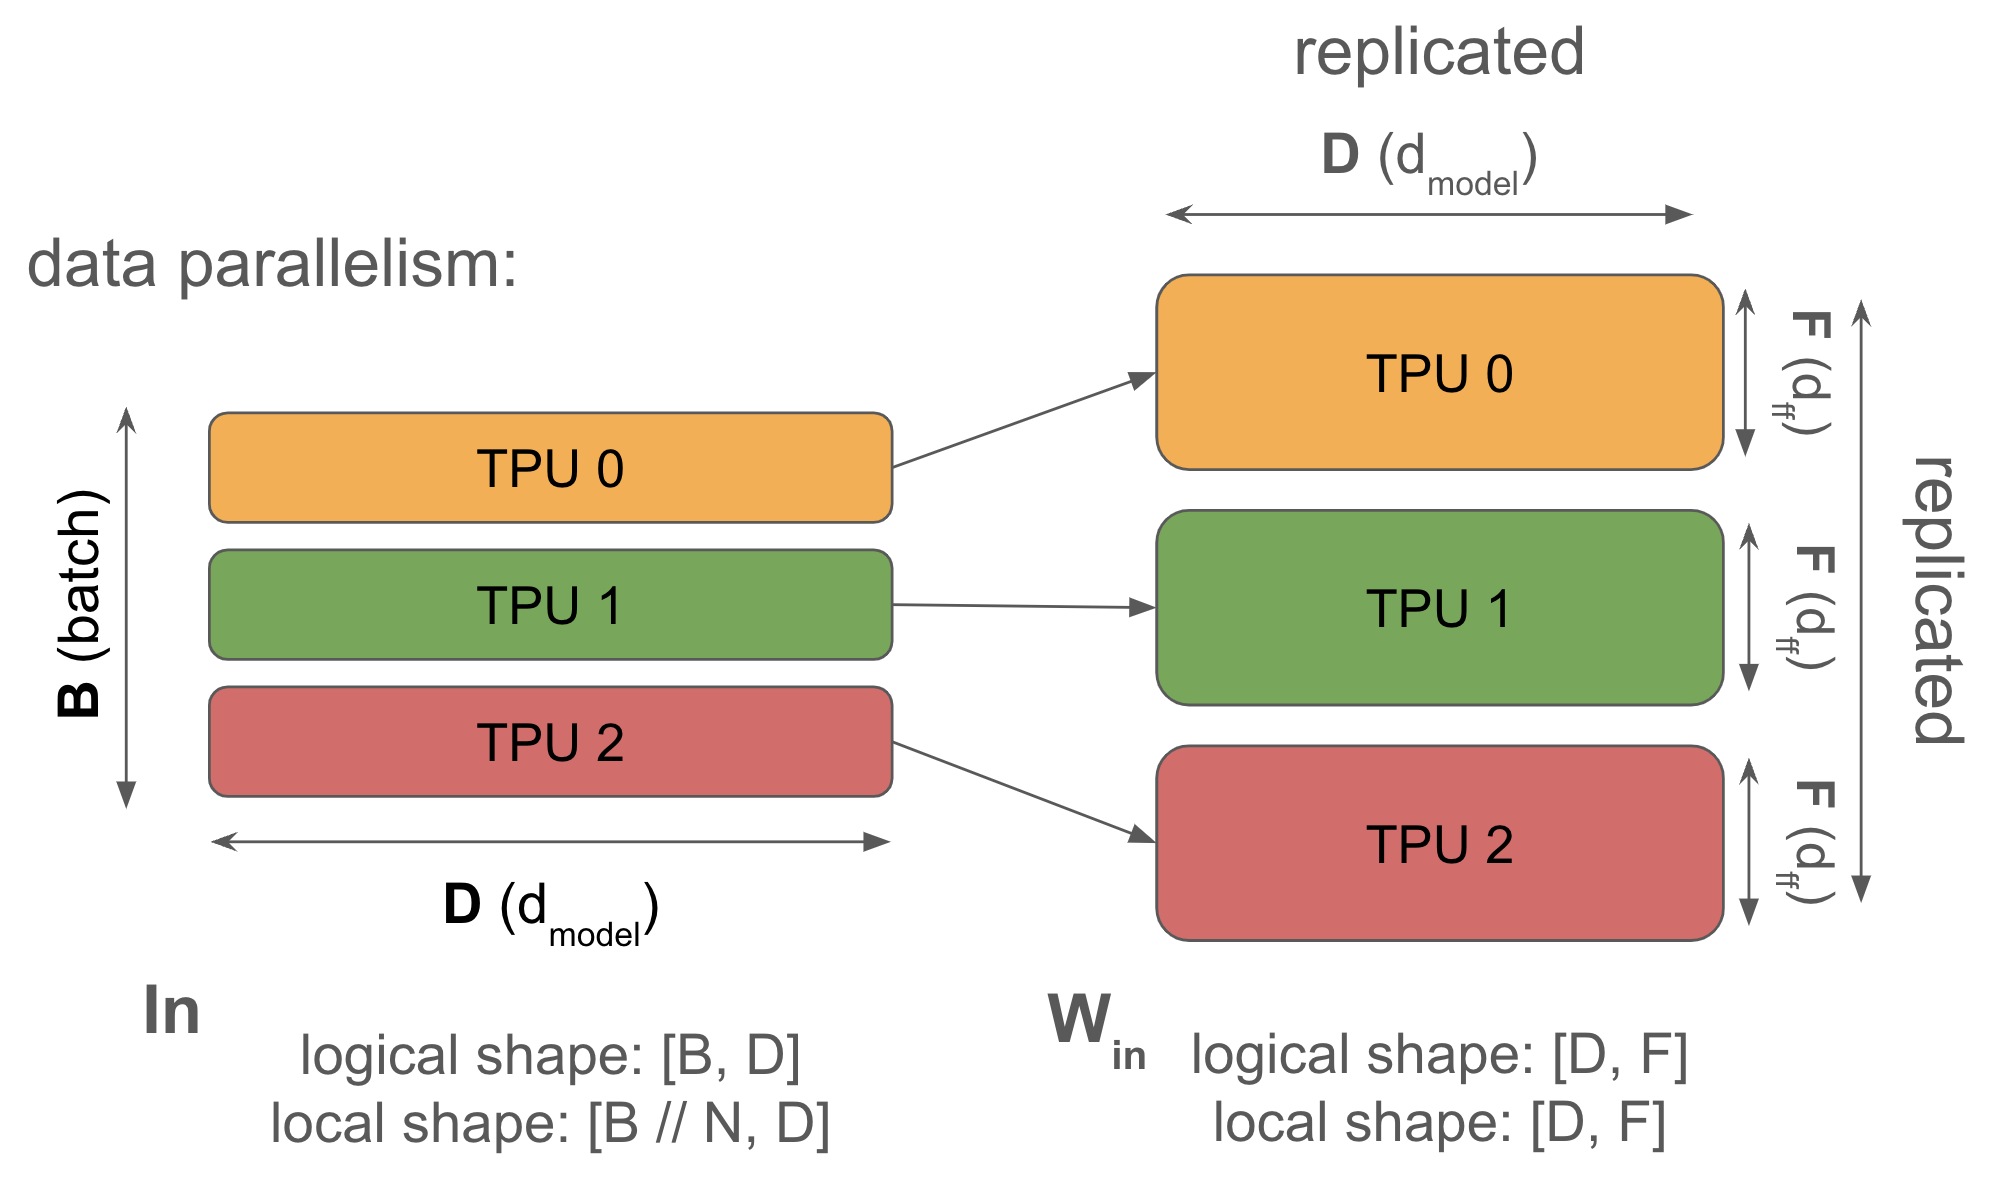
Полный алгоритм прямого и обратного прохода (для краткости dL/dOut пишем как dOut)
Алгоритм чистого параллелизма данных.
Прямой проход: нужно вычислить Loss[BX]
- Tmp[BX, F] = In[BX, D] *D Win[D, F]
- Out[BX, D] = Tmp[BX, F] *F Wout[F, D]
- Loss[BX] = …
Обратный проход: нужно вычислить dWout[F, D], dWin[D, F]
- dOut[BX, D] = …
- dWout[F, D] {UX} = Tmp[BX, F] *B dOut[BX, D]
- dWout[F, D] = AllReduce(dWout[F, D] {UX}) (не на критическом пути, можно асинхронно)
- dTmp[BX, F] = dOut[BX, D] *D Wout[F, D]
- dWin[D, F] {UX} = In[BX, D] *B dTmp[BX, F]
- dWin[D, F] = AllReduce(dWin[D, F] {UX}) (не на критическом пути, можно асинхронно)
- dIn[BX, D] = dTmp[BX, F] *F Win[D, F] (нужно для предыдущих слоёв)
Детали функции потерь опущены, и . Заметьте: хотя итоговые потери — среднее AllReduce(Loss[BX]), AllReduce нужен только в обратном проходе — при усреднении градиентов весов.
Заметьте: в прямом проходе связи нет — вся она в обратном проходе! У обратного прохода есть ещё отличное свойство: AllReduce не лежат на «критическом пути», то есть каждый AllReduce можно выполнить, когда удобно, и он не блокирует следующие операции. Общая стоимость связи всё равно может стать узким местом, если превысит общую стоимость вычислений, но с точки зрения реализации это гораздо снисходительнее. Мы увидим, что у тензорного параллелизма этого свойства нет.
Зачем это нужно? Чистый параллелизм данных снижает давление на память активаций, деля активации по батчу, и позволяет почти сколь угодно увеличивать батч, пока есть ещё чипы, по которым его можно разделить. Особенно при обучении, когда активации часто доминируют в расходе памяти, это очень полезно.
Почему бы так не делать? Чистый параллелизм данных никак не снижает давление на память со стороны параметров модели и состояния оптимизатора, поэтому для интересных моделей большого масштаба, где параметры + состояние оптимизатора не помещаются в один TPU, он редко полезен. Для масштаба: если обучать с параметрами в bf16 и состоянием оптимизатора Adam в fp322, самая большая модель, которая поместится, имеет параметров, например на чипе TPUv5p с 96 ГБ HBM при чистом параллелизме данных — около 9 млрд параметров.
Чтобы сделать это полезным для настоящих моделей при обучении, нужно хотя бы частично шардировать параметры модели или оптимизатор.
Когда мы упираемся в связь? Как видно выше, на слой приходится два AllReduce размером каждый (для весов в bf16). Когда параллелизм данных упирается в связь?
Как в таблице выше, пусть — FLOPs на чип, — двусторонняя пропускная способность сети, а — число шардов, на которые разбит батч4. Посчитаем время на нужные умножения, , и время связи, . В прямом проходе эта схема связи не требует, так что считаем только обратный проход.
Время связи. Из прошлой главы мы знаем, что время AllReduce на одномерной сетке зависит только от общего числа байт массива и пропускной способности ICI , а именно — . AllReduce нужен и для , и для , то есть 2 AllReduce на слой. Каждый — для матрицы весов из параметров, или байт. Итого время AllReduce на один слой —
Время умножений. В каждом слое два умножения в прямом проходе или четыре в обратном, каждое требует FLOPs. Значит, для одного слоя в обратном проходе
Поскольку мы их совмещаем, общее время на слой — максимум из двух величин:
Мы упираемся в вычисления, когда , то есть когда
Вывод: чтобы при параллелизме данных упираться в вычисления, батч на устройство должен превышать операционную интенсивность ICI, . В конечном счёте это следствие того, что время вычислений растёт с батчем на устройство, а время связи от него не зависит (передаются веса модели). Заметьте сходство условия с правилом для одного устройства: и там правило возникло потому, что время вычислений росло с размером батча, а объём передаваемых данных (при ) от него не зависел.
Подставим реальные числа, чтобы почувствовать масштаб. Для TPUv5p C=4.6e14 и W=2 * 9e10 при одномерном параллелизме
данных по ICI, так что батч на чип должен быть не меньше 2550, чтобы не упираться в связь. Параллелизм данных можно
вести по нескольким осям; если отдать все три оси пода TPUv5p чистому параллелизму данных, пропускная способность
утроится, и можно опуститься до батча 850 на TPU, или 7,6 млн токенов на батч на под (из 8960 чипов)!
Значит, упереться в связь при чистом параллелизме данных довольно трудно!
О нескольких осях сетки. Коротко отметим, как несколько осей влияют на доступную пропускную способность. Когда для данной стратегии параллелизма используется несколько осей сетки, пропускная способность растёт.
- Определение: (, и т. д.) — число аппаратных осей сетки, которые охватывает данная стратегия параллелизма.
- Эффект (в режиме, ограниченном пропускной способностью): осей дают примерно в раз большую суммарную пропускную способность каналов, так что время коллективной операции пропорционально .
Полностью шардированный параллелизм данных (FSDP)
Заголовок раздела «Полностью шардированный параллелизм данных (FSDP)»Запись:
Полностью шардированный параллелизм данных (его часто называют FSDP или шардированием ZeRO) делит состояние оптимизатора и веса модели между шардами параллелизма данных и эффективно собирает и разбрасывает их по мере надобности. По сравнению с чистым параллелизмом данных FSDP резко сокращает расход памяти на устройство и экономит FLOPs обратного прохода при совсем небольших накладных расходах.
Рисунок в оригинале (fsdp.png): FSDP шардирует сворачиваемое измерение Win и выходное измерение Wout по измерению данных. Это экономит память, но (см. главу 3) требует собрать веса W перед умножением. Заметьте: активации (слева) не шардированы по сворачиваемому измерению — именно это и вынуждает собирать. Состояние оптимизатора весов тоже шардировано по сворачиваемому измерению.
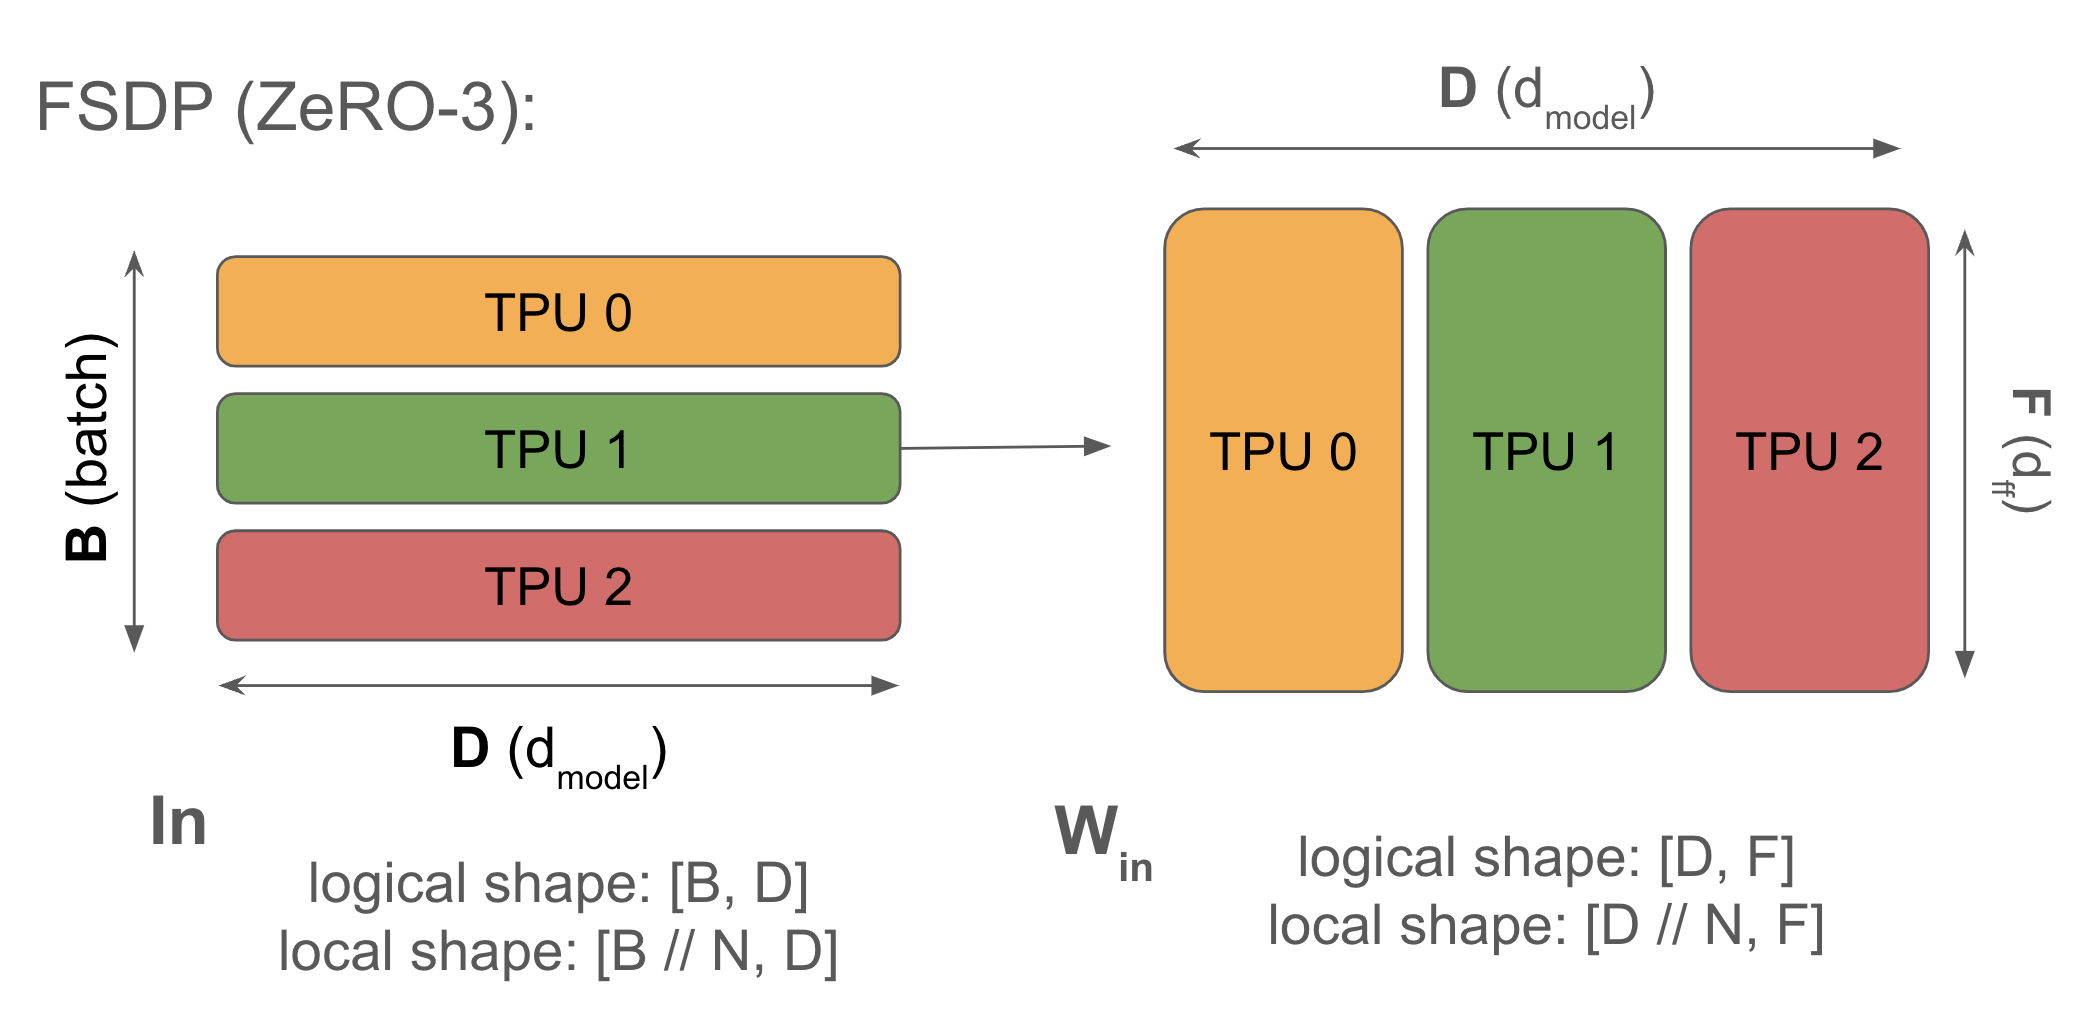
Вспомните (из главы 3): AllReduce раскладывается на AllGather и ReduceScatter. Значит, вместо полного AllReduce градиентов, как в обычном параллелизме данных, можно шардировать веса и состояние оптимизатора между чипами, собирать их AllGather на каждом слое в прямом проходе и разбрасывать ReduceScatter по весам в обратном — без дополнительных затрат.
Полный алгоритм FSDP
Прямой проход: нужно вычислить Loss[BX]
- Win[D, F] = AllGather(Win[DX, F]) (не на критическом пути, можно во время предыдущего слоя)
- Tmp[BX, F] = In[BX, D] *D Win[D, F] (теперь Win[D, F] можно выбросить)
- Wout[F, D] = AllGather(Wout[F, DX]) (не на критическом пути, можно во время предыдущего слоя)
- Out[BX, D] = Tmp[BX, F] *F Wout[F, D]
- Loss[BX] = …
Обратный проход: нужно вычислить dWout[F, DX], dWin[DX, F]
- dOut[BX, D] = …
- dWout[F, D] {UX} = Tmp[BX, F] *B dOut[BX, D]
- dWout[F, DX] = ReduceScatter(dWout[F, D] {UX}) (не на критическом пути, можно асинхронно)
- Wout[F, D] = AllGather(Wout[F, DX]) (можно заранее)
- dTmp[BX, F] = dOut[BX, D] *D Wout[F, D] (здесь Wout[F, D] можно выбросить)
- dWin[D,F] {UX} = In[BX, D] *B dTmp[BX, F]
- dWin[DX, F] = ReduceScatter(dWin[D, F] {UX}) (не на критическом пути, можно асинхронно)
- Win[D, F] = AllGather(Win[DX, F]) (можно заранее)
- dIn[BX, D] = dTmp[BX, F] *F Win[D, F] (нужно для предыдущих слоёв; здесь Win[D, F] можно выбросить)
Это называют ещё «шардированием ZeRO» — от «Zero Redundancy Optimizer» («оптимизатор без избыточности»), поскольку мы не выполняем лишних вычислений и не храним лишнего состояния. ZeRO-1, ZeRO-2 и ZeRO-3 обозначают шардирование таким способом соответственно состояния оптимизатора, градиентов и весов. Стоимость связи у всех одинакова5, так что практически всегда можно делать шардирование ZeRO-3, которое делит между устройствами параметры, градиенты и состояние оптимизатора.
Зачем это нужно? Обычный параллелизм данных выполняет много дублирующейся работы. Каждый TPU делает AllReduce полного градиента, затем обновляет полное состояние оптимизатора (одинаковая работа на всех TPU), затем обновляет параметры (снова полное дублирование). При шардировании ZeRO (шардирование градиентов и состояния оптимизатора) вместо AllReduce можно сделать ReduceScatter градиентов, обновить только свой шард состояния оптимизатора, обновить шард параметров, а затем собрать параметры AllGather, когда они понадобятся в прямом проходе.
Когда мы упираемся в связь? Соотношение FLOPs и связи в точности то же, что у чистого параллелизма данных: каждый AllReduce обратного прохода превратился в AllGather + ReduceScatter. Вспомните: AllReduce реализуется как AllGather и ReduceScatter, каждый — с половиной стоимости. Здесь моделируем прямой проход, поскольку отношение FLOPs к связи у него то же, что у обратного:
Поэтому, как и при чистом параллелизме данных, мы упираемся в вычисления, когда , то есть когда
батч на устройство превышает «операционную интенсивность ICI» (4.59e14 / 1.8e11 = 2550 у v5p).
Для нас это отличная новость: если батч на устройство достаточно велик, чтобы чистый параллелизм данных упирался
в вычисления, можно — не боясь выйти из режима упора в вычисления — просто перейти на FSDP и сэкономить огромный объём
памяти на параметрах и состоянии оптимизатора! Хотя в прямой проход пришлось добавить связь, эта стоимость несущественна:
она просто перекрывается FLOPs прямого прохода.
Например, DeepSeek-V2 (одна из немногих сильных недавних моделей, раскрывших размер батча при обучении) использовала батч около 40 млн токенов. Это позволило бы масштабироваться примерно до 47 000 чипов, или около 5 подов TPUv5, прежде чем упереться в пропускную способность.
Для LLaMA-3 70B, на обучение которой ушло примерно 6.3e24 (15e12 * 70e9 * 6) FLOPs, можно разделить батч в 16 млн токенов
примерно на 16e6 / (2550 / 3) = 18,823 чипа (примерно 2 пода по 8960 чипов), каждый с 4.59e14 FLOPs при 50% использования
пиковых FLOPs (это часто называют MFU), и обучить её примерно за 17 дней. Неплохо! Но посмотрим, как сделать лучше.
Тензорный параллелизм
Заголовок раздела «Тензорный параллелизм»Запись: (мы используем , чтобы потом сочетать с FSDP)
При AllReduce полностью шардированного параллелизма данных мы перемещаем между чипами веса. Можно также шардировать измерение прямого слоя модели и перемещать во время слоя активации — это называют «одномерным параллелизмом модели» или шардированием Megatron. Это позволяет уменьшить эффективный размер батча на под.
Рисунок в оригинале (model-parallelism.png): пример базового тензорного параллелизма. Активации шардированы только по Y (в отличие от FSDP, где шардируем по X), поэтому по X они реплицированы. В нашей стандартной записи: A[B, DY] * B[D, FY] → C[B, FY]. Поскольку шардировано только одно из сворачиваемых измерений, обычно перед умножением активации A собирают AllGather.
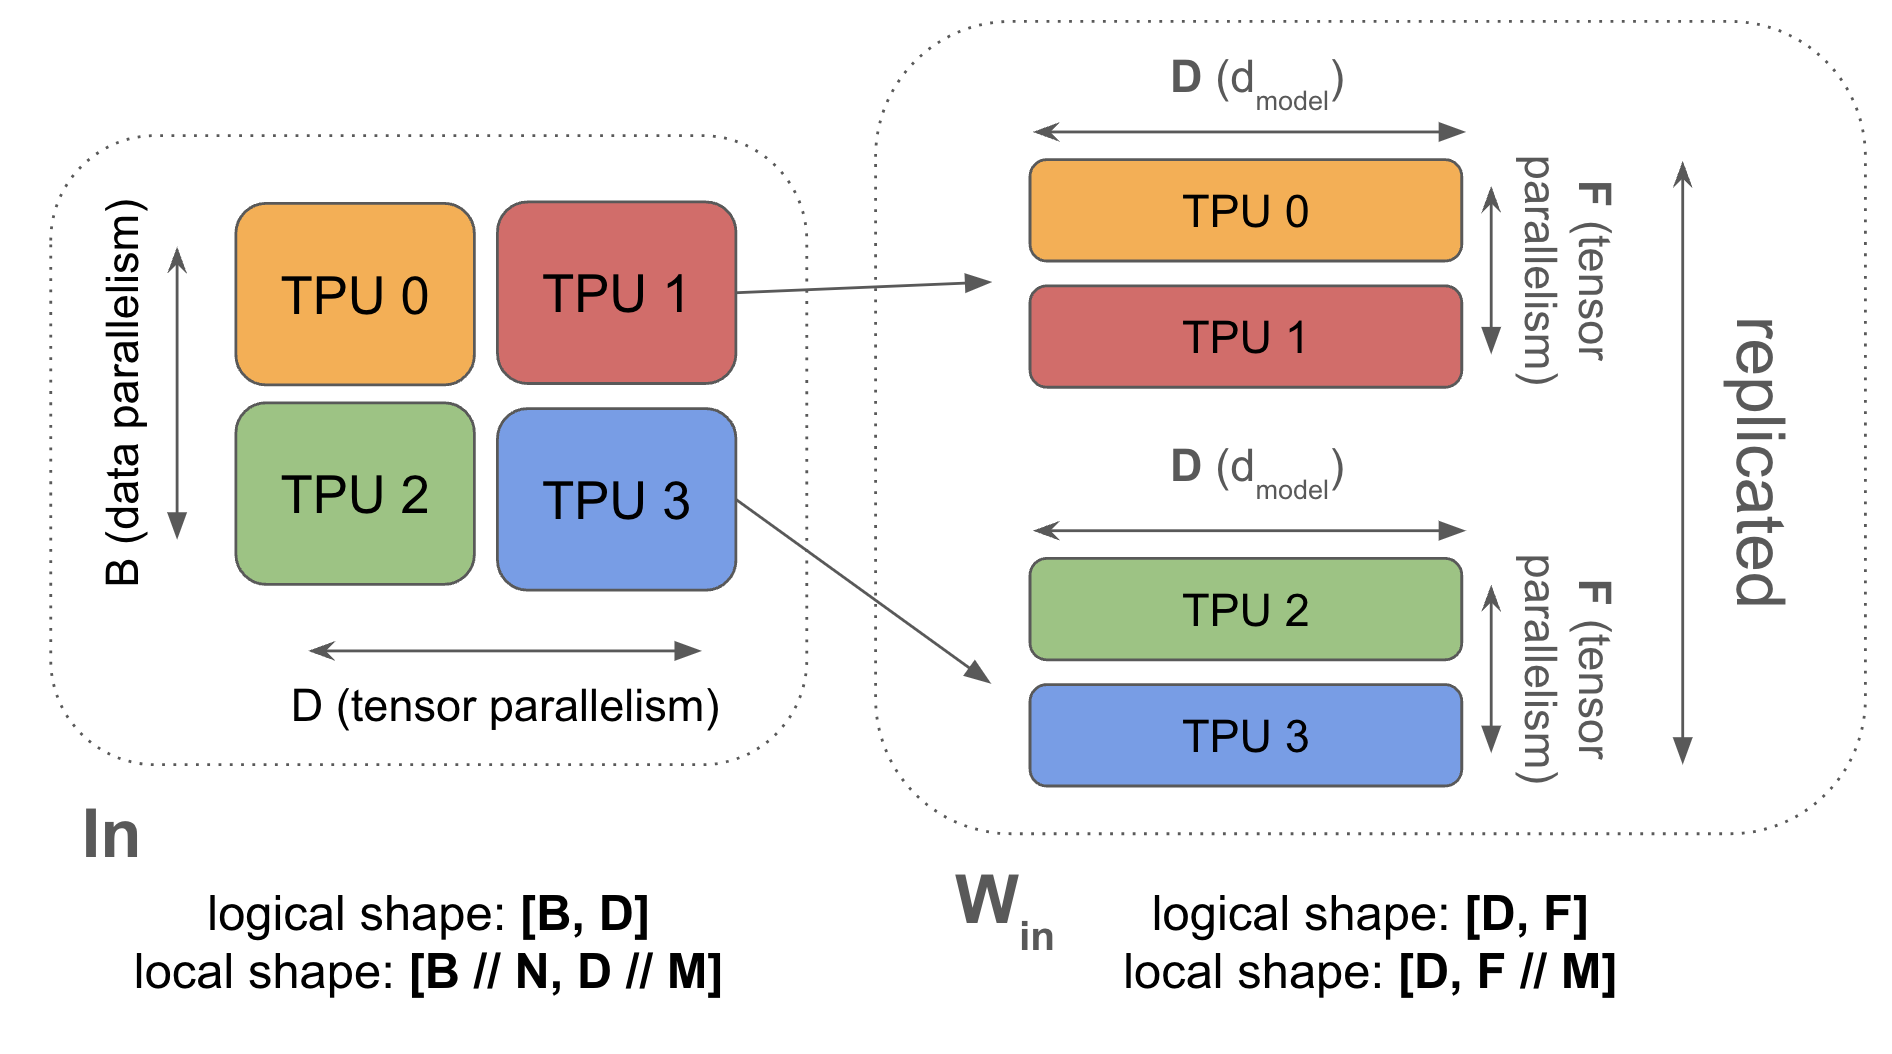
Как отмечено, In[B, DY] *D Win[D, FY] *F Wout[FY, D] → Out[B, DY] означает, что перед первым умножением нужно собрать активации. Это дешевле шардирования ZeRO, когда активации меньше весов. Обычно так бывает лишь при добавлении какой-то доли шардирования ZeRO (оно уменьшает размер сбора). Это одна из причин, почему ZeRO и тензорный параллелизм обычно смешивают.
Алгоритм тензорного параллелизма
Прямой проход: нужно вычислить Loss[B]
- In[B, D] = AllGather(In[B, DY]) (на критическом пути)
- Tmp[B, FY] = In[B, D] *D Win[D, FY] (сворачиваемое не шардировано — связи нет)
- Out[B, D] {UY} = Tmp[B, FY] *F Wout[FY, D]
- Out[B, DY] = ReduceScatter(Out[B, D] {UY}) (на критическом пути)
- Loss[B] = …
Обратный проход: нужно вычислить dWout[FY, D], dWin[D, FY]
- dOut[B, DY] = …
- dOut[B, D] = AllGather(dOut[B, DY]) (на критическом пути)
- dWout[FY, D] = Tmp[B, FY] *B dOut[B, D]
- dTmp[B, FY] = dOut[B, D] *D Wout[FY, D] (здесь dOut[B, D] можно выбросить)
- In[B, D] = AllGather(In[B, DY]) (можно пропустить, переиспользовав шаг 1 прямого прохода)
- dWin[D, FY] = In[B, D] *B dTmp[B, FY]
- dIn[B, D] {UY} = dTmp[B, FY] *F Win[D, FY] (нужно для предыдущих слоёв)
- dIn[B, DY] = ReduceScatter(dIn[B, D] {UY}) (на критическом пути)
Приятная особенность тензорного параллелизма — он хорошо сочетается с двумя матрицами прямого прохода трансформера. Наивно мы делали бы AllReduce после каждой из двух матриц. Но здесь мы сначала делаем In[B, DY] * Win[D, FY] → Tmp[B, FY], а затем Tmp[B, FY] * Wout[FY, D] → Out[B, DY]. То есть в начале делаем AllGather In, а в конце — ReduceScatter Out, вместо AllReduce.
Сколько это стоит? Смоделируем только прямой проход — обратный просто транспонирует каждую операцию. В одномерном тензорном параллелизме мы собираем активации AllGather перед первым умножением и разбрасываем ReduceScatter после второго, отправляя по два байта (bf16). Найдём, когда связь становится узким местом.
Мы хотим, чтобы стоимость вычислений была больше стоимости связи:
Например, для TPUv5p в bf16, так что тензорный параллелизм возможен только до . При нескольких осях ICI уменьшается в раз, и получаем .
Заметьте: это не зависит от точности вычислений, поскольку, например, для int8 на TPUv5p равно 5100, а не 2550, но и объём связи вдвое меньше, так что двойки сокращаются.
Несколько примеров:
- На TPUv5p с LLaMA 3-70B (, ) можно спокойно делать 8-путевой тензорный параллелизм, но 16-путевой упрётся в связь. Для 8-путевого шардирования модели нужно F не меньше 20 тысяч.
- У Gemma 7B тысяч, так что в связь упрёмся при 19-путевом тензорном параллелизме. Значит, 16-путевой, скорее всего, ещё будет работать хорошо.
Сочетание FSDP и тензорного параллелизма
Заголовок раздела «Сочетание FSDP и тензорного параллелизма»Запись:
FSDP и тензорный параллелизм хороши тем, что их можно сочетать. Шардируя Win и Wout по обеим осям, мы экономим и память, и вычисления. Поскольку B шардировано по X, уменьшаются AllGather параллелизма модели, а поскольку F шардировано по Y, уменьшаются накладные расходы связи FSDP. Значит, сочетание позволяет опуститься к ещё меньшему эффективному размеру батча, чем выше.
Рисунок в оригинале (mixed-fsdp-model-parallelism.png): сочетание FSDP и тензорного параллелизма. В отличие от других случаев, параметры модели нигде не дублируются. (Полный алгоритм из 12 шагов в оригинале — это объединение двух алгоритмов выше: AllGatherY активаций и ReduceScatterY выходов на критическом пути, AllGatherX весов и ReduceScatterX градиентов весов вне его. Связи много, но все AllGather и ReduceScatter меньше, потому что активации шардированы по батчу, а веса — тензорно.)

Какое сочетание FSDP и TP правильное? Простая, но ключевая максима: FSDP перемещает веса, а тензорный параллелизм перемещает активации. Значит, по мере уменьшения батча (особенно при большем параллелизме данных) тензорный параллелизм дешевеет, ведь активации на шард становятся меньше.
- Тензорный параллелизм выполняет , который уменьшается с ростом .
- FSDP выполняет , который уменьшается с ростом .
Так что, сочетая оба, можно ещё сильнее опустить минимальный батч на реплику. Оптимальные доли FSDP и TP можно посчитать так же, как выше.
Пусть — число чипов, отданных FSDP, — тензорному параллелизму, — общее число чипов в срезе, а и — число осей сетки, по которым идут FSDP и TP (в сумме примерно 3). Будем моделировать только прямой проход, у которого больше всего связи на FLOP. Складывая связь в алгоритме, получаем
А общее время FLOPs —
Для простоты сделаем два допущения: во-первых, разрешим и быть нецелыми (лишь бы положительными и ); во-вторых, будем считать, что связь по осям и полностью перекрывается между собой. При втором допущении общее время связи —
Прежде чем спрашивать, когда мы упираемся в вычисления, найдём и , минимизирующие общую связь. FLOPs от и не зависят, так что оптимальны значения, просто минимизирующие связь. Запишем через и (последнее фиксировано — это число чипов в системе):
монотонно растёт с , а монотонно убывает, так что максимум минимален при их равенстве, то есть при
Это очень полезно! Формула говорит, какая доля FSDP оптимальна при данных , и . Почувствуем масштаб: подставив реалистичные значения (массив чипов 4×4×4), , , получаем примерно . Так что мы взяли бы = 16 и = 4 — близко к рассчитанному оптимуму.
Вернёмся к вопросу, который мы задавали всем стратегиям: когда мы упираемся в вычисления? Поскольку FLOPs и связь совмещаются, мы упираемся в вычисления, когда
Обозначив (арифметическую интенсивность ICI), упрощаем:
Мы выбрали так, чтобы обе части максимума были равны, так что можно подставить его в любую (учитывая ). Упрощая, получаем
где левая часть пропорциональна времени связи, а правая — времени вычислений. Заметьте: время вычислений растёт с батчем линейно (как и при любом параллелизме), а время связи — как квадратный корень из батча. Значит, и отношение времени вычислений к времени связи растёт как корень из батча:
Чтобы это отношение было больше единицы и мы упирались в вычисления, нужно
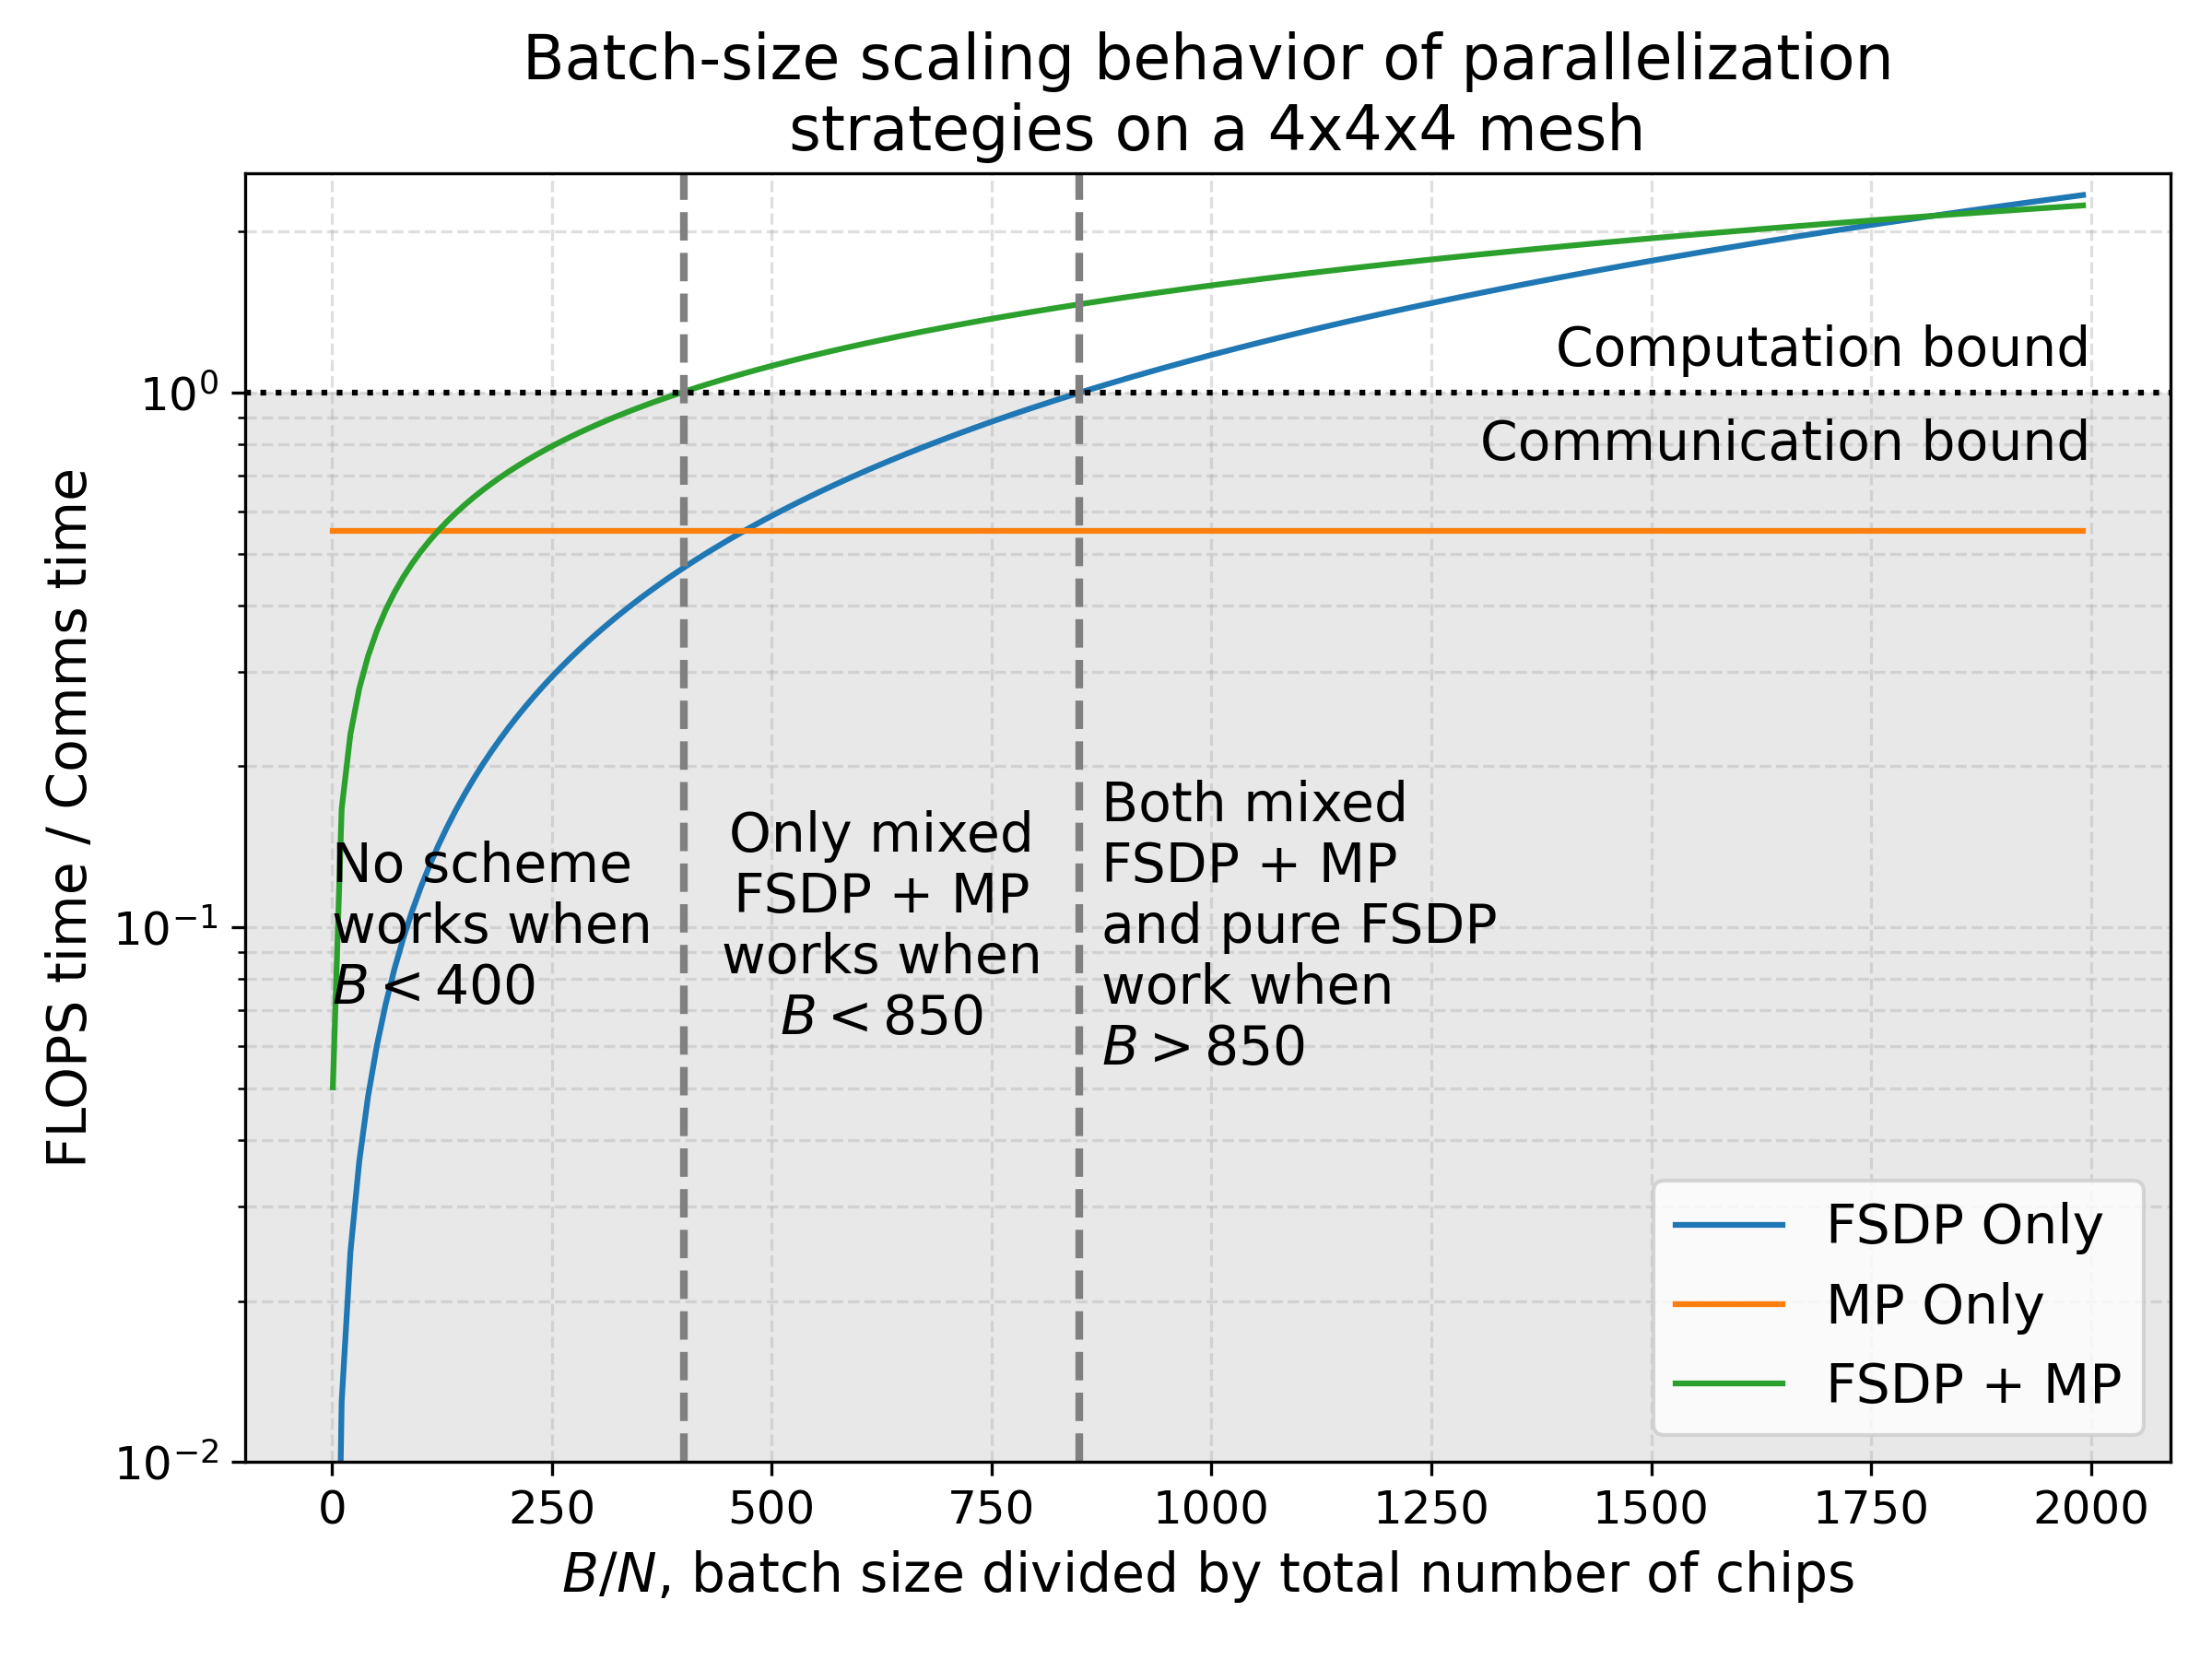
Для приближённых чисел снова подставим , и (так и должно быть для трёхмерной сетки). Получаем примерно . Это выигрыш примерно в восемь раз по сравнению с чистым параллелизмом данных (или FSDP), где для трёхмерной сетки должно превышать примерно 850.
Рисунок в оригинале (mixed-fsdp-comms-2.png): отношение времени FLOPs ко времени связи для оптимального сочетания FSDP/TP на срезе TPUv5p 4×4×4 при F=30 тысяч, в сравнении с чистым TP и чистым FSDP. Как и ожидалось, у тензорного параллелизма отношение от батча не зависит, у оптимального FSDP + TP растёт как , у FSDP — как . Чистый FSDP выигрывает при очень больших батчах, но в промежуточном режиме, когда батч на число чипов примерно от 100 до 850, упираться в вычисления позволяет только FSDP + TP.
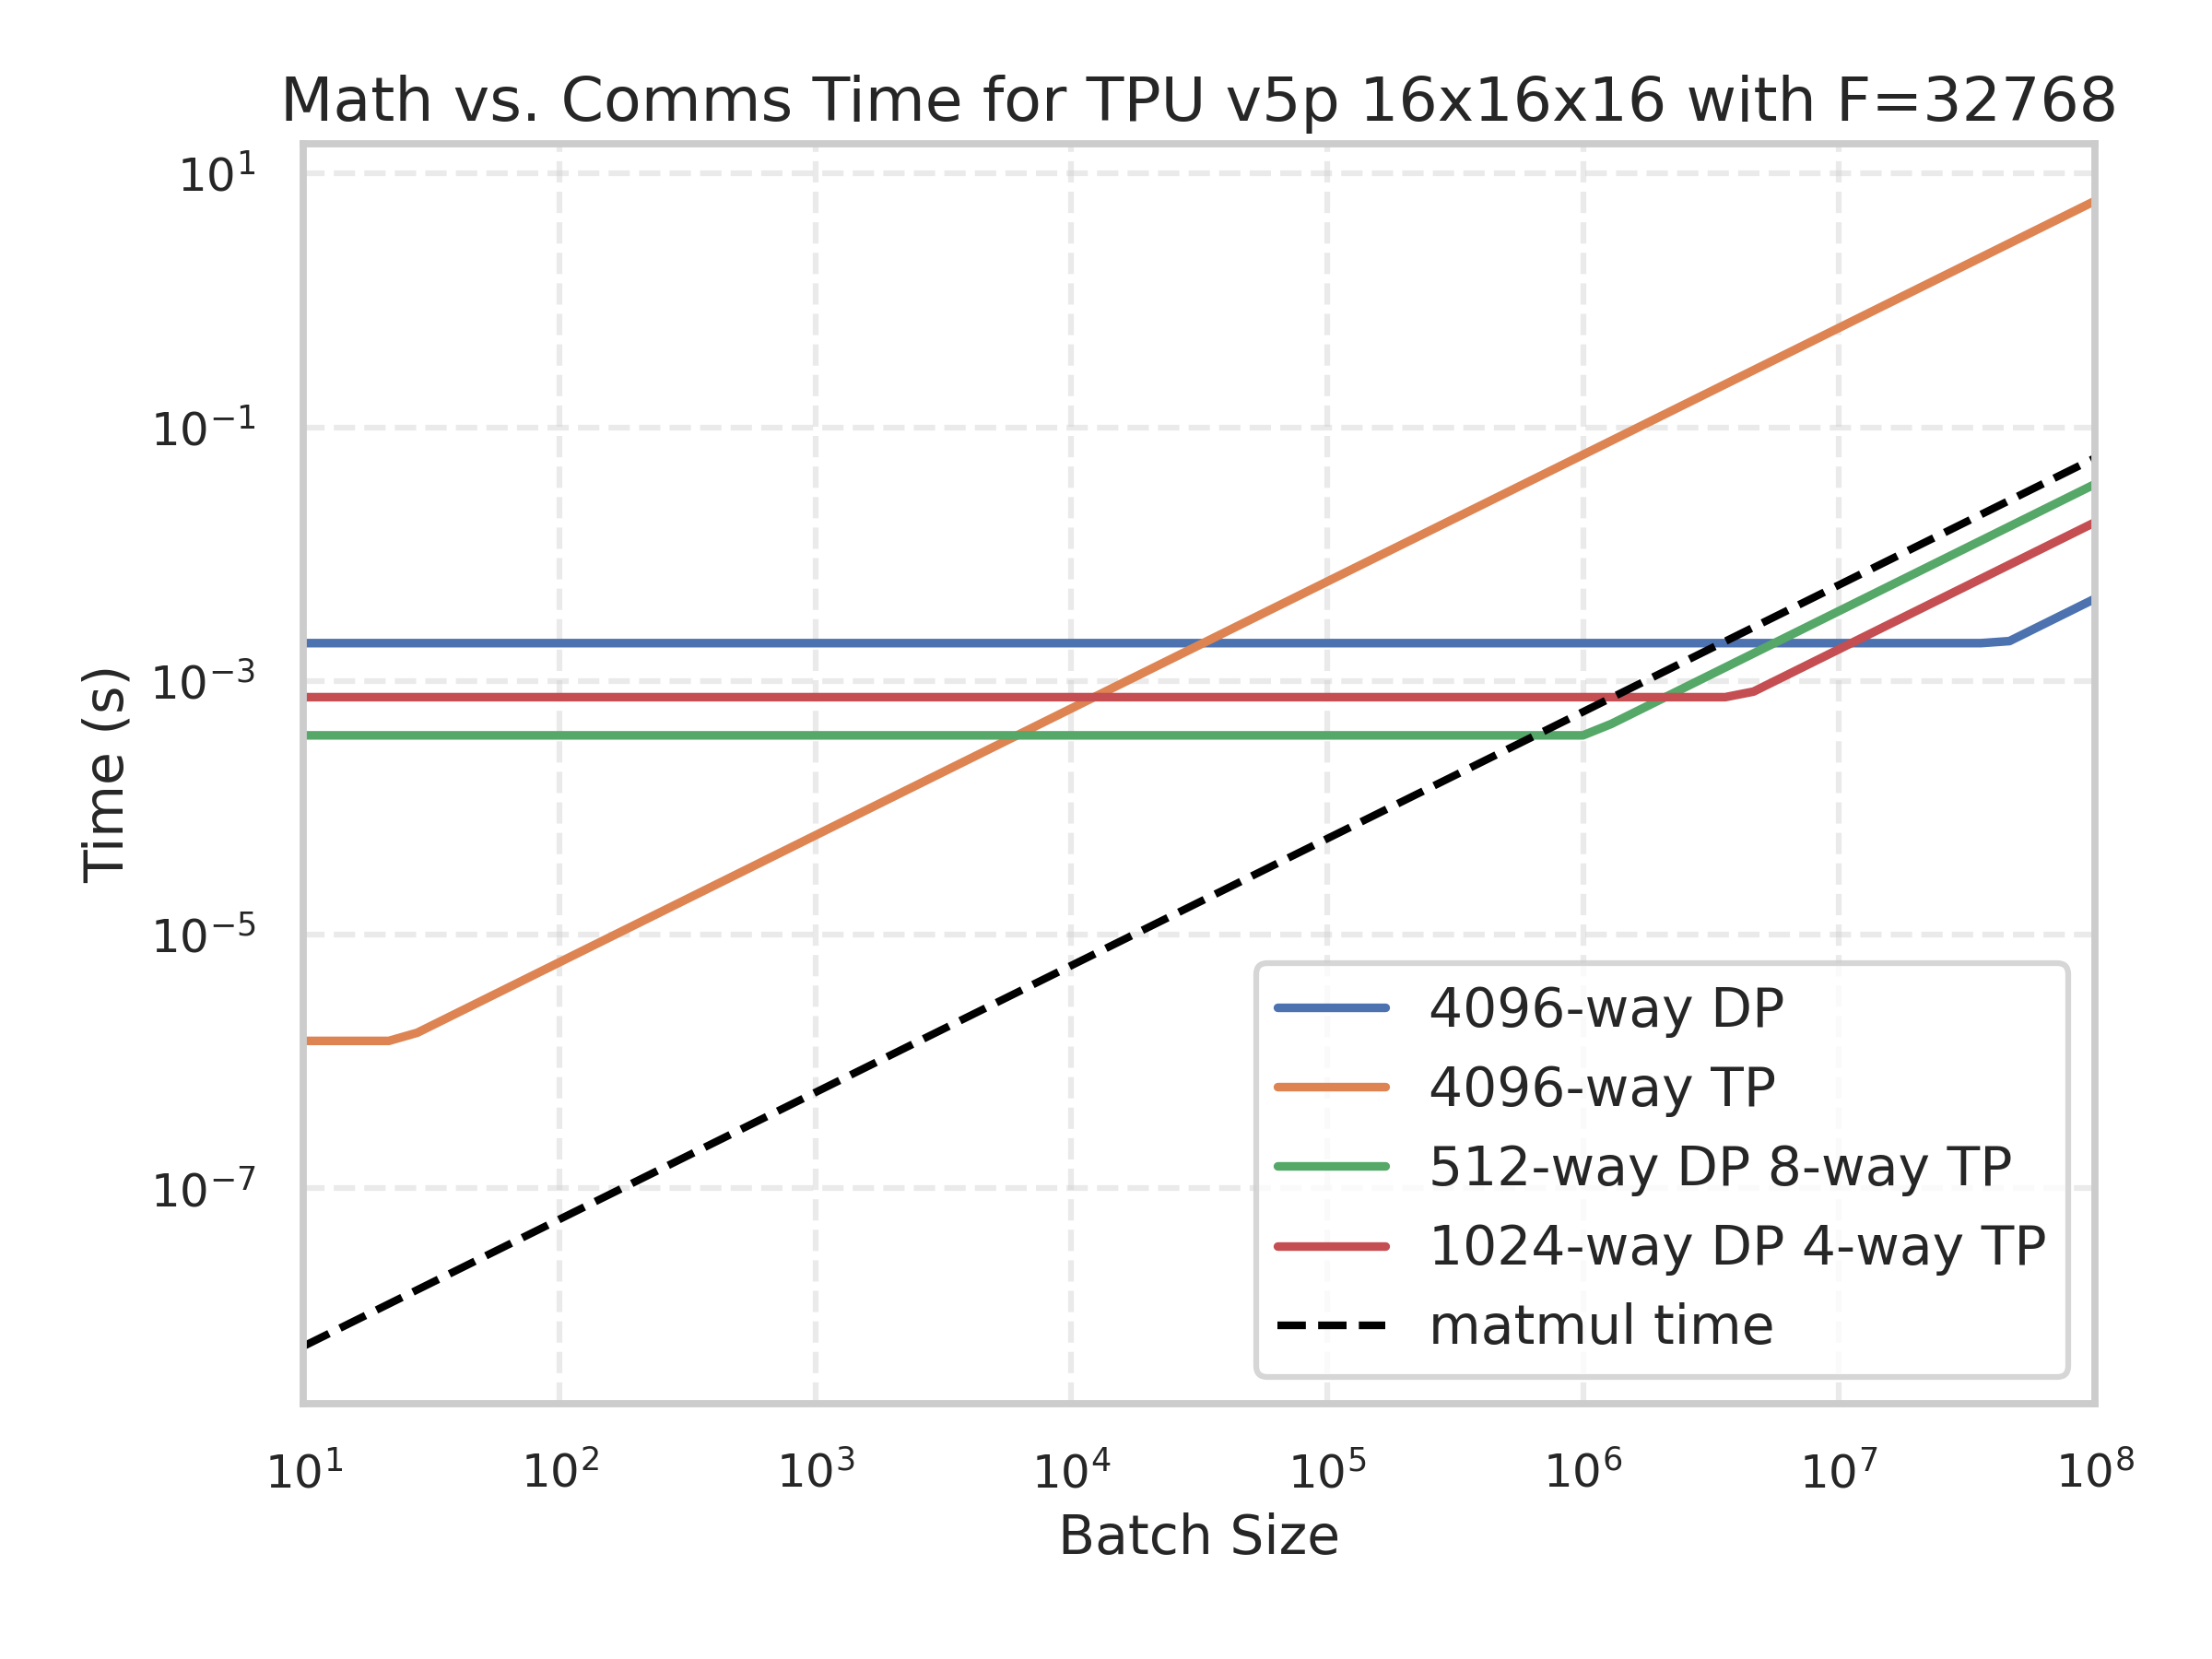
Ещё один пример — TPU v5p 16×16×16 (math-comms-time.png): время связи при разных схемах параллелизма в зависимости от батча; чёрная пунктирная линия — время FLOPs умножений, так что всё выше неё упирается в связь. Все стратегии упираются в связь ниже батча 6e5, что согласуется с ожидаемыми . В интерактивном графике оригинала можно двигать ползунок доли FSDP/TP: лучшее разбиение, FSDP=512 и TP=8, упирается в вычисления при батче больше ~4e5, а любое разбиение с большей долей тензорного параллелизма упирается в связь при любом батче.
Конвейерный параллелизм
Заголовок раздела «Конвейерный параллелизм»Вы, вероятно, заметили, что до сих пор мы избегали разговора о конвейерах. Конвейер — доминирующая стратегия параллелизма на GPU, но на TPU он не так необходим. Коротко: конвейерное обучение делит слои модели между устройствами и передаёт активации между стадиями конвейера в прямом и обратном проходах. Алгоритм примерно такой:
- Инициализировать данные на TPU 0, а веса шардировать по измерению слоёв ( для конвейера с FSDP и тензорным параллелизмом).
- Выполнить первый слой на TPU 0, затем скопировать получившиеся активации на TPU 1 и повторять до последнего TPU.
- Вычислить функцию потерь и её производную .
- На последней стадии конвейера вычислить производные и , затем скопировать на предыдущую стадию и повторять до TPU 0.
(Рабочий) псевдокод на Python
Этот псевдокод должен работать на Cloud TPU VM. Он не очень эффективен и не реалистичен, но даёт представление о том, как данные распространяются между устройствами.
import jaximport jax.numpy as jnp
batch_size = 32d_model = 128d_ff = 4 * d_model
num_layers = len(jax.devices())
key = jax.random.PRNGKey(0)
# Представим, что каждый слой — просто одно умножение матриц.x = jax.random.normal(key, (batch_size, d_model))weights = jax.random.normal(key, (num_layers, d_model, d_model))
def layer_fn(x, weight):  return x @ weight
# Считаем, что num_layers == num_pipeline_stages.intermediates = [x]for i in range(num_layers):  x = layer_fn(x, weights[i])  intermediates.append(x)
  if i != num_layers - 1:    x = jax.device_put(x, jax.devices()[i+1])   # передаём активации следующей стадии
def loss_fn(batch):  return jnp.mean(batch ** 2)  # выдуманная функция потерь
loss, dx = jax.value_and_grad(loss_fn)(x)
for i in range(num_layers - 1, -1, -1):  _, f_vjp = jax.vjp(layer_fn, intermediates[i], weights[i])  dx, dw = f_vjp(dx)  # вычисляем произведение dx на якобиан слоя (VJP)  weights = weights.at[i].set(weights[i] - 0.01 * dw)  # обновляем веса
  if i != 0:    dx = jax.device_put(dx, jax.devices()[i-1])  # передаём градиент предыдущей стадии
(Примечание переводчика: в оригинале обновление записано как weights[i] = ...; массивы JAX неизменяемы, поэтому
здесь использован weights.at[i].set(...). Для запуска без TPU задайте несколько CPU-устройств, как в
главе 3.)
Почему это хорошая идея? Конвейер хорош по многим причинам: стоимость связи между стадиями низкая, так что очень большие модели можно обучать даже при медленных межсоединениях. Это часто очень полезно на GPU, ведь они не связаны так плотно, как TPU по ICI.
Почему это трудно и неприятно? Вы, наверное, заметили в псевдокоде выше, что TPU 0 почти всё время простаивает! Он работает только на самом первом и последнем шаге конвейера. Период простоя называют пузырём конвейера (pipeline bubble), и бороться с ним очень неприятно. Обычно сначала пытаются смягчить его микробатчами: через конвейер пускают несколько маленьких батчей, и TPU 0 загружен хотя бы большую долю времени шага.
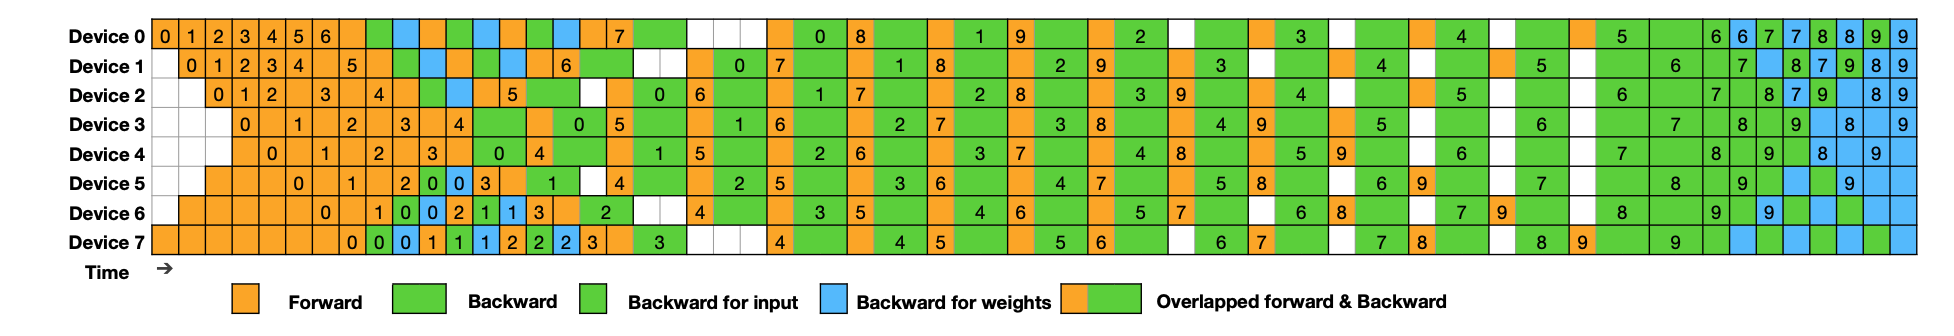
Второй подход — аккуратно совмещать прямое умножение , обратное умножение для — — и умножение для — . Каждое из них требует FLOPs, так что их можно перекрыть и полностью скрыть пузырь. На рисунке из недавней статьи о DeepSeek v3 (deepseek-pipeline.png) — их расписание конвейера «без пузырей»: оранжевым — прямые умножения, зелёным — умножения dL/dx, синим — умножения dL/dW; отдавая приоритет обратным умножениям dL/dx, можно не «оставлять на мели» FLOPs.
Для TPU (с их большими связанными подами) это менее критично, поэтому глубоко погружаться мы не будем, но понять главные узкие места конвейера — хорошее упражнение.
Масштабирование между подами
Заголовок раздела «Масштабирование между подами»Самый большой возможный срез TPU — суперпод TPU v5p из 8960 чипов (и 2240 хостов). Чтобы масштабироваться дальше, нужно пересечь границу сети дата-центра (DCN). У каждого хоста TPU одна или несколько сетевых карт (NIC), соединяющих хост с другими подами TPU v5p по Ethernet. Как отмечалось в главе о TPU, у каждого хоста около 200 Гбит/с (25 ГБ/с) полнодуплексной пропускной способности DCN, то есть около 6,25 ГБ/с исходящей пропускной способности на TPU.
Обычно при масштабировании за пределы одного пода внутри домена ICI делают какой-то параллелизм модели или FSDP, а между подами — чистый параллелизм данных. Пусть — число TPU, до которого мы хотим масштабироваться, а — число TPU в срезе, связанном ICI. Чтобы сделать AllReduce по DCN, можно выполнить кольцевую редукцию по набору подов, что даёт (в обратном проходе):
Пропускная способность связи растёт с : в отличие от ICI, общая пропускная способность растёт по мере роста домена ICI — появляется больше сетевых карт. Упрощая, получаем, что при
Для TPU v5p — около 4.59e14 / 6.25e9 = 73,440. Значит, чтобы эффективно масштабироваться через
DCN, нужен минимальный батч на домен ICI.
Насколько это проблема? Конкретный пример: мы хотим обучать LLaMA-3 70B на TPU v5p с батчем 2 млн токенов. У LLaMA-3 70B . Из разделов выше мы знаем:
- тензорный параллелизм возможен до ;
- FSDP возможен, пока . Значит, при батче 2 млн и 3 осях параллелизма данных можно использовать не больше чипов — примерно четверть пода TPU v5p;
- при сочетании FSDP + TP мы упираемся в связь при , так что можно масштабироваться примерно до 18 тысяч чипов! Но максимальный размер пода TPU v5p — около 9 тысяч чипов, так что дальше придётся использовать DCN.
Коротко: есть хороший рецепт обучения с батчем 1 млн — примерно X (FSDP) = 1024 и Y (TP) = 8, — а с батчем 2 млн нужен DCN. Как отмечено выше, арифметическая интенсивность DCN — 73 440, так что нужно лишь, чтобы батч на домен ICI был больше. Для нас это тривиально: с 2 подами батч на под — 1 млн, а на TPU — 111, и это отлично (может, впритык, но теоретически верно).
Главные выводы об обучении LLM на TPU
Заголовок раздела «Главные выводы об обучении LLM на TPU»- Рост параллелизма или уменьшение батча обычно делают нас сильнее ограниченными связью, потому что уменьшают объём вычислений на чип.
- До разумной длины контекста (~32 тысячи) трансформер можно моделировать как стопку блоков MLP и определять каждую схему параллелизма тем, как она шардирует два-три главных умножения матриц на слой.
- При обучении рассматриваются 4 главные схемы параллелизма, у каждой свои требования к пропускной способности и вычислениям (параллелизм данных, FSDP, тензорный параллелизм и сочетание FSDP + тензорного параллелизма).
| Стратегия | Описание |
|---|---|
| Параллелизм данных | Активации шардированы по батчу, всё остальное полностью реплицировано; в обратном проходе — AllReduce градиентов |
| FSDP | Активации, веса и оптимизатор шардированы по батчу; веса собираются прямо перед использованием, градиенты — ReduceScatter |
| Тензорный параллелизм (Megatron, параллелизм модели) | Активации шардированы по , веса — по ; активации собираются перед Win, результат разбрасывается ReduceScatter после Wout |
| FSDP + тензорный параллелизм | Оба вместе; FSDP собирает веса, шардированные по модели |
«Формулы» каждого метода:
- У каждой стратегии есть предел, после которого она упирается в сеть (связь), — он определяется вычислениями и связью на устройство. Вот вычисления и связь на слой ( — FSDP, — тензорный параллелизм):
- Чистый параллелизм данных редко полезен, потому что модель с состоянием оптимизатора занимает в байтах 10 × число параметров. Значит, в память редко помещается больше нескольких миллиардов параметров.
- Параллелизм данных и FSDP упираются в связь, когда — арифметической интенсивности сети. Для ICI это 2550, для DCN — около 71 000. Больше параллельных осей — порог ниже.
- Тензорный параллелизм упирается в связь, когда . Для большинства моделей это около 8–16-путевого. От размера батча это не зависит.
- Сочетание FSDP + тензорного параллелизма позволяет опустить батч до . Это удивительно мало.
- Параллелизм данных между подами требует минимального батча на под около 71 000, иначе он упирается в DCN.
- По сути, если батч большой или модель маленькая, всё просто: можно делать параллелизм данных или FSDP + параллелизм данных через DCN. Самое интересное — посередине.
Задачи главы 5 (условия; ответы — в оригинале):
- Сколько параметров у LLaMA-2 13B? (Учтите три большие матрицы FFW, как в главе 4.)
- Обучение с батчем 16 млн токенов и Adam: сколько памяти занимают параметры, состояние оптимизатора и активации (параметры в bf16, оптимизатор в fp32, три чекпоинта активаций на слой)?
- Обучение с длиной последовательности 32 тысячи и общим батчем 3 млн токенов на срезе TPUv5p 16×16×16: какое шардирование выбрать и сколько займёт обучение?
Глава 6 в кратком изложении: обучение LLaMA 3 на TPU
Заголовок раздела «Глава 6 в кратком изложении: обучение LLaMA 3 на TPU»Пересказ с переводом выводов и ключевых расчётов главы «Training LLaMA 3 on TPUs». В оригинале это серия вопросов с ответами — попробуйте сначала посчитать сами.
Архитектура LLaMA 3-70B (из конфигурации модели): слоёв, , , головы запросов, голов ключей/значений, , словарь .
Число параметров. FFW: млрд; словарь (вход и выход): млрд; внимание: млрд. Итого ≈ 70,4 млрд — сходится. Три большие матрицы MLP настолько больше всех остальных массивов, что при рассуждениях о памяти и FLOPs остальные параметры часто можно почти игнорировать.
FLOPs. На токен — FLOPs (около половины терафлопа). На 15 трлн токенов — FLOPs. На одном TPU v5p это 435 лет; на полном поде из 8960 чипов при 40% MFU — с, то есть около 44 дней.
Память при батче 4 млн токенов (bf16-параметры, fp32-оптимизатор, 2 чекпоинта активаций на слой): параметры ~140 ГБ, состояние оптимизатора ~560 ГБ, чекпоинты активаций ТБ, итого ~11,2 ТБ. Активации резко доминируют. Это ~117 чипов по 96 ГБ — но на них обучение шло бы почти 10 лет. Большие кластеры нужны не из-за памяти, а ради FLOPs: на 8960 чипах это ~1,3 ГБ на чип.
Шардирование на поде из 8960 чипов при батче 4 млн токенов (1024 последовательности по 4096):
- только FSDP по батчу — нельзя: последовательностей всего 1024;
- FSDP по батчу и последовательности — батч на TPU
4 * 1024 * 1024 / 8960 = 468токенов, меньше порога 850 для трёх осей, — упираемся в связь; - FSDP + TP — порог , мы выше; оптимум , то есть примерно 2048-путевой FSDP и 4-путевой тензорный параллелизм.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| strong scaling | сильное масштабирование |
| data parallelism (DP) | параллелизм данных |
| fully-sharded data parallelism (FSDP), ZeRO-1/2/3 | полностью шардированный параллелизм данных, шардирование ZeRO |
| tensor (model) parallelism, Megatron sharding | тензорный параллелизм (параллелизм модели), шардирование Megatron |
| pipeline parallelism, pipeline bubble, microbatch | конвейерный параллелизм, пузырь конвейера, микробатч |
| context / sequence parallelism, ring attention | контекстный / последовательностный параллелизм, кольцевое внимание |
| critical path | критический путь |
| ICI operational intensity | операционная интенсивность ICI |
| optimizer state | состояние оптимизатора |
| MFU (model FLOPs utilization) | доля использованных пиковых FLOPs |
| critical batch size | критический размер батча |
| DCN, NIC | сеть дата-центра, сетевая карта |
| activation checkpoint | чекпоинт активаций |
Footnotes
Заголовок раздела «Footnotes»-
Мы сосредоточимся на ограничениях связи: ограничения объёма памяти важны, но при использовании рематериализации (чекпоинтинга активаций) и очень большого числа чипов при предобучении они обычно нас не сдерживают. Экспертный параллелизм для MoE мы здесь тоже не обсуждаем — он существенно расширяет пространство решений, — только базовый случай плотного трансформера. ↩
-
Adam хранит параметры и накопители первого и второго порядка. Параметры в bfloat16, а состояние оптимизатора в float32, что даёт
2 + 8 = 10байт на параметр. ↩ -
Заметьте, что сюда не входят чекпоинты для градиентов, так что на деле это бесполезно. Это абсолютная нижняя граница при батче в 1 токен. ↩
-
Предполагаем, что разбиение идёт по сетке ICI, так что нужная пропускная способность сети — . ↩
-
Строго говоря, FSDP добавляет связь в прямом проходе, которой у чистого DP нет, но в той же пропорции, что и в обратном, так что на roofline связи это не влияет. Главное здесь — ZeRO-3 превращает AllReduce обратного прохода в AllGather и ReduceScatter, у которых тот же общий объём связи. ↩