How To Scale Your Model, главы 7–8: всё об инференсе трансформера
Перевод седьмой главы книги Google DeepMind об инференсе — prefill и генерация, почему декодирование упирается в память, нижняя граница задержки, KV-кэш и способы его уменьшить, шардирование при инференсе, раздельные серверы, непрерывный батчинг, кэширование префиксов, спекулятивное сэмплирование — и краткое изложение восьмой главы о LLaMA 3-70B.
Выполнять инференс трансформера бывает обманчиво сложно. В этой главе мы поговорим о том, как сэмплировать из трансформера, как устроены задержка и пропускная способность при генерации и как масштабировать инференс на много ускорителей. — подзаголовок главы 7.
Основы инференса трансформера
Заголовок раздела «Основы инференса трансформера»Итак, вы обучили трансформер и хотите с его помощью порождать новые последовательности. В конце концов, растущие оценки на бенчмарках и падающие кривые потерь — лишь приближённые показатели того, случится ли что-то интересное, когда дойдёт до дела!1
Сэмплирование концептуально просто. Мы подаём последовательность, и наш любимый трансформер выдаёт , то есть логарифмы вероятностей всех возможных следующих токенов. Можно сэмплировать из этого распределения и получить новый токен. Добавив этот токен и повторяя процесс, получаем последовательность токенов — продолжение промпта.
Рисунок в оригинале (naive-inference.png): наивное сэмплирование из трансформера. Синие логиты дают распределение следующего токена, из которого можно сэмплировать. Каждый шаг заново обрабатывает весь префикс, так что время работы алгоритма — .
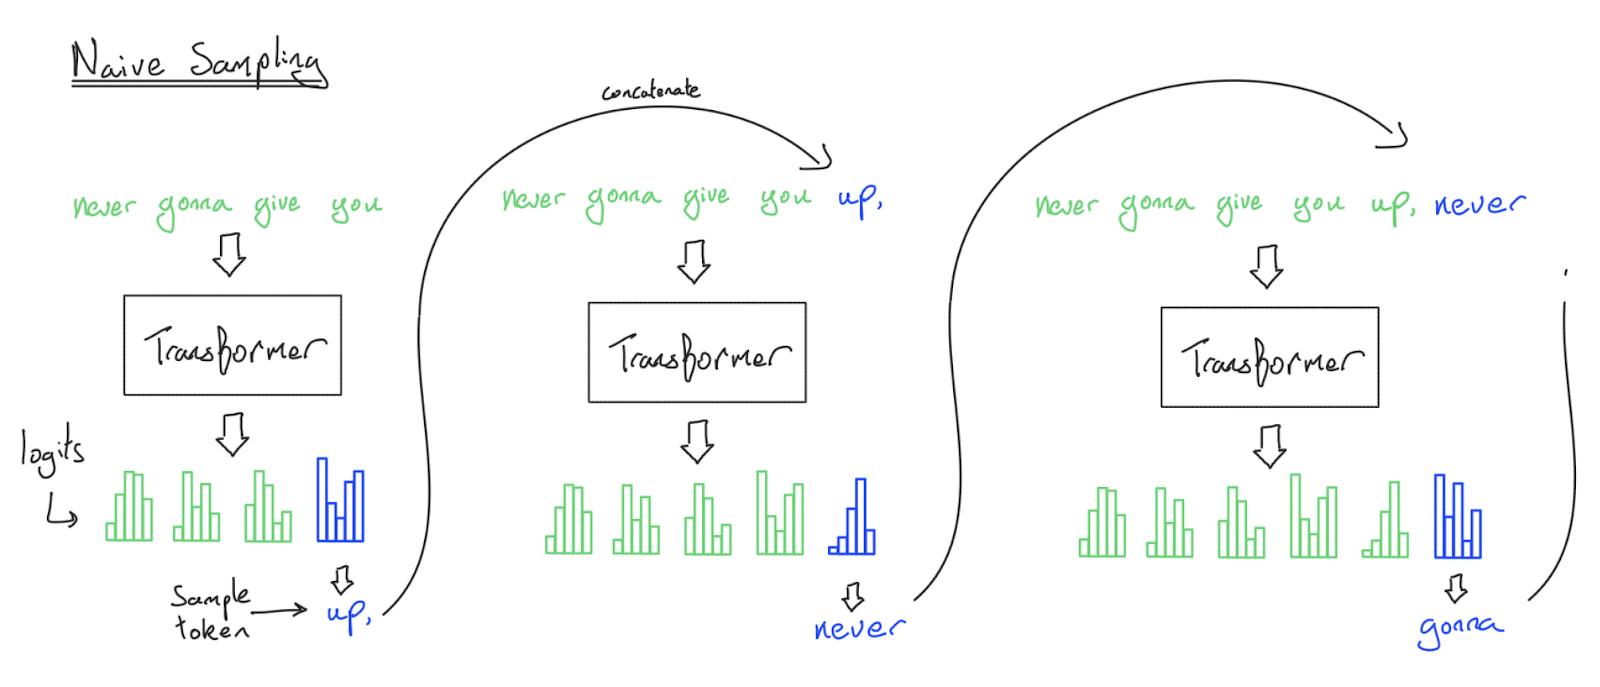
Мы описали наивную реализацию сэмплирования трансформера, и, хотя она работает, на практике её никогда не используют: при порождении каждого токена вся последовательность обрабатывается заново. Чтобы породить токенов, этот алгоритм тратит на FFW и на механизм внимания!
Как этого избежать? Вместо полного прямого прохода каждый раз оказывается, что можно сохранять из каждого прямого прохода некоторые промежуточные активации, которые позволяют не обрабатывать заново предыдущие токены. А именно: поскольку в скалярном внимании токен смотрит только на предыдущие токены, проекции ключей и значений каждого токена можно просто записывать в новую структуру данных — KV-кэш. Сохранив проекции ключей и значений прошлых токенов, будущие токены могут просто вычислять свои произведения , не тратя новых FLOPs на прежние токены. Потрясающе!
С учётом этого у инференса две ключевые части:
- Prefill (предзаполнение): получив длинный промпт, мы обрабатываем все его токены одновременно и сохраняем получившиеся активации (точнее, проекции ключей и значений) в KV-кэш. Сохраняем и логиты последнего токена.
- Генерация (generation, decode): имея KV-кэш и предыдущие логиты, мы пошагово сэмплируем из логитов один токен, подаём
его обратно в трансформер и получаем новый набор логитов для следующего шага. Активации KV нового токена дописываем
в KV-кэш. Повторяем, пока не встретится специальный токен
<EOS>или не будет достигнута максимальная длина.
Рисунок в оригинале (cached-inference.png): эффективное сэмплирование трансформера с KV-кэшем. Prefill обрабатывает промпт и сохраняет в кэш активации ключей и значений каждого токена. Генерация берёт этот кэш (и логиты последнего токена), сэмплирует новый токен и пропускает его через модель, обращаясь к KV-кэшу и дописывая в него проекции ключей и значений нового токена. Для блока MLP это алгоритм за .
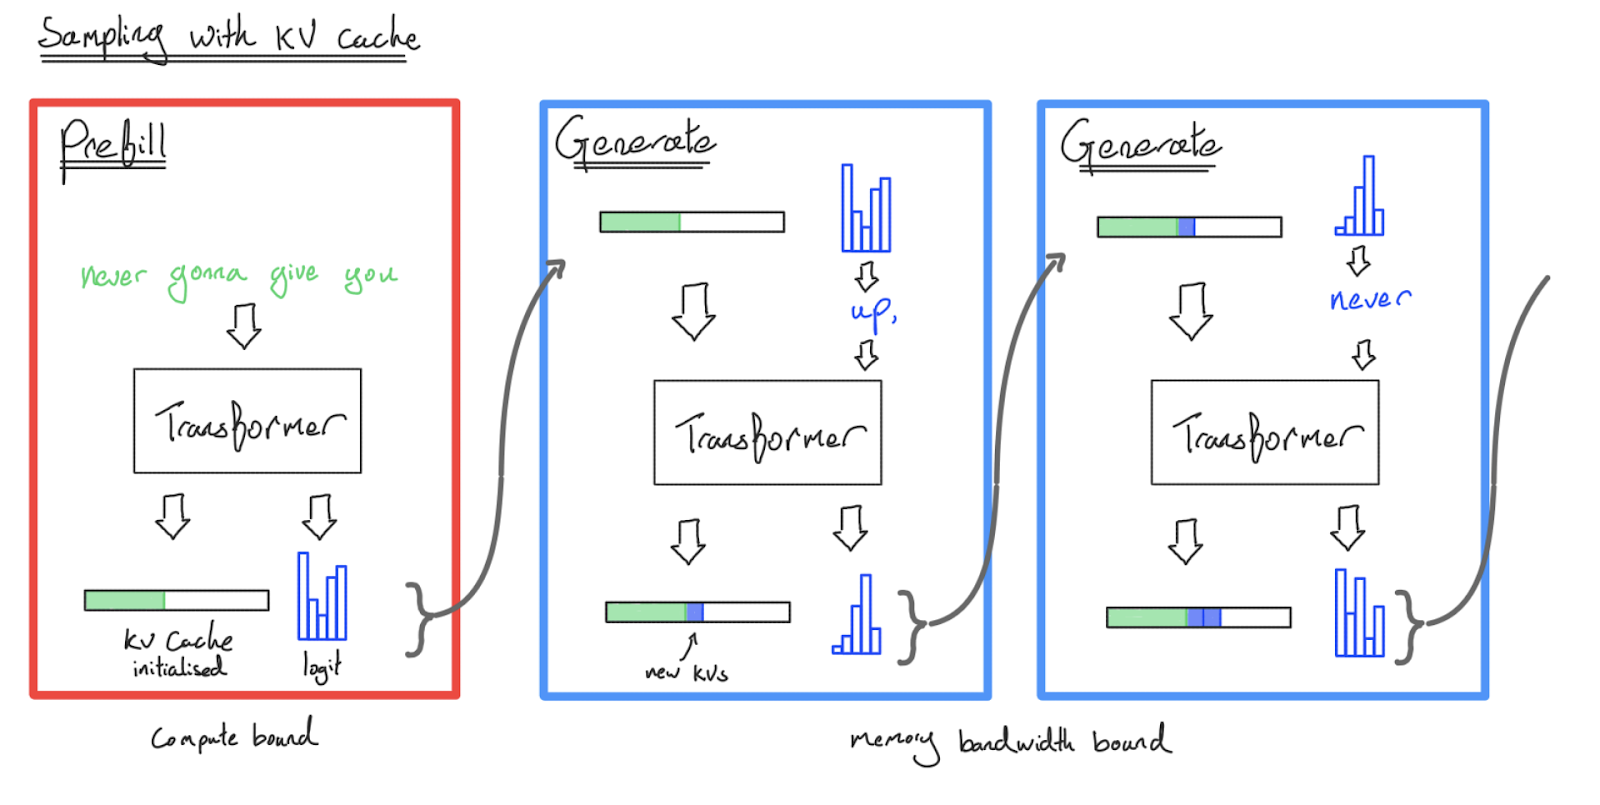
Сэмплируя с KV-кэшем, мы сократили время порождения токенов до на FFW и на внимании, ведь прежние токены больше не обрабатываются заново. Тем не менее, чтобы породить последовательность, нужно много прямых проходов — именно это происходит, когда вы задаёте вопрос Gemini или ChatGPT и ответ приходит потоком. Каждый токен — это (обычно) отдельный (хотя частично закэшированный) вызов огромной модели.
Скоро мы увидим, что prefill и генерация — совершенно разные звери: инференс трансформера — это две замаскированные задачи! По сравнению с обучением, KV-кэш — ещё и новый, серьёзный источник сложности.
flowchart LR
P["Промпт, T токенов"] --> PF["Prefill: один проход по всем T токенам — упор в вычисления"]
PF --> KV["KV-кэш [2, S, L, K, H]"]
KV --> G["Генерация: 1 токен за шаг, читаем все веса и весь KV-кэш — упор в память"]
G -->|"новый токен"| KV
G --> OUT["Ответ потоком"]
Что мы на самом деле хотим оптимизировать?
Заголовок раздела «Что мы на самом деле хотим оптимизировать?»Прежде чем двигаться дальше, стоит выделить одну совершенно новую сторону инференса — задержку (latency). При обучении нас волнует только пропускная способность (общее число токенов, обрабатываемых в секунду на чип), а при инференсе важно, как быстро мы выдаём токены (и время до первого токена, Time To First Token, TTFT, и задержка на токен). Например:
- Офлайн-инференс батчами для оценок (eval) и генерации данных интересует только общая стоимость инференса, задержка отдельных примеров не важна.
- Чат-интерфейсы и потоковые задачи должны работать дёшево в масштабе, но при этом иметь низкий TTFT и порождать токены быстрее, чем человек читает.
- Инференс на устройстве (edge; например,
llama.cppна ноутбуке) обслуживает одного пользователя за раз с минимально возможной задержкой, часто при жёстких ограничениях железа.
Максимальная загрузка железа по-прежнему критична и помогает со стоимостью и TTFT, но, в отличие от обучения, она не обязательно означает лучший опыт для отдельных пользователей во всех сценариях. Многие оптимизации на уровне ускорителя, системы и архитектуры модели меняют одно на другое: задержку, пропускную способность, длину контекста и даже качество модели.
Трансформер подробнее
Заголовок раздела «Трансформер подробнее»До сих пор мы в основном считали трансформер стопкой прямых блоков. С точки зрения FLOPs и памяти это часто разумно, но для моделирования инференса этого мало2. Как мы видели в главе 4, главные составляющие прямого прохода трансформера:
- Множество линейных операций, включая MLP (, ), проекции QKV внимания и выходную проекцию (, , и ). Все они читают из HBM параметры и батч активаций, выполняют какие-то FLOPs и записывают результат обратно в HBM.
- Скалярное внимание. Нужно прочитать из HBM батч проекций ключей и значений и батч активаций запросов, выполнить несколько скалярных произведений и softmax и записать результат внимания обратно в HBM.
- Всё остальное, включая layer norm, функции активации, сэмплирование токенов, обновление KV-кэшей и позиционные эмбеддинги. Они тоже требуют FLOPs, но их перекрывают или в них сливаются (fused) операции выше.
В следующих разделах мы рассмотрим каждую составляющую в контексте prefill и генерации и спросим, что, скорее всего, станет узким местом. Внутри одного ускорителя — упираемся мы в вычисления или в память? Подчеркнём, насколько разными будут ответы для prefill и для генерации.
Линейные операции: что нас ограничивает?
Заголовок раздела «Линейные операции: что нас ограничивает?»Все линейные операции концептуально одинаковы, в MLP они или во внимании. Их арифметическая интенсивность зависит от размера батча. Мы делали этот расчёт в главе 1, но его стоит повторить. Рассмотрим одно умножение батча на матрицу . Это может быть большой блок MLP ( или ) или одна из меньших проекций внимания (, , , ). Для умножения нужно загрузить оба массива из HBM в MXU, перемножить и записать результат обратно в HBM. Как и раньше:
TPU или GPU могут перекрывать одно другим, загружая данные во время вычислений, так что для упора в вычисления нужно , то есть
где правая часть — арифметическая интенсивность железа. Теперь будем считать и очень большими по сравнению с (обычно батчи не больше 500, а и больше 10 тысяч); тогда знаменатель упрощается: , и получаем
Если квантовать веса или считать умножения в пониженной точности, критический размер батча может меняться. Например, при квантовании весов в int8 или fp8 уменьшается вдвое. Если же FLOPs выполняются в int8 или fp8, вдвое растёт. Так что, обозначив и , получаем критический размер батча .
При обучении у всех умножений высокая интенсивность: одни и те же веса переиспользуются на очень большом батче. Эта высокая арифметическая интенсивность переходит и в prefill, ведь промпты пользователей обычно длиной в сотни, а то и тысячи токенов. Как мы видели, арифметическая интенсивность железа TPUv5e — 240, так что если на это железо в bf16 подать плотной модели последовательность длиннее 240 токенов, мы ожидаемо упрёмся в вычисления, и всё хорошо. Промпты короче можно формально объединять в батч ради лучшей загрузки, но обычно это не нужно.
Однако при генерации для каждого запроса прямые проходы можно выполнять только по одному токену за раз — между шагами есть последовательная зависимость! Так что хорошей загрузки можно (легко) добиться, только объединяя в батч несколько запросов, то есть параллеля по измерению батча. Подробнее мы поговорим об этом позже, но на деле объединить в батч много одновременных запросов, не ухудшив задержку, трудно. Поэтому при генерации загрузить FLOPs железа гораздо труднее.
Стоит отметить, насколько это много! Батч генерации в 240 значит 240 одновременных запросов, генерирующих сразу, и 240 отдельных KV-кэшей для плотных моделей. На практике этого трудно добиться, кроме некоторых сценариев массового инференса. А вот пропустить больше 240 токенов через prefill — обычное дело, хотя с ростом разреженности нужна осторожность.
Заметьте: точное число зависит от вида квантования и железа. Ускорители часто выполняют больше арифметики в пониженной точности. Например, если параметры в int8, а вычисления в bf16, критический батч падает до 120. С активациями и параметрами в int8 он снова вырастает до 240, поскольку TPUv5e выдаёт 400 TOPs/s для int8 × int8.
А что с вниманием?
Заголовок раздела «А что с вниманием?»Всё усложняется, когда мы смотрим на операцию скалярного внимания, особенно потому, что приходится учитывать KV-кэши. Рассмотрим одну голову внимания в чистом многоголовом внимании. В одном слиянии (fusion) Flash Attention мы3:
- читаем из HBM активации формы ;
- читаем из HBM KV-кэш — пару тензоров ;
- выполняем FLOPs в умножении . С Flash Attention матрицу внимания не нужно записывать обратно в HBM;
- выполняем в умножении внимания ;
- записываем получившийся тензор обратно в HBM.
Всё вместе даёт:
При prefill , поскольку это самовнимание, и выражение упрощается до . Это отлично: арифметическая интенсивность внимания при prefill — . Значит, упереться во внимании в вычисления довольно легко. Лишь бы последовательность была достаточно длинной!
Но при генерации измерение последовательности тривиально, а измерения и сокращаются, так что можно приблизить:
Это плохо: значит, мы никак не можем повысить арифметическую интенсивность внимания при генерации. Мы выполняем крошечное число FLOPs, загружая огромный KV-кэш. Так что во внимании мы практически всегда упираемся в пропускную способность памяти!
Почему так, концептуально? В основном мы упираемся в вычисления в линейных частях модели, потому что параметры (основной потребитель пропускной способности памяти) переиспользуются для многих элементов батча. Но у каждого элемента батча свой KV-кэш, так что больший батч означает больше KV-кэшей. Здесь мы почти всегда будем упираться в память, если только архитектура не изменена радикально.
Это значит также, что отдача от увеличения батча для пропускной способности начнёт убывать, как только память параметров станет сравнима с памятью KV-кэша. Насколько сильно это ударит, зависит от отношения байт параметров к байтам KV-кэша одной последовательности, то есть примерно от . Поскольку , это примерно зависит от отношения к длине последовательности . И от изменений архитектуры, уменьшающих KV-кэш (о них чуть ниже).
Теоретические оценки задержки и пропускной способности LLM
Заголовок раздела «Теоретические оценки задержки и пропускной способности LLM»Из этих расчётов можно получить довольно хорошие границы на время шага, к которому стоит стремиться при оптимизации. (Замечание: если вынести из всей главы что-то одно, то вот это.) Для маленьких батчей при генерации (это частый случай) задержку шага можно оценить снизу, считая, что и внимание, и MLP упираются в пропускную способность памяти:
Аналогично для пропускной способности:
С ростом батча FLOPs в конце концов начинают доминировать над загрузкой параметров, так что на практике получаем более общее уравнение:
где составляющая внимания (слева) никогда не упирается в вычисления, и roofline по FLOPs ей не нужен. Для прикидок «на салфетке» это очень полезно, например:
Быстрый вопрос. Допустим, мы хотим сделать шаг генерации с батчем 4 токена на плотной модели на 30 млрд параметров на срезе TPU v5e 4x4 в int8 с FLOPs в bf16, контекстом 8192 и KV-кэшем 100 кБ на токен. Какова разумная нижняя граница задержки этой операции? А если мы хотим сэмплировать батч из 256 токенов?
Ответ
В int8 параметры займут 30e9 байт, а KV-кэш при данных характеристиках — 100e3 * 8192 = 819MB на каждую
последовательность. У нас 16 чипов, у каждого 8.2e11 байт/с пропускной способности и 1.97e14 FLOPs/s в bf16. По формулам
выше, поскольку батч маленький, время шага будет не меньше (4 * 819e6 + 30e9) / (16 * 8.2e11) = 2.5 ms. При 256 токенах
блоки MLP будут уже глубоко в режиме упора в вычисления, так что время шага примерно
(256 * 819e6) / (16 * 8.2e11) + (2 * 256 * 30e9) / (16 * 1.97e14) = 21ms.
Как видите, здесь явный компромисс между пропускной способностью и задержкой. Маленькие батчи быстры, но плохо загружают железо. Большие — медленны, но эффективны. На рисунке в оригинале (latency-cost.png, из статьи ESTI) — Парето-фронт «стоимость (то есть пропускная способность) против задержки» для нескольких старых моделей PaLM. Число чипов (C) и размер батча (B) двигают вас вдоль фронта, кроме одной точки (C:32 B:16 для PaLM 540B), где памяти не хватило на хороший батч и пропускная способность пострадала. Пропускная способность обычно выходит на плато примерно после батча 240. Веса в int8 дают лучший Парето-фронт «задержка — пропускная способность», но не лучшую максимальную пропускную способность.
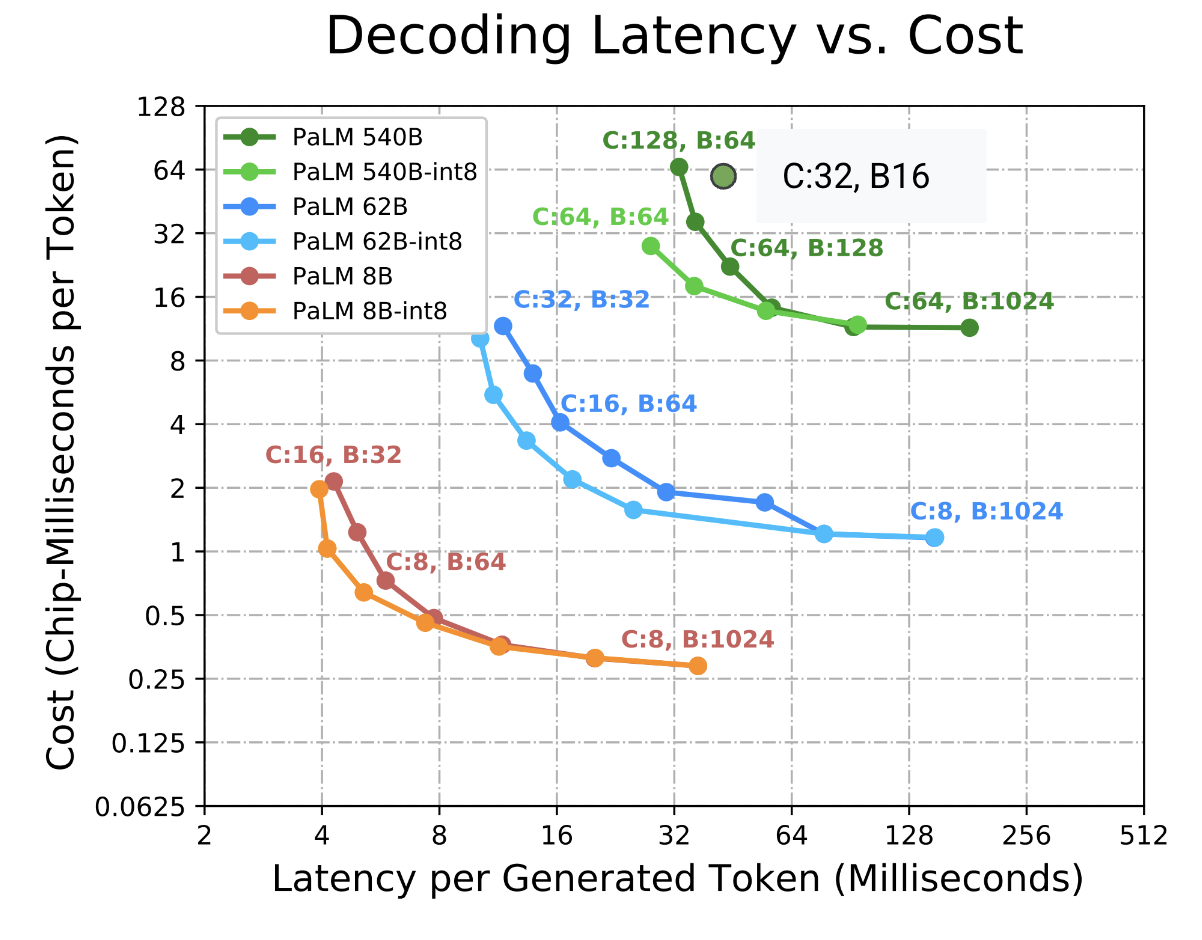
Мы меняем задержку на пропускную способность не только ручкой «размер батча»: если упираемся в HBM, можно предпочесть большую топологию меньшей, чтобы поместились большие батчи. Следующая глава разбирает это подробнее.
Оговорки с точки зрения железа
Всё это довольно теоретично. На практике чёткий roofline часто не наблюдается по нескольким причинам:
- Предположение, что чтения из HBM идеально перекрываются с FLOPs, нереалистично: компилятор (XLA) несовершенен.
- Для шардированных моделей XLA также часто не удаётся эффективно перекрыть связь ICI в шардированных умножениях с самими FLOPs, так что на линейных слоях задержка часто начинает расти уже при батче больше 32.
- Батчи больше теоретического roofline всё равно немного улучшают пропускную способность из-за неидеального перекрытия, но как эвристика это хорошо.
А что с памятью?
Заголовок раздела «А что с памятью?»Мы потратили время на пропускную способность и FLOPs, но не на память. При инференсе картина памяти выглядит совсем иначе благодаря новой структуре данных — KV-кэшу. Возьмём для этого раздела настоящую модель (LLaMA 2-13B), чтобы показать, насколько всё по-другому:
| Гиперпараметр | Значение |
|---|---|
| L (число слоёв) | 40 |
| D (d_model) | 5 120 |
| F (размерность FFW) | 13 824 |
| N (число голов) | 40 |
| K (число голов KV) | 40 |
| H (размерность qkv) | 128 |
| V (размер словаря) | 32 000 |
Что занимает память при инференсе? Ну, очевидно, параметры. Считаем:
| Параметры | Формула | Размер |
|---|---|---|
| FFW | d_model2 × множитель ffw × 3 (гейт, повышающая и понижающая проекции SwiGLU) × число слоёв | 5120 × 5120 × 2,7 × 3 × 40 = 8,5e9 |
| Словарь | 2 (входные и выходные эмбеддинги) × размер словаря × d_model | 2 × 32 000 × 5120 = 0,3e9 |
| Внимание | [2 (q и выход) × d_model × число голов × d_qkv + 2 (k и v) × d_model × число голов KV × d_qkv] × число слоёв | (2 × 5120 × 40 × 128 + 2 × 5120 × 40 × 128) × 40 = 4,2e9 |
Складывая, получаем 8,5e9 + 4,2e9 + 0,3e9 = 13e9 параметров, как и ожидалось. Как мы видели в прошлых главах, при обучении параметры можно хранить в bfloat16, а состояние оптимизатора — в float32. Это может занять около 100 ГБ памяти. Но это ничто по сравнению с чекпоинтами для градиентов, которые могут занимать несколько терабайт.
Чем отличается инференс? При инференсе мы храним одну копию параметров, скажем, в bfloat16. Это 26 ГБ — а с квантованием
на практике часто гораздо меньше. Нет ни состояния оптимизатора, ни градиентов. Поскольку мы не сохраняем активации для
обратного прохода, объём активаций пренебрежимо мал и при prefill4, и при генерации. Если делать prefill 8 тысяч
токенов, одна активация займёт лишь около 8,192 x 5,120 x 2 bytes = 80MB. Более длинный prefill можно разбить на много
меньших прямых проходов, так что и длинный контекст не проблема. При генерации токенов ещё меньше, так что активациями
можно пренебречь.
Главное отличие — KV-кэш. Это проекции ключей и значений всех прошлых токенов; их размер ограничен лишь максимально допустимой длиной последовательности. Общий размер для токенов —
где — размерность головы, — число голов KV, — число слоёв, а 2 — потому что храним и ключи, и значения.
Он очень быстро становится большим даже при скромных батче и длине контекста. Для LLaMA-13B KV-кэш одной последовательности длиной 8192 в bf16 —
Всего 4 таких кэша превышают память параметров! Справедливости ради, LLaMA 2 не оптимизировали по размеру KV-кэша на длинном контексте (обычно всё не так плохо: как правило, гораздо меньше, как в LLaMA-3), но пример показателен. Пренебрегать ими в оценках памяти и задержки нельзя.
Моделируем пропускную способность и задержку LLaMA 2-13B
Заголовок раздела «Моделируем пропускную способность и задержку LLaMA 2-13B»Посмотрим, что будет, если идеально эффективно выполнять генерацию на 8 TPU v5e с разными размерами батча, вплоть до выведенного ранее критического батча (240) ради максимальной теоретической пропускной способности.
| Размер батча | 1 | 8 | 16 | 32 | 64 | 240 |
|---|---|---|---|---|---|---|
| Память KV-кэша (ГиБ) | 6,7 | 53,6 | 107,2 | 214,4 | 428,8 | 1608 |
| Всего памяти (ГиБ) | 32,7 | 79,6 | 133,2 | 240,4 | 454,8 | 1634 |
| Теоретическое время шага (мс) | 4,98 | 12,13 | 20,30 | 36,65 | 69,33 | 249,09 |
| Теоретическая пропускная способность (токенов/с) | 200,61 | 659,30 | 787,99 | 873,21 | 923,13 | 963,53 |
8 TPU v5e дают 128 ГиБ HBM, 6,5 ТиБ/с пропускной способности HBM (по 0,82 ТиБ/с) и 1600 TFLOPs/s вычислений.
Для этой модели увеличение батча действительно повышает пропускную способность, но отдача быстро убывает. При батче больше 16 память кончается (OOM), а чтобы приблизиться к 240, нужно на порядок больше памяти. Большая топология может улучшить задержку, но в пропускную способность на чип мы упёрлись.
Допустим, число параметров то же, но KV-кэш волшебным образом стал в 5 раз меньше (например, с GMQA 1:5, то есть 8 голов KV на 40 голов Q — подробнее в следующем разделе).
| Размер батча | 1 | 8 | 16 | 32 | 64 | 240 |
|---|---|---|---|---|---|---|
| Память KV-кэша (ГиБ) | 1,34 | 10,72 | 21,44 | 42,88 | 85,76 | 321,6 |
| Всего памяти (ГиБ) | 27,34 | 36,72 | 47,44 | 68,88 | 111,76 | 347,6 |
| Теоретическое время шага (мс) | 4,17 | 5,60 | 7,23 | 10,50 | 17,04 | 52,99 |
| Теоретическая пропускная способность (токенов/с) | 239,94 | 1 429,19 | 2 212,48 | 3 047,62 | 3 756,62 | 4 529,34 |
С меньшим KV-кэшем отдача всё равно убывает, но теоретическая пропускная способность на чип продолжает расти до батча 240. Помещается гораздо больший батч — 64, и задержка стабильно лучше при любом батче. Задержка, максимальная пропускная способность и максимальный батч резко улучшаются! На самом деле следующие поколения LLaMA использовали именно эту оптимизацию: у LLaMA-3 8B 32 головы запросов и 8 голов KV.
Приёмы повышения пропускной способности и снижения задержки генерации
Заголовок раздела «Приёмы повышения пропускной способности и снижения задержки генерации»Со времени оригинальной статьи Attention is All You Need придумано много приёмов, делающих модель эффективнее, — часто они нацелены именно на KV-кэш. Вообще говоря, меньший KV-кэш позволяет увеличивать батч и длину контекста на шаге генерации без ущерба для задержки и облегчает жизнь системам вокруг трансформера (например, кэшированию запросов). Если не учитывать влияние на качество, это:
Групповое внимание с несколькими запросами (GMQA, GQA). Можно уменьшить число голов KV и разделить их между многими головами Q. В крайнем случае одну голову KV можно разделить между всеми головами Q. Это уменьшает KV-кэш во столько раз, каково отношение Q:KV, по сравнению с чистым MHA, и замечено, что качество моделей к этому изменению сравнительно нечувствительно. Это также фактически повышает арифметическую интенсивность вычисления внимания (см. вопрос 4 в главе 4).
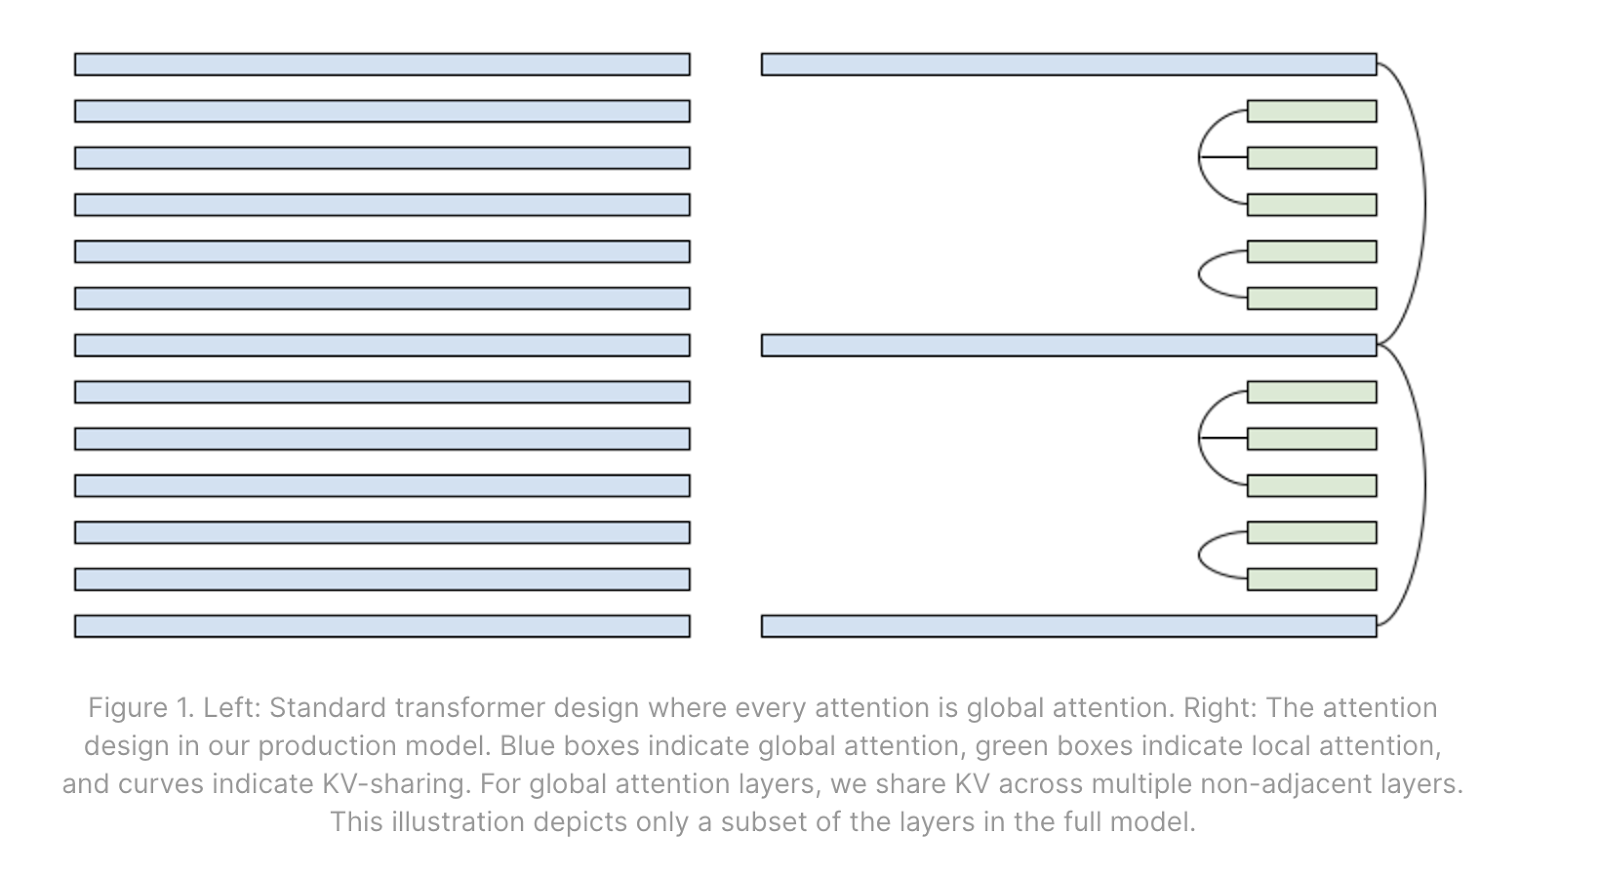
Подмешивание слоёв локального внимания. Локальное внимание ограничивает контекст небольшой или средней максимальной длиной. При обучении и prefill это значит маскировать матрицу внимания диагональной полосой вместо треугольника. Это фактически ограничивает максимальную длину KV-кэша локальных слоёв. Подмешав в модель несколько локальных слоёв к глобальным, можно сильно уменьшить KV-кэш на контекстах длиннее локального окна.
Общие KV между слоями. Модель может научиться делить одни и те же KV-кэши между слоями по какому-то шаблону. Это уменьшает размер KV-кэша и помогает увеличить батч, кэширование, офлайн-хранение и т. д., но общие KV-кэши, возможно, придётся читать из HBM по нескольку раз, так что время шага не обязательно улучшится. (Рисунок в оригинале, kv-sharing.png, по блогу Character.ai: слева — несколько слоёв чисто глобального внимания, справа — чередование глобальных и локальных слоёв с общими KV у соседних слоёв.)
Квантование. Инференс обычно менее чувствителен к точности параметров и KV. Квантуя параметры и KV-кэш (например,
в int8, int4, fp8 и т. д.), можно сэкономить пропускную способность памяти на обоих, уменьшить батч, нужный, чтобы
выйти на roofline вычислений, и освободить память для больших батчей. Ещё одно преимущество квантования — даже если модель
не обучали с квантованием, его часто можно применить после обучения.
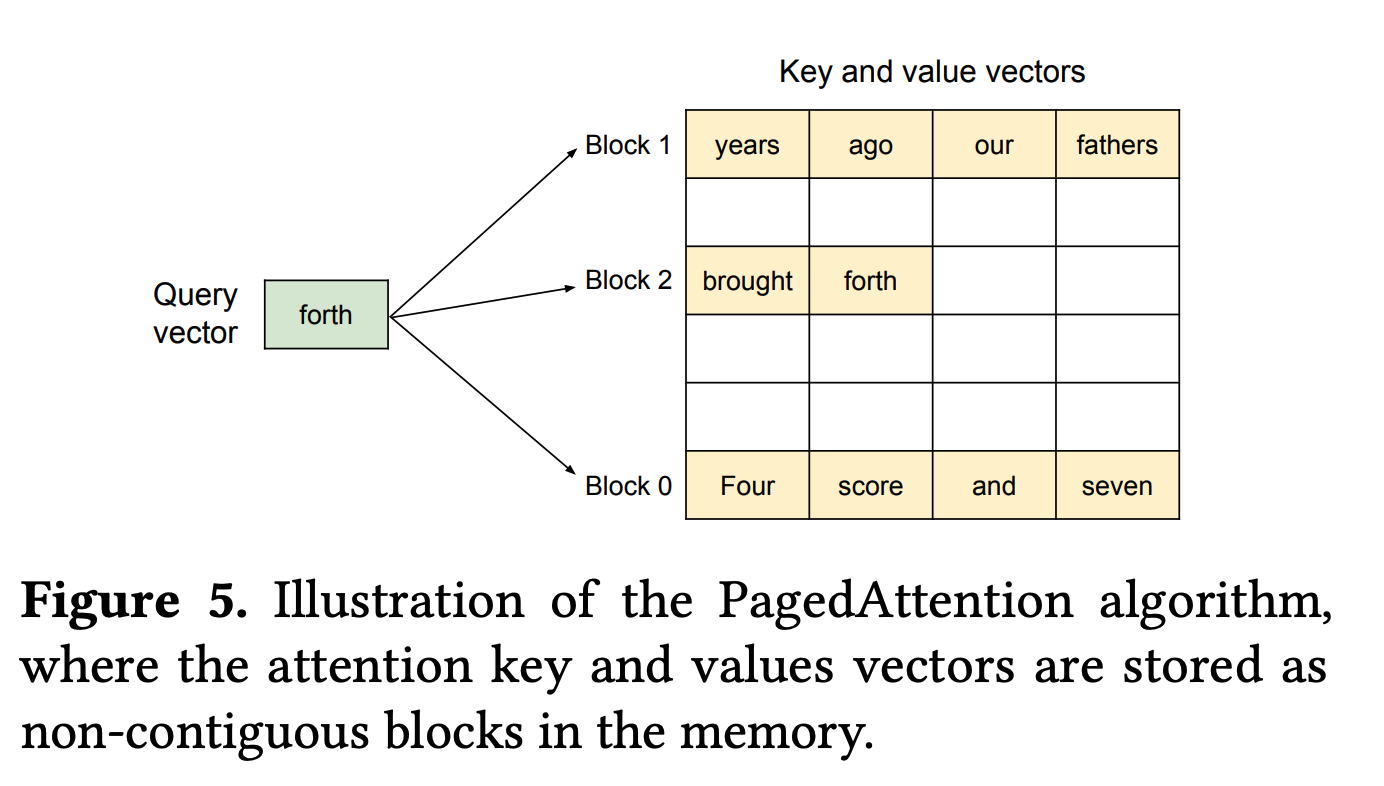
«Рваные» чтения HBM и Paged Attention. В расчётах выше мы отводили каждому KV-кэшу 8 тысяч контекста, но читать весь KV-кэш из памяти часто не нужно: длины запросов сильно различаются и не доходят до максимального контекста модели, так что часто можно реализовать ядра (например, варианты Flash Attention), читающие только непустую часть KV-кэша.
Paged Attention — развитие этой идеи: KV-кэши хранятся в таблицах страниц, как в операционной системе, и дополнение KV-кэшей почти полностью исчезает. Это добавляет много сложности, но зато каждый батч использует ровно столько памяти, сколько нужно. Это оптимизация времени выполнения, так что от архитектуры она снова не зависит. (Рисунок paged-attention.png из статьи о PagedAttention: при генерации один токен («forth») обращается к нескольким блокам-страницам KV-кэша.)
Распределённый инференс на нескольких ускорителях
Заголовок раздела «Распределённый инференс на нескольких ускорителях»До сих пор мы обходили вопрос, как масштабироваться за пределы одного чипа. Следуя главе 5, рассмотрим доступные стратегии и их компромиссы. Как всегда, prefill и генерацию разберём отдельно.
Prefill
Заголовок раздела «Prefill»С точки зрения roofline prefill почти идентичен обучению, и применимы почти все те же приёмы и компромиссы — параллелизм модели (Megatron), шардирование по последовательности (при достаточно длинном контексте), конвейеры, даже FSDP! Нужно лишь сохранять KV для последующей генерации. Как и при обучении, больше чипов — больше FLOPs/s (и, возможно, меньше TTFT), но и больше накладных расходов на связь (что может снизить пропускную способность на чип).
Общее правило шардирования prefill (считаем, что делаем prefill одной последовательности, без измерения батча):
- Шардирование модели. Обычно сначала делают какую-то долю параллелизма модели — до момента, когда упираемся в ICI. Как мы видели в главе 5, это около для 1 оси (обычно 4–8-путевое шардирование).
- Последовательностный параллелизм. Дальше — параллелизм по последовательности (как параллелизм данных, но с шардированием по измерению последовательности). Он добавляет немного связи во внимании, но на длинных контекстах она обычно невелика. Как и при обучении, связь и вычисления можно перекрыть (коллективными умножениями для Megatron и кольцевым вниманием соответственно).
Генерация
Заголовок раздела «Генерация»Генерация — зверь посложнее prefill. Во-первых, трудно получить большой батч: нужно объединять много запросов. Требования к задержке строже. Вместе это значит, что мы обычно сильнее упираемся в память и чувствительнее к накладным расходам на связь, а это ограничивает стратегии шардирования:
- FSDP невозможен. Мы упираемся в память, загружая параметры и KV-кэши из HBM в MXU, и не хотим перемещать их по ICI, которая на порядки медленнее HBM. Мы хотим перемещать активации, а не веса. Значит, методы вроде FSDP для генерации обычно совершенно неприменимы5.
- Параллелизм данных не имеет смысла. Чистый параллелизм данных бесполезен: он реплицирует параметры и не помогает загружать их быстрее. Лучше просто запустить несколько копий модели6.
- Нет последовательности — нет шардирования по последовательности. Удачи вам с шардированием по последовательности.
Для генерации плотных моделей остаются в основном варианты шардирования модели. Как и при prefill, проще всего — обычный параллелизм модели (активации полностью реплицированы, веса MLP полностью шардированы по скрытому измерению) до 4–8 частей, когда упираемся в ICI. Но поскольку мы часто упираемся в пропускную способность памяти, этот предел можно даже превысить, чтобы улучшить задержку!
О пределах ICI при генерации. При обучении мы хотим упираться в вычисления, поэтому roofline смотрит, когда связь ICI длится дольше FLOPs. Но при генерации, если мы упираемся в пропускную способность памяти при загрузке параметров, можно увеличить шардирование модели сверх этого предела и улучшить задержку при минимальной потере пропускной способности (в токенах/с на чип). Больше шардирование модели — больше HBM, по которой загружаются веса, а FLOPs не важны7. Посмотрим, насколько можно увеличить параллелизм модели, прежде чем он станет узким местом.
где . Для TPU v5e и TPU v6e это число обычно около 8. Значит, например, при = 16 384
и = 32 теоретически можно делать параллелизм модели вплоть до 16384 / (32 * 8) = 64 частей без заметной потери
пропускной способности. Это предполагает, что KV-кэши можно полностью шардировать на 64 части, а это трудно: об этом ниже.
Для слоя внимания мы также шардируем и по головам в стиле Megatron. Веса KV довольно малы, и реплицировать их часто дешевле, чем шардировать больше чем на частей.
Шардирование KV-кэша
Заголовок раздела «Шардирование KV-кэша»Есть ещё одна структура данных, которую нужно шардировать, — KV-кэш. И снова мы почти всегда избегаем реплицировать кэш, поскольку он — главный источник задержки внимания. Для этого сначала шардируем KV по измерению голов в стиле Megatron. Это ограничено частями, так что для моделей с малым числом голов мы шардируем измерение голов сколько возможно, а затем — по измерению батча: . Так KV-кэш полностью распределён.
Цена — два AllToAll на каждом слое внимания: один переводит активации Q в шардирование по батчу, чтобы считать внимание с шардированием по батчу, а второй возвращает шардированный по батчу выход внимания к чистому шардированию модели. (В оригинале приведён полный алгоритм из 12 шагов и рисунок esta-figure.png, сравнивающий многоголовое внимание с чистым шардированием модели и внимание с одним ключом с шардированием KV-кэша по батчу. Новая связь умеренно дорога, ведь она работает с маленькими активациями, а взамен экономится огромная пропускная способность памяти на загрузке KV, которые остаются на месте.)
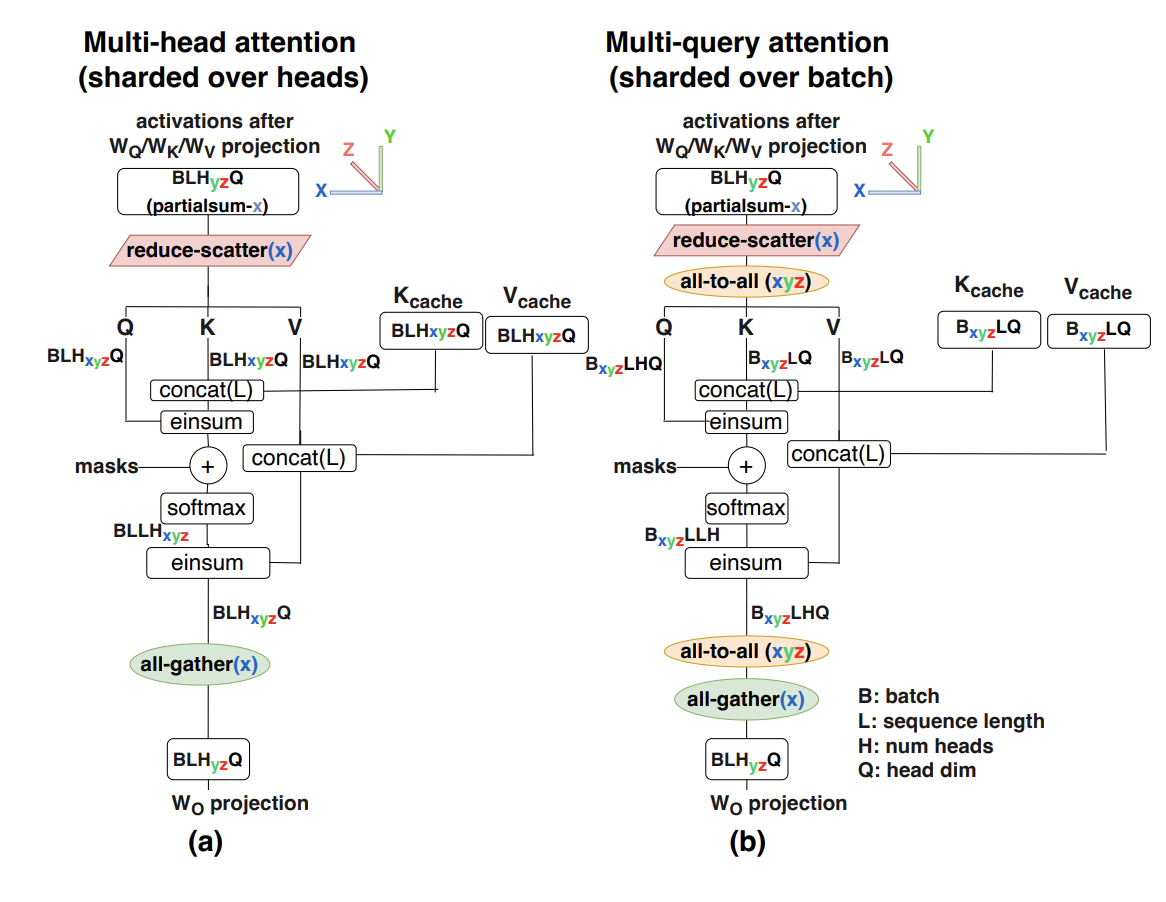
- Шардирование по последовательности. Если батч слишком мал или контекст длинный, KV-кэш можно шардировать по последовательности. И здесь мы платим коллективной операцией за накопление внимания по шардам: сначала собираем AllGather активации Q, затем накапливаем KV похожим на Flash Attention способом.
Как устроить эффективный движок инференса
Заголовок раздела «Как устроить эффективный движок инференса»До сих пор мы рассматривали, как по отдельности оптимизировать и шардировать операции prefill и генерации. Чтобы реально эффективно их использовать, нужен движок инференса, который будет подавать работу в эти две операции в выбранной точке Парето-фронта «задержка — пропускная способность».
Проще всего — выполнить батч prefill, затем батч генераций.
Рисунок в оригинале (batched-prefill.png): в простейшей схеме запросы собираются, и сервер чередует батч prefill и вызов функции генерации до завершения всех последовательностей.
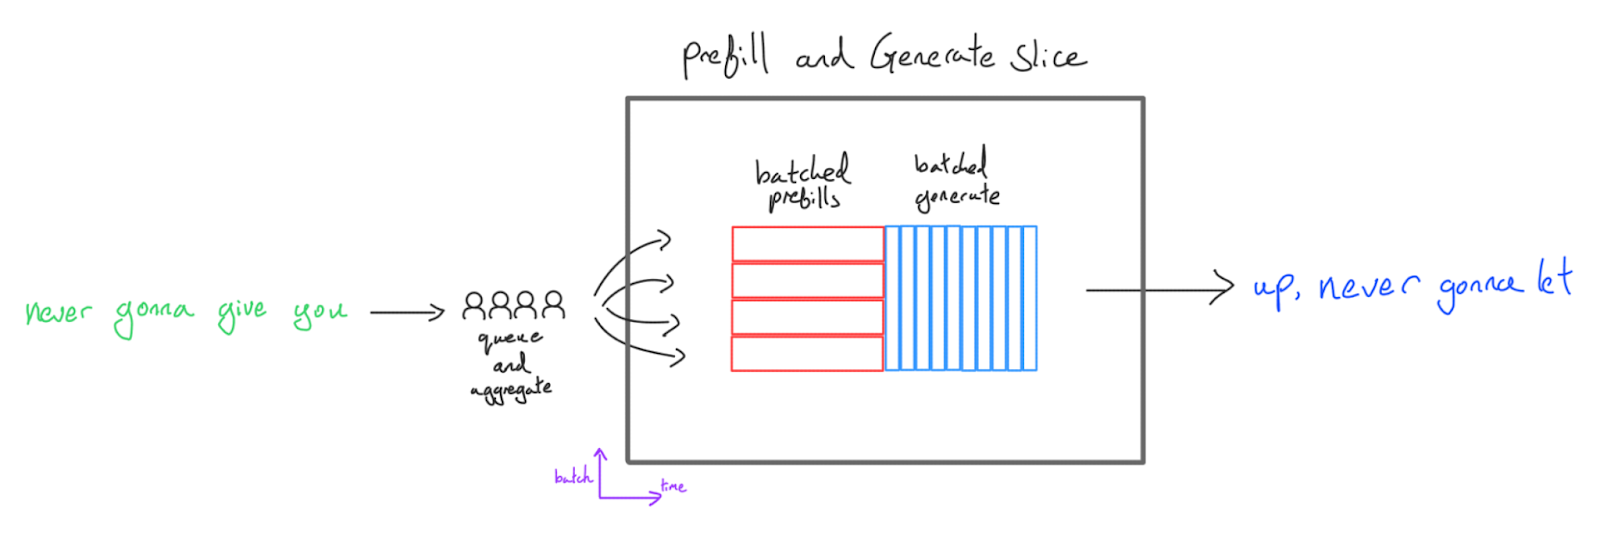
Это легко реализовать, и с этого начинается инференс в большинстве кодовых баз, но недостатков несколько:
- Задержка ужасна. Размеры батча prefill и генерации связаны. Время до первого токена (TTFT) ужасно при больших батчах prefill: нужно закончить все prefill, прежде чем хоть один пользователь увидит хоть один токен. Пропускная способность генерации ужасна при маленьких батчах.
- Короткие генерации блокируются длинными. Многие последовательности заканчиваются раньше других, оставляя в батче генерации пустые места и ещё сильнее снижая пропускную способность. Проблема усугубляется с ростом батча и длины генерации.
- Prefill дополняется. Prefill дополняется до самой длинной последовательности, и много вычислений пропадает. У этого есть решения, но исторически в XLA было довольно трудно пропускать эти FLOPs. И снова — чем больше батч и длина prefill, тем хуже.
- Prefill и генерация вынуждены делить шардирование. Оба живут на одном срезе, а значит, используют одну топологию и шардирование (если не держать две копии весов), что обычно плохо для производительности: например, генерации нужно гораздо больше шардирования модели.
Поэтому этот метод рекомендуется только для инференса на устройстве (там обычно обслуживают одного пользователя на железе с меньшим отношением FLOPs/байт) и для быстрой итерации на ранних этапах жизни кодовой базы трансформера (из-за простоты).
Чуть лучше — делать prefill с батчем 1 (там он упирается в вычисления, но задержка разумная), а при генерации объединять несколько запросов в батч (interleaving.png в оригинале).
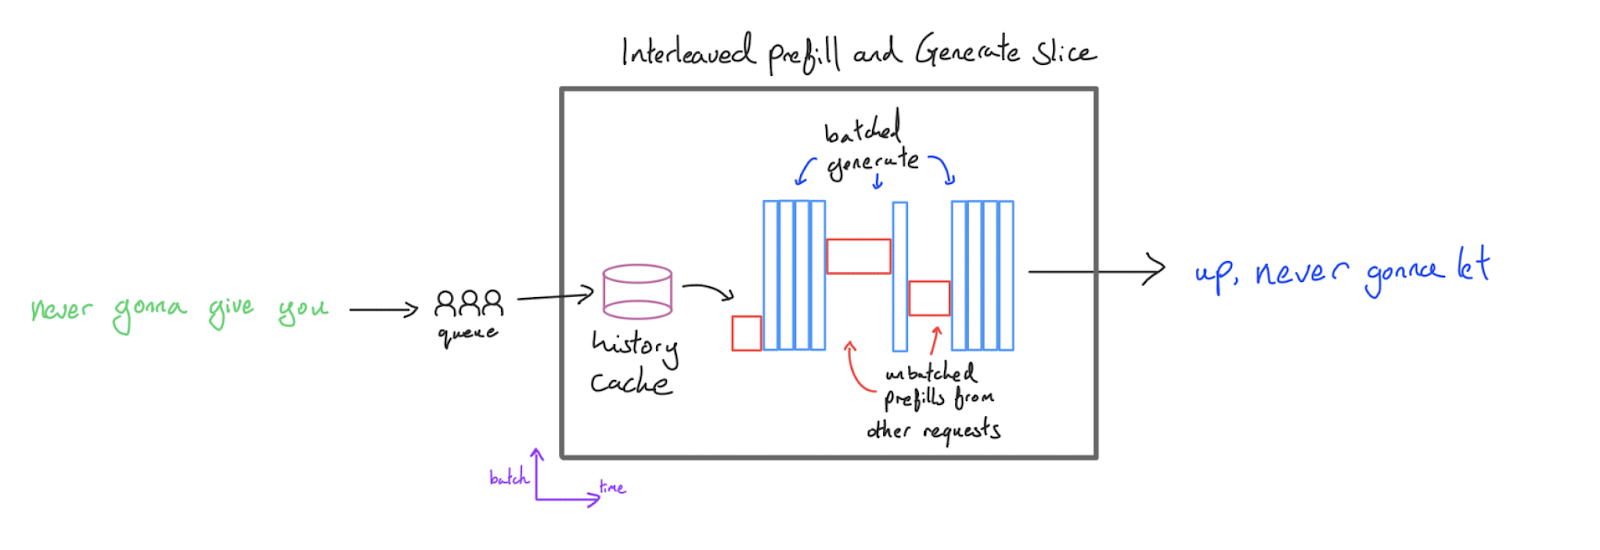
Так мы не теряем TTFT на батчевом prefill и сохраняем высокую пропускную способность генерации. Такую конфигурацию называют чередующейся (interleaved): шаги prefill и генерации «чередуются». Это очень сильный подход для массовой генерации вроде оценок, где главное — пропускная способность. Оркестратор можно настроить так, чтобы он выполнял prefill, как только в генерации освобождается место, и загрузка остаётся высокой даже при очень больших батчах генерации. Можно также не дополнять prefill до максимальной длины, ведь он не объединяется в батч с другими запросами.
Главный недостаток: пока сервер выполняет prefill, генерация всех остальных запросов останавливается — все вычислительные ресурсы заняты prefill. Пользователь A, чей ответ сейчас декодируется, будет заблокирован prefill пользователя B. Значит, хотя TTFT улучшился, генерация токенов в среднем будет рваной и медленной, а для многих приложений это плохой пользовательский опыт: чужие prefill оказываются на критическом пути задержки запроса.
Чтобы обойти это, декодирование и prefill разделяют. Хотя инференс трансформера можно выполнять на одном сервере, с точки зрения задержки часто лучше выполнять две разные задачи на двух наборах TPU/GPU. Серверы prefill порождают KV-кэши, которые по сети отправляются на серверы генерации, а те объединяют несколько кэшей в батч и порождают токены для каждого. Это называют раздельным (disaggregated) обслуживанием (disaggregation.png в оригинале).
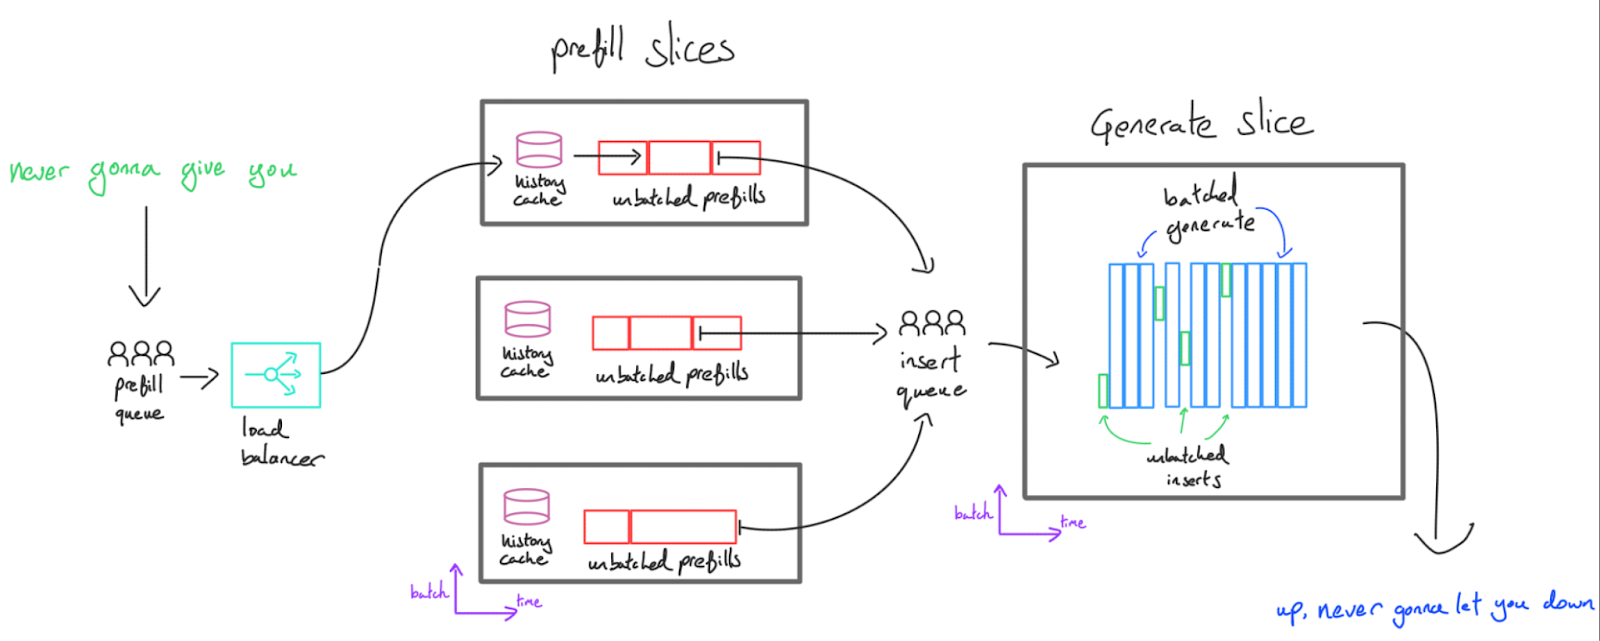
Преимущества:
- Низкая задержка в масштабе. Запрос одного пользователя никогда не блокируется запросом другого, разве что не хватает мощностей prefill. Запрос сразу проходит prefill, затем отправляется на сервер генерации и сразу встаёт в буфер генерации. Если ожидается много одновременных запросов, число серверов prefill можно масштабировать независимо от числа серверов генерации, чтобы пользователи не застревали в очереди prefill надолго.
- Специализация. Довольно часто оптимальные по задержке стратегия шардирования параметров и топология железа для prefill и генерации сильно различаются (например, больше параллелизма модели полезно для генерации, но не для prefill). Если заставить обе операции использовать одно шардирование, пострадают обе, а две копии весов занимают память. К тому же, вынеся prefill на отдельный сервер, ему не нужно хранить никаких KV-кэшей, кроме того, что обрабатывается сейчас. Значит, гораздо больше памяти свободно для кэширования истории (см. следующий раздел) или для оптимизации задержки prefill.
Один минус — KV-кэш теперь нужно передавать по сети. Обычно это приемлемо, но это ещё один довод в пользу уменьшения KV-кэша.
Непрерывный батчинг
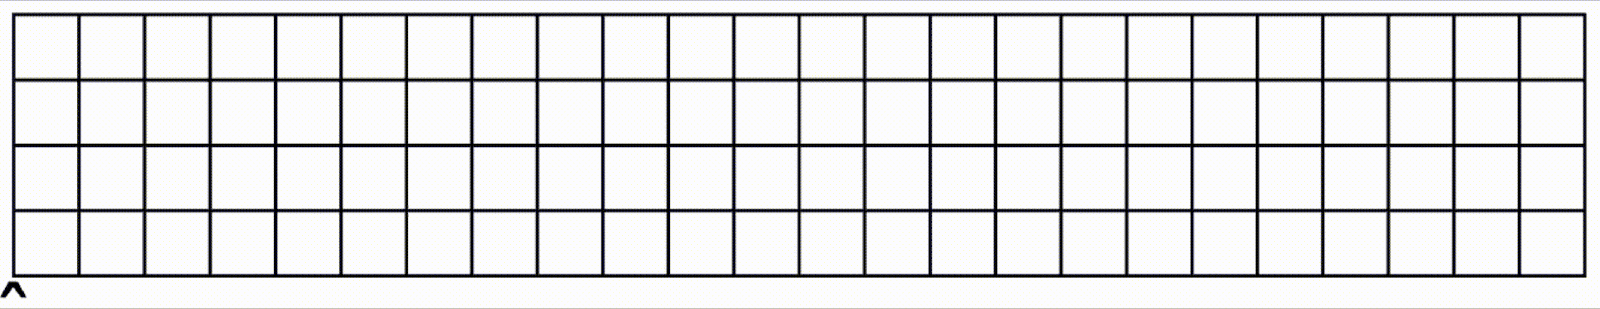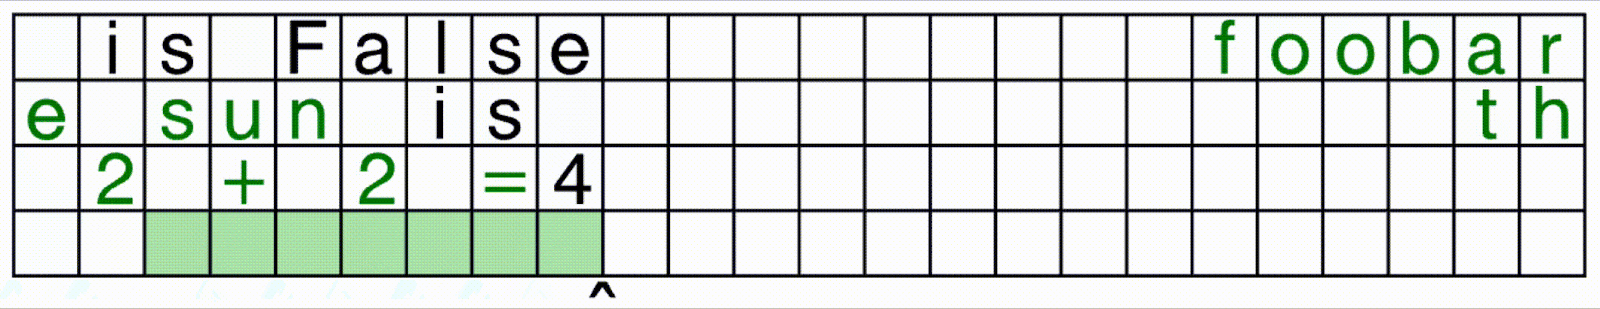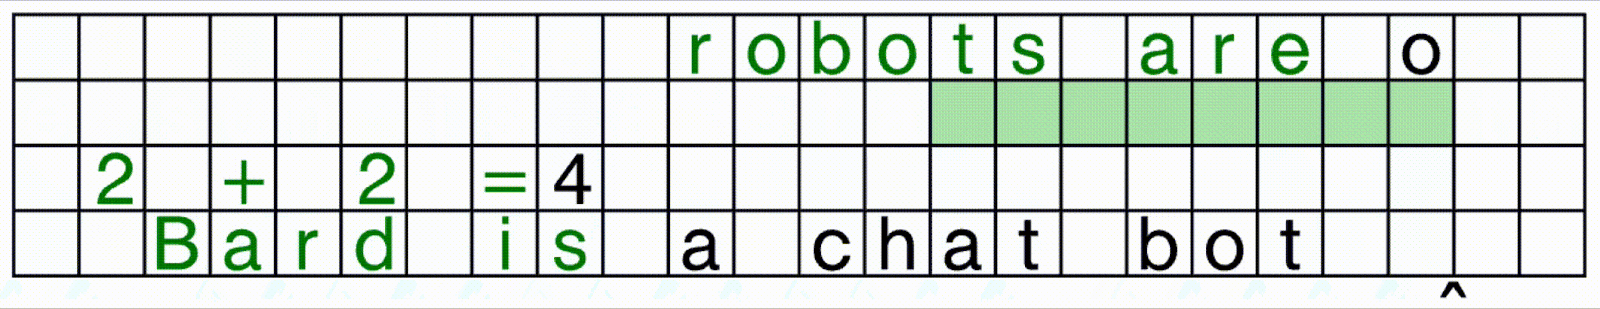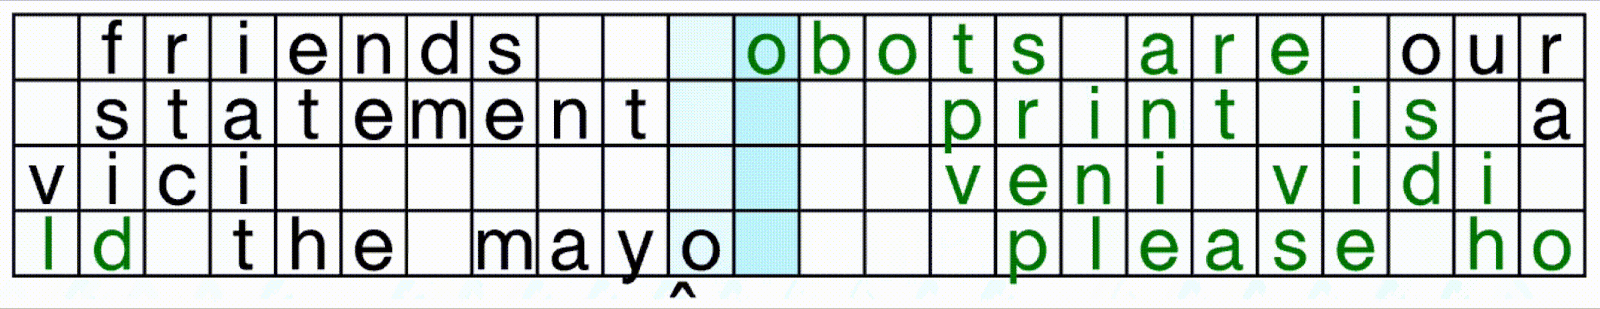
Заголовок раздела «Непрерывный батчинг»Проблема (2) выше ведёт к идее непрерывного батчинга (continuous batching). Мы оптимизируем и компилируем:
- функцию prefill, которая обрабатывает контекст переменной длины и вставляет результаты в буфер KV с некоторым максимальным батчем и длиной контекста / числом страниц;
- функцию генерации, которая принимает KV-кэш и выполняет шаг генерации для всех активных сейчас запросов.
Затем объединяем эти функции с оркестратором, который ставит входящие запросы в очередь, вызывает prefill и генерацию в зависимости от свободных мест в генерации, ведёт кэширование истории (см. следующий раздел) и отдаёт токены потоком. (Анимация в оригинале — continuous-batching.gif.)
Кэширование префиксов
Заголовок раздела «Кэширование префиксов»Prefill дорог и упирается в вычисления (запаса у нас меньше), поэтому один из лучших способов удешевить его — делать его поменьше. Поскольку LLM авторегрессионны, запросы [“I”, “like”, “dogs”] и [“I”, “like”, “cats”] дают KV-кэши, одинаковые в первых двух токенах. Значит, в принципе, если сначала вычислить кэш «I like dogs», а затем кэш «I like cats», нужно сделать лишь 1/3 вычислений. Большую часть работы можно сэкономить, переиспользуя кэш. Это особенно сильно в нескольких случаях:
- Чат-боты: большинство разговоров с чат-ботом — диалог «туда-обратно», который только дописывается в конец. Значит, если сохранять KV-кэши после каждой реплики, можно пропускать вычисления для всего, кроме самых новых токенов.
- Промпты с примерами (few-shot): любой промпт с примерами можно сохранить и переиспользовать бесплатно. Системные инструкции часто тоже имеют такой вид.
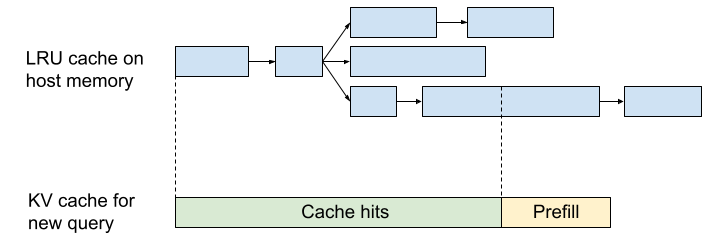
Единственное, что мешает, — ограничения памяти. Как мы видели, KV-кэши большие (часто много гигабайт), и, чтобы кэширование было полезным, их нужно хранить до прихода следующего запроса. Обычно любую неиспользуемую HBM на серверах prefill можно отдать под локальную систему кэширования. Кроме того, у ускорителей обычно много памяти на хостах с процессорами (например, у сервера 8xTPUv5e 128 ГиБ HBM, но около 450 ГиБ DRAM хоста). Эта память гораздо медленнее HBM — обычно слишком медленна для шагов генерации, — но достаточно быстра для чтения кэша. На практике:
- KV-кэш локален для набора TPU, обработавшего исходный запрос, поэтому нужна какая-то маршрутизация с привязкой (affinity routing), чтобы последующие запросы приходили на ту же реплику. Это может мешать балансировке нагрузки.
- Меньший KV-кэш (снова) помогает: в том же объёме помещается больше кэшей, и читаются они быстрее.
- KV-кэш и поиск по нему естественно хранить в дереве или префиксном дереве (trie). Вытеснение — по принципу LRU (давно неиспользуемые удаляются первыми). (Рисунок prefix-caching-trie.png по блогу Character.ai: кэш префиксов KV в виде LRU-дерева, общие префиксы не дублируются.)
Пример реализации: JetStream
Заголовок раздела «Пример реализации: JetStream»Google открыла библиотеку JetStream, реализующую эту логику. На сервере есть набор «движков prefill» и «движков генерации», обычно на разных срезах TPU, которыми управляет один контроллер. Prefill происходит в «потоке prefill», генерация — в «потоке генерации», а «поток передачи» организует копирование KV-кэшей со срезов prefill на срезы генерации.
Интерфейс Engine — общий интерфейс, который должна предоставить любая LLM. Ключевые методы:
- prefill: принимает набор входных токенов и порождает KV-кэш;
- insert: принимает KV-кэш и вставляет его в батч KV-кэшей, из которых идёт генерация;
- generate: принимает набор объединённых в батч KV-кэшей и порождает по одному токену на элемент батча, дописывая KV одного токена в состояние декодирования каждого элемента.
Есть и версия JetStream на PyTorch — jetstream-pytorch.
Спекулятивное сэмплирование (приложение D, кратко)
Заголовок раздела «Спекулятивное сэмплирование (приложение D, кратко)»Пересказ приложения «Speculative Sampling».
Когда очень важна сквозная задержка, есть ещё один приём — спекулятивное сэмплирование. Вместо того чтобы порождать токены большой моделью по одному, дешёвая маленькая модель-«черновик» (drafter) жадно порождает токенов, а большая модель за один прямой проход считает логиты для всех них сразу. При жадном декодировании проверка проста: принимаем самый длинный префикс, где токен черновика совпадает с самым вероятным токеном большой модели, первый неверный токен заменяем правильным; если верны все — по последнему логиту бесплатно сэмплируем ещё один токен.
Почему это выигрыш в задержке? FLOPs большой модели на каждый токен столько же, но генерация упирается в память, а не в вычисления, поэтому проверить несколько токенов за один проход — почти бесплатно. Каждый принятый токен в среднем дороже по FLOPs (часть отвергается, плюс вызов черновика), но железо используется полнее, а KV-кэш читается один раз на несколько шагов — так что на длинном контексте это может быть выигрышем и по пропускной способности. Поскольку всё проверено большой моделью, распределение сэмплирования не меняется. Черновиком может быть маленькая модель того же семейства, n-граммы или отдельная «голова-черновик» внутри самой модели (EAGLE, Medusa, MTP в DeepSeek-V3 — урок «Multi-Token Prediction»). По рисунку в оригинале для Chinchilla 70B с черновиком на 4B: на XSum оптимально угадывать 3–4 токена вперёд, а более предсказуемый код (HumanEval) выигрывает от более агрессивного угадывания. Для недетерминированного сэмплирования используется приём, вдохновлённый алгоритмом Метрополиса–Гастингса.
Задачи главы 7 (в оригинале, с ответами) разбирают, в частности: размер KV-кэша и минимальное время шага для конкретных моделей и топологий, предел параллелизма модели при генерации, стоимость prefill и генерации, обоснование правила «батч больше 240» (приложение A), двумерное шардирование весов (приложение B) и связь, ограниченную задержкой (приложение C).
Глава 8 в кратком изложении: обслуживание LLaMA 3-70B на TPU
Заголовок раздела «Глава 8 в кратком изложении: обслуживание LLaMA 3-70B на TPU»Пересказ с переводом выводов главы «Serving LLaMA 3-70B on TPUs».
На чём обслуживать? На том, что дешевле в FLOPs за доллар. По ценам Google Cloud на февраль 2025: H100 — 9,9e14 FLOPs/s за 10,8 долл./ч (3,3e17 FLOPs на доллар), TPU v5p — 4,59e14 за 4,2 долл./ч (3,9e17), TPU v5e — 1,97e14 за 1,2 долл./ч (5,8e17). Поэтому авторы выбирают TPU v5e с его 16 ГБ HBM на чип — модель придётся шардировать довольно агрессивно.
KV-кэш LLaMA 3-70B (8 голов KV, int8): кБ на токен. При длине 32 тысячи токенов — 5,3 ГБ на последовательность, при батче 240 — 1,3 ТБ; чтобы просто уместить это, нужно около 86 чипов TPU v5e. Для сравнения: параметры — 70 ГБ.
Главные выводы главы 8:
- Задержку декодирования всегда можно оценить снизу временем загрузки всех параметров модели из HBM в MXU. Когда KV-кэши малы, каждый слой можно представлять как загрузку весов кусками с последующим выбрасыванием. Если нет больших батчей или интенсивной связи между устройствами, эта граница обычно верна с точностью до 1,5 раза. При больших батчах нужно моделировать и загрузку KV-кэша — она доминирует над параметрами.
- Самая маленькая топология не всегда самая производительная, если мы ограничены размером KV-кэша: большая топология даёт место для большего батча.
- Обслуживать модель на срезе 4×8 с чистым параллелизмом модели не получится; лучшее — 4×2 или, может быть, 4×4. Максимальная полезная степень параллелизма модели зависит от и числа осей, по которым шардируется модель, и обычно лежит между 8 и 32. За этот предел можно выходить ради задержки ценой части пропускной способности.
- Для LLaMA 3-70B почти во всех конфигурациях мы сильно упираемся в пропускную способность памяти при чтении KV-кэша (и в объём HBM) — это показывает, насколько важно уменьшать KV-кэш для пропускной способности генерации. Компромисс «задержка — пропускная способность» остаётся очень резким.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| prefill / generation (decode) | prefill (обработка промпта) / генерация (декодирование) |
| KV cache | KV-кэш (кэш ключей и значений) |
| TTFT (time to first token), per-token latency | время до первого токена, задержка на токен |
| throughput / latency, Pareto frontier | пропускная способность / задержка, Парето-фронт |
| offline batch inference, edge inference | офлайн-инференс батчами, инференс на устройстве |
| critical batch size | критический размер батча |
| GQA / GMQA, local attention, KV sharing | групповое внимание, локальное внимание, общие KV между слоями |
| ragged reads, Paged Attention | «рваные» чтения, страничное внимание |
| disaggregated serving | раздельное обслуживание (prefill и decode на разных серверах) |
| interleaved configuration | чередующаяся конфигурация |
| continuous batching | непрерывный батчинг |
| prefix caching, affinity routing, LRU | кэширование префиксов, маршрутизация с привязкой, вытеснение давно неиспользуемых |
| speculative sampling, drafter | спекулятивное сэмплирование, модель-черновик |
Footnotes
Заголовок раздела «Footnotes»-
Исторически удивительно много исследований трансформеров можно было сделать, вообще не касаясь инференса: бенчмарки с выбором ответа по оценкам (scoring) можно эффективно прогнать без нормального KV-кэша или цикла генерации. Поэтому, особенно в исследовательских кодовых базах, в коде инференса часто много «низко висящих плодов». ↩
-
В этой главе вы заметите, что инференс гораздо менее снисходителен, чем обучение. Обычно FLOPs гораздо меньше, возможностей для батчинга меньше, а чувствительность к задержке гораздо выше. KV-кэши тоже резко усложняют инференс. ↩
-
Мы заметно упрощаем, игнорируя FLOPs не-умножений в softmax, масках и т. д. Их нужно перекрывать с вычислениями или чтениями HBM, но на некоторых поколениях TPU это нетривиально. Главного вывода — KV-кэши обычно упираются в память — эти детали не меняют, но обращать на них внимание стоит. ↩
-
Особенно благодаря Flash Attention, которая не материализует матрицу внимания. ↩
-
Случайно оставить его включённым после обучения — простой и частый способ получить замедление на порядок. ↩
-
То есть запустить несколько серверов с копиями модели при меньшем батче. Параллелизм данных на уровне модели строго хуже. ↩
-
В том смысле, что время FLOPs не узкое место, так что беспокоиться нужно о том, чтобы время ICI не превысило время загрузки параметров. ↩