Diffusion Models Course, юнит 4: продвинутые техники, инверсия DDIM и диффузия для звука
Перевод юнита 4 курса Hugging Face о диффузионных моделях: дистилляция для быстрого сэмплирования, улучшения обучения, редактирование изображений, видео и звук, DiT и «итеративное уточнение», а также ноутбуки об инверсии DDIM и о дообучении аудиодиффузии на спектрограммах.
Это перевод юнита 4 курса Diffusion Models Course: вводный текст юнита (обзор исследований) и два ноутбука — «DDIM Inversion» и «Diffusion for Audio». Предыдущий юнит — Stable Diffusion; этот юнит в курсе последний. Карта курса — в README оригинала.
Юнит 4: идём дальше с диффузионными моделями
Заголовок раздела «Юнит 4: идём дальше с диффузионными моделями»Добро пожаловать в юнит 4 курса Hugging Face о диффузионных моделях! В этом юните мы посмотрим на некоторые из многочисленных улучшений и расширений диффузионных моделей, которые появляются в свежих исследованиях. Кода здесь меньше, чем в предыдущих юнитах: юнит задуман как стартовая площадка для ваших дальнейших исследований.
Начинаем юнит 🚀
Заголовок раздела «Начинаем юнит 🚀»Шаги этого юнита:
- Убедитесь, что записались на курс, чтобы получать уведомления о новых юнитах.
- Прочитайте материал ниже — обзор тем этого юнита.
- Углубитесь в интересные вам темы с помощью видео и материалов по ссылкам.
- Изучите демонстрационные ноутбуки, а затем прочитайте раздел «Что дальше?» с идеями проектов.
📢 Не забудьте присоединиться к Discord, где можно обсуждать материал и
делиться тем, что получилось, в канале #diffusion-models-class.
(Оглавление оригинала мы опускаем — на сайте оно справа от текста.)
Быстрое сэмплирование через дистилляцию
Заголовок раздела «Быстрое сэмплирование через дистилляцию»Прогрессивная дистилляция (progressive distillation) — техника, которая берёт готовую диффузионную модель и с её помощью обучает новую версию модели, которой для инференса нужно меньше шагов. Модель-«ученик» инициализируется весами модели-«учителя». При обучении учитель делает два шага сэмплирования, а ученик пытается получить тот же результат за один шаг. Этот процесс можно повторять много раз: ученик предыдущей итерации становится учителем на следующем этапе. В итоге получается модель, которая выдаёт приличные сэмплы за гораздо меньшее число шагов (обычно 4 или 8), чем исходный учитель. Основной механизм показан на схеме из статьи, в которой предложена эта идея:
(В оригинале — рисунок из статьи с подписью «Прогрессивная дистилляция в картинках»: детерминированный сэмплер, который за 4 шага проходит от шума к изображению, дистиллируется сначала в сэмплер на 2 шага, а затем — на 1 шаг.)
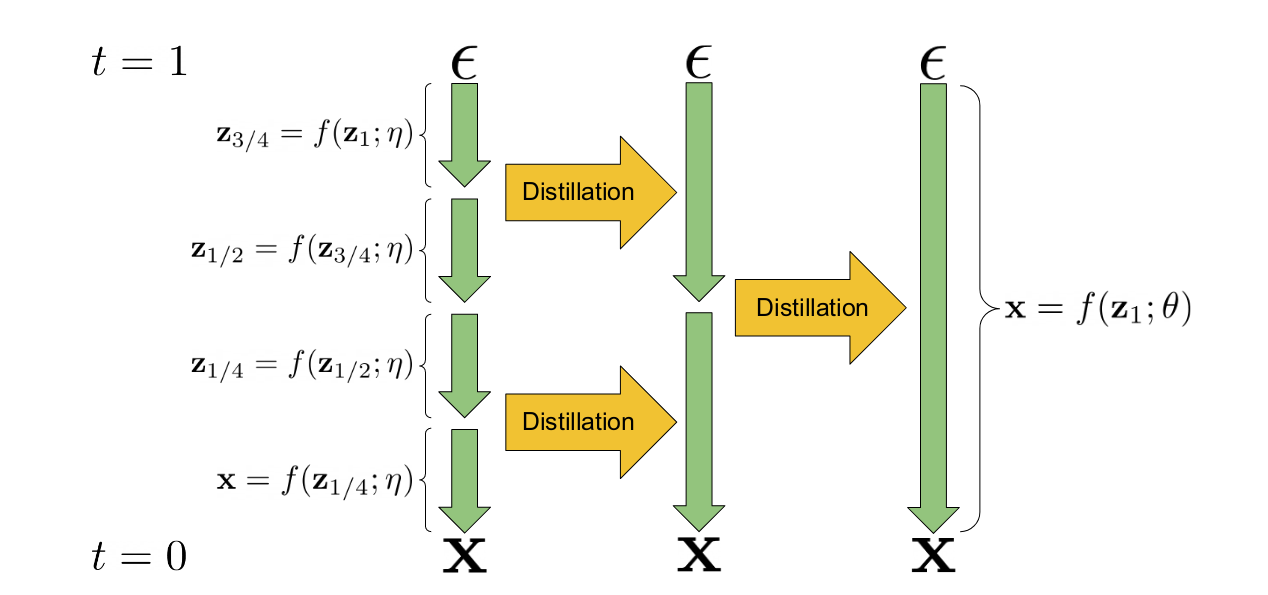
flowchart LR
T["Учитель<br/>N шагов"] -->|"ученик учится за 1 шаг<br/>делать то, что учитель за 2"| S1["Ученик 1<br/>N/2 шагов"]
S1 -->|"ученик становится<br/>учителем"| S2["Ученик 2<br/>N/4 шагов"]
S2 --> D["…"] --> F["4–8 шагов"]
(Пример с числами от переводчика: чтобы из 1024 шагов получить 4, нужно 8 этапов дистилляции: 1024 → 512 → 256 → 128 → 64 → 32 → 16 → 8 → 4.)
Идею «учить» новую модель с помощью готовой можно развить и получать модели с guidance: учитель применяет classifier-free guidance, а ученик должен научиться выдавать эквивалентный результат за один шаг, получая дополнительным входом нужный масштаб guidance. Это ещё сильнее сокращает число прогонов модели, необходимых для качественных сэмплов. Обзор подхода — в этом видео.
(«За один шаг» здесь значит «за один прогон сети». Без дистилляции classifier-free guidance на каждом шаге требует двух прогонов — с промптом и без, — и ученик учится заменять их одним.)
NB: дистиллированную версию Stable Diffusion можно попробовать здесь.
Ключевые работы:
- Progressive Distillation For Fast Sampling Of Diffusion Models («Прогрессивная дистилляция для быстрого сэмплирования диффузионных моделей»)
- On Distillation Of Guided Diffusion Models («О дистилляции диффузионных моделей с guidance»)
(Примечание переводчика: с 2023 года дистилляция стала обязательной частью почти каждой крупной модели. Появились consistency models и Latent Consistency Models (LCM), состязательная дистилляция (SDXL-Turbo), а у FLUX.1 [schnell] по умолчанию 4 шага. Обзор — в уроке 9.1.4.)
Улучшения обучения
Заголовок раздела «Улучшения обучения»Для улучшения обучения диффузионных моделей придумано ещё несколько трюков. В этом разделе мы постарались собрать главные идеи свежих статей. Исследования с новыми улучшениями выходят непрерывно, так что если вы видите статью, которую, по-вашему, стоит сюда добавить, — дайте нам знать!
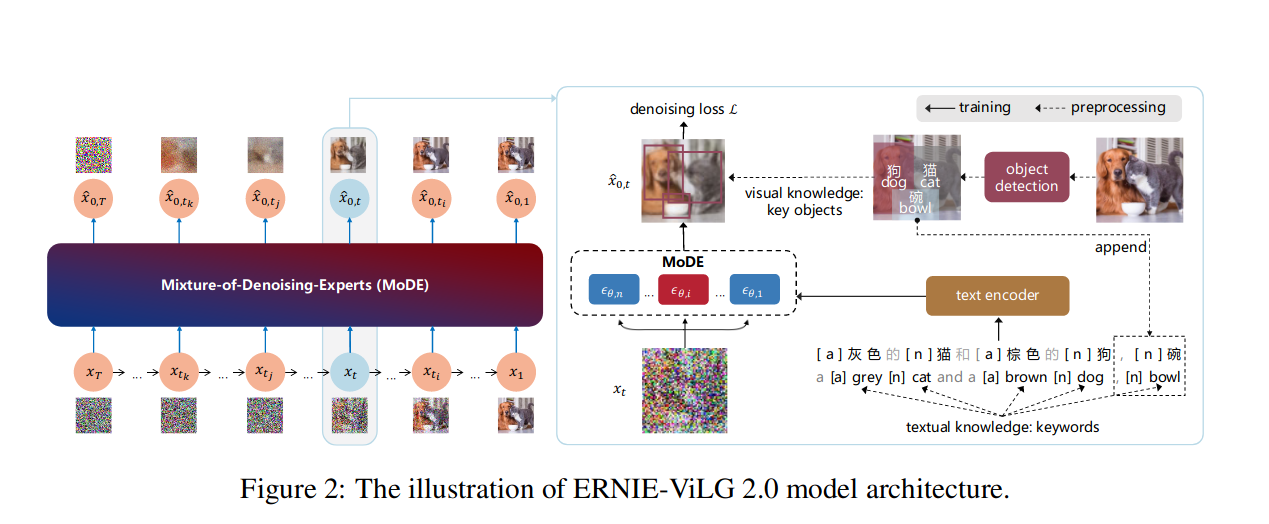
(В оригинале — рисунок 2 из статьи ERNIE-ViLG 2.0: общая схема модели, в которой к обучению добавлены знания о тексте и изображении, а удаление шума разделено по шагам между несколькими «экспертами»-денойзерами.)
Главные улучшения обучения:
- Настройка расписания шума (noise schedule), взвешивания функции потерь и траекторий сэмплирования для более эффективного обучения. Отличная статья, исследующая некоторые из этих проектных решений, — Elucidating the Design Space of Diffusion-Based Generative Models Карраса (Karras) и соавторов.
- Обучение на изображениях с разным соотношением сторон, как рассказано в этом видео с мероприятия по запуску курса.
- Каскадные диффузионные модели: одна модель обучается на низком разрешении, затем ещё одна или несколько моделей сверхразрешения (super-resolution). Так устроены DALL·E 2, Imagen и другие модели для генерации изображений высокого разрешения.
- Более качественное условие: богатые текстовые эмбеддинги (Imagen использует большую языковую модель T5) или несколько видов условий сразу (eDiffi).
- «Обогащение знаниями» (knowledge enhancement): в процесс обучения включаются предобученные модели для подписей к изображениям и для детекции объектов, чтобы получить более информативные подписи и лучшее качество (ERNIE-ViLG 2.0).
- «Смесь экспертов-денойзеров» (Mixture of Denoising Experts, MoDE): разные варианты модели («эксперты») обучаются для разных уровней шума, как на рисунке выше из статьи ERNIE-ViLG 2.0.
Ключевые работы:
- Elucidating the Design Space of Diffusion-Based Generative Models («Проясняем пространство проектных решений генеративных моделей на основе диффузии»)
- eDiffi: Text-to-Image Diffusion Models with an Ensemble of Expert Denoisers («eDiffi: диффузионные модели „текст → изображение“ с ансамблем денойзеров-экспертов»)
- ERNIE-ViLG 2.0: Improving Text-to-Image Diffusion Model with Knowledge-Enhanced Mixture-of-Denoising-Experts («ERNIE-ViLG 2.0: улучшаем диффузионную модель „текст → изображение“ смесью экспертов-денойзеров, обогащённой знаниями»)
- Imagen — Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding («Фотореалистичные диффузионные модели „текст → изображение“ с глубоким пониманием языка», демо-сайт)
(Примечание переводчика: ERNIE-ViLG 2.0 — модель китайской компании Baidu. Идея «экспертов по уровню шума»
вернулась в видеомодели Wan2.2 (Alibaba, 2025): там один эксперт работает на шумных ранних шагах и отвечает за
композицию, другой — на поздних шагах и отвечает за детали. Расписания из статьи Карраса (EDM) встроены в diffusers —
у многих планировщиков есть параметр use_karras_sigmas=True. Сильный текстовый кодировщик тоже стал нормой: SD3 и
FLUX используют T5, а Qwen-Image — мультимодальную модель Qwen2.5-VL.)
Больше контроля при генерации и редактировании
Заголовок раздела «Больше контроля при генерации и редактировании»Помимо улучшений обучения, появилось несколько нововведений на этапе сэмплирования и инференса, в том числе много подходов, которые добавляют новые возможности уже существующим диффузионным моделям.
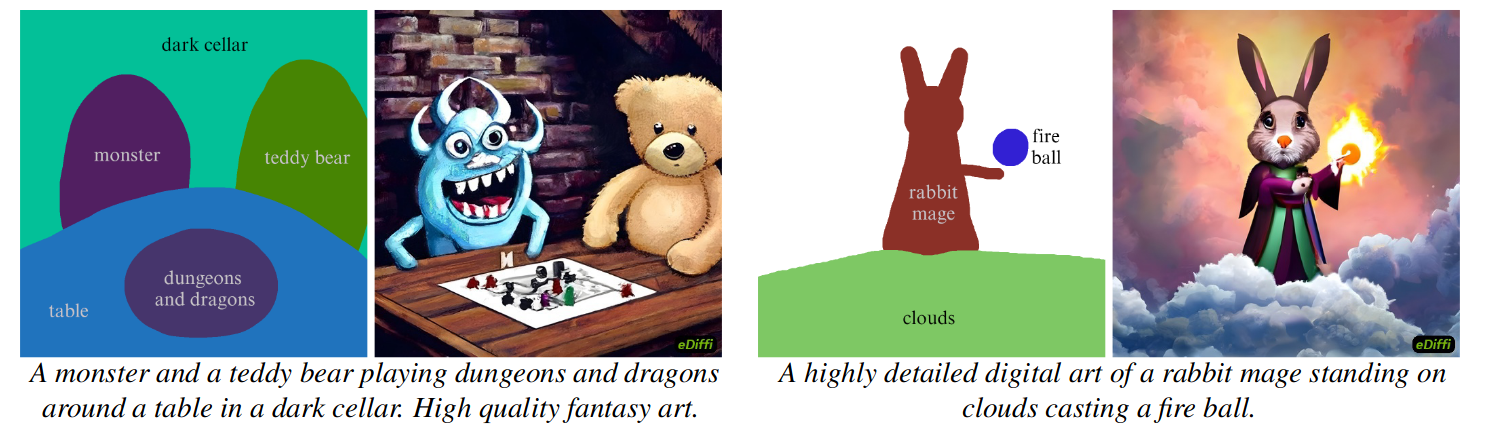
(В оригинале — сэмплы, созданные «рисованием словами» (paint-with-words) в eDiffi: пользователь закрашивает на холсте области и подписывает их словами из промпта, а модель рисует картинку, где названные объекты стоят в этих местах.)
Видео «Editing Images with Diffusion Models» («Редактирование изображений диффузионными моделями») даёт обзор разных методов редактирования существующих изображений диффузионными моделями. Доступные техники можно разделить на четыре основные категории.
- Добавить шум, а затем удалить его с новым промптом. Это идея конвейера
img2img, которую изменяли и развивали в разных статьях:
- SDEdit и MagicMix построены на этой идее.
- Инверсия DDIM (DDIM inversion) использует модель, чтобы «развернуть» траекторию сэмплирования вместо добавления случайного шума, — это даёт больше контроля. (В оригинале здесь пометка «TODO: ссылка на туториал»; этот туториал вышел — это ноутбук «DDIM Inversion», переведённый ниже.)
- Null-text Inversion резко улучшает качество такого подхода: на каждом шаге оптимизирует безусловные текстовые эмбеддинги, которые используются в classifier-free guidance. Это позволяет редактировать изображения по тексту с очень высоким качеством.
- То же, что в пункте 1, но с маской, которая определяет, где применять эффект:
- Blended Diffusion вводит базовую идею.
- Это демо использует готовую модель сегментации (CLIPSeg), чтобы построить маску по текстовому описанию.
- DiffEdit — отличная статья, которая показывает, как сама диффузионная модель может построить подходящую маску для редактирования изображения по тексту.
- SmartBrush: Text and Shape Guided Object Inpainting with Diffusion Model («SmartBrush: дорисовка объектов диффузионной моделью по тексту и форме») дообучает диффузионную модель для более точной дорисовки (inpainting) по маске.
- Управление перекрёстным вниманием (cross-attention control): механизм перекрёстного внимания в диффузионных моделях используется, чтобы управлять тем, в каком месте картинки происходят правки, и получить более тонкий контроль:
- Prompt-to-Prompt Image Editing with Cross Attention Control («Редактирование изображений „от промпта к промпту“ через управление перекрёстным вниманием») — ключевая статья, в которой предложена эта идея; позже технику применили к Stable Diffusion.
- Эта же идея используется в «рисовании словами» (eDiffi, см. рисунок выше).
- Дообучить («переобучить») модель на одном изображении, а затем генерировать дообученной моделью. Варианты этой идеи примерно одновременно опубликовали две статьи:
- Imagic: Text-Based Real Image Editing with Diffusion Models («Imagic: редактирование реальных изображений по тексту диффузионными моделями»).
- UniTune: Text-Driven Image Editing by Fine Tuning an Image Generation Model on a Single Image («UniTune: редактирование изображений по тексту через дообучение генеративной модели на одном изображении»).
Статья InstructPix2Pix: Learning to Follow Image Editing Instructions («InstructPix2Pix: учимся следовать инструкциям по редактированию изображений») примечательна тем, что использовала часть описанных выше техник редактирования, чтобы собрать синтетический датасет пар изображений вместе с инструкциями по правке (сгенерированными GPT-3.5), и обучила на нём новую модель, которая умеет редактировать изображения по инструкциям на естественном языке.
flowchart TD
E["Редактирование готовой картинки<br/>диффузионной моделью"] --> A["1. Зашумить и очистить<br/>с новым промптом<br/>SDEdit, инверсия DDIM, Null-text"]
E --> B["2. То же, но с маской<br/>Blended Diffusion, DiffEdit, SmartBrush"]
E --> C["3. Управлять перекрёстным вниманием<br/>Prompt-to-Prompt, paint-with-words"]
E --> D["4. Дообучить на одной картинке<br/>Imagic, UniTune"]
A --> I["Синтетические пары для обучения<br/>InstructPix2Pix"]
C --> I
(Примечание переводчика: почти сразу после выхода юнита, в феврале 2023 года, появился ControlNet — отдельная сеть-адаптер, которая подаёт
в U-Net карту глубины, контуры или позу. Он стал главным способом пространственного контроля. Линия InstructPix2Pix
привела к моделям, которые редактируют картинку по инструкции, — например, FLUX.1 Kontext и Qwen-Image-Edit (2025).
В diffusers есть готовые DDIMInverseScheduler и конвейер StableDiffusionDiffEditPipeline для DiffEdit.)
(В оригинале — кадры из видео, сгенерированных Imagen Video; источник — страница Imagen Video.)
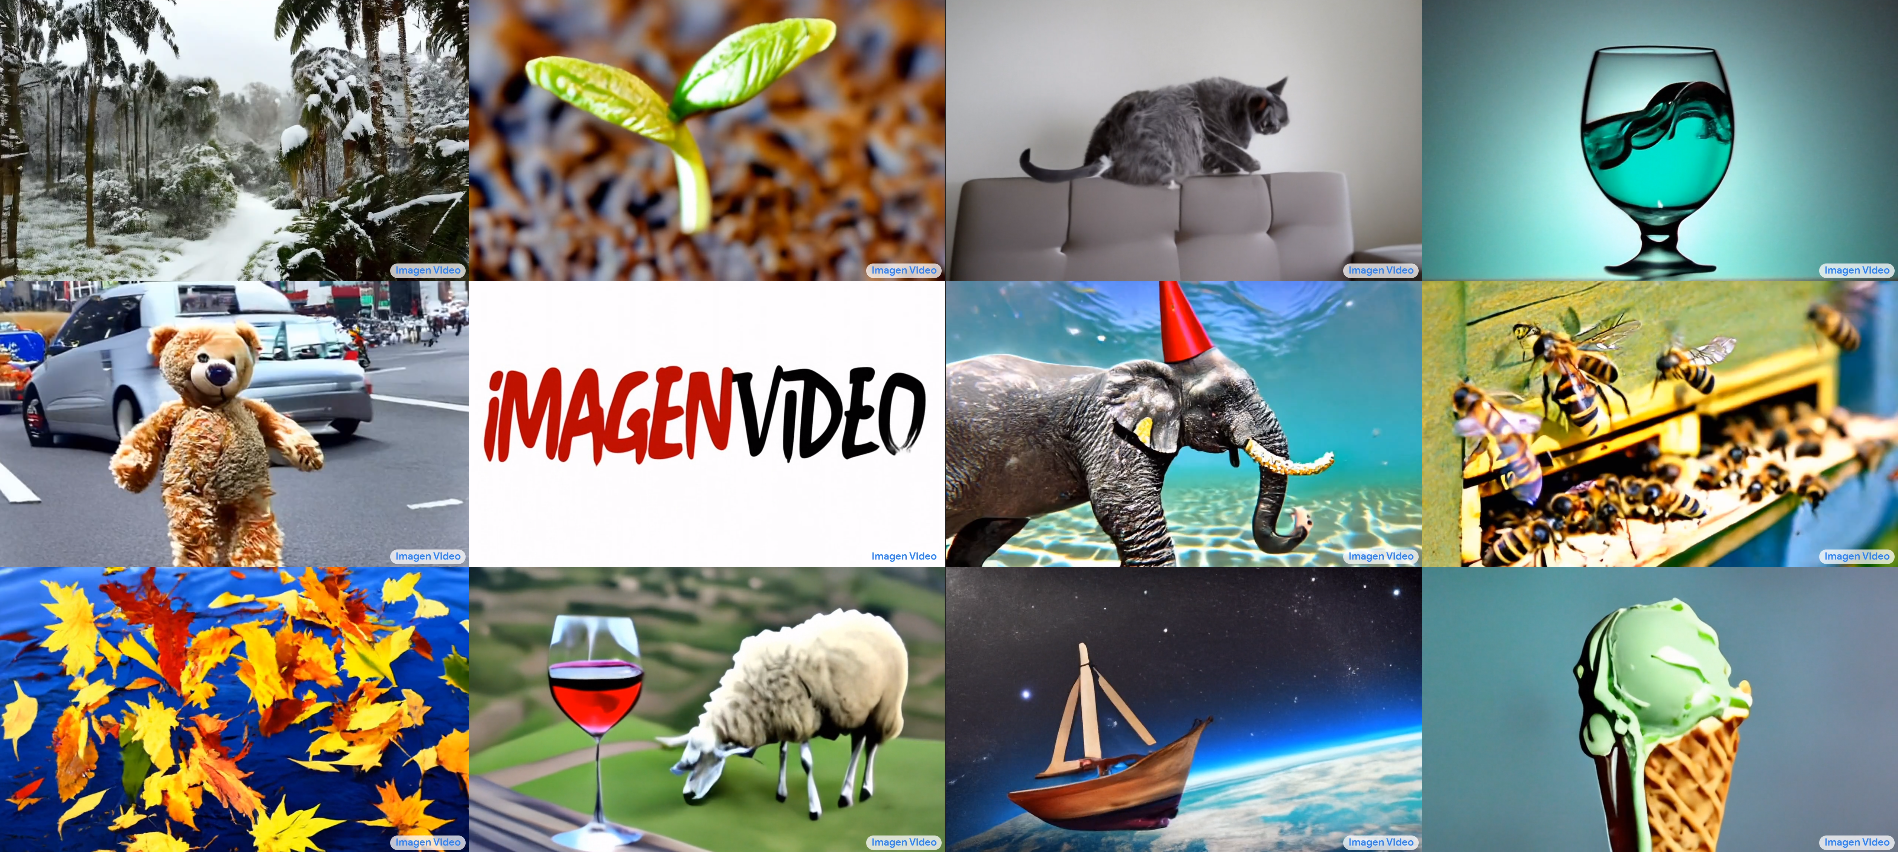
Видео можно представить как последовательность изображений, и основные идеи диффузионных моделей применимы к таким последовательностям. Недавние работы сосредоточены на поиске подходящих архитектур (например, «3D U-Net», которые работают с целой последовательностью) и на эффективной работе с видеоданными. В видео с высокой частотой кадров гораздо больше данных, чем в статичных изображениях, поэтому нынешние подходы обычно сначала генерируют видео низкого разрешения и с низкой частотой кадров, а затем применяют пространственное и временное сверхразрешение, чтобы получить итоговое качественное видео.
Ключевые работы:
- Video Diffusion Models («Видеодиффузионные модели»)
- IMAGEN VIDEO: HIGH DEFINITION VIDEO GENERATION WITH DIFFUSION MODELS («Imagen Video: генерация видео высокой чёткости диффузионными моделями»)
(Примечание переводчика: в Imagen Video каскад из 7 моделей. Базовая выдаёт 16 кадров 40×24 при 3 кадрах в секунду, а после трёх ступеней временного и трёх ступеней пространственного сверхразрешения получается 128 кадров 1280×768 при 24 кадрах в секунду — около 5,3 с. С 2024 года (Sora, затем HunyuanVideo, Wan2.1/2.2 и другие) каскады уступили место одной большой модели: видео-VAE сжимает ролик и по времени, и по пространству, а DiT-трансформер очищает от шума сразу весь пространственно-временной латент.)
(В оригинале — спектрограмма, сгенерированная Riffusion; источник изображения.)
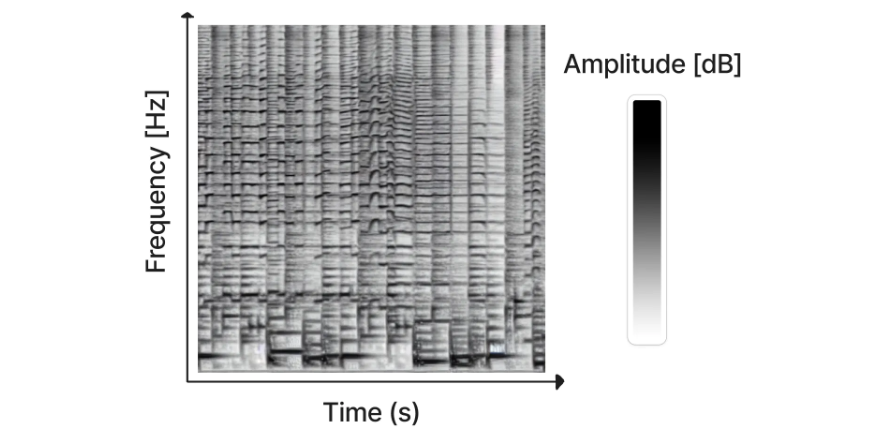
Были работы по генерации звука напрямую диффузионными моделями (например, DiffWave), но самым успешным подходом пока оказалось преобразовать звуковой сигнал в так называемую спектрограмму. Она фактически «кодирует» звук как двумерное «изображение», на котором можно обучать такие же диффузионные модели, какими мы привыкли генерировать картинки. Сгенерированные спектрограммы затем превращаются обратно в звук существующими методами. Этот подход лежит в основе недавно вышедшей Riffusion — в ней Stable Diffusion дообучили генерировать спектрограммы по тексту (попробуйте здесь).
Генерация звука развивается очень быстро. Только за последнюю неделю (на момент написания) объявили как минимум о 5 новых достижениях — в списке ниже они отмечены звёздочкой.
Ключевые работы:
- DiffWave: A Versatile Diffusion Model for Audio Synthesis («DiffWave: универсальная диффузионная модель для синтеза звука»)
- Riffusion (и код)
- *MusicLM от Google генерирует связный звук по тексту; в качестве условия можно напеть или насвистеть мелодию.
- *RAVE2 — новая версия вариационного автокодировщика, полезная для латентной диффузии в задачах со звуком. Он используется в модели *AudioLDM, анонс которой вот-вот выйдет.
- *Noise2Music — диффузионная модель, обученная выдавать качественные 30-секундные аудиоклипы по текстовому описанию.
- *Make-An-Audio: Text-To-Audio Generation with Prompt-Enhanced Diffusion Models («Make-An-Audio: генерация звука по тексту диффузионными моделями с улучшенными промптами») — диффузионная модель, обученная генерировать разнообразные звуки по тексту.
- *Moûsai: Text-to-Music Generation with Long-Context Latent Diffusion («Moûsai: генерация музыки по тексту латентной диффузией с длинным контекстом»)
(Примечание переводчика: MusicLM — не диффузионная модель. Она, как языковая модель, авторегрессионно генерирует дискретные звуковые токены. Дальше развивались оба пути. Латентная диффузия на сжатом представлении звука — это AudioLDM 2 и Stable Audio, авторегрессия токенов — MusicGen. Как звук превращают в спектрограмму и в токены, разобрано в уроке 9.1.5.)
Новые архитектуры и подходы: к «итеративному уточнению»
Заголовок раздела «Новые архитектуры и подходы: к «итеративному уточнению»»(В оригинале — рисунок 1 из статьи Cold Diffusion: прямой и обратный процессы для разных видов «порчи» изображения — не только гауссова шума, но и, например, размытия, маскирования и пикселизации.)
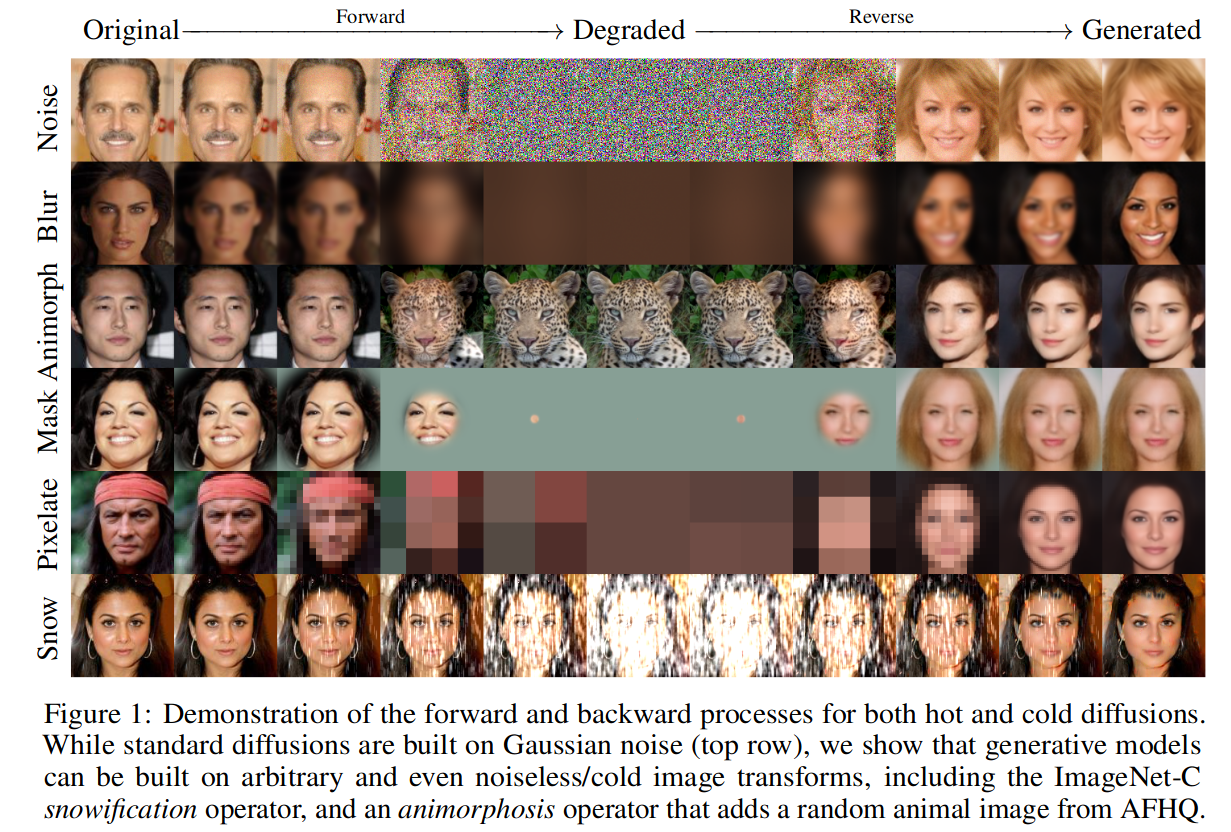
Мы постепенно выходим за рамки исходного узкого определения «диффузионных» моделей к более общему классу моделей, выполняющих итеративное уточнение (iterative refinement): некая форма «порчи» данных (как добавление гауссова шума в прямом процессе диффузии) постепенно обращается вспять, чтобы сгенерировать сэмплы. Статья «Cold Diffusion» показала, что для генерации изображений можно итеративно «отменять» и многие другие виды порчи (примеры — на рисунке выше), а недавние подходы на основе трансформеров продемонстрировали, что замена или маскирование токенов — эффективная стратегия зашумления.
(В оригинале — схема конвейера MaskGIT: изображение превращается в сетку дискретных токенов; при генерации сначала замаскированы все токены, и за несколько итераций трансформер предсказывает их, каждый раз оставляя самые уверенные предсказания и снова маскируя остальные.)
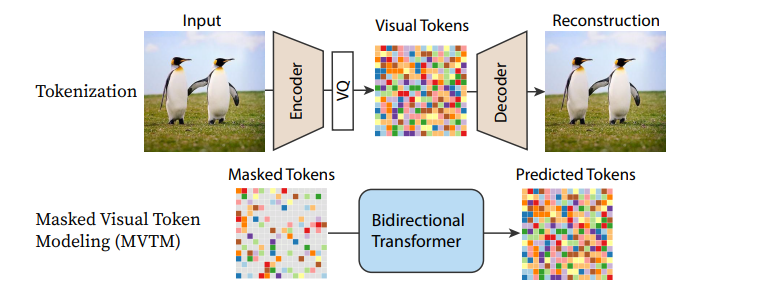
Архитектуру U-Net, лежащую в основе многих нынешних диффузионных моделей, тоже заменяют разными альтернативами — прежде всего различными архитектурами на основе трансформеров. В Scalable Diffusion Models with Transformers (DiT) трансформер используется вместо U-Net в довольно стандартном подходе к диффузии — с отличными результатами. Recurrent Interface Networks применяют новую архитектуру на основе трансформера и новую стратегию обучения ради дополнительной эффективности. MaskGIT и MUSE используют трансформеры для работы с токенизированными представлениями изображений, хотя модель Paella показывает, что и в таких режимах на токенах можно успешно применять U-Net.
С каждой новой статьёй появляются всё более эффективные подходы, и, возможно, пройдёт немало времени, прежде чем мы увидим, каков потолок качества в подобных задачах итеративного уточнения. Исследовать предстоит ещё очень многое!
Ключевые работы:
- Cold Diffusion: Inverting Arbitrary Image Transforms Without Noise («Холодная диффузия: обращение произвольных преобразований изображения без шума»)
- Scalable Diffusion Models with Transformers (DiT) («Масштабируемые диффузионные модели на трансформерах»)
- MaskGIT: Masked Generative Image Transformer («MaskGIT: генеративный трансформер изображений с маскированием»)
- Muse: Text-To-Image Generation via Masked Generative Transformers («Muse: генерация изображений по тексту генеративными трансформерами с маскированием»)
- Fast Text-Conditional Discrete Denoising on Vector-Quantized Latent Spaces (Paella) («Быстрое дискретное удаление шума с текстовым условием в векторно-квантованных латентных пространствах»)
- Recurrent Interface Networks — многообещающая новая архитектура, которая хорошо генерирует изображения высокого разрешения, не опираясь ни на латентную диффузию, ни на сверхразрешение. См. также simple diffusion: End-to-end diffusion for high-resolution images («Простая диффузия: сквозная диффузия для изображений высокого разрешения»), где подчёркивается, как важно расписание шума при обучении на высоких разрешениях.
(Примечание переводчика: прогноз сбылся. DiT вытеснил U-Net: на трансформерах построены SD3, FLUX, Sora, Wan, HunyuanVideo, Qwen-Image (урок 9.1.2). Flow matching (урок 9.1.4) — тоже итеративное уточнение, только вдоль прямого пути от шума к данным. Маскирование токенов как «зашумление» дошло до текста: диффузионные языковые модели вроде LLaDA (Китай, 2025) генерируют ответ, постепенно раскрывая замаскированные токены. Про дискретные токены изображений — урок 9.1.3.)
Практические ноутбуки
Заголовок раздела «Практические ноутбуки»| Глава | Где запустить |
|---|---|
| DDIM Inversion | Colab, Kaggle, Gradient, Studio Lab |
| Diffusion for Audio | Colab, Kaggle, Gradient, Studio Lab |
В этом юните мы охватили ОЧЕНЬ много разных идей, и многие из них в будущем заслуживают гораздо более подробных отдельных уроков. Пока же две из многих тем можно разобрать в подготовленных нами практических ноутбуках:
- DDIM Inversion показывает, как с помощью техники под названием «инверсия» редактировать изображения существующими диффузионными моделями.
- Diffusion for Audio знакомит с идеей спектрограмм и показывает минимальный пример дообучения аудиодиффузионной модели на конкретном жанре музыки.
Оба ноутбука переведены ниже на этой странице.
Что дальше?
Заголовок раздела «Что дальше?»Пока это последний юнит курса, а значит, что делать дальше — решать вам! Помните, что задавать вопросы и обсуждать свои проекты всегда можно в Discord Hugging Face. Ждём не дождёмся увидеть, что вы создадите 🤗.
(Примечание переводчика: новых юнитов в курсе так и не вышло. Продолжить можно с курсом fast.ai «Stable Diffusion from the Foundations», который упоминается в юните 3, с документацией 🤗 Diffusers и с уроками 9.1.2–9.1.5 нашего курса.)
Ноутбук: инверсия DDIM
Заголовок раздела «Ноутбук: инверсия DDIM»В этом ноутбуке мы разберём инверсию (inversion), посмотрим, как она связана с сэмплированием, и применим её к задаче редактирования изображений со Stable Diffusion.
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»- Как работает сэмплирование DDIM.
- Чем детерминированные сэмплеры отличаются от стохастических.
- Какая теория стоит за инверсией DDIM.
- Как редактировать изображения с помощью инверсии.
Приступим!
Подготовка
Заголовок раздела «Подготовка»%pip install -q transformers diffusers accelerateimport torchimport requestsimport torch.nn as nnimport torch.nn.functional as Ffrom PIL import Imagefrom io import BytesIOfrom tqdm.auto import tqdmfrom matplotlib import pyplot as pltfrom torchvision import transforms as tfmsfrom diffusers import StableDiffusionPipeline, DDIMScheduler
# Функция, которая пригодится дальшеdef load_image(url, size=None): response = requests.get(url,timeout=0.2) img = Image.open(BytesIO(response.content)).convert('RGB') if size is not None: img = img.resize(size) return img(Примечание переводчика: timeout=0.2 — это 0,2 секунды на ответ сервера. На медленном соединении загрузка
картинки упадёт с ошибкой — смело поставьте timeout=10.)
device = torch.device("mps" if torch.backends.mps.is_available() else "cuda" if torch.cuda.is_available() else "cpu")Загружаем готовый конвейер
Заголовок раздела «Загружаем готовый конвейер»# Загружаем конвейерpipe = StableDiffusionPipeline.from_pretrained("runwayml/stable-diffusion-v1-5").to(device)(Примечание переводчика: репозиторий runwayml/stable-diffusion-v1-5 удалён с Hub; та же модель доступна под именем
"stable-diffusion-v1-5/stable-diffusion-v1-5". В fp32 веса SD 1.5 занимают около 4 ГБ — нужна видеокарта примерно
с 8 ГБ памяти. Переходить на fp16 здесь не советуем: дальше картинка кодируется вручную тензором float32, и придётся
самим приводить типы.)
# Ставим планировщик DDIMpipe.scheduler = DDIMScheduler.from_config(pipe.scheduler.config)# Сэмплируем изображение, чтобы убедиться, что всё работаетprompt = 'Beautiful DSLR Photograph of a penguin on the beach, golden hour'negative_prompt = 'blurry, ugly, stock photo'im = pipe(prompt, negative_prompt=negative_prompt).images[0]im.resize((256, 256)) # Уменьшаем для удобного просмотра(Промпт: «Красивая фотография пингвина на пляже, снятая зеркальной камерой, золотой час». Негативный промпт: «размыто, некрасиво, фотосток». В выводе — фото пингвина на пляже.)
Сэмплирование DDIM
Заголовок раздела «Сэмплирование DDIM»В момент зашумлённое изображение — это смесь исходного изображения () и шума (). Вот формула для из статьи о DDIM, на которую мы будем опираться в этом разделе:
— гауссов шум с единичной дисперсией.
(«альфа») — величина, которую в статье о DDPM (!!), сбивая с толку, называют («альфа
с чертой», alpha_bar); она задаётся планировщиком шума. В Diffusers этот график альфа вычисляется заранее, а значения
хранятся в scheduler.alphas_cumprod. Знаю, путаница! Нарисуем эти значения и запомним: до конца ноутбука мы
пользуемся обозначениями DDIM.
# Рисуем 'alpha' (alpha_bar на языке DDPM, alphas_cumprod в Diffusers) для ясностиtimesteps = pipe.scheduler.timesteps.cpu()alphas = pipe.scheduler.alphas_cumprod[timesteps]plt.plot(timesteps, alphas, label='alpha_t');plt.legend();Вначале (шаг 0, левая часть графика) у нас чистое изображение без шума: . По мере роста шага мы приходим почти к чистому шуму, и падает к 0.
(На графике — кривая, которая плавно спадает от 1 при почти до 0 при .)
При сэмплировании мы начинаем с чистого шума на шаге 1000 и постепенно движемся к шагу 0. Чтобы вычислить следующую точку траектории сэмплирования (, ведь мы движемся от больших к малым), мы предсказываем шум ( — это выход нашей модели) и по нему вычисляем предсказанное очищенное изображение . Затем с помощью этого предсказания сдвигаемся на небольшое расстояние в «направлении, указывающем на ». Наконец, можно добавить немного дополнительного шума, масштабированного на . Вот раздел статьи, где это показано:
(В ноутбуке это скриншот раздела 4.1 статьи DDIM — формула (12) и пояснение к ней. Перевод пояснения: — стандартный гауссов шум, не зависящий от , и по определению . Разные значения дают разные генеративные процессы при одной и той же модели , поэтому переобучать модель не нужно. При для всех прямой процесс становится марковским, а генеративный процесс — это DDPM. Другой особый случай — для всех : коэффициент перед случайным шумом обнуляется, и сэмплы получаются из латентных переменных фиксированной процедурой (от к ). Такую модель авторы назвали denoising diffusion implicit model (DDIM, «неявная диффузионная модель удаления шума»): это неявная вероятностная модель, обученная с целевой функцией DDPM.)
Итак, у нас есть уравнение, как перейти от к с регулируемым количеством шума. Сегодня нас интересует именно случай, когда дополнительный шум не добавляется: это даёт полностью детерминированное сэмплирование DDIM. Посмотрим, как это выглядит в коде:
# Функция сэмплирования (обычный DDIM)@torch.no_grad()def sample(prompt, start_step=0, start_latents=None,           guidance_scale=3.5, num_inference_steps=30,           num_images_per_prompt=1, do_classifier_free_guidance=True,           negative_prompt='', device=device):
    # Кодируем промпт    text_embeddings = pipe._encode_prompt(            prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt    )
    # Задаём число шагов инференса    pipe.scheduler.set_timesteps(num_inference_steps, device=device)
    # Создаём случайную стартовую точку, если её ещё нет    if start_latents is None:        start_latents = torch.randn(1, 4, 64, 64, device=device)        start_latents *= pipe.scheduler.init_noise_sigma
    latents = start_latents.clone()
    for i in tqdm(range(start_step, num_inference_steps)):
        t = pipe.scheduler.timesteps[i]
        # Если используем classifier-free guidance, удваиваем латенты        latent_model_input = torch.cat([latents] * 2) if do_classifier_free_guidance else latents        latent_model_input = pipe.scheduler.scale_model_input(latent_model_input, t)
        # Предсказываем шум (остаток)        noise_pred = pipe.unet(latent_model_input, t, encoder_hidden_states=text_embeddings).sample
        # Применяем guidance        if do_classifier_free_guidance:            noise_pred_uncond, noise_pred_text = noise_pred.chunk(2)            noise_pred = noise_pred_uncond + guidance_scale * (noise_pred_text - noise_pred_uncond)

        # Обычно шаг обновления мы доверяем планировщику:        # latents = pipe.scheduler.step(noise_pred, t, latents).prev_sample
        # А здесь сделаем его сами:        prev_t = max(1, t.item() - (1000//num_inference_steps)) # t-1        alpha_t = pipe.scheduler.alphas_cumprod[t.item()]        alpha_t_prev = pipe.scheduler.alphas_cumprod[prev_t]        predicted_x0 = (latents - (1-alpha_t).sqrt()*noise_pred) / alpha_t.sqrt()        direction_pointing_to_xt = (1-alpha_t_prev).sqrt()*noise_pred        latents = alpha_t_prev.sqrt()*predicted_x0 + direction_pointing_to_xt
    # Постобработка    images = pipe.decode_latents(latents)    images = pipe.numpy_to_pil(images)
    return images
# Проверяем нашу функцию сэмплирования: генерируем изображениеsample('Watercolor painting of a beach sunset', negative_prompt=negative_prompt, num_inference_steps=50)[0].resize((256, 256))(Промпт: «Акварель: закат на пляже». В выводе — акварельный пейзаж с закатом.)
Попробуйте сопоставить код с уравнением из статьи. Обратите внимание: , ведь нас интересует только случай без дополнительного шума, поэтому соответствующие части уравнения можно опустить.
Инверсия
Заголовок раздела «Инверсия»Цель инверсии — «обратить» процесс сэмплирования. Мы хотим получить такой зашумлённый латент, что если взять его стартовой точкой обычной процедуры сэмплирования, то сгенерируется исходное изображение.
Здесь в качестве исходного изображения мы загружаем фотографию, но можно и сгенерировать своё.
# https://www.pexels.com/photo/a-beagle-on-green-grass-field-8306128/input_image = load_image('https://images.pexels.com/photos/8306128/pexels-photo-8306128.jpeg', size=(512, 512))input_image(В выводе — фото щенка бигля на зелёной траве.)
Инверсию мы тоже будем делать с classifier-free guidance, поэтому нужен промпт — введите описание изображения:
input_image_prompt = "Photograph of a puppy on the grass"(«Фотография щенка на траве».)
Дальше нужно превратить это PIL-изображение в набор латентов, который станет стартовой точкой инверсии:
# Кодируем VAEwith torch.no_grad(): latent = pipe.vae.encode(tfms.functional.to_tensor(input_image).unsqueeze(0).to(device)*2-1)l = 0.18215 * latent.latent_dist.sample()(*2-1 переводит пиксели из диапазона [0, 1] в [−1, 1], как ждёт VAE. 0.18215 — масштабный множитель латентов VAE
у SD 1.x, он же pipe.vae.config.scaling_factor.)
Теперь самое интересное. Эта функция похожа на функцию сэмплирования выше, но проходит по шагам в обратном направлении: начинает с и движется ко всё более сильному шуму. И вместо того чтобы обновлять латенты, делая их менее шумными, мы оцениваем предсказанный шум и с его помощью ОТМЕНЯЕМ шаг обновления, переводя латенты из в .
## Инверсия@torch.no_grad()def invert(start_latents, prompt, guidance_scale=3.5, num_inference_steps=80,           num_images_per_prompt=1, do_classifier_free_guidance=True,           negative_prompt='', device=device):
    # Кодируем промпт    text_embeddings = pipe._encode_prompt(            prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt    )
    # Теперь латенты — это заданные стартовые латенты    latents = start_latents.clone()
    # По ходу инверсии будем сохранять список промежуточных латентов    intermediate_latents = []
    # Задаём число шагов инференса    pipe.scheduler.set_timesteps(num_inference_steps, device=device)
    # Шаги в обратном порядке <<<<<<<<<<<<<<<<<<<<    timesteps = reversed(pipe.scheduler.timesteps)
    for i in tqdm(range(1, num_inference_steps), total=num_inference_steps-1):
        # Последнюю итерацию пропускаем        if i >= num_inference_steps - 1: continue
        t = timesteps[i]
        # Если используем classifier-free guidance, удваиваем латенты        latent_model_input = torch.cat([latents] * 2) if do_classifier_free_guidance else latents        latent_model_input = pipe.scheduler.scale_model_input(latent_model_input, t)
        # Предсказываем шум (остаток)        noise_pred = pipe.unet(latent_model_input, t, encoder_hidden_states=text_embeddings).sample
        # Применяем guidance        if do_classifier_free_guidance:            noise_pred_uncond, noise_pred_text = noise_pred.chunk(2)            noise_pred = noise_pred_uncond + guidance_scale * (noise_pred_text - noise_pred_uncond)
        current_t = max(0, t.item() - (1000//num_inference_steps)) #t        next_t = t # min(999, t.item() + (1000//num_inference_steps)) # t+1        alpha_t = pipe.scheduler.alphas_cumprod[current_t]        alpha_t_next = pipe.scheduler.alphas_cumprod[next_t]
        # Обращённый шаг обновления (переставляем члены уравнения шага, чтобы выразить x(t) (новые латенты) через x(t-1) (текущие латенты)        latents = (latents - (1-alpha_t).sqrt()*noise_pred)*(alpha_t_next.sqrt()/alpha_t.sqrt()) + (1-alpha_t_next).sqrt()*noise_pred

        # Сохраняем        intermediate_latents.append(latents)
return torch.cat(intermediate_latents)Запустив её на латентном представлении фото щенка, получаем набор всех промежуточных латентов, созданных по ходу инверсии:
inverted_latents = invert(l, input_image_prompt, num_inference_steps=50)inverted_latents.shapeВывод:
torch.Size([48, 4, 64, 64])(Почему 48, а не 50: цикл идёт с до 49 — это 49 итераций, а последнюю функция пропускает.)
Можно посмотреть на последний набор латентов — надеемся, это будет зашумлённая стартовая точка для наших новых попыток сэмплирования:
# Декодируем итоговые обращённые латентыwith torch.no_grad(): im = pipe.decode_latents(inverted_latents[-1].unsqueeze(0))pipe.numpy_to_pil(im)[0](В выводе — пёстрая мозаика из цветных пятен без узнаваемых форм: декодированный «шумный» латент.)
Эти обращённые латенты можно передать в конвейер через обычный метод __call__:
pipe(input_image_prompt, latents=inverted_latents[-1][None], num_inference_steps=50, guidance_scale=3.5).images[0](В выводе — щенок на траве, но другой: тёмный щенок с рыжими подпалинами вместо бигля.)
Но тут мы видим первую проблему: это не совсем то изображение, с которого мы начинали! Дело в том, что инверсия DDIM опирается на критическое допущение: предсказание шума в моменты и будет одинаковым. Это неверно, когда мы обращаем всего 50 или 100 шагов. Можно взять больше шагов в надежде на более точную инверсию, а можно «схитрить»: начать сэмплирование, скажем, с 20-го шага из 50 с соответствующими промежуточными латентами, которые мы сохранили при инверсии:
# Вот зачем нам нужно уметь задавать стартовый шагstart_step = 20sample(input_image_prompt, start_latents=inverted_latents[-(start_step+1)][None], start_step=start_step, num_inference_steps=50)[0]Очень близко к исходному изображению! Зачем мы это делаем? Надежда в том, что если теперь сэмплировать с новым промптом, получится изображение, совпадающее с оригиналом ВСЮДУ, КРОМЕ мест, к которым относится новый промпт. Например, если заменить ‘puppy’ на ‘cat’, мы должны увидеть кошку с почти такими же лужайкой и фоном:
# Сэмплируем с новым промптомstart_step = 10new_prompt = input_image_prompt.replace('puppy', 'cat')sample(new_prompt, start_latents=inverted_latents[-(start_step+1)][None], start_step=start_step, num_inference_steps=50)[0](Индексы: в inverted_latents латенты идут от малого шума к большому, а сэмплирование — от большого к малому.
Поэтому для старта с шага start_step берётся элемент -(start_step+1), отсчитанный с конца списка.)
Почему не просто img2img?
Заголовок раздела «Почему не просто img2img?»Зачем возиться с инверсией? Нельзя ли просто добавить шум к исходному изображению и очистить его с новым промптом? Можно, но тогда изменения получатся либо гораздо более радикальными везде (если добавить много шума), либо недостаточными где бы то ни было (если добавить мало). Попробуйте сами:
start_step = 10num_inference_steps = 50pipe.scheduler.set_timesteps(num_inference_steps)noisy_l = pipe.scheduler.add_noise(l, torch.randn_like(l), pipe.scheduler.timesteps[start_step])sample(new_prompt, start_latents=noisy_l, start_step=start_step, num_inference_steps=num_inference_steps)[0]Обратите внимание, насколько сильнее изменились лужайка и фон.
(В выводе — кошка на траве, но лужайка и фон уже заметно другие, чем на исходной фотографии.)
Собираем всё вместе
Заголовок раздела «Собираем всё вместе»Обернём написанный код в простую функцию, которая принимает изображение и два промпта и выполняет правку с помощью инверсии:
def edit(input_image, input_image_prompt, edit_prompt, num_steps=100, start_step=30, guidance_scale=3.5): with torch.no_grad(): latent = pipe.vae.encode(tfms.functional.to_tensor(input_image).unsqueeze(0).to(device)*2-1) l = 0.18215 * latent.latent_dist.sample() inverted_latents = invert(l, input_image_prompt, num_inference_steps=num_steps) final_im = sample(edit_prompt, start_latents=inverted_latents[-(start_step+1)][None], start_step=start_step, num_inference_steps=num_steps, guidance_scale=guidance_scale)[0] return final_imВ действии:
edit(input_image, 'A puppy on the grass', 'an old grey dog on the grass', num_steps=50, start_step=10)edit(input_image, 'A puppy on the grass', 'A blue dog on the lawn', num_steps=50, start_step=12, guidance_scale=6)(Промпты: «щенок на траве» → «старая седая собака на траве»; «щенок на траве» → «синяя собака на лужайке».)
# Упражнение: попробуйте это на других изображениях! Исследуйте разные параметры.flowchart LR I["Фото"] -->|"кодировщик VAE"| L["Латент x_0"] L -->|"инверсия DDIM<br/>с исходным промптом"| N["Латенты x_1 … x_T<br/>(сохраняем все)"] N -->|"берём x на шаге start_step"| S["Сэмплирование DDIM<br/>с новым промптом"] S -->|"декодер VAE"| O["Отредактированное фото"]
Больше шагов — лучше результат
Заголовок раздела «Больше шагов — лучше результат»Если инверсия получается неточной, попробуйте взять больше шагов (ценой более долгой работы). Чтобы проверить
инверсию, можно вызвать нашу функцию edit с одним и тем же промптом:
# Проверка инверсии с гораздо большим числом шаговedit(input_image, 'A puppy on the grass', 'A puppy on the grass', num_steps=350, start_step=1)Намного лучше! Попробуем теперь правку:
edit(input_image, 'A photograph of a puppy', 'A photograph of a grey cat', num_steps=150, start_step=30, guidance_scale=5.5)# источник: https://www.pexels.com/photo/girl-taking-photo-1493111/face = load_image('https://images.pexels.com/photos/1493111/pexels-photo-1493111.jpeg', size=(512, 512))faceedit(face, 'A photograph of a face', 'A photograph of a face with sunglasses', num_steps=250, start_step=30, guidance_scale=3.5)edit(face, 'A photograph of a face', 'Acrylic palette knife painting of a face, colorful', num_steps=250, start_step=65, guidance_scale=5.5)(Промпты: «фотография щенка» → «фотография серой кошки»; «фотография лица» → «фотография лица в солнечных очках»;
«фотография лица» → «акриловая живопись мастихином: лицо, красочно». Чем больше start_step, тем ближе к концу
траектории начинается сэмплирование и тем меньше шума остаётся — значит, тем сильнее результат похож на оригинал.
Для смены стиля в последнем примере взят start_step=65 из 250: первые 26% траектории пропускаются, и
сэмплирование стартует примерно с .)
Что дальше?
Заголовок раздела «Что дальше?»Вооружившись знаниями из этого ноутбука, рекомендую разобраться с Null-text Inversion: этот метод развивает DDIM, оптимизируя при инверсии «пустой» текст (безусловный текстовый промпт), чтобы инверсия была точнее, а правки — лучше.
Ноутбук: диффузия для звука
Заголовок раздела «Ноутбук: диффузия для звука»В этом ноутбуке мы коротко посмотрим, как генерировать звук диффузионными моделями.
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»- Как звук представлен в компьютере.
- Как переводить сырые аудиоданные в спектрограммы и обратно.
- Как подготовить загрузчик данных со своей функцией collate, которая превращает фрагменты звука в спектрограммы.
- Как дообучить готовую аудиодиффузионную модель на конкретном жанре музыки.
- Как выгрузить свой конвейер на Hugging Face Hub.
Оговорка: это в основном учебный пример — никаких гарантий, что наша модель будет хорошо звучать 😉.
Приступим!
Подготовка и импорты
Заголовок раздела «Подготовка и импорты»%pip install -q datasets diffusers torchaudio accelerateimport torch, randomimport numpy as npimport torch.nn.functional as Ffrom tqdm.auto import tqdmfrom IPython.display import Audiofrom matplotlib import pyplot as pltfrom diffusers import DiffusionPipelinefrom torchaudio import transforms as ATfrom torchvision import transforms as ITСэмплирование из предобученного аудиоконвейера
Заголовок раздела «Сэмплирование из предобученного аудиоконвейера»Для начала, следуя документации Audio Diffusion, загрузим готовый конвейер аудиодиффузионной модели:
# Загружаем предобученный конвейер аудиодиффузииdevice = "mps" if torch.backends.mps.is_available() else "cuda" if torch.cuda.is_available() else "cpu"pipe = DiffusionPipeline.from_pretrained("teticio/audio-diffusion-instrumental-hiphop-256").to(device)(Примечание переводчика: модель teticio/audio-diffusion-instrumental-hiphop-256 обучена на инструментальном
хип-хопе. Ноутбук писался под diffusers 0.12 (версия видна в выводе pipe.mel ниже). С тех пор конвейер
AudioDiffusion перенесён в раздел устаревших (deprecated) конвейеров diffusers и больше не развивается. Если на свежей
версии библиотеки загрузка или вызов падает, проще всего поставить в отдельное окружение старую версию diffusers.)
Как и с конвейерами из предыдущих юнитов, сэмплы создаются вызовом конвейера:
# Сэмплируем из конвейера и показываем результатыoutput = pipe()display(output.images[0])display(Audio(output.audios[0], rate=pipe.mel.get_sample_rate()))(В выводе — серая картинка-спектрограмма 256×256 и аудиоплеер. Конвейер делает 1000 шагов DDPM, так что генерация занимает заметное время даже на GPU.)
Здесь аргумент rate задаёт частоту дискретизации (sampling rate) звука; подробнее мы разберём её ниже. Вы также
заметите, что конвейер возвращает несколько вещей. Что тут происходит? Посмотрим внимательнее на оба выхода.
Первый — массив данных, представляющий сгенерированный звук:
# Массив звукаoutput.audios[0].shapeВывод:
(1, 130560)Второй похож на изображение в оттенках серого:
# Выходное изображение (спектрограмма)output.images[0].sizeВывод:
(256, 256)Это подсказывает, как работает конвейер. Звук генерируется диффузией не напрямую: в конвейере та же двумерная U-Net, что и в конвейерах безусловной генерации изображений из юнита 1 (перевод). Она генерирует спектрограмму, а та затем постобработкой превращается в итоговый звук.
У конвейера есть дополнительный компонент, который отвечает за эти преобразования; доступ к нему — через pipe.mel:
pipe.melВывод:
Mel { "_class_name": "Mel", "_diffusers_version": "0.12.0.dev0", "hop_length": 512, "n_fft": 2048, "n_iter": 32, "sample_rate": 22050, "top_db": 80, "x_res": 256, "y_res": 256}Из звука в картинку и обратно
Заголовок раздела «Из звука в картинку и обратно»Звуковая «волна» (waveform) кодирует сырые отсчёты звука во времени — например, это может быть электрический сигнал с микрофона. С таким представлением во «временной области» (time domain) работать бывает неудобно, поэтому его принято переводить в другую форму, обычно в так называемую спектрограмму. Спектрограмма показывает интенсивность разных частот (ось y) во времени (ось x):
# Вычисляем и показываем спектрограмму нашего сгенерированного звука средствами torchaudiospec_transform = AT.Spectrogram(power=2)spectrogram = spec_transform(torch.tensor(output.audios[0]))print(spectrogram.min(), spectrogram.max())log_spectrogram = spectrogram.log()plt.imshow(log_spectrogram[0], cmap='gray');Вывод:
tensor(0.) tensor(6.0842)Значения у спектрограммы, которую мы только что построили, лежат между 0.0000000000001 и 1, причём большинство — у нижнего края этого диапазона. Это неудобно и для визуализации, и для моделирования: нам даже пришлось взять логарифм этих значений, чтобы на сером графике была видна хоть какая-то детализация. Поэтому обычно используют особый вид спектрограммы — мел-спектрограмму (Mel spectrogram). Она устроена так, чтобы сохранять информацию, важную для человеческого слуха: для этого к разным частотным составляющим сигнала применяются определённые преобразования.
(Примечание переводчика: в сохранённом выводе ячейки минимум 0, а максимум около 6 — числа в тексте, видимо, остались от другого запуска. Суть та же: почти все значения крошечные, а разброс огромный, поэтому и берут логарифм.)
(В оригинале — схема из документации torchaudio с подписью «Некоторые преобразования звука из документации torchaudio»: как из звуковой волны получают спектрограмму, мел-спектрограмму и другие признаки.)
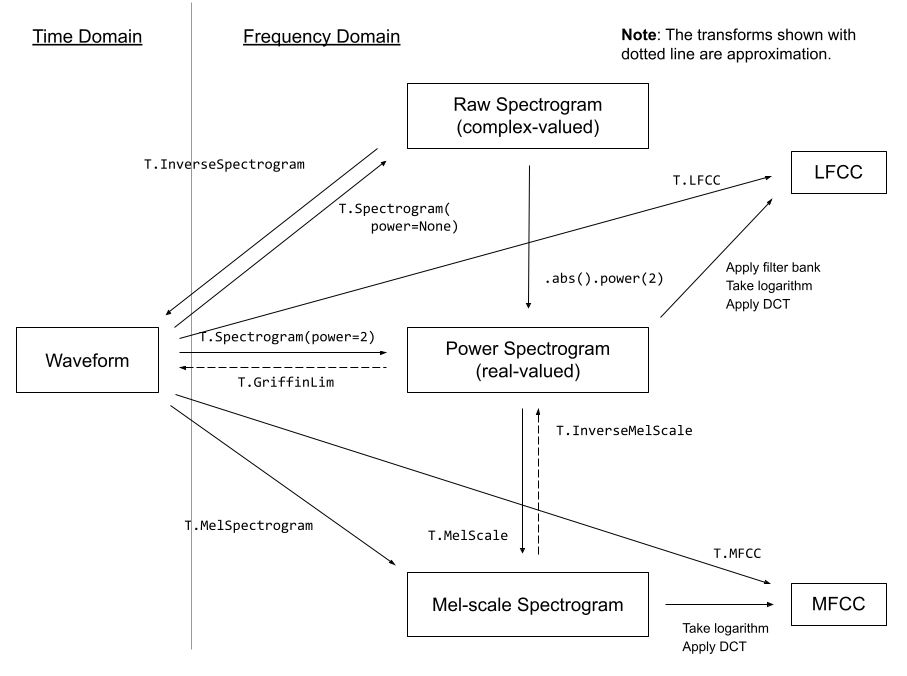
flowchart LR
W["Звуковая волна<br/>22 050 отсчётов/с"] -->|"окна по 2048, сдвиг 512<br/>преобразование Фурье"| S["Спектрограмма<br/>частота × время"]
S -->|"мел-шкала<br/>+ логарифм (дБ)"| M["Мел-спектрограмма<br/>картинка 256×256"]
M -->|"U-Net учится<br/>на этих картинках"| G["Сгенерированная<br/>спектрограмма"]
G -->|"обратная мел-шкала<br/>+ Гриффин — Лим (фаза)"| A["Звук"]
К счастью, об этих преобразованиях можно особо не беспокоиться: функциональность mel конвейера берёт эти детали на
себя. С её помощью спектрограмму-изображение можно превратить в звук так:
a = pipe.mel.image_to_audio(output.images[0])a.shapeВывод:
(130560,)А чтобы превратить массив аудиоданных в изображения-спектрограммы, сначала загружаем сырые аудиоданные, затем
вызываем функцию audio_slice_to_image(). Более длинные клипы автоматически режутся на куски нужной длины, чтобы
получалась спектрограмма 256×256:
pipe.mel.load_audio(raw_audio=a)im = pipe.mel.audio_slice_to_image(0)imЗвук представлен длинным массивом чисел. Чтобы проиграть его вслух, нужна ещё одна ключевая величина — частота дискретизации. Сколько отсчётов (отдельных значений) мы используем, чтобы представить одну секунду звука?
Частоту дискретизации, с которой обучался этот конвейер, можно посмотреть так:
sample_rate_pipeline = pipe.mel.get_sample_rate()sample_rate_pipelineВывод:
22050Если указать частоту дискретизации неправильно, звук получится ускоренным или замедленным:
display(Audio(output.audios[0], rate=44100)) # скорость ×2Дообучение конвейера
Заголовок раздела «Дообучение конвейера»Теперь, когда мы примерно понимаем, как работает конвейер, дообучим его на новых аудиоданных!
Датасет — коллекция аудиоклипов разных жанров; загрузить его с Hub можно так:
from datasets import load_datasetdataset = load_dataset('lewtun/music_genres', split='train')datasetВывод:
Dataset({ features: ['audio', 'song_id', 'genre_id', 'genre'], num_rows: 19909})(Примечание переводчика: это почти 20 тысяч 30-секундных клипов — скачивание займёт время и место на диске.)
Код ниже показывает, какие жанры есть в датасете и сколько в каждом примеров:
for g in list(set(dataset['genre'])): print(g, sum(x==g for x in dataset['genre']))Вывод:
Pop 945Blues 58Punk 2582Old-Time / Historic 408Experimental 1800Folk 1214Electronic 3071Spoken 94Classical 495Country 142Instrumental 1044Chiptune / Glitch 1181International 814Ambient Electronic 796Jazz 306Soul-RnB 94Hip-Hop 1757Easy Listening 13Rock 3095Звук в датасете хранится массивами:
audio_array = dataset[0]['audio']['array']sample_rate_dataset = dataset[0]['audio']['sampling_rate']print('Audio array shape:', audio_array.shape)print('Sample rate:', sample_rate_dataset)display(Audio(audio_array, rate=sample_rate_dataset))Вывод:
Audio array shape: (1323119,)Sample rate: 44100(1 323 119 отсчётов при 44 100 Гц — это 30 с звука.)
Обратите внимание: частота дискретизации у этого звука выше, и чтобы использовать готовый конвейер, звук нужно
«передискретизировать» (resample) под него. Кроме того, клипы длиннее тех, на которые рассчитан конвейер. К счастью,
когда мы загружаем звук через pipe.mel, он автоматически режет клип на куски поменьше:
a = dataset[0]['audio']['array'] # Берём массив звукаpipe.mel.load_audio(raw_audio=a) # Загружаем его в pipe.melpipe.mel.audio_slice_to_image(0) # Смотрим на первый «кусок» как на спектрограммуНужно не забыть поправить частоту дискретизации: в этом датасете отсчётов в секунду вдвое больше:
sample_rate_dataset = dataset[0]['audio']['sampling_rate']sample_rate_datasetВывод:
44100Здесь мы используем преобразования torchaudio (импортированы как AT), чтобы передискретизировать звук, mel
конвейера — чтобы превратить звук в изображение, и преобразования torchvision (импортированы как IT) — чтобы
превратить изображения в тензоры. Так получается функция, которая превращает аудиоклип в тензор спектрограммы для
обучения:
resampler = AT.Resample(sample_rate_dataset, sample_rate_pipeline, dtype=torch.float32)to_t = IT.ToTensor()
def to_image(audio_array):  audio_tensor = torch.tensor(audio_array).to(torch.float32)  audio_tensor = resampler(audio_tensor)  pipe.mel.load_audio(raw_audio=np.array(audio_tensor))  num_slices = pipe.mel.get_number_of_slices()  slice_idx = random.randint(0, num_slices-1) # Каждый раз берём случайный кусок (кроме последнего, короткого)  im = pipe.mel.audio_slice_to_image(slice_idx)  return im
Функцию to_image() мы используем внутри своей функции collate, чтобы превратить датасет в загрузчик данных для
обучения. Функция collate определяет, как превратить батч примеров из датасета в итоговый батч данных, готовый
к обучению. В нашем случае мы превращаем каждый аудиопример в изображение-спектрограмму и складываем получившиеся
тензоры в стопку:
def collate_fn(examples):  # в изображение -> в тензор -> масштабируем в (-1, 1) -> складываем в батч  audio_ims = [to_t(to_image(x['audio']['array']))*2-1 for x in examples]  return torch.stack(audio_ims)
# Создаём датасет только из песен жанра 'Chiptune / Glitch'batch_size = 4 # 4 в Colab, 12 на A100chosen_genre = 'Electronic' # <<< Попробуйте обучить на разных жанрах <<<indexes = [i for i, g in enumerate(dataset['genre']) if g == chosen_genre]filtered_dataset = dataset.select(indexes)dl = torch.utils.data.DataLoader(filtered_dataset.shuffle(), batch_size=batch_size, collate_fn=collate_fn, shuffle=True)batch = next(iter(dl))print(batch.shape)
Вывод:
torch.Size([4, 1, 256, 256])(Примечание переводчика: комментарий про ‘Chiptune / Glitch’ остался в оригинале от прошлой версии, на деле выбран
жанр 'Electronic'. Форма батча: 4 спектрограммы, 1 канал (оттенки серого), 256×256.)
NB: если у вас не очень много видеопамяти GPU, понадобится небольшой размер батча (например, 4).
Цикл обучения
Заголовок раздела «Цикл обучения»Вот простой цикл обучения, который несколько эпох проходит по загрузчику данных и дообучает U-Net конвейера. Эту ячейку можно пропустить и загрузить конвейер кодом из следующей ячейки.
epochs = 3lr = 1e-4
pipe.unet.train()pipe.scheduler.set_timesteps(1000)optimizer = torch.optim.AdamW(pipe.unet.parameters(), lr=lr)
for epoch in range(epochs):    for step, batch in tqdm(enumerate(dl), total=len(dl)):
        # Готовим входные изображения        clean_images = batch.to(device)        bs = clean_images.shape[0]
        # Для каждого изображения берём случайный шаг        timesteps = torch.randint(            0, pipe.scheduler.num_train_timesteps, (bs,), device=clean_images.device        ).long()
        # Добавляем к чистым изображениям шум той величины, которая соответствует каждому шагу        noise = torch.randn(clean_images.shape).to(clean_images.device)        noisy_images = pipe.scheduler.add_noise(clean_images, noise, timesteps)
        # Получаем предсказание модели        noise_pred = pipe.unet(noisy_images, timesteps, return_dict=False)[0]
        # Считаем функцию потерь        loss = F.mse_loss(noise_pred, noise)        loss.backward(loss)
        # Обновляем параметры модели оптимизатором        optimizer.step()        optimizer.zero_grad()
(Примечание переводчика: та же ошибка, что в юнитах 1 и 2, — loss.backward(loss) умножает градиенты на значение
loss; пишите loss.backward(). И pipe.scheduler.num_train_timesteps в новых версиях diffusers лучше писать как
pipe.scheduler.config.num_train_timesteps. Объём работы: в жанре Electronic 3071 клип, при батче 4 это 768 шагов на
эпоху, за 3 эпохи — около 2300 шагов. Каждый батч ещё и готовится на CPU (передискретизация и мел-спектрограмма),
поэтому обучение займёт заметное время.)
# ИЛИ: загружаем версию, которую я обучил заранееpipe = DiffusionPipeline.from_pretrained("johnowhitaker/Electronic_test").to(device)output = pipe()display(output.images[0])display(Audio(output.audios[0], rate=22050))# Делаем сэмпл подлиннее: подаём стартовый шумовой тензор другой формыnoise = torch.randn(1, 1, pipe.unet.sample_size[0], pipe.unet.sample_size[1]*4).to(device)output = pipe(noise=noise)display(output.images[0])display(Audio(output.audios[0], rate=22050))(В выводе — спектрограмма 1024×256, то есть клип вчетверо длиннее, примерно 24 с. U-Net в основном свёрточная, поэтому принимает вход другой ширины, хотя обучалась на квадратах 256×256.)
Звучит не слишком впечатляюще, но для начала неплохо :) Поэкспериментируйте со скоростью обучения и числом эпох и делитесь лучшими результатами в Discord, чтобы мы улучшали их вместе!
Над чем стоит подумать:
- Мы работаем с квадратными спектрограммами 256 пикселей, и это ограничивает размер батча. Удастся ли восстановить звук достаточного качества из спектрограммы 128×128?
- Вместо случайной аугментации изображений мы каждый раз берём разные куски аудиоклипа. Но, может быть, при обучении на много эпох это можно улучшить другими видами аугментации?
- Как ещё можно генерировать этим способом более длинные клипы? Например, сгенерировать начальный клип на 5 с, а затем, вдохновившись идеями inpainting, генерировать дополнительные фрагменты звука, продолжающие начальный клип…
- Что в контексте диффузии на спектрограммах будет аналогом image-to-image?
Выгрузка на Hub
Заголовок раздела «Выгрузка на Hub»Когда модель вас устроит, её можно сохранить и выгрузить на Hub, чтобы и другие могли ею насладиться:
from huggingface_hub import get_full_repo_name, HfApi, create_repo, ModelCard# Выбираем имя для моделиmodel_name = "audio-diffusion-electronic"hub_model_id = get_full_repo_name(model_name)# Сохраняем конвейер локальноpipe.save_pretrained(model_name)# Смотрим содержимое папки!ls {model_name}Вывод:
mel model_index.json scheduler unet# Создаём репозиторийcreate_repo(hub_model_id)# Выгружаем файлыapi = HfApi()api.upload_folder( folder_path=f"{model_name}/scheduler", path_in_repo="scheduler", repo_id=hub_model_id)api.upload_folder( folder_path=f"{model_name}/mel", path_in_repo="mel", repo_id=hub_model_id)api.upload_folder(folder_path=f"{model_name}/unet", path_in_repo="unet", repo_id=hub_model_id)api.upload_file( path_or_fileobj=f"{model_name}/model_index.json", path_in_repo="model_index.json", repo_id=hub_model_id,)# Выгружаем карточку моделиcontent = f"""---license: mittags:- pytorch- diffusers- unconditional-audio-generation- diffusion-models-class---
# Model Card for Unit 4 of the [Diffusion Models Class 🧨](https://github.com/huggingface/diffusion-models-class)
This model is a diffusion model for unconditional audio generation of music in the genre {chosen_genre}
## Usage
<pre>from IPython.display import Audiofrom diffusers import DiffusionPipeline
pipe = DiffusionPipeline.from_pretrained("{hub_model_id}")output = pipe()display(output.images[0])display(Audio(output.audios[0], rate=pipe.mel.get_sample_rate()))</pre>"""
card = ModelCard(content)card.push_to_hub(hub_model_id)(Текст карточки по-русски: «Карточка модели для юнита 4 курса Diffusion Models Class 🧨. Это диффузионная модель
для безусловной генерации музыки в жанре chosen_genre. Использование: …» — и пример кода загрузки. Карточку обычно
оставляют на английском, чтобы модель нашли пользователи Hub.)
(Примечание переводчика: перед выгрузкой войдите в аккаунт Hugging Face с токеном с правом записи — например,
from huggingface_hub import notebook_login; notebook_login() в ноутбуке или huggingface-cli login в терминале
(в новых версиях библиотеки — hf auth login).)
Заключение
Заголовок раздела «Заключение»Надеемся, этот ноутбук дал вам немного почувствовать, какие возможности открывает генерация звука. Загляните в материалы по ссылкам из введения к этому юниту: там более изощрённые методы и поразительные сэмплы, которые они создают!
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| progressive distillation, teacher, student | прогрессивная дистилляция, учитель, ученик |
| noise schedule, loss weighting | расписание шума, взвешивание функции потерь |
| cascaded diffusion, super-resolution | каскадная диффузия, сверхразрешение |
| mixture of denoising experts (MoDE) | смесь экспертов-денойзеров |
| knowledge enhancement | обогащение знаниями |
| inversion, DDIM inversion | инверсия, инверсия DDIM |
| null-text inversion | инверсия с оптимизацией «пустого» текста |
| cross-attention control | управление перекрёстным вниманием |
| inpainting, mask | дорисовка (inpainting), маска |
| deterministic / stochastic sampler | детерминированный / стохастический сэмплер |
| predicted , direction pointing to | предсказанный , направление, указывающее на |
| iterative refinement, corruption | итеративное уточнение, «порча» данных |
| masked token modeling | генерация через маскирование токенов |
| Diffusion Transformer (DiT) | диффузионный трансформер |
| waveform, time domain | звуковая волна, временная область |
| spectrogram, mel spectrogram | спектрограмма, мел-спектрограмма |
| sample rate, resampling | частота дискретизации, передискретизация |
| Griffin-Lim | алгоритм Гриффина — Лима (восстановление фазы) |
| collate function, dataloader | функция collate (сборка батча), загрузчик данных |
| model card | карточка модели |