How To Scale Your Model: обзор книги и введение
Путеводитель по книге Google DeepMind о масштабировании LLM: перевод введения, карта всех двенадцати глав с переводами, порядок чтения вместе с курсом ChinaAI и пересказ глав о профилировании, JAX и выводах.
How To Scale Your Model («Как масштабировать свою модель», с подзаголовком «Системный взгляд на LLM на TPU») — открытая онлайн-книга исследователей Google DeepMind о том, как большие языковые модели работают на реальном железе: сколько стоит каждая операция, во что она упирается — в вычисления, память или связь между чипами, — и как делить модель между тысячами ускорителей при обучении и инференсе. Примеры в основном про TPU, но арифметика та же для GPU, а последняя глава целиком посвящена GPU NVIDIA.
Как читать вместе с курсом ChinaAI
Заголовок раздела «Как читать вместе с курсом ChinaAI»Книга рассчитана на читателя, который уже понимает трансформер и обучение LLM. В курсе ChinaAI это значит: после ступени 4 (GPT с нуля) и параллельно ступени 5. Порядок, который мы советуем:
flowchart TD
S4["Ступень 4: GPT с нуля"] --> C1["Гл. 1: roofline"]
C1 --> L57["Урок 5.7.1: как устроена видеокарта"]
L57 --> C12["Гл. 12: GPU"]
C1 --> C4["Гл. 4: математика трансформера"]
C4 --> L51["Урок 5.1.1: законы масштабирования"]
C1 --> C2["Гл. 2: TPU"]
C2 --> C3["Гл. 3: шардирование и коллективные операции"]
C3 --> C5["Гл. 5–6: параллелизм при обучении"]
C5 --> L54["Уроки 5.4.3 и 5.7.4: DDP, FSDP на 4 GPU"]
C4 --> C7["Гл. 7–8: инференс"]
C7 --> L71["Уроки 7.1.1–7.1.2: prefill, decode, vLLM"]
- Минимум (≈4–5 часов): главы 1 и 4 — после этого вы умеете оценивать время любой операции и считать FLOPs, параметры и KV-кэш любого трансформера. Это нужно к урокам «Законы масштабирования» и «Как устроена видеокарта и куда уходит время».
- Обучение на многих GPU (+5–6 часов): главы 3, 5 и 12 — к урокам «Распределённое обучение» и «Четыре видеокарты: DDP и FSDP на практике». Глава 2 о TPU нужна ради обозначений и интуиции об иерархии каналов связи.
- Инференс (+3 часа): глава 7 — к урокам «Prefill и decode, узкие места» и «vLLM, SGLang и непрерывный батчинг».
- Главы 6 и 8 — практические разборы на LLaMA 3; их выводы пересказаны в конце переводов глав 5 и 7. Главы 9–10 — о JAX и профилировщике TPU; для курса на PyTorch они необязательны (пересказ — ниже).
Карта книги
Заголовок раздела «Карта книги»| Глава оригинала | О чём | Перевод | Вид | К какому уроку | Важность |
|---|---|---|---|---|---|
| 0. Intro | Зачем это нужно, план книги | ниже на этой странице | полный | — | ★★ |
| 1. All About Rooflines | Время операции = max(вычисления, связь); арифметическая интенсивность; батч больше 240 | глава 1 | полный | 5.7.1, 7.1.1 | ★★★ |
| 2. How to Think About TPUs | MXU, VMEM, HBM; сеть ICI и тор; иерархия каналов | глава 2 | полный | 5.7.1 | ★★ |
| 3. Sharded Matrices | Нотация шардирования, 4 случая умножения, AllGather / ReduceScatter / AllReduce / AllToAll | глава 3 | полный (задачи выборочно) | 5.4.3 | ★★★ |
| 4. Transformer Math | FLOPs и параметры по частям, 6ND, доля внимания, KV-кэш, Flash Attention | глава 4 | полный | 5.1.1, 5.2.1 | ★★★ |
| 5. Training | DP, FSDP/ZeRO, TP, FSDP+TP, конвейер, между подами | главы 5–6 | полный | 5.4.3, 5.7.4 | ★★★ |
| 6. Training LLaMA 3 | Параметры, FLOPs, память и шардирование LLaMA 3-70B | в конце главы 5 | пересказ | 5.1.1 | ★★ |
| 7. Inference | Prefill и decode, задержка, KV-кэш, шардирование, движок инференса | главы 7–8 | полный (ядро) | 7.1.1, 7.1.2 | ★★★ |
| 8. Serving LLaMA 3 | Стоимость и топология обслуживания LLaMA 3-70B на TPU v5e | в конце главы 7 | пересказ | 7.1.2 | ★★ |
| 9. Profiling | Стек JAX → XLA → TPU, профилировщик, чтение трассы | ниже | пересказ | 5.7.1 | ★ |
| 10. JAX | Параллелизм в JAX: jit с шардированием, shard_map, коллективное умножение | ниже | пересказ | — | ★ |
| 11. Conclusions | Благодарности и что читать дальше | ниже | пересказ | — | ★ |
| 12. GPUs | SM, тензорные ядра, NVLink/InfiniBand, коллективные операции, roofline параллелизма на GPU | глава 12 | ядро | 5.7.1, 5.7.4 | ★★★ |
Введение (перевод части 0)
Заголовок раздела «Введение (перевод части 0)»Обучение LLM часто похоже на алхимию, но понимать и оптимизировать производительность моделей не обязательно так. Эта книга стремится развеять туман вокруг науки о масштабировании языковых моделей: как работают TPU (и GPU) и как они общаются друг с другом, как LLM работают на реальном железе и как параллелить модели при обучении и инференсе, чтобы они эффективно работали в огромном масштабе. Если вы когда-нибудь задавались вопросом «сколько должно стоить обучение этой LLM», или «сколько памяти мне нужно, чтобы самому обслуживать эту модель», или «что такое AllGather», надеемся, книга вам пригодится. — описание книги.
(На заставке оригинала — рисунок дракона, dragon.png.)
Многое в глубоком обучении всё ещё сводится к своего рода чёрной магии, но оптимизация производительности моделей не обязана быть таковой — даже в огромном масштабе! Сравнительно простые принципы применимы везде — от одного ускорителя до десятков тысяч, — и их понимание позволяет делать много полезного:
- прикидывать, насколько близки части вашей модели к теоретическому оптимуму;
- осознанно выбирать схемы параллелизма в разных масштабах (как делить вычисления между несколькими устройствами);
- оценивать стоимость и время обучения и запуска больших трансформеров;
- проектировать алгоритмы, использующие особые возможности железа;
- проектировать железо, явно понимая, что ограничивает производительность нынешних алгоритмов.
Что нужно знать заранее. Мы предполагаем базовое понимание LLM и архитектуры трансформера, но не обязательно того, как они работают в масштабе. Нужно знать основы обучения LLM и, в идеале, немного знать JAX. Полезной предварительной литературой могут быть этот пост об архитектуре трансформера и оригинальная статья о трансформере. Посмотрите также этот список литературы для параллельного и последующего чтения.
Цели и обратная связь. К концу книги вы должны уверенно оценивать лучшую схему параллелизма для трансформера на заданной аппаратной платформе и примерно — сколько должны занимать обучение и инференс. Если нет — напишите нам или оставьте комментарий! Будем рады узнать, как сделать изложение понятнее.
Почему это должно вас волновать?
Заголовок раздела «Почему это должно вас волновать?»Три-четыре года назад, думаю, большинству исследователей ML не понадобилось бы понимать ничего из содержания этой книги. Но сегодня даже «маленькие» модели работают так близко к пределам железа, что для новых исследований приходится думать об эффективности в масштабе1. Выигрыш 20% на бенчмарках ничего не стоит, если он оплачен потерей 20% эффективности относительно roofline. Многообещающие архитектуры моделей регулярно проваливаются либо потому, что не могут эффективно работать в масштабе, либо потому, что никто не потрудился этого добиться.
Цель «масштабирования модели» — иметь возможность увеличивать число чипов для обучения или инференса, получая пропорциональный, линейный рост пропускной способности. Это называют «сильным масштабированием» (strong scaling). Хотя добавление чипов («параллелизм») обычно сокращает время вычислений, оно же добавляет связь между чипами. Когда связь длится дольше вычислений, мы «упираемся в связь» и сильно масштабироваться не можем2. Если понимать железо достаточно хорошо, чтобы предвидеть, где возникнут эти узкие места, модели можно спроектировать или перенастроить так, чтобы их избежать3.
Наша цель в этой книге — объяснить, как работает железо TPU (и GPU) и как архитектура трансформера развивалась, чтобы хорошо работать на нынешнем железе. Надеемся, это будет полезно и исследователям, проектирующим новые архитектуры, и инженерам, которые заставляют нынешнее поколение LLM работать быстро.
Общий план
Заголовок раздела «Общий план»Общая структура книги такова.
Глава 1 объясняет roofline-анализ и факторы, которые могут ограничивать масштабирование (связь, вычисления и память). Глава 2 и глава 3 подробно рассказывают, как работают TPU — и как отдельные чипы, и — что критически важно — как связанная система с межчиповыми каналами ограниченной пропускной способности и задержки. Мы ответим на вопросы вроде:
- Сколько должно занимать умножение матриц определённого размера? С какого момента оно упирается в вычисления, память или пропускную способность связи?
- Как TPU соединяются в кластеры для обучения? Какая пропускная способность у каждой части системы?
- Сколько занимает сбор, разброс или перераспределение массивов между несколькими TPU?
- Как эффективно перемножать матрицы, по-разному распределённые между устройствами?
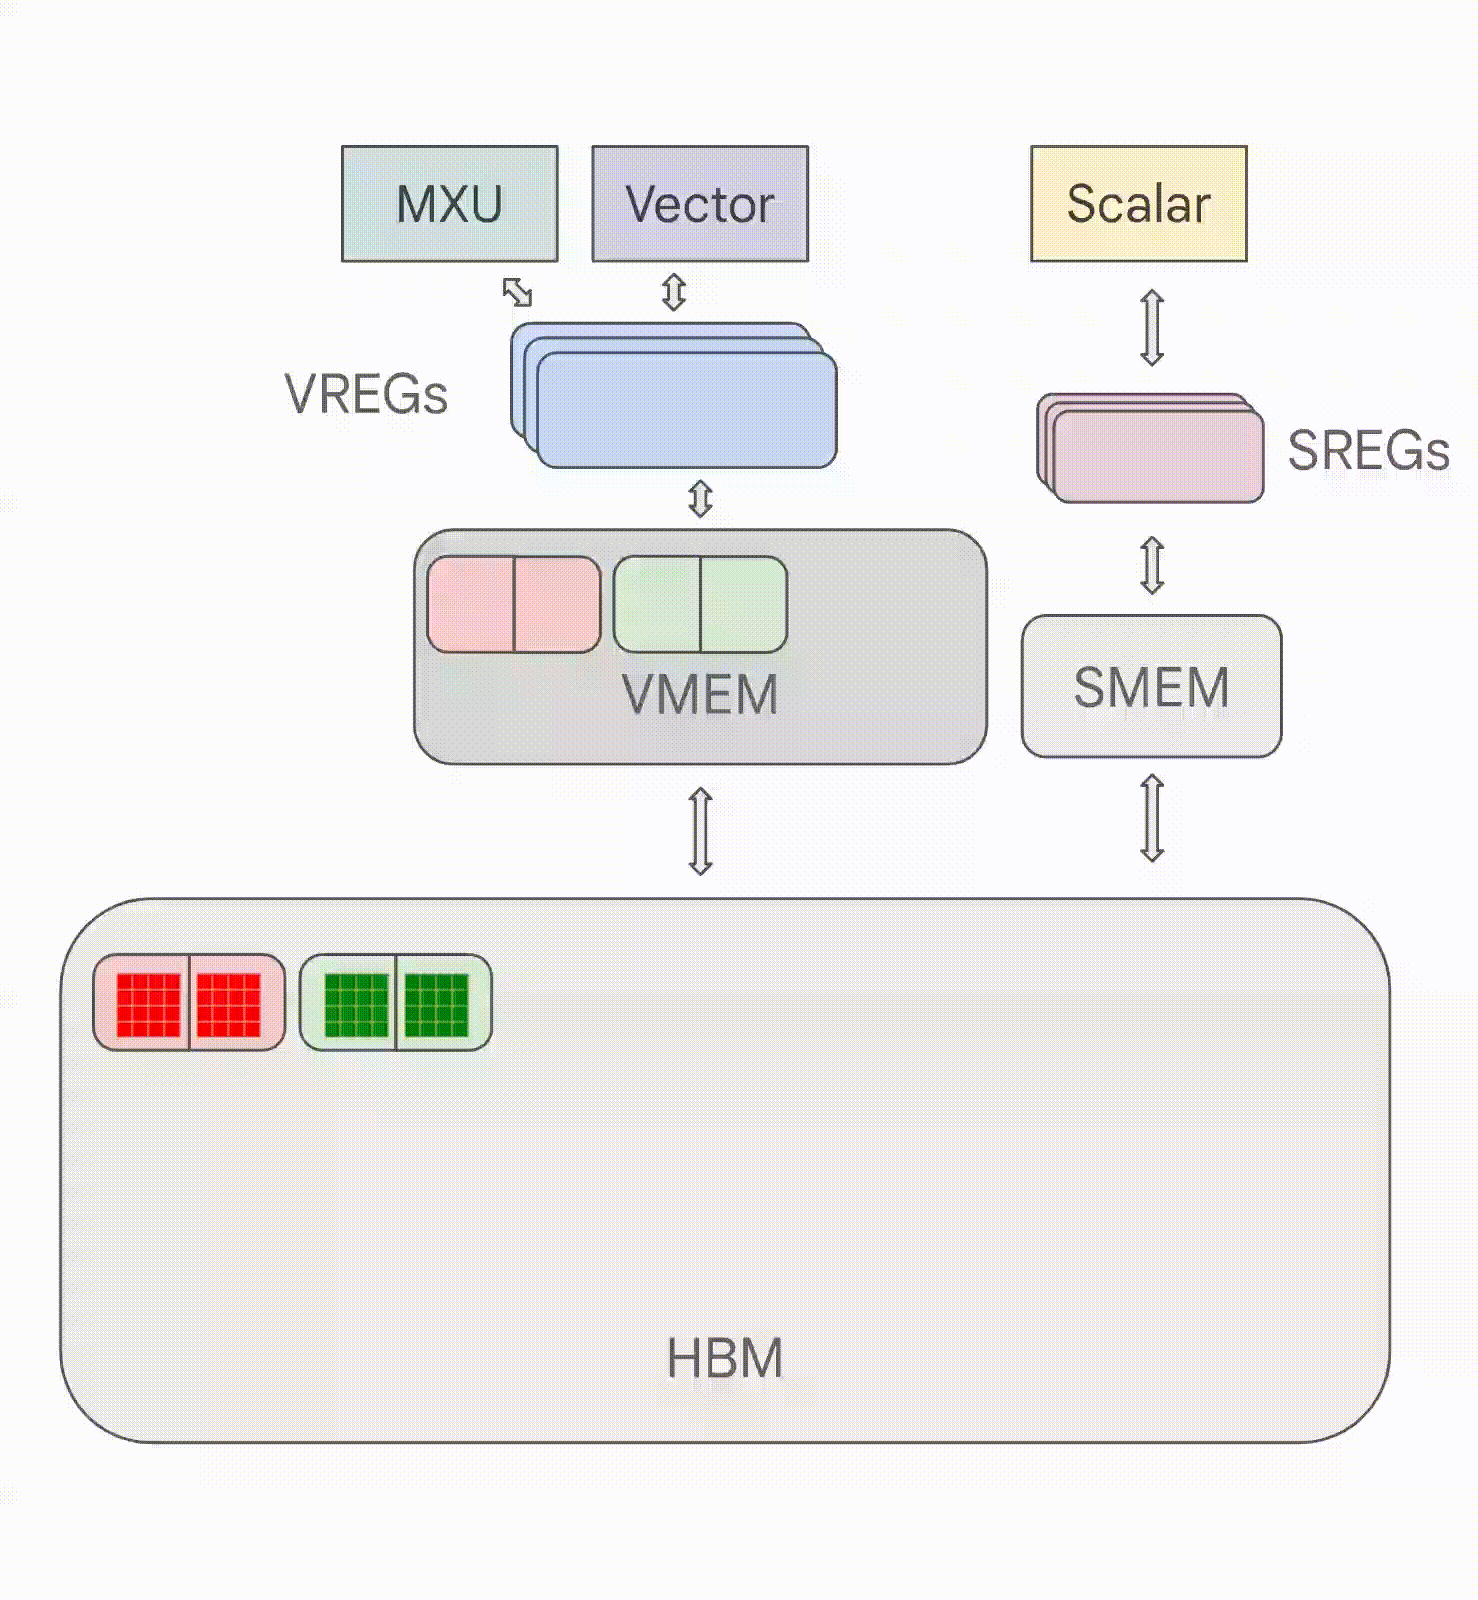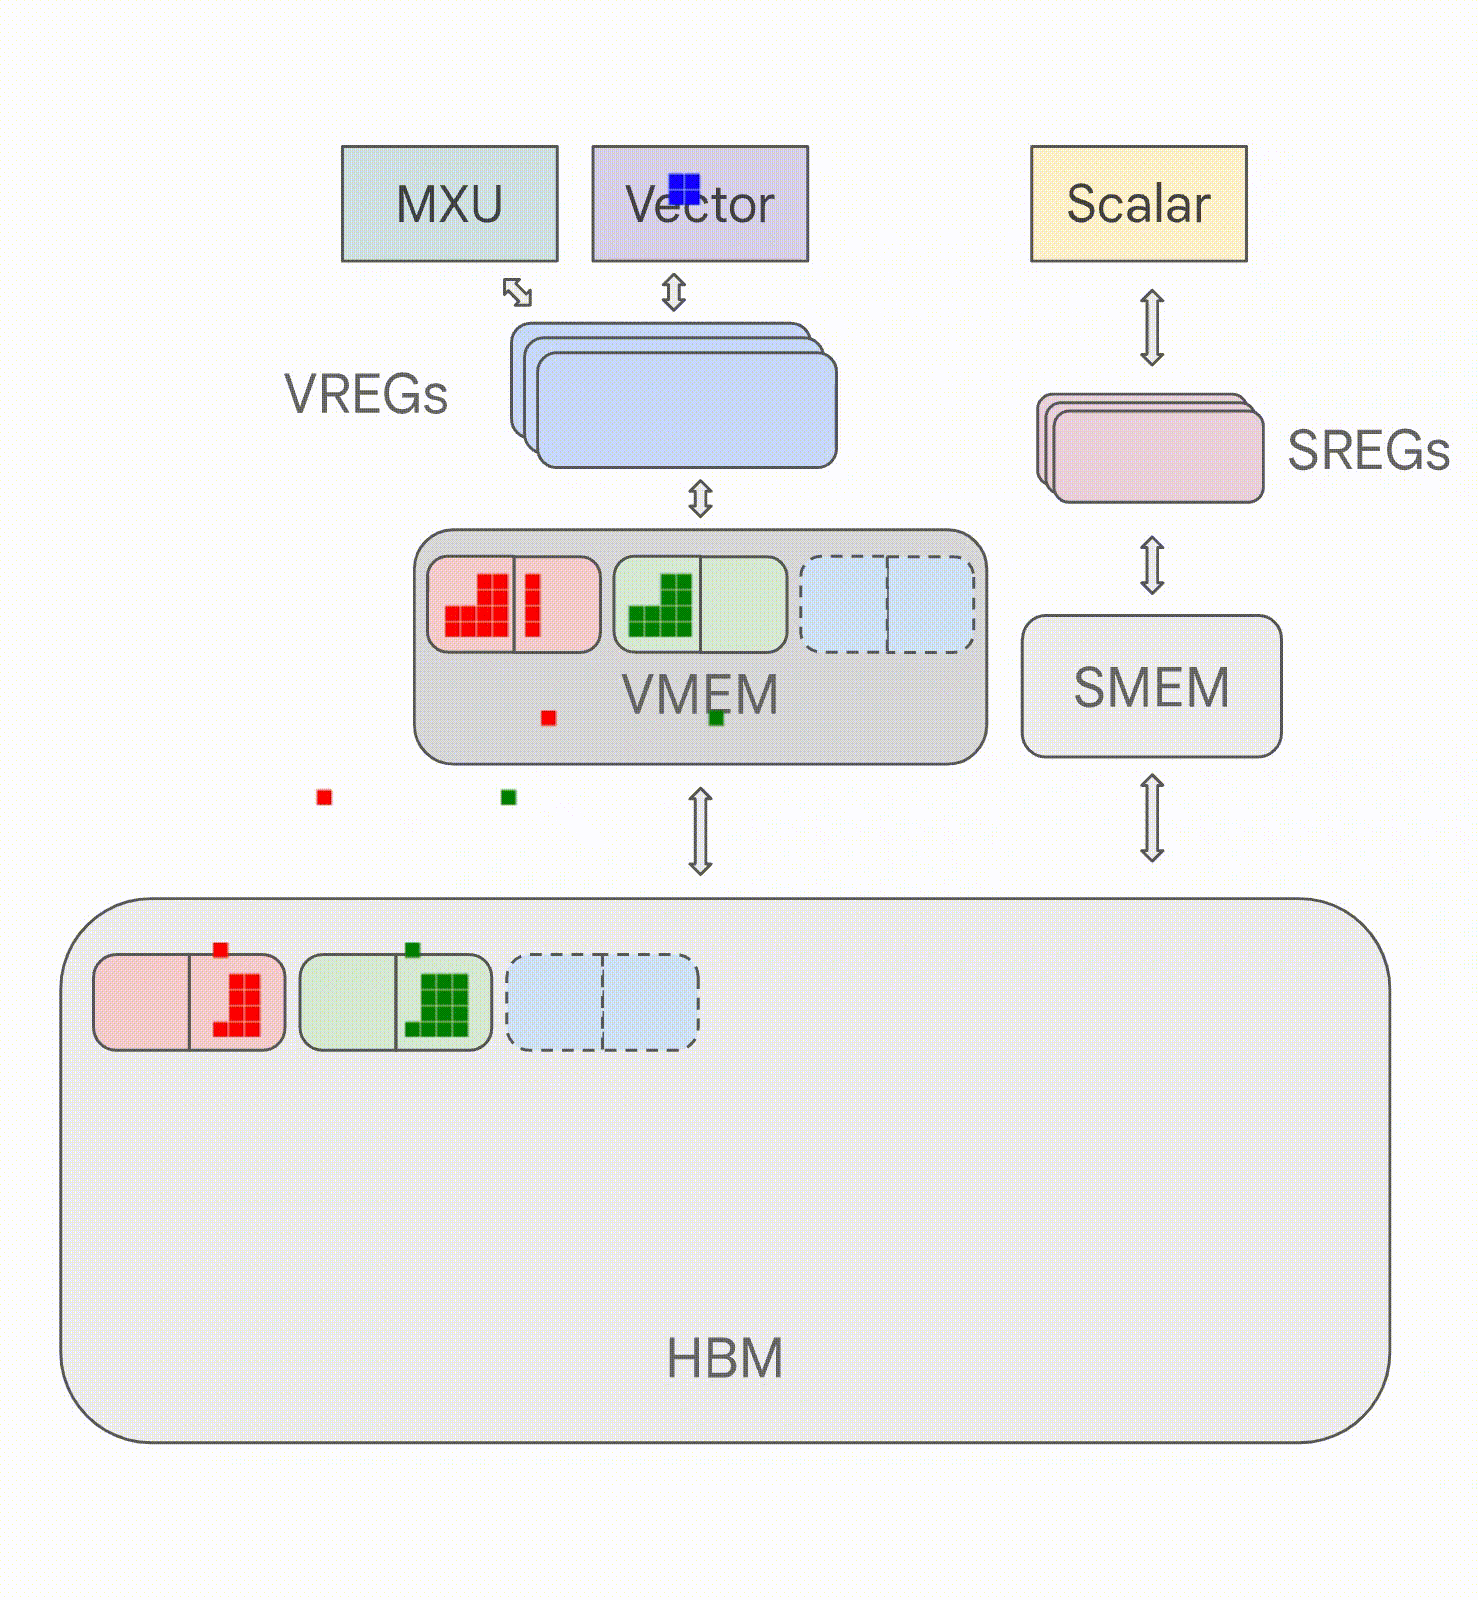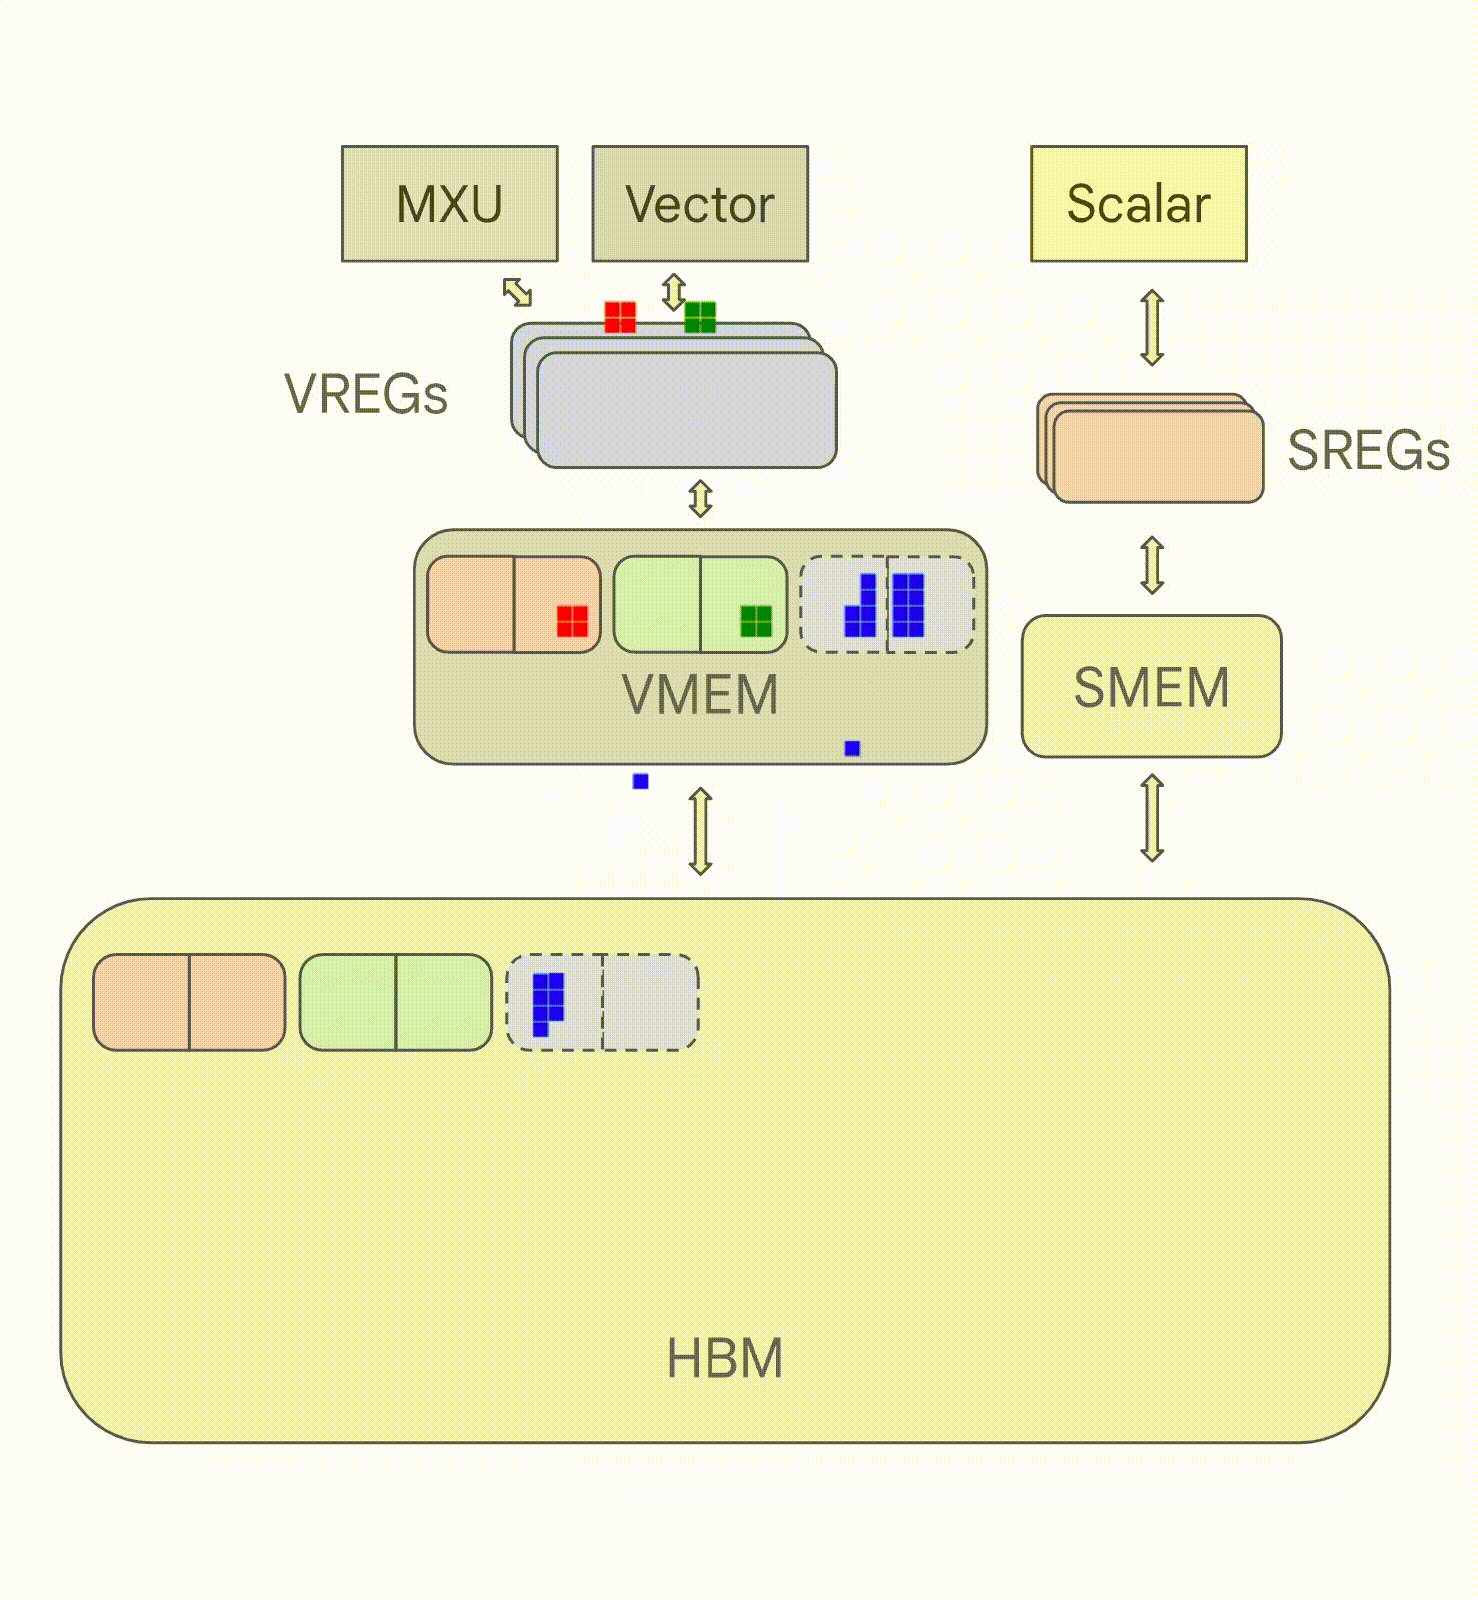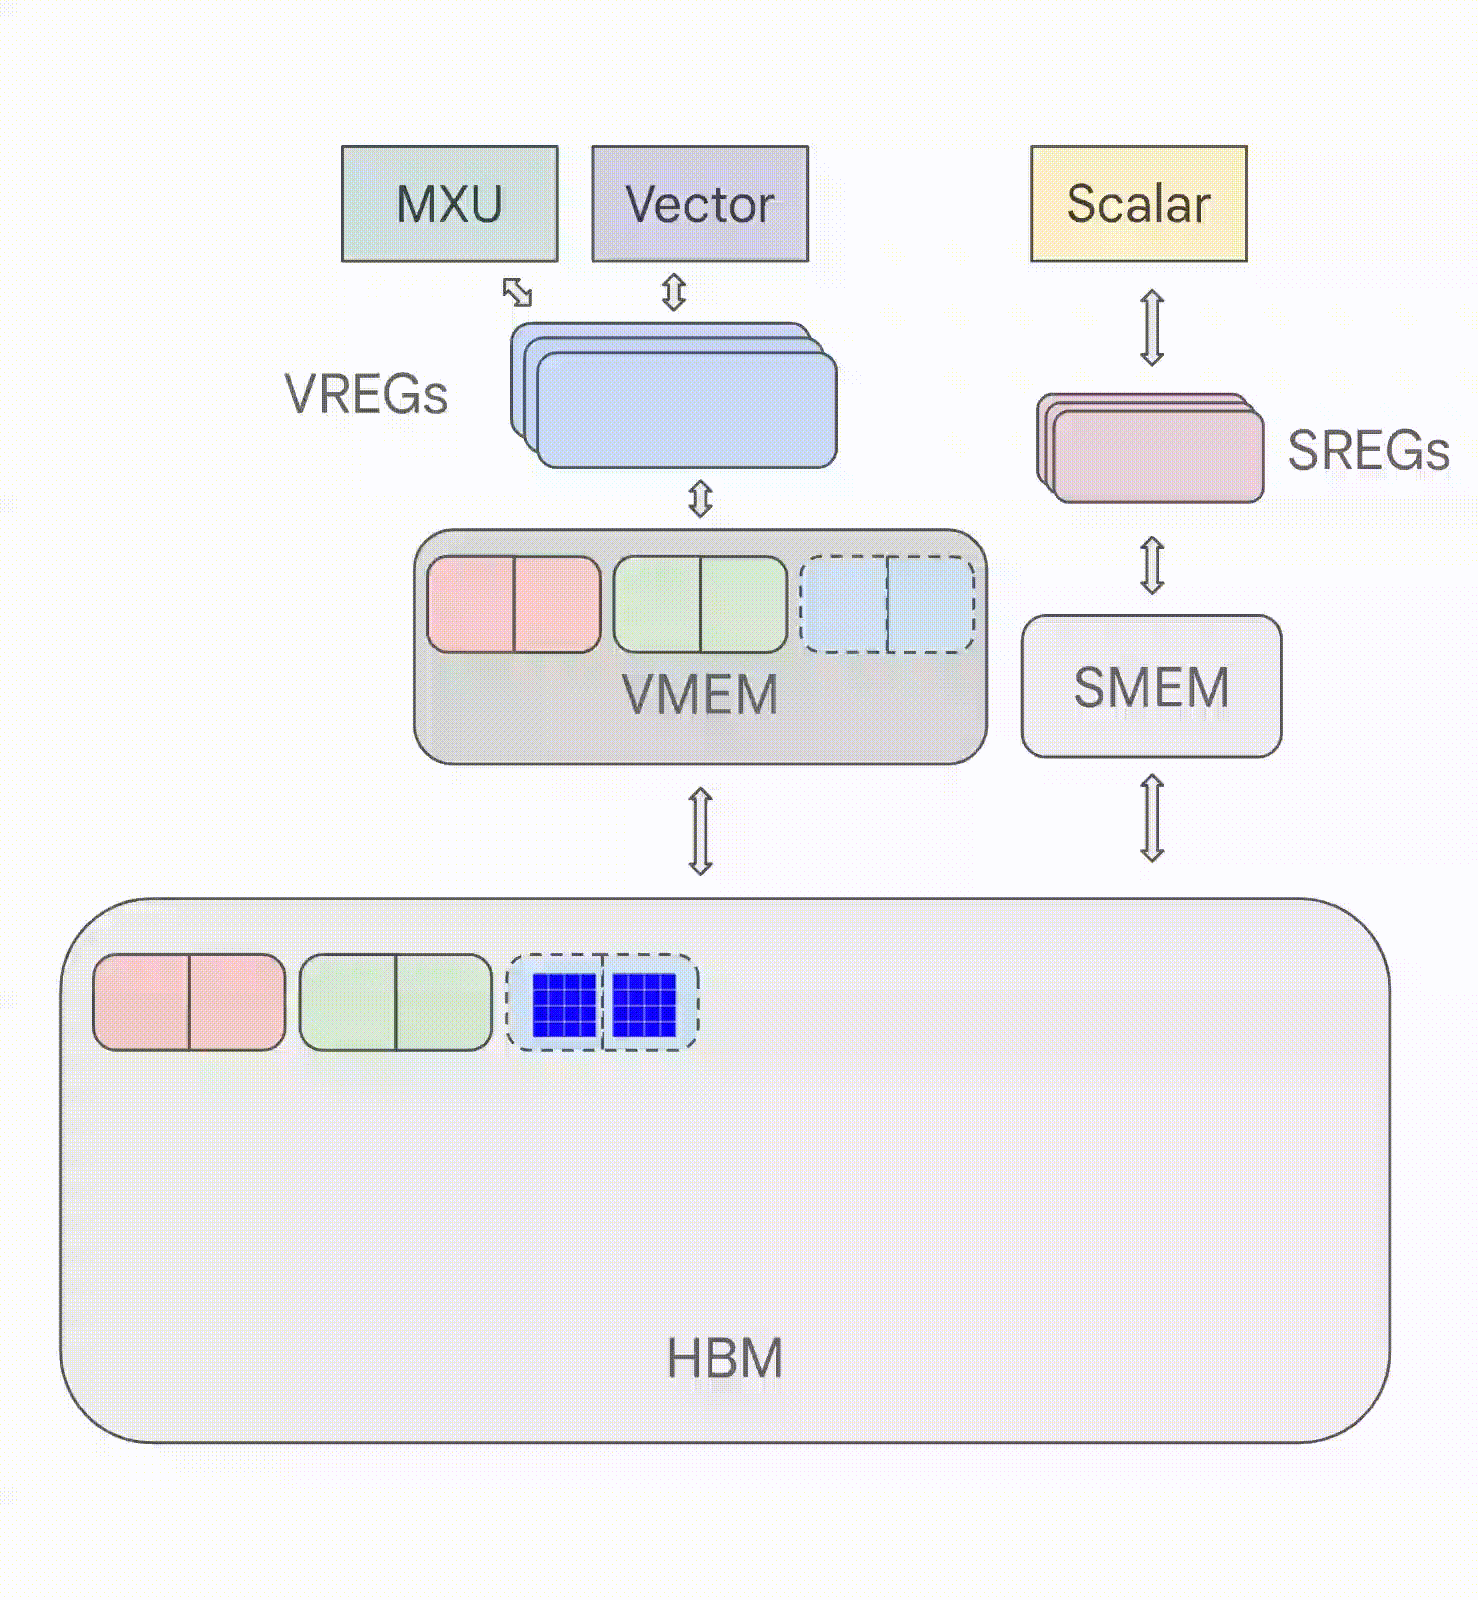
(Рисунок из главы 2 в оригинале, pointwise-product.gif, показывает, как TPU выполняет поэлементное произведение. В зависимости от размеров массивов и пропускной способности разных каналов мы можем упираться в вычисления (используя всю вычислительную мощность железа) или в память (узкое место — загрузка из памяти).)
Пять лет назад в ML был пёстрый ландшафт архитектур — свёрточные сети, LSTM, MLP, трансформеры, — а теперь у нас в основном один трансформер. Мы твёрдо уверены, что стоит понимать каждую часть архитектуры трансформера: точные размеры каждой матрицы, где стоит нормализация, сколько параметров и FLOPs4 в каждой части. Глава 4 тщательно проходит эту «математику трансформера» и показывает, как считать параметры и FLOPs и для обучения, и для инференса. Это говорит нам, сколько памяти займёт модель, сколько времени уйдёт на вычисления или связь и когда внимание станет важным по сравнению с прямыми блоками.
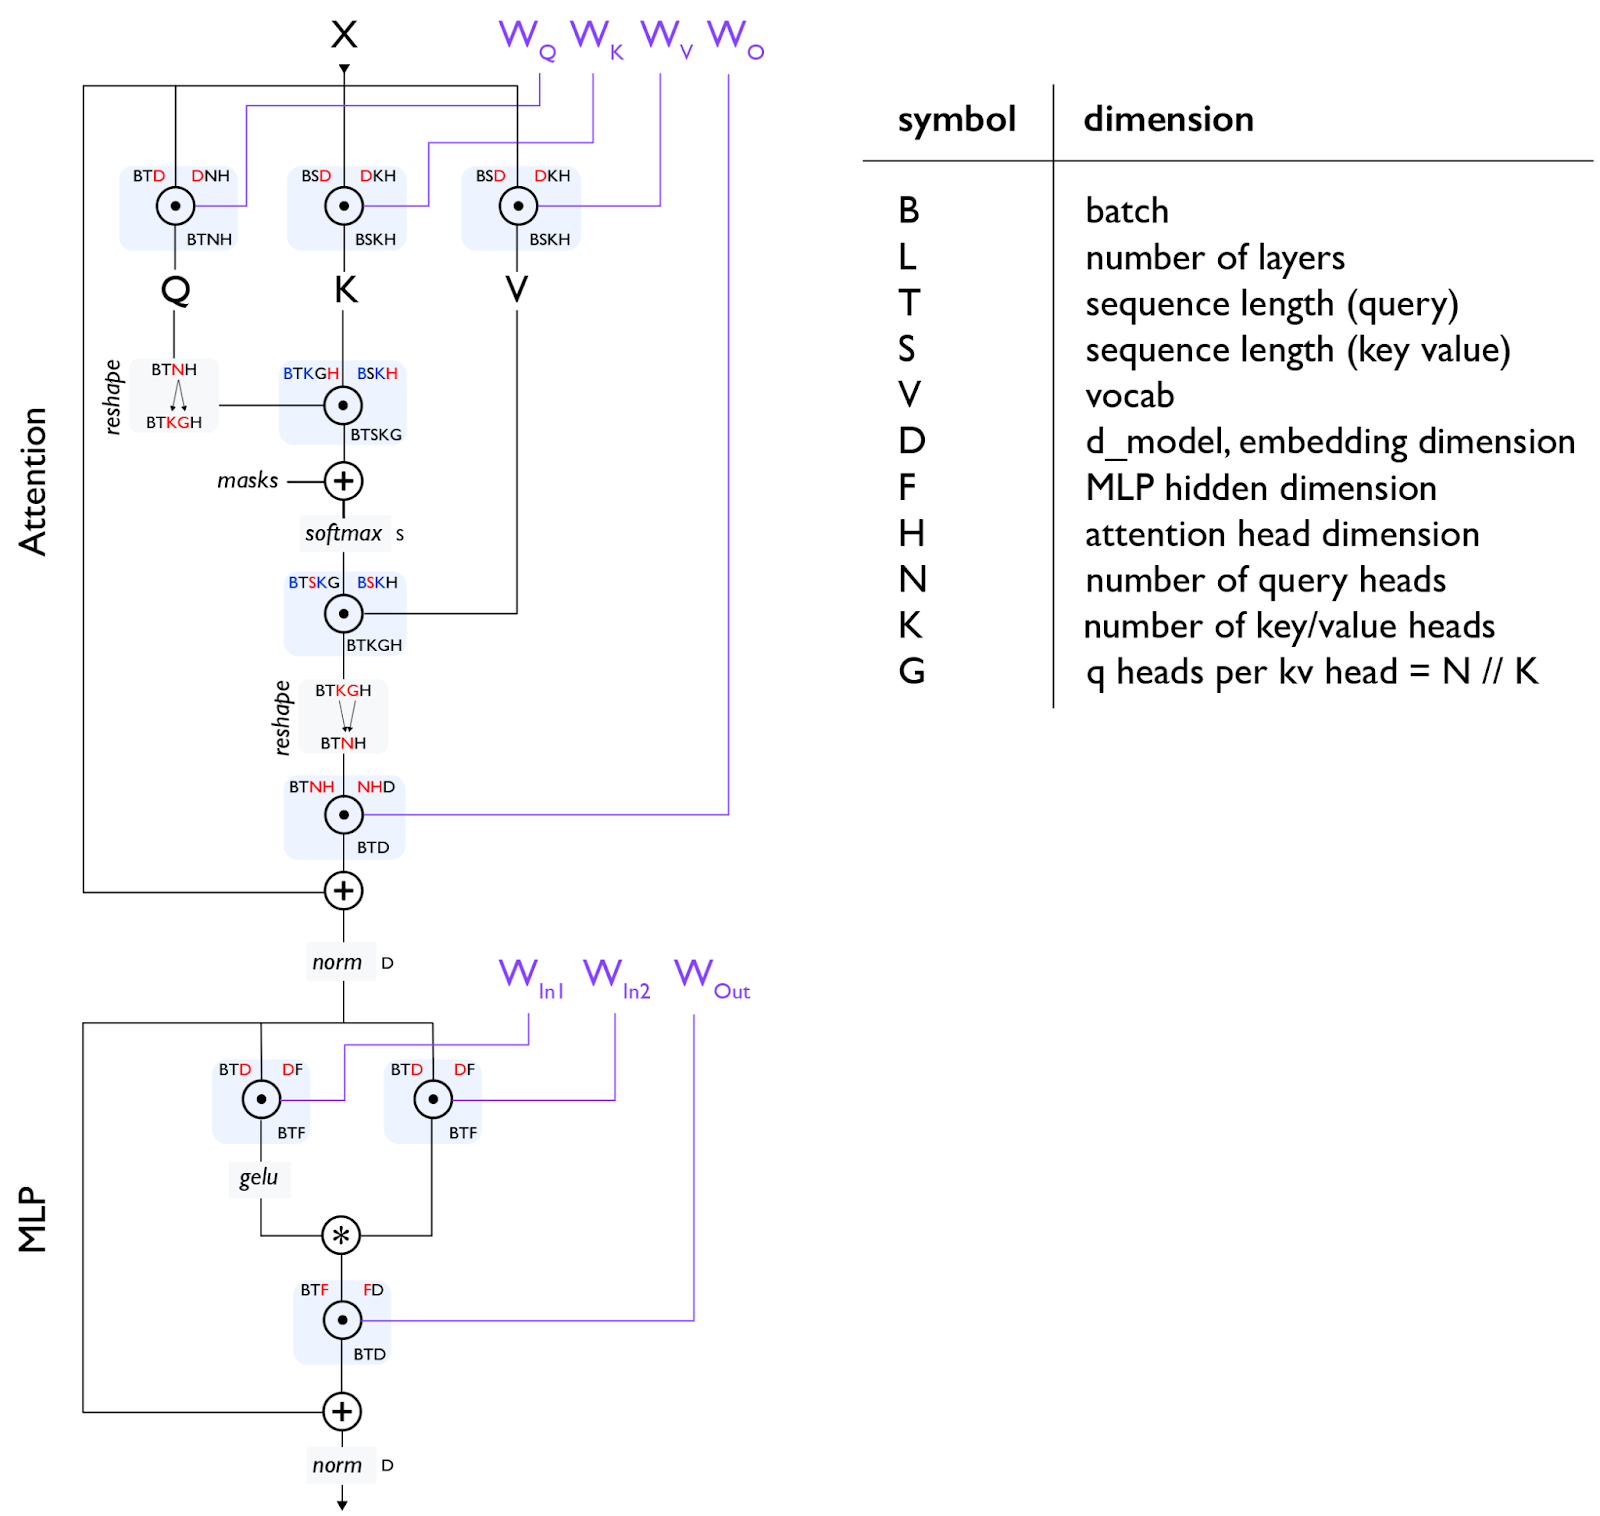
(Рисунок в оригинале, transformer-diagram.png: стандартный слой трансформера, где каждое умножение матриц показано точкой в круге, а все параметры (кроме норм) — фиолетовым. Подробно схема разобрана в главе 4.)
Глава 5: обучение и глава 7: инференс — ядро книги: в них мы обсуждаем фундаментальный вопрос: как при модели определённого размера и определённом числе чипов распараллелить модель, чтобы остаться в режиме «сильного масштабирования»? Это простой вопрос с удивительно сложным ответом. В общих чертах есть четыре главных приёма параллелизма для разбиения моделей на несколько чипов (данных, тензорный, конвейерный и экспертный) и ряд других приёмов для снижения требований к памяти (рематериализация, шардирование оптимизатора и модели, оно же ZeRO, выгрузка на хост, накопление градиентов). Многие из них мы здесь обсуждаем.
Надеемся, к концу этих глав вы сможете сами выбирать между ними для новых архитектур или условий. Главы 6 и 8 — практические руководства, применяющие эти понятия к популярной открытой модели LLaMA 3.
Наконец, главы 9 и 10 рассматривают, как реализовать некоторые из этих идей на JAX и как профилировать и отлаживать код, когда что-то идёт не так. Глава 12 — новая и подробно разбирает GPU.
На протяжении всей книги мы стараемся давать задачи для самостоятельного решения. Не чувствуйте себя обязанными читать все главы или читать их по порядку. И, пожалуйста, оставляйте отзывы. Пока это черновик, и он будет дорабатываться. Спасибо!
Мы хотим отметить Джеймса Брэдбери и Блейка Хехтмана, которые вывели многие идеи этой книги.
Ссылки на главы
Заголовок раздела «Ссылки на главы»Эта серия, вероятно, длиннее, чем нужно, но надеемся, вас это не отпугнёт. Первые три главы — подготовительные, и их можно пропустить, если материал знаком, хотя в них вводятся обозначения, используемые дальше. Последние три части, пожалуй, самые практически полезные: в них объясняется, как работать с настоящими моделями.
Часть 1: подготовка
- Глава 1: краткое введение в roofline-анализ. Алгоритмы ограничены тремя вещами: вычислениями, связью и памятью. По ним можно приблизительно оценить, насколько быстро будут работать наши алгоритмы.
- Глава 2: как думать о TPU. Как работают TPU? Как это влияет на то, какие модели мы можем обучать и обслуживать?
- Глава 3: шардированные матрицы и как их умножать. Здесь мы объясняем шардирование модели и параллелизм на многих TPU на примере нашей любимой операции — умножения (шардированных) матриц.
Часть 2: трансформеры
- Глава 4: вся математика трансформера, которую нужно знать. Сколько FLOPs тратит трансформер в прямом и обратном проходе? Можете ли вы посчитать число параметров? Размер KV-кэша? Здесь мы проходим эту математику.
- Глава 5: как параллелить трансформер при обучении. FSDP. Шардирование Megatron. Конвейерный параллелизм. Как при данном числе чипов обучить модель данного размера с данным батчем как можно эффективнее?
- Глава 6: обучение LLaMA 3 на TPU. Как бы мы обучали LLaMA 3 на TPU? Сколько бы это заняло? Сколько бы стоило?
- Глава 7: всё об инференсе трансформера. Обучив модель, её нужно обслуживать. Инференс добавляет новое соображение — задержку — и меняет картину памяти. Мы поговорим о раздельном обслуживании и о том, как думать о KV-кэшах.
- Глава 8: обслуживание LLaMA 3 на TPU. Сколько стоило бы обслуживать LLaMA 3 на TPU v5e? Каковы компромиссы между задержкой и пропускной способностью?
Часть 3: практические руководства
- Глава 9: как профилировать код на TPU. Настоящие LLM никогда не бывают так просты, как теория выше. Здесь мы объясняем стек JAX + XLA и как использовать профилировщик JAX/TensorBoard, чтобы находить и исправлять реальные проблемы.
- Глава 10: программирование TPU на JAX. JAX даёт много «волшебных» API для параллельных вычислений, но нужно знать, как ими пользоваться. Интересные примеры и задачи с решениями.
Часть 4: выводы и бонус
- Глава 11: выводы и что читать дальше. Заключительные мысли и литература о TPU и LLM.
- Глава 12: как думать о GPU. Бонусная глава о GPU: как они работают, как связаны в сеть и чем их roofline отличаются от TPU.
Глава 9: как профилировать код на TPU
Заголовок раздела «Глава 9: как профилировать код на TPU»Пересказ. До сих пор книга теоретична: прикидки на основе roofline. Но многое в оптимизации сводится к практическим
деталям — как работает компилятор XLA и как пользоваться профилировщиком, когда что-то идёт не так. Глава показывает стек
сверху вниз: код JAX превращается в StableHLO, компилятор XLA оптимизирует и сливает операции в «фьюжны» (fusions)
и порождает код для TPU; профилировщик JAX (jax.profiler, просмотр в TensorBoard/XProf) показывает Trace Viewer —
временную шкалу операций на каждом ядре (по ней можно перемещаться клавишами W/A/S/D, как в игре), Graph Viewer —
граф HLO, и Memory Profile — расход памяти во времени. Отдельный раздел учит читать операцию XLA: по её формам
и шардированию восстановить, какое это умножение или коллективная операция, и сравнить её реальное время с roofline-оценкой.
Разбирается «почти реальный» профиль трансформера: где AllGather не перекрылся с вычислениями, где умножение дольше оценки.
Для курса: на GPU роль этих инструментов играют torch.profiler и Nsight Systems; методика та же — найти операцию,
посчитать её roofline, сравнить с замером. Это разбирает урок «Как устроена видеокарта и куда уходит время».
Глава 10: программирование TPU на JAX
Заголовок раздела «Глава 10: программирование TPU на JAX»Пересказ. Глава показывает, как реализовать идеи книги в JAX: создать сетку устройств (jax.make_mesh), задать
шардирование массивов (NamedSharding, PartitionSpec) и выбрать один из трёх режимов: автоматический (Auto — компилятор
при jax.jit сам выводит промежуточные шардирования и вставляет коллективные операции), явный (Explicit — шардирование
становится частью типа массива и проверяется) и ручной shard_map, где функция пишется для одного шарда, а связь задаётся
явно (jax.lax.all_gather, psum, psum_scatter, all_to_all, ppermute). Центральный пример — коллективное
умножение матриц, которое перекрывает AllGather с вычислениями, передавая куски по кольцу через ppermute. Все примеры
можно запускать на бесплатных TPU в Colab или на восьми «фальшивых» CPU-устройствах (jax.config.update('jax_num_cpu_devices', 8)).
В конце — задачи с решениями.
Для курса: в PyTorch тот же уровень — torch.distributed (коллективные операции) и DeviceMesh/DTensor
(шардирование тензоров); FSDP2 и тензорный параллелизм в PyTorch построены на них (уроки
«Распределённое обучение» и
«Четыре видеокарты: DDP и FSDP на практике»).
Глава 11: выводы и что читать дальше
Заголовок раздела «Глава 11: выводы и что читать дальше»Пересказ. Авторы благодарят коллег: многие идеи книги первыми вывели Джеймс Брэдбери, Райнер Поуп, Ноам Шазир и Блейк Хехтман; первую версию написал Шолто Дуглас, Джейкоб Остин превратил её в законченную книгу, большинство рисунков и анимаций сделали Ансельм Левская и Чарли Чен, главу об инференсе написал Чарли Чен. Список «что читать дальше» из главы (с пометками, где у нас есть перевод):
- TPU Deep Dive — подробный разбор архитектуры TPU в духе книги;
- Domain specific architectures for AI inference — железо и модели в духе книги;
- A Domain-Specific Supercomputer for Training Deep Neural Networks — одна из первых статей о TPU;
- Making Deep Learning Go Brrrr From First Principles — roofline и производительность на GPU и PyTorch;
- Writing TPU Kernels with Pallas — свои ядра для TPU;
- How to Optimize a CUDA Matmul Kernel for cuBLAS-like Performance — пошаговая оптимизация ядра умножения матриц на CUDA;
- Distributed arrays and automatic parallelization — API параллелизма в JAX;
- High Performance LLMs 2024 — курс Рафи Уиттена по производительности на TPU;
- Efficiently Scaling Transformer Inference — статья о математике инференса, вдохновившая многое в книге;
- Hugging Face Ultra-Scale Playbook — своего рода GPU-аналог книги (у нас есть перевод: часть 1, часть 2);
- Transformer Inference Arithmetic — блог с похожими идеями;
- Stanford CS336 — курс об обучении и обслуживании LLM, особенно задания 1 и 2 (у нас есть путеводители: задание 2 — системы, лекции о параллелизме);
- ML Engineering Handbook Стаса Бекмана — практическое руководство по инфраструктуре ML;
- блог ezyang — шардирование и внутреннее устройство PyTorch;
- The Anatomy of Collective Communication — коллективные операции на GPU и TPU.
Авторы заключают, что в этой области ещё много места для обстоятельных текстов и исследований — и многое можно изучать даже без большого числа ускорителей под рукой.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| scaling, strong scaling | масштабирование, сильное масштабирование |
| roofline analysis | roofline-анализ |
| compute / memory / communication bound | упор в вычисления / память / связь |
| parallelism: data, tensor, pipeline, expert | параллелизм: данных, тензорный, конвейерный, экспертный |
| rematerialization, ZeRO, host offload, gradient accumulation | рематериализация, ZeRO, выгрузка на хост, накопление градиентов |
| sharding, collective operations | шардирование, коллективные операции |
| prefill, decode, KV cache | обработка промпта, генерация, KV-кэш |
| disaggregated serving | раздельное обслуживание |
| profiler, trace viewer, fusion | профилировщик, просмотр трассы, слияние операций |
| co-design | совместное проектирование (железа и алгоритмов) |
Footnotes
Заголовок раздела «Footnotes»-
Исторически исследования в ML шли своего рода циклом «тик-так» между системными инновациями и улучшениями ПО. Алексу Крижевскому пришлось писать нечестивый код на CUDA, чтобы сделать свёрточные сети быстрыми, но через пару лет библиотеки вроде Theano и TensorFlow избавили от этой необходимости. Может, и здесь так будет, и через несколько лет всё из этой книги спрячут за абстракциями. Но законы масштабирования постоянно толкают модели на самый край возможностей железа, и, похоже, в обозримом будущем передовые исследования будут неразрывно связаны с пониманием того, как эффективно масштабировать модели на большие аппаратные топологии. ↩
-
С уменьшением времени вычислений обычно появляются и узкие места на уровне отдельного чипа. Ваш новенький TPU или GPU может быть рассчитан на 500 триллионов операций в секунду, но, если не быть осторожным, он так же легко выдаст десятую часть этого, увязнув в перемещении параметров в памяти. Взаимодействие вычислений на чип, пропускной способности памяти и общего объёма памяти критически важно для масштабирования. ↩
-
Проектировщики железа решают обратную задачу: построить железо, которое даёт ровно столько вычислений, пропускной способности и памяти, сколько нужно нашим алгоритмам, при минимальной стоимости. Можно представить, насколько это напряжённая задача «совместного проектирования»: нужно ставить на то, как будут выглядеть алгоритмы, когда первые чипы станут доступны, — часто через 2–3 года. История TPU — оглушительный успех в этой игре. Умножение матриц — уникальный алгоритм в том смысле, что использует гораздо больше FLOPs на байт памяти, чем почти любой другой (N FLOPs на байт), и ранние TPU с их архитектурой систолических массивов давали гораздо лучшее соотношение производительности и цены, чем GPU того времени. TPU проектировали под задачи ML, и GPU со своими тензорными ядрами быстро меняются, чтобы занять ту же нишу. Но представьте, во что бы обошлось, если бы нейросети не взлетели или изменились каким-то фундаментальным образом, с которым TPU (по своей природе менее гибкие, чем GPU) не справились бы. ↩
-
FLOPs — операции с плавающей точкой (FLoating point OPs), по сути общее число нужных сложений и умножений. Многие источники понимают под FLOPs «операции в секунду», а мы для этого явно пишем FLOPs/s. ↩