How To Scale Your Model, глава 1: всё о roofline
Полный перевод первой главы книги Google DeepMind о масштабировании LLM: куда уходит время, арифметическая интенсивность, roofline-график, почему матричное умножение упирается в вычисления при батче больше ~240 токенов, roofline для связи между чипами и задачи с ответами.
Когда мы запускаем алгоритмы на железе, нас ограничивают три вещи: как быстро компьютер считает (операций в секунду), какая у него пропускная способность для перемещения данных (байт в секунду) и сколько всего памяти есть для хранения данных (байт). Эти ограничения — «потолки» (roofline) — позволяют оценить время вычисления сверху и снизу. — подзаголовок главы.
Куда уходит время?
Заголовок раздела «Куда уходит время?»Начнём с предельно простого вопроса: почему алгоритм работает 50 мс, а не 50 с или 5 мс? Что на самом деле происходит внутри модели и занимает заметное время, и сколько времени это должно занимать?
Вычисления. Модель глубокого обучения — по сути, набор умножений матриц, каждое из которых состоит из «операций» умножения и сложения чисел с плавающей точкой (FLOPs). Скорость ускорителя определяет, сколько времени займёт их расчёт:
Например, NVIDIA H100 выполняет около FLOPs/s в bfloat161, а TPU v6e —
FLOPs/s2. Значит, FLOPs на H100 займут (примерно)
1e12 / 9.89e14 = 1.01ms, а на TPU v6e — 1e12 / 9.1e14 = 1.1ms3.
Связь внутри чипа. Внутри ускорителя тензоры нужно передавать между памятью ускорителя (HBM) и вычислительными ядрами. Пропускную способность этого канала называют «пропускной способностью HBM» (HBM bandwidth)4. У H100 это около 3,35 ТБ/с, у TPU v6e — около 1,6 ТБ/с.
Связь между чипами. Когда модель распределена по нескольким ускорителям, тензоры часто приходится передавать между ними. Обычно для этого у железа есть несколько вариантов (ICI, DCN и PCIe), каждый со своей пропускной способностью.
Внутри чипа или между чипами — мы измеряем связь в байтах в секунду и оцениваем общее время связи так:
Обычно (но не всегда) вычисления внутри чипа можно совместить по времени со связью внутри чипа и между чипами. Значит, время обучения и инференса можно оценить снизу максимумом из времени вычислений и времени связи. А сверху — их суммой. На практике мы оптимизируем по максимуму: алгебра проще, и обычно можно приблизиться к этой границе, совмещая связь и вычисления. Если оптимизировать с прицелом на максимум, нижняя и верхняя оценки различаются не более чем вдвое, поскольку . Дальше точность можно повысить, моделируя «области перекрытия» и накладные расходы, — для этого стоит профилировать конкретную модель и целевую систему.
Если считать, что связь и вычисления совмещаются идеально, то при железо загружено полностью. Это называют «упором в вычисления» (compute-bound). При мы, как правило, «упираемся в связь» (communication-bound)5, и хотя бы часть FLOPs/s ускорителя пропадает впустую в ожидании передачи данных. Понять, во что упрётся операция — в вычисления или в связь, — можно по её арифметической интенсивности (arithmetic intensity, или operational intensity).
Определение: арифметическая интенсивность алгоритма — отношение общего числа FLOPs, которые он выполняет, к числу байт, которые ему нужно передать — внутри чипа или между чипами.
Арифметическая интенсивность измеряет «FLOPs на байт» данной операции. В первом приближении, когда арифметическая интенсивность высока, велико по сравнению с , и мы обычно используем большую часть доступных FLOPs. Когда наоборот, мы тратим больше времени на связь, а FLOPs пропадают. Точка, где одно сменяется другим, — «пиковая арифметическая интенсивность» железа: отношение пиковых FLOPs/s ускорителя к его пропускной способности.
Величина — это арифметическая интенсивность, при которой ускоритель выходит
на свои пиковые FLOPs/s. Для MXU в TPU v5e это около 240 FLOPs/байт: TPU выполняет 1.97e14 FLOPs/s и загружает
из HBM 8.2e11 байт/с6. Значит, если арифметическая интенсивность алгоритма ниже 240 FLOPs/байт, он упрётся
в загрузку байт и железо будет использоваться плохо7. Рассмотрим один такой пример.
Пример (скалярное произведение). Чтобы вычислить скалярное произведение двух векторов в bfloat16,
x • y: bf16[N], bf16[N] → bf16[1], нужно загрузить из памяти и — по байт каждый, выполнить
умножений и сложений и записать в HBM 2 байта:
при . То есть арифметическая интенсивность скалярного произведения — : оно делает 0,5 операции с плавающей точкой на каждый загруженный байт. Это ниже интенсивности железа, и мы упрёмся в связь8.
Как выглядит roofline
Заголовок раздела «Как выглядит roofline»Компромисс между памятью и вычислениями можно показать на roofline-графике: по вертикали — пиковые достижимые FLOPs/s алгоритма на нашем железе (пропускная способность вычислений), по горизонтали — арифметическая интенсивность алгоритма. Оба масштаба логарифмические.
Рисунок в оригинале (roofline-improved.png): пример roofline-графика с двумя алгоритмами разной арифметической интенсивности (Algo 1 и Algo 2) и их теоретическими пиковыми скоростями при двух разных пропускных способностях (BW1 и BW2). Линия сначала идёт наклонно вверх, затем упирается в горизонтальный «потолок» пиковых FLOPs/s. В красной области алгоритм ограничен пропускной способностью при обеих пропускных способностях и теряет часть пиковых FLOPs/s железа. Жёлтая область ограничена пропускной способностью только при меньшей (BW1). Зелёная область упирается в вычисления при любой пропускной способности: здесь мы уже используем пиковые FLOPs/s ускорителя, и ни рост пропускной способности, ни рост интенсивности ничего не дают.
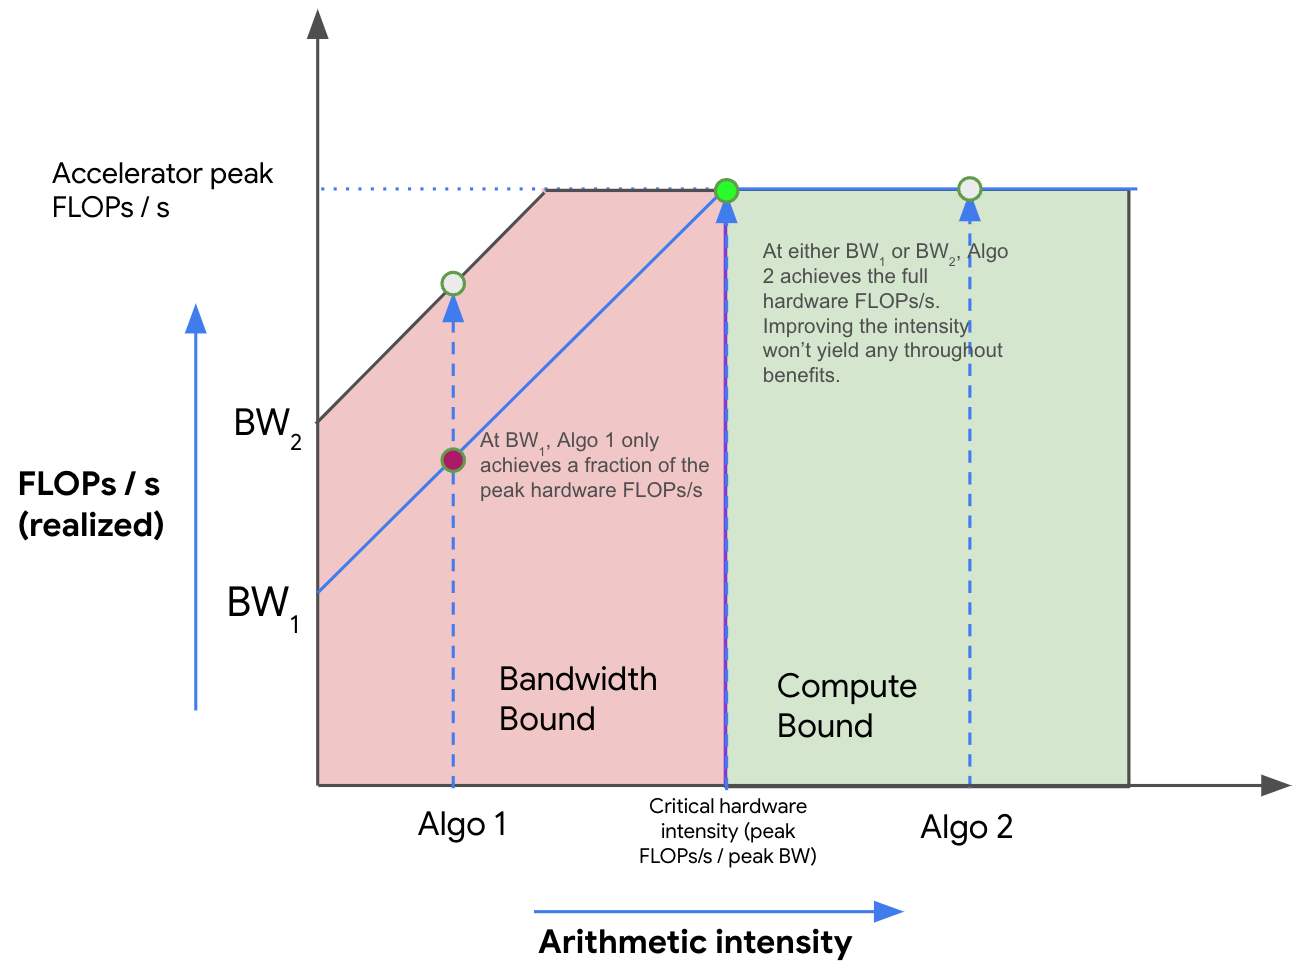
Выше видно: с ростом интенсивности (слева направо) производительность алгоритма (в FLOPs/s) сначала растёт линейно, пока не достигнет критической арифметической интенсивности железа — у TPU v5e это 240. Любой алгоритм с меньшей интенсивностью ограничен пропускной способностью (BW) и пиковой пропускной способностью памяти (красная область). Любой алгоритм правее полностью использует наши FLOPs (зелёная область). Здесь Algo 1 упирается в связь и использует лишь долю всех FLOPs/s железа. Algo 2 упирается в вычисления. В общем случае производительность алгоритма можно повысить, либо увеличив его арифметическую интенсивность, либо увеличив доступную пропускную способность памяти (переход от BW1 к BW2).
flowchart LR
A["Интенсивность алгоритма I"] --> C{"I больше пика железа?"}
C -->|"нет"| M["Упор в память: скорость = I × пропускная способность"]
C -->|"да"| F["Упор в вычисления: скорость = пиковые FLOPs/s"]Умножение матриц
Заголовок раздела «Умножение матриц»Рассмотрим алгоритм, который скоро станет нашим любимым: умножение матриц (matmul). Даны две матрицы и , пишем , где имеет форму , — , а — . Чтобы выполнить умножение, нужно загрузить байт, выполнить FLOPs и записать обратно байт910. Значит:
Формула хорошо упрощается, если считать, что «размер батча» мал по сравнению с и . Тогда
Для матмулов трансформера это разумное предположение: локальный (на одну реплику) батч в токенах обычно меньше 1024 (заметьте, это токены, а не последовательности), а и больше 8000. Поэтому в общем случае мы упираемся в вычисления, когда батч на реплику11 больше 240 токенов, — очень простое правило!
У этого правила есть несколько заметных оговорок, которые мы разберём в задачах ниже, особенно связанных с квантованием (например, если активации квантованы, а FLOPs выполняются в полной точности), но запомнить его стоит. Для GPU это число немного выше (ближе к 300), но вывод в целом тот же. Когда мы разбиваем большое умножение матриц на маленькие, важны и размеры тайлов13. Детали GPU и TPU нижнего уровня мы обсудим в следующей главе.
Roofline для сетевой связи
Заголовок раздела «Roofline для сетевой связи»Все roofline, которые мы обсуждали до сих пор, — это roofline по пропускной способности памяти, целиком внутри одного чипа. Это не стоит считать правилом. На самом деле большинство roofline, которые будут нас интересовать в этой книге, связаны со связью между чипами: обычно это умножения матриц, разбитых (шардированных) между несколькими TPU.
Возьмём несколько искусственный пример: мы хотим перемножить две большие матрицы
и , поровну разбитые между 2 TPU/GPU (по измерению ). Чтобы выполнить это умножение (как мы
увидим в главе 3), можно перемножить половины каждой матрицы на каждом TPU
(Z0 = X[:, :D // 2] @ Y[:D // 2, :] на TPU 0 и Z1 = X[:, D // 2:] @ Y[D // 2:, :] на TPU 1), а затем скопировать
получившиеся «частичные суммы» на другой TPU и сложить их. Допустим, мы можем копировать 4.5e10 байт/с в каждую
сторону и выполнять 1.97e14 FLOPs/s на каждом чипе. Чему равны и ?
, очевидно, вдвое меньше, чем раньше: каждый TPU делает половину работы14, то есть
А ? Теперь это время связи между чипами! Это просто общее число переданных байт, делённое на пропускную способность сети, то есть
Поэтому мы упираемся в вычисления (теперь относительно сети между чипами), когда , или, что то же самое, когда , то есть . Заметьте: в отличие от прошлого случая, критический порог теперь зависит от , а не от ! Подумайте, почему. Это лишь один пример, но подчеркнём: roofline такого рода критически важен, чтобы понимать, когда операцию можно распараллелить на несколько TPU.
Несколько задач
Заголовок раздела «Несколько задач»Вопрос 1 [матмул в int8]. Допустим, мы хотим выполнить умножение 15 в точности int8 (1 байт на параметр) вместо bfloat16 (2 байта на параметр), потому что TPU/GPU умеют умножать матрицы в пониженной точности быстрее.
- Сколько байт нужно загрузить из памяти? Сколько записать обратно?
- Сколько всего операций (OPs) выполняется?
- Какова арифметическая интенсивность?
- Какова roofline-оценка и ? Каковы разумные верхняя и нижняя оценки времени всей операции?
Считайте, что пропускная способность HBM — 8.2e11 байт/с, а пиковая скорость int8 — 3.94e14 OPs/s (примерно вдвое
больше, чем в bfloat16).
Ответ
- Параметры хранятся в int8, по 1 байту на параметр, поэтому из HBM загружается байт, а записывается .
- Столько же, сколько в bfloat16, но в теории операции int8 в секунду выполняются быстрее. Так что это по-прежнему OPs.
- Арифметическая интенсивность — . Если, как выше, считать и , получаем
арифметическую интенсивность , то есть правило превращается в . По данным
числам интенсивность для int8 —
3.94e14 / 8.2e11 = 480, так что правило: . Заметьте: почти ничего не изменилось! - и , так что разумная нижняя оценка — , а верхняя — .
Вопрос 2 [матмул int8 + bf16]. На практике веса и активации часто квантуют по-разному: веса храним в очень низкой
точности, а активации (и вычисления) — в более высокой. Допустим, мы хотим квантовать веса в int8, а активации
(и вычисления) оставить в bfloat16. При каком размере батча мы упрёмся в вычисления? Считайте, что скорость —
1.97e14 FLOPs/s в bfloat16.
Подсказка: речь именно о bf16[B, D] * int8[D, F] -> bf16[B, F], где — «размер батча».
Ответ
Снова считая малым, имеем FLOPs в bfloat16, но лишь байт весов (вместо в bfloat16). Значит, мы упираемся в вычисления при , то есть . Это намного меньше: если квантовать веса в int8 (что довольно легко), но считать FLOPs в bfloat16, эффективность заметно выигрывает (хотя операции в int8 были бы ещё лучше).
Вопрос 3. В условиях вопроса 2 постройте roofline-график пиковых FLOPs/s в зависимости от для и . Используйте точное число загружаемых байт, а не приближение.
Ответ
Нужный график — roofline-plot-q3.png в оригинале: две кривые растут с ростом батча и выходят на одно и то же плато пиковых FLOPs/s.
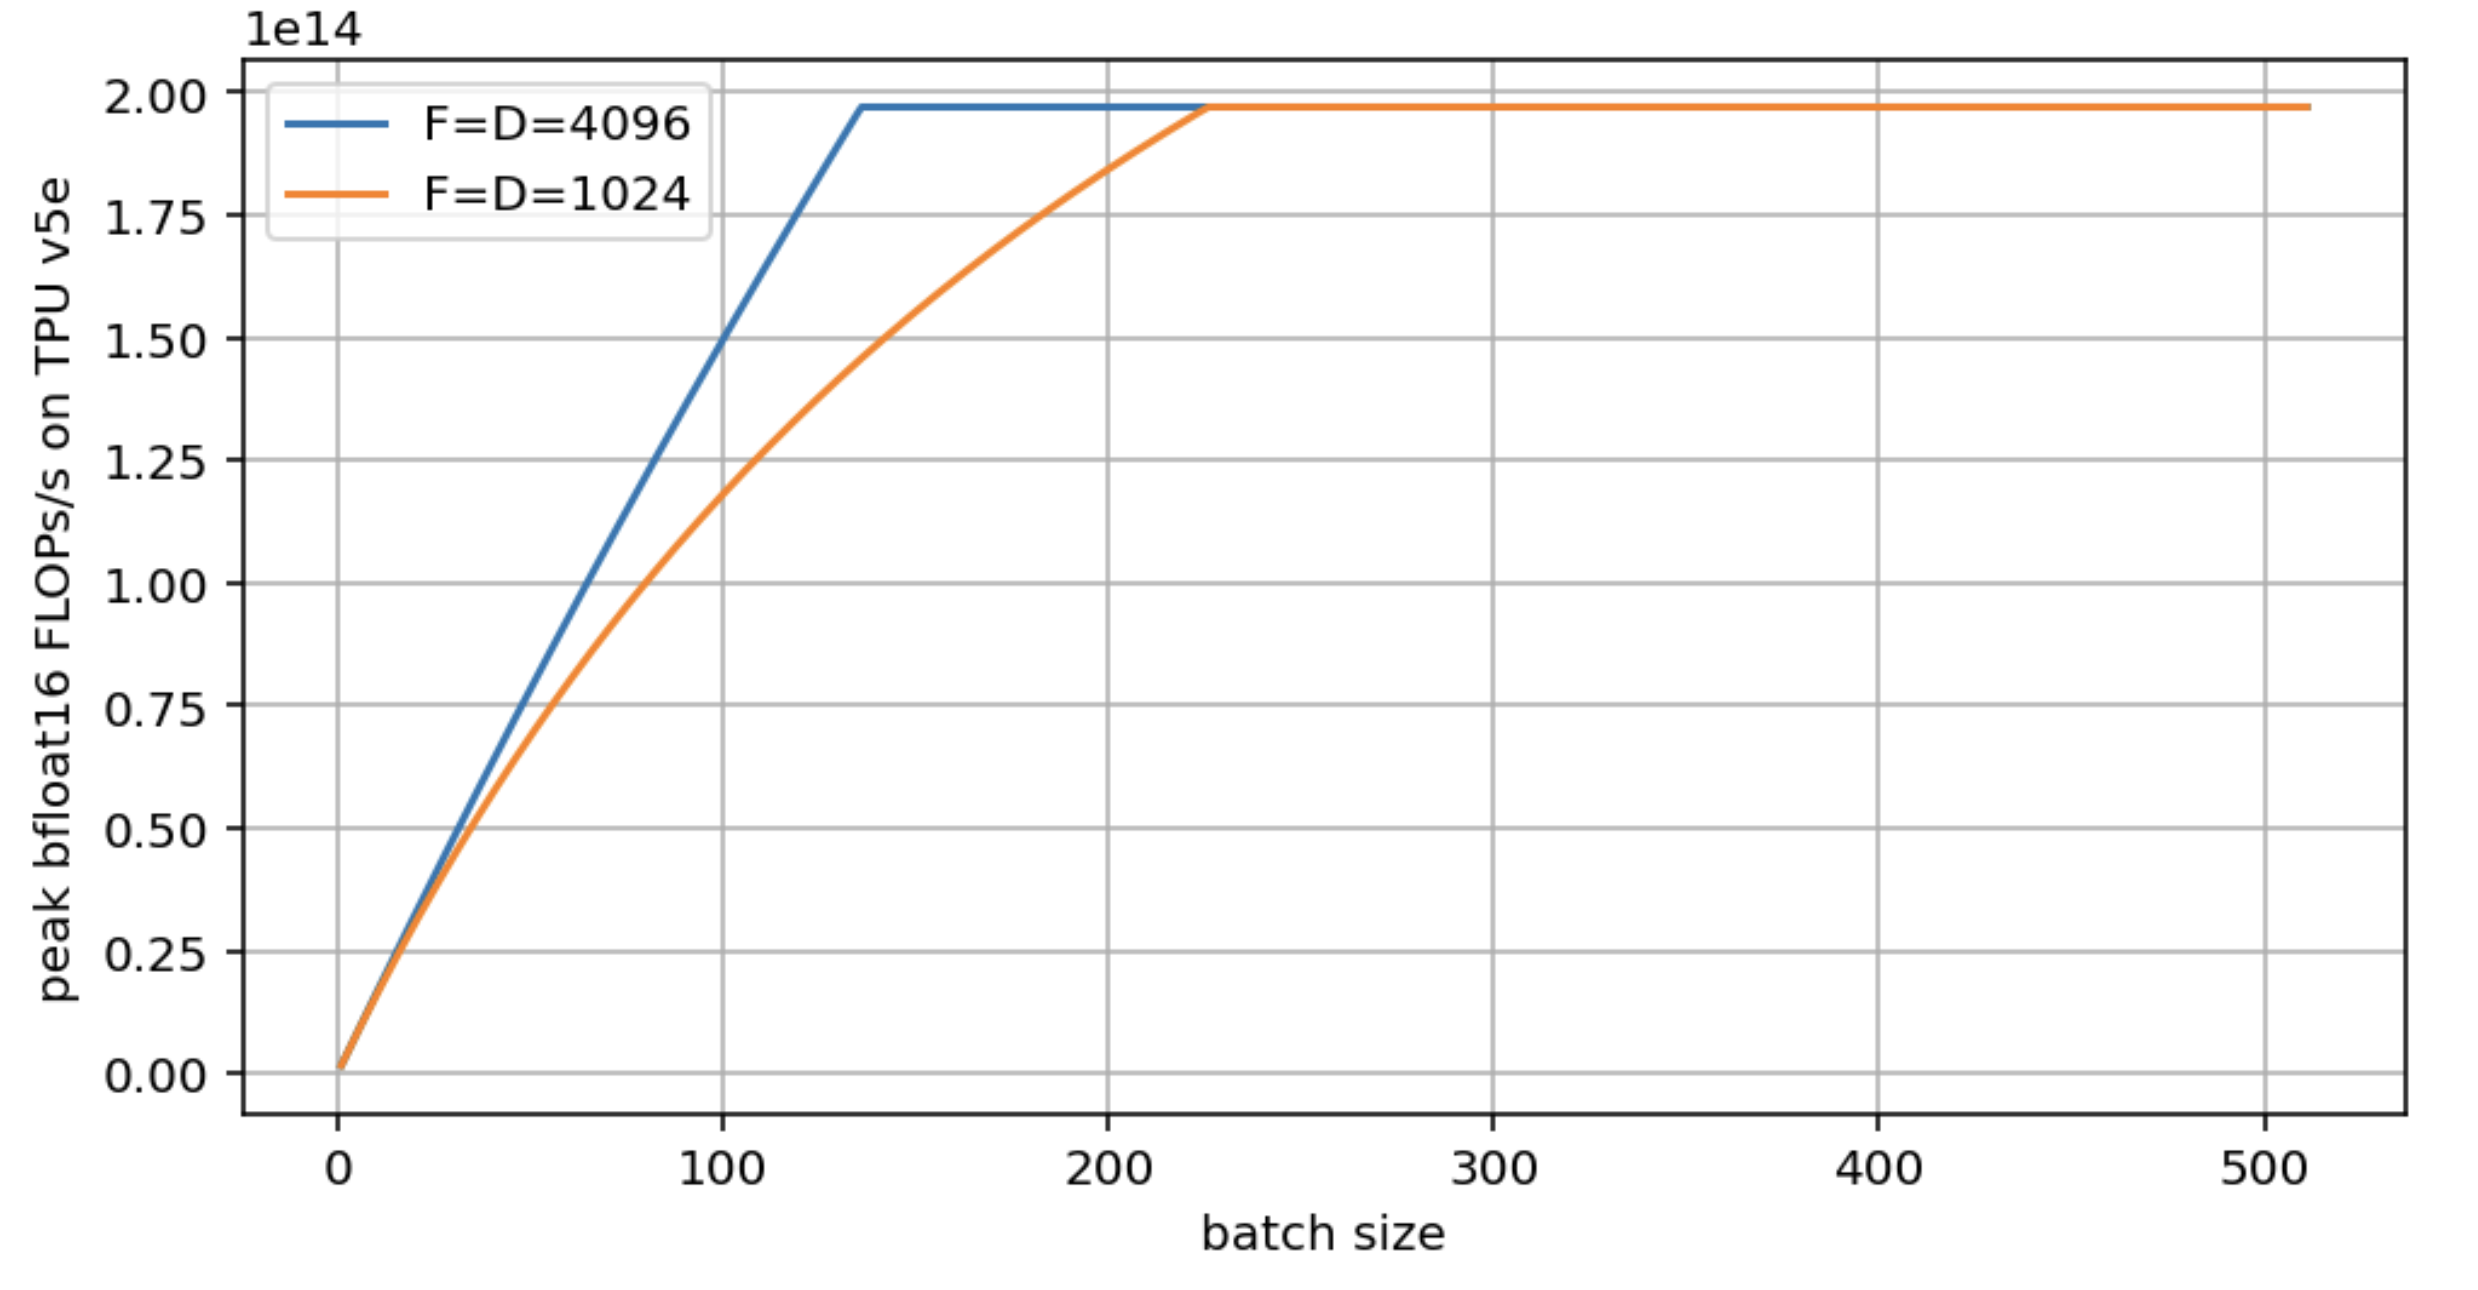
Обе модели в итоге выходят на пиковые FLOPs/s железа, но при больших D/F это происходит раньше. При D=F=1024 критический размер батча почти вдвое больше. Код, который строит этот график:
import matplotlib.pyplot as pltimport numpy as np
bs = np.arange(1, 512)
def roofline(B, D, F):  total_flops = 2*B*D*F  flops_time = total_flops / 1.97e14  comms_time = (2*B*D + D*F + 2*B*F) / 8.2e11   # активации bf16 (2 байта), веса int8 (1 байт)  total_time = np.maximum(flops_time, comms_time)  return total_flops / total_time
roofline_big = roofline(bs, 4096, 4096)roofline_small = roofline(bs, 1024, 1024)
plt.figure(figsize=(8, 4))plt.plot(bs, roofline_big, label='F=D=4096')plt.plot(bs, roofline_small, label='F=D=1024')plt.legend()plt.xlabel('batch size')plt.ylabel('peak bfloat16 FLOPs/s on TPU v5e')plt.grid()
Вопрос 4. А если мы хотим выполнить , представляя, что у каждого элемента батча своя матрица? Какова арифметическая интенсивность этой операции?
Ответ
Начнём с общего числа FLOPs и объёма связи.
- Всего FLOPs: почти столько же, ведь мы выполняем независимых произведений — та же общая работа, что и одно умножение (подробнее — в главе 4). Так что это просто .
- Всего связи: здесь её намного больше — .
- Поэтому арифметическая интенсивность теперь . Поскольку в знаменателе доминирует , это примерно . То есть вместо зависимости от размера батча она, по сути, постоянна. Это плохо: значит, мы почти всегда будем упираться в связь, что бы ни делали.
Вопрос 5 [roofline памяти для GPU]. По спецификации NVIDIA для H100 SXM вычислите размер батча, при котором умножение матриц в bfloat16 начнёт упираться в вычисления. Учтите, что числа FLOPs для Tensor Core там вдвое больше истинных: они достижимы только со структурированной разреженностью.
Ответ
В спецификации указано 1.979e15 FLOPs/s в bfloat16 со звёздочкой «с разреженностью». Без разреженности истинное
значение вдвое меньше: 9.89e14 FLOPs/s. Пропускная способность памяти — 3,35 ТБ/с, или 3.35e12 байт/с. Значит,
= 9.89e14 / 3.35e12 = 295 — довольно близко к TPU.
Это всё для главы 1. Глава 2 о том, как настоящие TPU обращаются с FLOPs и связью, — здесь.
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| roofline | roofline, «потолок» производительности |
| FLOPs / FLOPs/s | операции с плавающей точкой / операций в секунду |
| HBM (high bandwidth memory), HBM bandwidth | память HBM, пропускная способность HBM |
| ICI, DCN, PCIe | межчиповые связи (inter-chip interconnect), сеть дата-центра, шина PCIe |
| compute-bound / communication-bound, memory-bound | упор в вычисления / в связь, в память |
| arithmetic (operational) intensity | арифметическая интенсивность |
| peak / critical arithmetic intensity | пиковая / критическая арифметическая интенсивность |
| matmul | умножение матриц |
| per-replica batch size | размер батча на реплику |
| tile | тайл (блок матрицы) |
| sharded matrix, partial sums | шардированная (разбитая) матрица, частичные суммы |
| quantization, int8 | квантование, 8-битные целые |
| structured sparsity | структурированная разреженность |
Footnotes
Заголовок раздела «Footnotes»-
bf16 — сокращение от bfloat16, 16-битного формата с плавающей точкой, часто используемого в ML. ↩
-
H100 и B200 обычно достигают лишь 80–85% заявленного пика FLOPs, а TPU при обычном использовании — ближе к 95%. ↩
-
Учтите, что эти чипы стоят по-разному, и сравнение не нормировано на стоимость. ↩
-
NVIDIA называет её также «memory bandwidth» — пропускной способностью памяти. ↩
-
В книге «упор в связь», «упор в память» и «упор в пропускную способность» (communication-bound, comms-bound, memory-bound, bandwidth-bound) используются как синонимы. ↩
-
MXU — блок умножения матриц в TPU. Мы уточняем это, потому что в TPU есть и другие вычислительные блоки, например VPU, отвечающий за поэлементные операции, — у него другие пиковые FLOPs/s. ↩
-
Это верно, только если алгоритм загружает веса из HBM и выполняется на MXU. Как мы обсудим в следующей главе, иногда параметры можно хранить в VMEM, у которой гораздо больше пропускная способность. Многие алгоритмы также выполняются на VPU с другими характеристиками производительности. ↩
-
Число 240 выше здесь не совсем подходит для сравнения: как вы увидите в следующей главе, скалярное произведение выполняется на VPU, а не на MXU. VPU в TPU v5p выполняет примерно FLOPs в секунду на ядро, так что его критическая интенсивность около 3, и мы всё равно в некоторой степени упираемся в связь. В любом случае интенсивность низкая и постоянная, а значит, на большинстве железа упереться в вычисления трудно. ↩
-
Строго говоря, выполняется FLOPs, но это достаточно близко: умножений и сложений. Подробнее — в главе 4. ↩
-
Хотя результат матмула формально в float32, перед копированием в HBM его обычно приводят к bfloat16. ↩
-
«На реплику» — потому что, если мы как-то шардируем модель, чтобы увеличить число чипов в матмуле, мы одинаково масштабируем и доступные вычисления, и пропускную способность памяти. Поэтому критический размер батча верен для каждой независимой копии весов модели. ↩
-
Заметьте: это не размер батча в обычном смысле — в последовательностях. Оказывается, большинство roofline зависят только от числа токенов, принадлежат ли они одной последовательности или разным. Например, если у вас батч из 512 последовательностей по 4096 токенов на 2048 GPU, то общий батч —
512 * 4096 = 2Mтокенов, а локальный батч — 1 тысяча токенов. ↩ -
Большое умножение матриц приходится разбивать на маленькие тайлы, помещающиеся в VMEM/SMEM/TMEM — более быструю память на кристалле. Из-за этого блоки загружаются по нескольку раз, и уже не совсем верно, что мы загружаем лишь байт. Рассмотрим умножение с размерами тайлов , , . Пусть и т. д. Тогда всего FLOPs , а всего байт . Отбросив последнее слагаемое, получаем интенсивность , похожую на формулу выше. ↩
-
Мы пренебрегаем FLOPs на сложение двух частичных сумм (ещё сложений) — это практически ничто. ↩
-
Здесь и далее запись означает умножение со свёрткой (суммированием) по измерению D. Это вольное обращение с нотацией einsum. ↩