AI Research Foundations, курс 5, часть 2: Gemma, нехватка памяти и LoRA
Перевод лабораторных 5.4–5.6 курса Google DeepMind «Finetune Your Model»: попытка полного дообучения Gemma 1B упирается в память, LoRA своими руками на Keras и дообучение Gemma с LoRA для генератора учебных карточек.
Вторая половина курса «Finetune Your Model» («Дообучите свою модель»). В первой части вы дообучили всю маленькую модель (SLM) отвечать на вопросы в формате учебных карточек. Она хорошо справлялась с темами из набора Africa Galore и плохо — со всем остальным: она просто мало знает. Логичный следующий шаг — взять большую предобученную модель Gemma. Здесь и начинаются проблемы с памятью, а решение — LoRA.
Как проходить вместе с курсом ChinaAI
Заголовок раздела «Как проходить вместе с курсом ChinaAI»| Лабораторная | Время | Когда делать | Что нужно |
|---|---|---|---|
| 5.4. Полное дообучение Gemma | 15 мин | Перед уроком «LoRA и QLoRA» | GPU, аккаунт Kaggle |
| 5.5. LoRA своими руками | 40 мин | Вместе с уроком «LoRA и QLoRA» | CPU достаточно |
| 5.6. Дообучите Gemma с LoRA | 30 мин + 20 мин вычислений | Вместе с уроком «Практика — LoRA-дообучение Qwen» | GPU, аккаунт Kaggle |
Сюжет трёх лабораторных — это ровно та дорога, которую проходит урок 6.2.1 курса ChinaAI: полное дообучение большой модели не помещается в память → замечаем, что поправку к весам можно хранить в виде произведения двух узких матриц → обучаем только их. Почему обучение требует в несколько раз больше памяти, чем инференс, подробно считается в курсе 7 и в уроке «Смешанная точность».
flowchart LR
A["5.4: полное дообучение Gemma 1B"] -->|"нехватка памяти (OOM)"| B["5.5: LoRA своими руками"]
B -->|"W = W0 + BA"| C["5.6: Gemma 1B + LoRA"]
C --> D["Карточки на любые темы"]
Лабораторная 5.4. Полное дообучение Gemma
Заголовок раздела «Лабораторная 5.4. Полное дообучение Gemma»Ноутбук: gdm_lab_5_4_full_parameter_fine_tuning_of_gemma.ipynb · открыть в Colab
Попробуйте дообучить все параметры модели Gemma. 15 минут.
В предыдущей лабораторной вы дообучили маленькую языковую модель. Как вы видели, она часто давала ответы приличного качества для карточек на темы из набора Africa Galore. Но, как правило, она не справлялась, когда её просили ответить на вопрос по теме, которой в Africa Galore нет.
В этой лабораторной вы попробуете применить полное дообучение (full-parameter fine-tuning) к предобученной модели Gemma. Gemma обучалась на гораздо большем объёме данных, поэтому, скорее всего, сможет дать полезные ответы на гораздо больше вопросов. Но, попытавшись запустить полное дообучение, вы быстро столкнётесь с важнейшим ограничением реального мира: памятью. Лабораторная задумана так, чтобы вы на собственном опыте увидели, почему полное дообучение больших моделей — трудная задача и зачем нужны более экономные методы.
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»К концу лабораторной вы сможете:
- загружать реализацию предобученной модели Gemma на Keras и работать с ней;
- видеть практические ограничения по памяти, которые возникают при полном дообучении моделей с миллиардом параметров.
В этой лабораторной вы:
- подготовите набор карточек для токенизатора Gemma и Keras;
- загрузите предобученную модель Gemma и проверите её исходное качество на нескольких промптах;
- попробуете дообучить все параметры модели;
- увидите ошибки нехватки памяти, из-за которых обучение не проходит.
Эту лабораторную нужно запускать на GPU. Выберите T4 GPU.
Аккаунт Kaggle
Заголовок раздела «Аккаунт Kaggle»Чтобы запустить ноутбук, нужно зарегистрироваться на Kaggle — платформе, где лежат наборы данных и модели для машинного обучения, — и принять соглашение об использовании модели Gemma 3. Без этого веса Gemma не скачать.
- Создайте аккаунт. На kaggle.com нажмите «Register» в правом верхнем углу. Можно войти через аккаунт Google (удобнее всего для Colab) или по почте и паролю. Подтвердите почту.
- Примите соглашение Gemma 3. Войдя в аккаунт, откройте карточку модели Gemma 3, нажмите «Request Access», прочитайте лицензию и нажмите «Accept». Без этого API не даст скачать модель.
- Создайте API-ключ. Щёлкните по своему значку в правом верхнем углу → «Account» → раздел «API» → в блоке
«Legacy API Credentials» кнопка «Create Legacy API Key». На компьютер скачается файл
kaggle.jsonс вашим именем пользователя и секретным ключом. Храните его бережно. - Передайте ключ в Colab. Нажмите на значок ключа 🔑 на левой панели — откроется панель «Secrets». Откройте
kaggle.json(это обычный текстовый файл вида{"username":"YOUR_KAGGLE_USERNAME","key":"YOUR_KAGGLE_API_KEY"}) и создайте два секрета:KAGGLE_USERNAMEсо значением имени пользователя иKAGGLE_KEYсо значением ключа. Для обоих включите переключатель «Notebook access».
На своей машине вместо панели Secrets положите kaggle.json в ~/.kaggle/ — см.
обзор программы.
Импорты
Заголовок раздела «Импорты»В этой лабораторной вы будете загружать модель Gemma через пакет Keras, а набор данных — через пакет pandas. Запустите ячейку, чтобы импортировать нужные пакеты.
%%capture!pip install jax[cuda12]==0.7.2# Ставим специальный пакет курса.!pip install "git+https://github.com/google-deepmind/ai-foundations.git@main"
import os
# Чтобы загрузить имя пользователя и ключ Kaggle.from google.colab import userdata
# Загружаем имя пользователя и ключ Kaggle.os.environ["KAGGLE_USERNAME"] = userdata.get("KAGGLE_USERNAME")os.environ["KAGGLE_KEY"] = userdata.get("KAGGLE_KEY")
os.environ["KERAS_BACKEND"] = "jax" # Вычисления Keras — на JAX.
# Отключаем заблаговременное резервирование буферов команд, чтобы освободить память.os.environ["XLA_FLAGS"] = "--xla_gpu_enable_command_buffer="os.environ["XLA_PYTHON_CLIENT_ALLOCATOR"] = "platform"
import keras # Чтобы обучать модель.import keras_hub # Чтобы загрузить Gemma 3.import pandas as pd # Чтобы загрузить набор данных.from textwrap import fill # Чтобы абзацы читались легче.# Функция форматирования из лабораторной# «Формат текста для диалога по репликам».from ai_foundations import formatting
keras.utils.set_random_seed(812) # Чтобы обучение было воспроизводимым.
Зачем это нужно
Заголовок раздела «Зачем это нужно»Как говорилось в предыдущей статье, дообучение базовых (фундаментальных) моделей позволяет использовать знания, которые модель получила при предобучении на огромном объёме данных.
Чтобы почувствовать, чем предобученная модель вроде Gemma-1B отличается от маленькой языковой модели (SLM), с которой вы работали в прошлой лабораторной, сравните их в таблице:
| Gemma-1B | SLM | |
|---|---|---|
| Число параметров | 1 000 000 000 | 523 470 |
| Токенов в словаре | 256 000 | 3 086 |
| Токенов в обучающих данных | 2 000 000 000 000 | 92 568 |
| Обучающие данные | веб-документы на 140 языках | набор Africa Galore |
Как видно из таблицы, у Gemma намного больше параметров (около миллиарда против примерно полумиллиона), и обучалась она на наборе данных, который гораздо больше и разнообразнее Africa Galore. Вместе это позволяет модели выучить и хранить намного больше сведений, чем маленькая модель. Поэтому, если дообучить Gemma-1B генерировать ответы для карточек, она сможет давать полезные ответы по гораздо более широкому кругу тем, чем SLM.
Предобработка данных
Заголовок раздела «Предобработка данных»Как и с вашей SLM, нужно позаботиться о том, чтобы данные для дообучения использовали тот же токенизатор и те же
специальные токены-разделители, что и при предобучении. В этом курсе вы используете формат, принятый у моделей Gemma,
дообученных следовать инструкциям (он появился в лабораторной о формате диалога по репликам) [1]. Специальные токены
отмечают начало и конец реплики и указывают роль (user или model).
Один обучающий пример выглядит так:
<start_of_turn>userWhat is Jollof rice?<end_of_turn><start_of_turn>modelCategory: FoodJollof rice is a popular and iconic one-pot rice dish that is a staple in many West African countries.<end_of_turn>(Вопрос: «Что такое джолоф?» Ответ: «Категория: еда. Джолоф — популярное и знаковое блюдо из риса, приготовленное в одном котле; основа кухни многих стран Западной Африки».)
Запустите следующую ячейку, чтобы загрузить набор Africa Galore QA и привести каждый пример к этой структуре.
# Загружаем набор вопросов и ответов.africa_galore_qa = pd.read_json(    "https://storage.googleapis.com/dm-educational/assets/ai_foundations/africa_galore_qa_v2.json")
questions = []  # Список отформатированных вопросов.answers = []  # Список отформатированных ответов.
for idx, row in africa_galore_qa.iterrows():    # Форматируем вопрос и ответ функцией format_qa    # из предыдущей лабораторной.    question, answer = formatting.format_qa(row)    questions.append(question)    answers.append(answer)
# Показываем первую пару «вход — выход».print(questions[0])print(fill(answers[0], replace_whitespace=False))
Вспомните: в прошлой лабораторной подготовка данных требовала дополнительных шагов. Нужно было токенизировать каждый
вопрос и каждый ответ и вручную заменить часть токенов в целевой последовательности специальным токеном <PAD>,
чтобы исключить их из подсчёта потерь.
Дообучение модели — задача очень частая, поэтому реализации моделей вроде Gemma часто уже содержат функции, которые берут на себя несколько шагов подготовки данных в составе так называемого препроцессора (preprocessor).
В реализации Gemma на Keras достаточно указать промпт и то, что модель должна сгенерировать. Она сама соберёт
токенизированные примеры, на которых можно дообучать языковую модель Gemma. За кулисами она склеивает промпты и ответы
и исключает токены промпта из подсчёта потерь. Это избавляет от многих типовых шагов. Учтите, однако, что токены
<start_of_turn> и <end_of_turn> она сама не добавляет — их по-прежнему нужно подать модели самостоятельно, как
в предыдущей ячейке.
Готовим данные для модели Keras
Заголовок раздела «Готовим данные для модели Keras»Реализация Gemma на Keras ожидает данные для дообучения в виде словаря Python с двумя ключами: prompts — промпты
(в генераторе карточек это вопросы) и responses — то, что модель должна выдать (в генераторе карточек это ответы).
Запустите ячейку, чтобы создать этот словарь.
data = { "prompts": questions, "responses": answers}Загружаем модель Gemma через Keras
Заголовок раздела «Загружаем модель Gemma через Keras»Следующая ячейка загружает предобученную модель Gemma-1B
через Keras [2]. Как и ваша SLM, эта модель обучалась предсказывать следующее слово и не оптимизирована отвечать
на вопросы. После загрузки можно напечатать сводку методом summary и изучить её архитектуру.
Запустите ячейку, чтобы загрузить модель и настроить препроцессор.
# Загружаем модель Gemma3-1B для Keras.model = keras_hub.models.Gemma3CausalLM.from_preset("gemma3_1b")model.summary()
# Задаём максимальную длину последовательности — для дополнения и сборки батчей.model.preprocessor.sequence_length = 400
Сколько памяти занимает Gemma
Заголовок раздела «Сколько памяти занимает Gemma»Всего в Gemma 1B примерно миллиард параметров (около 700 млн — в блоках трансформера и около 300 млн — в эмбеддингах токенов, общих для входа и выхода). Модели такого размера обычно нужно около 4 ГБ памяти, поэтому она помещается на T4 с 15 ГБ памяти. А модели на 27B, то есть примерно с 27 миллиардами параметров, нужно примерно 100 ГБ ( ~3,7 ГБ) — в несколько раз больше, чем есть у одной T4.
Промпт базовой модели
Заголовок раздела «Промпт базовой модели»Прежде чем дообучать модель, посмотрите, как ведёт себя предобученная базовая модель, если задать ей вопрос.
prompt = "What is Jollof rice?"response = model.generate(prompt, max_length=200)print(fill(response, replace_whitespace=False))Что вы заметили?
Заголовок раздела «Что вы заметили?»На промпт вроде «What is Jollof rice?» ответ модели, скорее всего, содержит повторы, не лаконичен и может уйти от темы. Кроме того, модель выдаёт ответ не в нужном формате карточки.
Эти недостатки ожидаемы. Вспомните: модель обучалась на больших объёмах текста предсказывать следующий токен, но, в отличие от моделей, дообученных следовать инструкциям, её не оптимизировали отвечать на запросы пользователя. К тому же в предобучении не было ничего о формате генератора карточек.
Дообучение решает обе проблемы. Модель научится отвечать на вопросы лаконичнее и следовать формату карточки, потому что оба этих качества показаны в обучающих примерах набора Africa Galore QA.
Пробуем полное дообучение
Заголовок раздела «Пробуем полное дообучение»Дообучение требует гораздо больше памяти, чем использование модели для инференса. Для каждого параметра процесс обучения должен хранить не только его текущее значение, но и градиент, и дополнительные переменные оптимизатора. Поэтому обучение модели требует в несколько раз больше памяти, чем генерация.
На этом шаге запустите код, который дообучает Gemma-1B тем же способом полного дообучения, что и вашу SLM. Код ниже обновляет все параметры Gemma.
Если при дообучении возникнет ошибка, читайте дальше — там объяснено, что делать.
model.fit(data, epochs=1, batch_size=32, verbose=1)Что вы заметили?
Заголовок раздела «Что вы заметили?»При запуске ячейки вы должны были увидеть ошибку нехватки памяти — «out of memory» (OOM). Она возникла потому, что оптимизатор, пытаясь дообучить весь миллиард параметров Gemma-1B, запросил больше памяти, чем есть у T4. Когда такое случается, весь сеанс Colab падает, и весь код придётся запустить заново.
Это намеренный шаг. Он показывает: на T4 с 15 ГБ можно загрузить модель больше чем на миллиард параметров и запускать её инференс, как вы сделали выше в этой лабораторной, но это не значит, что можно дообучить все её параметры. Как вы подробнее узнаете в следующих курсах, любое обучение, включая дообучение, требует существенно больше памяти: в памяти GPU приходится хранить ещё и градиенты, и данные оптимизатора.
В этой лабораторной вы поработали с предобученной моделью Gemma-1B. Вы попробовали приспособить её к новой задаче полным дообучением и обнаружили, что для больших моделей этот метод часто непрактичен из-за непомерных требований к памяти.
Чтобы решить эту проблему, нужен более изощрённый подход. Следующие лабораторные познакомят вас с идеей экономного по параметрам дообучения (parameter-efficient fine-tuning, PEFT) и с методом LoRA, который позволяет дообучать большие модели, например Gemma, при ограниченной памяти GPU.
Литература
Заголовок раздела «Литература»- Google AI. 2025. Gemma formatting and system instructions. https://ai.google.dev/gemma/docs/core/prompt-structure
- Keras. 2025. Gemma3CausalLM model. https://keras.io/keras_hub/api/models/gemma3/gemma3_causal_lm/
Лабораторная 5.5. LoRA своими руками
Заголовок раздела «Лабораторная 5.5. LoRA своими руками»Ноутбук: gdm_lab_5_5_implement_lora_for_parameter_efficient_fine_tuning.ipynb · открыть в Colab
Примените LoRA (Low-Rank Adaptation, «низкоранговую адаптацию») для экономного по параметрам дообучения. 40 минут.
В прошлой лабораторной вы увидели, что без особых ресурсов полностью дообучить большую языковую модель трудно или невозможно. Решение — обучать меньше параметров, то есть следовать стратегии экономного по параметрам дообучения (parameter-efficient fine-tuning).
Как говорилось в предыдущей статье, низкоранговая адаптация (Low-Rank Adaptation, LoRA) — широко распространённый способ дообучить трансформер, не обучая все его параметры [1]. LoRA опирается на то, что многие матрицы можно приближённо представить произведением двух гораздо меньших матриц. Тогда обновления весов при дообучении затрагивают только эти маленькие матрицы, и LoRA оказывается намного экономнее полного дообучения. К тому же на практике LoRA даёт примерно то же качество, что и полное дообучение: при меньших требованиях к памяти качество почти не теряется.
В этой лабораторной вы реализуете LoRA для своей маленькой языковой модели.
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»К концу лабораторной вы сможете:
- объяснить математические принципы, на которых стоит LoRA;
- реализовать LoRA;
- подсчитать, сколько памяти экономит LoRA по сравнению с полным дообучением.
В этой лабораторной вы:
- разберётесь в математике LoRA;
- реализуете свой слой LoRA на Keras;
- подсчитаете, во сколько раз у LoRA меньше обучаемых параметров, чем при полном дообучении.
Вы работаете с одним слоем, поэтому всё можно сделать в Colab на CPU.
Импорты
Заголовок раздела «Импорты»В этой лабораторной вы будете определять слой LoRA с помощью Keras, а с векторами и матрицами работать через JAX. Запустите ячейку, чтобы импортировать нужные пакеты.
%%capture!pip install jax[cuda12]==0.7.2# Ставим специальный пакет курса.!pip install "git+https://github.com/google-deepmind/ai-foundations.git@main"
import os # Чтобы задать настройки Keras.
# Настройка Keras: вычисления — на JAX.os.environ["KERAS_BACKEND"] = "jax"
import keras # Чтобы строить модель.from keras import layers # Базовый класс для своего слоя LoRA.keras.utils.set_random_seed(812) # Для слоёв Keras.
import jax # Для работы с векторами и матрицами.import jax.numpy as jnp # Для работы с векторами и матрицами.
# Чтобы проверять ваши решения.from ai_foundations.feedback.course_5 import lora as feedback
Напоминание
Заголовок раздела «Напоминание»В лабораторной о полном дообучении вы дообучили маленький трансформер, продолжая обновлять все его параметры. Вы видели, что для больших моделей такой подход не работает: когда вы попытались обучить все параметры Gemma-1B в Colab, кончилась память. Проблему можно обойти, купив или арендовав машины с более мощными GPU, но это дорого. И с ростом моделей проблема становится только острее. Например, Gemma-1B с её миллиардом параметров — довольно маленькая для большой языковой модели, а есть варианты Gemma с гораздо большим числом параметров, например Gemma-27B [2]. Полностью дообучить такую модель на одной GPU невозможно даже на самых мощных видеокартах, существующих сегодня.
Как уже говорилось, LoRA не обновляет веса матрицы напрямую. Предобученные веса остаются замороженными в , а любое изменение записывается как сумма предобученных весов и поправки :
Главное свойство, которое делает LoRA такой экономной, — поправку весов при дообучении приближают произведением двух гораздо меньших матриц и :
Читается так: «поправка к весам равна произведению матрицы на матрицу ». На рисунке в оригинале (lora.png) слева большая замороженная матрица , справа — две узкие обучаемые матрицы: высокая и тонкая и низкая и широкая ; их произведение имеет тот же размер, что и , и прибавляется к ней.
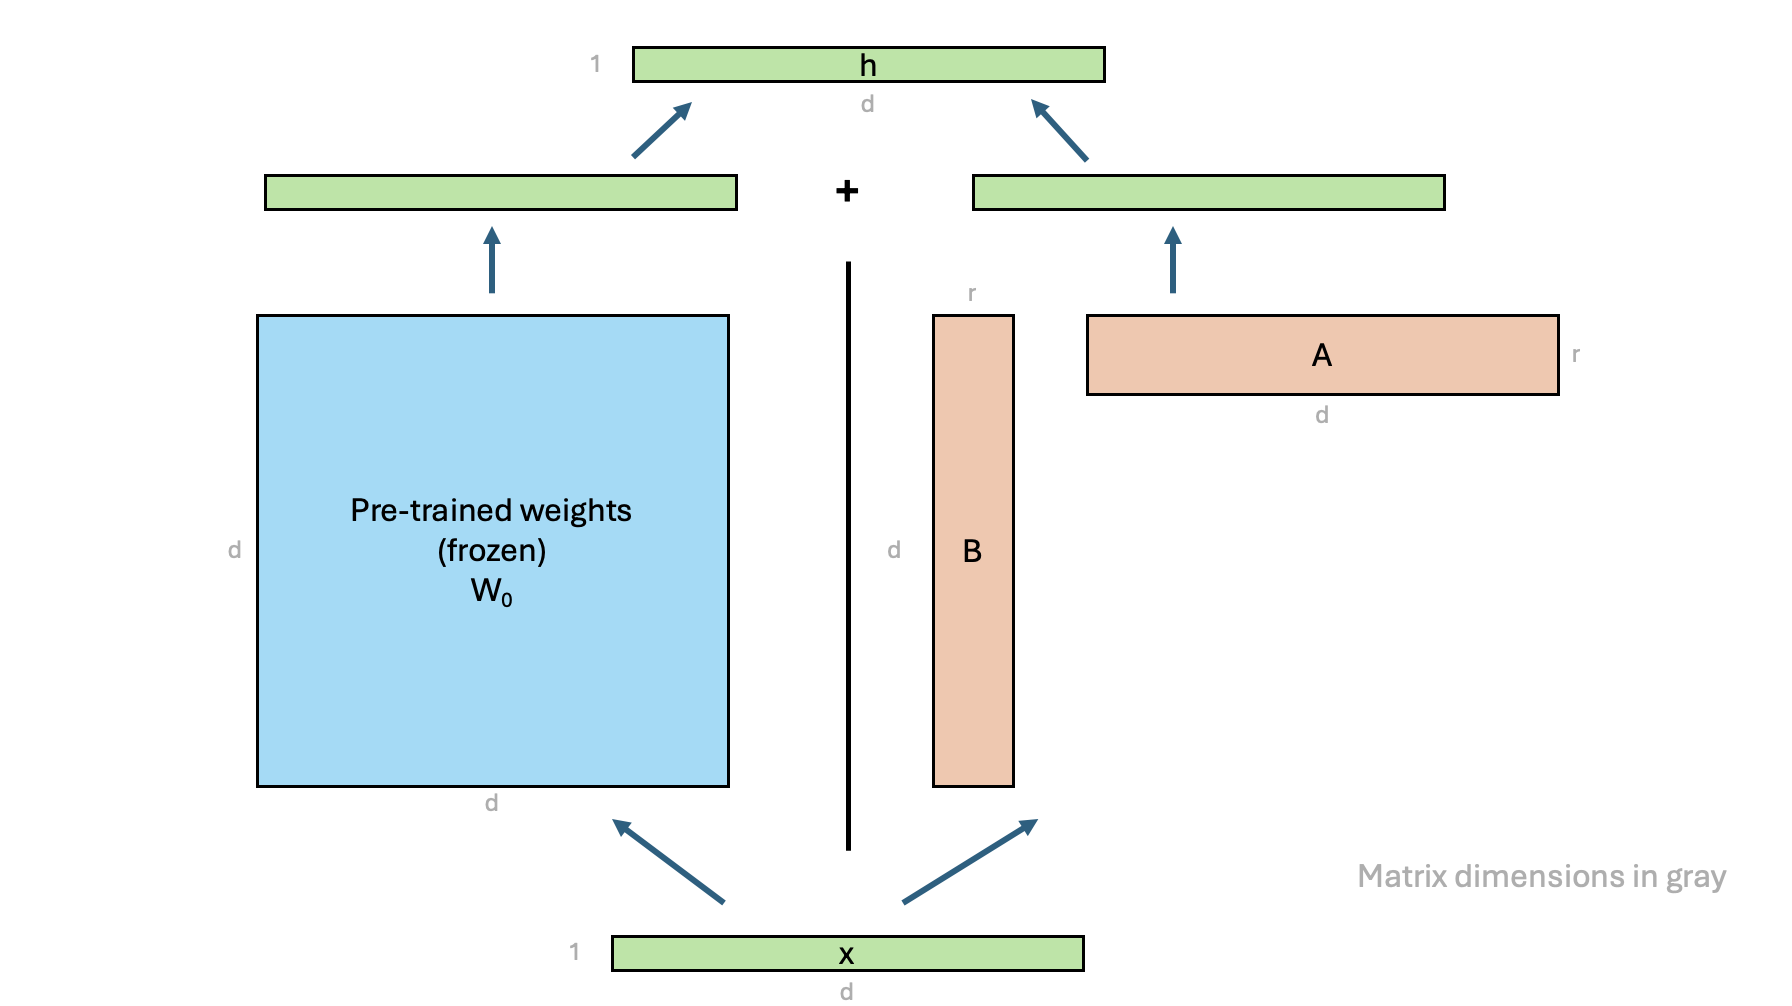
Следующий раздел помогает выработать интуицию, как работает LoRA. Для простоты рассмотрим матрицу весов одного слоя многослойного перцептрона. Учтите: та же идея применима к любой матрице весов в слое любого типа.
Интуиция: разложение матрицы с меньшим рангом
Заголовок раздела «Интуиция: разложение матрицы с меньшим рангом»Плотная (dense) матрица весов — матрица, в которой каждому элементу присвоено значение, — явно задаёт вес для каждой пары «вход — нейрон» в слое. Например, число в строке 5 и столбце 3 — это вес, с которым пятый вход участвует в вычислении выхода третьего нейрона. Число строк — это число входов, число столбцов — число нейронов.
Представьте, что вы составляете матрицу весов вручную, глядя на данные. Вы не стали бы, да и не смогли бы, рассматривать каждую связь по отдельности. Скорее, вы сделали бы несколько общих наблюдений, например:
- входы 1 и 2 вообще не важны;
- входы 3 и 6 меняют знак;
- при любом входе выходы 4 и 7 в пять раз больше по величине, чем остальные.
Наблюдения о выходах можно записать в матрицу из одной строки — матрицу , а наблюдения о входах — в один столбец, матрицу . Произведение на даст полную матрицу весов, которая задаёт каждую связь между каждым входом и выходом каждого нейрона.
Следующий код записывает эти наблюдения в матрицы и и перемножает их. Запустите его и внимательно рассмотрите матрицу рядом с матрицами и .
A = jnp.array([[1, 1, 1, 5, 1, 1, 5, 1]]) # Матрица из одной строки.B = jnp.array([[0, 0,-1, 1, 1,-1, 1, 1]])B = jnp.transpose(B) # Один столбец.
# Вычисляем ΔW как матричное произведение B × A.delta_W = jnp.matmul(B,A)print(delta_W)
Как видно, в получившемся произведении есть закономерности. И это не случайно. Нули в дают строки из нулей в , отрицательные элементы — строки с обратным знаком. Пятёрки в делают веса в столбцах 4 и 7 впятеро больше.
Эти закономерности можно изучить на примерах входов:
# Вход из одних единиц.x = jnp.array([1, 1, 1, 1, 1, 1, 1, 1])y = jnp.matmul(x,delta_W)
print(f"Output for ones only: {y}")
# Большие значения на входах, которые ни на что не влияют.x = jnp.array([100, 100, 1, 1, 1, 1, 1, 1])y = jnp.matmul(x,delta_W)
print(f"Output for high 1st and 2nd input: {y}")
# Значения побольше (7) на двух входах, которые меняют знак.x = jnp.array([1, 1, 7, 1, 1, 7, 1, 1])y = jnp.matmul(x,delta_W)
print(f"Output with input that reverses the sign: {y}")Если добавить к ещё одну строку, а к ещё один столбец, можно добавить ещё одно наблюдение, например:
- вход 3 никак не влияет на выход 7.
A = jnp.array(    [        [1, 1, 1, 5, 1, 1, 5, 1],        [0, 0, 0, 0, 0, 0, 5, 0]    ])B = jnp.array(    [        [0, 0,-1, 1, 1,-1, 1, 1],        [0, 0, 1, 0, 0, 0, 0, 0 ]    ])B = jnp.transpose(B)
delta_W = jnp.matmul(B, A)print(delta_W)
Как видно в выводе, элемент в седьмом столбце третьей строки получившейся матрицы стал равен 0 — так записалось наблюдение выше. Здесь наблюдение закодировано в и менее прямо, чем в примерах выше (пятёрка во второй строке и единица во втором столбце гасят −5, которое было в выше), но пример показывает главное: добавляя столбцы в и строки в , можно записать дополнительные наблюдения.
У матриц весов в трансформере сотни или тысячи входов и выходов. Если разложить на две матрицы ранга 8, и окажутся намного меньше , но каждая всё равно сможет записать несколько таких общих наблюдений, а для дообучения этого часто достаточно.
Заметьте ещё, что хранит только поправки относительно полной предобученной матрицы . Низкоранговое приближение LoRA обычно даёт модели достаточно свободы, чтобы записать тонкости конкретной задачи, а полная матрица по-прежнему хранит огромный объём сведений, полученных при предобучении.
Задание 1. Реализуйте LoRA
Заголовок раздела «Задание 1. Реализуйте LoRA»Теперь реализуйте этот метод как часть слоя многослойного перцептрона. Вспомните из курса 3 «Спроектируйте и обучите
нейросеть»: скрытый слой в Keras задаётся слоем Dense.
Для начала изучите ячейку ниже — в ней упрощённая версия слоя Dense из Keras. Запускать её не нужно, но подумайте:
- что делает функция
__init__? - как веса добавляются через
add_weight()? - метод
call()вычисляет взвешенную сумму для каждого нейрона и прибавляет смещениеb.
class SimplifiedDense(layers.Layer):    """Упрощённая реализация плотного слоя.
    Args:      output_dim: Число нейронов в слое.      input_dim: Число входов у каждого нейрона.    """    def __init__(self, output_dim: int = 32, input_dim: int = 32):        """Создаёт плотный слой."""        super().__init__() # Вызываем конструктор базового класса.
        self.w = self.add_weight( # w — матрица весов.            shape=(input_dim, output_dim), # Форма w.            initializer="random_normal", # Веса инициализируются случайно.            trainable=True # w должна обновляться при обучении.        )        # Добавляем смещения b — это вектор.        self.b = self.add_weight(            shape=(output_dim,),            initializer="zeros",            trainable=True        )
    def call(self, inputs: jax.Array):        """Умножает входы на матрицу весов и прибавляет смещение.
        Args:          inputs: Вход слоя.
        Returns:          Выход слоя.        """
        # Вычисляем y = XW + b        return jnp.matmul(inputs, self.w) + self.b
Теперь расширьте этот класс так, чтобы он реализовывал LoRA. Цель — написать класс, которым при дообучении можно заменить
обычный слой Dense.
Значит, этот слой должен:
- хранить исходную матрицу весов ;
- создавать матрицы весов и ранга ;
- в прямом проходе (метод
call):- вычислять из и ;
- вычислять новую матрицу весов .
class LoraDense(layers.Layer):  """Плотный слой с LoRA.
  Args:    pretrained_layer: Исходный предобученный плотный слой.    rank: Ранг матриц LoRA.
  Attributes:    num_units: Число нейронов в плотном слое.    rank: Ранг матриц LoRA.    A: Матрица LoRA A.    B: Матрица LoRA B.    W0: Предобученные веса.    bias: Предобученные смещения.  """  def __init__(self , pretrained_layer: layers.Dense, rank: int = 8, **kwargs):    """Создаёт слой LoRA.
    Args:      pretrained_layer: Исходный предобученный плотный слой.      rank: Ранг матриц LoRA.    """
    super().__init__(**kwargs)  # Вызываем конструктор базового класса.
    # Форма матрицы весов W предобученного слоя.    pretrained_layer_shape = pretrained_layer.weights[0].shape    # Форма вектора смещений предобученного слоя.    bias_shape = pretrained_layer.weights[1].shape    # Число нейронов = число столбцов W предобученного слоя.    self.num_units = pretrained_layer_shape[1]    # Ранг матриц LoRA.    self.rank = rank
    # Матрица LoRA A, форма rank x num_units.    # В оригинальной статье о LoRA эта матрица инициализируется    # случайными числами. Здесь — так же.    self.A = self.add_weight(        shape=(rank, self.num_units),        initializer=keras.initializers.RandomNormal(stddev=0.01),        trainable=True, # Эти параметры обновляются при дообучении.    )    # Матрица LoRA B, форма «число входов» x rank.    # В оригинальной статье о LoRA эта матрица инициализируется    # нулями. Здесь — так же.    self.B = self.add_weight(        shape=(pretrained_layer_shape[0], rank),        initializer=keras.initializers.Zeros(),        trainable=True, # Эти параметры обновляются при дообучении.    )    # Предобученные веса W0, скопированные из предобученного слоя.    self.W0 = self.add_weight(        shape=(pretrained_layer_shape),        initializer=keras.initializers.Constant(pretrained_layer.weights[0]),        trainable=False, # Эти параметры заморожены при дообучении.    )    # Смещения bias, скопированные из предобученного слоя.    self.bias = self.add_weight(        shape=(bias_shape),        initializer=keras.initializers.Constant(pretrained_layer.weights[1]),        trainable=True, # Эти параметры обновляются при дообучении.    )
  def call(self, x: jax.Array):    """      Прямой проход через слой.
      Args:        x: Вход слоя.
      Returns:        Выход слоя.    """
    # Вычисляем ΔW = BA.    delta_W = # Добавьте сюда свой код.
    # Вычисляем W = W0 + ΔW.    W = # Добавьте сюда свой код.
    # Вычисляем выход слоя y = xW + b.    y = # Добавьте сюда свой код.
return yЧтобы проверить реализацию слоя LoRA, можно собрать маленький однослойный MLP и заменить его плотный слой слоем LoRA.
Следующая ячейка сначала определяет модель, которая играет роль предобученной (pretrained_model), а затем создаёт
ещё одну модель с плотным слоем LoRA (lora_model).
Запустите ячейку и убедитесь, что код работает. Она печатает форму выхода обеих моделей. Если прямой проход реализован верно, ячейка выполнится без ошибок, а формы выходов совпадут.
# Число нейронов на входе и выходе.# В трансформере это обычно размерность пространства эмбеддингов, размер механизма# внимания и выход блока трансформера.num_units = 512rank = 8
# Модель pretrained_model с одним плотным слоем.x = layers.Input(shape=(num_units,))y = layers.Dense(units=num_units, name="dense_layer_1")(x)pretrained_model = keras.Model(inputs=x, outputs=y)
# Берём плотный слой, который превратим в слой LoRA.pretrained_layer = pretrained_model.get_layer("dense_layer_1")
# Модель с одним слоем LoRA.x = layers.Input(shape=(num_units,))y = LoraDense(    pretrained_layer=pretrained_layer,    rank=rank,    name="lora_dense_layer_1")(x)lora_model = keras.Model(inputs=x, outputs=y)
# Пропускаем пример входа и через исходную модель, и через модель с LoRA.input = jnp.ones((1, num_units))output_original = pretrained_model(input)output_lora = lora_model(input)
# Печатаем формы выходов обеих моделей.print(f"Shape of original model output: {output_original.shape}")print(f"Shape of LoRA model output: {output_lora.shape}")
Ожидаемый вывод — две одинаковые формы (1, 512).
Задание 2. Сравните число обучаемых параметров
Заголовок раздела «Задание 2. Сравните число обучаемых параметров»Последний шаг — выяснить, насколько слой LoRA сокращает число обучаемых параметров модели.
# Добавьте сюда свой код.Что вы заметили?
Заголовок раздела «Что вы заметили?»Если смотреть на общее число параметров, у модели с LoRA оно больше, чем у исходной: LoRA добавляет в модель матрицы и . Но обе матрицы сравнительно малы по сравнению с полной матрицей весов , поэтому и прирост параметров сравнительно невелик.
А вот обучаемых параметров у модели с LoRA намного меньше, чем у исходной: модель с LoRA не обновляет , а именно в ней большая часть параметров модели.
Задание 3. Посчитайте долю обучаемых параметров
Заголовок раздела «Задание 3. Посчитайте долю обучаемых параметров»В прошлом задании вы увидели, что у модели с LoRA обучаемых параметров меньше, чем у исходной. Теперь посчитайте, во сколько раз LoRA сокращает их число.
# @title Введите ответ (число от 0.0 до 1.0)answer = 0.0331 #@param {type: "number"}# @title Запустите эту ячейку, чтобы проверить ответ
feedback.check_loralab_answer(answer, num_units=512, rank=8)LoRA в трансформере
Заголовок раздела «LoRA в трансформере»Цель LoRA — уменьшить число параметров, которые обучаются при дообучении. И механизм внимания, и многослойный перцептрон в каждом блоке трансформера содержат плотные слои, поэтому LoRA можно применить к некоторым из них или ко всем, и обучать придётся гораздо меньше параметров [1].
LoRA стала важным инструментом дообучения нейросетей; класс layers.Dense
в Keras даже поддерживает её «из коробки», так что обычно реализовывать её с нуля не нужно.
Чтобы показать, как это выглядит в настоящей модели, вспомните трансформер из курса 4 «Откройте архитектуру
трансформера». Чтобы применить к нему LoRA, достаточно добавить параметр lora_rank всем плотным слоям модели.
При предобучении этот параметр равен None — LoRA выключена. При дообучении можно задать разумный ранг, например ,
чтобы сократить число обновляемых параметров.
В этой лабораторной вы реализовали LoRA для плотного слоя. Вы увидели, как и влияют на строки и столбцы .
В следующей лабораторной вы дообучите Gemma с LoRA и убедитесь, что так можно дообучить гораздо более крупную модель на GPU вроде T4, доступной в Colab.
Решения
Заголовок раздела «Решения»Сначала попробуйте решить задания сами — несколько раз. Застряли — добавьте отладочные print и посмотрите, что код
делает на каждом шаге. Решение не копируйте, а перепечатайте руками.
Задание 1
# Полная реализация прямого прохода.def call(self, x: jax.Array) -> jax.Array:    """      Прямой проход через слой.
      Args:        x: Вход слоя.
      Returns:        Выход слоя.    """
    # Вычисляем ΔW = BA.    delta_W = jnp.matmul(self.B, self.A)
    # Вычисляем W = W0 + ΔW.    W = self.W0 + delta_W
    # Вычисляем выход слоя y = xW + b.    y = jnp.matmul(x, W) + self.bias
    return y
Задание 2
# Добавьте этот код в ячейку выше.pretrained_model.summary()lora_model.summary()Задание 3
В условиях задачи полная матрица весов содержит 512 × 512 = 262 144 параметра. При полном дообучении все они обучаются, а при LoRA они заморожены в .
В матрице 8 × 512 = 4 096 параметров. В матрице — тоже 4 096. Именно они обучаются при LoRA.
Значит, доля равна (4 096 + 4 096) / 262 144 = 0,03125, то есть примерно 3,1%. Если учитывать смещения, получится (4 096 + 4 096 + 512) / (262 144 + 512) ≈ 0,03314.
Литература
Заголовок раздела «Литература»- Edward Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang, and Weizhu Chen. 2022. LoRA: Low-rank adaptation of large language models. ICLR 2022. https://openreview.net/pdf?id=nZeVKeeFYf9
- Google AI. 2025. Gemma 3 model overview. https://ai.google.dev/gemma/docs/core
- François Chollet. 2023. Making new layers and models via subclassing. Keras. https://keras.io/guides/making_new_layers_and_models_via_subclassing/
То же на PyTorch
Заголовок раздела «То же на PyTorch»Не часть оригинала. Учтите разницу в соглашениях: в Keras матрица Dense хранится как (входы × выходы) и слой считает
, а torch.nn.Linear хранит веса как (выходы × входы) и считает . Поэтому в PyTorch имеет форму
(выходы × ), — ( × входы), как в статье о LoRA. Множитель alpha / r — стандартный масштаб из статьи
и библиотеки PEFT (урок «LoRA и QLoRA»).
import torchimport torch.nn as nn
class LoRALinear(nn.Module):    def __init__(self, base: nn.Linear, r: int = 8, alpha: float = 16.0):        super().__init__()        self.base = base        for p in self.base.parameters():            p.requires_grad = False                     # W0 и смещение заморожены        self.A = nn.Parameter(torch.randn(r, base.in_features) * 0.01)  # случайная        self.B = nn.Parameter(torch.zeros(base.out_features, r))        # нули: ΔW = 0 на старте        self.scale = alpha / r
    def forward(self, x):        # base(x) = x W0ᵀ + b;  добавка = x (BA)ᵀ = x Aᵀ Bᵀ        return self.base(x) + (x @ self.A.T @ self.B.T) * self.scale
layer = LoRALinear(nn.Linear(512, 512), r=8)trainable = sum(p.numel() for p in layer.parameters() if p.requires_grad)total = sum(p.numel() for p in layer.parameters())print(trainable, total, trainable / 262_144)   # 8192 270848 0.03125
Лабораторная 5.6. Дообучите Gemma с LoRA
Заголовок раздела «Лабораторная 5.6. Дообучите Gemma с LoRA»Ноутбук: gdm_lab_5_6_fine_tune_gemma_with_lora.ipynb · открыть в Colab
Узнайте, как дообучать крупные предобученные модели с помощью LoRA. 30 минут на разбор + 20 минут вычислений.
Вспомните: в лабораторной «Полное дообучение Gemma» обучение упало с ошибкой нехватки памяти. В этой лабораторной вы увидите, как избежать этого, применив LoRA при дообучении Gemma. Так вы сможете дообучить Gemma для своего генератора карточек. Вы также увидите, чем выгодно дообучать большую предобученную модель: благодаря разнообразным данным предобучения она может отвечать на вопросы по самым разным темам.
Чему вы научитесь
Заголовок раздела «Чему вы научитесь»К концу лабораторной вы сможете:
- применять LoRA к Gemma-1B;
- дообучать модель под свою задачу;
- оценивать, что дообученная модель взяла из предобучения;
- оценивать, что дообученная модель взяла из дообучения;
- объяснять, как сочетание знаний из обоих этапов позволяет модели делать то, чего нельзя добиться ни одним из видов обучения по отдельности.
В этой лабораторной вы:
- повторите шаги из лабораторной о полном дообучении, чтобы загрузить и подготовить Gemma-1B;
- подготовите Gemma-1B к дообучению с LoRA;
- выберете гиперпараметры дообучения;
- будете следить за ходом дообучения;
- оцените качество предобученной и дообученной модели.
Лабораторную нужно запускать на GPU. Выберите T4 GPU. Также нужен аккаунт Kaggle, чтобы скачать веса Gemma 3 (инструкция — выше, в лабораторной 5.4).
Импорты
Заголовок раздела «Импорты»В этой лабораторной вы будете загружать модель Gemma через Keras, а набор данных — через pandas. Запустите ячейку, чтобы импортировать нужные пакеты.
%%capture!pip install jax[cuda12]==0.7.2# Ставим специальный пакет курса.!pip install "git+https://github.com/google-deepmind/ai-foundations.git@main"
import os
from google.colab import userdata
os.environ["KAGGLE_USERNAME"] = userdata.get("KAGGLE_USERNAME")os.environ["KAGGLE_KEY"] = userdata.get("KAGGLE_KEY")
os.environ["KERAS_BACKEND"] = "jax"  # Вычисления Keras — на JAX.
import json # Чтобы загрузить журналы обучения.from urllib import request # Чтобы скачать журналы обучения.import keras # Чтобы обучать модель.import keras_hub # Чтобы загрузить Gemma-1B.import pandas as pd # Чтобы загрузить набор данных.import jax.numpy as jnp # Для работы с матрицами и векторами.from textwrap import fill # Чтобы форматировать длинные абзацы.# Функция форматирования, которую вы реализовали в прошлых лабораторных.from ai_foundations import formatting
# Помогает избежать фрагментации памяти в JAX.os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.95"keras.utils.set_random_seed(812)  # Чтобы обучение было воспроизводимым.
Дообучаем Gemma 3 с LoRA
Заголовок раздела «Дообучаем Gemma 3 с LoRA»Готовим данные и загружаем модель
Заголовок раздела «Готовим данные и загружаем модель»Следующие ячейки готовят данные и загружают модель Gemma-1B. Это те же шаги, что вы делали, пытаясь полностью дообучить Gemma.
Загружаем и форматируем данные для дообучения
Заголовок раздела «Загружаем и форматируем данные для дообучения»Чтобы добавить специальные разделители, вы снова воспользуетесь функцией format_qa, которую реализовали раньше. Кроме
того, следующая ячейка определяет функцию format_question, которая форматирует только вопрос. Её удобно использовать,
чтобы форматировать промпты при оценке модели.
Ячейка определяет format_question, загружает набор Africa Galore QA и создаёт словарь данных, на котором можно
дообучать реализацию Gemma на Keras.
def format_question(    question: str,    sot: str = "<start_of_turn>",    eot: str = "<end_of_turn>") -> str:    """    Форматирует вопрос для промпта модели и добавляет специальные разделители    в начале и в конце вопроса.
    Args:      text: Вопрос, который нужно отформатировать.      sot: Токен начала реплики.      eot: Токен конца реплики.
    Returns:      Отформатированная строка с вопросом.    """
    formatted_q = f"{sot}user\n{question}{eot}\n"
    return formatted_q
# Загружаем набор вопросов и ответов.africa_galore_qa = pd.read_json(    "https://storage.googleapis.com/dm-educational/assets/ai_foundations/africa_galore_qa_v2.json")
questions = []  # Список отформатированных вопросов.answers = []  # Список отформатированных ответов.
for idx, row in africa_galore_qa.iterrows():    # Форматируем вопрос и ответ функцией format_qa    # из предыдущей лабораторной.    question, answer = formatting.format_qa(row)    questions.append(question)    answers.append(answer)
# Показываем первую пару «вход — выход».print(questions[0])print(fill(answers[0], replace_whitespace=False))
# Готовим словарь данных для дообучения Gemma.data = {    "prompts": questions,    "responses": answers}
Загружаем модель
Заголовок раздела «Загружаем модель»Запустите ячейку, чтобы загрузить модель Gemma и напечатать сводку с числом её параметров.
# Загружаем модель Gemma-1B для Keras.model = keras_hub.models.Gemma3CausalLM.from_preset("gemma3_1b")model.summary()Промпты предобученной модели Gemma
Заголовок раздела «Промпты предобученной модели Gemma»Прежде чем дообучать модель, посмотрите, как предобученная модель отвечает на промпты в том формате, который вы используете для генератора карточек.
Запустите ячейку, чтобы сгенерировать ответы на три вопроса. По ним вы будете оценивать модель на протяжении всей лабораторной:
- «What is Kente cloth?» («Что такое ткань кенте?») — вопрос, который есть в наборе Africa Galore QA.
- «What is the tallest mountain in Africa?» («Какая гора в Африке самая высокая?») — вопроса нет в наборе Africa Galore QA, но его тема в наборе для дообучения встречается.
- «What is Mount Aconcagua?» («Что такое гора Аконкагуа?») — ни вопроса, ни его темы в наборе для дообучения нет.
Изучите ответы на каждый из вопросов.
evaluation_prompts = [    "What is Kente cloth?",    "What is the tallest mountain in Africa?",    "What is Mount Aconcagua?"]
# Получаем от модели ответы на три отформатированных вопроса.# Генерируем ответы длиной до 200 токенов.for prompt in evaluation_prompts:    formatted_prompt = format_question(prompt)    model_response = model.generate(formatted_prompt, max_length=200)    print(fill(model_response, replace_whitespace=False))    print('\n------\n')
Что вы заметили?
Заголовок раздела «Что вы заметили?»Скорее всего, вы увидели: предобученная модель, которую учили только предсказывать следующий токен по большому корпусу текстов, иногда способна выдать какой-то ответ на вопрос. Но часто ответы получаются однообразными и повторяющимися, а иногда вместо ответа модель генерирует похожие вопросы.
Кроме того, вы, вероятно, заметили, что ни для одного вопроса модель не выдала ни категорию, ни токены смены реплик. То есть формату, нужному генератору карточек, она не следует.
Включаем LoRA
Заголовок раздела «Включаем LoRA»LoRA уже реализована в Keras-версии Gemma и включается вызовом метода enable_lora. Например, чтобы включить LoRA
с рангом 4, достаточно вызвать:
model.backbone.enable_lora(rank=4)Запустите следующую ячейку, чтобы включить LoRA, и посмотрите на вывод метода summary. Число параметров немного выросло
за счёт дополнительных параметров LoRA. Зато обучаемых параметров гораздо меньше, чем всего.
model.backbone.enable_lora(rank=4)model.summary()Задание 1. Выбираем гиперпараметры
Заголовок раздела «Задание 1. Выбираем гиперпараметры»Последний шаг перед обучением — задать гиперпараметры процесса обучения. Вспомните: для дообучения особенно важны два параметра — learning rate (скорость обучения) и число эпох, то есть сколько раз вы проходите по данным для дообучения.
Для обоих параметров обычно проводят подбор гиперпараметров и выбирают такой набор, при котором результаты на ваших примерах для оценки получаются полезными. Учтите: здесь вы работаете не с SLM, а с другой моделью и обучаете её с LoRA, а не полностью. Поэтому оптимальные гиперпараметры для Gemma могут отличаться от тех, что вы использовали при дообучении SLM.
Для предобученных моделей вроде Gemma разумное число эпох обычно от 1 до 20 — в зависимости и от размера набора для дообучения, и от learning rate. Если набор больше и (или) learning rate выше, эпох обычно нужно меньше. И наоборот, если примеров для дообучения очень мало или learning rate очень низкий, эпох понадобится больше.
Для learning rate на практике хорошо работают значения от 0,0001 (1e-4) до 0,000001 (1e-6) при дообучении моделей вроде Gemma.
# @title Журналы обучения для разных learning rate
if "training_logs" not in globals():    TRAINING_LOG_URL = "https://storage.googleapis.com/dm-educational/assets/ai_foundations/finetune-gemma-training-logs.json"    with request.urlopen(TRAINING_LOG_URL) as json_file:        training_logs = json.loads(json_file.read().decode())
learning_rate = 1e-3 # @param ["1e-3","5e-4","2e-4","1e-4","5e-5","2e-5","1e-5","5e-6","2e-6","1e-6"] {"type":"raw"}
print(training_logs[str(learning_rate)])
Определив оптимальный learning rate для этой задачи дообучения, впишите его в следующую ячейку.
# Задаём learning rate.model.optimizer.learning_rate = # Добавьте сюда свой код.
# Задаём число эпох.num_epochs = 10
# Задаём максимальную длину.model.preprocessor.sequence_length = 400
Запускаем дообучение
Заголовок раздела «Запускаем дообучение»Данные подготовлены, модель и LoRA настроены — дообучение делается так же, как любое обучение в Keras: методом
model.fit().
Как и раньше, важно следить за ходом обучения с помощью функции обратного вызова (callback). Запустите ячейку, чтобы определить callback, который печатает генерации для трёх промптов оценки.
class EvaluationCallback(keras.callbacks.Callback):    """    Callback Keras, который печатает генерации для промптов оценки.    """    def on_epoch_end(self, epoch: int, logs=None):        """Печатает генерации для трёх промптов оценки.
        Args:          epoch: Номер текущей эпохи.          logs: Словарь с журналом.        """
        evaluation_prompts = [            "What is Kente cloth?",            "What is the tallest mountain in Africa?",            "What is Mount Aconcagua?"        ]
        # Пропускаем три отформатированных вопроса через модель.        # Генерируем ответы длиной до 200 токенов.        for prompt in evaluation_prompts:            formatted_prompt = format_question(prompt)            model_response = model.generate(formatted_prompt, max_length=200)            print(fill(model_response, replace_whitespace=False))            print('\n------\n')
evaluation_callback = EvaluationCallback()training_history = model.fit( data, epochs=num_epochs, batch_size=1, verbose=1, callbacks=[evaluation_callback])Удовлетворяли ли ответы модели в конце дообучения всем перечисленным критериям? Если нет, можно дообучить ещё несколько эпох.
В целом вы, скорее всего, увидели «хорошее» качество даже на вопросах не об африканской культуре и географии. Например, на вопросе о южноамериканской горе «What is Mount Aconcagua?». Предобученная модель, вероятно, смогла ответить про эту гору — и в нужном генератору карточек формате. Тем самым она объединила фактические знания из предобучения на наборе в 2 триллиона токенов с особенностями формата, которые выучила по примерам дообучения.
Дополнительная проверка
Заголовок раздела «Дополнительная проверка»Как всегда, модель важно проверить на широком круге вопросов. Задайте ниже ещё несколько вопросов и посмотрите на ответы.
additional_prompts = [    "What is Mount Aconcagua?",    "What is American Football?",    "What is Python?"]
for prompt in additional_prompts:    formatted_prompt = format_question(prompt)    model_response = model.generate(formatted_prompt, max_length=300)    print(fill(model_response, replace_whitespace=False))    print('\n------\n')
Что вы заметили?
Заголовок раздела «Что вы заметили?»Скорее всего, модель смогла подобрать подходящие категории для многих вопросов и выдала много разумных ответов.
Если ответы на все ваши вопросы оказались полезными, попробуйте найти совсем узкие темы и спросите модель о них. Удастся ли вам нащупать пределы этой модели?
В этой лабораторной вы дообучили Gemma-1B с LoRA. Вы увидели, что модель отвечает в нужном формате не только на темы из набора для дообучения (Africa Galore QA), но и на самые разные другие.
Это показывает силу сочетания «хорошей» предобученной модели и дообучения: так можно построить очень способные модели для многих задач на маленьком наборе для дообучения.
Решения
Заголовок раздела «Решения»Задание 1
Хороший выбор learning rate — 2e-5. С ним ответы стабилизируются примерно после 7–8 эпох и фактически верны.
Можно взять и меньший learning rate. Но чем он ниже, тем больше эпох нужно для дообучения.
Более высокие learning rate на первый взгляд выглядят хорошо, но качество ответов у них ниже.
Ответы при learning rate 5e-5 не упоминают, что Токио — столица Японии, и дают более общее описание, подходящее к любому очень большому городу. Впрочем, их ещё можно счесть приемлемыми.
Learning rate 1e-4 даёт ответы с фактическими ошибками. Например, Килиманджаро — не вторая по высоте вершина мира после Эвереста. Килиманджаро славится многими удивительными фактами, но не тем, что сыграла какую-то особую роль в восхождении на Эверест в 1952 году. Первое успешное восхождение на Эверест случилось годом позже. У ещё более высоких learning rate похожие проблемы.
Как вы увидите, судить о правильности ответов бывает довольно трудно. «Разрушение» знаний из предобучения при высоких learning rate может быть незаметным. Катастрофическое забывание (catastrophic forgetting) не обязательно затрагивает всё сразу — оно может быть тоньше, как в ответах о Килиманджаро при learning rate 1e-4. Поэтому важно выбирать для проверки такие промпты, на которые вы сами можете ответить на уровне эксперта.
Литература
Заголовок раздела «Литература»- Gemma Team, Google DeepMind. 2025. Gemma 3 technical report. https://arxiv.org/pdf/2503.19786
- Edward Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang, and Weizhu Chen. 2022. LoRA: Low-rank adaptation of large language models. ICLR 2022. https://openreview.net/pdf?id=nZeVKeeFYf9
- Dan Biderman, Jacob Portes, Jose Javier Gonzalez Ortiz, Mansheej Paul, Philip Greengard, Connor Jennings, Daniel King, Sam Havens, Vitaliy Chiley, Jonathan Frankle, Cody Blakeney, and John P. Cunningham. 2024. LoRA learns less and forgets less. Transactions on Machine Learning Research. https://openreview.net/forum?id=aloEru2qCG
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| full-parameter fine-tuning | полное дообучение (всех параметров) |
| out of memory (OOM) | нехватка памяти |
| preprocessor | препроцессор (подготовка данных внутри модели) |
| prompt / response | промпт / ответ |
| parameter-efficient fine-tuning (PEFT) | экономное по параметрам дообучение |
| Low-Rank Adaptation (LoRA) | низкоранговая адаптация |
| rank | ранг |
| dense layer | плотный (полносвязный) слой |
| frozen weights | замороженные веса |
| trainable parameters | обучаемые параметры |
| callback | функция обратного вызова (callback) |
| epoch | эпоха |
| learning rate | скорость обучения (learning rate) |
| catastrophic forgetting | катастрофическое забывание |