Случайные числа и графики
Случайные числа, которые можно повторить (сид), среднее, медиана и разброс, гистограммы и первые графики в matplotlib — и почему честная оценка LLM требует многих прогонов.
Зачем это нужно
Заголовок раздела «Зачем это нужно»Случайность в ML повсюду. Веса сети перед обучением заполняются случайными числами. Примеры перемешиваются перед каждой эпохойэпохаEN epochОдин полный проход по обучающим данным. LLM на претрейне часто не делают и одной эпохи. — полным проходом по всем данным. Dropoutдропаут (dropout)EN dropoutНа обучении каждая активация обнуляется с вероятностью p, остальные умножаются на 1/(1 − p); на инференсе слой ничего не делает. В претрейне современных LLM обычно p = 0. — приём против переобучения (ступень 3) — на каждом шаге случайно выключает часть нейронов. Языковая модель выбирает следующий токен, бросая «кубик» по своему распределению. GRPO, алгоритм обучения DeepSeek-R1, генерирует на каждый вопрос группу случайных ответов и сравнивает их между собой.
Отсюда два навыка. Первый — контролировать случайность: повторный запуск эксперимента должен дать тот же результат, иначе невозможно понять, помогло ли ваше изменение. Второй — измерять её: отличать настоящее улучшение от шума. Третий навык идёт бонусом: смотреть на данные глазами. Андрей Карпатый в своём «рецепте» обучения нейросетей ставит этот шаг первым («Become one with the data»): гистограмма или график за минуту находят ошибки, которые не видны в таблицах чисел.
Генератор псевдослучайных чисел
Заголовок раздела «Генератор псевдослучайных чисел»Компьютер не бросает монету. Он запускает детерминированный алгоритм — генератор псевдослучайных чисел, — который из начального числа, сидасид генератора случайных чиселEN random seedНачальное значение генератора. Один и тот же сид даёт ту же последовательность «случайных» чисел., выдаёт длинную последовательность чисел, неотличимую от случайной по статистическим тестам. Один и тот же сид всегда даёт одну и ту же последовательность.
В NumPy генератор создаётся так:
import numpy as np
rng = np.random.default_rng(42)          # генератор с сидом 42print(rng.random(3))                     # 3 числа, равномерно из [0, 1)print(rng.integers(0, 10, size=5))       # 5 целых из [0, 10)print(rng.normal(loc=0.0, scale=1.0, size=3))   # нормальное распределение N(0, 1)print(rng.choice(["карп", "прыгает", "через", "врата", "дракона"], size=4))  # выбор с возвращениемprint(rng.permutation(6))                # случайная перестановка 0..5
Вывод в NumPy 2.4:
[0.77395605 0.43887844 0.85859792][0 6 2 0 5][ 0.1278404 -0.31624259 -0.01680116]['дракона' 'дракона' 'через' 'через'][0 5 4 2 1 3]Запустите этот код ещё раз — числа будут те же самые. Поменяйте сид на 43 — получите другую последовательность.
Без сида (np.random.default_rng()) генератор берёт начальное значение из источника случайности операционной системы,
и результат каждый раз новый. В игре «угадай число» из урока 0.2.6 вы пользовались
модулем random из стандартной библиотеки — идея сида там та же. Для массивов чисел в ML берут генератор NumPy.
Три выражения из комментариев к коду:
- Равномерно из — любое число от 0 до 1 выпадает одинаково часто, это равномерное распределениеравномерное распределениеEN uniform distributionВсе значения на отрезке (или все K исходов) равновероятны. U[0, 1) — то, что возвращает random().. Квадратная скобка значит, что 0 может выпасть, круглая — что 1 не выпадет никогда.
- Нормальное распределение — «колокол»нормальное (гауссовское) распределениеEN normal (Gaussian) distribution«Колокол» N(μ, σ²). Правило 68–95–99.7 — доля значений в пределах 1, 2 и 3 σ от среднего.: чаще всего выпадают числа
около среднего
loc(здесь 0), и чем дальше от него, тем реже.scale— ширина колокола, этоstdиз прошлого урока (0.3.2). Примерно 68 % значений лежат не дальше одногоscaleот среднего и 95 % — не дальше двух. Как выглядит колокол, увидите ниже, в разделе о гистограммах. - Выбор с возвращением — один и тот же элемент может выпасть несколько раз, как
'дракона'в выводе выше.
| Метод | Что делает | Где в ML |
|---|---|---|
rng.random(size) | равномерно из | dropout-маски, метод Монте-Карло (пример — в практике) |
rng.integers(lo, hi, size) | целые из | случайные индексы, id токенов |
rng.normal(loc, scale, size) | нормальное распределение | инициализация весов |
rng.choice(a, size, p=...) | выбор из a с вероятностями p | сэмплирование токенов |
rng.permutation(n) | перестановка | перемешивание данных, разбиение на обучающую и проверочную части (train/val) |
Воспроизводимость в ML
Заголовок раздела «Воспроизводимость в ML»воспроизводимостьвоспроизводимостьEN reproducibilityВозможность получить тот же результат, повторно запустив тот же код на тех же данных. — это возможность получить тот же результат, повторив тот же код на тех же данных. В обучении нейросети случайность приходит из нескольких мест, и зафиксировать нужно все:
import randomimport numpy as npimport torch
SEED = 42random.seed(SEED)                       # стандартный модуль randomrng = np.random.default_rng(SEED)       # NumPy: передавайте rng явноtorch.manual_seed(SEED)                 # PyTorch: инициализация весов, dropout (ступень 3)
rng_data, rng_init = np.random.default_rng(SEED).spawn(2)   # независимые потоки под разные задачи
Зачем отдельные генераторы? Если данные и инициализация берут числа из одного потока, то добавление одного лишнего вызова при загрузке данных изменит все веса. С двумя независимыми генераторами эксперименты не мешают друг другу.
Две оговорки:
- Сид фиксирует последовательность для данной версии библиотеки. После обновления NumPy или PyTorch числа могут стать другими.
- На GPU часть операций недетерминирована: порядок сложения в параллельных потоках меняется, и результаты
расходятся в последних знаках. В PyTorch есть строгий режим
torch.use_deterministic_algorithms(True), но он медленнее.
Частоты сходятся к вероятностям
Заголовок раздела «Частоты сходятся к вероятностям»Сэмплирование с заданными вероятностями — это то, что делает языковая модель при генерации:
rng = np.random.default_rng(0)vocab = np.array(["карп", "дракон", "врата", "река"])p = np.array([0.5, 0.3, 0.15, 0.05]) # «распределение модели»s = rng.choice(len(vocab), size=10_000, p=p) # 10 000 сэмплов: номера слов 0..3# bincount считает, сколько раз выпал каждый номер 0, 1, 2, 3; делим на число сэмплов — получаем долиprint(np.bincount(s, minlength=4) / len(s)) # [0.499 0.2989 0.1523 0.0498]print(vocab[s[:8]])Частоты почти совпали с вероятностями. Как работает choice внутри, вы реализуете сами в уроке 1.3.1, а температуру
и top-p разберёте в уроке 4.1.3. Сейчас важно другое: насколько частота отличается от вероятности при данном
числе сэмплов. Бросим нечестную монету, которая падает орлом с вероятностью , то есть в 70 % бросков:
rng = np.random.default_rng(1)for n in (10, 100, 1000, 10_000, 100_000): # равномерное число из [0, 1) меньше 0.7 ровно в 70 % случаев — это и есть бросок такой монеты; # .mean() у массива True/False — доля орлов freq = (rng.random(n) < 0.7).mean() print(n, freq, round(abs(freq - 0.7), 4), round(np.sqrt(0.7 * 0.3 / n), 4))| бросков | Частота орлов | Ошибка — отличие от 0.7 | Теория |
|---|---|---|---|
| 10 | 0.7 | 0.0 | 0.1449 |
| 100 | 0.67 | 0.03 | 0.0458 |
| 1 000 | 0.689 | 0.011 | 0.0145 |
| 10 000 | 0.6987 | 0.0013 | 0.0046 |
| 100 000 | 0.69918 | 0.0008 | 0.0014 |
Ошибка при равна нулю чисто случайно. Типичный разброс там ±0.145. Это закон больших чисел: частота приближается к вероятности, а стандартное отклонение оценки среднего падает как
Что здесь написано. (греческая «сигма») — стандартное отклонение одного броска, std из прошлого урока.
(«икс с чертой») — среднее по броскам, то есть наша частота, а — её типичная ошибка:
насколько частота обычно отличается от настоящей вероятности. Формула говорит: ошибка среднего равна разбросу одного
броска, делённому на корень из числа бросков.
Для монеты . При это . При ошибка равна — это число из столбца «Теория». При корень равен 20, и ошибка вдвое меньше, около 0.023. Практический вывод: чтобы уменьшить шум вдвое, нужно в четыре раза больше данных. Это правило ещё встретится нам в китайском углу этого урока.
Статистики: что посчитать в первую очередь
Заголовок раздела «Статистики: что посчитать в первую очередь»x = np.array([1.0, 2.0, 3.0, 4.0, 100.0])print(x.mean(), np.median(x)) # 22.0 3.0print(x.std(), x.min(), x.max()) # 39.01… 1.0 100.0print(np.percentile(x, [5, 50, 95])) # [ 1.2 3. 80.8] — 5-й, 50-й (медиана) и 95-й перцентилиМедиана — число посередине отсортированного списка: у [1, 2, 3, 4, 100] это 3. Перцентиль обобщает эту
идею: 95-й перцентиль — число, меньше которого 95 % значений, а 50-й перцентиль — та же медиана. Между соседними
значениями NumPy достраивает промежуточные числа, поэтому 95-й перцентиль здесь — 80.8, хотя такого числа в массиве нет.
Один выброс (100) утащил среднее до 22, хотя типичное значение около 3. Медиана устойчива к выбросам, среднее — нет. Поэтому, например, длины текстов в датасете описывают медианой и перцентилями: «медиана 300 токенов, 95 % короче 2 000», а не средним.
Ещё две проверки, которые спасают часы отладки: np.isnan(x).sum() и np.isinf(x).sum(). Если loss стал nan,
где-то в данных или в вычислениях появилось недопустимое число.
Гистограммы
Заголовок раздела «Гистограммы»гистограммагистограммаEN histogramДиапазон значений делят на корзины (bins) и считают, сколько значений попало в каждую. делит диапазон значений на корзины (bins) и считает, сколько значений попало в каждую. Это самый быстрый способ увидеть форму распределения.
rng = np.random.default_rng(0)x = rng.normal(size=10_000)counts, edges = np.histogram(x, bins=12, range=(-3, 3))for c, lo, hi in zip(counts, edges[:-1], edges[1:]): print(f"{lo:5.1f}..{hi:4.1f} | {'#' * (c // 40)} {c}") -3.0..-2.5 | # 67 -2.5..-2.0 | ### 152 -2.0..-1.5 | ########## 413 -1.5..-1.0 | ####################### 922 -1.0..-0.5 | ###################################### 1520 -0.5.. 0.0 | ################################################ 1939 0.0.. 0.5 | ############################################# 1808 0.5.. 1.0 | ###################################### 1556 1.0.. 1.5 | ####################### 950 1.5.. 2.0 | ########## 437 2.0.. 2.5 | #### 172 2.5.. 3.0 | # 41Такая текстовая гистограмма работает даже в терминале сервера без графики. Те же числа в виде столбцов:
xychart-beta
title "10 000 сэмплов N(0, 1): гистограмма"
x-axis ["-2.75", "-2.25", "-1.75", "-1.25", "-0.75", "-0.25", "0.25", "0.75", "1.25", "1.75", "2.25", "2.75"]
y-axis "Количество" 0 --> 2000
bar [67, 152, 413, 922, 1520, 1939, 1808, 1556, 950, 437, 172, 41]
Симметричный колокол с центром в нуле — так и должно выглядеть нормальное распределение. Если бы гистограмма весов вашей сети выглядела как один столбик в нуле или имела хвосты до ±1000, это был бы повод остановить обучение. Для данных с длинным хвостом, например частот слов (закон Ципфа, ступень 4), берите логарифмическую шкалу.
matplotlib: первые графики
Заголовок раздела «matplotlib: первые графики»matplotlib — стандартная библиотека графиков в Python. В Jupyter графики появляются прямо под ячейкой. Нарисуем три главных типа графиков за один раз:
import numpy as npimport matplotlib.pyplot as plt
rng = np.random.default_rng(0)
# 1) «кривая обучения»: шумный loss и его сглаживание# Формула ниже только рисует правдоподобную кривую: старт около 10.4, спад к 2 и случайный шум.# Экспоненту np.exp и логарифм np.log разберём в уроке 1.0.2.steps = np.arange(2000)loss = 2.0 + (np.log(32_000) - 2.0) * np.exp(-steps / 300) + rng.normal(0, 0.3, size=steps.size)w = 50smooth = np.convolve(loss, np.ones(w) / w, mode="valid")   # скользящее среднее по 50 шагам
# 2) два «облака» точек — так выглядят эмбеддинги слов, если нарисовать их на плоскостиru = rng.normal(loc=[-2.0, 0.0], scale=0.8, size=(200, 2))zh = rng.normal(loc=[2.0, 1.0], scale=0.8, size=(200, 2))
# 3) данные для гистограммыx = rng.normal(size=10_000)
fig, axes = plt.subplots(1, 3, figsize=(15, 4))      # одна фигура, три области (Axes)
axes[0].plot(steps, loss, alpha=0.3, label="loss на шаге")axes[0].plot(steps[w - 1:], smooth, label=f"скользящее среднее ({w})")axes[0].set_xlabel("шаг обучения")axes[0].set_ylabel("loss")axes[0].set_title("Кривая обучения")axes[0].legend()
axes[1].scatter(ru[:, 0], ru[:, 1], s=8, label="русские слова")axes[1].scatter(zh[:, 0], zh[:, 1], s=8, label="китайские слова")axes[1].set_title("Scatter: два кластера")axes[1].legend()
axes[2].hist(x, bins=40)axes[2].set_title("Гистограмма N(0, 1)")axes[2].set_xlabel("значение")axes[2].set_ylabel("сколько раз")
fig.tight_layout()fig.savefig("first_plots.png", dpi=90)    # сохранить в файлplt.show()                                # показать (в Jupyter можно не писать)
Результат:
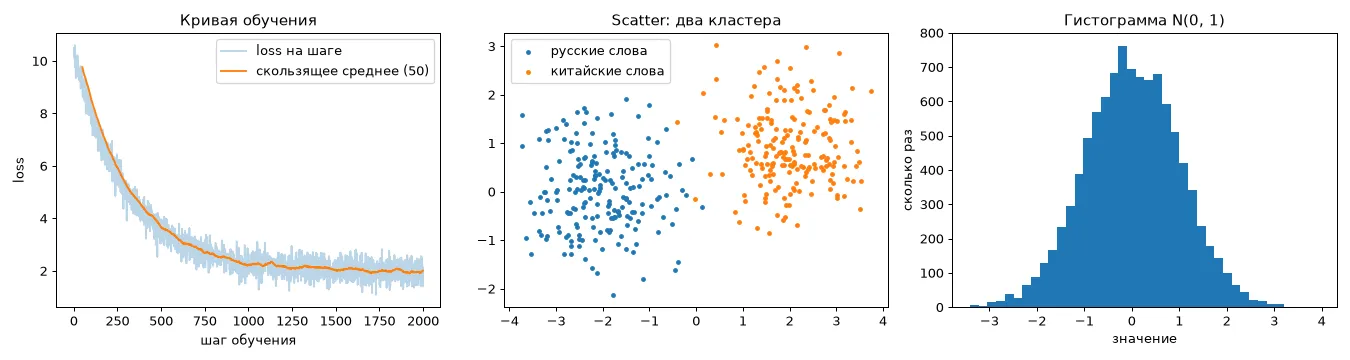
Разберём, что здесь важно:
- Figure и Axes.
plt.subplots(1, 3)создаёт фигуру (Figure) — весь рисунок — и массив из трёх областей (Axes), по одной на график. Рисуют методами области:ax.plot— линия,ax.scatter— точечная диаграмма (каждая пара чисел — точка на плоскости; кучки близких точек называют кластерами),ax.hist— гистограмма. - Подписи обязательны. График без подписей осей через неделю не поймёте даже вы.
set_xlabel,set_ylabel,set_title, а при нескольких линиях —label=...иlegend(). - Сглаживание. Loss на отдельных шагах шумит, потому что каждый батч — новая случайная выборка. Скользящее среднее
np.convolve(loss, np.ones(w) / w, mode="valid")показывает тренд: каждая точка сглаженной линии — среднее 50 соседних значений loss. Обратите внимание: свёртка с окном 50 делает массив на 49 точек короче, поэтому ось x сдвинута (steps[w - 1:]). - Проверка здравого смысла. Синтетическую кривую мы специально начали с (натуральный логарифм, урок 1.0.2): именно такой loss у только что созданной модели со словарём в 32 тысячи токенов, которая угадывает токены наугад (урок 1.3.2). Если ваша настоящая кривая стартует намного выше, не ждите конца обучения: сначала ищите ошибку в коде.
Как смотреть на данные глазами
Заголовок раздела «Как смотреть на данные глазами»Чек-лист на первые пять минут с любым новым массивом, будь то датасет, веса или логи:
x.shape,x.dtype— то ли вообще пришло?x.min(),x.max(),x.mean(),np.median(x)— правдоподобный ли масштаб? Пиксели в или в ?np.isnan(x).sum(),np.isinf(x).sum()— есть ли битые значения?- Гистограмма — какой формы распределение, есть ли выбросы и «столбик в нуле»?
- Несколько случайных примеров (
rng.choice(len(data), 5, replace=False)), а не первые пять. Первые часто нетипичны. - Для обучения — кривая loss со сглаживанием, при большом разбросе — в логарифмической шкале (
ax.set_yscale("log")).
Практика
Заголовок раздела «Практика»Четыре функции на случайность и статистику:
train_val_split— воспроизводимо разбить номера примеров на обучающую часть (на ней модель учится) и проверочную, валидационную (на ней честно измеряют качество, ступень 2). Перемешайте номера черезrng.permutation: первыеn_valпойдут в проверку, остальные — в обучение.describe— сводка по данным из раздела «Статистики».estimate_pi— оценка числа методом Монте-Карло, то есть с помощью множества случайных бросков. Бросаем точки в квадрат 1×1. Точка лежит внутри четверти круга радиуса 1, если её расстояние до угла меньше 1, то есть (теорема Пифагора из прошлого урока). Площадь четверти круга — , площадь квадрата — 1, поэтому внутрь попадёт примерно 78.5 % точек. Если из 10 000 точек внутри оказалось 7 854, то .pass_at_1— усреднение точности по нескольким прогонам бенчмарка (набора задач для оценки модели), как в техотчётах LLM. В таблицеresultsнули и единицы: строка — вопрос, столбец — прогон, 1 — модель решила. Точность прогона — среднее его столбца; дальше — среднее иstdэтих точностей. Зачем так делать, объясняет «Китайский угол» ниже.
import numpy as np


def train_val_split(n, val_frac, seed):
    """Воспроизводимо разбить индексы 0..n-1 на обучающую и валидационную части.

    1) создайте генератор rng = np.random.default_rng(seed);
    2) перемешайте индексы: rng.permutation(n);
    3) первые n_val = int(n * val_frac) индексов — валидация, остальные — обучение.
    Вернуть кортеж (train_idx, val_idx) из двух np.ndarray.
    """
    # TODO
    ...


def describe(x):
    """Сводка по массиву: словарь с ключами
    "mean", "std", "min", "max", "median", "p95" (95-й перцентиль). Значения — float.

    median — число посередине отсортированного массива; p95 — число, меньше которого 95 % значений.
    describe(np.array([1.0, 2.0, 3.0, 4.0, 100.0])) -> {"mean": 22.0, "std": 39.01..., "min": 1.0,
                                                     "max": 100.0, "median": 3.0, "p95": 80.8}
    """
    # TODO: словарь из шести пар: np.mean, np.std, np.min, np.max, np.median, np.percentile(x, 95);
    #       каждое значение оберните в float(...) — так число NumPy станет обычным числом Python.
    ...


def estimate_pi(n, seed):
    """Оценка числа π методом Монте-Карло.

    Бросьте n случайных точек (x, y) в квадрат [0, 1) × [0, 1) генератором default_rng(seed).
    Доля точек с x² + y² < 1 примерно равна площади четверти круга, π/4.
    Вернуть 4 × долю (float). Без циклов.
    Пример: если из 10 000 точек внутри оказалось 7 854, ответ 4 * 0.7854 = 3.1416.
    """
    # TODO: 1) rng = np.random.default_rng(seed); точки — таблица (n, 2): xy = rng.random((n, 2));
    #       2) маска «внутри»: сумма квадратов по строке (axis=1) меньше 1;
    #       3) доля True — это .mean() маски; верните 4 * долю.
    ...


def pass_at_1(results):
    """results — массив 0/1 формы (вопросы, прогоны): решила ли модель вопрос i в прогоне j.

    Вернуть кортеж (mean_acc, std_acc):
      mean_acc — средняя точность по всем вопросам и прогонам (float);
      std_acc  — стандартное отклонение точности МЕЖДУ прогонами (float): обычный np.std, по умолчанию ddof=0.
    """
    # TODO: точность каждого прогона — среднее по оси вопросов
    ...


# Проверьте себя кнопкой «Запустить»:
print(train_val_split(10, 0.2, seed=0))
print(describe(np.array([1.0, 2.0, 3.0, 4.0, 100.0])))
print(estimate_pi(100_000, seed=0))
Проверь себя
Заголовок раздела «Проверь себя»- Псевдослучайный генератор детерминирован:
np.random.default_rng(seed)даёт одну и ту же последовательность. Для разных задач берите отдельные генераторы (spawn). - Для воспроизводимости фиксируйте все источники случайности: данные, инициализацию, dropout, сэмплирование. Отчитывайтесь по нескольким сидам.
- Шум среднего падает как : вдвое точнее — вчетверо больше данных. Поэтому LLM оценивают по многим сэмплам на вопрос.
- Медиана устойчива к выбросам. Гистограмма за секунды показывает форму распределения, выбросы и битые значения.
- matplotlib:
fig, ax = plt.subplots(), затемplot,scatter,hist, подписи осей, заголовок, легенда. Шумный loss сглаживайте скользящим средним.
Дальше: ступень 1 — математика для ML. Начнём с освежения школьной математики: функции и их графики. matplotlib из этого урока пригодится там сразу.