How To Scale Your Model, глава 4: вся математика трансформера
Полный перевод четвёртой главы книги Google DeepMind: как считать FLOPs свёрток, почему обучение стоит 6 × параметры × токены, параметры и FLOPs MLP и внимания, доля внимания при длинном контексте, MoE, чекпоинтинг градиентов, размер KV-кэша, задачи и приложение о Flash Attention.
Здесь мы быстро пройдёмся по архитектуре трансформера, в частности посчитаем FLOPs, байты и другие важные величины. — подзаголовок главы.
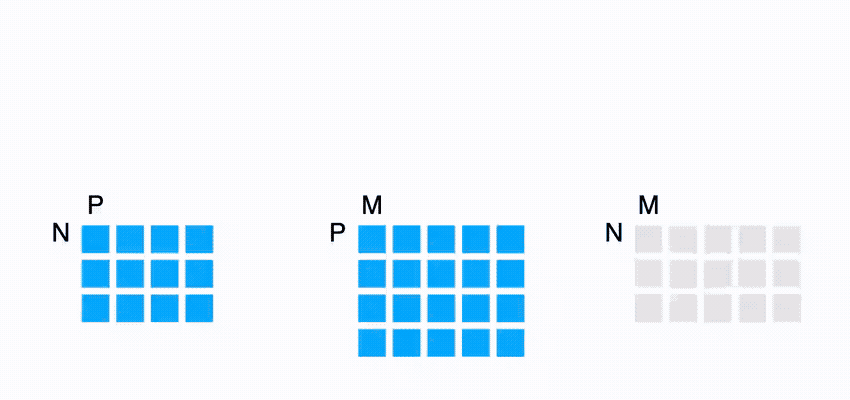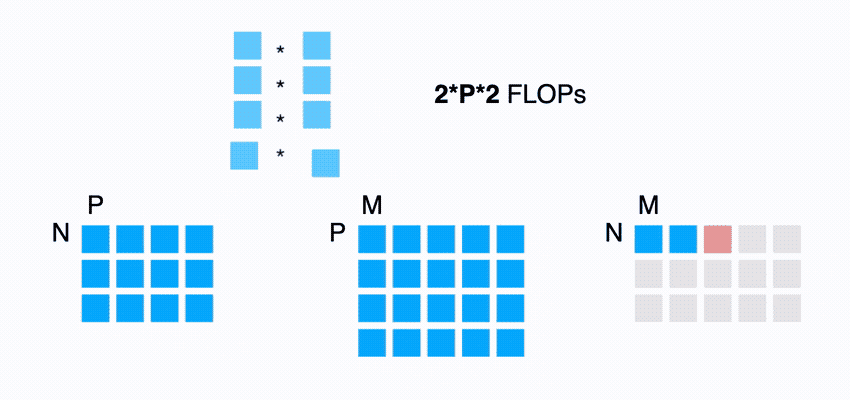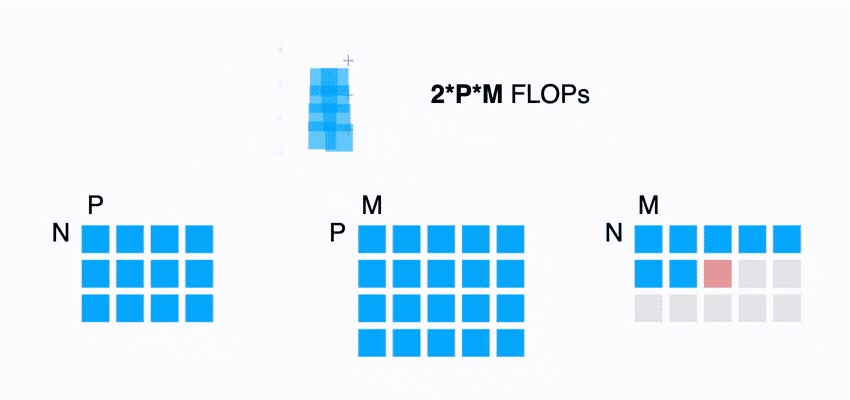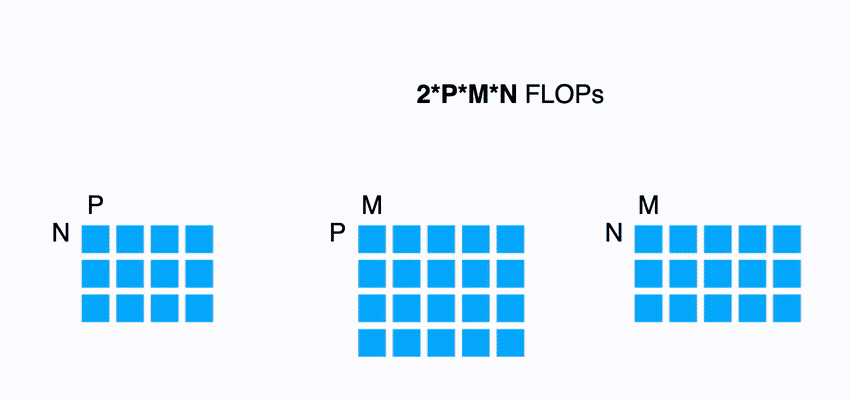
Считаем скалярные произведения
Заголовок раздела «Считаем скалярные произведения»Начнём с векторов , и матриц , следующих форм:
| Массив | Форма |
|---|---|
| [P] | |
| [P] | |
| [N P] | |
| [P M] |
- Скалярное произведение требует сложений и умножений, всего операций с плавающей точкой.
- Произведение матрицы на вектор — это скалярных произведений по строкам , то есть FLOPs.
- Произведение матриц — это произведение матрицы на вектор для каждого из столбцов , всего FLOPs.
- В общем случае, если есть два многомерных массива и , у которых часть измерений — сворачиваемые (CONTRACTING), а часть — батчевые (BATCHING) (например, , где — батчевые, а — сворачиваемые), то стоимость этой свёртки в FLOPs — удвоенное произведение всех измерений и , где батчевые и сворачиваемые измерения учитываются по одному разу (например, ). Заметьте: измерение батчевое, только если оно есть в обоих сомножителях. (И ещё: множитель 2 не применяется, если сворачиваемых измерений нет и это просто поэлементное произведение.)1
Обратите внимание: при умножении матриц вычисления растут кубически, , а передача данных — лишь квадратично, . Значит, с ростом размера умножения проще выйти на предел вычислений. Это очень необычно и во многом объясняет, почему мы используем архитектуры, где доминирует умножение матриц, — они хорошо масштабируются!
Анимация в оригинале (matmul-flops.gif): как из скалярных произведений складывается стоимость умножения матриц.
FLOPs прямого и обратного прохода
Заголовок раздела «FLOPs прямого и обратного прохода»При обучении нас не особенно интересует результат конкретного умножения матриц; на самом деле нас интересует его производная. Оказывается, вычисление этой производной стоит примерно в 3 раза больше, чем само умножение.
Если представить, что B — лишь одна матрица в большой сети, а A — наши входные активации, и C = A B, то производная функции потерь L по B находится по правилу цепочки:
и требует FLOPs (свёртка идёт по измерению ). Аналогично производная потерь по A —
снова FLOPs, поскольку dL/dC — матрица размера . Хотя эта величина — производная не по параметру, она нужна, чтобы вычислять производные для предыдущих слоёв сети (так же, как dL/dC используется выше, чтобы найти dL/dB).
Складывая, получаем, что при обучении всего 6NPM FLOPs против 2NPM при инференсе: 2NPM в прямом проходе и 4NPM в обратном. Поскольку PM — число параметров матрицы, это простейший вид знаменитого приближения для FLOPs обучения трансформера: каждый токен требует FLOPs. Более корректный вывод — ниже.
flowchart LR
F["Прямой проход: C = A·B — 2NPM"] --> G1["dL/dB = Aᵀ·dL/dC — 2NPM"]
F --> G2["dL/dA = dL/dC·Bᵀ — 2NPM"]
G1 --> T["Итого на обучение: 6NPM = 6 × параметры × токены"]
G2 --> T
Бухгалтерия трансформера
Заголовок раздела «Бухгалтерия трансформера»Трансформеры — это будущее. Ну, по крайней мере настоящее. Несколько лет назад они были одной из многих архитектур. Но сегодня стоит знать практически каждую деталь этой архитектуры. Мы не будем заново её вводить, но могут пригодиться этот блог и оригинальная статья о трансформере.
Рисунок в оригинале (transformer-diagram.png): один слой стандартного трансформера-декодера, поток идёт сверху вниз. Формы и раскладки массивов обозначены однобуквенными символами; сворачиваемые измерения показаны красным, батчевые — синим. В каждой операции форма входа дана слева вверху, форма параметра — справа вверху, а получающаяся форма — снизу; например, BTD — форма входа для «гейтового» einsum, а DF — форма весов. Порядок: RMSNorm → проекции Q, K, V (веса , , ) → внимание → проекция O () → сложение с остаточной связью → RMSNorm → и ( каждая) → поэлементное произведение с активацией → () → сложение с остаточной связью.
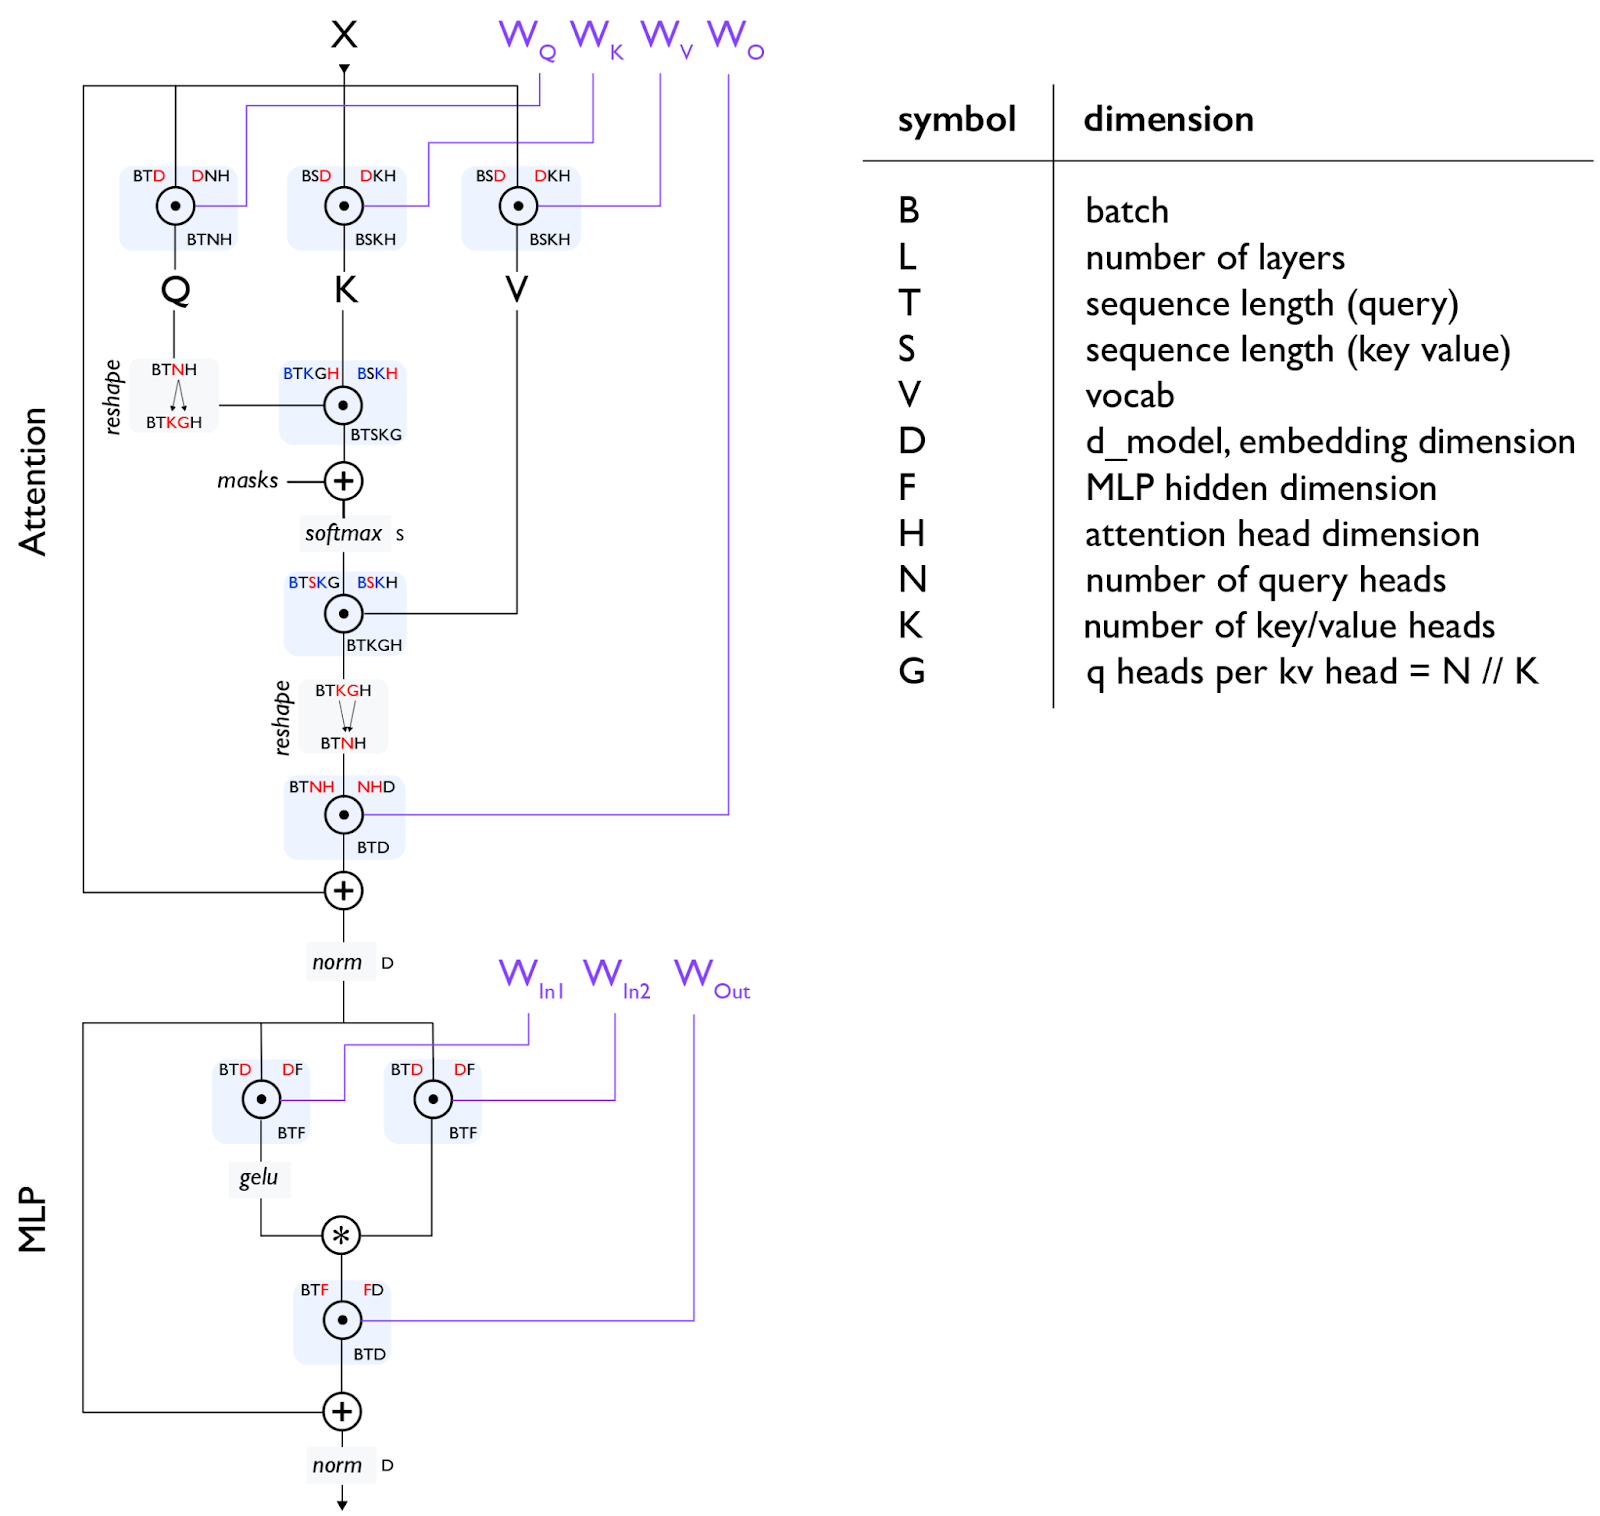
Замечание [гейтовый einsum]. На схеме используется «гейтовый einsum»: матрица повышающей проекции разделена на две ( и выше), выходы которых поэлементно перемножаются как своего рода «функция ворот» (gating). Так делают не все LLM, поэтому иногда вы увидите одну матрицу и общее число параметров MLP 2DF вместо 3DF. Обычно в этом случае D и F увеличивают, чтобы число параметров осталось тем же, что и в варианте с 3 матрицами. Впрочем, та или иная форма гейтового einsum используется в LLaMA, DeepSeek и многих других моделях.
Замечание 2 [MHA]. В самовнимании T и S совпадают, а в перекрёстном внимании могут различаться. В обычном многоголовом внимании (MHA) N и K совпадают, в Multi-Query Attention (MQA) K=1, а в групповом MQA (GMQA, оно же GQA) K должно лишь делить N.
Замечание 3 [pre-norm и post-norm]. На схеме показана архитектура «pre-norm», где нормализация стоит перед остаточной
связью, обычно как x + attn(norm(x)). Так сегодня устроены модели вроде LLaMA-3. В оригинальной статье о трансформере
использовалась архитектура «post-norm», где layernorm стоит после остаточной связи: norm(x + attn(x)).
Общий подсчёт FLOPs и параметров
Заголовок раздела «Общий подсчёт FLOPs и параметров»Посчитаем FLOPs трансформера на один слой (чтобы не таскать везде множитель L). Заметьте: FLOPs обучения ниже почти всегда втрое больше FLOPs инференса, так что любую сумму можно разделить на 3, чтобы получить стоимость одного прямого прохода.
MLP трансформера обычно состоит из 2 входных умножений, результаты которых поэлементно объединяются, и одного выходного умножения (сворачиваемые измерения — D в первых двух строках и F в последней):
Внимание
Заголовок раздела «Внимание»Для общего случая группового внимания (grouped-query attention) с разным числом голов Q и KV будем считать размерность головы H одинаковой для проекций Q, K, V и оценим стоимость умножений QKVO:
Само скалярное внимание (dot-product attention) устроено тоньше: по сути, это умножение , батчевое по измерениям и , затем softmax, затем умножение , снова батчевое по и (в первой строке сворачивается , в третьей — ):
(Здесь — число голов запросов на одну голову ключей.)
Замечание [каузальная маска]. Большинство современных трансформеров используют каузальную маску вместо полного двунаправленного внимания. Тогда полезные FLOPs скалярного внимания уменьшаются вдвое. Чтобы получить это сокращение на практике, нужно ядро внимания (attention kernel), а не наивный einsum.
Прочие операции
Заголовок раздела «Прочие операции»В трансформере есть и другие операции. Layernorm сравнительно дёшевы, и в оценках первого порядка ими можно пренебречь. Заметьте, что в каждом слое их обычно две (одна перед вниманием и одна перед MLP). Есть ещё последнее огромное (хотя и не на каждом слое) умножение на матрицу «разэмбеддинга» (unembedding) — выходного слоя в словарь.
Общее практическое правило для FLOPs трансформера
Заголовок раздела «Общее практическое правило для FLOPs трансформера»Если пренебречь стоимостью скалярного внимания (это разумно при обучении с не слишком длинным контекстом), то общее число FLOPs по всем слоям
Отсюда знаменитое практическое правило оценки FLOPs плотного трансформера без учёта FLOPs внимания. (Разэмбеддинг — ещё одно простое умножение с FLOPs и параметрами — подчиняется тому же правилу.)
Доля внимания при росте длины контекста
Заголовок раздела «Доля внимания при росте длины контекста»Если всё же учесть скалярное внимание и принять , (как обычно) и , то отношение FLOPs скалярного внимания к FLOPs всех умножений (включая проекции внимания):
Вывод: FLOPs скалярного внимания начинают доминировать при обучении, только когда T больше 8D. При D ~ 8 тысяч это ~64 тысячи токенов. Это логично: значит, чем больше MLP, тем менее критичны FLOPs внимания. Для больших моделей квадратичная стоимость внимания на самом деле не такое уж большое препятствие для обучения на длинном контексте. Но для моделей поменьше, например Gemma-27B с D=4608, внимание начинает доминировать примерно с длины 37 тысяч2. Стоимость длинного контекста помогает снизить и Flash Attention, которую мы кратко обсуждаем в приложении А.
Разная математика
Заголовок раздела «Разная математика»Разреженность и смесь экспертов
Заголовок раздела «Разреженность и смесь экспертов»Было бы упущением не обсудить кратко модели со смесью экспертов (Mixture of Experts, MoE), которые заменяют единственный плотный блок MLP стандартного трансформера набором независимых MLP, между которыми можно динамически маршрутизировать. В первом приближении MoE — это обычная плотная модель с E блоками MLP на слой вместо одного. Каждый токен активирует из этих экспертов, обычно . Отношение называют разреженностью (sparsity), обычно оно от 8 до 64 (например, у DeepSeek v3 фактически , ). По сравнению с плотной версией это увеличивает число параметров в раз, а общее число активируемых на токен параметров — в раз.
Рисунок в оригинале (moe.png): пример слоя MoE с экспертами. «Ворота» (gating) направляют каждый токен к из них, и выходы этих MLP суммируются. Число параметров — размеров эксперта, но на каждый токен используются только .
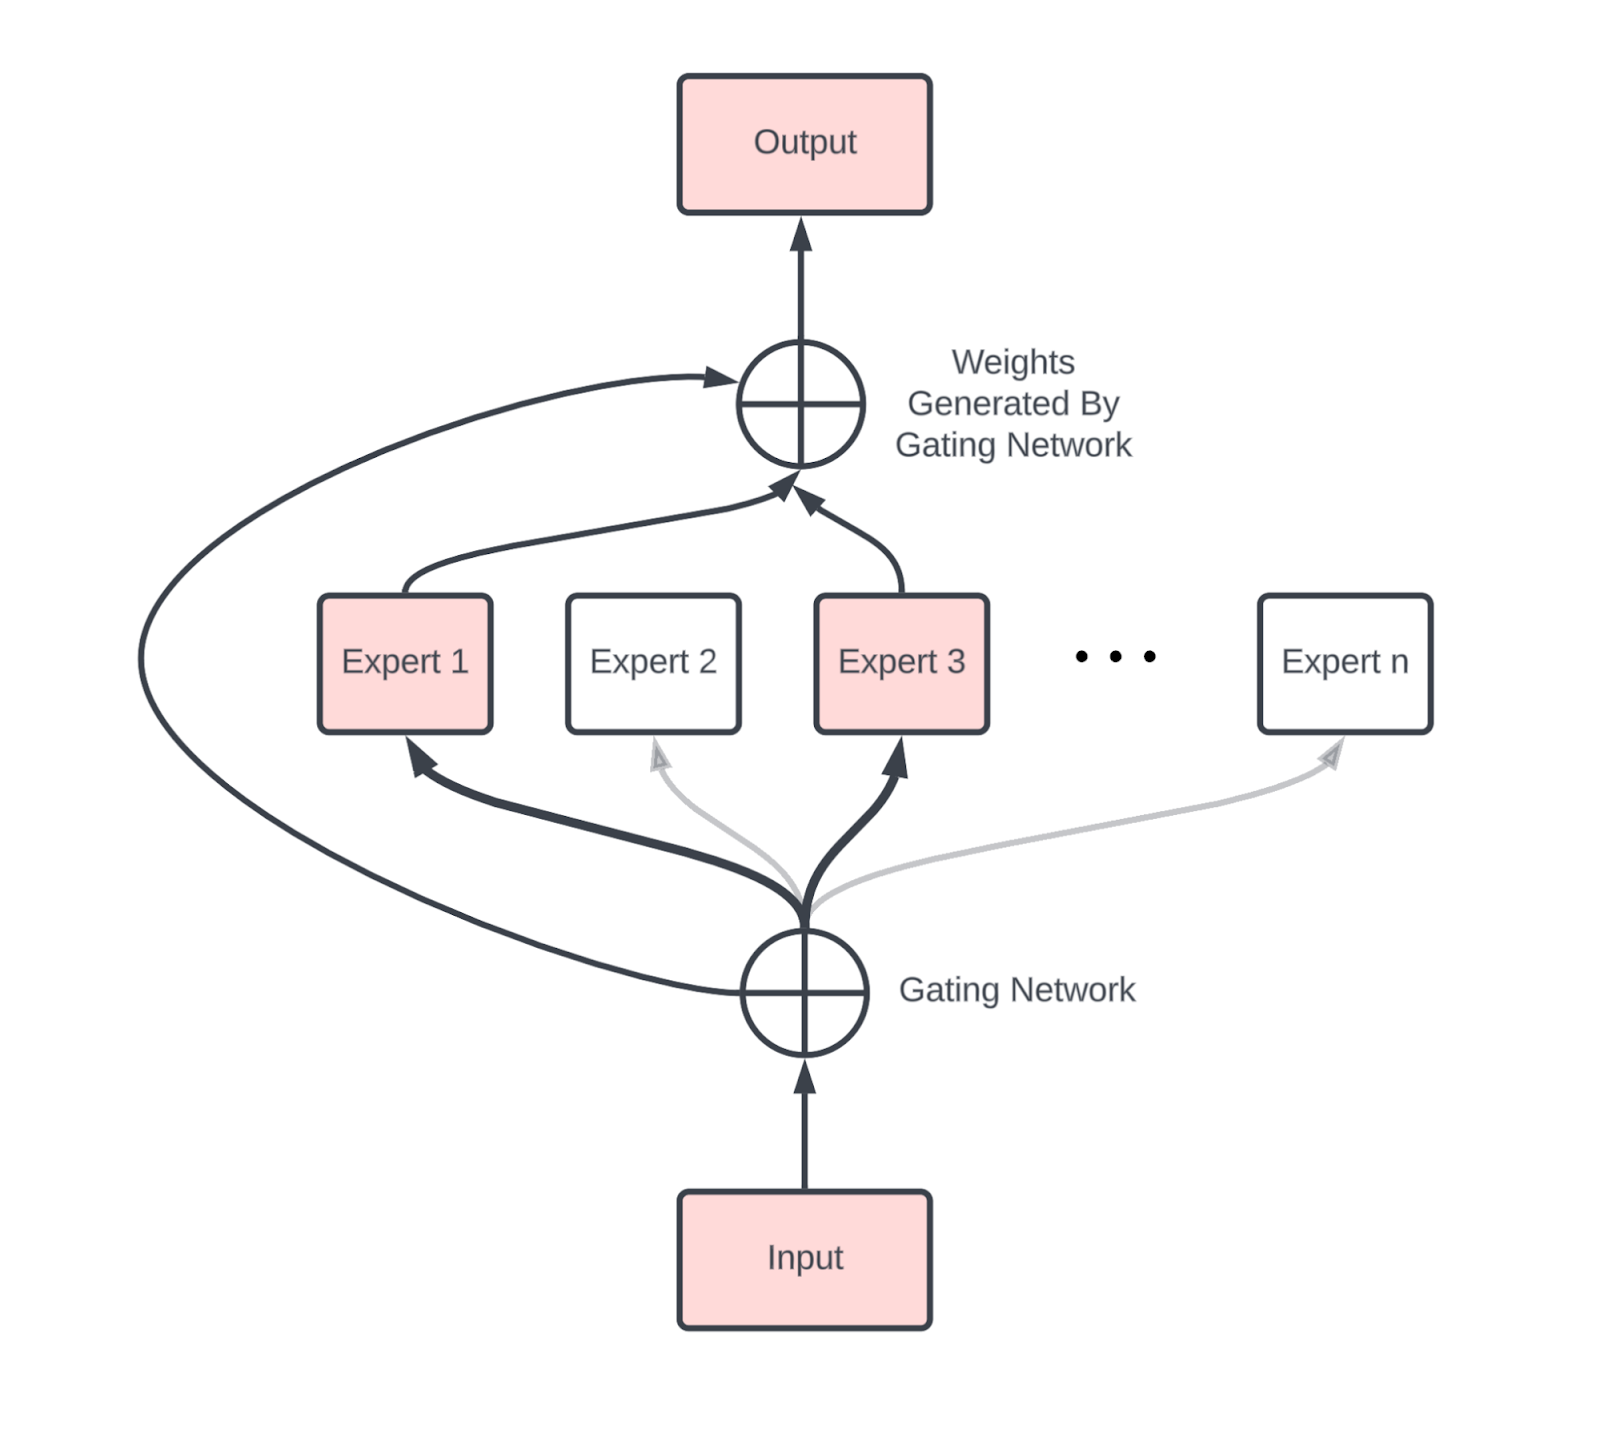
По сравнению с плотной моделью MoE добавляет новую связь — прежде всего два AllToAll (один перед блоком MoE и один после), которые отправляют токены к нужному эксперту и возвращают их на «родное» устройство3. Однако, как мы видели в прошлой главе, каждый AllToAll стоит лишь 1/4 сравнимого AllGather по одной оси (для двунаправленного кольца).
Чекпоинтинг градиентов
Заголовок раздела «Чекпоинтинг градиентов»Обратное распространение как алгоритм меняет вычисления на память. Вместо обратного прохода за FLOPs оно требует памяти: сохраняются все промежуточные активации прямого прохода. Это лучше квадратичных вычислений, но невероятно дорого по памяти: модель с (4 млн токенов в батче), L=64 и D=8192, которая избегает всех лишних вычислений в обратном проходе, должна была бы сохранить примерно ТБ активаций в bfloat16. Множитель 20 получается, если (примерно) посчитать каждый промежуточный узел на схеме трансформера выше, ведь, например,
так что, чтобы не пересчитывать, нужно сохранить из прямого прохода и , и . Чтобы не тратить столько памяти, можно сохранять лишь часть промежуточных активаций. Вот несколько стратегий, которые мы используем.
- Rematerialization по блокам (block remat): сохранять только вход каждого слоя. Это самый агрессивный метод из тех, что мы используем: всего 1 чекпоинт на слой, то есть в примере выше сохранилось бы лишь 4,2 ТБ. Зато в обратном проходе приходится повторить практически все FLOPs прямого, и FLOPs растут с примерно до .
- Только большие умножения: ещё одна простая политика — сохранять только выходы больших умножений матриц. Тогда в обратном проходе не нужно пересчитывать большие умножения, но остальные функции активации и части внимания всё же пересчитываются. Это сокращает 20 на слой примерно до 7.
Список далеко не полный. В JAX этим обычно управляют jax.remat/jax.checkpoint (подробнее
здесь).
Как мы увидим в главе 7, у инференса LLM две ключевые части: prefill и генерация.
- Prefill обрабатывает длинный промпт и сохраняет его активации внимания в кэше ключей и значений (KV Cache) для использования при генерации — точнее, проекции ключей и значений в блоке внимания.
- Генерация объединяет в батч несколько таких KV-кэшей и сэмплирует токены из каждого.
Каждый KV-кэш — это, по сути, массив размера , где 2 соответствует ключам и значениям. Это довольно много! Общий размер кэша ключей и значений в int8 — . Для модели среднего размера с контекстом 8 тысяч, 64 слоями и это . Видно, почему хочется использовать GMQA с .
Что стоит вынести из этой главы?
Заголовок раздела «Что стоит вынести из этой главы?»- Общее число параметров и FLOPs трансформера посчитать довольно просто; сводка ниже для MHA (батч B, словарь V, последовательность длины T, D=dmodel, F=dff):
| Компонент | Параметров на слой | FLOPs обучения на слой |
|---|---|---|
| MLP | 3DF | 18BTDF |
| Внимание | 4DNH | 24BTDNH + 12BT2NH |
| Прочее | 2D | BTD |
| Словарь | DV (всего, не на слой) | 12BTDV |
- Параметры блока MLP доминируют в общем числе параметров, и блок MLP доминирует в бюджете FLOPs, пока длина последовательности меньше .
- Общий бюджет FLOPs при обучении хорошо приближается величиной при разумной длине контекста.
- При инференсе KV-кэш занимает примерно на кэш (где K — число голов KV), хотя изменения архитектуры часто позволяют это уменьшить.
Несколько задач
Заголовок раздела «Несколько задач»Вопрос 1. Сколько параметров у модели с , , и ? Какая доля из них — параметры внимания? Каков размер KV-кэша на токен? Считайте, что , внимание многоголовое, а KV хранятся в int8.
Ответ
- Всего параметров примерно (с учётом двух layernorm на слой). Для данных чисел это , то есть 16 млрд параметров.
- Доля параметров внимания в общем случае — . То есть примерно 1/4 параметров приходится на внимание.
- На токен KV-кэш занимает в int8, то есть
512 KiB / token.
Вопрос 2. Сколько всего FLOPs нужно, чтобы выполнить A[BX, DY] *D W[DY, F]
на {'X': 4, 'Y': 8, 'Z': 4}? Сколько FLOPs выполняет каждый TPU?
Ответ
Общие «теоретические» FLOPs операции — . Но вычисление не шардировано по измерению Z, так что на самом деле мы делаем в Z раз больше FLOPs, то есть всего . Поскольку по остальным измерениям вычисление шардировано, на устройство приходится примерно .
Вопрос 3. Сколько FLOPs в операции ?
Ответ
По правилу выше I и J — сворачиваемые измерения, а K, L, M, N и O — несворачиваемые. «Батчевых измерений» нет, так что это просто — произведение всех осей. Будь у нас общая ось, она учитывалась бы один раз.
Вопрос 4. Какова арифметическая интенсивность группового внимания с несколькими запросами (без проекций Q/K/V/O)? Дайте ответ как функцию длин последовательностей запросов и KV — T и S — и группового множителя G. При какой длине контекста внимание упирается в FLOPs? С учётом пропускной способности HBM наших TPU постройте график относительной стоимости внимания по сравнению с блоком FFW при росте длины контекста. Подсказка: считайте, что реализация внимания эффективна и не делает лишних чтений и записей. Рассмотрите оба предела: T = S и T ≪ S.
Ответ
Самовнимание требует загрузить активации , и , затем вычислить , затем записать результат обратно в HBM. Это будет сделано с Flash Attention, так что у расчёта есть оговорки, но в целом в bf16 самовнимание выполняет
Итого байт: ; всего FLOPs — ; арифметическая интенсивность — .
Так что во время prefill , и интенсивность — . Во время генерации , и получаем при очень большом . В зависимости от трактовки вопроса, при prefill или обучении самовнимание упирается в вычисления при S=240 (если нет шардирования по последовательности). При генерации мы никогда не упираемся в вычисления, потому что мал. Тем не менее видно, что рост приближает нас к упору в вычисления.
Вопрос 5. При какой длине последовательности FLOPs самовнимания равны FLOPs проекций QKVO?
Ответ
Это просто вопрос, когда . Упрощая, получаем , то есть, например, при это . Значит, при большинстве разумных длин контекста FLOPs умножений матриц больше.
Вопрос 6. Допустим, при прямом проходе мы сохраняем только выходы 7 главных умножений слоя трансформера (Q, K, V, O и три матрицы FFW). Сколько дополнительных FLOPs нужно «рематериализовать» в обратном проходе?
Ответ
Если сохранять только выходы семи умножений (Q, K, V, O, W₁, W₂, W₃), то в обратном проходе нужно пересчитать два умножения внимания
чтобы получить .
Каждое из них — умножение , батчевое по последовательностям и головам, так что дополнительные FLOPs —
Другие пересчитываемые операции:
- для и .
- И для .
Вопрос 7. DeepSeek v3, по их словам, обучалась 2,79 млн часов H800 на 14,8 трлн токенов (источник). Учитывая, что у неё 37 млрд активируемых параметров, какой примерно загрузки железа они добились? Подсказка: они использовали FLOPs в FP8 без структурированной разреженности.
Ответ
По спецификации — 3026 TFLOPs/s в FP8 с разреженностью, или обычно вдвое
меньше (1.513e15 FLOPs/s) без неё. 2,79 млн часов H800 — это 2.79e6 * 1.513e15 * 60 * 60 = 1.52e25 FLOPs всего.
При 37 млрд активируемых параметров этот запуск обучения должен был потребовать около 6 * 37e9 * 14.8e12 = 3.3e24 FLOPs.
Значит, использование FLOPs — около 3.3e24 / 1.52e25 = 21.7%.
Вопрос 8. У моделей со смесью экспертов (MoE) копий стандартного плотного блока MLP, и каждый токен активирует из этих экспертов. Какой батч в токенах нужен, чтобы MoE с весами в int8 упиралась в вычисления на TPU v5e? Каково это число для DeepSeek с 256 (маршрутизируемыми) экспертами и ?
Ответ
Поскольку у нас копий каждого эксперта, в int8 для каждой матрицы весов нужно загрузить байт. Поскольку каждый токен активирует экспертов, для каждой матрицы весов получаем FLOPs. Чтобы упираться в вычисления с весами int8 и FLOPs в bfloat16, арифметическая интенсивность (FLOPs на загруженный байт) должна превышать ~240 FLOPs/байт у TPU, то есть , или .
Значит, нужно . Для DeepSeek это . Это удивительно большой батч для этапа генерации.
Это всё для главы 4. Глава 5 — о масштабировании обучения трансформера — здесь.
Приложение
Заголовок раздела «Приложение»Приложение А: как работает Flash Attention?
Заголовок раздела «Приложение А: как работает Flash Attention?»Традиционное возражение против масштабирования трансформеров на очень длинный контекст — FLOPs и память внимания растут квадратично с длиной контекста. Действительно, произведение QK во внимании имеет форму , где B — размер батча, T и S — длины последовательностей Q и K, а N — число голов, но у этого утверждения серьёзные оговорки:
- Как мы отмечали, хотя рост квадратичный, FLOPs внимания доминируют, только когда , а при обучении память одной матрицы внимания мала по сравнению со всеми весами и чекпоинтами активаций в памяти, особенно при шардировании.
- Чтобы вычислить внимание, не нужно материализовывать всю матрицу внимания! Можно вычислять локальные суммы и максимумы и никогда не держать в памяти больше небольшого куска массива. Общие FLOPs всё равно квадратичны, но давление на память резко снижается.
Второе наблюдение впервые сделали Rabe et al. 2021, а затем — в статье о Flash Attention (Dao et al. 2022). Основная идея — вычислять внимание кусками по K/V: вычисляется локальный softmax и вспомогательная статистика, которые передаются следующему куску, а он объединяет их со своим локальным. А именно, вычисляются:
- M: текущий максимум по измерению последовательности;
- O: текущий полный результат softmax-внимания по измерению последовательности;
- L: текущий знаменатель .
С ними можно вычислить новый максимум, новую текущую сумму и новый выход, используя лишь постоянный объём памяти. Если описать схематично, внимание — это примерно такая операция:
Максимум вычитается ради численной устойчивости, и его можно вычесть без влияния на результат, поскольку . Посмотрим только на знаменатель: представим, что у нас два соседних куска векторов ключей, и , и для каждого мы посчитали локальные суммы softmax и :
Тогда их можно объединить в полную сумму softmax для двух кусков вместе:
где
То же можно сделать и для полного softmax — так получается способ накапливать сколь угодно большие суммы softmax. Полный алгоритм из статьи о Flash Attention — на рисунке flash-algo.png в оригинале.
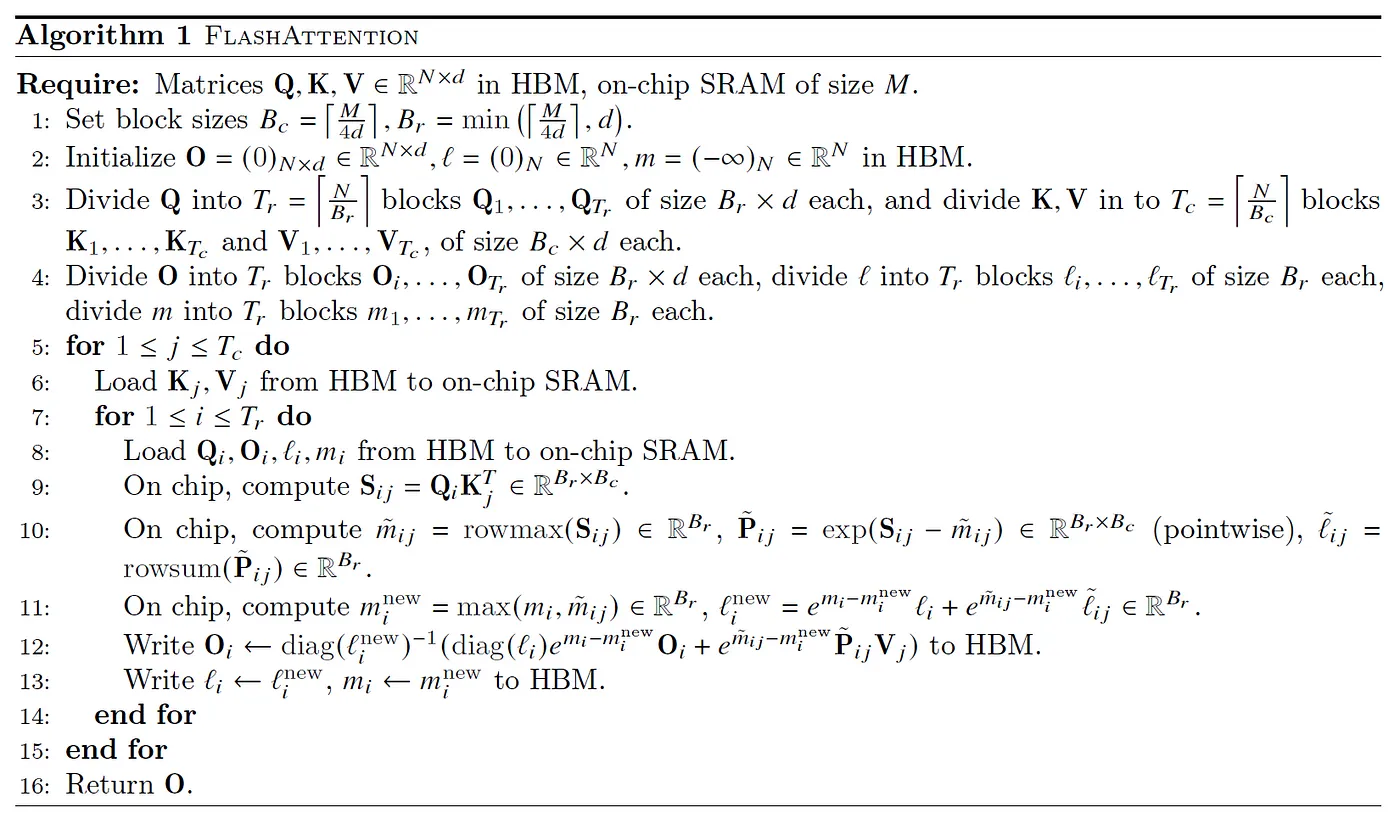
С точки зрения железа это позволяет поместить кусок Q в VMEM (в алгоритме выше она называется SRAM на кристалле), так что на каждой итерации загружаются только куски KV, и арифметическая интенсивность растёт. В VMEM можно держать и текущую статистику.
# Примечание переводчика: онлайн-softmax по кускам ключей — суть Flash Attention для одного запроса q.import numpy as np
rng = np.random.default_rng(0)q, K, V = rng.normal(size=8), rng.normal(size=(1000, 8)), rng.normal(size=(1000, 4))
m, l, o = -np.inf, 0.0, np.zeros(4)            # текущий максимум, знаменатель, ненормированный выходfor start in range(0, 1000, 128):              # куски по 128 ключей    s = K[start:start + 128] @ q               # оценки q·k для куска    m_new = max(m, s.max())    scale = np.exp(m - m_new)                  # пересчёт старых сумм к новому максимуму    p = np.exp(s - m_new)    l = l * scale + p.sum()    o = o * scale + p @ V[start:start + 128]    m = m_new
w = np.exp(K @ q - (K @ q).max()); ref = (w / w.sum()) @ Vprint(np.allclose(o / l, ref))                 # True: результат совпадает с обычным softmax
Последний тонкий момент, который стоит подчеркнуть, — свойство softmax во внимании, благодаря которому вычисление VJP (производной обратного режима) Flash Attention становится практичным для обучения. Определим промежуточный массив softmax:
Во внимании мы получаем dS из массивов обратного режима dO и V:
При обратном распространении этого градиента к Q и K
Мы пользуемся тождеством, которое позволяет заменить свёртку по большому измерению длины ключей локальной свёрткой по измерению глубины признаков:
Эта замена критически важна, чтобы реализовать для VJP локальное вычисление по блокам последовательности, и она открывает путь к другим хитрым схемам шардирования вроде кольцевого внимания (ring attention).
Словарик
Заголовок раздела «Словарик»| English | Русский |
|---|---|
| contracting / batching dimension | сворачиваемое / батчевое измерение |
| forward / backward (reverse-mode) FLOPs | FLOPs прямого / обратного прохода |
| gating einsum (GLU) | гейтовый einsum |
| MHA, MQA, GQA (GMQA) | многоголовое внимание, внимание с одним ключом, групповое внимание |
| pre-norm / post-norm | нормализация до / после остаточной связи |
| dot-product attention | скалярное внимание |
| causal mask | каузальная маска |
| unembedding | разэмбеддинг (выходной слой в словарь) |
| Mixture of Experts, sparsity, routing | смесь экспертов, разреженность, маршрутизация |
| gradient checkpointing, rematerialization | чекпоинтинг градиентов, рематериализация (пересчёт) |
| KV cache, prefill, generation | KV-кэш, prefill (обработка промпта), генерация |
| online softmax, running max | онлайн-softmax, текущий максимум |
| VJP (vector-Jacobian product) | произведение вектора на якобиан (обратный режим) |
| ring attention | кольцевое внимание |
Footnotes
Заголовок раздела «Footnotes»-
Сворачиваемые измерения — оси, по которым в операции идёт суммирование (они есть в обоих входах, но не в выходе), как внутреннее измерение при умножении матриц. Батчевые измерения — общие оси, которые есть в обоих входах и без изменений переходят в выход; они нумеруют независимые подзадачи и при подсчёте FLOPs не перемножаются между собой. В терминах einsum: метки, которые есть в обоих входах и в выходе, — батчевые; метки, которые есть в обоих входах, но отсутствуют в выходе, — сворачиваемые. ↩
-
Заметьте, что некоторые современные открытые модели вводят локальное внимание или другие оптимизации, которые снижают стоимость внимания и меняют этот roofline. ↩
-
Строго говоря, это происходит, только если данные или последовательность шардированы по той же оси, что и эксперты. ↩